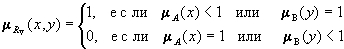Нечеткие множества в системах управления
Теорема декомпозиции
Любое нечеткое отношение R представимо в форме:
R =
 R,
0<1,
где R означает, что все элементы R умножаются на .
Условные нечеткие подмножества.
Пусть X и Y - универсальные множества, взаимосвязь которых задана нечетким отношением R: (XY)[0,1], т.е. для каждой пары (x,y)XY задано значение функции принадлежности R(x,y)[0,1].
Пусть А - некоторое нечеткое множество, заданное на Х, т.е. определена функция принадлежности A(x) для всех х из Х. Тогда нечеткое множество А и нечеткое отношение R индуцируют в Y нечеткое подмножество B с функцией принадлежности
B(y)
=
 min[A(x),
R(x,y)]
=
 [
A(x)
R(x,y)].
Обозначение: B = AR.
Пример:
Пусть X = {x1, x2, x3}, Y = {y1, y2, y3, y4} и заданы нечеткое отношение
XRY = |
y1 |
y2 |
y3 |
y4 |
|
|
x1 |
0,8 | 1 | 0 | 0,3 | |
|
x2 |
0,8 | 0,3 | 0,8 | 0,2 | |
|
x3 |
0,2 | 0,3 | 0 | 0,4 |
и нечеткое множество A = {0,3/x1,0,7/x2,1/x3}.
Проведем операцию для А и столбца y1 :
-
x1
x2
x3
0,3 0,7 1 L y1
0,8 0,8 0,2 = y1
0,30,8
0,70,8
10,2
= y1
0,3 0,7 0,2
После выполнения операции V на элементах полученного столбца имеем:
B(y1) = 0,3V0,7V0,2 = 0,7.
Проделав аналогичные вычисления для y2, y3, y4 имеем:
B(y2) = 0,3
B(y3) = 0,7
B(y4) = 0,4.
И окончательно:
-
A R B 0,3 0,7 1 ·
0,8 1 0 0,3 0,8 0,3 0,8 0,2 0,2 0,3 0 0,4 = 0,7 0,3 0,7 0,4
Замечание. При заданном R, если А индуцирует В, то ближайшее четкое подмножество А индуцирует В.
Нечеткие подмножества последовательно обуславливающие друг друга
Если
А1 индуцирует А2 посредством R1,
А2 индуцирует А3 посредством R2,
.............................................
Аn-1 индуцирует Аn посредством Rn-1,
то
А1 индуцирует Аn посредством Rn-1Rn-2 ...R1,
где Rn-1Rn-2 ...R1 - определенная выше композиция нечетких отношений R1, R2, ..., Rn.
Пример:
Вернемся к примеру (max-min)-композиции.
|
R1 |
· |
R2 |
= |
R1R2 |
|||||||||||||||||||||||||||||||||||||||||||||
|
|
|
Пусть А={0,3/x1, 0,7/x2 }, тогда
|
А1 |
R1 |
А2 |
|||||||||||||
|
· |
|
= |
|
|||||||||||
|
А2 |
R2 |
А3 |
|||||||||||||||||||||
|
· |
|
= |
|
|||||||||||||||||||
|
А1 |
R1R2 |
А3 |
||||||||||||||||
|
· |
|
= |
|
||||||||||||||
Немного о бинарных отношениях вида XRX
Нечеткие отношения вида XRX задаются функцией принадлежности R(x,y), но с условием, что x и y - элементы одного и того же универсального множества. В зависимости от своих свойств (основные - симметричность, рефлексивность, транзитивность) конкретные нечеткие отношения задают отношения сходства и различия, порядка или слабого порядка между элементами Х. Они имеют обширную сферу приложений в задачах автоматической классификации и принятия решений (сравнение альтернатив).
3. НЕЧЕТКАЯ И ЛИНГВИСТИЧЕСКАЯ ПЕРЕМЕННЫЕ
Понятие нечеткой и лингвистической переменных используется при описании объектов и явлений с помощью нечетких множеств.
Нечеткая переменная характеризуется тройкой <, X, A>, где
- наименование переменной,
X - универсальное множество (область определения ),
A - нечеткое множество на X, описывающее ограничения (т.е. A(x)) на значения нечеткой переменной .
Лингвистической переменной называется набор < ,T,X,G,M>, где
- наименование лингвистической переменной;
Т - множество ее значений (терм-множество), представляющих собой наименования нечетких переменных, областью определения каждой из которых является множество X. Множество T называется базовым терм-множеством лингвистической переменной;
G - синтаксическая процедура, позволяющая оперировать элементами терм-множества T, в частности, генерировать новые термы (значения). Множество T G(T), где G(T) - множество сгенерированных термов, называется расширенным терм-множеством лингвистической переменной;
М - семантическая процедура, позволяющая превратить каждое новое значение лингвистической переменной, образуемое процедурой G, в нечеткую переменную, т.е. сформировать соответствующее нечеткое множество.
Замечание. Чтобы избежать большого количества символов
символ используют как для названия самой переменной, так и для всех ее значений;
пользуются одним и тем же символом для обозначения нечеткого множества и его названия, например терм "молодой", являющийся значением лингвистической переменной = "возраст", одновременно есть и нечеткое множество М ("молодой").
Присвоение нескольких значений символам предполагает, что контекст позволяет разрешить возможные неопределенности.
Пример: Пусть эксперт определяет толщину выпускаемого изделия с помощью понятий "малая толщина", "средняя толщина" и "большая толщина", при этом минимальная толщина равна 10 мм, а максимальная - 80 мм.
Формализация такого описания может быть проведена с помощью следующей лингвистической переменной <, T, X, G, M>, где
- толщина изделия;
T - {"малая толщина", "средняя толщина", "большая толщина"};
X - [10, 80];
G - процедура образования новых термов с помощью связок "и", "или" и модификаторов типа "очень", "не", "слегка" и др. Например: "малая или средняя толщина", "очень малая толщина" и др.;
М -
процедура
задания на X =
[10, 80] нечетких
подмножеств
А1="малая
толщина", А2
= "средняя толщина",
А3="большая
толщина", а
также нечетких
множеств для
термов из G(T) в
соответствии
с правилами
трансляции
нечетких связок
и модификаторов
"и", "или",
"не", "очень",
"слегка" и
др. операции
над нечеткими
множествами
вида: А
В, А В,
 ,
CON А = А2 , DIL А = А0,5
и др.
Замечание. Наряду с рассмотренными выше базовыми значениями лингвистической переменной "толщина" (Т={"малая толщина", "средняя толщина", "большая толщина"}) возможны значения, зависящие от области определения Х. В данном случае значения лингвистической переменной "толщина изделия" могут быть определены как "около 20 мм", "около 50 мм", "около 70 мм", т.е. в виде нечетких чисел.
Продолжение примера:
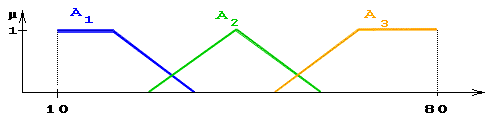
Функции принадлежности нечетких множеств:
"малая толщина" = А1 , "средняя толщина"= А2, " большая толщина"= А3 .
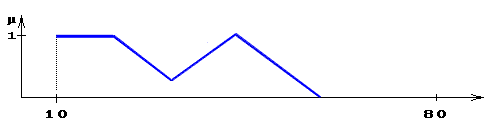
Функция принадлежности:
нечеткое множество "малая или средняя толщина" = А1А1.
Нечеткие числа
Нечеткие числа - нечеткие переменные, определенные на числовой оси, т.е. нечеткое число определяется как нечеткое множество А на множестве действительных чисел R с функцией принадлежности A(x)[0,1], где x - действительное число, т.е. xR.
Нечеткое
число А нормально,
если
 A(x)=1,
выпуклое,
если для любых
xyz
выполняется
A(x)A(y)A(z).
Множество - уровня нечеткого числа А определяется как
А = {x/ A(x)}.
Подмножество SAR называется носителем нечеткого числа А, если
S = {x/A(x)>0}.
Нечеткое число А унимодально, если условие A(x) = 1 справедливо только для одной точки действительной оси.
Выпуклое нечеткое число А называется нечетким нулем, если
A(0)
=
 (A(x)).
Нечеткое число А положительно, если xSA, x>0
и отрицательно, если xSA, x<0.
Операции над нечеткими числами
Расширенные бинарные арифметические операции (сложение, умножение и пр.) для нечетких чисел определяются через соответствующие операции для четких чисел с использованием принципа обобщения следующим образом.
Пусть
А и В - нечеткие
числа, и
 -
нечеткая операция,
соответствующая
операции
 над
обычными числами.
Тогда
С =
АB
C(z)= (A(x)B(y))).
Отсюда:
С = C(z)=
 (A(x)B(y))),
С =

C(z)=
 (A(x)B(y))),
С =

C(z)=
 (A(x)
B(y))),
С =

C(z)=
 (A(x)B(y))),
С =

C(z)=
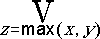 (A(x)B(y))),
С =

C(z)=
 (A(x)B(y))).
Нечеткие числа (L-R)-типа
Нечеткие числа (L-R)-типа - это разновидность нечетких чисел специального вида, т.е. задаваемых по определенным правилам с целью снижения объема вычислений при операциях над ними.
Функции принадлежности нечетких чисел (L-R)-типа задаются с помощью невозрастающих на множестве неотрицательных действительных чисел функций действительного переменного L(x) и R(x), удовлетворяющих свойствам:
а) L(-x)=L(x), R(-x)=R(x);
б) L(0)=R(0).
Очевидно, что к классу (L-R) функций относятся функции, графики которых имеют следующий вид:
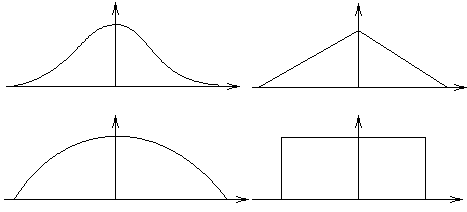
Примерами аналитического задания (L-R) функций могут быть
L(x)
=
 ,
p0;
R(x)=
 ,
p 0 и т.д.
Пусть L(y) и R(y) - функции (L-R)-типа (конкретные). Унимодальное нечеткое число А с модой а (т.е. A(a)=1) c помощью L(y) и R(y) задается следующим образом:
A(x)
=
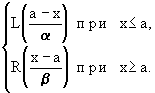
где а - мода; >0, >0 - левый и правый коэффициенты нечеткости.
Таким образом, при заданных L(y) и R(y) нечеткое число (унимодальное) задается тройкой А = (а, , ).
Толерантное нечеткое число задается, соответственно, четверкой параметров А=(а1, a2, , ), где а1 и a2 - границы толерантности, т.е. в промежутке [а1,a2] значение функции принадлежности равно 1.
Примеры графиков функций принадлежности нечетких чисел (L-R)-типа приведены ниже.
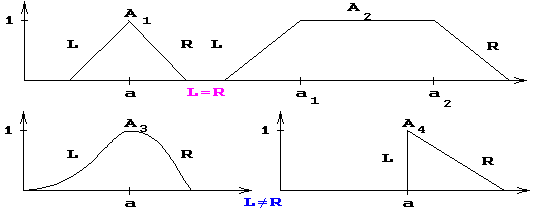
Мы не будем здесь рассматривать операции над (L-R) числами; отметим, что в конкретных ситуациях функции L(y), R(y), а также параметры , нечетких чисел (а, , ) и (а1, a2, , ) должны подбираться таким образом, чтобы результат операции (сложения, вычитания, деления и т.д.) был точно или приблизительно равен нечеткому числу с теми же L(y) и R(y), а параметры и результата не выходили за рамки ограничений на эти параметры для исходных нечетких чисел, особенно если результат в дальнейшем будет участвовать в операциях.
Замечание. Решение задач математического моделирования сложных систем с применением аппарата нечетких множеств требует выполнения большого объема операций над разного рода лингвистическими и другими нечеткими переменными. Для удобства исполнения операций, а также для ввода-вывода и хранения данных, желательно работать с функциями принадлежности стандартного вида.
Нечеткие множества, которыми приходится оперировать в большинстве задач, являются, как правило, унимодальными и нормальными. Одним из возможных методов аппроксимации унимодальных нечетких множеств является аппроксимация с помощью функций (L-R)-типа.
Примеры (L-R)-представлений некоторых лингвистических переменных:
| Терм ЛП | (L-R)-представление | Графическое представление |
| Средний |
А = (а, , )LR = >0 |
a b |
| Малый |
А = (а, , )LR = |
= |
| Большой |
А = (а, , )LR = |
= |
| Приблизительно в диапазоне |
А = (а1, а2, , )LR = >0 |
a1 a2 |
| Определенный |
А = (а, 0, 0)LR = = 0 |
= 0 = 0 |
|
Разнообразный зона полной неопределенности |
А = (а, , )LR = = |
= = |
4. НЕЧЕТКИЕ ВЫСКАЗЫВАНИЯ И НЕЧЕТКИЕ МОДЕЛИ СИСТЕМ
Нечеткими высказываниями будем называть высказывания следующего вида:
Высказывание < есть '>, где - наименование лингвистической переменной, ' - ее значение, которому соответствует нечеткое множество на универсальном множестве Х.
Например высказывание <давление большое> предполагает, что лингвистической переменной "давление" придается значение "большое", для которого на универсальном множестве Х переменной "давление" определено соответствующее данному значению "большое" нечеткое множество.
Высказывание < есть m'>, где m - модификатор, которому соответствуют слова "ОЧЕНЬ", "БОЛЕЕ ИЛИ МЕНЕЕ", "МНОГО БОЛЬШЕ" и др.
Например: <давление очень большое>, <скорость много больше средней> и др.
Составные высказывания, образованные из высказываний видов 1. и 2. и союзов "И", "ИЛИ", "ЕСЛИ.., ТО...", "ЕСЛИ.., ТО.., ИНАЧЕ".
Высказывания на множестве значений фиксированной лингвистической переменной
То, что значения фиксированной лингвистической переменной соответствуют нечетким множествам одного и того же универсального множества Х, позволяет отождествлять модификаторы "очень" или "не" с операциями "CON" и "дополнение", а союзы "И", "ИЛИ" с операциями "пересечение" и "объединение" над нечеткими множествами .
Для иллюстрации понятия лингвистической переменной мы в качестве примера рассматривали лингвистическую переменную "толщина изделия" с базовым терм-множеством Т = {"малая", "средняя", "большая"}. При этом на Х = [10, 80] мы определили нечеткие множества А1, А2, А3, соответствующие базовым значениям: "малая", "средняя", "большая".
В
этом случае
высказыванию
<толщина изделия
очень малая>
соответствует
нечеткое множество
CONA = A2; высказыванию
<толщина изделия
не большая или
средняя> - нечеткое
множество А2 высказыванию
<толщина изделия
не малая и не
большая> А1.
Высказывания <толщина изделия много больше средней> или <толщина изделия близка к средней> требуют использования нечетких отношений R ("много больше,чем") и R ("близко к"), заданных на ХХ. Тогда этим высказываниям будут соответствовать нечеткие множества AR1 и AR2, индуцированные нечеткими отношениями R1 и R2.
Случай двух и более лингвистических переменных
Пусть <, T, X, G, M> и <, T, Y, G, M> - лингвистические переменные, и высказываниям < есть '>, < есть '> соответствуют нечеткие множества А и В заданные на X и Y.
Составные нечеткие высказывания вида 3, связывающие значения лингвистических переменных и , можно привести к высказываниям вида 1, введя лингвистическую переменную (, ), значениям которой будут соответствовать нечеткие множества на XY.
Напомним,
что нечеткие
множества А
и В, заданные
на X и Y, порождают
на XY нечеткие
множества
 и
 ,
называемые
цилиндрическими
продолжениями,
с функциями
принадлежности:
 (x,y)
= A(x)
при любом y,
 (x,y)
= B(y)
при любом x,
где (x,y) XY.
Нечеткие множества, соответствующие составным высказываниям
< есть ' и есть '> и
< есть ' или есть '>,
определяются по следующим правилам (преобразования к виду 1), справедливым при условии невзаимодействия переменных, т.е. множества X и Y таковы, что их элементы не связаны какой-либо функциональной зависимостью.
Правила преобразований нечетких высказываний
Правило преобразования конъюнктивной формы
Справедливо выражение:
< есть ' и есть '><(, ) есть ('')>.
Здесь
- знак
подстановки,
''
- значение
лингвистической
переменной
(, ),
соответствующее
исходному
высказыванию
< есть
' и
есть '>,
которому на
XY ставится
в соответствие
нечеткое множество
c
функцией
принадлежности
 (x,y)
=
(x,y)(x,y)
= A(x)B(y).
Правило преобразования дизъюнктивной формы
Справедливо выражение:
<
есть '
или есть
'><(,)
есть ('')>,
где значению
('')
лингвистической
переменной
(, )
соответствует
нечеткое множество
,
с функцией
принадлежности
 (x,y)
=
(x,y)V(x,y)
= A(x)VB(y).
Замечание 1. Правила справедливы также для переменных вида <, T1, X, G1,M1> и <, T2, Y, G2, M2>, когда в форме значений лингвистических переменных формализованы невзаимодействующие характеристики одного и того же объекта. Например, для построения нечеткого множества высказывания <ночь теплая и очень темная> нужно использовать правило конъюнктивной формы, а для высказывания <ночь теплая или очень темная> - правило дизъюнктивной формы.
Замечание 2. Если задана совокупность лингвистических переменных {<i, Ti, Xi, Gi, Mi>}, i = 1, 2, .., n, то любое составное высказывание, полученное из высказываний < есть '> с использованием модификаторов "очень", "не", "более или менее" и др. и связок "и", "или", можно привести к виду < есть '>, где - составная лингвистическая переменная (1,2,..,n ), ' - ее значение, определяемое (как и функция принадлежности) в соответствии с вышеуказанными правилами.
Правило преобразования высказываний импликативной формы
Справедливо выражение:
<если есть ', то есть '> <(, ) есть ('')>, где значению ('') лингвистической переменной (, ) соответствует нечеткое отношение XRY на XY.
Функция принадлежности R(x,y) зависит от выбранного способа задания нечеткой импликации.
Способы определения нечеткой импликации
Будем считать, что заданы универсальные множества X и Y, содержащие конечное число элементов. Под способом определения нечеткой импликации "если А, то В" (где А и В нечеткие множества на X и Y соответственно) будем понимать способ задания нечеткого отношения R на XY, соответствующего данному высказыванию.
С целью обоснованного выбора определения нечеткой импликации, японскими математиками Мидзумото, Танака и Фуками было проведено исследование всех известных по литературе определений (плюс предложенные авторами). Рассмотренные определения задавали следующие нечеткие отношения для высказывания "если А, то В":
Rm
= (AB)(Y)
Rm(x,y) = (A(x) B(y)) V (1 - A(x));
Ra
= (Y)(XB)
Ra(x,y) = 1 (1-A(x) + B(y));
Rc = AB
Rc(x,y) = A(x) B(y);
Rs
= AY XB
Rs(x,y)
=
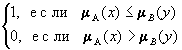 ;
Rg
= AY XB
Rg(x,y)
=
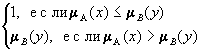 ;
Rsg
= ( AYXB
)
(
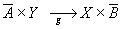 )
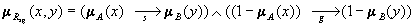 ;
Rgg
= ( AY XB)
()
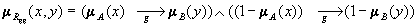 ;
Rgs
= ( AYXB)
(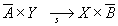 )
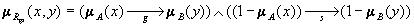 ;
Rss
= ( AY XB)
()
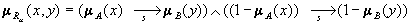 ;
Rb
= (Y)(XB)
Rb(x,y) = (1-A(x)) B(y);
R
= AY XB
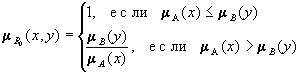 ;
R
= AY XB
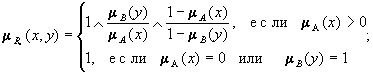
R*
= AY XB
R*(x,y) = 1 - A(x)+ A(x) B(y);
R#
= AY XB
R#(x,y)=( A(x) B(y)) ((1 - A(x)) (1 - B(y)) (B(y) (1 - A (x));
R
= AY XB