О теории вероятностей
Важным частным случаем стохастической зависимость является корреляционная. Корреляционная зависимость м/у переменными величинами – это та функциональная зависимость, которая существует м/у значениями одной из них и групповыми средними другой. (Корреляционные зависимости Y на Х и Х на Y обычно не совпадают). Корреляционная связь чаще всего характеризуется выборочным коэффициентом корреляции r, который характеризует степень линейной функциональной зависимости м/у CB X и Y. Для двух СВ Х и Y коэффициент корреляции имеет => св-ва:
-1≤r≤1;
если r=+ 1, то м/у СВ Х и Y существует функциональная линейная зависимость;
если r=0, то СВ Х и Y некоррелированны, что не означает независимости вообще;
если Х и Y образуют систему нормально распределенных СВ, то из их некоррелированности => их независимость.
Коэффициенты корреляции Y на Х и Х на Y совпадают.
Корреляция используется для количественной оценки взаимосвязи двух наборов данных с помощью коэффициента корреляции. Коэффициент корреляции выборки представляет собой ковариацию двух наборов данных, деленную на произведение их стандартных отклонений.
44. Критерий согласия
Проверка гипотезы о предполагаемом законе неизвестного распределения производится так же, как и проверка гипотезы о параметрах распределения, т. е. при помощи специально подобранной случайной величины — критерия согласия.
Критерием согласия называют критерий проверки гипотезы о предполагаемом законе неизвестного распределения.
Имеется несколько критериев согласия: χ2 («хи квадрат») К. Пирсона, Колмогорова, Смирнова и др.
Ограничимся описанием применения критерия Пирсона к проверке гипотезы о нормальном распределении генеральной совокупности (критерий аналогично применяется и для других распределений, в этом состоит его достоинство). С этой целью будем сравнивать эмпирические (наблюдаемые) и теоретические (вычисленные в предположении нормального распределения) частоты. Обычно эмпирические и теоретические частоты различаются.
Случайно ли расхождение частот? Возможно, что расхождение случайно и объясняется малым числом; наблюдений, либо способом их группировки, либо другими причинами. Возможно, что расхождение частот неслучайно (значимо) и объясняется тем, что теоретические частоты вычислены, исходя из неверной гипотезы о нормальном распределении генеральной совокупности. Критерий Пирсона отвечает на поставленный выше вопрос. Правда, как и любой критерий, он не доказывает справедливость гипотезы, а лишь устанавливает, на принятом уровне значимости, ее согласие или несогласие с данными наблюдений.
Итак, пусть по выборке объема п получено эмпирическое распределение:
варианты xl, x1, x2 ... xs,
эмп. частоты ni n1 п2 ... ns.
Допустим, что в предположении нормального распределения генеральной совокупности, вычислены теоретические частоты п. При уровне значимости α, требуется проверить нулевую гипотезу; генеральная совокупность распределена нормально.
В качестве критерия проверки нулевой гипотезы примем случайную величину
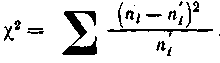 (*)
Эта величина случайная, так как в различных опытах она принимает различные, заранее неизвестные значения. Ясно, что чем меньше различаются эмпирические и теоретические частоты, тем меньше величина критерия (*) и, следовательно, он в известной степени характеризует близость эмпирического и теоретического распределений.
Заметим, что возведением в квадрат разностей частот устраняют возможность взаимного погашения положительных и отрицательных разностей. Делением на n’i достигают уменьшения каждого из слагаемых; в противном случае сумма была бы настолько велика, что приводила бы к отклонению нулевой гипотезы даже и тогда, когда она справедлива. Разумеется, приведенные соображения не являются обоснованием выбранного критерия, а лишь пояснением.
Доказано, что при n→∞ закон распределения случайной величины (*), независимо от того, какому закону распределения подчинена генеральная совокупность, стремится к закону распределения χ2 с k степенями свободы. Поэтому случайная величина (*) обозначена через χ2, а сам критерий называют критерием согласия «хи квадрат».
Число степеней свободы находят по равенству
k=s-1-r
где s — число групп выборки; r — число параметров предполагаемого распределения, которые оценены по данным выборки.
В частности, если предполагаемое распределение — нормальное, то оценивают два параметра (математическое ожидание и среднее квадратическое отклонение) поэтому r=2 и число степеней свободы
k=s-1-r=s-1-2-s-3.
Если, например, предполагают, что генеральная совокупность распределена по закону Пуассона, то оценивают один параметр X, поэтому r=1 и k=s-2.
Поскольку односторонний критерий более «жестко» отвергает нулевую гипотезу, чем двусторонний, построим правостороннюю критическую область, исходя из требования, чтобы вероятность попадания критерия в эту область, в предположении справедливости нулевой гипотезы, была равна принятому уровню значимости α:
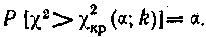
Т.о., правосторонняя критическая область определяется неравенством
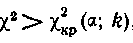
а область принятия нулевой гипотезы — неравенством
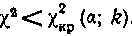
Обозначим значение критерия, вычисленное по данным наблюдений, через χ2набл и сформулируем правило проверки нулевой гипотезы.
Правило. Для того чтобы, при заданном уровне значимости, проверить нулевую гипотезу H0: генеральная совокупность распределена нормально, надо сначала вычислить теоретические частоты, а затем наблюдаемое значение критерия
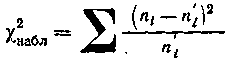 (**)
и по таблице критических точек распределения χ2, по заданному уровню значимости α, и числу степеней свободы k=s-3, найти критическую точку χ2 (α; k).
Если χ2набл<χ2кр – нет оснований отвергнуть нулевую гипотезу.
Если χ2набл >χ2кр — нулевую гипотезу отвергают.
Замечание 1. Объем выборки должен быть достаточно велик, во всяком случае не менее 50. Каждая группа должна содержать не менее 5—8 вариант; малочисленные группы следует объединять в одну, суммируя частоты.
Замечание 2. Поскольку возможны ошибки первого и второго рода, в особенности, если согласование теоретических и эмпирических частот «слишком хорошее», следует проявлять осторожность.
Замечание 3. В целях контроля вычислений, формулу (**) преобразуют к виду
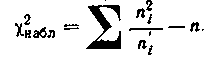
45. Понятие и модели дисперсионного анализа
Дисперсионный анализ позволяет ответить на вопрос о наличии существенного влияния некоторых факторов на изменчивость фактора, значения которого могут быть получены в результате опыта. При проверке статистических гипотез предполагается случайность вариации изучаемых факторов. В дисперсионном анализе один или несколько факторов изменяются заданным образом, причем, эти изменения могут влиять на результаты наблюдений. Исследование такого влияния и является целью дисперсионного анализа.
Идея дисперсионного анализа заключается в том, что основная дисперсия разлагается в сумму составляющих ее дисперсий, каждое слагаемое которой соответствует действию определенного источника изменчивости. Например, в двухфакторном анализе мы получим разложение вида:
sС2=sА2+sВ2+sАВ2+dZ’2,
где
sС2 –общая дисперсия изучаемого признака С
sА2 –доля дисперсии, вызванная влиянием фактора А
sВ2 - доля дисперсии, вызванная влиянием фактора В
sАВ2 - доля дисперсии, вызванная взаимодействием факторов А и В
dZ’2 –доля дисперсии, вызванная неучтенными случайными причинами (случайная дисперсия).
В дисперсионном анализе рассматривается гипотеза: Н0 – ни один из рассматриваемых факторов не оказывает влияния на изменчивость признака. Значимость каждой из оценок дисперсии проверяется по величине ее отношения к оценке случайной дисперсии и сравнивается с соответствующим критическим значением, при уровне значимости a, с помощью таблиц критических значений F – распределения Фишера-Снедекора. Гипотеза Н0 относительно того или иного источника изменчивости отвергается, если Fрасч.> Fкр.
В дисперсионном анализе рассматриваются эксперименты трех видов:
А) эксперименты, в которых все факторы имеют систематические (фиксированные) уровни;
Б) эксперименты, в которых все факторы имеют случайные уровни;
В) эксперименты, в которых есть факторы, имеющие случайные уровни, а так же факторы, имеющие фиксированные уровни.
Все три случая соответствует трем моделям, которые рассматриваются в дисперсионном анализе.
Однофакторный дисперсионный анализ.
Рассмотрим единичный фактор, который принимает р различных уровней, и предположим, что на каждом уровне сделано n наблюдений, что дает N = np наблюдений. (все факторы имеют фиксированные уровни)
Пусть результаты представлены в виде Хij (i=1,2...,p; j=1,2...,n).
Предполагается, что доля каждого уровня n наблюдений имеется средняя, которая равна сумме общей средней и ее вариации обусловленной выбранным уровнем:
Xij = m + Ai + eij,
где m - общая средняя;
Ai – эффект, обусловленный i-м уровнем фактора;
eij – вариация результатов внутри отдельного уровня фактора. С помощью члена eij принимаются в расчет все неконтролируемые факторы.
Пусть наблюдения на фиксированном уровне фактора нормально распределены относительно среднего значения m + Ai с общей дисперсией s2.
Тогда (точка вместо индекса обозначает усреднение соответствующих наблюдений по этому индексу):
Xij – X.. = (Xi. – X..) + (Xij – Xi.).
Иначе первую формулу можно записать: S = S1 + S2. Величина S1 вычисляется по отклонениям р средних от общей средней X.. , поэтому S1 имеет (р-1) степеней свободы. Величина S2 вычисляется по отклонениям N наблюдений от р выборочных средних и, следовательно, имеет N – р = np – p = p(n - 1) степеней свободы. S имеет (N -1) степеней свободы.
Если гипотеза о том, что влияние всех уровней одинаково, справедлива, то обе величины М1 и М2 будут несмещенными оценками s2. Значит, гипотезу можно проверить, вычислив отношение (М1/М2) и сравнив его с Fкр. с n1= (р-1) и n2= (N – р) степенями свободы.
Если Fрасч.> Fкр. , то гипотеза о незначимом влиянии фактора А на результат наблюдений не принимается.
Многофакторный дисперсионный анализ. Дисперсионный анализ в Excel.
Дисперсионный анализ позволяет ответить на вопрос о наличии существенного влияния некоторых факторов на изменчивость фактора, значение которого могут быть получены в результате опыта. При проверке статистических гипотез предполагается случайность вариации изучаемых факторов. В дисперсионном анализе один или несколько факторов изменяются заданным образом, причем, эти изменения могут влиять на результаты наблюдений. Исследование такого влияния и является целью дисперсионного анализа. Идея дисперсионного анализа заключается в том, что основная дисперсия разлагается на сумму составляющих ее дисперсий, каждое слагаемое которой соответствует действию определенного источника изменчивости. Например, в двухфакторном анализе мы получим разложение вида:
sC2=sA2 + sB2 + sAB2 + dZ2
sC2 – общая дисперсия изучаемого признака С;
sA2 – доля дисперсии, вызванная влиянием фактора А;
sB2 – доля дисперсии, вызванная влиянием фактора В;
sAB2 – доля дисперсии, вызванная взаимодействием факторов А и В;
dZ2 – доля дисперсии, вызванная неучтенными случайными причинами (случайная дисперсия);
В дисперсионном анализе рассматривается гипотеза Н0 – и один из рассматриваемых факторов не оказывает влияния на изменчивость признака. Значимость каждой из оценок дисперсии проверяется по величине ее отношения к оценке случайной дисперсии и сравнивается с соответствующим критическим значением, при уровне значимости a, с помощью таблиц критических значений F-распределения Фишера-Снедекора. Гипотеза Н0 относительно того или иного источника изменчивости отвергается, если Fрасч>Fкр. В дисперсионном анализе рассматриваются эксперименты 3 видов:
1. эксперименты, в которых все факторы имеют систематические (фиксированные) уровни;
2. эксперименты, в которых все факторы имею случайные уровни;
3. эксперименты, в которых есть факторы, имеющие случайные уровни, а так же факторы, имеющие случайные уровни.
Двухфакторный дисперсионный анализ с повторениями представляет собой более сложный вариант однофакторного анализа, включающего более чем одну выборку для каждой группы данных. Двухфакторный дисперсионный анализ позволяет статистически обосновать существенность влияния факторных признаков А и В взаимодействия факторов (А и В) на результативный фактор F.
Двухфакторный дисперсионный анализ без повторений позволяет оценить существенность воздействия факторов А и В на результирующий фактор без учета воздействия взаимодействии факторов А и В.
46. Оценка методом наименьших квадратов коэффициентов регрессии
Регрессионный анализ – один из основных методов современной мат статистики. Корреляционный анализ позволяет установить существует или не существует зависимость м/у парами наблюдений, то регрессионный анализ дает целый арсенал методов построения соответствующих зависимостей. Классическим методом оценивания коэффициентов уравнения регрессии является метод наименьших квадратов (МНК).
На основании известных n пар наблюдений (xi, yi) делается предположение о виде зависимости, например:
y=a+bx,
где y – зависимая (результативная) переменная, х – независимая (факторная) переменная.
Пусть переменная x задается точно (без ошибок), тогда отклонение наблюдений yi от зависимости y=a+bx является случайным и параметры a и b можно найти из условия минимизации суммы квадратов ошибок
εi=yi–a–bxi
S= Sεi2→ min,
S= S( yi–a–bxi)2→ min,
Эта система носит название системы нормальных уравнений Гаусса, т.к. получена из условия минимизации суммы квадратов отклонении, в предположении, что xi – фиксированы, т.е. отклонения перпендикулярны оси ОХ.