«Биокомпьютеры»
Алгоритм построения оптимального выравнивания основан на методе динамического программирования, введенном в широкую практику Ричардом Беллманом в 1957. Идея метода состоит в следующем: чтобы решить основную задачу, нужно придумать множество промежуточных и последовательно их решить (в каком порядке - отдельный вопрос). При этом очередная промежуточная задача должна «легко» решаться, исходя из уже известных решений ранее рассмотренных задач. Множество промежуточных задач удобно представлять в виде ориентированного ациклического графа. Его вершины соответствуют промежуточным задачам, а ребра указывают на то, результаты решений каких промежуточных задач используются для основной. Таким образом, исходная задача сводится к поиску оптимального пути в графе 2 (подробнее о методе динамического программирования см. книгу Ахо, Хопкрофта и Ульмана, а также статью Finkelstein A.V., Roytberg M.A. Computation of biopolymers: a general approach to different problems. Biosystems.1993; 30 (1-3): 1-19.). Аналогично можно переформулировать различные варианты задач выравнивания, предсказания вторичной структуры РНК и белков, поиска белок-кодирующих областей ДНК и других важных проблем биоинформатики.
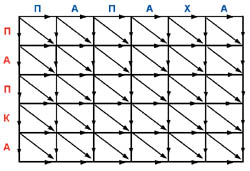
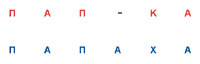
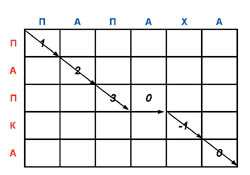
При построении оптимального выравнивания (мы рассматриваем простейший случай, когда удаление и вставка отдельных символов штрафуются независимо) промежуточные задачи - это построение оптимальных выравниваний начальных фрагментов исходных последовательностей. При этом задачи нужно решать в порядке возрастания длин фрагментов. Граф зависимости между промежуточными решениями для сравнения слов «ПАПКА» и «ПАПАХА», а также последовательность промежуточных шагов, приводящих к оптимальному выравниванию, показаны на рис. 2.
Рис. 2.

|
|
(a) Граф зависимостей между промежуточными задачами для выравнивания слов ПАПКА и ПАПАХА. Каждая вершина соответствует паре начальных фрагментов указанных слов. Диагональное ребро, входящее в вершину, соответствует сопоставлению последних букв сравниваемых начальных фрагментов (случай 1), горизонтальное ребро - удалению буквы в слове ПАПАХА, вертикальное ребро - удалению буквы в слове ПАПКА (случаи 2 и 3). Правая верхняя вершина - начальная и соответствует выравниванию пустых слов, левая нижняя вершина - конечная, соответствует выравниванию полных слов ПАПКА и ПАПАХА. |
|
|
(b) Оптимальное выравнивание слов ПАПКА и ПАПАХА при следующих параметрах: вес совпадения букв: 1, штраф за замену гласной на гласную или согласной на согласную: 1, штраф за замену гласной на согласную или согласной на гласную: 2, штраф за удаление символа: 3. |
|
|
(c) Траектория, соответствующая оптимальному выравниванию. В клетках указаны веса промежуточных оптимальных выравниваний. Например, вес оптимального выравнивания для «ПАП» и «ПАПА» равен 0, а для «ПАПК» и «ПАПАХ» равен -1. |
На двух примерах - распознавания вторичной структуры РНК (бегло) и выравнивания белковых последовательностей (более подробно) мы проследили за эволюцией постановок задач в биоалгоритмике. Упомянем кратко еще несколько аспектов. Пожалуй, с практической точки зрения самым важным является поиск в базах данных последовательностей, сходных с изучаемой. Определяющую роль начинают играть проблемы вычислительной эффективности, решаемые, в частности, с применением алгоритмов хеширования. Для предсказания пространственной структуры белков важны алгоритмы выравнивания последовательности со структурой (при этом используется тот факт, что из-за разницы физико-химических свойств аминокислоты встречаются с разной частотой на поверхности белка и в структурном ядре). Наконец, мы полностью оставили в стороне задачи построения эволюционных деревьев по белковым последовательностям. Подчеркнем, что во всех случаях происходит интенсивная «притирка» постановок задач - как с биологической (большая адекватность), так и с алгоритмической (возможность построения более эффективных алгоритмов) точки зрения.
Врезка
1
Врезка
2
Врезка
3: Алгоритм
оптимального
выравнивания
(набросок)

1 (обратно
к тексту)
- Последняя
монография
- Pavel A. Pevzner. Computational
Molecular Biology. An Algorithmic Approach. The MIT Press. Cambridge,
MA, 2000, из
книг
на
русском
языке
укажем
М.
С.
Уотермен
(ред).
Математические
методы для
анализа последовательностей
ДНК.-М.: Мир, 1999.
2
(обратно
к тексту)
- Иногда (например,
в упоминавшейся
задаче о построении
оптимальной
вторичной
структуры РНК)
приходится
рассматривать
не графы, а
гиперграфы.
Гиперграф
отличается
от графа тем,
что вместо
ребер на множестве
вершин задаются
гиперребра.
Ребро в (ориентированном)
графе сопоставляет
начальной
вершине одну
конечную вершину.
Гиперребро
сопоставляет
начальной
вершине множество
вершин (не
обязательно
одноэлементное).
Аналогом пути
в гиперграфе
является гиперпуть
- объект, похожий
на дерево.
ПОДБЕРЕЗОВИК
|
(1) |
ПОДБЕРЕЗОВИК |
(2) |
ПОДБЕРЕЗОВИК |
(3) |
ПОДБЕРЕЗОВИК |
(4) |
ПОДБЕРЕЗ----ОВИК
|
(5) |
С точки зрения алгоритма построения оптимального выравнивания введение весовых матриц ничего не меняет. Однако оказывается, что нельзя рассматривать удаление одного символа как отдельное эволюционное событие. Вес нужно приписывать удалению целого фрагмента, и этот вес должен зависеть от длины фрагмента. Ограничения на выбор функции G(L) штрафов за удаление фрагментов (L - длина удаляемого фрагмента) влияют на эффективность построения оптимального выравнивания. В простейшем случае посимвольных замен (этот случай соответствует функции G(L)=k•L, где k - штраф за удаление одного символа) время работы квадратично зависит от длины сравниваемых слов (считаем, что их длины примерно равны), а в случае допустимости произвольных штрафных функций порядок роста времени работы соответствующего алгоритма - кубический. Компьютерные эксперименты показали, что разумным компромиссом служат линейные функции вида G(L)=k•L+s, где s - штраф за начало удаления/вставки, где k и L имеют тот же смысл, что и раньше. Для таких функций можно построить квадратичный по времени работы алгоритм построения оптимального выравнивания (хотя и с большей константой пропорциональности).
Алгоритм оптимального выравнивания (набросок)
Пусть нам нужно найти оптимальное выравнивание последовательностей U=Xa и W=Yb (здесь a - последняя буква U, b - последняя буква W, последовательности X и Y - получаются соответственно из U и W отбрасыванием последней буквы. Для оптимального выравнивания возможны ровно три альтернативы:
последние буквы слов U и W сопоставлены друг другу;
последняя буква слова U удалена, последняя буква слова W - нет;
последняя буква слова W удалена, последняя буква слова U - нет.
В первом случае вес оптимального выравнивания равен
S1 = S(X, Y)+m(a, b).
Здесь S(X, Y) - вес оптимального выравнивания последовательностей X и Y (оно уже построено ранее, т. к. пара (X, Y) рассмотрена до текущей пары (U, W)), m(a, b) - вес сопоставления символов a и b.
Во втором и третьем случае аналогично получаем формулы:
S2 = S(X, Yb)+g,
S3 = S(Xa, Y)+g.
Здесь g - штраф за удаление символа, S(X, Yb) и S(Xa, Y) - веса оптимальных выравниваний для пар последовательностей (X и Yb = W) и (Xa=U и Y) соответственно. Оптимальные выравнивания для этих пар последовательностей тоже построены ранее. Таким образом, чтобы найти вес S(U, W) оптимального выравнивания последовательностей U и W и само это выравнивание, достаточно найти наибольшее из чисел S1 , S2 , S3. Очевидно, каждое из этих чисел можно вычислить за конечное (не зависящее от длин исходных последовательностей) время. Поэтому общее время построения оптимального выравнивания двух последовательностей пропорционально количеству промежуточных задач, т. е. произведению длин этих последовательностей.
Биочипы как
пример индустриальной
биологии
Ж ивые
организмы
устроены крайне
сложно и содержат
большое количество
взаимодействующих
систем. Основную
роль в управлении
жизнедеятельностью
играют гены
- участки молекулы
ДНК, в которых
хранится информация
об устройстве
молекул, вовлеченных
в различные
процессы в
живой клетке.
Считается, что
ген работает,
когда с него
считывается
информация.
Биологам и медикам необходимо знать реакцию больших каскадов взаимозависимых и взаимообуславливающих генов на то или иное изменение внешних условий, например в ответ на введенное лекарство.
Полное число генов измеряется величинами порядка 103 (6200 у дрожжей) - 104 (38 000 по последним данным у человека), при этом базовые жизненные процессы регулируются сотнями генов. До последнего времени в значительной степени отсутствовали возможности для получения, хранения и обработки столь значительных массивов данных. Благодаря прогрессу компьютерной индустрии были созданы как технологии для одновременного экспериментального получения информации о работе большого числа генов в клетке, так и методы обработки этой информации, позволяющие сделать на ее основе простые и однозначные выводы (например, поставить точный диагноз какого-либо заболевания).
Возникла индустриальная молекулярная биология, в которой применение компьютерных технологий является необходимым условием и предусматривается уже на стадии планирования эксперимента. Формирование этой области совершенно изменило взгляд на роль вычислительных устройств в биологической науке - то, что раньше было дополнительным, необязательным и вспомогательным фактором, неожиданно стало играть определяющую роль. Таким образом, оказалось, что прогресс биотехнологии нереален без разработки специализированных аппаратных, алгоритмических и программных средств, а соответствующая отрасль кибернетики вошла в состав биоинформатики.
Современная экспериментальная техника позволяет создать анализирующую матрицу (называемую также биочипом) размером несколько сантиметров, при помощи которой можно получить данные о состоянии всех генов организма. Для создания эффективной методики необходимы совместные усилия специалистов в области молекулярной биологии, физики, химии, микроэлектроники, программирования и математики.
История
развития технологии
биочипов относится
к началу девяностых
годов, при этом
российская
наука сыграла
не последнюю
роль. Здесь
уместно пояснить,
что биочипы
по природе
нанесенного
на подложку
материала
делятся на
« олигонуклеотидные»
(см. «КТ» № 370, Рубен
Ениколопов,
«Биочипы»),
когда наносятся
короткие фрагменты
ДНК, обычно
принадлежащие
к одному и тому
же гену, и биочипы
на основе кДНК,
когда робот
наносит длинные
фрагменты генов
(длиной до 1000
нуклеотидов).
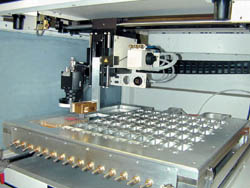
Наиболее популярны в настоящее время биочипы на основе кДНК, ставшие по-настоящему революционной технологией в биомедицине. Остановимся подробнее на их приготовлении, а также на получении и обработке данных с их помощью. Определяющей технологической идеей стало применение стеклянной подложки для нанесения генетического материала, что сделало возможным помещать на нее ничтожно малые его количества и очень точно определять местоположение конкретного вида тестируемой ДНК. Для приготовления биочипов стали использоваться роботы, применяемые прежде в микроэлектронике для создания микросхем (рис. 1). Молекулы ДНК каждого типа создаются в достаточном количестве копий с помощью процесса, называемого амплификацией; этот процесс также может быть автоматизирован, для чего используется специальный робот - умножитель. После этого полученный генетический материал наносится в заданную точку на стекле (на жаргоне такой процесс называется «печать») и химически к стеклу пришивается (иммобилизация). Для иммобилизации генетического материала необходима первичная обработка стекла, а также обработка напечатанного биочипа ультрафиолетом, стимулирующим образование химических связей между стеклом и молекулами ДНК (рис. 2).
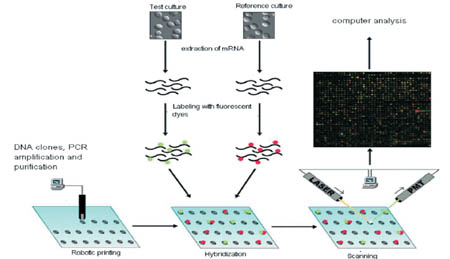
Грубо говоря, из клетки выделяется смесь продуктов работы генов, т. е. РНК различных типов, производимых в определенных условиях. Результатом эксперимента и является знание того, продукты каких именно генов появляются в клетке в условиях, интересующих исследователя. Молекулы каждого типа РНК связываются (в лучшем случае) с единственным типом молекул из иммобилизованных на биочипе. Те молекулы, которые не связались, можно смыть, а для определения того, к каким из иммобилизованных на чипе молекул нашлись «партнеры» в исследуемой клетке, экспериментальная и контрольная РНК метится флуоресцирующими красителями.
Таким
образом, следующим
этапом в получении
результата
на приготовленном
биочипе является
биохимическая
реакция, в процессе
которой один
или несколько
образцов ДНК
или РНК, полученные
из клеток, ткани
или органа,
метятся одним
или н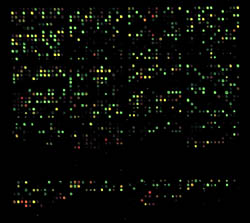 есколькими
флуоресцентными
красителями
и гибридизуются
(связываются)
с материалом,
напечатанным
на биочипе.
После того как флуоресцирующие образцы прореагировали с биочипом, чип сканируют лазером, освещая поочередно точки нанесения ДНК каждого конкретного типа и следя за интенсивностью сигнала флуоресценции (рис. 3).
Изготовление одного биочипа занимает от трех до шести недель, при условии, что в распоряжении исследователя есть генетический материал для нанесения на чип. Сам эксперимент - гибридизация и снятие данных - занимает один-два дня, а при традиционной технологии такая же группа исследователей потратила бы годы на последовательное проведение всех экспериментов, включенных в один биочип.
Сигналы лазерного сканирования должны быть обработаны и проанализированы. Гены на стекле дают сигналы различной интенсивности, кроме того, всегда есть некоторое фоновое излучение от метки, не смывшейся со стекла, которое также неоднородно. Необходимо автоматически выделить из шума сигналы разной интенсивности, несущие различную информацию.
На следующем этапе гены, которые дают в одинаковых условиях одинаковый сигнал, объединяются в группы. Это также делается автоматически, с помощью алгоритмов кластерного анализа. Кластеры генов, ведущих себя схожим образом в разных условиях или в разные моменты времени, служат исходной точкой для заключений биологического характера.
В Советском Союзе была создана замечательная школа по разработке алгоритмов распознавания изображений, в первую очередь для анализа изображений, поступающих с искусственных спутников Земли. Наше математическое образование на протяжении многих десятилетий было одним из лучших в мире, поэтому наши прикладники, инженеры и алгоритмисты всегда легко разрабатывали оригинальные специализированные методы анализа данных. Неудивительно, что выходцы из нашего Отечества трудятся во многих фирмах, работающих на переднем крае возникающей на наших глазах индустрии. Наши бывшие соотечественники являются организаторами одной из наиболее известных фирм, предоставляющих методы обработки, - Informax, акции которой являются ценообразующими во всех биотехнологических биржевых индексах.
Однако создание биохимической технологии, в подавляющей степени, - заслуга американских фирм и научных центров. Mногие фирмы делают на заказ сами биочипы. Самые известные из них - это Affymetrix и Clontech. Incyte - самая мощная на сегодняшний день компания - кроме изготовления биочипа на заказ и продажи генетического материала для печати на чип, сама выполняет и гибридизацию, а заказчику предоставляет только готовые данные. Развитие индустрии зашло настолько далеко, что возник прибыльный рынок приготовления специально обработанных стекол для приготовления биочипов в условиях отдельной молекулярно-биологической лаборатории. К таким фирмам относится, например, Corning.
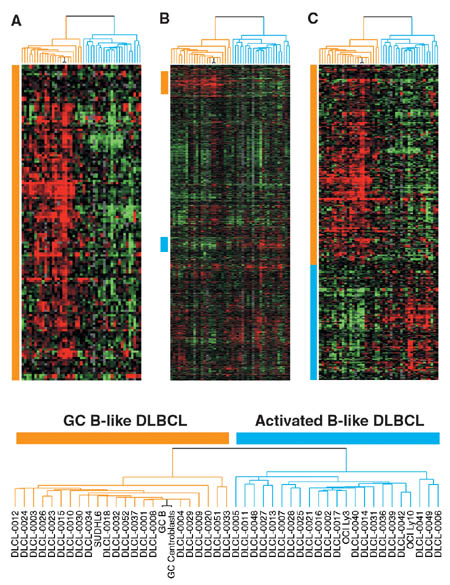
Какие же задачи под силу подобной непростой технологии, имеющей дело с сотнями тысяч генов одновременно? Сразу хотелось бы сделать оговорку, что на сегодняшний момент имеется тенденция перехода от чипов с тысячами генов к чипам с сотнями генов, отобранных специально для решения конкретной задачи. Поясним на примере. Исследователями Массачусетсского технологического института была сделана работа по использованию чипов для диагностики различных подклассов острого лейкоза человека. Точная диагностика двух подтипов острого лейкоза (острый миелоидный и острый лимфобластный) имеет определяющее значение при выборе курса терапии. Первоначально был использован олигонуклеотидный чип из 6000 генов. Используя в качестве пробы РНК из клеток костного мозга, исследователям удалось выделить и подготовить к реальному использованию в качестве подчипа набор из 50 генов, сильное различие по экспрессии которых позволяет однозначно определить тип опухоли 1 (рис. 4). Мы полагаем, что нет нужды доказывать необходимость диагностических чипов, поэтому учитывая небольшое количество аналитических ячеек на чипе, а значит меньшую себестоимость, существует реальная возможность их разработки и производства у нас в стране.
Что же до классической науки, то тут возможности применения чипов безграничны. Группа исследователей из Иллинойского университета под руководством Андрея Гудкова, используя кДНК-чипы, нашла и сравнила спектры генов, отвечающих за реакцию клетки на радиационные воздействия различной природы. Под воздействием радиации, которое клетка воспринимает как стресс, активируются гены, известные как каскад зависимых от р53 генов (р53 - белок, одна из главных функций которого - защищать клетку от любых неблагоприятных воздействий). Многие из этих белков могут рассматриваться как кандидаты на использование в химиотерапии раковых опухолей и для защиты нормальных клеток организма от противоопухолевых агентов, таких как радиационное облучение и химиотерапевтические препараты.
Интересную по практическому приложению работу сделали ученые из лаборатории радиобиологии в Хельсинки. Используя чипы, они попытались выяснить, какие гены меняют свою активность под влиянием радиосигнала с частотой 900 МГц, который дают всеми нами любимые сотовые телефоны. Человеческие клетки из первичного подкожного слоя были выдержаны в культуре под этим сигналом в течение одного часа, после чего РНК из этих клеток и из клеток контрольной серии была пущена в качестве пробы на чип. Гены, активность которых существенным образом изменилась в течение этого эксперимента, относятся к генам стресс-ответа, таким как р53, hsp27, изменение активности которых во многих случаях говорит о том, что клетка или целый организм подвергаются неблагоприятным воздействиям. По-видимому, можно говорить (хотя и очень осторожно) о том, что получены прямые доказательства стрессогенного воздействия электромагнитного поля, а также данные о биохимических основах его биологического действия. Так что не исключено, что люди, меньше говорящие в течение дня по сотовому телефону или использующие специальные наушники, меньше устают в конце рабочего дня.
Судя по всему, мы присутствуем при возникновении нового метода получения и использования информации о живой природе. Данные будут собираться автоматически и на промышленной основе. Планирование и подготовка таких экспериментов, вероятно, со временем также будет осуществляться автоматически. В пользу этого свидетельствует опыт развития компьютерных технологий, где создание микропроцессора автоматизировано в значительной степени уже на ранних стадиях проектирования, все же дальнейшие стадии разработки и внедрения в производство во всё большей степени происходят практически без участия, да и без контроля человека. На «входе» будет ставиться задача крайне общего вида, например: найти три характерных гена, отвечающие за реакцию клетки на такие-то нестандартные внешние условия, и не работающие ни в каких нормальных условиях. Автоматическая система будет сама осуществлять подбор биологического материала, подготовку, постановку и интерпретацию биологического эксперимента, а также формулировку наиболее вероятного решения поставленной задачи. На долю исследователя останется только тестирование полученных результатов и выработка инструкций для применения полученного нового знания в медицине или биотехнологии.
Более того, изменится, вероятно, сама идея биологического эксперимента. Поскольку заключение о работе той или иной живой системы будет выноситься с помощью компьютерного анализа данных, биологический эксперимент будет часто ставиться не с целью непосредственной проверки той или иной идеи, как сейчас, но с целью расшивки «узких мест» в работе автоматизированной системы хранения и обработки информации. Что-то подобное мы уже наблюдаем в физике высоких энергий, где эксперименты на ускорителях ставятся с учетом существующих приближенных методов вычислений в физических теориях, с целью более точного определения оценочных параметров, в наибольшей степени влияющих на точность вычисляемых физических величин.
Хотелось бы надеяться, что в российских условиях можно будет включиться в серьезную работу по созданию программного обеспечения индустриальной биомедицины. Работа в этой области не требует больших затрат, характерных для биологических исследований (на оборудование, реактивы и т. д.) Дорогие суперкомпьютеры тоже в общем-то не необходимы - в большинстве научно-исследовательских центров в США используются кластеры ПК. Необходимы изобретательность, упорство и фантазия, а также хорошее владение современными математическими методами статистического анализа, что всегда составляло наши сильные стороны.
По-видимому, единственной организацией в России, серьезно занимающейся технологией биочипов, является Институт молекулярной биологии РАН им. В. А. Энгельгардта. В этом институте создаются также микрочипы с ячейками, содержащими различные зонды для проведения химических и ферментативных реакций с анализируемыми образцами (см. «Инфобизнес», №151 - Л. Л.-М.).
Разработка технологии биологических микрочипов начата в ИМБ РАН в 1989 году и с тех пор продолжается усиленными темпами, в последние годы в сотрудничестве с США. ИМБ РАН принадлежит 15 международных и множество российских патентов. Более подробно с исследованиями, проводимыми в ИМБ РАН, можно ознакомиться на сайте biochip/.