Организация и содержание элективного курса "Основы теории вероятностей и математической статистики" в классах оборонно-спортивного профиля
Для введения
формулы Бейеса
составим задачу.
Пусть дано
событие А, оно
может наступить
при появлении
одного из
несовместных
Событий В1,
В2, …, Вn,
которые образуют
полную группу.
Так, как нам
заранее не
известно, какое
событие наступит,
их называют
гипотезами.
Допустим, что
произведено
испытание в
результате,
которого появилось
событие А.
Поставим своей
задачей определить,
как изменились
вероятности
гипотез, в связи
с тем, что событие
А уже наступило.
Другими словами
определим
следующие
условные вероятности:
 ,
 ,
…,
 .
Определить данные вероятности можно при помощи формулы Бейеса:
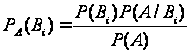 .
Заменив
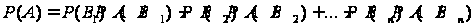 ,
получим:
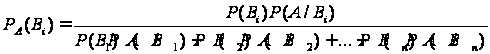 .
Прибор состоит из двух узлов; работа каждого узла необходима для работы прибора в целом. Надежность (вероятность безотказной работы) в течении времени t первого узла равна p1, второго р2. Прибор испытывался в течении времени t, в результате чего обнаружено, что он отказал. Найдите вероятность того, что отказал первый узел, а второй исправен.
Решение. Пусть
событие В –
прибор отказал,
событие А1
– оба узла
исправны, А2
– первый узел
отказал, а второй
испарвен, А3
– первый узел
исправен, а
второй узел
отказал, А4
– оба узла отказали.
Эти события
образуют полную
группу событий.
Найдем их
вероятности:
Р(А1)=р1
р2; Р(А2)=(1-р1)р2;
Р(А3)=р1(1-р2);Р(А4)=(1-р1)(1-р2).
Так как наблюдалось
событие В, то
 ,
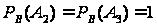 .
Применяя формулу
Бейеса получим:
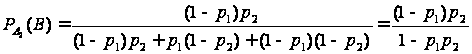 .
Изучение случайных величин требует связи этих величин с определенными событиями, которые заключаются в попадании случайной величины в некоторый интервал и для которых определены вероятности. Другими словами необходимо связать случайную величину с полем данного испытания.
Для лучшего понимания, учителю следует привести пример.
При бросании кости могли появиться цифры 1, 2, 3, 4, 5, 6. Наперед определить число выпавших очков невозможно, так как это зависит от многих случайных величин, которые полностью не могут быть учтены. В этом смысле число очков есть величина случайная; и числа 1, 2, 3, 4, 5, 6 – есть возможные значения этой величины.
Случайной называют величину, которая в результате испытания примет одно и только одно возможное значение, наперед неизвестное и зависящее от случайных причин, которые заранее не могут быть учтены.
Будем обозначать случайные величины прописными (заглавными) буквами: X, Y, Z, а их возможные значения соответствующими строчными буквами x, y, z. Если величина Х имеет три значения то они будут обозначены так: х1, х2, х3 .
Обычно рассматриваются два типа случайных величин: дискретные и непрерывные. Рассмотрим следующий пример.
Число мальчиков пошедших в секцию бальных танцев среди 100 пришедших туда людей есть случайная величина, которая может принимать следующие значения 0, 1, 2, …, 100. Эти значения отделены друг от друга промежутками, в которых нет возможных значений Х.
Таким образом, в этом примере случайная величина принимает отдельные изолированные значения. Приведем второй пример.
Расстояние, которое пролетит диск при метании, есть величина случайная. Действительно величина зависит от многих факторов, например от ветра, температуры и других факторов, которые не могут быть полностью учтены. Возможные значения этой величины принадлежат некоторому промежутку (а; b).
В данном примере случайная величина может принять любое из значений промежутка (а; b). Здесь нельзя отделить одно возможное значение от другого промежутком, не содержащим возможных значений случайной величины.
Уже из сказанного можно заключить о том, что целесообразно будет различать случайные величины, принимающие лишь отдельные изолированные значения, и случайные величины, возможные значения которых сплошь заполняют некоторый промежуток. Далее следует дать четкое определение дискретной и непрерывной случайной величины.
Дискретной (прерывной) называют случайную величину, которая принимает отдельные, изолированные возможные значения с определенными вероятностями. Число возможных значений дискретной случайной величины может быть конечным или бесконечным.
Непрерывной называют случайную величину, которая может принимать все значения из некоторого конечного или бесконечного промежутка. Очевидно, число возможных значений непрерывной случайной величины бесконечно.
Примерами непрерывных случайных величин могут быть спортивный результат в беге или прыжках, рост и масса тела человека, сила мышц и другие.
Для задания дискретной случайной величины не достаточно перечислить все возможные ее значения, нужно еще указать их вероятности.
Законом распределения дискретной случайной величины называют соответствие между возможными значениями и их вероятностями; его можно задать таблично, в виде формулы и графически.
При табличном задании первая строка содержит возможные значения, а вторая – их вероятности:
| Х | х1 | х2 | … | хn |
| p | p1 | p2 | … | p2 |
Сумма вероятностей
второй строки
таблицы равна
единице:
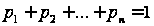 .Если
множество
возможных
значений Х
бесконечно,
то ряд
 сходится и его
сумма равна
единице.
Для закрепления следует решить задачу.
В денежной лотерее выпущено 100 билетов. Разыгрывается один выигрыш в 50 р. и десять выигрышей по 1 р. Найти закон распределения случайной величины Х – стоимости возможного выигрыша для владельца лотерейного билета.
Решение. Напишем возможные значения Х: х1=50; х2=1; х3=0. Вероятности этих возможных значений равны: р1=0,01; р2= 0,1; р3=1-(0,01+0,1)=0,89.
Напишем исходный закон распределения:
| Х | 50 | 10 | 0 |
| p | 0,01 | 0,1 | 0,89 |
Контроль: 0,01+0,1+0,89=1
Для наглядности закон распределения дискретной случайной величины можно изобразить и графически, для чего в прямоугольной системе координат строят точки (хi; pi), а затем соединяют их отрезками прямых. Полученную фигуру называют многоугольником распределения. Также следует привести пример построения такого многоугольника.
Как мы ранее сказали, закон распределения полностью характеризует случайную величину. Однако часто закон распределения неизвестен, и приходится ограничиваться меньшими сведениями. Также для решения многих задач не нужно знать распределения случайной величины, а достаточно знать лишь некоторые обобщающие числовые характеристики этого распределения.
Одной из таких характеристик является математическое ожидание. Для более наглядного определения рассмотрим подход к этому понятию на конкретном примере.
Пусть имеется
дискретная
случайная
величина Х,
которая может
принимать
значения x1,
x2, …, xn.
Вероятности
которых соответственно
равны р1,
р2, …, рn.
Тогда математическое
ожидание М(Х)
случайной
величины Х
определяется
равенством:
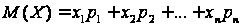 .
После определения математического ожидания ученикам может быть непонятно, где оно может пригодиться. На самом деле математическое ожидание приближенно равно (тем точнее, чем больше число испытаний) среднему арифметическому наблюдаемых значений случайной величины.
Для введения дисперсии можно привести следующий пример. На практике часто требуется оценить рассеяние возможных значений случайно величины вокруг ее среднего значения. Например, в артиллерии важно знать, насколько кучно лягут снаряды вблизи цели, которая должна быть поражена. Именно такие задачи решает дисперсия.
Дисперсией случайной величины Х называется математическое ожидание квадрата отклонений случайной величины от ее математического ожидания. Дисперсия обозначается, как D(x): D(Х)=M[X-М(Х)]2.
Для вычисления дисперсии часто бывает удобно пользоваться следующей формулой: дисперсия равна разности между математическим ожиданием квадрата случайной величины Х и квадратом ее математического ожидания
D(Х)=M(X)2-[М(Х)]2.
Для оценки рассеяния всевозможных значений случайной величины вокруг ее среднего значения кроме дисперсии служат и другие величины.
Средним
квадратичным
отклонением
величины Х
называют квадратный
корень из дисперсии
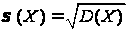 .
Найти дисперсию случайной величины Х, которая задана следующим законом распределения:
| Х | 1 | 2 | 5 |
| p | 0,3 | 0,5 | 0,2 |
Решение.
Найдем математическое
ожидание:
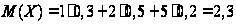 .
Найдем всевозможные
значения квадрата
отклонения:
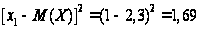 ,
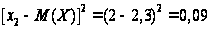 ,
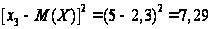 .
Напишем закон квадрата отклонения:
| [Х-М(Х)]2 | 1,69 | 0,09 | 7,29 |
| p | 0,3 | 0,5 | 0,2 |
По определению
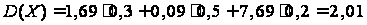 .
Используя
формулу D(Х)=M(X)2-[М(Х)]2
можно найти
дисперсию
гораздо быстрее:
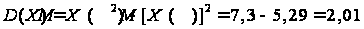 .
Далее следует продолжить изучать статистику. Математическая статистика – это раздел математики, в котором изучаются методы сбора, систематизации и обработки результатов наблюдений массовых случайных явлений для выявления существующих закономерностей [21]. Необходимо основательно остановиться на изучении статистических характеристик и их практического применения. Рассмотреть понятия, составляющие суть выборочного метода в статистике (выборка, варианта и пр.). Также следует рассмотреть способы их графического представления.
В практике статистических наблюдений различают два вида наблюдений:
сплошное (изучаются все объекты);
выборочное (не сплошное, когда изучается часть объектов).
Примером сплошного наблюдения является перепись населения, охватывающее все население страны. Выборочными наблюдениями является, например, проводимые социологические исследования, охватывающие часть населения страны, области, района и т.д.
Вся подлежащая изучению совокупность объектов называется генеральной совокупностью. Часть объектов, которая отобрана для непосредственного изучения из генеральной совокупности, называется выборочной совокупностью или выборкой.
Числа объектов в генеральной или выборочной совокупности называют их объемами. Генеральная совокупность может иметь конечный и бесконечный объем.
Сущность выборочного метода состоит в том, чтобы по некоторой части генеральной совокупности (по выборке) выносить суждение о ее свойствах в целом. Обычно ограничиваются 5-10% всей изучаемой совокупности.
Так как в дальнейшем мы будем рассматривать выборочный метод, поэтому целесообразно выделить преимущества выборочного метода:
экономия затраты ресурсов;
единственно возможный в случае бесконечной генеральной совокупности или в случае, когда исследовании связано с уничтожением наблюдаемых объектов (например, исследование долговечности электрических лампочек и т.д.);
возможность углубленного исследования за счет расширения программы исследования при тех же затратах;
снижение ошибок регистрации;
неизбежные ошибки, возникающие в связи с изучением части объектов, могут быть заранее оценены и посредством правильной организации выборки сведены к незначимым величинам.
Между тем, использование сплошного наблюдения часто приводит к снижению точности наблюдения, а это у же вызывает неустранимые ошибки, и может привести к снижению точности сплошного наблюдения по сравнению с выборочным. Чтобы по данным выборки иметь возможность судить о генеральной совокупности, она должна быть отобрана случайно. На практике отбор может выполняться с помощью жеребьевки (лотереи) или с помощью случайных чисел.
Основной недостаток выборочного метода – ошибки исследования, называемые ошибками репрезентативности.
Выборка называется репрезентативной (представительной), если она достаточно хорошо воспроизводит генеральную совокупность. Виды выборок:
случайная выборка (случайный выбор элементов без расчленения на части или группы);
механическая выборка (элементы отбираются через определенный интервал);
типическая выборка (выбор случайным образом элементов из типических групп, на которые по некоторому признаку разбивается генеральная совокупность);
серийная выборка (случайным образом отбираются целые группы совокупности, а сами серии подвергаются сплошному наблюдению).
Способы образования выборки:
повторный выбор – каждый элемент, случайно отобранный и обследованный, возвращается в общую совокупность и может быть повторно отобран.
бесповторный отбор – когда обратный элемент не возвращается в общую совокупность.
Затем учащимся можно дать таблицу с основными характеристиками генеральной совокупности и выборки.
| Наименование характеристики | Генеральная совокупность | Выборка |
| Математическое ожидание |
|
|
| Дисперсия |
|
|
| Доля |
|
|
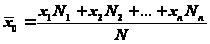
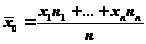
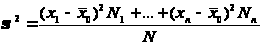
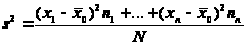


Здесь хi – значение признака; N и n – объемы генеральной и выборочной совокупностей; Ni и ni – число элементов генеральной и выборочной совокупностей со значением признака хi; M и m – число элементов генеральной и выборочной совокупностей, обладающих данным признаком.
На несложном примере покажем, как вычисляются введенные характеристики.
Генеральная совокупность задана таблицей распределения:
| Xi | 2 | 4 | 5 | 6 |
| Ni | 8 | 9 | 10 | 3 |
Найти дисперсию.
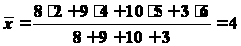
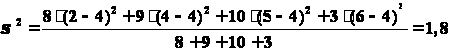
Важнейшей задачей выборочного метода является оценка параметров генеральной совокупности по данным выборки.
Далее введем понятие вариационного ряда. Для начала рассмотрим пример.
Необходимо изучить изменение результатов спортсменов, занимающихся легкой атлетикой, по сравнению с предыдущим годом. Получены следующие данные результатов в процентах к предыдущему году: 97,8; 97,10; 101,17;…;142,3;141,02.(всего 100 значений.).
Различные значения признака (случайной величины Х) называется вариантами (обозначаем их через х).
Первый шаг к осмыслению – упорядочивание. Расположение вариантов в порядке возрастания (убывания), т.е. ранжирование вариантов ряда.
Следующим
шагом произведем
группировку,
то есть разобьем
на отдельные
интервалы.
Число интервалов
не следует
брать большим.
Числа показывающие,
сколько раз
встречаются
варианты из
данного интервала,
называются
частотами (ni),
а отношение
их к общему
числу наблюдений
частостями
 .
Частоты и частости
называют весами.
Составим таблицу.
| Д | Результаты в процентах к предыдущему году х | Частота (количество спортсменов) ni |
Частость
(доля рабочих)
|
Накопленная частота niнак |
Накопленная
частость
|
| 1 | 94,0-100 | 3 | 0,03 | 3 | 0,03 |
| 2 | 100,0-106,0 | 7 | 0,07 | 10 | 0,10 |
| 3 | 106,0-112,0 | 11 | 0,11 | 21 | 0,21 |
| … | … | … | … | … | … |
| 8 | 136,0-142,0 | 2 | 0,02 | 100 | 1,00 |
| 100 | 1,00 |
Вариационным
рядом называется
ранжированный
в порядке возрастания
или убывания
ряд вариантов
с соответствующими
им весами (частотами
или частостями).
Накопленная
частота niнак
показывает,
сколько наблюдалось
вариантов со
значениями
признака меньших
х. Накопленная
частость –
отношение
накопленной
частоты к общему
числу наблюдений:
 .
Теперь полученный вариационный ряд позволяет выявить закономерности.
Для задания вариационного ряда достаточно указать варианты и соответствующие им частоты или частости.
Аналогично с определением дискретной и непрерывной случайной величины, мы даем определение дискретного и непрерывного вариационного ряда.
Вариационный ряд называется дискретным, если любые его варианты отличаются на постоянную величину. Вариационный ряд называется непрерывным, если варианты могут отличаться один от другого на сколь угодно малую величину.
В примере мы привели непрерывный ряд.
Для графического изображения вариационного ряда используются:
полигон – служит для изображения дискретного вариационного ряда и представляет собой ломаную, в которой концы отрезков имеют (хi, ni);
гистограмма служит для изображения интервальных вариационных рядов и представляет собой ступенчатую фигуру из прямоугольников с основаниями, равными интервалам значений признака к=х2-х1. И высоты равные частотам. Если соединить середины верхних оснований прямоугольников отрезками прямой, то можно получить полигон того же распределения;
кумулятивная прямая (кумулята) – кривая накопленных частот. Для дискретных рядов кумулята представляет ломаную, соединяющую точки (хi, niнак ) или (хi, wiнак). Для интервального вариационного ряда ломаная начинается с точки, абсцисса, которой равна началу первого интервала, а ордината – накопленной частоте, равной нулю. Другие точки соответствуют концам интервалов.
Теперь переходим еще к одной важной теме – проверка статистических гипотез. Сформулируем принцип практической уверенности. Если вероятность события А в данном испытании очень мала, то при однократном выполнении испытания можно быть уверенным в том, что событие А не произойдет, и в практической деятельности вести себя так, как будто событие А вообще невозможно.
Отправляясь самолетом в другой город, мы не рассчитываем на возможность погибнуть в авиа катастрофе, хотя вероятность такого события имеется.
При многократном повторении испытаний мы не можем считать маловероятное событие А практически невозможным.
Статистической гипотезой называется любое предположение о виде или параметрах неизвестного закона распределения.
Проверяемую гипотезу обычно называют нулевой и обозначают Н0. Также рассматривают альтернативную (конкурирующую гипотезу) Н1, являющуюся отрицанием Н0.
Суть проверки статистической гипотезы состоит в вычислении статистики данной выборки. Затем по выборочному распределению определятся критическое значение. Если статистика больше критического значения, то событие можно считать практически невозможным.
Сравнение двух совокупностей имеет важное практическое значение. На практике часто встречается случай, когда средний результат одной серии эксперимента отличается от среднего результата другой серии.
В промышленности данная задача возникает при выборочном контроле качества изделий, изготовленных на разных установках или при различных технологических режимах.
Рассмотрим, как проверятся гипотеза.
Пусть имеются две совокупности, характеризуемые генеральными средними х и у. И дисперсиями. Для которых найдены средние арифметические и выборочные дисперсии. Необходимо проверить гипотезу Н0 о равенстве генеральных средних. Тогда статистика находится по следующей формуле:
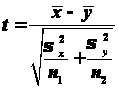
Если t>tкр то гипотеза Н0 отвергается. Если нет, то делается вывод, что нулевая гипотеза не противоречит имеющимся наблюдениям.
Еще одной важной темой для формирования профессионально значимых навыков у учащихся является корреляционный анализ.
Корреляционной зависимостью между двумя переменными величинами называется функциональная зависимость между значениями одной из них и условным математическим ожиданием другой.
Корреляционная
зависимость
может быть
представлена
в виде
 .
Это уравнение называют уравнением регрессии, а их графики линиями регрессии. Для отыскания уравнений регрессий необходимо знать закон распределения двумерной случайной величины.
Данные о статистической зависимости удобно задавать в виде корреляционной таблицы.
|
Вес (кг) (Х) |
Середины интервалов |
Рост (см) (у) | |||||
| 155-160 | 160-165 | 165-170 | 170-175 |
Всего (ni) |
Групповая Средняя
|
||
| Хi yj | 157,5 | 162,5 | 167,5 | 172,5 | |||
| 40-45 | 42,5 | 2 | 1 | 7 | 10 | 168,5 | |
| 45-50 | 47,5 | 3 | 6 | 4 | 6 | 19 | 165,9 |
| 50-55 | 52,5 | 3 | 11 | 1 | 15 | 166,8 | |
| 60-65 | 62,5 | 2 | 1 | 2 | 5 | 162,5 | |
| 70-75 | 72,5 | 1 | 1 | 172,5 | |||
| Всего nj | 7 | 11 | 17 | 15 | 50 | ||
|
Групповая средняя
|
50,4 | 49,8 | 52,5 | 47,2 | |||


Вычисленные групповые средние изобразим графически в виде ломанной, называемой эмпирической линией регрессии.
По виду ломанной
можно предположить
наличие линейной
функциональной
зависимости
между случайными
величинами
Х и Y, то
есть имеется
функция y=kx+b, где
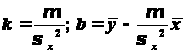 .
Здесь
 выборочная
ковариация
и равна
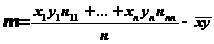 .
Вычислим для данной таблицы основные характеристики и найдем уравнение линии регрессии.
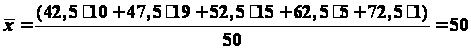 ,
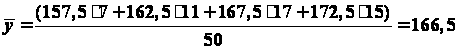 ,
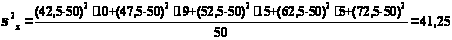 ,
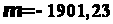 ,
k = – 46,09, b
= 2471,02.
Тогда уравнение линии регрессии запишется как: y = – 46,09 х + 2471,02.
Если