Разработка и исследование имитационной модели разветвленной СМО (системы массового обслуживания) в среде VB5
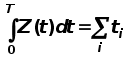 , (8)
где сумма распространяется на все заявки, пришедшие за время Т.
Разделим правую и левую часть (8) на длину интервала Т. Получим, с учетом (7):
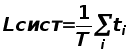 (9)
Разделим и умножим правую часть (9) на интенсивность l:
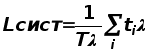 (10)
Величина Tl — это среднее число заявок, пришедших за время Т. Если мы разделим сумму всех времен ti на среднее число заявок, то получим среднее время пребывания заявки в системе Wсист- Итак,
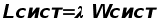 (11)
Это и есть формула Литтла: для любой СМО, при любом характере потока заявок, при любом распределении времени обслуживания, при любой дисциплине обслуживания среднее время пребывания заявки в системе равно среднему числу заявок в системе, деленному на интенсивность потока заявок.
Точно таким же образом выводится вторая формула Литтла, связывающая среднее время пребывания заявки в очереди Wоч и среднее число заявок в очереди Lоч.
Lоч = l Wоч
2.3 Варианты систем массового обслуживания
n-канальная СМО с отказами
A — абсолютная пропускная способность (среднее число заявок, обслуживаемых в единицу времени);
Q — относительная пропускная способность (средняя доля пришедших заявок, обслуживаемых системой);
Pотк — вероятность того, что заявка покинет СМО необслуженной;
 — среднее
число занятых
каналов;
 ;
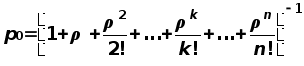 ;
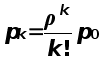 ;
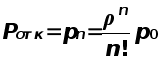 ;
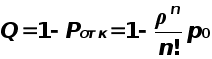 ;
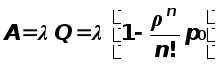 ;
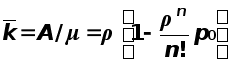
2. Одноканальная СМО с неограниченной очередью
Pзан — вероятность того, что канал занят; Lоб — среднее число заявок под обслуживанием
 ;
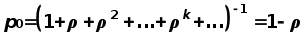 ;
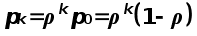 ;
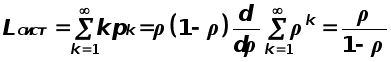 ;
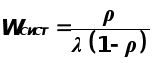 ;
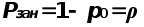 ;
 ;
 Lоч
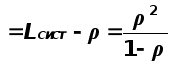 ;
Wоч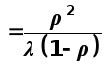
3. Одноканальная СМО с неограниченной очередью, простейшим потоком заявок и произвольным распределением времени обслуживания
На
одноканальную
СМО поступает
простейший
поток заявок
с интенсивностью
l.
Время обслуживания
имеет произвольное
распределение
с математическим
ожиданием
 и коэффициентом
вариации nm.
nm
— отношение
среднего
квадратического
отклонения
времени обслуживания
к его математическому
ожиданию.
Формулы Полячека — Хинчина:
Lоч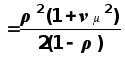 ; Lсист
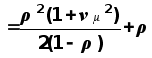
Далее, согласно формуле Литтла:
Wоч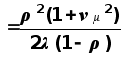 ; Wсист
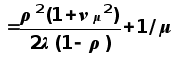
4. Одноканальная СМО с произвольным потоком заявок и произвольным распределением времени обслуживания
Рассматривается
одноканальная
СМО с неограниченной
очередью, на
которую поступает
произвольный
поток заявок
с интенсивностью
l
и коэффициентом
вариации nl,
0 < nl
и коэффициентом
вариации nm,
0 < nm
< 1. Для этого
случая точных
аналитических
формул получить
не удается;
можно только
приближенно
оценить среднюю
длину очереди,
ограничить
ее сверху и
снизу.
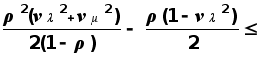 Lоч

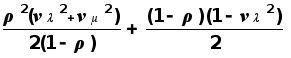
Если входящий поток — простейший, то обе оценки — верхняя и нижняя — совпадают, и получается формула Полячека — Хинчина. Для грубо приближенной оценки средней длины очереди М. А. Файнбергом получена формула:
Lоч

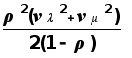 Lсист
= Lоч
+ r
Средние времена пребывания заявки в очереди и в системе вычисляются через Lоч и Lсист по формуле Литтла делением на l
2.4 Математическое описание разрабатываемой модели.
На
вход системы
из N станций
поступает поток
заявок с заданными
(экспоненциальным
или нормальным)
законом распределения
времени прихода,
интенсивностью
входного потока
l
и, при нормальном
распределении,
коэффициентом
вариации nl.
Каждая станция
рассматривается,
как одноканальная
СМО с неограниченной
очередью. На
каждой станции
задано среднее
время обслуживания
и, при нормальном
распределении,
коэффициент
вариации nm.
На выходе станций
поток заявок
может ветвиться,
также может
происходить
отбраковка
заявок. Это
изменяет
интенсивность
входного потока
на последующих
станциях.
При имитационном моделировании поэтапно имитируется (с использованием генератора случайных чисел) весь описанный процесс: моделируются входной поток и потоки обслуживаний, имитируются процессы ветвления и объединения потоков, а также процесс отбраковки заявок.
Расчетно-формульная
модель такой
системы может
рассматриваться
только в случае,
когда существуют
финальные
вероятности.
Для таких СМО
финальные
вероятности
существуют
только тогда,
когда станции
не перегружены,
т. е для всех
станций выполняется
условие ()
Глава 3
Создание программы
3.1 Структура программы
Выделим основные составные части проекта: Form1 («Задание связей между рабочими станциями») — форма для создания связей между станциями, FormTabl («Создание матрицы связей») — форма для задания коэффициентов связей, FormMultiMass («Модель многофазной многопоточной системы обслуживания») — форма для ввода входных параметров, FormRes («Результаты моделирования многофазной системы обслуживания») — форма для вывода результатов моделирования, ModStation1 — основной вычислительный модуль.
На Form1 помещены следующие компоненты: Frame — для разделения формы на несколько областей, Line и Shape — для графического отображения связей между станциями, CommandButton — для обозначения станций, реализации процедуры задания связей между станциями и перехода к другим формам.
На FormTabl помещены компоненты: Label — для обозначения названий строк и столбцов матрицы связей, TextBox — для обозначения матрицы связей и ввода коэффициентов, CommandButton — для запуска проверки правильности задания коэффициентов связей и перехода к другим формам.
На FormMultiMass помещены компоненты: Frame — для разделения формы на несколько областей, TextBox — для ввода параметров, Label — для обозначения названия вводимого параметра, OptionButton — для организации выбора типа распределения, ProgressBar — для обозначения прохождения процесса моделирования, CommandButton — для начала ввода параметров, запуска процесса моделирования, перехода к другим формам и выхода из программы.
На FormRes помещены компоненты: SSTab — для разделения формы на две страницы (графиков и числовых результатов), Frame — для разделения страницы числовых результатов на несколько областей, Label — обозначения названия выводимого показателя, PictureBox — для вывода графических результатов моделирования, TextBox — для вывода числовых результатов моделирования, CommandButton — для возвращения к формам, используемым для ввода входных параметров.
3.2 Алгоритм работы программы
Рассмотрим обобщенный алгоритм работы программы, представленный укрупненными блоками, затем более детально рассмотрим реализацию каждого из блоков и приведем описание используемых переменных и функций.
Обобщенный алгоритм работы программы показан на рис. 2:
Начало



 Ввод
исходных
данных


Н Ввод Д



 корректен?




 Создание
массива переходов
Н Расчет по

 формулам?


 Переход к первой
станции Д


 Создание
входного массива
на текущей
станции
Расчет по имита- Расчет по
ционной модели формулам

 Нужна
Д

 сортировка?


 Сортировка
Вывод рассчитанных
 Н показателей


 Создание
выходного
массива на
текущей станции

 Н Продолжать
работу?


 Н Последняя
Конец
 станция?
 Переход к
Д
 следующей
Д
 станции рис.
2
Программу можно поделить на две части: имитационная модель системы и расчетно-формульная модель. Для начала функционирования любой модели необходимо задать ряд входных параметров. Пользователь должен выбрать тип распределения времени прихода заявок на первую станцию (экспоненциальное — DistIndex = 0 или нормальное — DistIndex = 1) и тип распределения времени обслуживания заявок по станциям (экспоненциальное — DistIndex1 = 0 или нормальное — DistIndex1 = 1). Выбор осуществляется с помощью связанных пар компонентов OptionButton. Также пользователь задает количество рабочих станций — m (m = 1 — 10), число заявок на входе — n, среднее время между заявками во входном потоке — Ta и, при нормальном распределении на входе, стандартное отклонение (в % от среднего) — DTa (перечисленные параметры вводятся с помощью компонентов TextBox). Затем, при помощи компонентов CommandButton на форме «Задание связей между рабочими станциями», задаются связи между станциями, каждая из которых обозначаются линией, соединяющей две станции с кружком на том конце, куда связь приходит, далее, с помощью матрицы связей на форме «Создание матрицы связей», задаются весовые коэффициенты связей — pi(i). Матрица составлена из компонентов TextBox. Далее, для каждой станции, также при помощи компонентов TextBox, задается среднее время обслуживания — Ts(k), вероятность снятия заявки на выходе i-ой станции — Pr(k) и, при нормальном распределении времени обслуживания, стандартное отклонение (в % от среднего) — DTs(k).
После ввода весовых коэффициентов связей предусмотрена процедура проверки на корректность ввода. В случае некорректного задания коэффициентов, пользователю выдается сообщение об этом — MsgBox, и строка матрицы связей, в которой были заданы некорректные значения, очистится. Корректность проверяется через суммарные коэффициенты перехода: суммарный коэффициент перехода в конце каждой строки должен равняться единице. Так как коэффициенты определены типом Single, то для избежания ошибок, которые могут возникнуть в результате погрешности вычислений, производимых с переменными этого типа, проверка на равенство 1 заменяется проверкой на принадлежность интервалу (0.9999; 1.0001).
Далее, рассмотрим отдельно структуру каждой части.
3.3 Расчетно-формульная модель.
При расчете показателей по формулам, после задания пользователем всех необходимых входных параметров, производится расчет выходных параметров. Вначале рассчитываются доля заявок (от исходного количества заявок, пришедшего на первую станцию), пришедшая на последующие станции — kz(k) и среднее время между заявками на входе каждой станции (величина, обратная интенсивности входного потока) — kf(k).
Далее, происходит расчет показателей по формулам, соответствующим типам распределения входного потока и потоков обслуживания, и вывод результатов расчета (см. главу 2).
3.4 Имитационная модель
При расчете показателей с помощью имитационного моделирования вначале создается двумерный массив переходов — a1(i, k), где k — номер станции, а i — номер заявки. При создании данного массива с использованием случайных чисел, имитируются процесс прохождения заявок по станциям (на основании заданных коэффициентов переходов) и процесс отбраковки заявок (на основании заданных вероятностей снятия заявок на выходе станций). Если заявка пришла на станцию, то массиву в этой позиции присваивается значение 1; если же заявка не пришла на станцию, то массиву в данной позиции присваивается нулевое значение. Одновременно с созданием массива переходов производится расчет количества снятых заявок по станциям — NumRef(k).
Далее, для каждой станции формируется входной массив (времен прихода заявок на станцию) — a2(i, k) и выходной массив (времен выхода заявок со станции) — a3(i, k), где k — номер станции, а i — номер заявки. Входной массив первой станции образуется с использованием вспомогательной функции Rexp(T As Single) — для экспоненциального распределения (или функции Rnorm(MT As Single, DT As Single) — для нормального распределения). Выходной массив первой станции образуется из входного массива, с использованием тех же функций и функции Gener(nst As Integer). Входные массивы последующих станций образуются в соответствии с массивом переходов из выходных массивов предыдущих станций. В случае, когда заявки попадают на вход данной станции с нескольких станций (sort > 1), производится сортировка времен прихода заявок по возрастанию, с использованием вспомогательной функции Sort1(nst As Integer). После создания входного массива, на каждой последующей станции, создается выходной массив, с использованием входного массива и вспомогательных функций: Gener(nst As Integer), Rexp(T As Single) и Rnorm(MT As Single, DT As Single).
Функции Rnorm(MT As Single, DT As Single) и Rexp(T As Single) преобразуют случайную величину X, равномерно распределенную на интервале (0;1) — Rnd, в случайную величину Y, распределенную, соответственно, по нормальному или экспоненциальному закону и предназначены для генерации нормального и экспоненциального распределения с заданными параметрами.
Функция
Sort1(nst As Integer)
— реализует
алгоритм
пирамидальной
сортировки.
Этот алгоритм
требует
 операций. В
нашем случае,
сортируются
не элементы,
а индексный
массив, причем
таким образом,
чтобы нулевые
элементы исключались
из сортировки
(см. рис. 3).
Начало
 l1 = nr(nst)/2 + 1
 t1=nr(nst)

Н Н



