Построение выборки в социологическом исследовании
Результатом приписывания веса каждому наблюдению является увеличение точности оценок для исследуемых параметров. Вес каждой единицы (респондента) в k-й страте равен отношению числа таких элементов в генеральной совокупности к объему выборки для k-й страты, т.е.:

При расчете среднего или других параметров каждое наблюдавшееся значение просто умножается на весовой коэффициент «своей» страты.
В частности, среднее значение какого-то параметра совокупности (например, средний доход или среднее количество хронических заболеваний) будет равняться просто взвешенной сумме средних значений для отдельных страт:
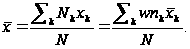
Формула расчета стандартной ошибки для стратифицированной выборки также включает в себя весовые коэффициенты, w:
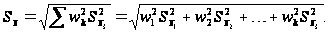
Стандартные компьютерные программы, используемые при статистическом анализе данных, всегда содержат элементарные процедуры взвешивания.
Вернемся к нашему примеру с непропорциональным стратифицированным отбoром русского и украинского населения. Предположим, мы выяснили, что в среднем каждая украинская семья заготавливает на зиму 50 кг варенья, тогда как среднее значение для русской страты составило 40 кг.
Для украинской страты весовой коэффициент составит:
wукр. = 10000 : 400 = 25.
Соответственно для русского населения:
wрусск. = 80000 : 400 = 200.
С учетом этих весовых коэффициентов уточненная оценка среднего запаса варенья в выборке составит:
х = 25 • 50 • 400 + 200 • 40 • 400 /100000 = 37 кг.
Если бы мы не учли в своих расчетах сверхпредставительность украинцев в нашей непропорциональной стратифицированной выборке, то оценка среднего запаса варенья для всей совокупности оказалась бы завышенной (45 кг).
Четвертый тип вероятностной выборки, используемой социологами, — это кластерная выборка. «Кластеры» (дословно с англ. — гроздья) — это естественные группировки единиц наблюдения. Например, популяция избирателей имеет тенденцию жить в городах и деревнях, генеральная совокупность военнослужащих естественным образом группируется по воинским частям и подразделениям, а совокупность студентов — по университетам, институтам и колледжам. Способность к образованию локальных группировок, которую обнаруживают генеральные совокупности, изучаемые социологами, при соблюдении ряда условий позволяет уменьшить расходы на получение единицы информации.
Цель использования кластерной выборки таким образом заключается в повышении эффективности затрат на проведение исследования. При фиксированном бюджете и объеме выборки социолог получает возможность снизить общие расходы на проведение личных интервью преимущественно за счет уменьшения транспортных расходов.
В общем случае кластерная выборка основана на первоначальном отборе группировок (кластеров) и затем — на изучении всех единиц внутри кластеров. Возможными примерами кластеров, используемых в больших общенациональных опросах, являются сельские районы, городские квартиры, избирательные участки. При изучении специфических популяций используются иные кластеры: больницы — при изучении пациентов, школы — при изучении школьников и т. п.
Корректное применение кластерной процедуры основано на неукоснительном соблюдении четырех необходимых условий:
1) кластеры должны быть однозначно и явно заданы: каждый член генеральной совокупности должен принадлежать к одному (и только одному) кластеру;
2) число членов генеральной совокупности, входящих в каждый кластер, должно быть известно или поддаваться оценке с приемлемой степенью точности;
3) кластеры должны быть не слишком велики и географически компактны, иначе кластерная выборка теряет всякий финансовый смысл;
4) выбор кластеров должен быть осуществлен таким способом, который минимизирует рост выборочной ошибки (последний процесс, в свою очередь, является неизбежным следствием кластеризации).
Для того чтобы уяснить, как именно кластерная процедура влияет на рост выборочной ошибки, рассмотрим ее на простейшем примере. Допустим, мы изучаем труд и занятость жителей небольшого сельского района. Для того чтобы составить полный список-основу для случайной выборки, нам пришлось бы предварительно посетить все сельские советы, а в некоторых случаях — и весьма отдаленные деревни. Располагая ограниченными ресурсами, мы решаем использовать имеющуюся в нашем распоряжении карту района, на которой отмечены все населенные пункты, включая самые небольшие хутора. Известна и численность населения для каждого пункта. Естественными границами кластеров-поселений являются шоссе и проселочные дороги. Составив список всех 40 деревень и хуторов, мы можем теперь без труда осуществить простую случайную выборку кластеров. Для отдельного поселения вероятность попадания в выборку составит 1/40. Если, например, мы собираемся опросить 200 человек, нам, скорее всего, потребуется отобрать 1—2 кластера-поселения. Отметим здесь, что естественные различия в величине кластеров никак не влияют на процедуру кластерного отбора.
Что при этом происходит с выборочной ошибкой и, следовательно, с получаемыми в нашем исследовании статистическими параметрами генеральной совокупности сельского населения района (т. е. с оценками возраста, дохода и т. п.)? Чтобы ответить на этот вопрос, мы должны ввести еще одно статистическое понятие «независимых наблюдений» (степеней свободы).
Предположим, мы хотим оценить соотношение работающих и пенсионеров в обследуемом нами районе. Мы отобрали, условно, три деревни по 30 домовладений каждая (итого 90 домовладений). Однако в ходе опроса выясняется, что в двух деревнях, не входящих ни в одно сельхозобъединение или кооператив, живут исключительно старики-пенсионеры, а в одной, построенной недавно для переселенцев из Средней Азии, живут только молодые семьи с детьми. Таким образом, каждая деревня является населенной либо только работающими семейными парами, либо исключительно «пенсионерской». В результате мы можем заранее предсказать результат обследования каждой деревни (кластера), посетив лишь один дом. Если в первом доме интервьюер обнаружит чету пенсионеров, во всех остальных домах тоже будут жить пенсионеры. Если в первом доме живут люди трудоспособного возраста, посещение остальных 29 домовладений приведет к тому же результату. Фактически для каждой деревни мы будем располагать одним независимым наблюдением и, посетив 90 семей в трех деревнях, получим лишь три независимых, информативных наблюдения относительно распределения работающих и пенсионеров в выборке. Соответственно наши оценки величины данного соотношения в генеральной совокупности окажутся более неточными, чем в случае 90 независимых наблюдений. Причина возникающей ошибки заключается в том, что использованные вами кластеры (деревни) оказались гомогенными, однородными по исследуемому признаку трудовой занятости, хотя по другим признакам, например, по политической активности, они вполне могут быть гетерогенными, неоднородными. В принципе можно показать, что рост выборочной ошибки для кластерной выборки (в сравнении с простой случайной) является функцией двух нерешенных — величины кластеров и гомогенности исследуемого признака внутри каждого кластера.
Ясно, что оценка гомогенности часто становится важной практической задачей в планировании кластерной выборки. Основная проблема здесь заключается в том, что соответствующими данными о распределении признаков внутри кластеров исследователь располагает после завершения собственно полевой стадии. Практически при проектировании выборки обычно основываются на уже существующих данных предыдущих исследований, переписей и т. п.
Таблица 2
Значения мер гомогенности р для кластеров, состоящих из домовладений (для основных социально-демографических параметров)
| Параметр | Значение р для кластера, имеющего средний размер п | |||
| п = 3 | п = 9 | n = 27 | n = 62 | |
| Доля домовладений: — находящихся в личной собственности; | ,170 | ,171 | ,161 | ,096 |
| — наемных, с низкой квартплатой; | ,235 | ,169 | ,107 | ,062 |
| — наемных, с высокой квартплатой; | ,430 | ,349 | ,243 | ,112 |
| Среднее количество жильцов | ,230 | ,186 | ,142 | ,066 |
| Доля среди жильцов: | ||||
| — белых мужчин | ,100 | ,088 | ,077 | ,058 |
| — безработных мужчин | ,060 | ,070 | ,045 | ,034 |
| — мужчин в возрасте 25—34 лет | ,045 | ,026 | ,018 | ,008 |
Мера гомогенности р ведет себя так же, как соответствующий коэффициент корреляции. Величина р — это корреляция между значениями признака для всех возможных парных сочетаний элементов, входящих в кластер. Эта величина обычно положительна и возрастает с ростом гомогенности элементов внутри кластера. Если наблюдения внутри кластера абсолютно независимы (как в примере случайного распределения между разными кластерами), то р = 0. При использовании территориальной кластерной выборки городского населения, например при отборе кварталов или многоэтажных домов, р для признаков экономического статуса может быть весьма высоким из-за «пороговых» эффектов: в престижном кооперативном доме маловероятно встретить семьи с очень низкими доходами (верхний порог) и, наоборот, лишь немногие состоятельные люди обитают в коммуналках, подобно герою «Золотого теленка» Александру Ивановичу Корейко (нижний порог).
Ориентировочное представление о типичных значениях р и их изменении для кластеров разной величины для общенационального выборочного исследования дает табл. 2. В таблице показаны величины р для имеющих разные размеры кластеров, составленных из соседних городских домовладений (квартир и домов). Данные таблицы основаны на выборке городского населения США (N> 100000).
Еще одной немаловажной практической проблемой в планировании кластерной либо стратифицированной выборки является сравнение эффективности затрат на исследование при разных среднем размере кластера и количестве кластеров (заметим, что и кластеры, и страты часто обозначают общим термином — «первичные единицы отбора»). Функция, описывающая зависимость расходов от вышеперечисленных двух переменных, выглядит так:
Сt = ас1 + пс2,
где Ct — общая стоимость исследования,
а — количество «первичных единиц отбора»,
с1 — средние затраты на обследование первичной единицы отбора, планируемые для данного исследования,
n — общий размер планируемой выборки,
с2 — средние затраты на проведение одного интервью.
Дальнейшим обобщением идей случайного отбора из субпопуляций и естественных группировок, лежащих в основе, соответственно стратифицированной и кластерной выборок, является многофазная (многоступенчатая) выборка. Построение такой выборки представляет собой довольно сложную статистическую задачу, подходы к решению которой мы рассмотрим лишь в самом обобщенном виде.
В простейшем случае многофазная выборка состоит из двух фаз случайного отбора. На первой — как при кластерном отборе — выбираются «первичные единицы отбора», например, районы, избирательные участки, предприятия. На второй фазе производится случайный отбор единичных членов генеральной совокупности — отдельных респондентов, семей и т. п. Так как «первичные единицы отбора» могут существенно отличаться по величине (как, например, отличаются друг от друга городские квартиры или дома с разной численностью проживающих), то результатом первой фазы может стать неравная вероятность попадания в выборку для членов генеральной совокупности, относящихся к разным «первичным единицам отбора». В этом случае исследователь имеет возможность выравнивания вероятностей на последующих фазах (например, из «первичной единицы отбора», где проживает 1000 семей, он выберет 10, а из «первичной единицы», где живет 500 семей, будет отобрано 20).
Рассмотрим многофазную процедуру на простейшем примере с равной вероятностью отбора.
Пусть нам необходимо осуществить выборку размером 2000 человек из генеральной совокупности населения крупного города, где проживает 4 млн. человек. Каждая «первичная единица отбора» — городской квартал — содержит 1000 единиц (т. е. отдельных респондентов). На первой фазе мы отберем из 100000 кварталов («первичных единиц отбора») 400, так что для каждого квартала вероятность попадания в выборку составит:
400:100000 = 0,004.
На следующей стадии из 1000 жителей каждого квартала мы отберем 50, так что для каждого респондента суммарная накопленная вероятность попадания в двухфазную выборку составит:
0,004 X (50:1000) = 0,0002.
Решение об использовании многофазной выборки обычно принимается после анализа «баланса» затрат и приобретений. Снижение затрат на сбор данных. достигаемое в этом случае, сопровождается увеличением сложности выборочной процедуры. С ростом числа фаз (в больших общенациональных обследованиях нередко используют 4 или 5 «ступенек» отбора — от области до квартала) точность получаемых оценок имеет тенденцию снижаться. Поэтому исследователям нередко приходится сочетать многофазный отбор со стратификацией на завершающих стадиях выборочной процедуры, что обычно ведет к улучшению характеристик выборки. Отсюда понятно, почему многофазная выборка в значительной мере остается «прерогативой» крупных исследовательских организаций, которые обладают значительными финансовыми ресурсами и могут воспользоваться услугами профессионалов-статистиков при проектировании выборки.
3 Размер вероятностной выборки
Вопрос об оптимальном размере вероятностной выборки всегда был спорным и, в значительной мере, остается таковым. Мы обсудим лишь основные принципы, лежащие в основе современного подхода к оптимизации размера выборки.
Решение относительно размера выборки принимают с учетом целого ряда факторов, среди которых самую существенную роль играют два: 1) ценность и новизна получаемой в результате опроса информации и 2) затраты на проведение опроса (включая временные) при заданном размере выборки.
Некоторые исследователи полагают, что принятие решения о размере выборки может основываться на сугубо статистическом подходе. При этом в расчет принимают допустимую величину ошибки в оценке исследуемого параметра (например, дохода). Существуют статистические формулы, связывающие размер выборки с вероятностью ошибки и величиной доверительного интервала, задающего пределы этой ошибки. Так как использование этих формул требует принятия определенных предположений о том, как распределена интересующая исследователя величина, возникает необходимость в предварительной информации, относящейся к тому самому параметру, который мы решили изучить. Трудности, возникающие при использовании классического статистического подхода к определению размера вероятностной выборки, можно описать одной фразой, принадлежащей известному специалисту по массовым опросам С. Судману: «Очевидно, что формула, описывающая зависимость размера выборки от предполагаемой ширины доверительного интервала и приемлемой вероятности ошибки, попросту заменяет проблему определения размера выборки другой, не менее трудной проблемой — определения ширины доверительного интервала».
Во многих важных случаях можно руководствоваться сложившейся практикой, т.е. размером выборки, использовавшейся в аналогичных исследованиях. Кроме того, нужно помнить о простейших «правилах левой руки» для определения размера выборки.
Размер выборки растет
— при необходимости опубликовать данные для отдельных подгрупп (размеры подвыборок при этом суммируются, и выборка в целом растет пропорционально числу подгрупп);
— при проведении общенациональных обследований, когда велика генеральная совокупность (заданная доля генеральной совокупности/будет определять тем больший объем выборки, чем больше генеральная совокупность);
— если уже имеющаяся информация по ключевым вопросам (например, о намерениях избирателей голосовать за ту или иную партию) явно недостаточна, и степень неопределенности значительна
Размер выборки уменьшается
— при исследовании организаций, институтов и прочих «первичных единиц отбора», если сравнительно невелика величина генеральной совокупности, из которой производится отбор (например, совокупности сотрудников рекламных агентств, школьников, пациентов и т. п.);
— при проведении локальных и региональных исследований;
— если уже существующая информация относительно полна, и все еще остающаяся степень неопределенности незначительна.
«Типичные» размеры выборок для общенациональных опросов варьируют в пределах 1000—2500 респондентов (в зависимости от числа анализируемых подгрупп), для региональных опросов и опросов специальных популяций — от 200 до 500 (при анализе многочисленных подгрупп размер региональной или специальной выборки обычно возрастает как минимум до 1000 человек). Указанные значения, разумеется, могут служить лишь самым общим ориентиром для определения оптимального размера выборки.
4 Целевой отбор
социологическое исследование вероятностная выборка
Иногда социологи вынуждены применять не основанные на вероятностях выборки. Отбор в этом случае базируется не на принципе рандомизации, а на следовании тем или иным субъективным критериям — доступности, типичности, равного представительства и т. п. Многие из этих критериев при систематическом использовании позволяют добиться достаточно высокого качества социологических данных. Часто такой отбор называют целевым, так как он в большой степени определяется целями исследования. Кроме того, в конкретной исследовательской ситуации может оказаться, что осуществление случайной выборки — это практически невыполнимое или экономически неэффективное мероприятие (затраты на построение выборки превышают ценность получаемой в результате исследования информации). Наконец, использование вероятностного отбора лишено всякого смысла, если речь идет об исследовании уникальных событий, групп или ситуаций — полетов на Луну, войн или любовных историй.
Основной недостаток неслучайных процедур отбора связан с тем, что не существует строгих статистических методов, позволяющих обобщить результаты, полученные в ходе исследования выборки. Оценка точности и валидности этих результатов (и основанных на них выводов) остается делом субъективного суждения, опыта, теоретических предпочтений.
Самый распространенный тип не основанной на вероятности выборки — это выборка доступных случаев. Такого рода выборка может считаться корректной лишь тогда, когда используется в экспериментальном (или квазиэкспериментальном) исследовании. Так, в большинстве психологических экспериментов испытуемыми являются студенты. Это позволяет экономить скудные финансовые ресурсы, отпускаемые на сугубо академические изыскания. Для того чтобы исключить влияние посторонних, смешивающих факторов, экспериментатор в случайном порядке распределяет выборку доступных случаев (т. е. доступных испытуемых) по двум группам — экспериментальной и контрольной. В нашем обсуждении роли рандомизации в эксперименте подчеркивалось ее значение для получения точных и обоснованных выводов. Однако случайное приписывание испытуемых-добровольцев к экспериментальной и контрольной группам, строго говоря, не является достаточным основанием для обобщения результатов эксперимента для всей генеральной совокупности, из которой осуществлялась выборка доступных случаев. Точнее, в ситуации отбора доступных случаев невозможно с полной уверенностью сказать, что, собственно, являлось генеральной совокупностью в процессе исследования, так как последняя не была определена с самого начала. Поэтому, в частности, шутливое определение предмета психологии гласит, что это наука, изучающая студентов-второкурсников гуманитарных факультетов. В социологии выборкой доступных случаев чаще всего приходится довольствоваться при изучении таких специальных популяций, которые практически не поддаются локализации. Речь идет, прежде всего, об относительно малочисленных группах, находящихся вне сферы институционального (например, административного) контроля. Для таких групп трудно найти какую-то основу выборки — скажем, посетители стрелковых тиров едва ли состоят на каком-нибудь государственном учете. «Просеивание» большой случайной выборки из генеральной совокупности с целью рекрутирования сколько-нибудь значительного числа респондентов в специальную выборку требует непомерных затрат. Поэтому социологам иногда приходится уподобляться орнитологам и отбирать членов экзотических популяций в местах их «естественного обитания» или вероятного скопления. Многие исследования посетителей массовых библиотек проводятся в библиотеках, посетителей выставок — в музеях, ветеранов войны — в клубах ветеранов и т. п. В этой ситуации исследователю приходится прилагать дополнительные усилия для получения высококачественной информации. Следует заметить, что некоторая статистическая «небезупречность» получаемых таким образом результатов, при должной методической культуре исследователей, иногда окупается, и мы узнаем нечто принципиально новое об относительно «закрытых» областях человеческого поведения. Однако если целью исследования является описание распределения признаков во вполне определенной генеральной совокупности (покупателей зубной пасты, избирателей, читателей газет), то социолог, использующий выборку доступных случаев, понапрасну тратит деньги заказчика (и пренебрегает профессиональной этикой). Квалифицированному заказчику в этом случае также не стоит принимать всерьез рассуждения о принципиально новых, нестатистических и даже «мягких» методах проведения массовых опросов.
Значительно реже социологи используют две другие разновидности целевого отбора — отбор «критических случаев» и отбор «типичных случаев». В обоих случаях исследователь полагается на какие-то теоретические представления или предыдущий опыт, чтобы отобрать ограниченное число «симптоматических», характерных наблюдений, позволяющих сделать более широкие обобщения и предсказания. Иногда это удается, но следует помнить о том, что опыт и теоретические суждения обычно бывают субъективны. В печально знаменитых президентских выборах 1948 г. в Америке (Г. Трумэн против Т. Дьюи) ошибочные прогнозы сделали все знаменитые институты опросов общественного мнения. При этом некоторые из них избрали в качестве «типичного» случая население штата Мэн, так как прежде жители этого штата всегда «угадывали» будущего президента. В описываемом случае «нетипично» (т.е. за проигравшего выборы Дьюи) проголосовали только два штата — Мэн и Вермонт. Поэтому поговорку «Как голосует Мэн, голосует вся Америка» пришлось перефразировать: «Как голосует Мэн, так голосует Вермонт».
Метод «снежного кома» — это еще один (наряду с выборкой доступных случаев) интересный подход к отбору из «редких» совокупностей. Его идея такова: первоначально идентифицированная небольшая группа членов интересующей социолога совокупности служит источником сведений о других членах этой совокупности, так что выборка постепенно разрастается вширь подобно снежному кому, катящемуся с горы. Этот метод использовал, например, П. Лазарсфельд с коллегами в исследовании «влиятельных людей» и неформальных связей. Помимо властвующих элит данный метод применяют в изучении других групп, также избегающих широкой известности, — например, наркоманов или коллекционеров антиквариата. Для этого метода существуют определенные приемы оценки систематической ошибки, однако они слишком сложны, чтобы обсуждаться здесь.
К выборкам, не основанным на случайном отборе, относится и квотная выборка, когда-то чрезвычайно популярная даже среди профессиональных статистиков и практически не используемая сейчас. Идея квотной выборки проста: изучаемая совокупность разбивается на такие социально-демографические группы, которые исследователь почему-либо считает важными. Обычно критериями разбивки становятся пол, возраст, национальная принадлежность, место жительства и т. п. Далее, основываясь на уже известных (обычно из официальной статистики) пропорциях этих групп в генеральной совокупности, социолог составляет полевые задания для интервьюеров, указывая, сколько женщин, мужчин, лиц с высшим образованием и т. п. нужно опросить. Например, интервьюер получает задание опросить десять женщин старше 50 лет, восемь мужчин 35 — 45 лет и трех восемнадцатилетних девушек, проживающих в г. Санкт-Петербурге. В результате должна получиться выборка, представляющая все заданные пропорции групп в генеральной совокупности.
Основная проблема квотного отбора заключается в том, что он носит неслучайный характер и осуществляется лично интервьюером. Последний выбирает респондентов, в конечном счете, по собственному усмотрению. Хотя число мужчин или женщин, рабочих или пенсионеров, которых следует опросить в данном районе или местности, задано заранее, интервьюер решает, в какую квартиру ему удобнее позвонить, с кем из членов семьи провести интервью, куда вернуться вторично, если на звонок никто не ответил, и т. п. Это неизбежно ведет к систематическим смещениям в процессе отбора, причем не существует никаких методов для оценки величины возникающей систематической ошибки.
Еще один очевидный недостаток квотного отбора связан с тем, что обычно невозможно даже приблизительно оценить количество отказов от участия в опросе. Если интервьюер сталкивается с человеком, не желающим отвечать на вопросы, или просто недоброжелательным, или вызывающим у него антипатию, интервьюер всегда волен попрощаться и попытать счастья в соседней квартире.
По указанным причинам квотные выборки «вышли из моды» среди социологов, несмотря на свою относительную дешевизну.
Оценивая полезность и применимость вышеописанных «неслучайных» методов отбора в исследовательской практике, следует, прежде всего, сказать, что в определенных обстоятельствах никакой другой альтернативы просто не существует. В ситуации нехватки денег, персонала, времени либо первичной информации о генеральной совокупности социологи использовали и будут использовать впредь выборки доступных случаев, метод «снежного кома» и даже (к сожалению) квотную выборку. При этом профессиональный долг социолога заключается в том, чтобы оценить, пусть даже очень приблизительно, величину и источники возникающей выборочной ошибки.
Безусловно, разумно использовать целевые выборки в пилотажных исследованиях, в экспериментах, в том числе методических (т. е. нацеленных на проверку и отработку анкет, опросников, шкал и т. п.).
Однако всегда следует помнить о том, что возможность обобщения любых оценок, полученных на целевой выборке, для генеральной совокупности в целом, т. е. внешняя валидность результатов исследования, чаще всего оказывается сомнительна.
Библиографический список
1. Кокрен У. Методы выборочного обследования. М.: Статистика, 2010.
2. Петренко Е. С., Ярошенко Т. М. Социально-демографические показатели в социологических исследованиях. М.: Статистика, 2009.
3. Территориальная выборка в социологических исследованиях. М.: Наука, 2010.
4. Чурилов Н. Н. Проектирование выборочного социального исследования. Киев: Наукова думка, 2008.
5. Маслова О. М. Качественная и количественная социология: методология и методы (по материалам круглого стола) // Социология: 4М. 2009. № 5—6.
Размещено на
36