Статистический анализ и прогнозирование безработицы
 – дисперсии
факторного
и результативного
признака
соответственно;
xy – среднее
значение суммы
произведений
значений факторного
и результативного
признака; x
и y – средние
значения факторного
и результативного
признака
соответственно.
Для фактора x1 получаем коэффициент корреляции r1: r1= 0,627
Для фактора x2 получаем коэффициент корреляции r2: r2 =0,295
Для фактора x3 получаем коэффициент корреляции r3: r3=0,717
По полученным данным можно сделать вывод о том, что:
1)Связь между x1 и y прямая (так как коэффициент корреляции положительный) и умеренно сильная. Поэтому, будем использовать фактор в дальнейших расчётах.
2)Связь между x2 и y прямая (так как коэффициент корреляции положительный) и умеренная, так как она находится между 0,21 и 0,30. Таким образом, возникает необходимость исключить данный фактор из дальнейших исследований.
3)Связь между x3 и y прямая (так как коэффициент корреляции положительный) и сильная. Также будем использовать данный фактор в дальнейших расчетах.
Таким образом, два наиболее влиятельных фактора - индекс ВРП и доля пенсионеров. Для имеющихся факторов x1 и x3 составим уравнение множественной регрессии. Для анализа воспользуемся линейной формой связи, т.е. составим линейное уравнение, т.к. линейное уравнение легче подвергать анализу, интерпретации.
Проверим факторы на мультиколлинеарность, для чего рассчитаем коэффициент корреляции rx1x3:
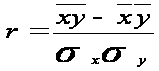
где:
 и
– дисперсии
факторного
и результативного
признака
соответственно;
x,y –
среднее значение
суммы произведений
значений факторного
и результативного
признака; x
и y – средние
значения факторного
и результативного
признака
соответственно.
Подставив имеющиеся данные (из таблицы 10) в формулу, имеем следующее значение: rx1x3=0,8998. Полученный коэффициент говорит об очень высокой связи, поэтому дальнейший анализ по обоим факторам вестись не может. Однако в учебных целях продолжим анализ.
Проводим оценку существенности связи с помощью коэффициента множественной корреляции:
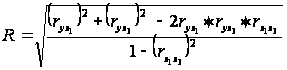
где: ryx1 – коэффициент корреляции между y и x1; ryx3 – коэффициент корреляции между y и x3; rx1x3 – коэффициент корреляции между x1 и x3.
Подставив имеющиеся данные в формулу и получим: R=0,717
Так как R < 0,8, то связь признаем не существенной, но, тем не менее, в учебных целях, проводим дальнейшее исследование.
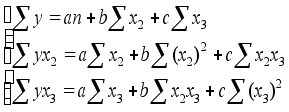 Уравнение
прямой имеет
следующий вид:
ŷ = a
+ bx1
+ cx3
Для определения параметров уравнения необходимо решить систему:
Решив систему, получим уравнение: Ŷ=14,72+0,00023 x1+0,00086x3
Для данного уравнения найдем ошибку аппроксимации:
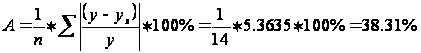
А> 5%, то данную модель нельзя использовать на практике.
Проведем оценку параметров на типичность. Рассчитаем значения величин:
S2=28,039
ma=1,415; mb=0,023; mс=0,8404;
ta=10,403; tb=0,01; tc=0,001.
Сравним полученные выше значения t для α = 0,05 и числа степеней свободы (n-2) с теоретическим значением t-критерия Стьюдента, который tтеор = 2,1788. Расчетные значения tb и tс < tтеор, значит данные параметры не значимы и данное уравнение не используется для прогнозирования.
Далее оценим существенность совокупного коэффициента множественной корреляции на основе F-критерия Фишера по формуле:
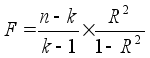
где: n – число уровней ряда; к – число параметров; R – коэффициент множественной корреляции.
После расчета получаем: F=5,819
Сравним Fрасч с Fтеор для числа степеней свободы U1 = 9 и U2 = 2, видим, что 0,045 < 19,40, то есть Fрасч < Fтеор - связь признаётся не существенной, то есть корреляция между факторами x1, x3 и у не существенна.
3.4. Прогнозирование безработицы
Определив наличие тенденции, можно начать прогнозирование. Прогнозирование проводится следующими методами:
1)на основе средних показателей динамики;
2)на основе экстраполяции тренда;
3)на основе скользящих и экспоненциальных средних.
I. Сначала проведем прогнозирование методом среднего абсолютного прироста. Для этого надо проверить выполняются ли предпосылки. Вычисляем данные для подстановки в формулы предпосылок:
ρ2= 310,14
σ2ост = 250,11
т.к. σ2ост< ρ2 , условие выполняется, значит можно строить прогноз на основе среднего абсолютного прироста. Вычислим средний абсолютный прирост:
 , где yp-
прогнозируемый
уровень; yb-
конечный уровень
ряда как наиболее
близкий к
прогнозируемому;
L-период
упреждения;
∆- средний
абс.прирост.
Подставляем значения yb=54,13 L=1 ∆=1,91 в функцию прогноза:
yp =54,13+1,91*1=56,04 – прогноз на 2006г.
yp =54,13+1,91*2=57,95 – прогноз на 2007г.
Фактически численность безработных в 2006г. составила 60,6 тыс.чел.
Вычислим ошибку прогноза для сравнения методов прогнозирования на точность: 60,6-56,04=4,56 тыс.чел.
Теперь составим прогноз методом среднего темпа роста. Вычислим средний темп роста: yp= yb*КL
 =1,0096
Подставим это значение в формулу и составим прогноз на 2006г.:
yp=54,13*1,00961=54,65
Вычислим ошибку: 60,6-54,65=5,95тыс.чел.
Так как ошибка при прогнозировании методом среднего абсолютного прироста меньше ошибки при прогнозировании методом среднего темпа роста, то можно сделать вывод, что прогнозирование первым методом дает более точные результаты. Поэтому мы оставляем для анализа результатов данные прогноза полученные методом среднего абсолютного прироста. Составим диаграмму при прогнозировании методом абсолютного прироста.
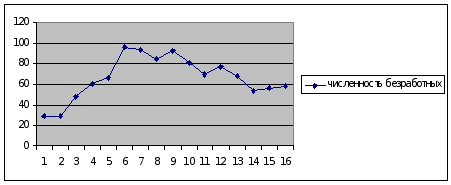
Рис. 4.Численность безработных при прогнозировании «методом абсолютного прироста»
II. Следующий способ прогнозирования - методом экстраполяции тренда.
Ранее по аналитическому выравниванию нашли уравнение параболы второй степени: у =13,37+13,94t-1,0017t2
Сделаем прогноз на 2006г., примем t=7, т.к. нумерация дат определена с середины ряда, т.е. ∑t=0.
уp=13,37+13,94*7-1,0017*49=60,87 – прогноз на 2006г.
Определим доверительный интервал прогноза, в основе которого лежит показатель колеблемости уровней ряда. Колеблемость уровней ряда определяется по формуле: Sy =
Sy=91,44
Интервал определяется с помощью ошибки прогноза Sp= Sy*Q, где Q- поправочный коэффициент, учитывающий период упреждения.
Q= = 1,2127
Тогда ошибка прогноза: Sp=91,44*1,2127=110,886
Соответственно доверительный интервал прогноза составит: уp+t*Sp, где t-табличное значение t-критерия Стьюдента. При ά=0,05 и числе степеней свободы n-3= 11 t=2,2010.
уp+2,2010*110,886 или 61,87 +244,061, т.е. -182,2< уp <305,93
Значит, прогнозная величина находится в данном интервале.
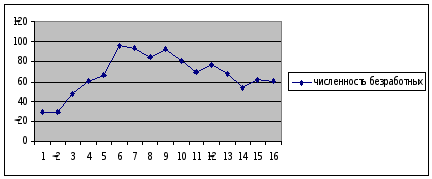
Рис.5. Численность безработных при прогнозировании «методом экстраполяции тренда»
III. Метод скользящих и экспоненциальных средних.
Ранее в своих расчетах я определила, что ряд не содержит периодических колебаний и отсутствуют трендовая компонента Т и циклическая (сезонная) компонента S. Поэтому нет необходимости использовать метод скользящих средних.
Метод экспоненциальных средних.
Экспоненциальное сглаживание является простым методом, который в ряде наблюдений позволяет строить приемлемые прогнозы наблюдаемых временных рядов. Суть метода в том, что исходный ряд x(t) сглаживается с некоторыми экспоненциальными весами, образуется новый временной ряд S(t) (с меньшим уровнем шума), поведение которого можно прогнозировать.
Веса в экспоненциальных средних устанавливаются в виде коэффициентов ά(|ά|<1). В качестве весов используется ряд:
ά; ά(1- ά); ά(1- ά)2; ά(1- ά)3 и т.д.
Экспоненциальная
средняя определяется
по формуле:
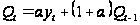
где Qt – экспоненциальная средняя (сглаженное значение уровня ряда) на момент t; ά- вес текущего наблюдения при расчете экспонен. средней; yt –фактический уровень ряда; Qt-1-экспонен. средняя предыдущего периода.
Каждый новый прогноз основывается на предыдущем прогнозе:
St= St-1+ά(yt -1- St-1),
где St- прогноз для периода t; St-1-прогноз предыдущего периода; ά- сглаживающая константа; yt -1- предыдущий уровень.
Например, St=29,3+0,5*(29,25-29,3)=29,275.
При прогнозе учитывается ошибка предыдущего прогноза, т.е. каждый новый прогноз St получается в результате корректировки предыдущего прогноза с учетом ошибки.
Таблица 12. Расчет прогноза и ошибки.
| 1992 | 1993 | 1994 | 1995 | 1996 | 1997 | 1998 | 1999 | 2000 | 2001 | 2002 | 2003 | 2004 | 2005 | 2006 | |
| yt | 29,3 | 29,25 | 48,03 | 60,06 | 66,39 | 96,26 | 93,59 | 84,74 | 92,91 | 81,26 | 69,73 | 76,85 | 67,9 | 54,13 | - |
| прогноз | - | 29,3 | 29,28 | 38,65 | 49,36 | 57,87 | 77,07 | 85,33 | 85,03 | 88,97 | 85,12 | 77,42 | 77,14 | 72,52 | 60,32 |
| ошибка | - | -0,05 | 18,76 | 21,41 | 17,03 | 38,39 | 16,52 | -0,59 | 7,876 | -7,71 | -15,4 | -0,57 | -9,24 | -18,4 | - |
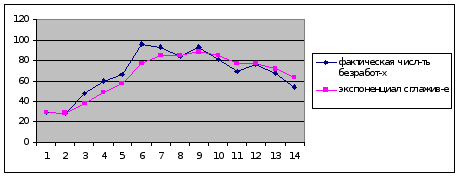
Рис. 6. Экспоненциальное сглаживание.
При прогнозировании могут использоваться экспоненциальные средние более высоких порядков, полученные путем многократного сглаживания. Экспоненциальная средняя К-го порядка:
Qt(к) = ά Qt(к-1) +(1- ά) Qt-1(к)
Экспоненциальные средние 2-го, 3-го порядка применяются в адаптивном прогнозировании по полиномиальным моделям. Для прогноза использован линейный тренд: y=a+bt. Его параметры связаны с экспоненциальными средними 1-го (Qt(1)) и 2-го (Qt(2)) порядков:
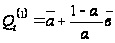
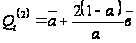
соответственно:
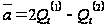
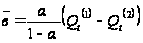
Необходимо задать начальные условия Qt-1к:
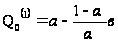
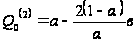
Линейный тренд: уt=49,25+2,49t
Параметр сглаживания ά определим: ά=2/(n+1).
Так как n=14, то ά=2/(14+1)=0,13.
Соответственно (1- ά)/ά=(1-0,13)/0,13=6,69, ά/(1- ά)=0,13/(1-0,13)=0,15.
Начальные условия для экспоненциального сглаживания:
Qо(1)=а-6,69*b=49,25-6,69*2,49=32,59
Qo(2)=а-2*6,69*b=49,25-2*6,69*2,49=15,93
Экспоненциальные средние Qt(1) и Qt(2) составят:
Qt(1)= άyt+(1- ά) Qt-1(1)=0,13*84,11+(1-0,13)*32,59=39,28, где yt=yt=n ;Qt-1(1)= Qо(1)
Qt(2)= άQt(1)+(1- ά) Qt-1(2)=0,13*39,28+(1-0,13)*15,93=18,97, где Qt-1(2)= Qo(2)
Тогда скорректированные параметры линейного тренда составят:
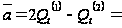 2*39,28-18,97=59,59
=0,15*(39,28-18,97)=3,0465
Прогноз
производим
по модели:
 ,
где l-период
упреждения.
Тогда при l=1 прогноз на 2006г. составит: уp=59,59+3,0465*1 =60,6т.ч.
Соответственно при прогнозе на 2007г. берем l=2: уp=59,59+3,0465*2=65,683.
Таким образом, по результатам проведенного анализа следует, что численность безработных в 2006 году возрастет по сравнению с 2005г. на 6,5 тыс.чел. или 12% и составит 60,6 тыс.чел., а в 2007г. возрастет на 11,55 тыс.чел. и составит 65,68 тыс.человек.
3.5. Анализ динамики уровня безработицы
1. Расчет аналитических (∆у, Тр, Тпр, |%|) и средних показателей рядов динамики.
Таблица 1. Расчетная таблица для ∆у, Тр, Тпр,|%|.
| год |
уровень |
абс прирост | коэф-ты роста % | коэф-ты прироста % |
абс
знач-е |
|||
| базис | цепн | базис | цепн | базис | цепн | |||
| 1992 | 5,8 | |||||||
| 1993 | 5,9 | 0,10 | 0,1 | 1,017 | 1,017 | 0,017 | 0,017 | 580 |
| 1994 | 9,8 | 4,00 | 3,9 | 1,6897 | 1,661 | 0,6897 | 0,661 | 590 |
| 1995 | 12,7 | 6,90 | 2,9 | 2,1897 | 1,296 | 1,1897 | 0,296 | 980 |
| 1996 | 14,9 | 9,10 | 2,2 | 2,569 | 1,173 | 1,569 | 0,173 | 1270 |
| 1997 | 22 | 16,20 | 7,1 | 3,793 | 1,477 | 2,793 | 0,477 | 1490 |
| 1998 | 22,2 | 16,40 | 0,2 | 3,828 | 1,009 | 2,828 | 0,009 | 2200 |
| 1999 | 17,7 | 11,90 | -4,5 | 3,052 | 0,797 | 2,052 | -0,203 | 2220 |
| 2000 | 19,1 | 13,30 | 1,4 | 3,293 | 1,079 | 2,293 | 0,079 | 1770 |
| 2001 | 18,4 | 12,60 | -0,7 | 3,172 | 0,963 | 2,172 | -0,0367 | 1910 |
| 2002 | 15,4 | 9,60 | -3,0 | 2,655 | 0,837 | 1,655 | -0,163 | 1840 |
| 2003 | 16,9 | 11,10 | 1,5 | 2,914 | 1,097 | 1,914 | 0,097 | 1540 |
| 2004 | 15,3 | 9,50 | -1,6 | 2,638 | 0,9053 | 1,6379 | -0,095 | 1690 |
| 2005 | 12 | 6,20 | -3,3 | 2,069 | 0,784 | 1,069 | -0,216 | 1530 |
| итого | 208,1 | 6,2 | ||||||
Максимальное значение абсолютного прироста (по цепной системе) зафиксировано в 1997 году (7,1%), минимальное значение - в 1999 году(-4,5%). Максимальное значение абсолютного прироста по базисной системе составило 16,4% в 1998 году, минимальное – 0,1 в 1993 году. В общем абсолютный прирост уровня безработицы по цепной, так и по базисной системам с 1992 по 1998г увеличивается, а с 1998г уменьшается. Это объясняется, прежде всего, неравномерностью освоения инвестиций по отношения к периоду финансового года, что характеризует большой поток инвестиций на завершение начатых проектов в конце года, и относительно небольшой поток их в течение остального времени.
Коэффициенты роста и прироста, как по базисной, так и по цепным системам также сначала увеличиваются, а потом уменьшаются. Максимальный коэффициент роста как по цепной зафиксирован в 1994г., по базисной в 1998г.- 3,828. Минимальное значение коэффициента роста по цепной системе принимает в 2005 году и составляет 0,784, а по базисной системе – в 1993 году и составляет 1,017.
Коэффициент прироста достигает своего максимального значения по базисным системам в 1993г., и составляет - 0,017, по цепной системе в 1998г. (2,828). Коэффициент прироста достигает своего минимального значения: по цепной системе в 1998г., и составляет - -0,216; по базисной системе -2,828 в 1998 года.
Так как темпы роста и прироста зависят от коэффициентов роста и прироста, то их максимальные значения будут также находиться по цепной системе в 1994 г., по базисной в 1998г. Максимальное значение темпа роста по цепной системе составляет 166,1%, по базовой - 382,76 %, минимальное - 78,43 % и 101,72 % соответственно. Максимальное значение темпа прироста по цепной системе составляет 66,102%, по базовой - 282,76%, минимальное соответственно - -21,57% и 1,724%.
Рассчитаем среднегодовой уровень численности безработных:
У=280,1/14=20,01%, т.е. за период 1992-2005гг. ежегодно уровень численности безработных составила 20,01%.
Средний абсолютный прирост:
Равен ∆=6,2/13=0,48%, т.е. за период с 1992-2005гг. в среднем ежегодно абсолют. прирост уровня численности безработных составил 0,48%.
Средний коэффициент роста:
Тр=1,042 или 104,2% - это говорит о том, что с 1992-2005гг. в среднем ежегодно темп роста безработных составил 104,2%.
Средний темп прироста:
Тпр = 104,2%-100%= 4,2% - с 1992-2005гг. в среднем темп прироста достигал 4,2%.
2. Определение наличия тенденции.
Выдвигаем гипотезу Н0 об отсутствии тенденции, проверка осуществляется на основе кумулятивного t-критерия Стьюдента. Расчетное значение определяется по формуле:
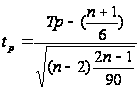 ,
где

Таблица 2. Для расчёта характеристик S2 и Z2.
| год |
уровень |
S2 | Z2 |
| 1992 | 5,8 | 82,16128 | 82,16 |
| 1993 | 5,9 | 80,35842 | 162,5197 |
| 1994 | 9,8 | 25,64699 | 188,1667 |
| 1995 | 12,7 | 4,684133 | 192,8508 |
| 1996 | 14,9 | 0,001276 | 192,8521 |
| 1997 | 22 | 50,91842 | 243,7705 |
| 1998 | 22,2 | 53,8127 | 297,5832 |
| 1999 | 17,7 | 8,041276 | 305,6245 |
| 2000 | 19,1 | 17,94128 | 323,5658 |
| 2001 | 18,4 | 12,50128 | 336,067 |
| 2002 | 15,4 | 0,28699 | 336,354 |
| 2003 | 16,9 | 4,144133 | 340,4982 |
| 2004 | 15,3 | 0,189847 | 340,688 |
| 2005 | 12 | 8,204133 | 348,8921 |
| итого | 208,1 | 348,8921 | 3691,593 |
Tp= 10,581; tp=4,26
Табличное значение t-критерия Стьюдента для числа степеней свободы df=(n-2)=12 и вероятности 95% составляет 2,1788. tp >tтабл → гипотеза Н0 о равенстве средних отвергается, расхождение между средними существенно значимо и не случайно, то в ряде динамики существует тенденция средней и, следовательно в исходном временном ряду тенденция имеется.
3. Метод аналитического выравнивания и определение параметров.
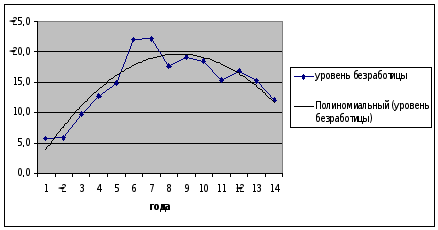
Рис.7. График общего уровня безработицы.
По
графику видно,
что временной
ряд характеризуется
сначала тенденцией
возрастания
до 1998г., а затем
убывания. Можно
предположить,
что данный ряд,
вероятно, развивается
согласно
полиномиальной
функции, которая
описывается
параболой
второго порядка:
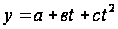
Таблица 3. Расчет параметров тренда.
| год | тыс.чел. | t | t2 | t3 | t4 | yt | yt2 |
| 1992 | 5,8 | 1 | 1 | 1 | 1 | 5,8 | 5,8 |
| 1993 | 5,9 | 2 | 4 | 8 | 16 | 11,8 | 23,6 |
| 1994 | 9,8 | 3 | 9 | 27 | 81 | 29,4 | 88,2 |
| 1995 | 12,7 | 4 | 16 | 64 | 256 | 50,8 | 203,2 |
| 1996 | 14,9 | 5 | 25 | 125 | 625 | 74,5 | 372,5 |
| 1997 | 22 | 6 | 36 | 216 | 1296 | 132 | 792 |
| 1998 | 22,2 | 7 | 49 | 343 | 2401 | 155,4 | 1087,8 |
| 1999 | 17,7 | 8 | 64 | 512 | 4096 | 141,6 | 1132,8 |
| 2000 | 19,1 | 9 | 81 | 729 | 6561 | 171,9 | 1547,1 |
| 2001 | 18,4 | 10 | 100 | 1000 | 10000 | 184 | 1840 |
| 2002 | 15,4 | 11 | 121 | 1331 | 14641 | 169,4 | 1863,4 |
| 2003 | 16,9 | 12 | 144 | 1728 | 20736 | 202,8 | 2433,6 |
| 2004 | 15,3 | 13 | 169 | 2197 | 28561 | 198,9 | 2585,7 |
| 2005 | 12 | 14 | 196 | 2744 | 38416 | 168 | 2352 |
| итого | 208,1 | 105 | 1015 | 11025 | 127687 | 1696,3 | 16327,7 |
Подставим значения из таблицы 3 и решим систему. Получим параметры уравнения тренда:
а=2,46; b=3,545; c=-0,205.
Соответственно
уравнение
тренда составит:
 =2,46+3,545t-0,205

Оценим параметры уравнения на типичность. Найдем S2- остаточная уточнённая дисперсия; mа, mв, mr - ошибки по параметрам. Получим следующие данные:
S2=6,29; mа=0,671; mв=0,028; mr=0,173
 Оценим
значимость
параметров
модели по критерию
Стьюдента.
Предположим,
что параметры
и коэффициент
корреляции
стат. значимы.
Найдем расчётные
значения t-критерия
Стьюдента для
параметров:
ta=3,669; tb=126,61; tс=-7,32; tr=4,636.
Сравним полученное значение с табличным t-критерием Стьюдента. tтабличное при Р=0,05 и (n-2)= 2,1788. Так как tрасчётное > tтабличное , то параметры а, b и r уравнения типичны (значимы). Так как tрасчётное < tтабличное , то параметр с незначим.
Оценим уравнение в целом по критерию Фишера, выдвигаем гипотезу Н0:о том, что коэффициент регрессии равен нулю.
Fф=Dфакт/Dост=348,89/6,29=55,47.
FT(v1=1;v2=12)=4,75.
Т.к. Fф > FT при 5%-ном уровне значимости гипотеза Н0 отвергается, уравнение в целом стат. значимо. Индекс детерминации здесь составляет 0,642. Следовательно, уравнением регрессии объясняется 64,2% дисперсии результативного признака, а на долю прочих факторов приходится 35,8% её дисперсии (т.е. остаточная дисперсия).
3.6. Многофакторный корреляционно - регрессионный анализ
Таблица 4. Исходные данные.
| год |
уровень |
доход |
индекс |
индекс |
| 1995 | 12,7 | 83,7 | 278,2 | 86,2 |
| 1996 | 14,9 | 89,6 | 235,2 | 93,5 |
| 1997 | 21,3 | 130,5 | 124 | 102,2 |
| 1998 | 22,2 | 72,2 | 107,9 | 94,2 |
| 1999 | 17,3 | 99,9 | 163,7 | 108 |
| 2000 | 19,1 | 111,2 | 144,6 | 104,9 |
| 2001 | 18,4 | 110,2 | 120,3 | 106,4 |
| 2002 | 15,4 | 121,5 | 110,6 | 106,4 |
| 2003 | 16,8 | 104,5 | 114,2 | 106,7 |
| 2004 | 15,3 | 104,4 | 114,7 | 103,7 |
| 2005 | 12 | 111,3 | 115,1 | 104,8 |
| итого | 185,4 | 1139 | 1628,5 | 1117 |
| средн | 16,86 | 103,55 | 148,046 | 101,55 |
Для анализа необходимо из нескольких факторов произвести предварительный отбор факторов для регрессионной модели. Сделаем это по итогам расчета коэффициента корреляции, т.е. возьмем те факторы, связь которых с результативным признаком будет выражена в большей степени. Рассмотрим следующие факторы:
- Доход на душу населения – x1 (%)
- Индекс потребительских цен – x2 (%)
- Индекс ВРП - x3 (%)
Рассчитаем коэффициент корреляции для линейной связи и для имеющихся факторов - x1, x2 и x3:
Для фактора x1 получаем коэффициент корреляции: r1= 0,042
Для фактора x2 получаем коэффициент корреляции: r2 =0,437
Для фактора x3 получаем коэффициент корреляции: r3=0,151
По полученным данным можно сделать вывод о том, что:
1)Связь между x1 и y отсутствует, так как коэффициент корреляции меньше 0,15. Таким образом, возникает необходимость исключить данный фактор из дальнейших исследований.
2)Связь между x2 и y прямая (так как коэффициент корреляции положительный) и умеренная, так как она находится между 0,41 и 0,50. Поэтому, будем использовать фактор в дальнейших расчётах.
3)Связь между x3 и y прямая (так как коэффициент корреляции положительный) и слабая. Тем не менее, будем использовать фактор в дальнейших расчетах.
Таким образом, два наиболее влиятельных фактора – Индекс потребительских цен – x2 и индекс ВРП - x3. Для имеющихся факторов x2 и x3 составим уравнение множественной регрессии.
Проверим факторы на мультиколлинеарность, для чего рассчитаем коэффициент корреляции rx2x3. Подставив имеющиеся данные (из таблицы 10) в формулу, имеем следующее значение: rx2x3=0,747. Полученный коэффициент говорит об очень высокой связи, поэтому дальнейший анализ по обоим факторам вестись не может. Однако в учебных целях продолжим анализ.
Проводим оценку существенности связи с помощью коэффициента множественной корреляции: R=0,512
Так как R < 0,8, то связь признаем не существенной, но, тем не менее, в учебных целях, проводим дальнейшее исследование.
Уравнение
прямой имеет
следующий вид:
ŷ = a
+ bx1
+ cx3
Для определения параметров уравнения необходимо решить систему:
Решив систему, получим уравнение: Ŷ=41,57-0,042 x1-0,183x3
Для данного уравнения найдем ошибку аппроксимации:
A=15,12
А> 5%, то данную модель нельзя использовать на практике.
Проведем оценку параметров на типичность. Рассчитаем значения величин:
S2=28,039
ma=0,886; mb=0,0003; mс=0,017;
ta=41,57/0,886=46,919; tb=-0,042/0,0003=-140; tc=-0,183/0,017=-10,77.
Сравним полученные выше значения t для α = 0,05 и числа степеней свободы (n-2) с теоретическим значением t-критерия Стьюдента, который tтеор = 2,1788. Расчетные значения tb и tс < tтеор, значит данные параметры не значимы и данное уравнение не используется для прогнозирования.
Далее оценим существенность совокупного коэффициента множественной корреляции на основе F-критерия Фишера по формуле:
где: n – число уровней ряда; к – число параметров; R – коэффициент множественной корреляции.
После расчета получаем: F=1,41
Сравним Fрасч с Fтеор для числа степеней свободы U1 = 9 и U2 = 2, видим, что 1,41 < 19,40, то есть Fрасч < Fтеор - связь признаётся не существенной, то есть корреляция между факторами x2, x3 и у не существенна.
3.7. Прогнозирование уровня безработицы
Определив наличие тенденции, можно начать прогнозирование.
I. Сначала проведем прогнозирование методом среднего абсолютного прироста. Для этого надо проверить выполняются ли предпосылки. Вычисляем данные для подстановки в формулы предпосылок:
ρ2=5,88
σ2ост = 4,65
т.к. σ2ост< ρ2 , условие выполняется, значит можно строить прогноз на основе среднего абсолютного прироста. Вычислим средний абсолютный прирост:
, где yp-
прогнозируемый
уровень; yb-
конечный уровень
ряда как наиболее
близкий к
прогнозируемому;
L-период
упреждения;
∆- средний
абс.прирост.
Подставляем значения yb=12 L=1 ∆=0,48 в функцию прогноза:
yp =12+0,48*1=12,48 – прогноз на 2006г.
yp =12+0,48*2=12,23 – прогноз на 2007г.
Фактически уровень безработицы в 2006г. составил 14,1%.
Вычислим ошибку прогноза для сравнения методов прогнозирования на точность: 14,1-12,48=1,62.
Теперь составим прогноз методом среднего темпа роста. Вычислим средний темп роста: yp= yb*КL
=1,042
Подставим это значение в формулу и составим прогноз на 2006г.:
yp=12*1,0421=12,304
Вычислим ошибку: 14,1-12,304=1,796.
Так как ошибка при прогнозировании методом среднего абсолютного прироста меньше ошибки при прогнозировании методом среднего темпа роста, то можно сделать вывод, что прогнозирование первым методом дает более точные результаты. Поэтому мы оставляем для анализа результатов данные прогноза, полученные методом среднего абсолютного прироста. Составим диаграмму при прогнозировании методом абсолютного прироста.
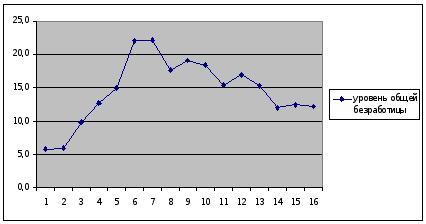
Рис. 8.Уровень общей безработицы при прогнозировании «методом абсолютного прироста»
II. Следующий способ прогнозирования - методом экстраполяции тренда.
Ранее по аналитическому выравниванию нашли уравнение параболы
второй
степени:
=2,46+3,545t-0,205
Сделаем прогноз на 2006г., примем t=7, т.к. нумерация дат определена с середины ряда, т.е. ∑t=0.
уp=2,46+3,545*7-0,205*49=17,23 – прогноз на 2006г.
Определим доверительный интервал прогноза, в основе которого лежит показатель колеблемости уровней ряда. Колеблемость уровней ряда определяется по формуле: Sy =
Sy=2,62
Интервал определяется с помощью ошибки прогноза Sp= Sy*Q, где Q- поправочный коэффициент, учитывающий период упреждения.
Q=1,064
Тогда ошибка прогноза: Sp=2,62*1,064=2,79
Соответственно доверительный интервал прогноза составит: уp+t*Sp, где t-табличное значение t-критерия Стьюдента. При ά=0,05 и числе степеней свободы n-3= 11 t=2,2010.
уp+2,2010*2,79 или 17,23 +6,14, т.е. 11,09< уp <23,37
Значит, прогнозная величина находится в данном интервале.
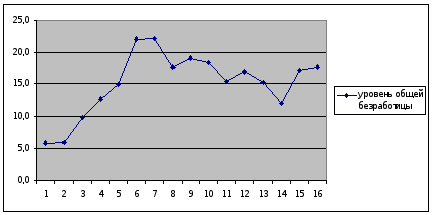
Рис.9. Уровень безработицы при прогнозировании «методом экстраполяции тренда»
III. Метод экспоненциальных средних.
Теперь проведем экспоненциальное сглаживание и прогноз (Exsponential Smoothing and Forecasting) временного ряда в ППП «Statistira 5.5».
Таблица 5. Экспоненциальное сглаживание и прогноз.
Exp. smoothing: S0=19,76 T0=19,08 (new1.sta)
Damped trend, no season ; Alpha=,100 Gamma=,100 Phi=,100
Уровень безработицы
| годы |
уровень |
Qt | остатки |
| 1992 | 5,8 | 5,8498 | -0,0498 |
| 1993 | 5,9 | 5,9 | 0 |
| 1994 | 9,8 | 6,0017 | 3,798 |
| 1995 | 12,7 | 9,969 | 2,731 |
| 1996 | 14,9 | 12,919 | 1,981 |
| 1997 | 22 | 15,157 | 6,843 |
| 1998 | 22,2 | 22,379 | -0,179 |
| 1999 | 17,7 | 22,583 | -4,883 |
| 2000 | 19,1 | 18,005 | 1,095 |
| 2001 | 18,4 | 19,429 | -1,029 |
| 2002 | 15,4 | 18,717 | -3,317 |
| 2003 | 16,9 | 15,666 | 1,234 |
| 2004 | 15,3 | 17,1914 | -1,8914 |
| 2005 | 12 | 15,564 | -3,564 |
| 2006 | 12,2069 |
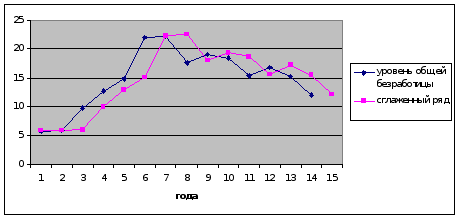
Рис. 10. Экспоненциальное сглаживание.
Таким образом, по результатам проведенного анализа следует, что уровень безработицы в 2006 году возрастет по сравнению с 2005г. на 0,2% и составит 60,6 тыс.человек.
Заключение
В настоящей работе было рассмотрено такое понятие как безработица, ее сущность. Было выяснено, что безработица бывает фрикционная, структурная, добровольная, институциональная и циклическая, а также технологическая, конверсионная, молодежная, вынужденная, скрытая, застойная и другие. Основными показателями безработицы являются: уровень безработицы, частота, длительность безработицы. Еще в работе была рассмотрена методика расчета этих показателей, основные источники получения информации о безработице, а также методы исследования безработицы: метод статистического учета и методы социологического опроса. В данной работе для прогнозирования использовались методы:
1)на основе средних показателей динамики;
2)на основе экстраполяции тренда;
3)на основе скользящих и экспоненциальных средних.
Два первых метода прогнозирования дают почти идентичные результаты. Это