Елементи дисперсійного аналізу і теорії кореляції
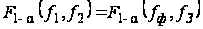
Якщо
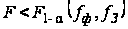
то нульову
гіпотезу приймають,
тобто при заданому
рівні значущості
 приймають
рішення про
те, що вплив
фактора
 можна вважати
несуттєвим.
Якщо
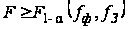
то вплив фактора
визнають значимим.
Отже, метод
дисперсійного
аналізу складається
в перевірці
нульової гіпотези
про рівність
групових середніх
нормальних
сукупностей
з однаковими
дисперсіями.
Для цього досить
перевірити
за критерієм
 нульову гіпотезу
про рівність
факторної і
залишкової
дисперсій.
2 Поняття про кореляцію і регресію
Оцінка залежності між випадковими величинами та поява можливості прогнозувати при цьому значення однієї випадкової величини за значеннями іншої випадкової величини є важливою проблемою статистичного аналізу.
2.1 Функціональна, статистична і кореляційна залежності
Дві випадкові величини можуть бути незалежними або пов'язаними між собою визначеною функціональною залежністю, або залежністю особливого типу, що називається статистичною (стохастичною).
Статистичною називають залежність, при якій зміна однієї з випадкових величин спричиняє зміну розподілу іншої випадкової величини. Статистична залежність виявляється зокрема в тому, що при зміні однієї з величин змінюється середнє значення іншої; при цьому статистичну залежність називають кореляційною.
Прикладом такої кореляційної залежності є зв'язок між внесеними в землю добривами і отриманим врожаєм зерна. Відомо, що твердого функціонального зв'язку між цими величинами немає у зв'язку з впливом безлічі випадкових факторів (опади, температура повітря й ін.). Однак досвід свідчить, що зміна кількості внесених добрив змінює середню врожайність.
2.2 Умовне математичне сподівання, коефіцієнт кореляції і регресія двовимірної випадкової величини в теорії ймовірностей
У теорії
ймовірностей
при описі системи
двох випадкових
величин
 і
 було введено
поняття умовного
математичного
сподівання
(регресії) для
дискретних
і для неперервних
випадкових
величин, відповідно
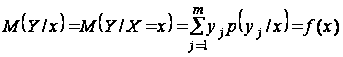
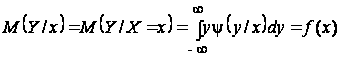
де
 – визначене
можливе значення
випадкової
величини
;
 (
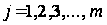 ) – можливі значення
величини
;
 – відповідні
умовні ймовірності;
 – умовна щільність
ймовірності
випадкової
величини
при
 ;
 – функція регресії
на
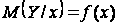 (8)
– рівняння
регресії
на
.
Аналогічно
визначаються
умовне математичне
сподівання
випадкової
величини
і функція, а
також рівняння
регресії
на
:
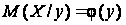 (9)
Функції
і
 (рівняння регресії),
що уявляють
інтерес, у загальному
випадку невідомі,
тому їх шукають
у наближеному
вигляді, причому
звичайно обмежуються
лінійним наближенням:
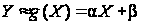 (10)
де
і
 – параметри,
що підлягають
визначенню.
Найчастіше
для цього вживають
метод найменших
квадратів.
Функцію
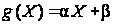 називають
"найкращим
наближенням"
у сенсі методу
найменших
квадратів, якщо
математичне
сподівання
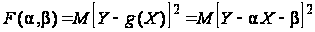 (11)
приймає
найменше можливе
значення. При
цьому функцію
 називають
середньоквадратичною
регресією
на
.
У теорії
ймовірностей
доведено, що
лінійна середня
квадратична
регресія
на
має вигляд
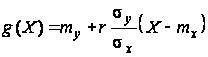
де
 ,
 ,
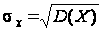 ,
 ,
 – коефіцієнт
кореляції
величин
і
,
 – кореляційний
момент цих
величин.
Можна показати,
що кореляційний
момент
характеризує
зв'язок між
величинами
і
,
зокрема, якщо
вони незалежні,
то

Коефіцієнт

називають
коефіцієнтом
регресії
на
,
а пряму
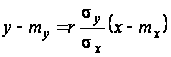 (12)
називають
прямою середньоквадратичної
регресії
на
.
При підстановці
знайдених
значень
 і
 у формулу (11)
отримуємо
мінімальне
значення функції
 ,
що дорівнює
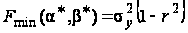
Цю величину
називають
залишковою
дисперсією
випадкової
величини
щодо випадкової
величини
.
Вона характеризує
похибку, що
виникає під
час заміни
лінійною функцією
(10). При
 залишкова
дисперсія
дорівнює нулю,
тобто в цих
випадках лінійна
функція (10) точно
подає випадкову
величину
.
Це означає, що
при цьому
та
пов'язані лінійною
функціональною
залежністю.
Аналогічний
вигляд має і
пряма середньоквадратичної
регресії
на
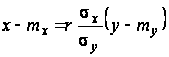 (13)
Очевидно,
що обидві прямі
регресії (12) і
(13) проходять
через спільну
точку
 ,
яка називається
центром спільного
розподілу
величин
і
.
Якщо коефіцієнт
кореляції
 дорівнює нулю,
то пряма регресії
на
(12) є паралельною
осі
,
а пряма регресії
на
(13) – паралельна
осі
 ,
тобто вони є
взаємно ортогональні.
Крім того, при
обидві прямі
регресії співпадають.
Таким чином, значення кута між прямими регресії (12) і (13) характеризує тісноту зв’язку між випадковими величинами: чим менше кут, тим більш тісною є зв’язок.
2.3 Умовне середнє і вибіркова регресія
У математичній
статистиці
вводять вибіркові
оцінки умовного
математичного
сподівання
і регресії. У
якості оцінки
умовного
математичного
сподівання
 беруть умовне
середнє
 ,
яке знаходять
за вибірковими
даними спостережень.
Умовним середнім
називається
середнє арифметичне
значень випадкової
величини
,
що спостерігаються
за умови, яка
випадкова
величина
при цьому має
значення
.
Аналогічно
визначається
і умовне середнє
 ,
однак надалі
для стислості
викладення
обмежимося
в основному
розглядом
тільки
і пов'язаними
з ним питаннями.
Також як і умовне
математичне
сподівання
,
його вибіркова
оцінка є функцією
від змінної
,
що позначимо
через
 і будемо називати
вибірковою
регресією
на
,
а її графік –
вибірковою
лінією регресії
на
.
Крім того, за
аналогією з
рівняннями
(8) і (9) вводяться
вибіркові
рівняння регресії
на
і
на
,
відповідно
 (14)
 (15)
2.4 Визначення параметрів вибіркового рівняння прямої лінії середньоквадратичної регресії за незгрупованих даних
Нехай під час
дослідження
кількісних
ознак (
,
)
у результаті
 незалежних
випробувань
отримано
пар чисел:
 ,
 ,...,
 .
Будемо шукати
функцію
 в лінійному
наближенні
(все аналогічно
проводиться
і для функції
 у випадку регресії
на
).
Крім того, у
припущенні
незгрупованих
даних спостережень
(різні значення
ознаки
і відповідні
їм значення
ознаки
спостерігалися
по одному разу)
 і
можна замінити
на