Автоматизированный априорный анализ статистической совокупности в среде MS Excel
Для нормального распределения Ek=0. Чем больше абсолютная величина |Ek|, тем существеннее распределение отличается от нормального.
При незначительном отклонении Ek от нуля форма кривой эмпирического распределения незначительно отличается от формы нормального распределения.
Вывод:
1. Так как для признака Среднегодовая стоимость основных производственных фондов Ek>0 (Ek<0), то кривая распределения является более островершинной (пологовершинной) по сравнению с нормальной кривой. При этом Ek незначительно (значительно) отличается от нуля (Ek=|0,34|) Следовательно, по данному признаку форма кривой эмпирического распределения значительно (незначительно) отличается от формы нормального распределения.
2.Так как для признака Выпуск продукции Ek>0 (Ek<0), то кривая распределения является более островершинной (пологовершинной) по сравнению с нормальной кривой. При этом Ek незначительно (значительно) отличается от нуля (Ek=|0,21|). Следовательно, по данному признаку форма кривой эмпирического распределения значительно (незначительно) отличается от формы нормального распределения.
III. Экономическая интерпретация результатов статистического исследования предприятий2
Типичны ли образующие выборку предприятия по значениям изучаемых экономических показателей?
Предприятия с резко выделяющимися значениями показателей приведены в табл.2. После их исключения из выборки, оставшиеся 30 предприятий являются типичными (нетипичными) по значениям изучаемых экономических показателей.
Каковы наиболее характерные для предприятий значения показателей среднегодовой стоимости основных производственных фондов и выпуска продукции?
Ответ на
вопрос следует
из анализа
данных табл.9,
где приведен
диапазон значений
признака ( ),
содержащий
наиболее характерные
для предприятий
значения показателей.
Для среднегодовой стоимости основных производственных фондов наиболее характерные значения данного показателя находятся в пределах от 3709,01 млн. руб. до 5230,99 млн. руб. и составляют 66,66% от численности совокупности.
Для выпуска продукции наиболее характерные значения данного показа-теля находятся в пределах от 3266,07 млн. руб. до 5081,66 млн. руб. и составляют 63,33% от численности совокупности.
Насколько сильны различия в экономических характеристиках предприятий выборочной совокупности? Можно ли утверждать, что выборка сформирована из предприятий с достаточно близкими значениями по каждому из показателей?
Ответы на вопросы следуют из значения коэффициента вариации (табл.8), характеризующего степень однородности совокупности (см. вывод к задаче 3б). Максимальное расхождение в значениях показателей определяется размахом вариации Rn. (табл.8).
Для среднегодовой стоимости основных производственных фондов различия в значениях показателя значительны (незначительны). Максимальное расхождение в значениях данного показателя 3200,00 млн. руб.
Какова структура предприятий выборочной совокупности по среднегодовой стоимости основных производственных фондов? Каков удельный вес предприятий с наибольшими, наименьшими и типичными значениями данного показатели? Какие именно это предприятия?
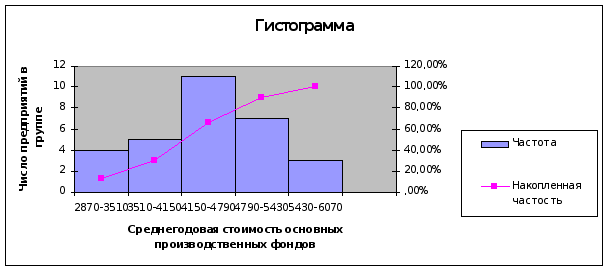
Структура предприятий представлена в табл.7 Рабочего файла.
Предприятия с наиболее типичными значениями показателя входят в интервал от 3709,01 млн. руб. до 5230,99 млн. руб. Их удельный вес 66,66%. Это предприятия №№ 22, 19, 2, 3, 13, 26, 9, 4, 28, 17, 6, 14, 25, 7, 31, 18, 10, 20, 24, 29.
Предприятия с наибольшими значениями показателя входят в интервал от 5430,00 млн. руб. до 6070,00 млн. руб. Их удельный вес 100,00 %. Это предприятия №№ 12, 21, 16.
Предприятия с наименьшими значениями показателя входят в интервал от 2870,00 млн. руб. до 3510,00 млн. руб. Их удельный вес 13,33%. Это предприятия №№ 5, 23, 27, 1.
Носит ли распределение предприятий по группам закономерный характер и какие предприятия (с более высокой или более низкой стоимостью основных фондов) преобладают в совокупности?
Ответ на вопрос следует из вывода к задаче 5 и значения коэффициента асимметрии (табл.8).
Распределение предприятий на группы по среднегодовой стоимости основных производственных фондов носит закономерный характер, близкий к нормальному (незакономерный характер). В совокупности преобладают предприятия с более высокой (низкой) стоимостью основных фондов.
Каковы ожидаемые средние величины среднегодовой стоимости основных фондов и выпуска продукции на предприятиях корпорации в целом? Какое максимальное расхождение в значениях каждого показателя можно ожидать?
Ответ на первый вопрос следует из данных табл.11. Максимальное расхождение в значениях показателя определяется величиной размаха вариации RN.
По корпорации в целом ожидаемые с вероятностью 0,954 средние величины показателей находятся в интервалах:
для среднегодовой стоимости основных производственных фондов – от 4175,39 млн. руб. до 4764,61 млн. руб.;
для выпуска продукции - от 3822,42 млн. руб. до 4525,31 млн. руб.;
Максимальные расхождения в значениях показателей:
для среднегодовой стоимости основных производственных фондов -3200,00 млн. руб.;
для выпуска продукции - 3840,00 млн. руб.
ПРИЛОЖЕНИЕ
Результативные таблицы и графики
| Таблица 2 | ||
| Аномальные единицы наблюдения | ||
| Номер предприятия | Среднегодовая стоимость основных производственных фондов, млн.руб. | Выпуск продукции, млн. руб. |
| 11 | 1910,00 | 4800,00 |
| 30 | 6070,00 | 1600,00 |
| Таблица 3 | |||
| Описательные статистики | |||
| По столбцу "Среднегодовая стоимость основных производственных фондов, млн.руб." | По столбцу "Выпуск продукции, млн.руб" | ||
| Столбец1 | Столбец2 | ||
| Среднее | 4470 | Среднее | 4173,866667 |
| Стандартная ошибка | 141,3123385 | Стандартная ошибка | 168,5734857 |
| Медиана | 4518 | Медиана | 4144 |
| Мода | 4630 | Мода | 4160 |
| Стандартное отклонение | 774,00 | Стандартное отклонение | 923,3150071 |
| Дисперсия выборки | 599075,3103 | Дисперсия выборки | 852510,6023 |
| Эксцесс | -0,34 | Эксцесс | -0,21 |
| Асимметричность | -0,152503649 | Асимметричность | 0,042954448 |
| Интервал | 3200 | Интервал | 3840 |
| Минимум | 2870 | Минимум | 2240 |
| Максимум | 6070 | Максимум | 6080 |
| Сумма | 134100 | Сумма | 125216 |
| Счет | 30 | Счет | 30 |
| Уровень надежности(95,4%) | 294,6096545 | Уровень надежности(95,4%) | 351,4440204 |
| Таблица 4 | |||
| Предельные ошибки выборки | |||
| По столбцу "Среднегодовая стоимость основных производственных фондов, млн.руб." | По столбцу "Выпуск продукции, млн.руб" | ||
| Столбец1 | Столбец2 | ||
| Уровень надежности(68,3%) | 143,8849956 | Уровень надежности(68,3%) | 171,6424447 |
| Таблица 5 | |||
| Выборочные показатели вариации | |||
| По столбцу "Среднегодовая стоимость основных производственных фондов, млн.руб." | По столбцу "Выпуск продукции, млн.руб" | ||
| Стандартное отклонение | 760,9902321 | Стандартное отклонение | 907,7960025 |
| Дисперсия | 579106,1333 | Дисперсия | 824093,5822 |
| Коэффициент вариации, % | 17,02438998 | Коэффициент вариации, % | 21,74952089 |
| Таблица 6 | |
| Карман | Частота |
| 1 | |
| 3510 | 3 |
| 4150 | 5 |
| 4790 | 11 |
| 5430 | 7 |
| 6070 | 3 |
| Таблица 7 | ||
|
Интервальный
ряд распределения
предприятий |
||
| Группа предприятий по стоимости основных фондов | Число предприятий в группе | Накопленная частость группы.% |
| 2870-3510 | 4 | 13,33% |
| 3510-4150 | 5 | 30,00% |
| 4150-4790 | 11 | 66,67% |
| 4790-5430 | 7 | 90,00% |
| 5430-6070 | 3 | 100,00% |
| Итого | 30 | |
ВСЕРОССИЙСКИЙ ЗАОЧНЫЙ ФИНАНСОВО-ЭКОНОМИЧЕСКИЙ ИНСТИТУТ
КАФЕДРА СТАТИСТИКИ
О Т Ч Е Т
о результатах выполнения
компьютерной лабораторной работы
Автоматизированный корреляционно-регрессионный анализ взаимосвязи статистических данных в среде MS Excel
Вариант № 62
Выполнил:
Проверил:
Брянск 2009 г.
1. Постановка задачи статистического исследования
Корреляционно-регрессионный анализ взаимосвязи признаков является составной частью проводимого статистического исследования деятельности 30-ти предприятий и частично использует результаты ЛР-1.
В ЛР-2 изучается взаимосвязь между факторным признаком Среднегодовая стоимость основных производственных фондов (признак Х) и результативным признаком Выпуск продукции (признак Y), значениями которых являются исходные данные ЛР-1 после исключения из них аномальных наблюдений.
| Номер предприятия | Среднегодовая стоимость основных производственных фондов, млн.руб. | Выпуск продукции, млн. руб. |
| 1 | 3446,00 | 3296,00 |
| 2 | 4054,00 | 3616,00 |
| 3 | 4182,00 | 4032,00 |
| 4 | 4406,00 | 4480,00 |
| 5 | 2870,00 | 2240,00 |
| 6 | 4630,00 | 3840,00 |
| 7 | 4758,00 | 5184,00 |
| 8 | 3574,00 | 3520,00 |
| 9 | 4374,00 | 4128,00 |
| 10 | 5046,00 | 5152,00 |
| 12 | 5526,00 | 5440,00 |
| 13 | 4214,00 | 4288,00 |
| 14 | 4630,00 | 4672,00 |
| 15 | 5302,00 | 5664,00 |
| 16 | 6070,00 | 6080,00 |
| 17 | 4534,00 | 4096,00 |
| 18 | 5014,00 | 4864,00 |
| 19 | 3990,00 | 3040,00 |
| 20 | 5078,00 | 4160,00 |
| 21 | 5654,00 | 5600,00 |
| 22 | 3894,00 | 3168,00 |
| 23 | 3094,00 | 2976,00 |
| 24 | 5174,00 | 4768,00 |
| 25 | 4630,00 | 4160,00 |
| 26 | 4310,00 | 3936,00 |
| 27 | 3350,00 | 2560,00 |
| 28 | 4502,00 | 4000,00 |
| 29 | 5206,00 | 4384,00 |
| 31 | 4950,00 | 4160,00 |
| 32 | 3638,00 | 3712,00 |
В процессе статистического исследования необходимо решить ряд задач.
Установить наличие статистической связи между факторным признаком Х и результативным признаком Y графическим методом.
Установить наличие корреляционной связи между признаками Х и Y методом аналитической группировки.
Оценить тесноту связи признаков Х и Y на основе эмпирического корреляционного отношения η.
Построить однофакторную линейную регрессионную модель связи признаков Х и Y, используя инструмент Регрессия надстройки Пакет анализа, и оценить тесноту связи признаков Х и Y на основе линейного коэффициента корреляции r.
Определить адекватность и практическую пригодность построенной линейной регрессионной модели, оценив:
а) значимость и доверительные интервалы коэффициентов а0, а1;
б) индекс детерминации R2 и его значимость;
в) точность регрессионной модели.
Дать экономическую интерпретацию:
а) коэффициента регрессии а1;
б) коэффициента эластичности КЭ;
в) остаточных величин εi.
Найти наиболее адекватное нелинейное уравнение регрессии с помощью средств инструмента Мастер диаграмм.
2. Выводы по результатам выполнения лабораторной работы3
Задача 1
Установление наличия статистической связи между факторным признаком Х и результативным признаком Y графическим методом.
Статистическая связь является разновидностью стохастической (случайной) связи, при которой с изменением факторного признака X закономерным образом изменяется какой–либо из обобщающих статистических показателей распределения результативного признака Y.
Вывод:
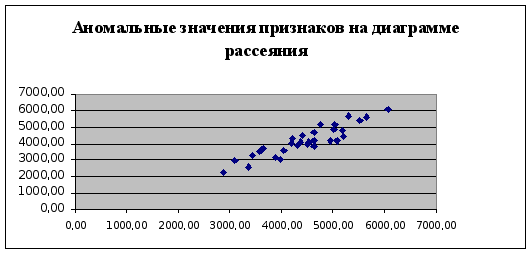
Точечный график связи признаков (диаграмма рассеяния, полученная в ЛР-1 после удаления аномальных наблюдений) позволяет сделать вывод, что имеет (не имеет) место статистическая связь. Предположительный вид связи – линейная (нелинейная) прямая (обратная).
Задача 2
Установление наличия корреляционной связи между признаками Х и Y методом аналитической группировки.
Корреляционная
связь – важнейший
частный случай
стохастической
статистической
связи, когда
под воздействием
вариации факторного
признака Х
закономерно
изменяются
от группы к
группе средние
групповые
значения
 результативного
признака Y
(усредняются
результативные
значения
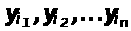 ,
полученные
под воздействием
фактора
 ).
Для выявления
наличия корреляционной
связи используется
метод аналитической
группировки.
Вывод:
Результаты выполнения аналитической группировки предприятий по факторному признаку Среднегодовая стоимость основных производственных фондов даны в табл. 2.2 Рабочего файла, которая показывает, что с увеличением значений факторного признака Х закономерно (незакономерно) увеличиваются (уменьшаются) средние групповые значения результативного признака . Следовательно, между признаками Х и Y существует корреляционная связь.
Задача 3
Оценка тесноты связи признаков Х и Y на основе эмпирического корреляционного отношения.
Для анализа тесноты связи между факторным и результативным признаками рассчитывается показатель η – эмпирическое корреляционное отношение, задаваемое формулой
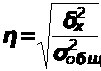 ,
где
 и
 - соответственно
межгрупповая
и общая дисперсии
результативного
признака Y
- Выпуск продукции
(индекс х
дисперсии
означает, что
оценивается
мера влияния
признака Х
на Y).
Для качественной оценки тесноты связи на основе показателя эмпирического корреляционного отношения служит шкала Чэддока:
|
Значение η |
0,1 – 0,3 | 0,3 – 0,5 | 0,5 – 0,7 | 0,7 – 0,9 | 0,9 – 0,99 |
| Сила связи | Слабая | Умеренная | Заметная | Тесная | Весьма тесная |
Результаты выполненных расчетов представлены в табл. 2.4 Рабочего файла.
Вывод:
Значение коэффициента η =0,9028, что в соответствии с оценочной шкалой Чэддока говорит о весьма тесной степени связи изучаемых признаков.
Задача 4
Построение однофакторной линейной регрессионной модели связи изучаемых признаков с помощью инструмента Регрессия надстройки Пакет анализа и оценка тесноты связи на основе линейного коэффициента корреляции r.
4.1. Построение регрессионной модели заключается в нахождении аналитического выражения связи между факторным признаком X и результативным признаком Y.
Инструмент
Регрессия
на основе исходных
данных (xi
, yi),
производит
расчет параметров
а0 и а1
уравнения
однофакторной
линейной регрессии
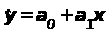 ,
а также вычисление
ряда показателей,
необходимых
для проверки
адекватности
построенного
уравнения
исходным
(фактическим)
данным.
Примечание. В результате работы инструмента Регрессия получены четыре результативные таблицы (начиная с заданной ячейки А75). Эти таблицы выводятся в Рабочий файл без нумерации, поэтому необходимо присвоить им номера табл.2.5 – табл.2.8 в соответствии с их порядком.
Вывод:
Рассчитанные в табл.2.7 (ячейки В91 и В92) коэффициенты а0 и а1 позволяют построить линейную регрессионную модель связи изучаемых признаков в виде уравнения -695,5510+1,0894х.
4.2. В случае линейности функции связи для оценки тесноты связи признаков X и Y, устанавливаемой по построенной модели, используется линейный коэффициент корреляции r.
Значение коэффициента корреляции r приводится в табл.2.5 в ячейке В78 (термин "Множественный R").
Вывод:
Значение коэффициента корреляции r =0,9132, что в соответствии с оценочной шкалой Чэддока говорит о весьма тесной степени связи изучаемых признаков.
Задача 5
Анализ адекватности и практической пригодности построенной линейной регрессионной модели.
Анализ адекватности регрессионной модели преследует цель оценить, насколько построенная теоретическая модель взаимосвязи признаков отражает фактическую зависимость между этими признаками, и тем самым оценить практическую пригодность синтезированной модели связи.
Оценка соответствия построенной регрессионной модели исходным (фактическим) значениям признаков X и Y выполняется в 4 этапа:
оценка статистической значимости коэффициентов уравнения а0, а1 и определение их доверительных интервалов для заданного уровня надежности;
определение практической пригодности построенной модели на основе оценок линейного коэффициента корреляции r и индекса детерминации R2;
проверка значимости уравнения регрессии в целом по F-критерию Фишера;
оценка погрешности регрессионной модели.
5.1 Оценка статистической значимости коэффициентов уравнения и определение их доверительных интервалов
Так как коэффициенты уравнения а0 , а1 рассчитывались, исходя из значений признаков только для 30-ти пар (xi , yi), то полученные значения коэффициентов являются лишь приближенными оценками фактических параметров связи а0 , а1. Поэтому необходимо:
проверить значения коэффициентов на неслучайность (т.е. узнать, насколько они типичны для всей генеральной совокупности предприятий отрасли);
определить (с заданной доверительной вероятностью 0,95 и 0,683) пределы, в которых могут находиться значения а0, а1 для генеральной совокупности предприятий.
Для анализа коэффициентов а0, а1 линейного уравнения регрессии используется табл.2.7, в которой:
– значения коэффициентов а0, а1 приведены в ячейках В91 и В92 соответственно;
– рассчитанный уровень значимости коэффициентов уравнения приведен в ячейках Е91 и Е92;
– доверительные интервалы коэффициентов с уровнем надежности Р=0,95 и Р=0,683 указаны в диапазоне ячеек F91:I92.
5.1.1 Определение значимости коэффициентов уравнения
Уровень значимости – это величина α=1–Р, где Р – заданный уровень надежности (доверительная вероятность).
Режим работы инструмента Регрессия использует по умолчанию уровень надежности Р=0,95. Для этого уровня надежности уровень значимости равен α = 1 – 0,95 = 0,05. Этот уровень значимости считается заданным.
В инструменте Регрессия надстройки Пакет анализа для каждого из коэффициентов а0 и а1 вычисляется уровень его значимости αр, который указан в результативной таблице (табл.2.7 термин "Р-значение"). Если рассчитанный для коэффициентов а0, а1 уровень значимости αр, меньше заданного уровня значимости α= 0,05, то этот коэффициент признается неслучайным (т.е. типичным для генеральной совокупности), в противном случае – случайным.
Примечание. В случае, если признается случайным свободный член а0, то уравнение регрессии целесообразно построить заново без свободного члена а0. В этом случае в диалоговом окне Регрессия необходимо задать те же самые параметры за исключением лишь того, что следует активизировать флажок Константа-ноль (это означает, что модель будет строиться при условии а0=0). В лабораторной работе такой шаг не предусмотрен.
Если незначимым (случайным) является коэффициент регрессии а1, то взаимосвязь между признаками X и Y в принципе не может аппроксимироваться линейной моделью.
Вывод:
Для свободного члена а0 уравнения регрессии рассчитанный уровень значимости есть αр =0,1061. Так как он меньше (больше) заданного уровня значимости α=0,05, то коэффициент а0 признается типичным (случайным).
Для коэффициента регрессии а1 рассчитанный уровень значимости есть αр =0 . Так как он меньше (больше) заданного уровня значимости α=0,05, то коэффициент а1 признается типичным (случайным).
5.1.2 Зависимость доверительных интервалов коэффициентов уравнения от заданного уровня надежности
Доверительные интервалы коэффициентов а0, а1 построенного уравнения регрессии при уровнях надежности Р=0,95 и Р=0,683 представлены в табл.2.7, на основе которой формируется табл.2.9.
Таблица 2.9
Границы доверительных интервалов коэффициентов уравнения
| Коэффициенты | Границы доверительных интервалов | |||
|
Для уровня надежности Р=0,95 |
Для уровня надежности Р=0,683 |
|||
| нижняя | верхняя | нижняя | верхняя | |
|
а0 |
-1548,8999 | 157,7979 | -1119,9924 | -271,1096 |
|
а1 |
0,9012 | 1,2776 | 0,9957 | 1,1830 |
Вывод:
В генеральной совокупности предприятий значение коэффициента а0 следует ожидать с надежностью Р=0,95 в пределах -1548,8999 а0 157,7979, значение коэффициента а1 в пределах 0,9012 а1 1,2776. Уменьшение уровня надежности ведет к расширению (сужению) доверительных интервалов коэффициентов уравнения.
Определение практической пригодности построенной регрессионной модели.
Практическую
пригодность
построенной
модели
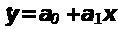 можно
охарактеризовать
по величине
линейного
коэффициента
корреляции
r:
близость
 к единице
свидетельствует
о хорошей
аппроксимации
исходных
(фактических)
данных с помощью
построенной
линейной функции
связи
;
близость
 к нулю означает,
что связь между
фактическими
данными Х и
Y нельзя
аппроксимировать
как построенной,
так и любой
другой линейной
моделью, и,
следовательно,
для моделирования
связи следует
использовать
какую-либо
подходящую
нелинейную
модель.
Пригодность построенной регрессионной модели для практического использования можно оценить и по величине индекса детерминации R2, показывающего, какая часть общей вариации признака Y объясняется в построенной модели вариацией фактора X.
В основе такой оценки лежит равенство R = r (имеющее место для линейных моделей связи), а также шкала Чэддока, устанавливающая качественную характеристику тесноты связи в зависимости от величины r.
Согласно
шкале Чэддока
высокая
степень тесноты
связи
признаков
достигается
лишь при
 >0,7,
т.е. при
 >0,7. Для индекса
детерминации
R2
это означает
выполнение
неравенства
R2
>0,5.
При недостаточно
тесной связи
признаков X,
Y
(слабой, умеренной,
заметной) имеет
место неравенство

 0,7,
а следовательно,
и неравенство
 .
С учетом
вышесказанного,
практическая
пригодность
построенной
модели связи
оценивается
по величине
R2
следующим
образом:
неравенство R2 >0,5 позволяет считать, что построенная модель пригодна для практического применения, т.к. в ней достигается высокая степень тесноты связи признаков X и Y, при которой более 50% вариации признака Y объясняется влиянием фактора Х;
неравенство
означает, что
построенная
модель связи
практического
значения не
имеет ввиду
недостаточной
тесноты связи
между признаками
X и Y, при
которой менее
50% вариации
признака Y
объясняется
влиянием фактора
Х, и, следовательно,
фактор Х влияет
на вариацию
Y в значительно
меньшей степени,
чем другие
(неучтенные
в модели) факторы.
Значение индекса детерминации R2 приводится в табл.2.5 в ячейке В79 (термин "R - квадрат").
Вывод:
Значение линейного коэффициента корреляции r и значение индекса детерминации R2 согласно табл. 2.5 равны: r =0,9132, R2 =0,8339. Поскольку и , то построенная линейная регрессионная модель связи пригодна (не пригодна) для практического использования.
Общая оценка адекватности регрессионной модели по F-критерию Фишера
Адекватность построенной регрессионной модели фактическим данным (xi, yi) устанавливается по критерию Р.Фишера, оценивающему статистическую значимость (неслучайность) индекса детерминации R2.
Рассчитанная
для уравнения
регрессии
оценка значимости
R2 приведена
в табл.2.6 в ячейке
F86 (термин
"Значимость
F"). Если
она меньше
заданного
уровня значимости
α=0,05,
то величина
R2 признается
неслучайной
и, следовательно,
построенное
уравнение
регрессии
может быть
использовано
как модель
связи между
признаками
Х и Y для генеральной
совокупности
предприятий
отрасли.
Вывод:
Рассчитанный уровень значимости αр индекса детерминации R2 есть αр=0. Так как он меньше(больше) заданного уровня значимости α=0,05, то значение R2 признается типичным (случайным) и модель связи между признаками Х и Y -695,5510+1,0894х применима (неприменима) для генеральной совокупности предприятий отрасли в целом.
Оценка погрешности регрессионной модели
Погрешность
регрессионной
модели можно
оценить по
величине стандартной
ошибки
 построенного
линейного
уравнения
регрессии
.
Величина ошибки
оценивается
как среднее
квадратическое
отклонение
по совокупности
отклонений
 исходных
(фактических)
значений yi
признака Y от
его теоретических
значений
 ,
рассчитанных
по построенной
модели.
Погрешность
регрессионной
модели выражается
в процентах
и рассчитывается
как величина
 .100.
В адекватных моделях погрешность не должна превышать 12%-15%.
Значение
 приводится
в выходной
таблице "Регрессионная
статистика"
(табл.2.5) в ячейке
В81 (термин
"Стандартная
ошибка"), значение
 – в таблице
описательных
статистик
(ЛР-1, Лист 1,
табл.3, столбец
2).
Вывод:
Погрешность линейной регрессионной модели составляет .100= .100=9,1749%, что подтверждает (не подтверждает) адекватность построенной модели -695,5510+1,0894х.
Задача 6
Дать экономическую интерпретацию:
1) коэффициента регрессии а1;
3) остаточных
величин
 i.
2) коэффициента эластичности КЭ;
6.1 Экономическая интерпретация коэффициента регрессии а1
В случае
линейного
уравнения
регрессии
 =a0+a1x
величина коэффициента
регрессии a1
показывает,
на сколько в
среднем (в
абсолютном
выражении)
изменяется
значение
результативного
признака Y при
изменении
фактора Х на
единицу его
измерения. Знак
при a1
показывает
направление
этого изменения.
Вывод:
Коэффициент регрессии а1 =1,0894 показывает, что при увеличении факторного признака Среднегодовая стоимость основных производственных фондов на 1 млн руб. значение результативного признака Выпуск продукции увеличивается (уменьшается) в среднем