Основы практического использования прикладного регрессионного анализа
СОДЕРЖАНИЕ
Содержание
Введение
Теоретическая часть
Теоретические основы прикладного регрессионного анализа
Проверка предпосылок и предположений регрессионного анализа
Проверка случайности
Проверка стационарности
Обнаружение выбросов в выборке
Мультиколлинеарность переменных
Рекомендации по устранению мультиколлинеарности
Доверительные интервалы для уравнения регрессии
Определение доверительного интервала для истинного значения уравнения регрессии
Свойства доверительных интервалов
Адекватность модели
Практическая часть
Вывод
Список литературы
ВВЕДЕНИЕ
Общее назначение множественной регрессии (этот термин был впервые использован в работе Пирсона - Pearson, 1908) состоит в анализе связи между несколькими независимыми переменными (называемыми также регрессорами или предикторами) и зависимой переменной. Например, агент по продаже недвижимости мог бы вносить в каждый элемент реестра размер дома (в квадратных футах), число спален, средний доход населения в этом районе в соответствии с данными переписи и субъективную оценку привлекательности дома. Как только эта информация собрана для различных домов, было бы интересно посмотреть, связаны ли и каким образом эти характеристики дома с ценой, по которой он был продан. Например, могло бы оказаться, что число спальных комнат является лучшим предсказывающим фактором (предиктором) для цены продажи дома в некотором специфическом районе, чем "привлекательность" дома (субъективная оценка). Могли бы также обнаружиться и "выбросы", т.е. дома, которые могли бы быть проданы дороже, учитывая их расположение и характеристики.
Специалисты по кадрам обычно используют процедуры множественной регрессии для определения вознаграждения адекватного выполненной работе.
Как только эта так называемая линия регрессии определена, аналитик оказывается в состоянии построить график ожидаемой (предсказанной) оплаты труда и реальных обязательств компании по выплате жалования. Таким образом, аналитик может определить, какие позиции недооценены (лежат ниже линии регрессии), какие оплачиваются слишком высоко (лежат выше линии регрессии), а какие оплачены адекватно.
1. ТЕОРЕТИЧЕСКАЯ ЧАСТЬ
1.1 Теоретические основы прикладного регрессионного анализа
Регрессионный анализ применяется для построения математических зависимостей объектов, явлений по результатам экспериментальных данных, полученных на основе проведения активного или пассивного экспериментов.
Предполагается, что математическая зависимость относится к определенному классу функций с несколькими неизвестными параметрами. В общем виде эти функции представим в виде:
 ,
где
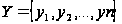 - вектор зависимой
(выходной) переменной
размерностью
 ;
 - матрица
независимых
(входных) переменных
размерностью
 ;
 - вектор неизвестных
параметров
размерностью
 ;
 - вектор возмущений
размерностью
;
 - количество
независимых
переменных;
 - количество
экспериментальных
данных;
 - класс функциональных
зависимостей.
В зависимости
 – является
случайной
величиной,
значения
могут рассматриваться
либо как фиксированные,
либо как случайные.
При этом ожидаемое
значение одной
случайной
переменной
соотносится
с наблюдаемыми
значениями
других случайных
переменных
в виде условной
регрессии.
Рассмотрим
зависимость
между случайными
величинами
и
,
представленную
в виде некоторой
таблицы наблюдений
значений
и
.
Перенося
табличные
значения
и
на плоскость
 ,
получаем поле
корреляции,
приведенное
на рисунке 3.1
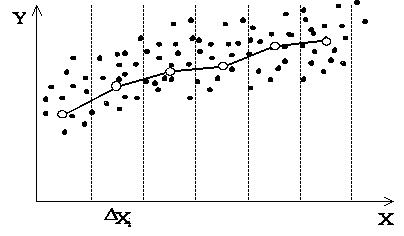
Рисунок 1.1 — Экспериментальное уравнение регрессии
Разобьем
диапазон изменения
 на
 -равных
интервалах
 .
Все точки, попавшие
в интервал
 ,
отнесем к середине
интервала
 ,
в результате
получаем
трансформированное
поле корреляции.
Определим
частичные
средние арифметические
 для каждого
значения
 :
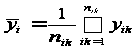 ,
где
 - число точек,
оказавшихся
в интервале,
причем
 ,
где
 - общее число
наблюдений.
Соединим
последовательно
точки с координатами
и
отрезками
прямых. Полученная
ломаная линия
называется
эмпирической
линией регрессии
 по
;
она показывает,
как в среднем
меняется
с изменением
.
Предельное
положение
эмпирической
линии регрессии,
к которому она
стремится при
неограниченном
увеличении
числа наблюдений
и одновременном
уменьшении
,
называется
предельной
теоретической
линией регрессии.
Ее нахождение
и составляет
основную задачу
регрессионного
анализа. Отметим,
что по линии
регрессии
невозможно
точно определить
значение
по
в одном опыте.
Однако зависимость
 позволяет
определить
в среднем значение
при многократном
повторении
опыта при
фиксированном
значении
.
В регрессионном
анализе рассматривается
связь между
одной переменной,
называемой
зависимой, и
несколькими
другими, называемыми
независимыми.
Эта связь
представляется
в виде математической
модели, т.е. в
виде функции
регрессии. Если
функция линейна
относительно
параметров,
но не обязательно
линейна относительно
независимых
переменных,
то говорят о
линейной модели.
В противном
случае нелинейная.
Статистическими
проблемами
обработки в
регрессионном
анализе являются:
а) Получение наилучших точечных и интервальных оценок неизвестных параметров регрессионного анализа;
б) Проверка гипотез относительно этих параметров;
в) Проверка адекватности;
г) Проверка множества предполагаемых предположений.
Исследуемый объект представлен на рисунке 3.2
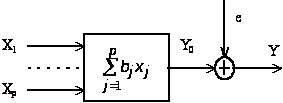
Рисунок 1.2 — Вид исследуемого объекта
Для корректного
использования
регрессионного
анализа существует
следующие
предпосылки
и следующие
допущения на
свойства
регрессионной
ошибки
 ,
 ;
 - значение зависимой
переменной,
полученное
подстановкой
 в уравнение
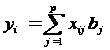 ,
 ,
 ;
- количество
экспериментальных
данных,
 - количество
независимых
переменных:
Приведем свойства и предпосылки регрессионной ошибки:
а) Свойства регрессионной ошибки:
1) В каждом
опыте
 имеет нормальный
закон распределения;
 ,
 .
2) В каждом
опыте математическое
ожидание
равно нулю;
 ,
.
3) Во всех опытах
дисперсия
постоянна и
одинакова;
 ,
.
4) Во всех опытах
ошибки
независимы.
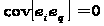 ,
 .
б) предпосылки регрессионной ошибки:
1). Матрица
наблюдений
имеет полный
ранг;
 .
2). Структура модели адекватна истинной зависимости;
3). Значения
случайной
ошибки
не зависят от
значений регрессоров
;
4). Ошибки
регистрации
 регрессоров
пренебрежимо
малы по сравнению
со случайной
ошибкой
 .
1.2 Проверка предпосылок и предположений регрессионного анализа
Регрессионный анализ является одним из самых распространённых методов обработки результатов наблюдений. Он служит основой для целого ряда разделов математической статистики и методов обработки данных. Регрессионный анализ базируется на ряде предположений и предпосылок, нарушение которых приводит к некорректному его использованию и ошибочной интерпретации результатов.
Если F-критерий и показал, что подгонка модели в целом является удовлетворительной; целесообразно провести анализ остатков для проверки соблюдений предпосылок и предположений.
В этом случае исследуется набор отклонений между экспериментальными и предсказанными значениями зависимой переменной,
 .
Проверка предпосылок и предположений регрессионного анализа включает в себя следующие задачи:
1) оценка случайности зависимой переменной;
2) оценка стационарности и эргодичности зависимых и независимых переменных;
3) Проверка гипотезы о нормальности распределения ошибок E;
4) Обнаружение выбросов;
5) Проверка постоянства математического ожидания и дисперсии ошибок;
6) Оценка коррелированности остатков;
7) Обнаружение мультиколлинеарности.
1.2.1 Проверка случайности
Построение
моделей методом
множественного
регрессионного
анализа требуется
выполнение
предположения
случайности
 и
 в
нормальной
линейной модели
вида

где
 – вектор наблюдений
зависимой
переменной;
 – матрица
наблюдений
независимых
переменных;
 – вектор
неизвестных
коэффициентов;
 – вектор
ошибок.
Задача проверки случайности может быть разбита на 2 подзадачи:
1) проверка случайности собственной величины Y;
2) проверка случайности выборки, то есть допущения об отсутствии существенного смещения средней величины во времени.
Первая подзадача
решается с
использованием
критерия серий.
Для этой цели
последовательность
наблюдений
величины Y
представляют
последовательностью
нулей и единиц,
где единицей
обозначают
значение, превышающее
среднее или
медиану, и нулем,
собственно,
значение меньшее
медианы. После
обозначения
вектор наблюдений
преобразуется
в последовательность
серий
 где
 – количество
подряд идущих
элементов
одного вида,
i – номер серии.
Доказано,
что при
 распределение
величины r
близится к
нормальному
с характеристиками


Тогда с вероятностью 0,954 теоретическое число серий r будет находиться в пределах
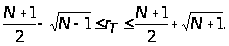
Если фактическое
значение
 попадает в
указанные
пределы, то Y
можно считать
случайной
величиной.
Серией называется последовательность наблюдаемых значений, перед которыми и после которых расположены наблюдаемые значения другой категории. Если последовательность N наблюдений представляет собой независимые наблюденные значения одной и той же случайной величины, т.е. вероятность знаков (+) и (–) не меняется от одного наблюдения к другому, то выборочное распределение числа серий в последовательности есть случайная величина r со средним значением
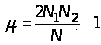 (3.1)
и дисперсией
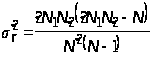 (3.2)
Здесь
 – число наблюдений
со знаком (+),
 – число наблюдений
со знаком (–).
Когда
 соотношения
(3.1) и (3.2) принимают
вид
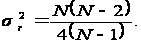
Для решения
второй подзадачи
используется
метод последовательных
разностей.
Элементы исследуемой
выборки
 располагаются
в порядке получения
наблюдений
и для них вычисляются
выборочные
среднее и дисперсия
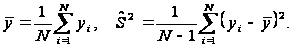
Определяют
разности
 между соседними
наблюдениями
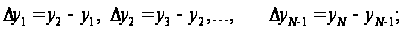
и математическое ожидание квадрата разности
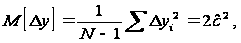
где
 – оценка генеральной
дисперсии.
Фактическая величина критерия случайности выборки
 .
Теоретическое значение критерия
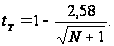
При
 для конкретного
N гипотеза
случайности
отвергается.
1.2.2 Проверка стационарности
Анализ случайных процессов может производиться осреднением величин по ансамблю выборочных реализаций или по одной реализации.
Поскольку на практике проверка по ансамблю достаточно длинных выборочных реализаций неосуществима, то для использования тестов проверки стационарности процесса принимается ряд допущений:
а) проверка заключается в исследовании поведения не ансамбля, а его отдельных реализаций; это означает, что доказательство внутренней стационарности отдельных реализаций может служить доказательством стационарности случайного процесса, которому принадлежит эта реализация;
б) для большинства процессов достаточно проверить слабую стационарность, поскольку, во-первых, для эффективного использования спектрального и корреляционного анализа случайных процессов достаточно выполнения условия слабой стационарности, а во-вторых, для реальных процессов обычно слабая стационарность влечет за собой и строгую; если процесс определяется нормальной плотностью, то это доказательство осуществляется автоматически, поскольку все моменты высших порядков полностью определяются средним и автокорреляционной функцией;
в) на практике часто стационарность автокорреляционной функции обеспечивается стационарностью дисперсии.
Учитывая
эти допущения,
проверку
стационарности
осуществляют
исследованием
одной реализации
 .
Для этого реализация делится на N равных интервалов таких, что её участки в пределах каждого интервала можно считать независимыми. Для всех интервалов вычисляются средние значения и средние значения квадратов, из которых составляются две последовательности и затем их проверяют на наличие тренда.
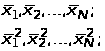
Если известно
выборочное
распределение,
то для проверки
можно использовать
существующие
непараметрические
критерии (t-критерий
Стьюдента,
