Разработка АРМ научно-технической библиотеки университета
Аналогично таблица Группа будет связываться с таблицей Читатель отношением типа «один ко многим» через первичный ключ Код_группы, потому как в любой группе может содержаться множество читателей, но каждый читатель содержится в одной группе. Таблица Города, имеющая первичный ключ Код_города связана с таблицей Читатель в отношении «один ко многим», аналогично связаны таблицы Улицы, Фамилии, Имена и Отчества, у которых первичными ключами являются Код_улицы, Код_Фамилии, Код_имени и Код_отчества соответственно. Так же таблица Читатель, имеющая первичный ключ Номер_читателя, связана с таблицей Выдача в отношении «один ко многим».
3.2 Разработка таблиц.
3.2.1 Построение таблиц.
После разработки проекта приложения можно приступать к непосредственному его созданию.
В Microsoft VFP существует три способа создания таблицы:
Использование мастера баз данных для создания всех таблиц входящих в базу данных, содержащей все требуемые представления, индексы, хранимые процедуры и связи за одну операцию. Мастер баз данных создает новую базу данных, его нельзя использовать для добавления новых таблиц, индексов, представлений, связей и хранимых процедур в уже существующую базу данных.
Использование мастера таблиц позволяет выбрать поля для данной таблицы из множества определенных ранее таблиц, таких как деловые контакты, список личного имущества или указать произвольную таблицу. Добавить в существующую базу данных, назначить типы полей, индексы и связи.
Определение всех параметров таблицы в режиме конструктора.
Независимо от метода, примененного для создания таблицы, всегда имеется возможность использовать режим конструктора для дальнейшего изменения макета таблицы, например, для добавления новых полей, определения типов, индексов и связей.
В дальнейшем, используя, конструктор базы данных создаём проекты таблиц, указываем типы данных и свойства полей, определяем индексы и устанавливаем связи между таблицами, назначаем методы контроля целостности.
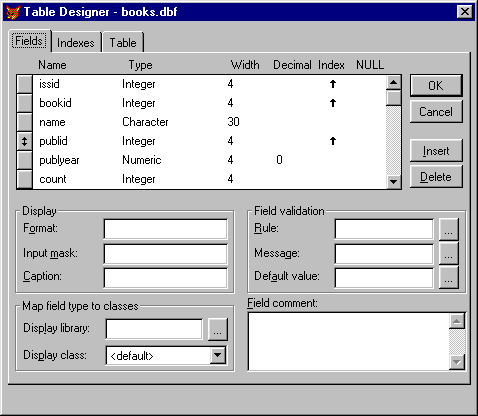
Рис.3.2 Окно конструктора таблиц
В верхней части дизайнера таблиц расположены столбцы, в которых вводится название поля, тип данных, размер поля, наличие простого индекса, направление индексации (по возрастанию, по убыванию), возможность использования значения .NULL., в нижней части окна вводятся формат поля, формат маски ввода, заголовок поля, процедуры для проверки вводимых значений, сообщения, значение по умолчанию и комментарий для поля.
Для оптимизации работы с таблицами существует несколько возможностей:
Проектировать таблицы, в которых не содержится избыточных данных.
Выбирать наиболее подходящий тип данных для поля – это приведёт к уменьшению размера таблицы и увеличит скорость выполнения операций. При описании таблицы следует задавать для него тип данных наименьшего размера, позволяющий хранить нужные данные.
Microsoft Visual FoxPro поддерживает тринадцать типов данных:
|
Тип данных |
Использование |
Размер |
| Character | Алфавитно-цифровые данные | До 254 байт |
| Currency | Денежные суммы |
8 байт |
| Numeric/ Float | Числовые данные | До 20 байт |
| Date | Дата | 8 байт |
| Data/Time | Дата-время | 8 байт |
| Double |
Числа двойной точности с плавающей точкой (18 разрядов) |
8 байт |
| Integer | Целые числа |
4 байта |
| Logical |
Логические данные (.T./.F.) |
1 байт |
| Memo | Алфавитно-числовые данные | Ограничено свободным местом на диске |
| General |
Графические изображения, диаграммы, OLE объекты |
Ограничено свободным местом на диске |
| Character (binary) |
Алфавитно-цифровые данные с символами ASCII от 0 до 255 |
Ограничено свободным местом на диске |
| Memo (binary) |
Алфавитно-цифровые данные с символами ASCII от 0 до 255 |
Ограничено свободным местом на диске |
3.2.2 Назначение типов данных для полей таблиц.
Исходя из выше описанной модели, определим типы полей для таблиц.
Для таблицы Создатели:
Код_создателя – тип данных Integer;
Создатель – тип данных Character, размер порядка 50 символов.
Для таблицы Издательства:
Код_издательства – тип данных Integer;
Название – тип Character, размером 30 символов;
Город – тип Character, размером 20 символов.
Для таблицы Виды издания:
Вид_издания – тип данных Integer;
Название_вида – тип Character, размером 30 символов.
Для таблицы Раздел:
Название_раздела – тип Character, размером 100 символов;
Библиотечный_код – тип Character, размером 20 символов;
Код_раздела – тип данных Integer;
Код_родителя – тип данных Integer.
Для таблицы Издание:
Код_издания – тип данных Integer;
Код_раздела – тип данных Integer;
Заглавие – тип Character, размером 30 символов;
Вид_издания – тип данных Integer;
Код_издательства – тип данных Integer;
Авторский_знак – тип Character, размером 10 символов;
Год_издания – тип Numeric, размером 4 символов;
Аннотация – тип Memo.
Для таблицы Переплёты:
Номер_переплёта – тип данных Integer;
Код_издания – тип данных Integer;
Дата_приобретения – тип Date.
Для Таблицы Группа:
Код_группы – тип данных Integer;
Название_группы – тип Character, размером 30 символов;
Код_родителя – тип данных Integer.
Для таблицы Читатели:
Номер_читателя – тип данных Integer;
Код_группы – тип данных Integer;
Код_фамилии – тип данных Integer;
Код_имени – тип данных Integer;
Код_отчества – тип данных Integer;
Код_города – тип данных Integer;
Код_улицы – тип данных Integer;
Дом_Квартира – тип Character, размером 20 символов;
Номер_телефона – тип Character, размером 15 символов;
Дата_рождения – тип Date;
Дата_регистрации – тип Date;
Комментарий – тип Memo.
Для таблицы Авторы:
Код_создателя – тип данных Integer.
Код_издания – тип данных Integer.
Для таблицы Составители:
Код_создателя – тип данных Integer.
Код_издания – тип данных Integer.
Для таблицы Редакторы:
Код_создателя – тип данных Integer.
Код_издания – тип данных Integer.
Для таблицы Выдача:
Номер_переплёта – тип данных Integer.
Номер_читателя – тип данных Integer.
Дата_выдачи – тип Date;
Дата_сдачи – тип Date.
Для таблицы Фамилии:
Код_фамилии – тип данных Integer.
Фамилия – тип Character, размером 30 символов.
Для таблицы Имена:
Код_имени – тип данных Integer.
Имя – тип Character, размером 30 символов.
Для таблицы Отчества:
Код_отчества – тип данных Integer.
Отчество – тип Character, размером 30 символов.
Для таблицы Города:
Код_города – тип данных Integer.
Город – тип Character, размером 30 символов.
Для Таблицы Улицы:
Код_улицы – тип данных Integer.
Улица – тип Character, размером 30 символов.
На основе выше изложенного создадим следующую структуру таблиц для использования при разработке АРМ.
| Раздел (Issue.dbf) | ||||
| № | Название | Тип | Значение | |
| размер | ||||
| 1 | Id | Integer | 4 | Уникальный номер раздела |
| 2 | Bbk | Character | 20 | Номер по ББК |
| 3 | Name | Character | 100 | Название раздела |
| 4 | Parent | Integer | 4 | Номер вышестоящего раздела |
| Издания (Books.dbf) | ||||
| № | Название | Тип | Значение | |
| размер | ||||
| 1 | IssId | Integer | 4 | Номер раздела (Issue.Id) |
| 2 | BookId | Integer | 4 | Уникальный номер книги |
| 3 | Name | Character | 30 | Название книги |
| 4 | BookType | Integer | 4 | Код вида издания |
| 5 | PublId | Integer | 4 | Номер издательства (Publisher.PublId) |
| 6 | PublYear | Numeric | 4 | Год издания |
| 7 | AutorId | Character | 10 | Авторский знак |
| 6 | Date | Date | 8 | Дата поступления |
| 7 | Comment | Memo | 4 | Аннотация |
| Создатели (Creators.dbf) | ||||
| № | Название | Тип | Значение | |
| размер | ||||
| 1 | NameId | Integer | 4 | Уникальный номер значения |
| 2 | Name | Character | 50 | Значение |
| Виды изданий (TypePubl.dbf) | ||||
| № | Название | Тип | Значение | |
| размер | ||||
| 1 | NameId | Integer | 4 | Уникальный номер значения |
| 2 | Name | Character | 30 | Значение |
| Авторы (Autor.dbf) | ||||
| № | Название | Тип | Значение | |
| Размер | ||||
| 1 | UniqId | Integer | 4 | Уникальный номер записи |
| 2 | BookId | Integer | 4 | Номер книги (Books.BookId) |
| 3 | AutorId | Integer | 4 | Номер автора |
| Составители (Compilers.dbf) | ||||
| № | Название | Тип | Значение | |
| Размер | ||||
| 1 | CreatorId | Integer | 4 | Код создателя |
| 2 | BookId | Integer | 4 | Код издания |
| 3 | UniqId | Integer | 4 | Уникальный ключ |
| Редакторы (Editors.dbf) | ||||
| № | Название | Тип | Значение | |
| Размер | ||||
| 1 | CreatorId | Integer | 4 | Код создателя |
| 2 | BookId | Integer | 4 | Код издания |
| 3 | UniqId | Integer | 4 | Уникальный ключ |
| Издательства (Publisher.dbf) | ||||
| № | Название | Тип | Значение | |
| Размер | ||||
| 1 | PublId | Integer | 4 | Уникальный номер издательства |
| 2 | PublName | Character | 30 | Название издательства |
| 3 | PublCity | Character | 20 | Город издательства |
| Переплёты (BookNum.dbf) | ||||
| № | Название | Тип | Значение | |
| Размер | ||||
| 1 | BookId | Integer | 4 | Номер книги (Books.BookId) |
| 2 | Number | Integer | 4 | Инвентарный номер книги |
| 3 | Date | Date | 8 | Дата поступления экземпляра |
| Группы (Groups.dbf) | ||||
| № | Название | Тип | Значение | |
| Размер | ||||
| 1 | Id | Integer | 4 | Уникальный номер группы |
| 2 | Name | Character | 30 | Название группы |
| 3 | Parent | Integer | 4 | Номер вышестоящего раздела |
| Читатели (Abonents.dbf) | ||||
| № | Название | Тип | Значение | |
| размер | ||||
| 1 | GrId | Integer | 4 | Номер группы (Groups.Id) |
| 2 | AbonId | Integer | 4 | Уникальный номер абонента |
| 3 | Name1 | Integer | 4 | Номер фамилии из словаря |
| 4 | Name2 | Integer | 4 | Номер имени из словаря |
| 5 | Name3 | Integer | 4 | Номер отчества из словаря |
| 6 | CityId | Integer | 4 | Номер города из словаря |
| 7 | StreetId | Integer | 4 | Номер улицы из словаря |
| 8 | House_ Fl | Character | 20 | Номер дома и номер квартиры |
| 9 | Telefon | Character | 15 | Номер телефона |
| 10 | Date1 | Date | 8 | Дата рождения |
| 11 | Date2 | Date | 8 | Дата регистрации |
| 12 | Comment | Memo | 4 | Комментарии к карточке абонента |
| Выдача (BookUse.dbf) | ||||
| № | Название | Тип | Значение | |
| Размер | ||||
| 1 | UniqId | Integer | 4 | Уникальный номер записи |
| 2 | AbonId | Integer | 4 | Номер абонента (Abonents.AbonId) |
| 3 | Number | Integer | 4 | Инвентарный номер книги (BookNum.Number) |
| 4 | Date1 | Date | 8 | Дата выдачи книги |
| 5 | Date2 | Date | 8 | Дата сдачи книги |
| Фамилии (Name1.dbf) | ||||
| № | Название | Тип | Значение | |
| размер | ||||
| 1 | NameId | Integer | 4 | Уникальный номер значения |
| 2 | Name | Character | 30 | Значение |
| Имена (Name2.dbf) | ||||
| № | Название | Тип | Значение | |
| размер | ||||
| 1 | NameId | Integer | 4 | Уникальный номер значения |
| 2 | Name | Character | 30 | Значение |
| Отчества (Name3.dbf) | ||||
| № | Название | Тип | Значение | |
| размер | ||||
| 1 | NameId | Integer | 4 | Уникальный номер значения |
| 2 | Name | Character | 30 | Значение |
| Города (City.dbf) | ||||
| № | Название | Тип | Значение | |
| размер | ||||
| 1 | CityId | Integer | 4 | Уникальный номер значения |
| 2 | City | Character | 30 | Значение |
| Улицы (Streets.dbf) | ||||
| № | Название | Тип | Значение | |
| Размер | ||||
| 1 | StreetId | Integer | 4 | Уникальный номер значения |
| 2 | Street | Character | 30 | Значение |
3.2.3 Создание индексов и связей между таблицами
Чем больше хранится данных в таблицах, тем больше индексов необходимо для эффективного поиска данных. Индекс – это внутренняя таблица, состоящая из двух столбцов: значение выражения, в котором содержатся все поля, включенные в индекс, и местоположение каждой записи таблицы с данным значением индексного выражения. Для создания индексов по ключевым полям, необходимо установить тип индекса Primary. Для внешних ключей используется тип Regular.
Определив необходимые таблицы и индексы, создадим связи таблиц.
Как уже было описано выше, все таблицы в базе данных будут связаны между собой отношением «один ко многим». Для установления связи между таблицами следует соединить первичный ключ таблицы, находящийся на стороне отношения «один» с соответствующим ему внешним ключом таблицы на стороне отношения «многие».
После установки связи, можно определить критерии обеспечения целостности, для любого действия в главной таблице которое изменяет ключевое значение, таких как, добавление, удаление и изменения.
Для изменения и удаления записей возможно введения одного из следующих правил:
Cascade – замена или удаление всех записей в подчинённой таблице, удовлетворяющих старому ключевому значению главной таблице.
Restrict – проверяет наличие в подчинённой таблице значений удовлетворяющих текущему значению главного ключа, и при их наличии запрещает изменения или удаление.
Ignore – игнорирует ссылочную целостность и позволяет изменять или удалять значения главного ключа.
Для добавления записей можно определить только два правила проверки:
Restrict – запрещает добавление, если в главной таблице отсутствует запись с подходящим ключевым значением.
Ignore – не выполняет никаких проверок.
Связи таблиц показаны на рисунке 3.3.
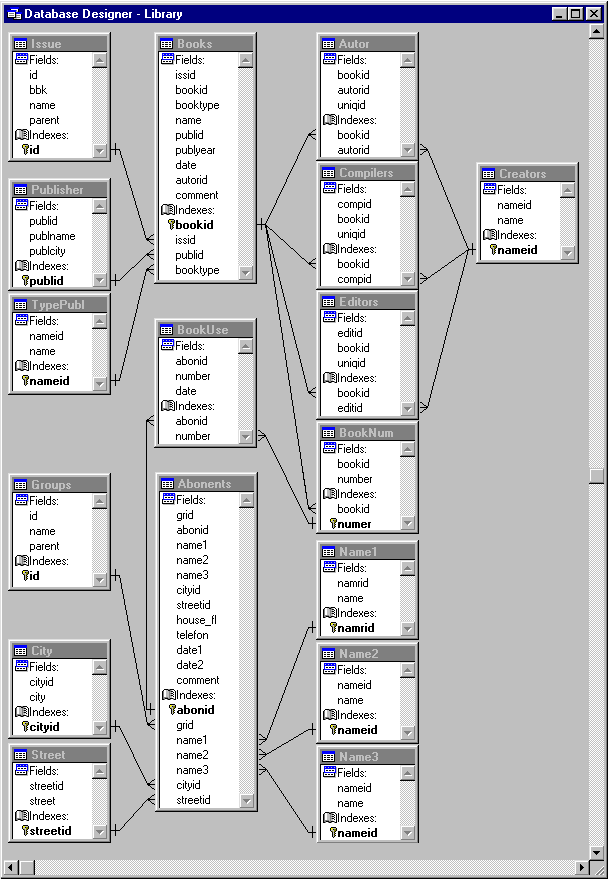
Рис.3.3 Схема связей таблиц
Глава 4. Разработка и реализация алгоритма
4.1 Разработка алгоритма.
Назначение любой базы (в том числе и БРЭА) заключается в получении пользователем базы необходимой ему информации. Кроме того, пользователю должны быть предоставлены возможности пополнения базы данных вновь возникшей информацией и её коррекции в случае изменения тех или иных компонент, хранящихся в базе данных.
Указанные моменты определяют технологический цикл кругооборота информации между пользователем и базой данных, а также основные направления прохождения информации внутри самой базы, иными словами, - взаимодействие отдельных компонент, составляющих в целом базу данных.
Сказанное может быть проиллюстрировано схемой информационных потоков БД, представленной на рис.4.1. От пользователя поступает некоторое множество заданий на выполнение тех или иных информационных действий. Входные формы воспринимают эти задания и инициализируют соответствующие запросы, которые в свою очередь осуществляют поиск необходимой информации в таблицах, где находятся данные, позволяющие выполнить заданные действия. Выбранная информация с помощью исполнительных частей запросов пересылается в выходные формы и представляется пользователю для её оценки и принятия решения.
Обобщённо алгоритм, реализующий данную технологическую схему обработки информации, представляет собой следующую совокупность действий:
1. Выбор соответствующей выходной формы (Формаi, i=l, ).
2. Заполнение полей формы (Формаi, i=l, ).
3. Отображение информации на видеоконтрольном устройстве.
4. Если необходима твёрдая копия полученных данных, то Ввод исходных данных.
5. Анализ исходных данных (Формаi, i=l, N).
6. Если исходные данные корректны, то переход на пункт 4, в противном случае - выдача диагностического сообщения и переход на пункт 1.
7. Передача данных соответствующему запросу (Запросij, i=l, N; j=l, ).
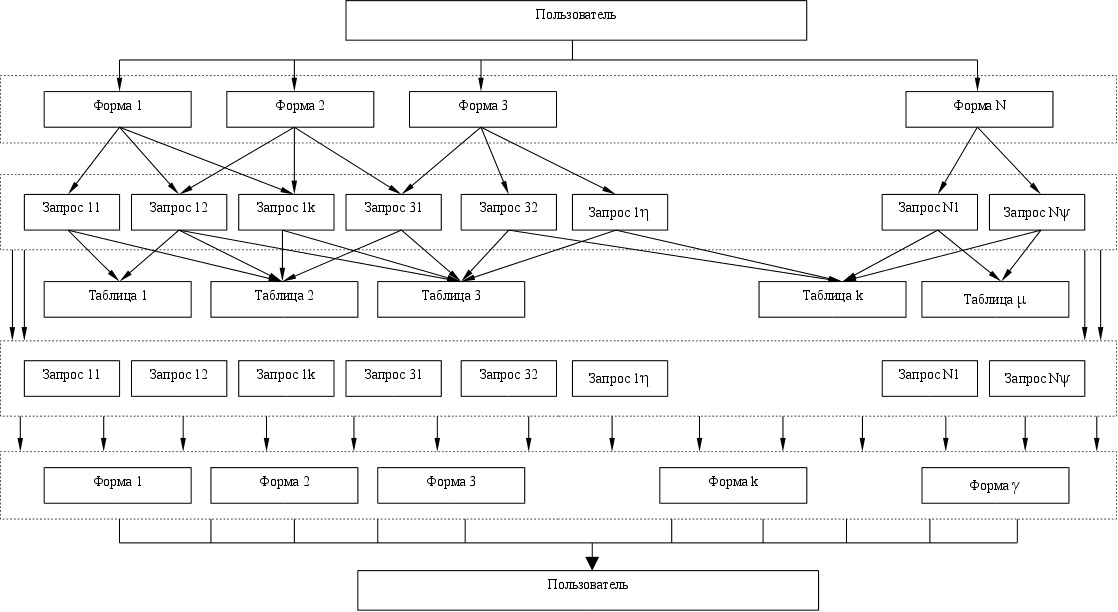
Рис. 4.1 Схема информационных потоков АРМ
8. Анализ параметров и условий выборки информации.
9. Формирование списка таблиц для поиска информации (Таблицаi,...,Таблицаk, i, k).
10. Поиск информации по выбранному списку таблиц в соответствии со значениями параметров и условиями выборки.
11. Если информация, удовлетворяющая заданным параметрам и условиям выборки, отсутствует, то выдаётся соответствующее диагностическое сообщение и переход на пункт 1. При нахождении необходимой информации, она передаётся исполнительным частям запросов (Запросij, i=l ,N; j=l , ) и переход на пункт 9.
12. производится её печать, в противном случае переход на пункт 13.
13. Выяснение необходимости завершить работу с базой данных. Если «Да», то переход на пункт 14, если «Нет», то переход на пункт 1.
14. Конец работы.
Здесь и далее обозначения имеют следующий смысл:
• N - мощность (количество) множества входных форм;
• К,, - мощности множеств запросов, соответствующих входным формам (Формаi, i=l, N);
• -мощность множества таблиц;
• - мощность множества выходных форм.
Данный алгоритм может быть выражен блок-схемой, представленной на рис.4.2. Такое представление даёт возможность более наглядного понимания процесса прохождения информации.
АРМ функционирует в следующих режимах:
Ввод данных в базу данных АРМ;
Просмотр информации из базы данных АРМ;
Коррекция информации в базе данных АРМ;
Формирование выходных документов.
Выбор режимов работы осуществляется пользователем после инициализации программных модулей. Следовательно структурная схема будет иметь вид показанный на рис.
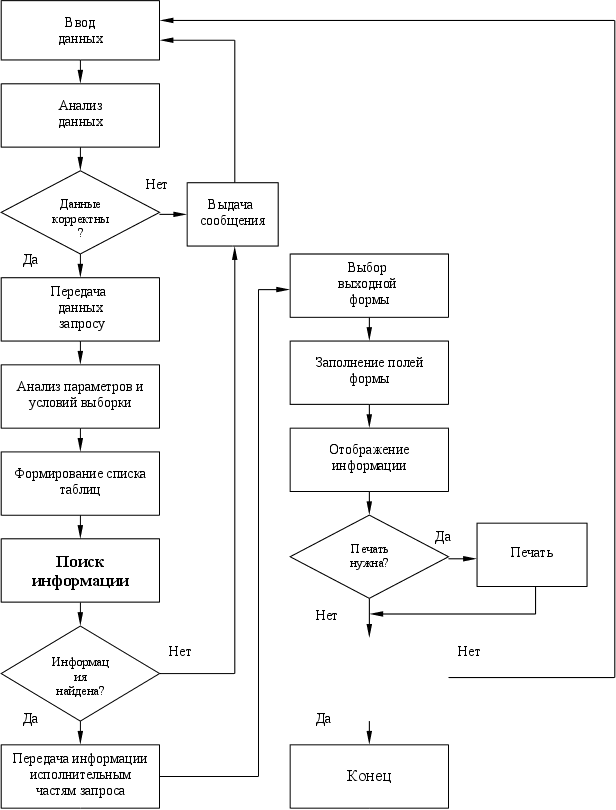
Рис. 4.2 Блок-схема алгоритма, реализующего технологическую схему обработки информации
Рис. 4.3 Структурно-функциональная схема АРМ
В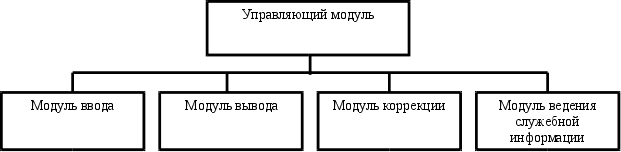
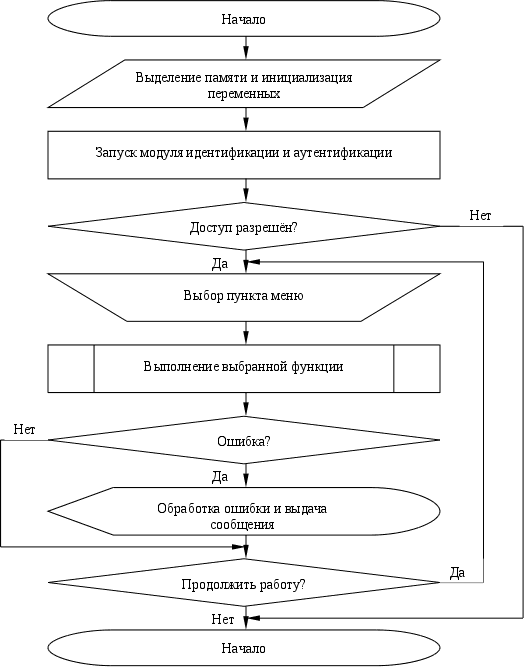
качестве примера
рассмотрим
блок-схему
алгоритма
функционирования
управляющего
модуля. Блок-схема
приведена на
рис.
Рис. 4.4 Блок-схема функционирования алгоритма управляющего модуля
4.2 Реализация алгоритма.
4.2.1 Функциональные модули.
Функционально АРМ состоит из следующих модулей:
Модуль идентификации и аутентификации, предназначенный для определения пользователя и его прав доступа;
Модуль картотеки фондов, предназначен для ввода/просмотра, получения различных отчётов по картотеке фондов;
Модуль картотеки читателей, предназначенный для ввода/просмотра, получения различных отчётов по читателям;
Модуль контроля, обеспечивающий контроль достоверности и целостности базы данных;
Модуль администратора, предназначенный для корректировки системной информации, путей доступа к базе данных, назначения прав доступа для пользователей.
Доступ к функциональным модулям обеспечивается через развитую систему меню.
Вид системы меню представлен на рис.4.5
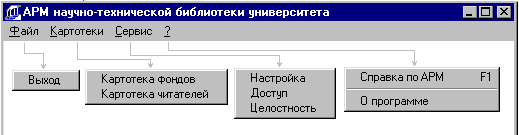
Рис. 4.5 Вид системного меню
4.2.2 Модуль идентификации и аутентификации.
При доступе в программу необходимо производить идентификацию пользователя и его прав для доступа к функциям программы это диктуется тем, что доступ к программе будут иметь не только обслуживающий персонал библиотеки, но и читатели. Форма демонстрирующая этот процесс показана на рис. 4.6.
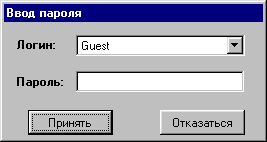
Рис. 4.6 Форма ввода модуля идентификации и аутентификации
П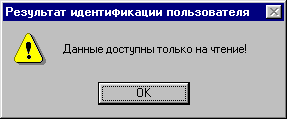
осле
ввода логина
и пароля пользователя
производится
проверка прав
доступа, в случае
наличия прав
только на чтение
выводится
сообщение
показанное
на рис. 4.7, в случае
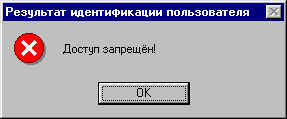
отсутствия
прав доступа
к программе
выводится
сообщение
показанное
на рис. 4.8.
Рис. 4.7 Рис. 4.8
При наличие прав доступа только на чтение некоторые функции будут не доступны.
Создание новых пользователей и назначение прав производится в модуле администратора.
4.2.3 Модуль картотеки фондов.
На рисунке 4.9 показана структурная схема модуля для работы с картотекой фондов. Далее рассмотрим подробнее данную структурную схему.
Схема отображает связи функций и возможные переходы между функциями, отображает входные и выходные формы, позволяет оценить возможности данного модуля.
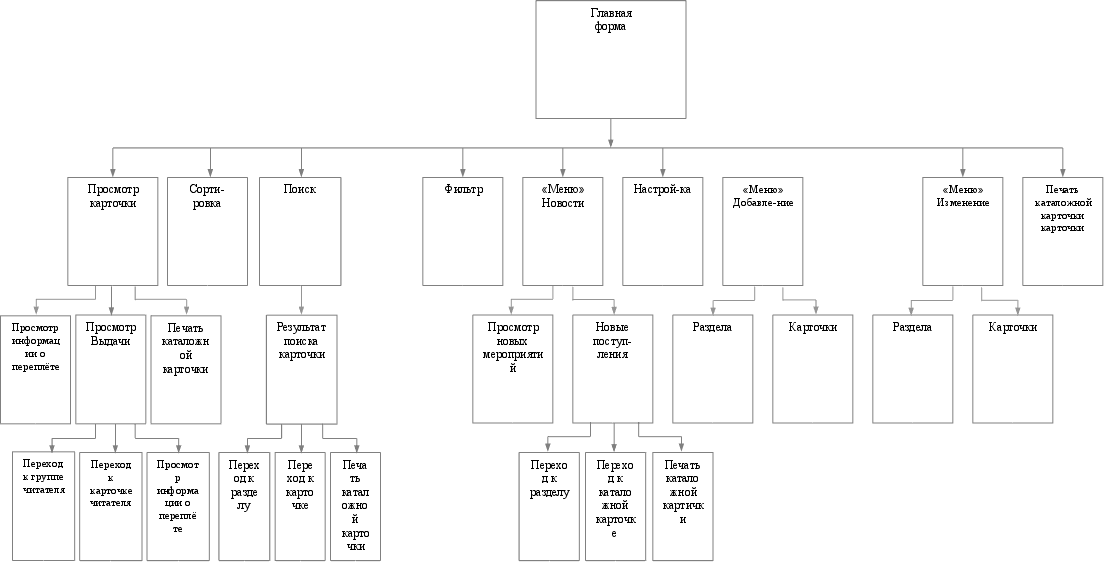
Р

 ис.
4.9 Структурная
схема модуля
картотеки
фондов
4.2.3.1 Главная форма
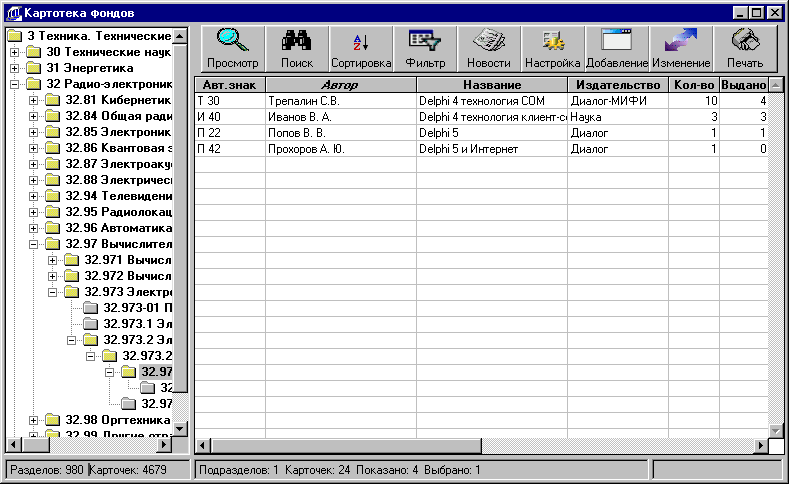 Рис.
4. 10 Главная форма
модуля картотеки
фондов
На рисунке 4.10 представлена главная форма для работы с картотекой фондов. Слева располагается дерево разделов, в котором отображаются названия разделов и их нумерация по ББК. Справа находится таблица, содержащая список литературы для выбранного раздела, в ней отображаются следующие данные:
Автор издания;
Название издания;
Издательство;
Год издания;
Город издателя;
Количество экземпляров;
Количество выданных экземпляров;
Дата поступления.
Вверху справа располагается меню (набор кнопок) для выбора функций, предусмотрены следующие функции:
Просмотр библиографической карточки;
Поиск по выбранным значениям раздела или карточки;
Сортировка разделов и карточек;
Наложение фильтра на выбранный раздел;
Просмотр новых поступлений;
Настройка отображаемых полей формы;
Добавление новых разделов и карточек изданий;
Редактирование добавленных ранее разделов и карточек;
Печать библиографической карточки.
Функции для добавления и изменения информации в картотеке доступны только для авторизированного персонала библиотеки.
В нижней части формы представлена строка статуса, в которой слева отображается общее количество разделов и общее количество карточек изданий, а справа количество подразделов в выбранном разделе, общее количество карточек в этих подразделах, количество карточек в текущем разделе, количество выбранных карточек изданий, а также здесь расположен индикатор, в котором при длительных операциях производится отображение хода процесса.
Для главной формы картотеки фондов рассмотрим получение списка литературы, для этого используются SQL запрос, который будет иметь вид:
SELECT Books.bookid AS BookId, ;
Books.name AS BookName, ;
Books.booktype AS BookType, ;
Typepubl.name AS TypeName, ;
Books.publyear AS PublYear, ;
Creators.name AS AutorName, ;
Publisher.publname AS PublName, ;
Publisher.publcity AS PublCity, ;
Count(‘BookNum.Num’) AS Count, ;
Count(‘BookUse.Num’) AS UseCount, ;
Booksment AS Comment ;
FROM library!Books INNER JOIN library!Autor;
INNER JOIN library!Creators;
INNER JOIN library!BookNum;
INNER JOIN library!BookUse;
INNER JOIN library!Books;
INNER JOIN library!TypePubl ;
ON Typepubl.nameid = Books.booktype ;
ON Publisher.publid = Books.publid ;
ON Booknum.number = Bookuse.number ;
ON Books.bookid = Booknum.bookid ;
ON Creators.nameid = Autor.autorid ;
ON Books.bookid = Autor.bookid;
WHERE Books.issid = lnissid AND ;
EMPTY(BookUse.Date2);
GROUP BY Books.BookId ;
INTO CURSOR vwBooks
Пример 4.1 SQL-запрос получение списка литературы.
В качестве фильтрующего параметра для таблицы изданий Books используется уникальный код раздела из таблицы Issue, а из таблицы выдачи BookUse выбираются записи, для которых не заполнена дата возврата.
4.2.3.2 Просмотр
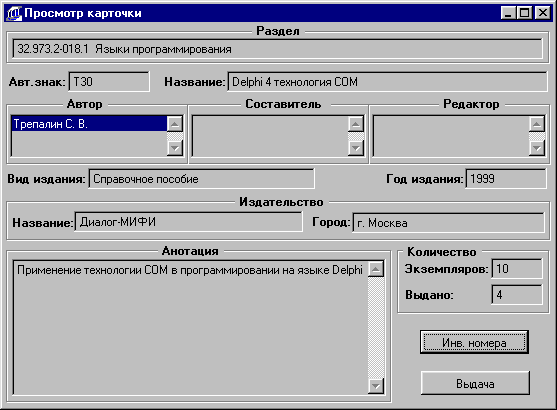
Рис. 4.11 Просмотр карточки издания
На рисунке 4.11 представлена форма развёрнутого просмотра со следующей информацией:
Название раздела;
Номер раздела по ББК;
Автор, составитель и редактор (или их списки);
Название книги;
Название издательства;
Город издательства;
Вид издания;
Год издания;
Количество экземпляров;
Количество выданных экземпляров;
Краткая аннотация.
Данные для формы обеспечиваются на основе SQL-запроса который представлен в примере 4.1, а данные об авторах, составителях, редакторах получают отдельными запросами. Рассмотрим подробнее запрос для получения списка авторов, запрос будет иметь следующий вид:
SELECT Creators.name, ;
Autor.autorid;
FROM library!Creators INNER JOIN library!Autor ;
ON Creators.nameid = Autor.autorid;
WHERE Autor.bookid = lnbookid ;
INTO CURSOR vwAutor
Пример 4.2 SQL-запрос получение списка авторов
В качестве фильтрующего параметра используется уникальный код книги из таблицы Books.
Для данной формы предусмотрены дополнительные функции:
Просмотр выданных экземпляров;
Просмотр инвентарных номеров книг.
Данные функции доступны только для авторизированного персонала библиотеки.
На форме просмотра выданных экземпляров, которая показана на рисунке 4.12 доступна информация о:
группе;
фамилии;
имени;
дате выдачи;
количестве выданных экземпляров.
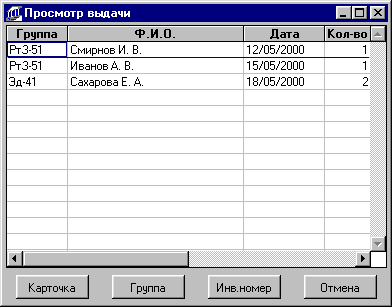
Рис. 4.12 Просмотр выданных экземпляров
Показываются только те экземпляры, которые в текущий момент являются выданными абоненту.
Предусмотрены следующие функциональные возможности:
перехода на карточку абонента;
группу абонентов;
просмотр инвентарных номеров выданных книг;
изменение порядка сортировки отображаемых данных.
Данные для формы получаем SQL-запросом следующего вида:
SELECT Groups.name AS GrpName, ;
Name1.name AS Fam, ;
Name2.name AS Name, ;
Name3.name AS Otch, ;
BookUse.date1 AS Date, ;
COUNT('BookUse.Num') AS Count, ;
Abonents.abonid AS AbonId, ;
BookNum.bookid AS BookId ;
FROM library!BookNum INNER JOIN library!BookUse ;
INNER JOIN library!Abonents ;
INNER JOIN library!Groups ;
INNER JOIN library!Name1 ;
INNER JOIN library!Name2 ;
INNER JOIN library!Name3 ;
ON Name1.nameid = Abonents.name3 ;
ON Name2.nameid = Abonents.name2 ;
ON Name3.nameid = Abonents.name1 ;
ON Groups.id = Abonents.grid ;
ON Abonents.abonid = Bookuse.abonid ;
ON Booknum.number = Bookuse.number ;
WHERE Booknum.bookid = lnBookId ;
AND EMPTY(Bookuse.date2) ;
GROUP BY Abonents.abonid ;
INTO CURSOR vwUseBook
Пример 4.3 SQL-запрос получение списка читателей
В качестве элементов фильтра используется уникальный код книги из таблицы Books и значение поля Date2 таблицы BookUse, которое должно быть не заполненным, так как определяет дату возврата книги в библиотеку.
На форме просмотра инвентарных номеров, которая представлена на рис. 4.13, доступна информация:
список инвентарных номеров;
дате поступления экземпляра книги.
Для получения данных используем SQL-запрос:
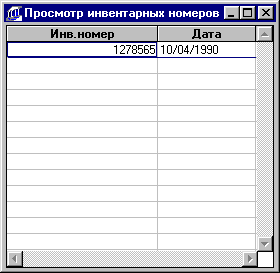
Рис. 4.13 Просмотр инвентарных номеров
SELECT Booknum.number AS InvNum, ;
Booknum.date AS Date ;
FROM library!BookNum;
WHERE Booknum.bookid = lnBookId ;
INTO CURSOR vwInvNum
Пример 4.4 SQL-запрос получение инвентарных номеров
В качестве элемента фильтра применяется уникальный код книги из таблицы