Автоматизированная справочно-информационная система учета и контроля поставок на предприятии
Достоинства реляционной модели можно разделить на две группы:
достоинства для пользователя:
реляционная БД представляет собой набор таблиц с которыми пользователь привык работать;
не нужно помнить пути доступа к данным и строить алгоритмы и процедуры обработки своего запроса;
реляционные языки легки для изучения и освоения, в то время как языки общения с иерархической и сетевой моделями предназначены для программистов и мало пригодны для пользователей;
достоинства обработки данных реляционной БД:
связность. Реляционное представление дает ясную картину взаимосвязей атрибутов из различных отношений;
точность. Направленные связи в реляционной БД отсутствуют. Отношения по своей природе обладают более точным смыслом и поддаются манипулированию с использованием таких средств, как алгебра и исчисление отношений [5], обеспечивающих наглядность и гибкость модели данных;
гибкость. Операции проекции и объединения [17] позволяют разрезать и склеивать отношения, так что программист может получать разнообразные файлы в нужной форме;
секретность. Контроль секретности упрощается. Для каждого отношения имеется возможность задания правомерности доступа, засекреченные показатели можно выделить в отдельные отношения с проверкой прав доступа.
Простота внедрения. Физическое размещение однородных (табличных) файлов намного проще, чем размещение иерархических и сетевых структур.
Независимость данных. БД должна допускать возможность расширения, т.е. добавления новых атрибутов и отношений.
Вывод: поскольку среди перечисленных логических моделей данных реляционная обладает значительными преимуществами и малыми недостатками, то она и будет взята в основу для построения СУБД.
2.3 Выбор концептуальной модели.
Для выбора концептуальной модели данных рассмотрим три их разновидности:
Семантическая модель;
Фреймы;
Модель “сущность-связь”.
Семантическая модель основывается на построении семантической сети. Под семантической сетью понимают ориентированный граф, состоящий из помеченных вершин и дуг и задающий объекты и отношения предметной области. Семантические сети обладают рядом достоинств, а именно:
Описание объектов предметной области происходит естественным языком;
Все записи, поступающие в БД накапливаются в относительно однородной структуре.
Но несмотря на эти преимущества, семантическая модель данных обладает рядом недостатков, один из которых и наиболее существенный, заключается в том, что построение реляционной модели данных на основе семантических сетей затруднено.
Фреймы выражаются структурами данных с привязанными процедурами обработки этих данных. Фреймы могут быть следующих видов: событийные, характеристики, логические предикаты. Использование фреймовой модели так же нецелесообразно, поскольку данная модель не отражает типы связей [14] в реляционной модели данных.
Модель “сущность-связь” описывается в терминах сущность, связь, значение. Сущность – понятие которое может быть идентифицировано. Связь – соединение сущностей. Для представления связей и сущностей введен специальный метод: ER-диаграма [27]. Различаются сущности трех основных классов: стержневые, ассоциативные и характеристические. Стержневая сущность – это независимая сущность (ей свойственно независимое существование). Ассоциативная сущность или ассоциация рассматривается как связь между двумя или более сущностями типа "многие -ко- многим" или подобные им. Характеристическая сущность (или характеристика) представляет собой сущность, единственная цель которой, в рамках рассматриваемой предметной области, состоит в описании или уточнении некоторой другой сущности. ER-диаграма – графическое представление взаимосвязей сущностей. Каждое множество сущностей представляется прямоугольником, а множество связей – ромбом. Связи могут быть трех типов: “один к одному”, “один ко многим”, “многие ко многим”. данные типы связи присущи реляционной модели, как и сущности, которым в реляционной модели соответствуют таблицы.
Вывод: в связи с тем, что модель “сущность-связь” наиболее близка по принципам организации к реляционной модели и реализация последней на основе первой наиболее удобна, то в качестве концептуальной модели выбрана модель “сущность-связь”.
2.4 Процесс моделирования.
2.4.1 Выделение сущностей.
Сущность “поставщик” является стержневой сущностью разрабатываемой модели. С поставщиком заключается договор, на основании которого ведется вся остальная деятельность предприятии по поставкам, отправление заявки поставщикам, получение от них счета-фактуры, отправление заказа на поставку, получение товара, оплата поставки. В качестве ключа для данной сущности вводится атрибут № Поставщика.
Все сущности , их атрибуты и ключи представлены в табл. 2.1.
Таблица 2.1
-
Название сущности
Атрибут
Ключ
Договор
№Договора, дата договора, сумма договора, срок действия.
№Договора
Поставщик
№Поставщика, наименование поставщика, адрес, телефон.
№Поставщика
Ассортимент товаров
№Товара, наименование товара.
№Товара
Заявка
№Заявки, ассортимент заявки, номер договора, дата заявки.
№Заявки
Заказ
№Заказа, №Договора, ассортимент заказа, дата заказа, номер счета.
№Заказа
Счет-фактура
№Счета, ассортимент счета, цена за единицу товара, сумма счета.
№Счета
2.4.2. Выделение связей между сущностями
Выделение связей между сущностями осуществляется на основании анализа предметной области. Все выделенные связи представлены на рис.2.1


Рис 2.1. Связи между сущностями
2.5 Построение логической модели.
Выполнив анализ сущностей и связей меду ними построим логическую модель, в виде отношений (таблица 2.2)
Таблица 2.2
-
Название сущности
Атрибут
Ключ
Договор
№Договора, дата договора, сумма договора, срок действия.
№Договора
Поставщик
№Поставщика, наименование поставщика, адрес, телефон.
№Поставщика
Ассортимент товаров
№Товара, наименование товара.
№Товара
Заявка
№Заявки, номер договора, дата заявки.
№Заявки
Заявка
№Заявки, №товара, количество.
№Заявки, №Товара
Ассортимент заявки
№Заказа, №Договора, дата заказа, номер счета.
№Заказа
Ассортимент заказа
№Заказа, №Заявки, №товара.
№Заказа, №Заявки, №товара.
Счет-фактура
№Счета, сумма счета.
№Счета
Цены поставщика
№Счета, №Заявки, №Товара.
№Счета, №Заявки, №Товара.
-
Для построения логической модели данных использовалось case - средство [17] ER-Win, которое позволяет проектировать реляционные модели данных как на физическом уровне (ER-диаграмы), так и на физическом (проектирование таблиц БД).
Логическая модель данных представлена в виде ER-диаграмы на рис. 2.2.
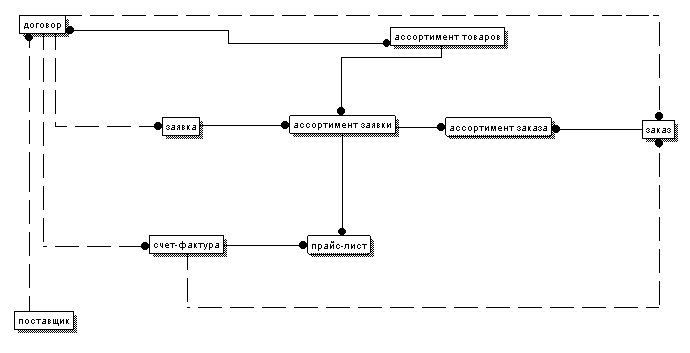
Рис 2.2 ER-диаграмма модели данных АСИС “Учет поставок”
3. Проектирование алгоритмов справочно-информационной системы учета и контроля поставок на предприятие.
Алгоритмизация в самом общем виде может быть определена как процесс направленного действия проектировщика (группы проектировщиков), необходимый для выработки алгоритмов, достаточных для реализации создаваемого объекта (системы), удовлетворяющего заданным требованиям [19]. Завершающим этапом алгоритмизации является выпуск набора алгоритмов, отображающий решения, принятые проектировщиком, в форме, необходимой для производства объекта (системы). При проектировании системы я использовал три класса алгоритмов:
Алгоритмы, связанные с проектированием АСИС;
Алгоритмы реляционной алгебры, необходимые для работы с БД;
Алгоритмы расчета необходимых показателей (вычисление задолженности предприятия по оплате поставок, определение оптимального счета-фактуры).
3.1 Выбор метода проектирования АСИС.
Метод — это последовательный процесс создания моделей, которые описывают вполне определёнными средствами различные стороны разрабатываемой программной системы [18]. Методы важны по нескольким причинам. Во-первых , они упорядочивают процесс создания сложных программных систем. Во-вторых , они позволяют менеджерам в процессе разработки оценить степень продвижения и риск.
Обычно методы проектирования делятся на три основные группы;
Метод проектирования сверху вниз;
Метод потоков данных;
Объектно-ориентированное проектирование.
Для структурного проектирования характерна алгоритмическая декомпозиция. Следует отметить , что большинство программ написано в соответствии с этим методом. Тем не менее структурный подход не позволяет выделить абстракции и обеспечить ограничение доступа к данным; он также не предоставляет достаточных средств для организации параллелизма. Структурный метод не может обеспечить создание предельно сложных систем , и он, как правило, неэффективен в объектных и объектно-ориентированных языках программирования. Поэтому данный метод не использовался для проектирования АСИС “Учет поставок”.
В методе потоков данных программная система рассматривается как преобразователь входных потоков в выходные. Метод потоков данных с успехом применялся при решении ряда сложных задач, в частности , в системах информационного обеспечения, где существуют прямые связи между входными и выходными потоками системы и где не требуется уделять особого внимания быстродействию. Но поскольку одним из основных требований предъявляемых к проектируемой АСИС является увеличение скорости автоматизации учета поставок и уменьшение временных затрат на оформление поставок на предприятии, то применение данного метода также нецелесообразно для проектирования АСИС.
Объектно-ориентированное проектирование (object-oriented design, OOD)—это подход в основе которого лежит представление о том , что программную систему нужно проектировать как совокупность взаимодействующих друг с другом объектов, рассматривая каждый объект как экземпляр определённого класса, причём классы образуют иерархию. Объектно-ориентированный подход отражает топологию новейших языков высокого уровня , таких как Object Pascal, C++, Smalltalk [23] и др. Модели, для проектирования которой используется вышеназванный подход проектирования присущи четыре главных элемента:
Абстрагирование;
Инкапсуляция;
Модульность;
Иерархия.
Абстрагирование позволяет выделить существенные характеристики проектируемого объекта, отличающие его от других объектов;
Инкапсуляция – процесс отделения друг от друга элементов объекта, определяющих его устройство и поведение. Она позволяет изолировать контрактные обязательства абстракции от их реализации.
Модульность – свойство системы, которая была разложена на внутренне связные, но слабо связанные между собой модули.
Иерархия – упорядочивание абстракций, расположение их по уровням.
Абстракция и инкапсуляция дополняют друг друга. Абстрагирование направлено на наблюдение поведения объекта извне, а инкапсуляция определяет четкие границы между различными абстракциями, т.е. наблюдение за поведением объекта изнутри.
Использование этих элементов проектирования и позволяет значительно увеличить производительность любой проектируемой системы.
Таким образом, для проектирования АСИС используется объектно-ориентированный подход.
3.2. Анализ алгоритмов работы с базой данных
Система управления разработанной БД использует реляционный подход для построения базы данных [20]. Подобные системы основаны на реляционной модели данных, которые используются для моделирования взаимосвязей между объектами реального мира и для хранения данных об этих объектах. Применение реляционной модели данных [27] обусловлено использованием реляционной алгебры и соответствующих алгоритмов и операций для выполнения действий над данными. Использование алгоритмов реляционной алгебры [20] позволяет обеспечить высокую производительность работы с базой данных.
Основные операции реляционной алгебры были впервые предложены Коддом [26]. Он доказал, что запросы, формулируемые с помощью языка исчисления могут быть сформулированы в языках реляционной алгебры и наоборот [18], т.е запросы представленные с помощью языка реляционной алгебры могут быть использованы для выполнения запросов к разработанной БД. Ниже приведен ряд запросов к БД:
SELECT nomer_dogovora, postav.nomer_postav, dogovor.nomer_postav,
naimen_post
FROM postav, dogovor
WHERE postav.nomer_postav=dogovor.nomer_postav
SELECT select nomer_zajavki, zajavka.nomer_dogovora,
dogovor.nomer_dogovora, naimen_post,postav.nomer_postav,
dogovor.nomer_postav
FROM from zajavka,dogovor,postav
WHERE (zajavka.nomer_dogovora=dogovor.nomer_dogovora)
AND (postav.nomer_postav=dogovor.nomer_postav)
SELECT nomer_zakaza, zakaz.nomer_dogovora, dogovor.nomer_dogovora,
naimen_post,postav.nomer_postav, dogovor.nomer_postav
FROM zakaz, dogovor, postav
WHERE (zakaz.nomer_dogovora=dogovor.nomer_dogovora)
AND (postav.nomer_postav=dogovor.nomer_postav)
Рассмотрим четыре операции над отношениями [20]:
Селекция;
Проекция;
Теоретико-множественное объединение;
Соединение.
Селекция (selected_on – подвергнутые селекции по) уменьшает количество строк в таблице, и ее можно представить как результат разрезания таблицы по горизонтали и удаления ненужных кортежей. Формально селекция записывается так:
R selected_on [<предикат>] {синтаксис языка запросов (SQL)}
Здесь <предикат> - это логическое выражение, которое может содержать сравнения значений одних атрибутов со значениями других в том же кортеже или с константами. В результате сохраняются только строки, удовлетворяющие <предикату>.
Операция селекции соответствует программам, которые выбирают записи из файлов и печатают эти записи. Однако условия отбора могут относится только к отдельно взятым записям. Например, невозможно выбрать запись, исходя из того, что значение какого-либо ее поля равно или больше, чем значение этого поля в предидущей записи. В действительности почти невозможно смоделировать поведение автомата с конечным числом состояний, который изменяет свое состояние для каждой записи, изменяя тем самым критерии отбора для следующей записи.
Проекция (projected_to – спроецированное на) уменьшает количество столбцов в таблице; данную операцию можно представить себе как разрезание по вертикали название операции имеет своим источником понятие проекции множества точек N-мерного пространства в пространство с меньшим количеством измерений. Например, в результате проекции множества точек плоскости (Х,У) на ось Х получается множество точек, расположенных на этой оси. К сожалению, значения проекций некоторых “точек” могут совпадать; это произойдет в том случае, когда проекция удалит столбец, входящий в ключ, так что оставшиеся части двух “укороченных” кортежей могут быть идентичными. Тогда придется удалить дубликаты и тем самым уменьшить количество строк, т.е. размер БД. Если хотя бы один из возможных ключей при выполнении проекции останется незатронутым, то дубликатов не будет.
Формально проекция записывается следующим образом:
R projected_to <имя-атрибута>{, <имя-атрибута>}
Где список <имен-атрибутов> означает имена сохраняемых столбцов.
Операция проекции соответствует программе отбора несколько иного рода, чем операция селекции, а именно, она печатает определенные поля из каждой записи. Удаление дубликатов обычно достигается в результате сортировки записей по требуемым полям, после чего записи пропускаются до тех пор, пока не изменится значение поля. На практике при одном просмотре файла операция проекции обычно происходит с операцией селекции.
Теоретико-множественное объединение (union) имеет два операнда; она берет строки двух таблиц и размещает их друг за другом, формируя одну длинную таблицу. Это возможно лишь в том случае, когда обе таблицы имеют один и тот же тип, т.е. имеют совпадающие названия (имена) и типы столбцов. Такие таблицы называют “совместимыми по объединению”. Все дубликаты строк должны быть удалены из отношения-результата. Данная операция аналогична объединению множеств в алгебре, но она является дополнительной по отношению к ограничению, так как имеется возможность восстановить отношение путем объединения двух дополняющих друг друга результатов операции селекции.
Операция теоретико-множественного отношения соответствует известной операции “слияния” файлов. Если известно, что файлы не пересекаются, и если порядок записей не играет роли, то достаточно скопировать один файл в конце другого. Однако, как правило, файлы поддерживаются в порядке первичных ключей, и тогда используются простые алгоритмы слияния., считывающие поочередно записи из каждого файла в зависимости от того, в каком из файлов запись имеет ключ с меньшим значением полей, так что в новый файл записи также будут помещаться в порядке первичных ключей.
Соединение (joined_to – соединение с) имеет два операнда; она определена для любых двух таблиц. Если эти две таблицы не имеют столбцов с совпадающими именами, то соединение ведет себя, как декартово произведение, соединяя каждую строку первой таблицы поочередно с каждой строкой второй таблицы. Если имена всех столбцов этих двух таблиц совпадают, то соединение ведет себя как теоретико-множественное пересечение, и создает таблицу, состоящую из тех строк, которые встречаются в каждой из рассматриваемых двух таблиц (такая таблица может быть и пустой, аналогично пустому множеству). Если у двух таблиц-операндов совпадают лишь некоторые имена столбцов, то в результате соединения получается таблица, содержащая все имена столбцов первой таблицы, а также все те имена столбцов второй таблицы, которые не встретились в первой. Строки результата выбираются из первой таблицы, а дополнительные значения конкатенируются (присоединяются) из тех строк второй таблицы, у которых значения в общих столбцах совпадают. До некоторой степени соединения является дополнением проекции, если осуществить проекцию “исходного” отношения так, чтобы получился набор отношений, каждое из которых сохраняет первичный ключ исходного, то соединение этого отношения восстановит исходное при дополнительном условии, что каждый столбец исходного отношения встречается хотя бы в одной из проекций.
При формулировании запросов операция соединения является решающей, если в запросе используется более одного отношения. Как правило, для формирования запроса используется соединение нескольких таблиц, а затем селекция требуемых строк, и , наконец, проекция на требуемые столбцы при печати.
Операция соединения больше всего соответствует операции “селективной выборки”, при выполнении которой список ключей представлен в виде записей в файле транзакций [19], и требуется выбрать или записать в выходной файл соответствующие записи из основного файла. Ключи в файле транзакций могут совпадать, например, с посторонним ключом в основном файле или же с частью первичного ключа, и в этих случаях для каждой записи в файле транзакций может быть выбрано несколько записей из основного файла. Таким образом, используется соединение как обобщенное пересечение [20].
Алгоритмы, которые выполняют вышеперечисленные операции, реализуются на уровне системы управления базой данных. Их содержание формируется на основе определений этих операций. Для их реализации используются или стандартные функции языка программирования , или формируется SQL-запрос. Более подробно реализация будет рассмотрена в следующей главе.
3.3. Проектирование алгоритмов расчёта задолженности по оплате поставок и определения оптимальной заявки.
Данные алгоритмы представлены в виде блок-схем на рис 3.1 и рис 3.2 соответственно:



 нет
 да
 нет

да


 нет


нет