Вопросы по информатике
Если f ( j ; k ) = 0, то термины совсем не ассоциируются, если f ( j ; k ) = 1, то полностью ассоциируемы.
Второй способ: используются матрицы для расширения поиска: вводится некоторое пороговое значение коэффициента ассоциируемости (СКА), выше которого коэффициенты приравниваются к единице, а ниже к 0.
13.Метод ассоциативного индексирования в задаче увеличения полноты поиска.
Основан на использовании матрицы ассоциируемости терминов, которая задаёт для каждой пары терминов показатель ассоциируемости. Абсолютная запись этого ПА между терминами j и k:
f ( j ; k ) = сумм ( i=1 – n ) fij * fjk – частота совместного использования f ( j ; k ) = сумм ( i=1 – n ) fij * fjk / (сумм ( i=1 – n ) fij ^ 2+ сумм ( i=1 – n ) fjk ^ 2 - сумм ( i=1 – n ) fij * fjk - для расчёта относительного значения этого показателя. fij,k – частота появления термина j или k в i – м документе. 0 <= f ( j ; k ) <= 1.
Если f ( j ; k ) = 0, то термины совсем не ассоциируются, если f ( j ; k ) = 1, то полностью ассоциируемы.
Второй способ: используются матрицы для расширения поиска: вводится некоторое пороговое значение коэффициента ассоциируемости (СКА), выше которого коэффициенты приравниваются к единице, а ниже к 0.
14.Метод вероятностного индексирования в задаче увеличения полноты поиска.
Суть: наличие в документе некоторых терминов Т1, Т2, …, Тi позволяет с некоторой вероятностью Р отнести эти документы к классу документов Ск и присвоить вектору документов идентификатор этого класса, т.е. дополнительный термин. Причём указанная вероятность Р для этого “приписывания” должна быть больше некоторого порогового значения.
Вероятность Р записывается: Р(Т1, Т2, …, Тi , Ск) – вероятность того, что при наличии терминов Тi, документ будет принадлежать классу Ск. Р(Т1, Т2, Тi, Ск) = а * р(Ск) * р(Т1, Ск) * (Т2, Ск) * … * (Тi, Ск)
Коэффициент а подбирается таким образом, чтобы выполнялось условие: сумма(к=1, m) Р(Т1, Т2, …, Тi , Ск) = 1 – т.е. чтобы выполнялась полная группа событий. Документ, содержащий термин Т1, Т2, …, Тi обязательно должен принадлежать одному из классов Ск.
m – число классов документов нашего массива.
Р(Ск) – вероятность класса Ск. Эта вероятность рассчитывается как частота, в числителе – число документов, находящихся в классе Ск, в знаменателе – общее число документов во всех m классах.
Р(Тj, Ск) – дробь, в числителе – общее число появления термина Тj в документах класса Ск, в знаменателе – общее число появления всех терминов в документах класса Ск.
15.Постановка задачи улучшения точности поиска в текстовой базе данных и основные методы ее решения.
Задача - как можно точнее получать нужные документы.
2 способа:
а). Использование наиболее узких терминов.
б). Использование словосочетаний для индексирования документов. Для определения словосочетаний используются статистический и лингвистический подходы.
Статистический подход (СП):
В соответствии со СП словосочетание – такая комбинация терминов, частота совместного появления которых в массивах документов велика относительно частот появления отдельных терминов этого словосочетания. Связность терминов определяется коэффициентом связности:
Сik = Fkj / ( Fk * Fj ) * N – это связность 2-х терминов, хотя может быть и больше (до 4-х).
Fk , Fj – частные частоты терминов k и j. Вопрос 15(окончание).
Fkj – частота совместного появления терминов.
N – число слов в массиве.
После расчёта этих значений и коэффициента связности (КС) в словосочетании отбирают такие термины, для которых Сjк и Fkj больше порогового значения, которое устанавливается эмпирически. Пороговые значения: Сjк >= 20 и Fkj >= 3.
Если эти характеристики для термов, включённых в словосочетание поддерживаются, то получаются хорошие выборки.
Недостаток:
не учитывается порядок слов в словосочетаниях;
метод позволяет считать идентичными даже словосочетания с одинаковым порядком следования термина.
Лингвистические методы – используют упрощённые синтаксические разборы предложений, причём, как правило, предложений из заголовков текстов.
Алгоритм анализа упрощённых фраз:
Образуются предводительные словосочетания путём проставления скобок перед предлогами, числительными, неопределёнными местоимениями и т.д.
Устанавливаются связи справа и/или слева от слов, выделенных в первом пункте между различными структурами.
Из структуры исключаются количественные числительные, вспомогательные глаголы, местоимения и т.д. Остаются лишь индексационные словосочетания. В результате должны остаться связи или комбинации вида: сущ. – сущ. (прил. - прил.).
Пример: (Some investigations)(in computer science)(which can lead)(to the creation)(of artificial intelligence). В результате имеем:
Computer science - >investigations -> artificial intelligence -> creation.
16.Статистический метод образования словосочетаний в задаче улучшения точности поиска в текстовой базе данных.
В соответствии со СП словосочетание – такая комбинация терминов, частота совместного появления которых в массивах документов велика относительно частот появления отдельных терминов этого словосочетания. Связность терминов определяется коэффициентом связности:
Сik = Fkj / ( Fk * Fj ) * N – это связность 2-х терминов, хотя может быть и больше (до 4-х).
Fk , Fj – частные частоты терминов k и j.
Fkj – частота совместного появления терминов.
N – число слов в массиве.
После расчёта этих значений и коэффициента связности (КС) в словосочетании отбирают такие термины, для которых Сjк и Fkj больше порогового значения, которое устанавливается эмпирически. Пороговые значения: Сjк >= 20 и Fkj >= 3.
Если эти характеристики для термов, включённых в словосочетание поддерживаются, то получаются хорошие выборки.
Недостаток:
не учитывается порядок слов в словосочетаниях;
метод позволяет считать идентичными даже словосочетания с одинаковым порядком следования термина.
17.Лингвистический метод образования словосочетаний в задаче улучшения точности поиска в текстовой базе данных.
Лингвистические методы – используют упрощённые синтаксические разборы предложений, причём, как правило, предложений из заголовков текстов.
Алгоритм анализа упрощённых фраз:
Образуются предварительные словосочетания путём проставления скобок перед предлогами, числительными, неопределёнными местоимениями и т.д.
Устанавливаются связи справа и/или слева от слов, выделенных в первом пункте между различными структурами.
Из структуры исключаются количественные числительные, вспомогательные глаголы, местоимения и т.д. Остаются лишь индексационные словосочетания. В результате должны остаться связи или комбинации вида: сущ. – сущ. (прил. - прил.).
Пример: (Some investigations)(in computer science)(which can lead)(to the creation)(of artificial intelligence). В результате имеем:
Computer science - >investigations -> artificial intelligence -> creation.
18.Задача автоматического реферирования текстов и методы ее решения.
Задача создания рефератов – задача выявления списка документов и краткое его представление.
Исходные данные:
массив исходных данных;
готовые вектора документов (т.е. уже должна быть решена задача создания векторов {tik , wik}).
Методы для автореферирования:
Расчётный – определяются веса словосочетаний, содержащих 2 значимых термина из вектора документа.
w = 1 / 2t * wi1 * wi2 – вес словосочетания из 2-х терминов .
wi1 и w i2 - веса 1-го и 2-го термина из вектора.
t – количество слов в тексте между терминами ti1 и t i2, которые не являются значимыми.
Далее по тексту определяется значимое предложение. Это такое предложение, которое содержит большое число значимых групп. После расчёта значимости предложений, они упорядочиваются и для реферирования выбираются наиболее значимые. Далее наиболее значимые предложения упорядочиваются так, как они шли в тексте, чтобы не потерять логику.
Позиционный метод. Включает в себя следующие не альтернативные шаги:
Наиболее значимые предложения, которые либо начинают, либо заканчивают абзац или раздел.
Исключаются вопросительные предложения, несмотря на их положение в абзаце.
К значимым относятся предложения, содержащие слова – подсказки. Например: “ данная (слово-подсказка) работа выполнена по такому – то плану и т.д.”
Из значимых исключаются те предложения, в которых есть ссылки на рисунки, таблицы, цитаты и т.д.
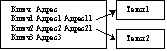

 19.Цепочечные текстовые файлы.
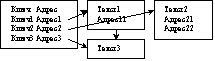
К самой БД добавляется справочник, который имеет следующую структуру:
Ключ – значимое слово, характеризующее тот или иной документ. Рядом пишется адресная ссылка на тот текстовый файл, который имеет данный ключ в качестве значимого термина. И к этой подстроке добавляются собственно текстовые файлы.
Цепочечная модель: сколько индексных терминов в тексте выделено столько и должно быть ссылок.
Преимущества:
Максимальная длина поиска определяется самой длинной цепочкой;
Новые записи (тексты) можно ставить в начало цепи, что упрощает её корректировку.
Недостатки:
Цепи могут быть длинными, если некоторые ключи используются довольно часто;
Необходимость выделения памяти для хранения адресных ссылок в самих текстах;
Если справочник очень велик, он значительно усложняет работу с текстами и требует организации дополнительного доступа к себе самому.
20.Инвертированные текстовые файлы.
Получаются из цепочечных файлов, когда в справочник включаются адресные ссылки на все тексты, имеющие соответствующий ключ в качестве индексационного термина.
Недостаток: переменное число адресов в справочнике.
Достоинство: быстрый поиск релевантных документов, так как их адреса находятся сразу в справочнике, обработку которого можно организовать в оперативной памяти.
21.Рассредоточенные текстовые файлы.
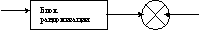
Весь массив документов разбивается на группы файлов, ключевые термины которых связаны некоторым математическим соотношением. Тогда поиск в справочнике заменяется вычислительной процедурой, которая называется хешированием, рандомизацией или перемешиванием.
Здесь нет справочника, а существует вычислительная процедура, т.е. блок, называемый блоком рандомизации, который по ключу (поисковому термину) на основании вычислительной процедуры определяет адрес, по которому находится текст.
Ключ адрес этот участок
{ключ} памяти
называется
бакетом
В этой области памяти находится несколько текстов, каждый из которых характеризуется по своему в векторе документов. Т.е. адрес получается по вычислительной процедуре.
Преимущества:
Быстрый вычисляемый доступ;
Из-за отсутствия справочника экономится память.
Недостатки:
Сложность при выборе метода хеширования;
Применяется для коротких векторов запросов, когда в поиске участвует немного слов;
Изменения векторов документов порождает сложность в ведении файлов.
 Вопрос 27(окончание).
4. Коррекция кластеров сверху вниз.
В начале строятся один или несколько очень больших кластеров, которые затем разбиваются на более мелкие.
Способы выбора исходных классов:
В качестве центров классов используются случайные документы;
Классом с именем i можно считать множество документов, в векторах которых находится термин i;
В качестве исходных классов принимаются все документы, признанные релевантными некоторому запросу по результатам предыдущих поисковых операций.
Процесс коррекции кластеров:
Вычисляется КП между каждым документом и каждым центроидом кластера;
Кластеры переопределяются путём отнесения документов к тем из них, по отношению к которым, они имеют наибольшее подобие;
Формируются центроиды новых кластеров.
Эти 3 шага выполняются до тех пор, пока:
Будет необходимость в изменениях;
Чтобы процесс не был бесконечным, он выполняется в заданное число итераций.
5.Однократная кластеризация.
Документы рассматриваются в произвольном порядке и каждый документ либо относится к существующему классу, если КП достаточен, либо образует новый кластер.
“+”: каждый документ обрабатывается только 1 раз, => требует мало времени.
“-”: состав и структура классов существенно зависит от порядка рассмотрения документов.
28. Нахождение КЛИК.
Клика – такой вид кластера, в котором каждый документ подобен любому другому документу. Клика формируется тогда, когда возникает полный граф, т.е. полное соотношение подобия между всеми элементами.
А В
С Д
Исходными данными для метода является матрица подобия документа массива, которая заполняется коэффициентами подобия всех пар документов.
Матрица: S(Di , Dj) – диагональная квадратная и симметричная.
i = 1,N ; j = 1,N.
Пусть задано множество пар:
VDi = {(ti , wi)}
VDj = {(tj , wj)}
Коэффициент подобия документов определяется:
S(Di , Dj) = сумм(k =1,N)rk/N
r – отношение; N – мощность множества документов.
0, wi = 0 или wj = 0
rk = wi / wj в противном случае
Чтобы задача решалась адекватно, вектора (*) должны быть упорядочены по терминам, т.е. одни и те же термины должны быть записаны в одних и тех же позициях этих векторов. Исходная матрица, которая получена в результате расчётов, преобразуется в бинарную следующим образом: вводится некоторое пороговое значение T коэффициента подобия, и те коэффициенты, которые меньше его заменяются на 0, в противном случае на 1:
S(Di , Dj) < T , => 0
S(Di , Dj) > T , => 1
Алгоритм:
1.В класс или кластер включаются подгруппы порядка 2, т.е. те элементы, которые в отношении подобия установлены на паре.
2.Из подгруппы порядка 2 получают подгруппу порядка 3 по следующему правилу: если есть подгруппы (Di , Dj) , (Di , Dp) , (Dj , Dp), то получаем: (Di , Dj , Dp) и подгруппы из исходного списка исключаются.
3.Из подгруппы порядка p формируют подгруппу порядка (p+1),т.е. (Di , Dj , … , Dp) => (Di , Dj , … ,
Вопрос 33(продолжение).
Последовательность.
Это свойство гарантирует, что пользователь, освоивший работу в одной части системы не запутается, работая в другой её части.
Выражается в 3-х явлениях:
Последовательность в построении фраз. Т.е. вводимые коды или команды в системе всегда трактуются одинаково;
Последовательность в использовании форматов данных - аналогичные поля всегда представляются в одном формате (противоречит требованию гибкости);
Последовательность в размещении данных на экране.
Рекомендуется следующий шаблон для оформления экрана:
Вверху в 2-х, 3-х строках помещается заголовок и данные о состоянии системы;
Далее, под заголовком размещается область для вывода справочных сообщений;
Основная область – для рисования или для ввода данных;
Ниже – область для вывода сообщений об ошибках;
Описание функциональных клавиш.
Краткость.
Требует от пользователя ввода минимума информации. Это, с одной стороны, убыстряет работу системы, а, с другой, приводит к появлению ошибок.
Рекомендации:
Не следует запрашивать информацию, которую следует сформировать автоматически;
Информация не должна выводится сразу же, только потому, что она стала доступна системе. Она должна выводится только в том объёме, который требуется пользователю и в нужном для него формате.
Поддержка пользователя – мера помощи, которую система оказывает пользователю при работе с ней.
Эта поддержка выражается в 3-х видах:
Инструкции пользователя. Выводятся в виде подсказок или справочной информации. При этом справочная информация должна быть контекстной, своевременной и доступной в любой точке диалога. Помимо внутрисистемной существует внешняя справочная информация, которая сопровождает текст в виде бумажного носителя. Там указывается 5 моментов:
Общий обзор, в котором описывается назначение системы, основные понятия предметной области, необходимые для оценки системы, связанные с этими понятиями принципы работы системы;
Как начать работу с системой;
Сведения о поведении пользователя при выходе системы или отдельных частей из строя;
Пример работы с системой;
Ограничения на систему.
Сообщения об ошибках. Хорошее сообщение об ошибке должно отвечать следующим требованиям:
Должно быть изложено в терминах, понятных пользователю;
Нужно точно определить причину ошибки;
Должно пояснять, как исправить ошибку;
Должно быть своевременным, пока не проделаны вещи, которые необратимы.
Подтверждения каких-либо действий системы.
Гибкость - мера того, насколько хорошо диалог соответствует различным уровням подготовки и производительности труда пользователя. Гибкость называют свойством адаптивности системы.
Существует 3 системы, которые характеризуют её гибкость:
 37.Типы диалогов.
4 типа диалога:
вопрос – ответ;
меню;
командный язык;
экранные формы.
Вопрос – ответ. Самая старая форма ведения диалога. Используется в экспертных системах, в информационно – поисковых системах к фактографическим или документальным базам данных.
3 вида диалога в режиме “вопрос – ответ”:
Диалог с ограничениями на предметную область. Форма запроса – произвольна (ограничений нет), а лексика