Вопросы по информатике
2-й словарь содержит специфические термины, которые характеризуют данную предметную область и, как правило, являются именами полей с записями базы данных. 1-е ограничение: если существуют надёжные окончания, то каждое слово из запроса нужно спроецировать на слова из словаря (где максимальное пересечение, то и брать). 2-е ограничение в рамках диалога – ограничение на язык.
Требования:
Запрос или задание формируется с помощью фраз естественного языка, каждая из которых описывает элемент, операцию, которую надо выполнить.
Каждое предложение должно начинаться с функционального слова, определяющего нужное действие.
При формулировке условий поиска каждое значение поля БД должно предваряться названием этого поля.
3-я форма – естественно языковая без ограничений.
Этот диалог применяется тогда, когда диапазон либо слишком велик, либо вообще не определён.
Последующий запрос зависит от предыдущего, т.е. этот диалог нельзя заранее описать некоторым сценарием.
Меню – ориентированный диалог.
Здесь у пользователя есть список вариантов ответа и он выбирает нужный номер.
Виды меню:
1.
2. С использованием мнемонических обозначений опций (Norton Commander);
3. Блоковое;
4. Строчное меню;
5. Меню в виде пиктограмм.
Требования к меню:
Каждое меню должно содержать 5-6 опций;
При большом числе различных вариантов их надо группировать (подменю);
Пункты меню должны следовать в естественном порядке или по алфавиту.
Применение меню:
Диапазон возможных ответов невелик и они все известны заранее и могут быть представлены явно;
Когда пользователю необходимо видеть сразу все опции для выбора оптимальной, чтобы оценить все возможные варианты;
Когда пользователь неопытен.
 40.Метод нисходящего синтаксического
анализа(СА).
Нисходящий СА (развёртка) – дерево разбора строится от корней к листьям.
СА методом развёртки. Здесь делается предположение, что исходное предложение уже принадлежит языку, а следовательно к ней применяется 1-я продукция грамматики, в которой левая часть является начальным символом грамматики. Этот шаг является 1-м шагом алгоритма развёртки. Введём здесь понятие элемента развёртки, роль которого на 1-м шаге правая часть продукции.
2-й шаг: из элемента развёртки выбирается крайний слева нетерминальный символ. Нетерминальный символ заменяется правой частью продукции с соответствующей левой частью того же списка продукции. Управление передаётся началу 2-го шага этого алгоритма. Если цепочка не содержит нетерминальных символов, она сравнивается с исходной анализируемой цепочкой. Если они совпадают, то конец алгоритма, иначе переход к шагу 3.
Шаг 3: разбор выполняется заново и при альтернативных вариантах продукции выбираются те, которые ранее не использовались. Т.е. выполняется разбор предложения фактически, по несколько другой схеме.
Если в грамматических правилах преобладают правила с одинаковыми левыми частями, оптимальнее выбирать восходящий разбор предложения и наоборот, если превалируют правила с альтернативными правыми частями нужно выбирать нисходящий разбор.
41.Метод восходящего синтаксического анализа(СА)
Восходящий синтаксический анализ СА (свёртка) – дерево разбора строится от листьев к корню.
Алгоритм восходящего левостороннего СА:
Слева во фразе выделяется слово с морфологическими признаками (элемент свёртки). Если фраза пуста, по выполняется шаг 4, иначе следующий шаг;
Элемент свёртки сравнивается с правыми частями продукций. Если его совпадение, то элемент свёртки заменяется на левую часть продукции и выполняется передача на начало шага 2. Если совпадений нет выполняется следующий шаг.
Выбирается элемент из стека. Если при этом стек пуст, то элемент свёртки помещается в стек и выполняется шаг 1, иначе элемент из стека и элемент свёртки заменяются на понятия элемент свёртки и выполняется шаг 2.
Выполняется когда фраза обработана полностью. Здесь выбирается элемент из стека. Это должен быть начальный символ грамматики. В этом случае, если, к тому же, стек пуст, делаем 2 вывода:
Предложение принадлежит языку.
Построили его структуру, которая используется на этапе СеА.
Если условие не выполняется (стек не пуст), то либо предложение построено синтаксически неверно, либо при свёртке были использованы не те продукции. В этом случае возвращаются на тот шаг СА, где была возможность выбора альтернативной продукции.
 45.Задача управления доступом.
При решении этой задачи выделяют 3 понятия:
Субъект – пользователь, который выполняет некоторые операции над данными;
Объект операции доступа – те данные, к которым выполняется доступ;
Вид операции доступа.
В общем случае различают 3 вида доступа:
Неограниченный доступ ко всем данным;
Неограниченный доступ к группе данных;
Ограниченный доступ к группе данных. С ограничением как у субъекта, так и по видам операций.
Подход к управлению доступом.
Использование ключей и замков (идентификация и аутентификация пользователя). Идентификация – характеристики пользователя, которые его определяют. Идентификация позволяет определить себя пользователю, сообщив своё имя. Замок (средство аутентификации) позволяет 2-йстороне (ПК) убедиться что субъект – тот, за кого себя выдаёт.
Способы идентификации:
Пароль, личный идентификационный номер или криптографический ключ и т.д.;
Личная карточка;
Голос или отпечатки пальцев;
Нечто, ассоциируемое с субъектом.
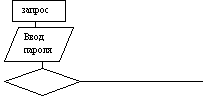
Наиболее распространённый способ – использование паролей, когда аутентификация реализуется в программном обеспечении. Символически алгоритм аутентификации можно представить:
Выход в зависимости от
количества пользователей
Преимущество этого метода – гибкость, доступность и простота реализации.
Недостатки:
Нужно многократно вводить пароль;
Изменение замка оказывает влияние на большое число пользователей;
Замок управления может реализовать только то лицо, которое разрабатывает данное ПО.
Повышение надёжности парольной защиты осуществляется:
Пароль должен быть не слишком коротким и использовать различные символы;
Периодически менять пароли;
Если пароли не встроены в программу, а реализованы в виде файла, то ограничить доступ к файлу паролями;
Если возможны ошибки в пароле, то нужно ограничить число повторных вводов пароля;
Использование генераторов паролей, которые позволяют формировать благозвучные (хорошо запоминающиеся) пароли.
Если в качестве идентификатора используется личная карточка, для аутентификации используется устройство, называемое токеном – устройство, владение которым позволяет определить подлинность пользователя.
2 вида токенов:
Пассивные (токены с памятью);
Активные (интеллектуальные) токены.
Наиболее распространенными в силу дешевизны являются токены 1-го класса. Это устройства с клавиатурой и процессором, а личная карточка снабжена магнитной полосой. При использовании этого токена пользователь с клавиатуры вводит свой идентификационный номер, который проверяется процессором на совпадение с карточкой и далее проверяется подлинность самой карточки. Недостатки: дороговизна, использование специальных устройств чтения, неудобство использования. 22.Кластерные текстовые файлы.
Документы разбиваются на родственные группы, которые называют кластерами или классами. Каждый класс описывается центроидом (профилем) и вектор запроса прежде всего сравнивается с центроидами класса.
Преимущества:
Возможен быстрый поиск, т.к. число классов, как правило, невелико;
Возможно интерактивное сужение (расширение) поиска за счёт исключения или добавления дополнительных кластеров.
Недостатки:
Необходимость формировать кластеры;
Необходимость введения файла центроидов;
Дополнительный расход памяти для файла центроидов или профилей.
23.Основные способы определения центроидов.
1. Логический профиль (обозначается Р1).
Заданы вектора документов в следующем виде:
VDi = (d1 , d2 , d3 , … , dt), где t – число индексационных терминов, выделенных во всех документах нашего массива. Тогда логический профиль определяется как результат с логической “или”:
Р1 = VD1 v VD2 v VD3 v …
1, если термин tk входит в вектор документа Di;
dk (k = 1,t) = 0, в противном случае.
2.Профиль частотного документа (Р2).
Исходные данные также вектора документов. Исходная информация задана прошлой матрицей, а в формуле используются не логическое сложение, а арифметическое:
3.Профиль частотности термина (Р3).
Здесь используются веса терминов в документах:
VDi = (w1 , w2 , w3 , … , wt), где wi – веса терминов входящих в вектор документа VDi.
В вычислении Р3 участвуют веса.
Р3 (k = 1,t) = сумм(j = 1,N) wik , где j – порядковый номер документа; N – число документов кластера; t – число индексационных терминов в массиве; k – порядковый номер термина.
24. Логический способ определения центроидов.
Логический профиль (обозначается Р1).
Заданы вектора документов в следующем виде:
VDi = (d1 , d2 , d3 , … , dt), где t – число индексационных терминов, выделенных во всех документах нашего массива. Тогда логический профиль определяется как результат с логической “или”:
Р1 = VD1 v VD2 v VD3 v …
1, если термин tk входит в вектор документа Di;
dk (k = 1,t) = 0, в противном случае.
25.Профиль частотности документа.
Исходные данные также вектора документов. Исходная информация задана матрицей, а в формуле используются не логическое сложение, а арифметическое:
26.Профиль частотности термина.
Здесь используются веса терминов в документах:
VDi = (w1 , w2 , w3 , … , wt), где wi – веса терминов входящих в вектор документа VDi.
В вычислении Р3 участвуют веса.
Р3 (k = 1,t) = сумм(j = 1,N) wik , где j – порядковый номер документа; N – число документов кластера; t – число индексационных терминов в массиве; k – порядковый номер термина.
Вопрос 28(окончание).
Dp+1), если существуют пары: (Di , Dp+1) , (Dj , Dp+1) , … , (Dp , Dp+1).
Алгоритм заканчивается, когда дальнейшее слияние невозможно.
Недостаток метода: образуется большое число кластеров.
29.Метод одной связи.
Здесь классы представляются документами, между которыми установлены отношения подобия, которые подчиняются следующему требованию: между двумя документами устанавливается связь при выполнении одного из следующих условий: существуют Di , Dj,
S(Di , Dk) , S(Dk , Dj);
S(Di , Dk) , S(Dk , Dm) , S(Dm , Dj);
Самое сильное требование: S(Di , Dk) – если в матрице подобия уже существует подобие.
Если одно из условий выполняется, то документы в одном классе.
30.Кластеризация вокруг выборочных документов.
Вместо построения матрицы подобия используют плотность пространства некоторых документов. В качестве возможных центров кластера выступают те документы, которые по результатам расчётов оказались расположенными в плотных зонах пространства. Все документы в данном методе делятся на 3 класса:
Документы, уже включённые в кластеры;
Документы, ещё не подвергшиеся исследованию(не включенные в кластеры);
Свободные документы. Те документы, относительно которых делалась попытка включения в кластер, но она закончилась неудачей.
Берём документ, пробуем включить его в кластер. Если не получается, то заносим его в множество свободных документов. Далее из свободного множества пытаемся подключить документы к кластеру.
Алгоритм:
Выбирается очередной, не включённый в кластеры документ и считается возможным центром кластера;
Рассчитываются коэффициенты подобия между этим документом, документами свободного типа и документами, не включёнными в классы;
Плотность считается достаточной, если:
существует по меньшей мере n1 документов, коэффициенты подобия которых по отношению к выбранному документу превышает некоторое пороговое значение T1;
Существует по крайней мере n2 документов, коэффициенты подобия (КП) которых, по отношению к исследуемому документу превышают пороговое значение T2;
Если между n2 и T2 существует некоторое соотношение: n2>=n1; T2<=T1, тогда считается, что выбранный документ - “центр массы”, вокруг которого собраны другие документы. Если плотность недостаточна (если одно из условий не выполняется), то документ относят к свободным и аналогичным образом исследуют следующий документ из множества не включенных в кластеры. Если плотность достаточна, то формируют кластер, включающий все свободные документы и не включённые ранее в кластеры документы, для которых КП с исследуемым документом не меньше порогового значения T3. Для нового кластера строится вектор центроида, и все документы, включённые в этот кластер и те, которые включены в остальные кластеры сопоставляются с данным центроидом. Это сопоставление служит для отнесения каждого документа к одной из следующих категорий:
Вопрос 33(окончание).
Фиксированная адаптация. При этом пользователь сам явно выбирает свой уровень подготовки;
Полная адаптивность. Здесь диалоговая система строит модель пользователя, которая меняется автоматически по ходу работы системы.
Косметическая. Занимает промежуточное место между фиксированной полной и достигается использованием специальных приёмов:
Приём использования сокращений (md – mkdir , cd – chdir , *.bak);
Синонимы – пользователь выбирает то, что ему ближе;
Использование объектов по умолчанию и макросы.
34.Естественность и последовательность как критерии хорошего диалога.
Естественность – свойство диалога, в соответствии с которым пользователю не нужно менять свои традиционные способы решения задачи.
Свойство включает следующие аспекты:
Диалог должен вестись на родном языке пользователя;
Стиль ведения диалога должен быть разговорным, т.е. имеется в виду краткость;
Фразы не должны требовать дополнительных пояснений;
Допускается использование жаргона пользователя;
Порядок ведения диалога должен соответствовать порядку, которым обычно пользователь обрабатывает информацию;
Должна быть исключена предварительная обработка данных перед их вводом в систему.
Последовательность.
Это свойство гарантирует, что пользователь, освоивший работу в одной части системы не запутается, работая в другой её части.
Выражается в 3-х явлениях:
Последовательность в построении фраз. Т.е. вводимые коды или команды в системе всегда трактуются одинаково;
Последовательность в использовании форматов данных - аналогичные поля всегда представляются в одном формате (противоречит требованию гибкости);
Последовательность в размещении данных на экране.
Рекомендуется следующий шаблон для оформления экрана:
Вверху в 2-х, 3-х строках помещается заголовок и данные о состоянии системы;
Далее, под заголовком размещается область для вывода справочных сообщений;
Основная область – для рисования или для ввода данных;
Ниже – область для вывода сообщений об ошибках;
Описание функциональных клавиш.
Вопрос 37(окончание).
Командный язык (MS – DOS).
Используется для организации диалога с операционной системой. Требует хорошей квалификации пользователя и команды должны нести смысловую нагрузку.
Параметры командного языка могут быть 2-х типов: позиционные и ключевые.
Применение такого диалога:
Число значений для ввода мало и их можно запомнить;
Задача не требует много данных на вводе;
Опытность пользователя.
Экранная форма.
Позволяет получить сразу всю информацию от пользователя, поскольку он отвечает сразу на несколько вопросов. И, следовательно:
Она быстрее работает;
Может работать с более широким диапазоном данных, чем меню;
Может использоваться пользователем любой квалификации.
Широко используется в Windows.
38.Задача морфологического анализа естественно-языковых текстов.
Морфологический анализ (МА) – выделяет гипотетические основы слов и приписывает им различные грамматические категории. Может включать в себя морфографический анализ;
МА выполняется 2-мя способами:
Декларативный: т.е. словарь системы содержит все всевозможные словоформы языка, с приписанными им грамматическими характеристиками. Словоформы – все возможные модификации, которые существуют в языке;
Процедурный способ проведения МА – когда МА выделяет основу слова по словоизмерительным аффиксам и приписывает этой основе необходимые грамматические характеристики.
Рассмотрим 2-й способ. Состоит из 2-х шагов:
Определение морфологического типа и части речи;
Получение списка гипотетических основ и знаний грамматических категорий.
Для реализации 1-го шага используется таблица словоизмерительных аффиксов, которая приведена в приложении (Л – любой)
39.Задача синтаксического анализа естественно-языковых текстов.
Синтаксический анализ (СА). Преследует 2 цели:
Проверка правильности построения фраз, т.е. соответствие её правилам языка;
Построение синтаксической структуры фразы, которая используется при выполнении следующей фазы – семантического анализа (СеА);
СА использует правила сочетаемости грамматических категорий, например, по числу, падежу и правила построения типичных языковых конструкций.
В зависимости от направления СА он может быть левосторонним и правосторонним. В 1-ом случае исходная фраза анализируется слева направо, во втором – справа налево.
2-й подход классификации: в зависимости от правил применения продукций различают:
восходящий СА (свёртка) – дерево разбора строится от листьев к корню;
нисходящий СА (развёртка) – дерево разбора строится от корней к листьям.
42.Постановка задачи семантического анализа .
Выявляет смысл предложения и отвергает те фразы, которые бессмысленны для данной предметной области. При выполнении СеА используется база знаний(БЗ) по предметной области, представленная как правила для этих задач в виде семантических сетей или фреймов.
Грамматика фразы: “Зелёные идеи яростно спят.”.
Это результат СА структуры.
Семантический анализатор на основе дерева строит следующую семантическую сеть:
Идеи Что делают Спят
Какие ® как
¬
Зелёные Яростно
Эти связи возникли:
Из-за свёртки глагола и наречия в группу глагола (нагружается весом “как”);
Из-за свёртки прилагательного и существительного в группу существительного и нагружается весом “какие”, т.к. прилагательное в предложении как правило является определением;
Из-за свёртки группы существительного и группы глагола в предложение и нагружается весом “что делают”, т.к. эта связка связывает существительное и глагол в предложении.
Построенная семантическая сеть называется ситуативной и возникает в системе по мере прихода и анализа естественно-языковых фраз. Одновременно с ситуативными фразами, в системе существует БЗ, включающая парадигматические отношения между понятиями предметной области, которые тоже представлены некоторой семантической сетью.
Рисунок в приложении.
Между этими вершинами существуют связи, которые носят аналоговый характер. Наша ситуативная семантическая сеть проецируется на БЗ, которая присутствует в системе. Возникают следующие противоречия:
“идеи” и “спят” относятся к таким классам, где существует отношение с весом “никогда”. Аналогично между “идеи и зелёные” и “спят и яростно ” никогда не установятся семантические отношения. Т.о. в