Концептно-ориентированная модель памяти переводов
Рис. 1
Повторяя данную процедуру каждый раз, когда обнаруживается очередное пересечение, мы, в конечном счете, получим направленный граф, узлами которого являются языковые пары, а дугами- отношения включения.
Еще одной оптимизацией является разделение исходного и целевого сегментов каждой языковой пары. Это имеет смысл, поскольку не так уж редки случаи, когда одна и та же исходная фраза переводится на целевой язык по-разному, что порождает две языковые пары с одинаковым первым элементом. Помимо этого, пересечения исходных и целевых сегментов не всегда изоморфны, и их результаты не обязательно образуют языковую пару.
Поэтому разделим языковые пары, и получим два ориентированных графа, "синхронизированных" друг относительно друга (рис. 2). При этом отношения, связывающие вершины разных графов, могут быть различной местности, но обязательно обладают свойством симметричности.
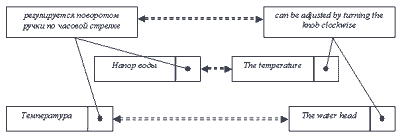
Рис. 2
Развивая идею дальше, вспомним, что в нашем распоряжении уже имеется аппарат, позволяющий формализовать представленную схему. Это- объектно-ориентированный подход. В самом деле, каждому сегменту в базе может быть сопоставлен отдельный класс, отношение включения по своим свойствам идентично отношению наследования, а горизонтальные связи, формирующие языковые пары могут быть заданы механизмом ассоциирования, либо введением в класс метода Translate ("перевести").
Тем не менее, предложенная модель пока что не описывает внутреннюю структуру сегментов, которую необходимо анализировать при создании новой языковой пары на основе пересечения существующих. Для решения этой задачи разобьем все сегменты на отдельные слова (по пробелам). Теперь каждый сегмент может быть представлен классом, являющимся производным от всех слов, образующих текст сегмента. При этом совершенно необязательно иметь перевод для каждого слова, поскольку это будет отражено лишь отсутствием соответствующей связи между узлами графов, а метод Translate будет возвращать "нулевое" значение.
Памятуя о том, что в состав среды перевода помимо памяти переводов входит также терминологический словарь, деление сегментов можно осуществлять не по словам, а по терминам. Наличие терминологического словаря дает и еще одну возможность. Для каждого вхождения термина в сегмент можно определить его начальную форму, то есть ту, в которой он входит в базу словаря. Эта начальная форма послужит как бы абстрактным базовым классом для каждого вхождения термина, а конкретное вхождение будет содержать определение значений заданных в базовом классе атрибутов: род, число, падеж и т. п.
Последнее нововведение подталкивает нас к мысли о том, терминологический словарь можно слить воедино с памятью переводов, представив, тем самым, все ресурсы переводчика в виде универсальной модели (рис. 3).
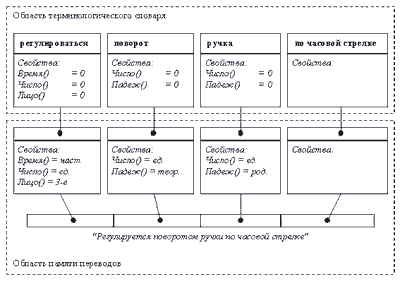
Рис. 3
Поиск и добавление
До тех пор, пока память переводов была линейной, сегменты неделимыми, а сравнение строгим, решение задачи поиска сводилось к введению отношения строгого лексикографического порядка над множеством сегментов на исходном языке. Иными словами, определялся оператор "меньше", на основе которого можно было осуществить обыкновенный двоичный поиск, и проверку на равенство. С введением оператора "нечеткого совпадения", который позволял оценить степень сходства для любых двух сегментов, решение проблемы поиска резко усложнилось и, без дополнительных ухищрений с различного рода индексацией, стало эквивалентно задаче полного перебора. Предложенная многоуровневая модель памяти переводов, собственно, и предоставляет некоторый механизм неявной индексации: каждое входящее в сегмент слово, по сути, идентифицирует некоторое подмножество ориентированного графа памяти переводов, состоящее из узлов, которые можно достичь, начав обход от узла, соответствующего выбранному слову.
Используя особенности выбранной структуры памяти переводов, задачу поиска сегментов, похожих на заданный, можно решить путем выполнения следующих действий (рис. 4):
разбить заданный сегмент на слова;
найти в памяти переводов все узлы, соответствующие этим словам;
спускаясь по графу отношений наследования, помещать в список найденных сегментов все встречаемые узлы.
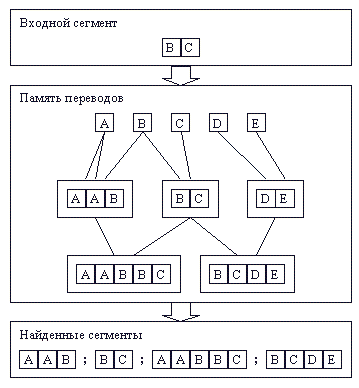
Рис. 4
Резонным представляется вопрос о том, в каком порядке следует предоставлять найденные сегменты переводчику: ведь приведенная процедура поиска выберет из памяти все сегменты, пересекающиеся с заданным по крайней мере по одному слову. Каковы правила фильтрации и сортировки найденных сегментов?
Ответ на этот вопрос лежит за пределами выбранного формализма, однако в этом нет ничего страшного. Дело в том, что результат поиска представляет собой классический вариант одноуровневой памяти переводов, анализ которого может быть произведена методами, формализованными в рамках существующих сред перевода. Для обеспечения эффективности поиска целесообразно осуществлять оценку "пригодности" сегментов по мере их нахождения. Например, если некоторый сегмент полностью совпадает с эталоном, то все его потомки в графе могут быть автоматически исключены из поиска.
Теперь поговорим о задаче добавления нового сегмента в память переводов. Очевидным условием корректности процедуры добавления является обеспечение успешного поиска. Стало быть, добавляемый сегмент должен иметь в числе своих предков (не обязательно прямых) все составляющие его слова. Следуя целям оптимальности, можно заключить, что среди предков должны присутствовать также узлы графа, содержащие фрагменты данного сегмента. Иными словами, если в памяти переводов присутствуют сегменты "AB" и "CD", то сегмент "ABCD" должен стать наследником этих двух сегментов. Аналогично, если в памяти присутствует сегмент "ABCD", то добавляемый сегмент "AB" должен стать его предком. В общем случае при добавлении сегмента в граф памяти переводов могут существовать альтернативные варианты наследования. В такой ситуации схема добавления заметно усложнится. В любом случае, проблема построения оптимальной иерархии классов решается в рамках объектно-ориентированного подхода, поэтому мы не будем заострять здесь на ней внимание.
Вычисление пересечения языковых пар
Поскольку выделение общей части двух сегментов- важный этап предлагаемой технологии перевода, изучим этот вопрос более детально. При этом, помня о том, что сегмент в памяти перевода выступает, чаще всего, не отдельно, а как элемент языковой пары, будем рассматривать именно пересечение пар.
Для начала дадим определения пересечения сегментов. Итак, пересечение сегментов A и B- это множество сегментов Ci, таких что:
каждый из Ci содержится и в A, и в B;
никакие два Ci не содержат одинаковых фрагментов;
не существует такого сегмента D, что и A, и B содержат D, и D содержит один из сегментов Ci.
Приведенное определение не подразумевает выделения из сегментов A и B всех общих фрагментов. Это сделано для того, чтобы можно было использовать алгоритмы различной сложности реализации пересечения.
Теперь перейдем к пересечению языковых пар. Как уже было упомянуто выше, очень важно определить, является ли пересечение изоморфным, иными словами, можно ли считать результаты пересечения исходных и целевых сегментов языковой парой. Два примера иллюстрируют это (рис. 5). В первом случае пару сегментов "достаточно высока" и "ishighenough" имеет смысл поместить в память переводов, поскольку она действительно представляет собой вариант перевода, который может быть повторно использован переводчиком. Во втором случае- это совершенно очевидно- сегменту "достаточно" не следует сопоставлять сегмент "ishighenough", поскольку данная языковая пара будет некорректной.
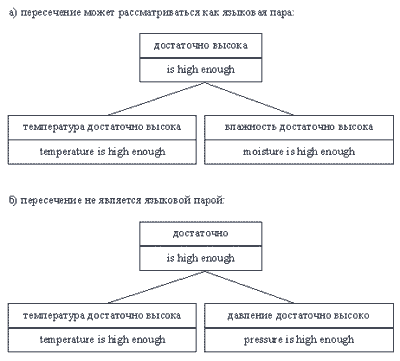
Рис. 5
Для проверки изоморфизма пересечений можно использовать подход, основанный на технологии машинного перевода. Его суть в сопоставлении терминов, образующих исходный и целевой сегменты. Для этого необходимо произвести грамматический разбор сегментов с целью выделения терминов и синтаксических связей между ними. После этого можно воспользоваться терминологическим словарем для определения того, какому термину в целевом сегменте соответствует заданный термин в исходном сегменте. Иными словами, изоморфизм можно определить по следующему критерию (рис. 6):
пересечение является изоморфным, если всем терминам его исходного сегмента, сопоставлены термины его целевого сегмента, и синтаксические связи между ними идентичны тем, которые присутствуют в сегментах, из которых было получено пересечение.
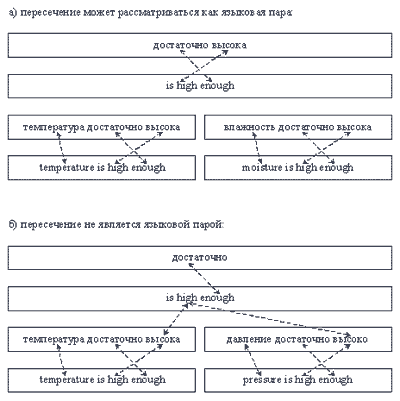
Рис. 6
В общем случае, для оценки изоморфизма можно проверять не только отдельные термины (суть корневые узлы графа памяти переводов), но и родительские сегменты всех уровней. Это повысит надежность оценки, снизив риск неправильного определения синтаксических связей.
Следует обратить внимание на тот факт, что в предлагаемой модели машинный перевод используется только для грамматического анализа текста, образующего сегмент. Слабым местом систем машинного перевода является выбор перевода для терминов сегмента, и именно эта задача решается более надежным способом- с помощью памяти переводов.
От языковых пар к языковым звездам
Нередкой является ситуация, когда перевод приходится осуществлять не только с языка A на язык B, но и, наоборот, с языка B на язык A. Одна и та же память переводов будет одинаково полезна в обоих случаях, поскольку содержит максимально синхронизированные графы сегментов на языке A и на языке B. Однако стоит нам усложнить задачу и предположить необходимость перевода между несколькими языками, как полезность единой памяти переводов заметно падает. Действительно, если перевод осуществлялся с языка A на языки B и C, то в памяти не будет храниться соответствия между сегментами на языках B и C. Как же обеспечить подобную возможность?
Разумным решением могло бы явиться использование некоторого промежуточного языка X, на который осуществлялся бы перевод, а затем, вторым этапом, выполнялся бы перевод с языка X на целевой язык. В подобном случае все языковые пары в памяти переводов состояли бы из сегмента языка X и сегмента одного из целевых (либо исходных) языков. Тут имеются, однако, подводные камни. Во-первых, как мы уже убедились, пересечение языковых пар не всегда бывает изоморфным, следовательно, не все языковые пары в памяти переводов будут содержать перевод на язык X. Очевидно, такие пары будут бесполезны. Во-вторых, при переводе всегда имеется опасность потери смысла: двойной перевод значительно увеличивает эту опасность.
Каким же должен быть этот гипотетический промежуточный язык X, чтобы им было целесообразно воспользоваться? Его свойства вытекают из двух названных проблем. Во-первых, этот язык должен обеспечивать изоморфное пересечение для любого другого языка. Нарушение изоморфизма (по крайней мере, в родственных языках) обусловлено в значительной степени различием синтаксических правил, приводящим к разному порядку членов предложения, а также к различию форм одного и того же слова. Отсюда следует, что язык X должен быть инвариантен к порядку слов и как-то учитывать их формы в исходном языке. Во-вторых, он должен быть в состоянии передать смысл фразы на любом языке, следовательно- включать в себя специфические понятия всех существующих человеческих языков.
Если такой универсальный язык будет найден, то память переводов можно будет организовать не на основе языковых пар, а на основе языковых звезд, где в центре находится сегмент на языке X, на лучах- варианты переводов его на другие языки. При значительном объеме перевода между большим количеством языков дополнительные затраты на удвоенную работу переводчика с лихвой окупятся гибким механизмом памяти переводов, значительно упрощающим многоязычный перевод.
Осталось только найти язык X. И такой язык существует! Это универсальный сетевой язык UNL (UniversalNetworkingLanguage), предложенный Институтом Развития Обучения (InstituteofAdvancedStudies- IAS) при Университете Объединенных Наций (UnitedNationsUniversity- UNU). Им мы и воспользуемся для дальнейшего развития модели памяти переводов.
Язык UNL и концептно-ориентированная парадигма
Краткое описание языка UNL
Язык UNL представляет высказывания в виде множества так называемых универсальных слов, связанных определенного типа бинарными отношениями. Универсальное слово представляет собой обозначение некоторого понятия и задается именем соответствующего понятия (обычно на английском языке), группой вспомогательных атрибутов (число, время, наклонение и т. п.) и некоторыми ограничениями семантики, представленными с помощью других универсальных слов и отношений. Вот примеры универсальных слов:
"человек" - man(icl>person)
"люди" - man(icl>person).@plural
"шляпа" - hat(icl>thing)
Бинарные отношения задают тип взаимосвязи между понятиями. Например, в словосочетании "человек идет" используется отношение "agt" (agent), обозначающее связь между субъектом действия и самим действием. В словосочетании "нести флаг" используется отношение "obj" (object), обозначающее направленность действия на объект. В синтаксисе UNL эти примеры запишутся так:
"человекидет" - agt(walk(icl>do), man(icl>person))
"нестифлаг" - obj(carry(icl>do), flag(icl>thing))
Любое множество таких пар может быть объединено в одно составное универсальное слово при помощи специальных меток. Например, словосочетание "человек, несущий флаг" представится следующим образом:
agt:01(carry(icl>do):02, man(icl>person))
obj:01(carry(icl>do):02, flag(icl>thing))
Чтобы отразить тот факт, что несколько вхождений одного и того же универсального слова обозначают один объект, все вхождения маркируются одной и той же меткой, как это сделано в случае слова "carry".
Составное слово, так же как и простое универсальное слово, может быть элементом бинарного отношения. Фраза "я вижу человека, несущего флаг" запишется так:
agt:01(carry(icl>do):02, man(icl>person))
obj:01(carry(icl>do):02, flag(icl>thing))
agt(see(icl>do):03, I)
obj(see(icl>do):03, :01)
Как видно из примеров, каждое слово, простое и составное, в языке обозначает определенное понятие, или "концепт". Следовательно, UNL оперирует не словами, а именно концептами. С другой стороны, предложение на языке UNL представляет собой неупорядоченное множество связанных бинарными отношениями концептов. Отсюда следует, что при переводе на UNL исключено нарушение изоморфизма, вызванное различным порядком слов.
Проблема изоморфизма пересечения языковых пар
Итак, мы определили, что представление на языке UNL позволяет полностью сохранить смысл (поскольку лексическими единицами являются однозначные обозначения понятий) и обеспечивает независимость изоморфизма пересечения языковых пар от порядка слов в предложениях. Тем не менее, осталась и усугубилась проблема нарушения изоморфизма, вызванного различием форм одного и того же слова в разных предложениях. Действительно, концепт в языке UNL, не меняет своей формы, с каким бы другим концептом он ни был связан. В то же время, одно и то же слово на естественном человеческом языке может видоизменяться.
Анализируя эту проблему, задумаемся: а действительно ли нам нужно вычислять пересечение исходных сегментов? Нельзя ли, вычислив пересечение целевых сегментов (то есть UNL-предложений), сформировать для него перевод обратно на исходный язык автоматически? Положительный ответ на эти вопросы можно дать, если снова воспользоваться технологией машинного перевода. Действительно, для всех концептов имеется их перевод на исходный язык, следовательно, слабое место машинного перевода- выбор лексики- удастся избежать. Все, что будет требоваться от компьютера- это выделить в исходном сегменте те слова и синтаксические связи, которые вошли в состав пересечения UNL-предложений, и сформировать новое словосочетание, нужным образом изменив формы слов (рис. 7).
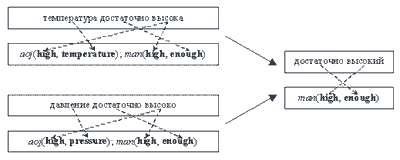
Рис. 7
Коль скоро мы доверили системе машинного перевода синтаксический и морфологический разбор исходного сегмента, когда оценивали изоморфизм пересечения языковых пар без привлечения UNL, доверим ей сделать то же самое для организации поиска сегмента в памяти переводов. В самом деле, почему бы не преобразовать исходный сегмент в UNL-предложение и не осуществить поиск в графе сегментов, хранящих текст на языке UNL? Поступив подобным образом, мы полностью избавимся от необходимости осуществлять операции поиска и добавления над графом сегментов, хранящих текст на естественном языке. Все операции будут производиться над графом UNL-предложений. Теперь вместо нескольких графов (по одному на каждый язык) память переводов будет использовать один единственный граф, каждый узел которого будет представлять собой языковую звезду с UNL-предложением в центре и вариантами перевода на лучах.
Весь процесс работы переводчика с предлагаемой системой описывается схемой, изображенной на рис. 8.
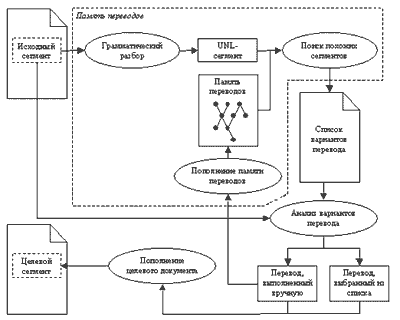
Рис. 8
Важным фактором является то, что работа классической памяти переводов описывается такой же схемой. Это означает, что реализация предлагаемой модели может быть легко встроена в существующие системы.
Концептно-ориентированная сущность памяти переводов
В результате всех