АИС управления серверным программным обеспечением на базе программного комплекса Webmin/Alterator
поиск файлов;
посылка на печать и отмена печати на принтере.
Все эти операции могут быть помещены в сообщение SMB и переданы к и от сервера. Название SMB происходит от названия формата данных √ разновидности стандартных системных вызовов DOS к различным структурам данных или Server Message Blocks, адаптированная для передачи данных другому компьютеру по сети.
Формат SMB
Richard Shape из команды разработчиков Samba дал определение протоколу SMB как запрос-ответ. На практике это означает, что клиент посылает запрос SMB к серверу и сервер отвечает сообщением на этот запрос. Сервер редко формирует ответы, которые не относятся к клиенту.
Сообщение SMB не так сложно. Рассмотрим структуру сообщения. Его можно разделить на две части: заголовок фиксированного размера и поле команды, размер которой меняется динамически в зависимости от состава сообщения.
Формат заголовка SMB
Таблица 3.1 показывает формат заголовка SMB. Команды SMB не обязательно должны заполнять все поля заголовка SMB. Например, когда клиент впервые пытается соединиться с сервером, то значение идентификатора дерева (TID) пусто √ он появляется после успешного соединения и нулевое значение TID (0xFFFF) устанавливается в соответствующее поле заголовка. Другие поля могут также устанавливаться в ноль, когда не используются.
Значения полей заголовка SMB перечислены в Таблице 3.1.
Таблица 3.1 Поля заголовка SMB
| Поле | Размер (байты) | Описание |
| 0xFF 'SMB' | 1 | Идентификатор протокола |
| COM | 1 | Код команды, от 0x00 до 0xFF |
| RCLS | 1 | Класс ошибки |
| REH | 1 | Зарезервирован |
| ERR | 2 | Код ошибки |
| REB | 1 | Зарезервирован |
| RES | 14 | Зарезервирован |
| TID | 2 | ID Дерева; уникальное ID для ресурса, исп. клиентом |
| PID | 2 | ID Вызывающего процесса |
| UID | 2 | Идентификатор пользователя |
| MID | 2 | Мультиплексный ID; используемый для передачи запросов внутри процесса |
Формат команды SMB
После того, как заголовок представлен определенным числом байт, происходит выполнение команды SMB. Любая команда, например такая, как открыть файл (ID поля COM: SMBopen ) или получить запрос на печать (SMBsplretq), имеет свой набор параметров и данные. Как и в поле заголовка SMB, здесь также могут быть заполнены не все командные поля, все зависит от команды. Например, команда GetServerAttributes (SMBdskattr) устанавливает поля WCT BCC в 0. Поля командных сегментов показаны в Таблице 3.2.
Таблица 3.2 - Содержание команды SMB
| Поле | Размер в байтах | Описание |
| WCT | 1 | Счетчик слов |
| VWV | Переменная | Параметр слов (размер, определяемый WCT) |
| BCC | 2 | Параметр счетчика байт |
| DATA | Переменная | Данные (размер, определяемый BCC) |
3.3 Описание протокола DNS
Служба Доменных Имен (Domain Name System) предназначена для того, чтобы машины, работающие в Internet, могли по доменному имени узнать IP-адрес нужной им машины, а также некоторую другую информацию; а по IP-номеру могли узнать доменное имя машины.
Служба Доменных Имен была разработана для именования машин в глобальной сети. Основной особенностью глобальной сети является распределенное администрирование, когда один администратор физически не может уследить за выделением имен. Поэтому Служба Доменных Имен функционирует на принципе делегирования полномочий. Каждая машина либо знает ответ на вопрос, либо знает кого спросить. При правильном функционировании система замкнута, т.е. если запрошенная информация имеется у кого-либо, то она будет найдена и сообщена клиенту, либо, если вопрос не имеет ответа, клиент получит сообщение о невозможности получения ответа на вопрос.
Каждый клиент знает своего сервера; обычно указывается не один, а несколько серверов - если первый не отвечает, клиент обращается ко второму и так далее до исчерпания списка. В принципе неважно, к какому серверу обращаться - они дают (должны давать при правильном функционировании) одинаковые ответы на любой запрос. Поэтому для ускорения работы обычно указывают ближайший. Следует помнить, что на одной машине могут функционировать одновременно Name-сервер и программы-клиенты; поэтому если на машине запущен Name-сервер, то в качестве Name-сервера на ней должен быть прописан "я сам".
Имеется некий домен верхнего уровня, обозначаемый точкой: ".". Имеется девять серверов (по крайней мере на моем Name-сервере записано столько), которые отвечают за эту зону. Они не знают ни одного доменного имени - они только авторизуют серверы верхних зон. Серверы верхних зон тоже гнушаются хранить информацию о конкретных машинах и передают это право нижележащим серверам. Тут уже появляются первые упоминания о конкретных машинах, равно как и происходит авторизация нижележащих серверов.
Очень редко используются доменные имена из двух сегментов; имена из трех и четырех сегментов составляют подавляющую долю всех имен Internet; имена из пяти сегментов встречаются довольно редко.
Допустим, клиент запросил адрес "www.организация.город.страна". Поиск информации по доменному имени происходит следующим образом:
Клиент спрашивает своего сервера.
Если тот является сервером данной зоны, то ответит, на чем все заканчивается.
Сервер спрашивает корневой сервер.
Тот не может ответить, потому что не знает; зато знает, какой сервер отвечают за зону "страна".
Сервер зоны "страна" тоже не может ответить, но знает, что нужно спросить сервер зоны "город.страна".
Тот в свою очередь отсылает запрос серверу зоны "организация.город.страна", который сообщит нужную информацию.
Это приближенная модель, которая тем не менее позволяет представить работу системы DNS.
Однако эту стройную картину искажают системы кэширования и вторичных серверов. Дело в том, что получив ответ на свой вопрос, DNS-сервер получает также некоторое число, которое говорит ему о том, по истечении какого времени эта информация должна считаться устаревшей. Таким образом, все серверы, участвовавшие в поиске ответа на вопрос, заданный клиентом, могут (и скорее всего будут) помнить как ответ на заданный вопрос, так и путь, по которому шел поиск. При следующих запросах, имеющих общую правую часть с недавно сделанными запросами, поиск будет упрощен (ускорен).
Следует обратить внимание на сходство, различие и взаимодействие систем DNS и IP-маршрутизации. Как и IP-маршрутизация, DNS работает по принципу делегирования полномочий, но выделение доменных имен совершенно не зависит от выделения IP-адресов. Для примера рассмотрим домен freebsd. Это - домен организации, занимающейся распространением операционной системы FreeBSD Unix. FTP-сервер, содержащий дистрибутив операционной системы и множества утилит для нее, имеет копии в нескольких десятках стран.
Политика и стратегия назначения имен
Имена зон условно можно разделить на "организационные" и "географические". В высшей зоне зарегистрированы следующие "организационные" зоны:
com - commercial (коммерческие);
edu - educational (образовательные);
gov - goverment (правительственные);
mil - military (военные);
net - network (организации, обеспечивающие работу сети);
org - organization (некоммерческие организации).
3.4 Протокол NFS
Система NFS обеспечивает разнообразным приложениям на клиентских хостах прозрачный доступ к файловым системам и файлам на сервере. Слово доступ здесь означает, что становятся доступными разнообразные операции с отдельными частями содержимого файлов (а не только копирование файлов целиком с помощью специализированного клиента подобно тому, как это происходит при пересылке файлов в FTP). Предоставляемый доступ является прозрачным в том смысле, что каждое приложение на клиентской машине, работающее с локальными файлами, точно так же работает через NFS и с файлами на удаленной системе, причем без каких-либо изменений в коде этого приложения.
Система NFS построена по принципу клиент-сервер и базируется на RPC фирмы Sun Microsystems. NFS-клиент получает доступ к файлам на хосте NFS-сервера, посылая ему RPC-запросы. С принципиальной точки зрения NFS-клиент и NFS-сервер могли бы быть обычными пользовательскими процессами, взаимодействующими через RPC, однако из практических соображений NFS обычно реализуют иначе, и на это есть две причины. С одной стороны, как было сказано, доступ к файлам с помощью NFS должен быть прозрачным для любых приложений на стороне клиента. Следовательно, все обеспечивающие удаленную работу с файлами NFS-запросы с клиентской машины должны автоматически генерироваться операционной системой. С другой стороны, высокая производительность NFS-сервера достигается, только если он функционирует как часть операционной системы на его хосте. Если бы NFS-сервер был реализован как пользовательский процесс, то обращения сервера с запросом к файловой системе вместе с записываемыми и считываемыми данными в каждой транзакции пересекали бы границу между ядром и этим пользовательским процессом, что неизбежно повлекло бы значительные издержки и резко снизило производительность. Поэтому NFS-серверы реализуют в коде ядра.
1. Для пользовательского приложения скрыто, обращается он к местному файлу или через NFS к файлу на удаленном хосте (далее последние будем кратко называть NFS-файлами). За него это знает ядро: в момент открытия файла оно определяет его местонахождение и в зависимости от этого в последующем все обращения к местным файлам отдает на обработку своей файловой системе, а те, что относятся к дальним файлам, направляет NFS-клиенту.
2. NFS-клиент посылает RFC-запросы на NFS-сервер через используемый транспортный протокол. Большей частью NFS работает по UDP, но последние реализации могут быть конфигурированы на установление соединений по TCP.
3. NFS-сервер принимает дейтаграммы с запросами NFS-клиента на свой UDP-порт 2049. Хотя, в принципе, NFS-сервер мог бы использовать эфемерный порт, объявляя его на регистраторе портов, в большинстве реализаций NFS зафиксирован стандартный порт 2049.
4. При поступлении запроса от NFS-клиента NFS-сервер транслирует его в запросы к своей местной файловой системе, которая и осуществляет соответствующие действия на диске хоста сервера.
5. Обработка запроса на сервере может занять значительное время, особенно если потребуется выполнить манипуляции в его файловой системе. Чтобы в период выполнения одного запроса не блокировать запросы от других NFS-клиентов, NFS-сервер должен обрабатывать их параллельно. Способ параллельной обработки зависит от возможностей конкретной операционной системы. Поскольку большинство реализаций Unix не поддерживают механизм нитей (multithreading), то обычно используемый искусственный прием состоит в следующем. Запросы от клиента на стороне сервера обрабатывает пользовательский процесс, называемый демоном. NFS (обычное его имя — nf sd), который может сам себя копировать в некотором числе экземпляров. Эта простейшая программа посылает один не требующий ответа вызов в код встроенного в ядро NFS-сервера.
6. В свою очередь, и NFS-клиент, обслуживающий свой пользовательский процесс, вынужден, выслав RPC-запрос, в течение достаточно длительного времени ждать завершения его обработки на сервере до получения RPC-ответа. Поэтому и на клиентском хосте необходимо так или иначе обеспечить параллельное обслуживание многих использующих NFS пользовательских процессов, что также решается различными способами в зависимости от операционной системы. В Unix на хосте клиента NFS часто используется тот же прием, что и в случае сервера: создается новая копия пользовательского процесса, называемого здесь демоном блочного ввода-вывода (biod), который посылает один не требующий ответа вызов в код встроенного в ядро NFS-клиента.
Большинство хостов в Unix поддерживают либо NFS-клиента, либо NFS-сервера, либо обоих одновременно. Реализации NFS-клиентов существуют и для персональных компьютеров с операционными системами, например, от Microsoft. Мэйнфреймы, в частности фирмы IBM, часто выполняют роль только NFS-сервера.
В системе NFS на стороне сервера кроме программы, реализующей собственно сам протокол NFS, действуют еще и другие работающие поверх RPC программы, включая непременный для RPC регистратор портов.
Та или иная файловая система NFS-сервера становится доступной с машины NFS-клиента только после того, как будет на ней должным образом смонтирована. Для этого NFS-клиент обращается с соответствующим запросом к демону монтирования (mount daemon) NFS-сервера. Сам протокол монтирования в NFS будет рассмотрен ниже.
Менеджер блокировок (lock manager) и монитор состояний (status monitor) позволяют блокировать фрагменты файлов на сервере. Эти две программы необходимы как отдельные дополнения к протоколу NFS, поскольку для временной блокировки обращений к частям файла при их модификации необходимо, чтобы клиент и сервер могли из одного состояния переходить в другое. (Протоколом NFS не предусмотрено запоминание состояний на стороне сервера).
3.5 Выводы по разделу
В данном разделе были рассмотрены алгоритмы функционирования автоматизированной информационной системы, а также детально рассмотрены протоколы используемые системой для настройки и конфигурирования серверного программного обеспечения.
4. Руководство пользователя
4.1 Руководство пользователя Webmin
Настройка Webmin для работы с серверными приложениями.
Программный комплекс запускается путем ввода в адресную строку https://<ip-сервера>:10000 (https, если с поддержкой SSL). После чего появится окно входа в систему. В открывшемся окне следует заполнить:
Логин (логическое имя) пользователя;
Пароль для входа в систему.
На рисунке 4.1 представлен внешний вид программного комплекса при входе в систему.
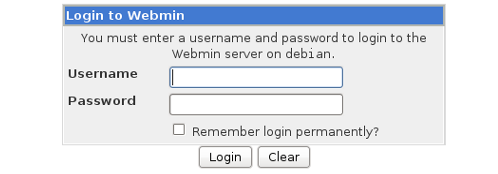
Рисунок 4.1 – Вход в систему
Если авторизация прошла успешно, открывается главное окно, содержащие сведения о системе и разделы.
Раздел Система (System) связан с общими настройками операционной системы. Здесь вы можете настраивать файловые системы, пользователей, группы и поведение системы при загрузке. Вы можете управлять сервисами, работающими в системе, и контролировать, запускаются ли они автоматически иконками Bootup и Shutdown. Настройка этих сервисов производится в разделе Servers. Особый интерес представляет утилита "Software Packages". Она позволяет легко просматривать пакеты, установленные на вашей системе, а также предоставляет интерфейсы доступа к репозиторию обновлений дистрибутива и к debfind, публичному DEB репозиторию в Internet.
В разделе Сервисы (Servers) размещены модули настройки различных сервисов, которые могут быть запущены на вашей системе. Очень удобны утилиты для настройки BIND и DHCP. Также очень просто пользоваться утилитой для настройки Samba -- файл- и принтсерверов для Windows и других клиентов. Webmin также избавит вас от проблем с настройкой SMTP сервера Sendmail, пользующегося дурной славой из-за сложного конфигурационного файла.
Раздел Сеть (Networking) позволяет настраивать сетевое оборудование, а также ряд сложных функций управления сетью, таких как firewalling (межсетевая защита). Все утилиты работают со стандартными конфигурационными файлами, поэтому все, что вы делаете в Webmin, будет отображаться в командной строке.
Раздел Оборудование (Hardware) предназначен для конфигурирвания физических устройств, в основном принтеров и устройств хранения. Утилита Logical Volume Management (LVM) особенно интересна, поскольку позволяет визуально управлять динамическими томами в вашей Linux системе.
Раздел Кластер (Cluster) содержит утилиты, которые вы можете использовать если вы кластеризуете систему. В данном контексте cluster -- это набор связанных систем, для которых необходимо синхронизировать их настройки. Системы могут синхронизировать пользователей, группы, пакеты и прочее с отслеживанием системных сбоев. Эти утилиты позволяют настраивать мощные отказоустойчивые системы, а также системы, для которых важна синхронизация. Кластеризация - это достаточно сложная тема, которая, возможно, потребует установки пакетов, не входящих в ваш дистрибутив.
Раздел Прочее (Others) содержит разнообразные утилиты, которые могут оказаться вам полезны. "SSH/Telnet Login" и "File Manager" реализованы в виде апплетов и не могут быть запущены, пока у браузера не установлено JRE. Утилита "Perl Modules" будет полезна для обслуживания модулей Perl, и позволяет напрямую подсоединяться к CPAN в интернете. "File Manager" обеспечивает доступ к файловой системе сервера с интерфейсом, похожим на Explorer, и позволяет перемещать и копировать файлы без перемещения их через память вашей рабочей станции (если вы работаете удаленно). "SSH/Telnet Login" - утилита, позволяющая вам получить доступ к консоли удаленной машины через ваш браузер.
На рисунке 4.2 представлен внешний вид программного комплекса после авторизации.
Далее будут приведены самые необходимые и распространенные возможности программного комплекса и подключаемых либо написанных модулей.
Модуль File Manager
Модуль File Manager находится в категории Прочее (Other). Он несколько отличается от большинства других модулей. Вместо предоставления возможности настройки серверов и служб, этот модуль позволяет пользователям просматривать и управлять файлами на сервере при помощи файлового менеджера. Интерфейс похож на старый explorer в Windows: слева - дерево каталогов, а справа - содержимое текущей папки, сверху - кнопки и панель инструментов.
Пользователи и группы
В Webmin, модуль The Users and Groups (Пользователи и группы), который находится в категории System (Система), может быть использован для создания, редактирования и удаления UNIX пользователей и групп в системе..
В дополнение, к управлению UNIX пользователями в вашей системе, этот модуль также позволяет управлять пользователями, находящимися в других модулях. Например, Samba имеет свой собственный список пользователей и паролей, которые должны быть согласованы со списком паролей UNIX. Webmin может сделать это автоматически, используя функции других модулей, которые вызывают формы создания, редактирования и удаления пользователя.
Внешний вид работы с пользователями представлен на рисунке 4.3.
Модуль System and Server Status
Этот модуль позволяет отслеживать состояния выбранных серверов и запущенных демонов. С его помощью можно легко определить какие процессы выполняются должным образом или выявить те процессы, работа которых нарушена. Также можно сконфигурировать модуль таким образом, что при проверке состояния сервера происходила отправка сообщения по e-mail или выполнялась какая-либо команда. Эта функция может быть полезна если система управляет серверами, от которых зависят другие люди, такими как web или DNS сервера.
Внешний вид модуля System and Server Status представлен на рисунке 4.4.
Для полноценной работы с программным комплексом и решения поставленных задач, стандартных модулей в Webmin недостаточно. Система позволяет дополнить их.
Установка нового модуля представлена на рисунке 4.5.
4.2 Создание первичного контроллера домена в Webmin
Первичный контроллер домена хранит у себя БД пользователей домена, их пароли, права доступа и прочую информацию. Это позволяет им авторизовавшись один раз посещать все сетевые ресурсы домена без ввода пароля. PDC позволяет применять так называемые logon scripts - текстовые файлы хранящиеся на сервере, в которых содержатся команды, которые будут выполнены на машине клиента при входе в домен. С их помощью можно проводить автоматическое монтирование сетевых дисков, синхронизацию часов, запуск других программ и так далее. На PDC можно настроить перемещаемые профили (roaming profiles). Они используются для хранения windows профиля пользователя (рабочий стол, меню пуск, оформление и пр.) на сервере. Т.е. пользователь, залогинившись с любого компьютера в сети будет работать в своем настроенном рабочем окружении. Конечно такая возможность предполагает наличие быстрого сетевого соединения и наличия достаточного свободного место на диске сервера. Ну и напоследок тот момент что пользователь он на то и пользователь чтобы пользоваться, администрировать он ничего не сможет (пока конечно вы не дадите ему таких прав), следовательно и исправлять будет нечего - это также немаловажный аргумент перехода на PDC.
Настройка первичного контроллера домена процесс трудоёмкий. Применения для этих целей программного комплекса позволит сократить время и облегчит работу администратора, позволив работать не напрямую правив smb. conf, а работая в удобном интерфейсе.
Внешний вид менеджера ресурсов Samba представлен на рисунке 4.6. Модуль включает в себя:
Настройки безопасности;
Настройки сети Unix и Windows;
Параметры вывода на печать;
Параметры использования файловых ресурсов.
В случае каких-либо ошибок или неясностей администратор имеет возможность просмотреть либо править прямо в программном комплексе.
Внешний вид правки конфига представлен на рисунке 4.10.
4.3 Руководство пользователя Alterator
На рисунке 4.11 представлен внешний вид конфигуратора Alterator.
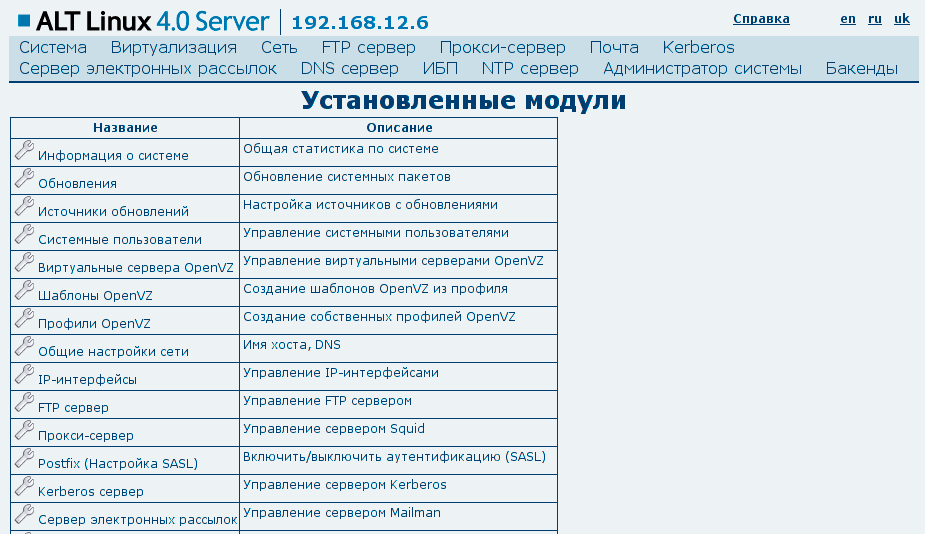
Рисунок 4.11 Интерфейс Alterator
4.4 Выводы по четвертому разделу
Созданная система управления удобна для восприятия и имеет интуитивно понятный интерфейс, рассчитанный на администраторов с опытом работы или без такового. Система позволит сократить время настройки и конфигурации, при этом расширив круг вопросов, которые может решить администратор. В наглядном примере показана функциональные возможности автоматизированной информационной системы.
5. Экономическое обоснование проекта
Целью данного раздела является доказательство экономической целесообразности создания автоматизированной информационной системы управления программным обеспечением серверного оборудования на базе программного комплекса Webmin/Alterator.
5.1 Цель и краткое описание программного продукта
Наименование программного продукта: АИС управления серверным программным обеспечением.
Целью является внедрение для Министерства промышленной политики, транспорта и связи Омской области программного комплекса Webmin, позволяющего решить следующие задачи:
производить мониторинг процессов, запускать, останавливать и перезапускать процессы;
осуществлять полноправную навигацию по файловой системе, выполнять любые операции с файлами и каталогами;
единовременно запускать приложения на сервере с возможностью просмотра их вывода через браузер.
При разработке системы использовался программный комплекс Webmin, который является открытым программным обеспечением, распространяемый по лицензии GPU.
5.2 Определение затрат труда на разработку программного продукта
Трудоемкость выполнения отдельных видов работ определяется двумя видами оценок:
 - минимальные
затраты времени
на выполнение
отдельного
вида работ;
 - максимальное
время выполнения
при наименее
благоприятных
условиях.
По этим величинам оценивается ожидаемое значение трудоемкости и стандартное отклонение.
Ожидаемое
значение трудоемкости
 рассчитывается
по формуле:
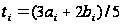 ,
где i – номер этапа.
Стандартное
отклонение
 оценивается
по следующей
формуле:
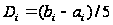 ,
где i – номер этапа.
Экспертные оценки и расчетные величины трудоемкости, а также стандартные отклонения по всем видам работ приведены в таблице5.1.
Таблица 5.1– Оценка трудоемкости отдельных по всем видам работ
| Вид работ | Оценка трудоемкости | Расчетные величины | ||
| а(ч.) | b(ч.) | t(чел/ч) | D | |
| 1. Изучение и анализ предметной области | 120 | 150 | 132 | 6 |
| 2. Изучение структуры серверов | 180 | 200 | 188 | 4 |
| 3. Изучение алгоритма удаленного управления | 180 | 200 | 188 | 4 |
| 4. Развертывание системы | 220 | 250 | 232 | 6 |
| 5. Отладка | 50 | 70 | 58 | 4 |
| 6. Подготовка документации | 70 | 100 | 82 | 6 |
| Итог: | 820 | 970 | 880 | 12,49 |
Общая трудоемкость работы составляет 880 человеко-часов или 5 месяцев (по 22 рабочих дня в каждом месяце). Стандартное отклонение составляет менее 5 %, то есть степень достоверности того, что работа будет выполнена в срок, велика.
5.3 Определение численности исполнителей
Период разработки программы – 5 месяцев, с 1 января по 1 июня 2010 года.
Количество рабочих дней в каждом месяце равно 22. Рабочий день равен 8 часам. Отсюда получаем действительный фонд времени за период разработки программы:
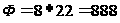 ч.
Численность исполнителей, необходимая для выполнения работ определяется как отношение трудоемкости всей разработки к действительному фонду времени за весь период разработки программы.
Таким образом, получаем:
 чел.
Отсюда следует, что разработчиком будет являться один исполнитель – техник.
В таблице 5.2 представлено распределение трудоемкости по стадиям разработки и исполнителям.
Таблица 5.2 – Распределение трудоемкости по стадиям разработки
| Вид работы | Трудоемкость этапа, ч. | Должность исполнителя |
| 1. Изучение и анализ предметной области | 64 | Техник |
| 2. Изучение структуры БД | 44 | Техник |
| 3.Изучение алгоритма | 49 | Техник |
| 4. Развертывание системы | 220 | Техник |
| 5. Отладка | 71 | Техник |
| 6. Подготовка документации | 88 | Техник |
| Итого: | 536 |
5.4 Расчет себестоимости разработки программного продукта
Расчет основной заработной платы
Основная
заработная
плата рассчитывается,
исходя из
трудоемкости
работ, выполняемых
специалистом
i-й квалификации
при разработке
программного
продукта ()
в чел/ч и размера
оплаты труда
1 чел/ч.
Основная заработная плата разработчика за месяц рассчитывается по следующей формуле:
 ,
где
 - основная
заработная
плата разработчика,
руб.;
 - оклад техника,
руб.;
 - общая трудоемкость
работ, ч.
Оклад сотрудника отдела информационных систем – 10000 руб./мес.
Трудоемкость техника – 880 ч.
Таким образом, основная заработная плата разработчика, при районном коэффициенте 1,15, применяемом к окладу работников, проживающих в городе Омске и среднем количестве рабочих часов в месяц равном 176 следующая:
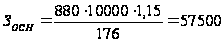 руб.
Расчет дополнительной заработной платы
Дополнительная заработная плата в среднем составляет 12% от основной заработной платы.
Таким образом, дополнительная заработная плата составит:
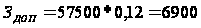 руб.
Расчет отчислений на социальные нужды
Сумма отчислений на социальные нужды составляет 26% от суммы основной и дополнительной заработной платы.
Отчисления на социальные нужды составят:
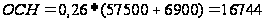 руб.
Расчет расходов по отладке программного продукта
Расходы по отладке определяются, исходя из планируемых затрат машинного времени, необходимого для разработки и оформления программного продукта (Тм.в), и стоимости одного машино-часа работы ЭВМ, на которой ведется разработка (См.ч.):
Cотл = См.ч. * Тм.в ,
Стоимость одного машино-часа определяется по формуле:
См.ч. = Сэ / Фвт Кз,
где Сэ – годовые расходы, обеспечивающие функционирование вычислительного комплекса, руб./год;
Ф – годовой плановый
фонд времени
работы вычислительного
комплекса, ч.;
Кз –коэффициент загрузки (не более 0,9-0,95).
Рассчитаем годовой плановый фонд времени:
Фвт = Фном - Фпроф,
где Ф – номинальный
фонд времени
работы вычислительного
комплекса, ч.
Ф
= 12*22*8 = 2112 ч.
Фпроф – годовые
затраты времени
на профилактические
работы (принимаются
15 % от Ф),
Фпроф = 0,15*2112=316,8 ч.
Ф
= 2112 – 316,8 = 1795,2 ч.
Рассчитаем годовые расходы:
Сэ = Сосн з/п+ Сдоп з/п + Сотч+ Сам + Срем + См + Сэл;
Основная заработная плата сотрудника, проводящего профилактические работы ЭВМ, составляет:
Сосн з/п =
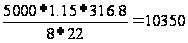 руб.
Дополнительная заработная плата сотрудника, проводящего профилактические работы ЭВМ, составляет:
Сдоп з/п = Сосн з/п * 12 % = 10350 * 0,12 = 1242 руб.
Сотч =0,26 * (Сосн з/п + Сдоп з/п) = 0,26 * (10350+1242) = 3013,92 руб.
Затраты на амортизацию определяются как сумма затрат на амортизацию ЭВМ и амортизацию ПО.
Сам = Апо + Аэвм
Затраты на амортизацию ЭВМ:
Cк = 25000 рублей – стоимость компьютера за одно рабочее место;
Максимальный срок полезного использования ЭВМ составляет 3 года.
Аэвм =
 =
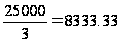 руб.
Затраты на амортизацию ПО:
ПО, которое необходимо дополнительно приобрести для данной разработки и которое в дальнейшем будут использоваться является свободно распространяемым. Для нашего расчета примем затраты на амортизацию ПО