Массивно-параллельные суперкомпьютеры серии Cry T3 и кластерные системы класса BEOWULF
Априорно оценить долю последовательных операций f непросто. Однако можно попробовать формально использовать закон Амдаля для решения обратной задачи определения f по экспериментальным данным производительности; это дает возможность количественно судить о достигнутой эффективности распараллеливания.
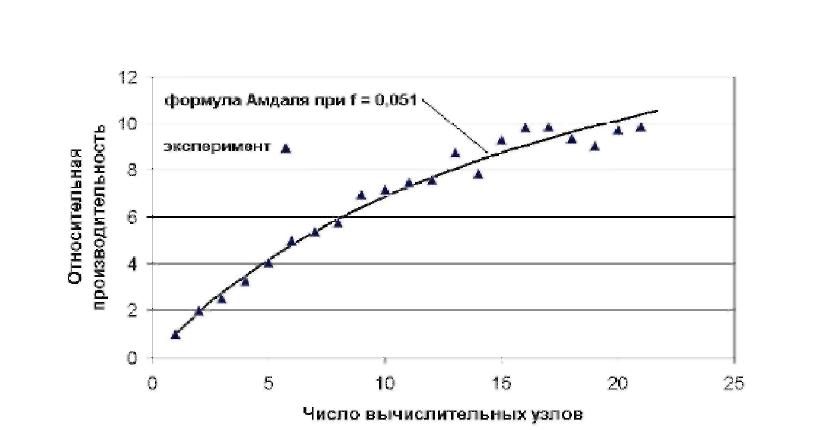
Рисунок 6. Производительность вычислительной кластерной системы на процедуре умножения матриц (эксперимент и расчет по формуле Амдаля)
На рисунке 6 приведены результаты эксперимента на кластере SCI-MAIN НИВЦ МГУ на задаче умножения матриц по ленточной схеме (размерность 103Ч103 вещественных чисел двойной точности), экспериментальные данные наилучшим образом (использован метод наименьших квадратов) соответствуют формуле Амдаля при f=0,051.
Закон Амдаля удобен для качественного анализа проблемы распараллеливания.
2. Принципы построения многопроцессорных вычислительных систем
2.1 Архитектура многопроцессорных вычислительных систем
Архитектура параллельных компьютеров развивалась практически с самого начала их создания и применения, причем в самых различных направлениях. Наиболее общие положения приводят к двум классам – компьютеры с общей памятью и компьютеры с распределенной памятью.
Компьютеры с общей памятью состоят из нескольких процессоров, имеющих равноприоритетный доступ к общей памяти с единым адресным пространством (рисунок 7a).
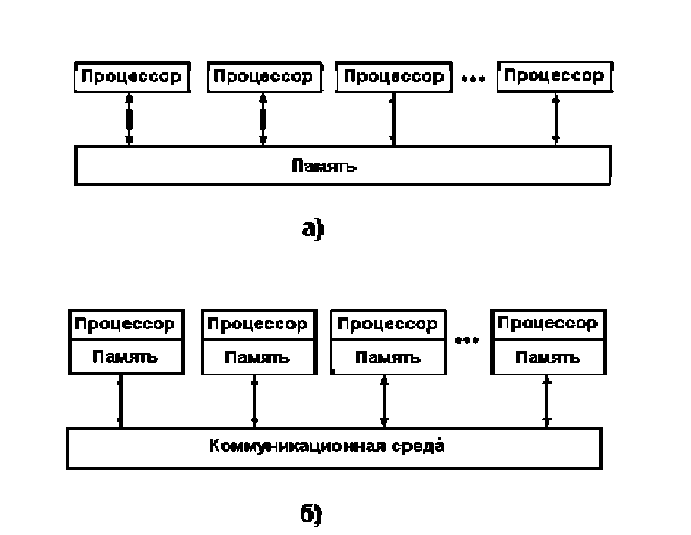
Рисунок 7. Параллельные компьютеры: с общей памятью – а) и с распределенной памятью – б)
Типичный пример такой архитектуры – компьютеры класса SMP (Symmetric Multi Processors), включающие несколько процессоров, но одну память, комплект устройств ввода/вывода и операционную систему. Достоинством компьютеров с общей памятью является относительная простота программирования параллельных задач, минусом – недостаточная масштабируемость. Реальные SMP-системы содержат обычно не более 32 процессоров, для дальнейшего наращивания вычислительных мощностей подобных систем используется NUMA-технология.
В компьютерах с распределенной памятью (мультикомпьютерные системы) каждый вычислительный узел является полноценным компьютером и включает процессор, память, устройства ввода/вывода, операционную систему и др. (рисунок 7б). Типичный пример такой архитектуры – компьютерные системы класса MPP (Massively Parallel Processing), в которых с помощью некоторой коммуникационной среды объединяются однородные вычислительные узлы. Достоинством компьютеров с распределенной памятью является (почти неограниченная) масштабируемость, недостатками – необходимость применения специализированных программных средств (библиотек обмена сообщениями) для осуществления обменов информацией между вычислительными узлами. Для многопроцессорных вычислительных систем с общей и распределенной памятью используются термины сильно- и слабосвязанные машины соответственно.
Как было показано, производительность каналов обмена сильно влияет на возможность эффективного распараллеливания, причем это важно для обоих рассмотренных архитектур. Простейшей системой коммуникации является общая шина (рисунок 8a), которая связывает все процессоры и память, однако даже при числе устройств на шине больше нескольких десятков производительность шины катастрофически падает вследствие взаимного влияния и конкуренции устройств за монопольное владение шиной при обменах данными.
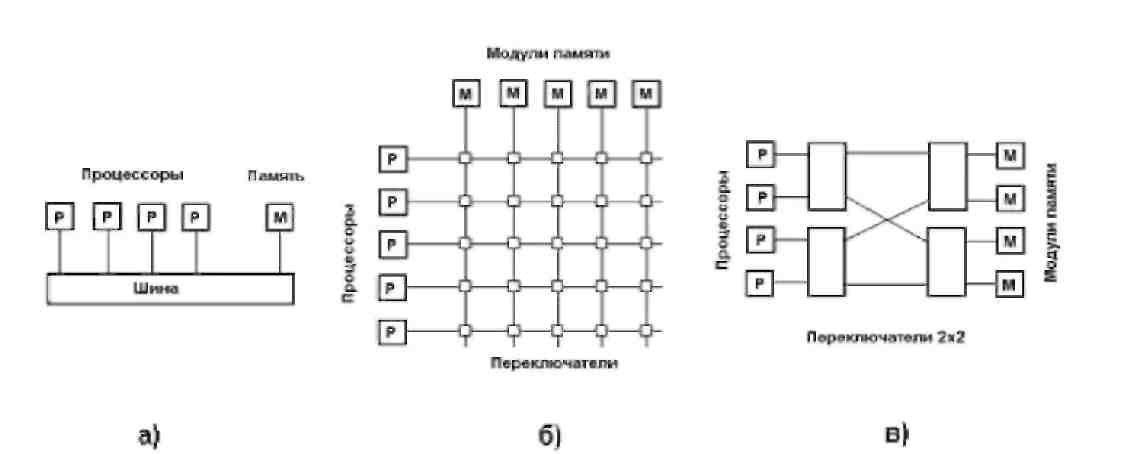
Рисунок 8. Многопроцессорные системы с общей шиной – а), с матричным коммутатором – б) и с каскадированием коммутаторов (Омега-сеть) – в)
При построении более мощных систем используются более изощренные подходы. Эффективной является схема матричной коммутации (рисунок 8б), при которой устройства связываются между собой двунаправленными переключателями, разрешающими или запрещающими передачу информации между соответствующими модулями. Альтернативой является каскадирование переключателей; например, по схеме Омега-сети (рисунок 8в). При этом каждый переключатель может соединять любой из двух своих входов с любым из двух выходов, для соединения n процессоров с n блоками памяти в этом случае требуется nЧlog2n/2 переключателей. Недостаток схем с каскадированием коммутаторов – задержки срабатывания переключателей.
Для систем с распределенной памятью используются практически все мыслимые варианты соединений (рисунок 9), при этом параметром качества с точки зрения скорости передачи сообщений служит величина средней длины пути, соединяющего произвольные процессоры; при этом имеется в виду именно физический путь, так как реализовать логическую топологию (программными средствами) не представляет трудностей.
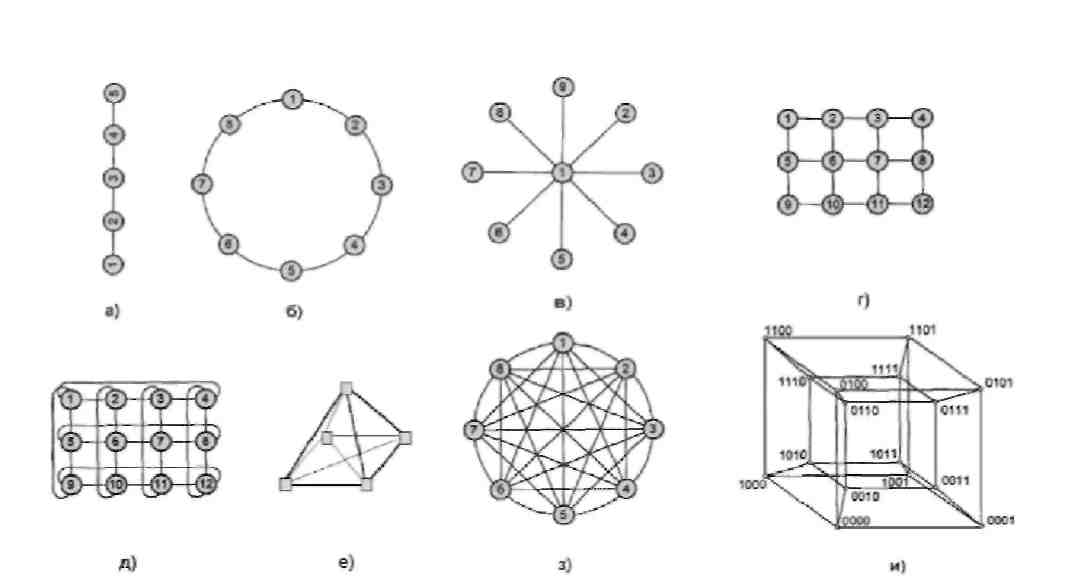
Рисунок 9. Варианты топологий связи процессоров в многопроцессорных вычислительных системах
Простейшая линейная топология (рисунок 9a) удовлетворительно соответствует многим алгоритмам, для которых характерна связь лишь соседних процессов между собой (одномерные задачи математической физики и многомерные, сводимые к одномерным); недостаток – невозможность передачи сообщений при разрыве в любом месте. Уменьшение вдвое средней длины пути и повышение надежности связи (при нарушении связи сообщения могут быть переданы в противоположном направлении, хотя и с меньшей скоростью) достигается соединение первого узла с последним – получается топология "кольцо" (рисунок 9б). Топология "звезда" (рисунок 9в) максимально отвечает распределению нагрузки между процессами, характерной для систем "клиент/сервер" (главный узел "раздает" задания и "собирает" результаты расчетов, при этом подчиненные узлы друг с другом взаимодействуют минимально).
Топология "решетка" (рисунок 9г) использовалась еще в начале девяностых годов при построении суперкомпьютера Intel Paragon на основе процессоров i860; нахождение минимального пути передачи данных между процессорами A и B для топологии "трехмерная решетка" иллюстрировано на рисунке 10. Топология "двумерный тор" (рисунок 9д) расширяет "двумерную решетку" дополнительными связями, снижающими длину среднего пути (само собой, возможен и "трехмерный тор") и характерна для сетевой технологии SCI. Применяется (рисунок 9e) характеризующаяся наличием связи каждого процессора с каждым трехмерная топология "клика". На рисунке 9з приведен общий вид топологии полной связи всех процессоров между собой; такая топология характеризуется наименьшей длиной среднего пути между процессорами, однако аппаратно практически нереализуема при значительном числе процессоров вследствие катастрофического роста числа связей. Для топологии "гиперкуб" (рисунок 9и) характерна сокращенная длина среднего пути и близость к структурам многих алгоритмов численных расчетов, что обеспечивает высокую производительность. N-мерный гиперкуб содержит 2N процессоров. Двухмерный гиперкуб – это квадрат, трехмерный гиперкуб образует обычный куб, а четырехмерный гиперкуб представляет собой куб в кубе. Для семейства суперкомпьютеров nCube гиперкуб максимальной размерности 13 содержит 8192 процессора, в системе nCube 3 число процессоров может достигать 65536 (16-мерный гиперкуб).
В качестве основных характеристик топологии сети передачи данных часто используются следующие показатели:
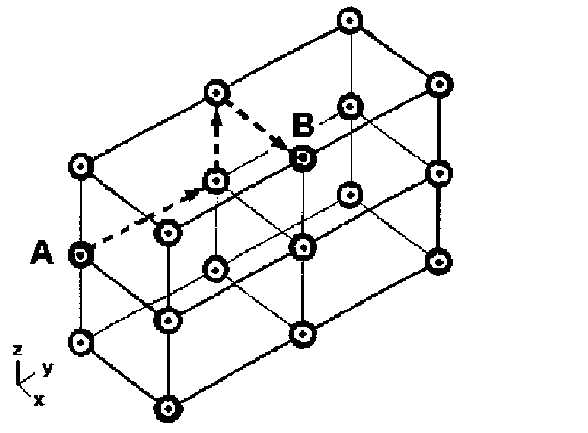
Рисунок 10. Нахождение минимального пути для передачи сообщений между процессорами в топологии "трехмерная решетка"
Диаметр определяется как максимальное расстояние (обычно кратчайших путь между процессорами) между двумя процессорами в сети, эта величина характеризует максимально необходимое время для передачи данных между процессорами (время передачи в первом приближении прямо пропорционально длине пути).
Связность – показатель, характеризующий наличие разных маршрутов передачи данных между процессорами сети; конкретный вид показателя может быть определен, например, как минимальное количество дуг, которое надо удалить для разделения сети передачи данных на две несвязные области.
Ширина бинарного деления – показатель, определяемый как минимальное количество дуг, которое надо удалить для разделения сети передачи данных на две несвязные области одинакового размера.
Стоимость определяется, например, как общее количество линий передачи данных в многопроцессорной вычислительной системе.
Естественным представляется объединение преимуществ систем с общей (относительная простота создания параллельных программ) и распределенной памятью (высокая масштабируемость); решением этого вопроса явилось создание компьютеров с архитектурой NUMA (Non Uniform Memory Access).
В этом смысле классические SMP-компьютеры обладают архитектурой UMA (Uniform Memory Access). При этом применяется механизм (обычно аппаратного уровня – что быстрее), позволяющий пользовательским программам рассматривать всю (физически) распределенную между процессорами память как единое адресное пространство. Примерами NUMA-компьютеров является построенная еще в семидесятых годах и содержащая объединенный межкластерной шиной набор кластеров система Cm и объединяющий 256 процессоров комплекс BBN Butterfly (1981, фирма BBN Advanced Computers).
2.2 Распределение вычислений и данных в многопроцессорных вычислительных системах с распределенной памятью
В случае наличия в составе многопроцессорной вычислительной системы вычислительных узлов с локальной оперативной памятью кроме распределения частей вычисления по отдельным вычислительным узлам важно рациональным образом распределить по имеющимся вычислительным узлам данные (например, блоки обрабатываемых матриц значительной размерности). Дело в том, что затраты времени на обмен данными между обрабатывающими эти данные вычислительные узлы и вычислительными узлами, хранящими эти данные в своей локальной оперативной памяти, может на порядки замедлить процесс вычислений.
Ясно, что расположение большого пула данных на одном вычислительном узле вряд ли целесообразно вследствие неизбежной значительной потери времени на организацию пересылок отдельных блоков этих данным обрабатывающим вычислительным узлом. С другой стороны, чисто формальное разбиение данных на равное числу вычислительного узла число блоков чревато тем же.
Рациональное распределение данных по локальным оперативной памяти вычислительного узла должно совершаться с учетом частоты обращения каждого вычислительного узла к каждому блоку данных, расположенных на соответствующих вычислительных узлах при стремлении к минимизации числа обменов, что требует определения тонкой информационной структуры алгоритма.
Казалось бы, в общем случае возможно построение некоей функции трудоемкости (например, в смысле времени) вычислений, учитывающей как ресурсные затраты на собственно вычисления так и трудоемкость обменов при заданном распределении данных по вычислительным узлам и дальнейшей минимизации этой функции по параметру (параметрам) распределения данных; причем само распределение может являться изменяемым. Реально построение подобной функции затруднено вследствие необходимости количественного определения временных параметров выполнения операций и выявлении значимых параметров оптимизации. Претендентом на роль подобной функции может служить, например, вышеописанный сетевой закон Амдаля.
В стандартных пакетах решения задач линейной алгебры используются основанные на теоретическом анализе и долговременной практике методы распределения данных по вычислительным узлам.
2.3 Классификация параллельных вычислительных систем
Классификация архитектур вычислительных систем преследует цели выявление как основных факторов, характеризующих каждую архитектуру, так и взаимосвязей параллельных вычислительных структур.
SISD (Single Instruction stream / Single Data stream) – одиночный поток команд и одиночный поток данных; к SISD-классу относятся классические последовательные (фон-Неймановского типа) машины. В таких машинах имеется только один поток (последовательно обрабатываемых) команд, каждая из которых инициирует одну скалярную операцию. В этот класс попадают и машины с технологией конвейерной обработки.
SIMD (Single Instruction stream / Multiple Data stream) – одиночный поток команд наряду со множественным потоком данных. При этом сохраняется один поток команд, но включающий векторные команды, выполняющие одну арифметическую операцию сразу над многими данными. Выполнение векторных операций может производиться матрицей процессоров (как в машине ILLIAC IV) или конвейерным способом (Cray-1). Фактически микропроцессоры Pentium VI и Xeon c набором инструкций MMX, SSE, SSE2 являются однокристальными SIMD-системами.
Из стран СНГ SIMD-систем следует назвать ПС-2000 (1972 – 1975) – высокопараллельная компьютерная система для обработки информации с производительностью до 200 млн. оп/с.
MISD (Multiple Instruction stream/Single Data stream) – множественный поток команд и одиночный поток данных. Архитектура подразумевает наличие многих процессоров, обрабатывающих один и тот же поток данных; считается, что таких машин не существует.
MIMD (Multiple Instruction stream / Multiple Data stream) – множественные потоки как команд, так и данных. К классу MIMD принадлежат машины двух типов: с управлением от потока команд и управлением от потока данных; если в компьютерах первого типа используется традиционное выполнение команд последовательно их расположения в программе, то второй тип предполагает активацию операторов по мере их текущей готовности.
Класс предполагает наличие нескольких объединенных в единый комплекс процессоров, работающий каждый со своим потоком команд и данных.
Классический пример – система Denelcor HEP (Heterogeneous Element Processor); содержит до 16 процессорных модулей, через многокаскадный переключатель связанных со 128 модулями памяти данных, причем все процессорные модули могут работать независимо друг от друга со своими потоками команд, а каждый процессорный модуль может поддерживать до 50 потоков команд пользователей.
2.4 Многопроцессорные вычислительные системы с распределенной памятью
С последнего десятилетия 20 века наблюдается тенденция к монополизации архитектур супер-ЭВМ системами с распределенной памятью, причем в качестве процессоров на вычислительных узлах все чаще применяются легкодоступные готовые устройства. Основными преимуществами таких систем является огромная масштабируемость (в зависимости от класса решаемых задач и бюджета пользователь может заказать систему с числом узлов от нескольких десятков до тысяч); что привело к появлению нового названия для рассматриваемых систем – массивно-параллельные компьютеры (вычислительные системы архитектуры MPP – Massively Parallel Processing).
Первый суперкомпьютер с массивной параллельной обработкой – Connection Machine (СМ-1), была оснащена 64000 процессоров, каждый из который имел собственную память. СМ-1 выполняла сканирование 16 тыс. статей со сводками последних новостей за 1/20 сек. и разработала интегральную схему процессора с 4 тыс. транзисторов за три минуты. Выпуклыми представителями MPP-систем являются суперкомпьютеры серии Cry T3.
Cry T3E (1350) это мультипроцессорная вычислительная система 2000 года выпуска, с распределенной памятью построена из RISC-процессоров. Топология коммуникационной сети – трехмерный тор. Операционная система UNICOS/mk (операционная система UNIX с микроядром). Трансляторы для языков FORTRAN, HPF, C/C++. Тактовая частота 675 МГц. Количество процессоров от 40 до 2176. Максимальный объем оперативной памяти для каждого узла 512 Мбайт и максимальное быстродействие 2938 Гфлоп/с. В отличие от предшественника – Cry T3D, данной системе не требуется фронтальный компьютер.
В системе используется процессор Alpha21164A, однако, при необходимости, его несложно заменить другим, например, более быстродействующим процессором. Каждый процессорный элемент содержит центральный процессор, модуль памяти и коммуникационный узел для связи с другими процессорами. Пропускная способность канала связи между процессорами 325 Мбайт/с.
Поддерживаются модели программирования MPI, PVM, HPF, собственная библиотека обмена сообщениями Cray shmem. Быстродействие, полученное при решении систем линейных алгебраических уравнений, достигает 1,12 Тфлоп/с.
МРР – система состоит из однородных вычислительных узлов, включающих:
один, а иногда несколько центральных процессоров (обычно архитектуры RISC – Reduced Instruction Set Computing, для которой характерно длинное командное слово для задания операций, сокращенный набор команд и выполнение большинства операций за один такт процессора),
локальную память (причем прямой доступ к памяти других узлов невозможен),
коммуникационный процессор (или сетевой адаптер),
жесткие диски (необязательно) и/или другие устройства ввода/вывода.
К системе добавляются специальные узлы ввода-вывода и управляющие узлы. Вычислительные узлы связаны некоторой коммуникационной средой (высокоскоростная сеть, коммутаторы и т.п.).
Техническое обслуживание многопроцессорных систем является непростой задачей – при числе вычислительных узлов сотни/тысячи неизбежен ежедневный отказ нескольких из них; система 5k управления ресурсами (программно-аппаратный комплекс) массивно-параллельного компьютера обязана обрабатывать подобные ситуации в обход катастрофического общего рестарта с потерей контекста исполняющихся в данный момент задач.
2.4.1 Массивно-параллельные суперкомпьютеры серии CRY T3
Основанная в 1972 году фирма Cry Research Inc. (сейчас Cry Inc.), прославившаяся разработкой векторного суперкомпьютера Cry 1, в 1993 – 1995 годы выпустила модели Cry T3D/T3E, полностью реализующие принцип систем с массовым параллелизмом (систем MPP-архитектуры). В максимальной конфигурации эти компьютеры объединяют 32 – 2048 процессоров DEC Alpha 21064/150 MHz, 21164/600 MHz, 21164A/675 MHz (в зависимости от модели), вся предварительная обработка и подготовка программ (например, компиляция) выполняется на управляющей машине (хост-компьютере).
Разработчики серии Cry T3D/T3E пошли по пути создания виртуальной общей памяти. Каждый процессор может обращаться напрямую только к своей локальной памяти, но все узлы используют единое адресное пространство. При попытке обращения по принадлежащему локальной памяти другого процессора адресу генерируется специализированное аппаратное прерывание и операционная система выполняет пересылку страницы с одного узла на другой, причем вследствие чрезвычайно высокого быстродействия коммуникационной системы (пиковая скорость передачи данных между двумя узлами достигает 480 Мбайт/с) этот подход в целом оправдан. Однако замечен резко снижающий производительность эффект "пинг-понга" – в случае попадания на одну страницу переменных, модифицируемых несколькими процессорами, эта страница непрерывно мигрирует между узлами. Вычислительные узлы выполняют программы пользователя в монопольном режиме (однозадачный режим).
Конкретное исполнение компьютеров серии Cry T3 характеризуется тройкой чисел, например, 24/16/576 (управляющие узлы/узлы операционной системы/вычислительные узлы); при используемой топологии "трехмерный тор" каждый узел (независимо от его расположения) имеет шесть непосредственных соседей. При выборе маршрута между двумя узлами А и В (3D-координаты которых суть рисунок 11) сетевые машрутизаторы, начиная процесс с начальной вершины А, сначала выполняют смещение по координате X таким образом, пока координаты очередного узла связи и узла B не станут равными; затем аналогичные действия выполняются по координате Y и далее по Z (физически подобная маршрутизация происходит одновременно по всем трем координатам). Смещения могут быть и отрицательными, при отказе одной или нескольких связей возможен их обход.
Другой интересной особенностью архитектуры Cry T3 является поддержка барьерной синхронизации – аппаратная организация ожидания всеми процессами определенной точки в программе, при достижении которой возможна дальнейшая работа. Компьютеры серии T3E демонстрировали производительность 1,8 – 2,5 Тфлопс (на 2048 микропроцессорах Alpha/600 MHz).
Дальнейшим развитием линии массивно-параллельных компьютеров Cry T3 является суперкомпьютер Cry XT3. Каждый вычислительный узел Cry XT3 включает процессор AMD Opteron, локальную память (1 – 8 Гбайт) и обеспечивающий связь по коммуникационному блоку Cry SeaStar канал Hyper Transport, имеющий пиковую производительность (для AMD Opteron 2,4 GHz) от 2,6 Тфлопс (548 процессоров, оперативная память 4,3 Тбайт, топология 6Ч12Ч8) до 147 Тфлопс. Cray XT3 работает под управлением операционной системы UNICOS/lc, позволяющей объединять до 30000 вычислительных узлов, применяются компиляторы Fortran 77/90/95 и C/C++, коммуникационные библиотеки MPI (Message Passing Interface c поддержкой стандарта MPI 2.0) и ShMem (разработанная Cray Research Inc. библиотека для работы с общей памятью), стандартные библиотеки численных расчетов.
Несмотря на достигнутые столь высокие результаты в области MPP-систем фирма Cry Inc. производит векторно-конвейерный компьютеры, причем эти модели могут быть объединены в MPP-систему. Производительность каждого процессора компьютера Cry SV1 достигает 4 Гфлопс (общая пиковая производительность системы 32 Гфлопс), общее число процессоров может достигать 1000.
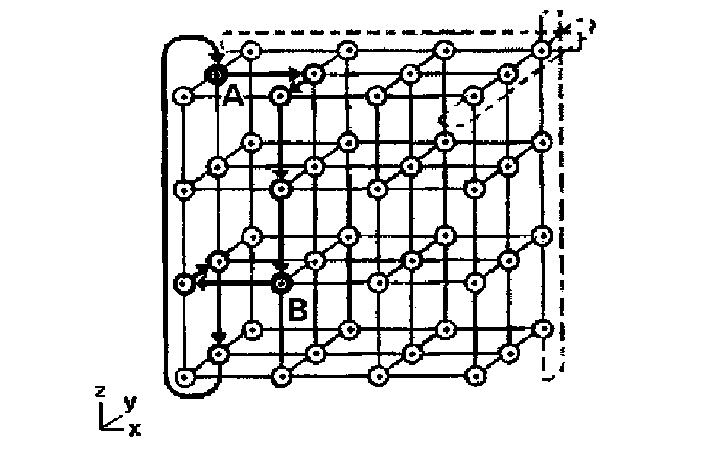
Рисунок 11. Коммуникационная решетка "трехмерный тор" компьютера Cray T3E
2.4.2 Кластерные системы класса BEOWULF
Запредельная стоимость промышленных массивно-параллельных компьютеров не давали покоя специалистам, желающим применить в своих исследованиях вычислительные системы сравнимой мощности, но не имеющих возможностей приобрести промышленные супер-ЭВМ. Поиски в этом направлении привели к развитию вычислительных кластеров (не путать с кластерами баз данных и WEB-серверов); технологической основой развития кластеризации стали широкодоступные и относительно недорогие микропроцессоры и коммуникационные (сетевые) технологии, появившиеся в свободной продаже в девяностых годах.
Вычислительный кластер представляет собой совокупность вычислительных узлов (от десятков до десятков тысяч), объединенных высокоскоростной сетью c целью решения единой вычислительной задачи. Каждый узел вычислительного кластера представляет собой фактически программируемых электронно-вычислительных машин (часто двух- или четырех- процессорный/ядерный SMP-сервер), работающую со своей собственной операционной системой (в подавляющем большинстве Linux(*)); объединяющую сеть выбирают исходя из требуемого класса решаемых задач и финансовых возможностей, практически всегда реализуется возможность удаленного доступа на кластер посредством InterNet.
Вычислительные узлы и управляющий компьютер обычно объединяют (минимум) две (независимые) сети – сеть управления (служит целям управления вычислительными узлами) и (часто более производительная) коммуникационная сеть (непосредственный обмен данными между исполняемыми на узлах процессами), дополнительно управляющий узел имеет выход в Internet для доступа к ресурсам кластера удаленных пользователей, файл-сервер выполняет функции хранения программ пользователя (рисунок 12). Администрирование кластера осуществляется с управляющей ЭВМ (или посредством удаленного доступа), пользователи имеют право доступа (в соответствие с присвоенными администратором правами) к ресурсам кластера исключительно через управляющий компьютер.
Windows-кластеры значительной мощности до настоящего времени остаются экзотикой в силу известных причин (несмотря на активно продвигаемые MS решения класса Windows Compute Cluster Server – WCCS).
Одним из первых кластерных проектов явился проект BEOWULF. Проект "БЕОВУЛЬФ" был заложен в созданном на основе принадлежащей NASA организации GSFC (Goddard Space Flight Center) исследовательском центре CESDIS (Center of Excellence in Space Data and Information Sciences) в 1994 году и стартовал сборкой в GSFC 16шестнадцатиузлового кластера (на процессорах 486DX4/100 MHz, 16 Mb памяти, 3 сетевых адаптера на каждом узле и 3 параллельных 10 Mbit Ethernet-кабелей); вычислительная система предназначалась для проведения работ по проекту ESS (Earth and Space Sciences Project).
Позднее в подразделениях NASA были собраны другие модели BEOWULF-подобных кластеров: например, theHIVE (Highly-parallel Integrated Virtual Environment) из 64 двухпроцессорных (Pentium Pro/200 MHz, 4 Gb памяти и 5 коммутаторов Fast Ethernet в каждом) узлов. Именно в рамках проекта Beowulf были разработаны драйверы для реализации режима Channel Bonding.
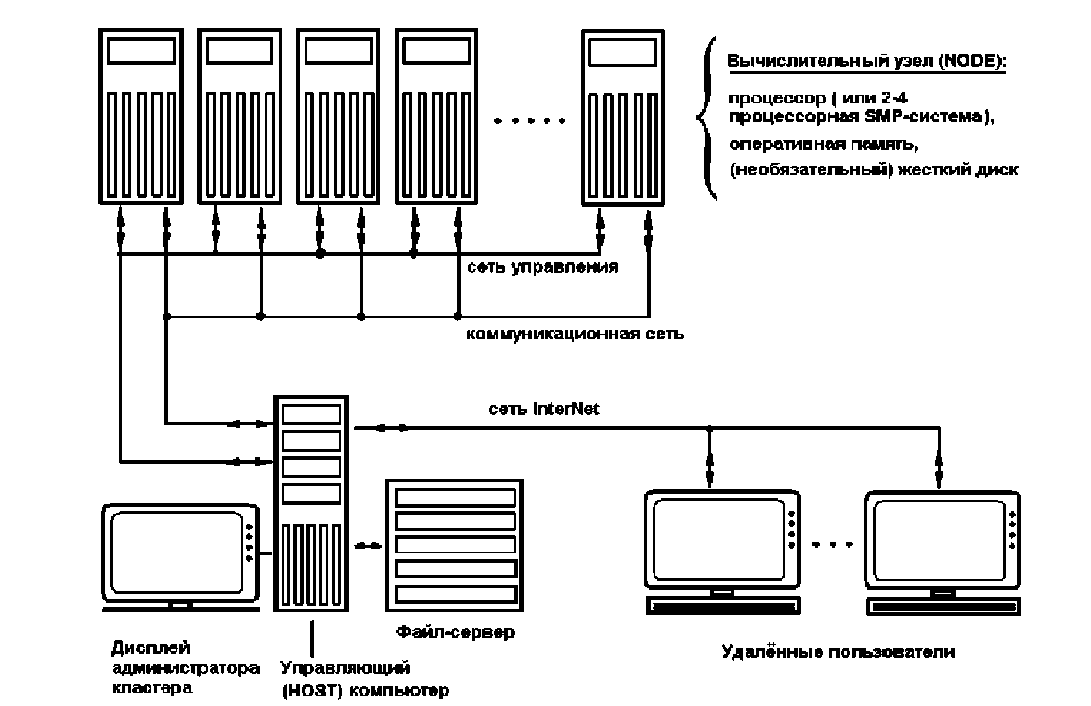
Рисунок 12. Укрупненная схема вычислительного кластера
"Беовульф" – типичный образец многопроцессорной системы MIMD (Multiple Instruction − Multiple Data), при этом одновременно выполняются несколько программных ветвей, в определенные промежутки времени обменивающиеся данными. Многие последующие разработки во всех странах мира фактически являются кланами Beowulf.
В 1998 году в национальной лаборатории Лос-Аламос астрофизик Michael Warren с сотрудниками группы теоретической астрофизики построили вычислительную систему Avalon, представляющую Linux-кластер на процессорах DEC Alpha/533 MHz. Первоначально Avalon состоял из 68 процессоров, затем был расширен до 140, в каждом узле установлено 256 MB оперативной памяти, EIDE-жесткий диск 3,2 Gb, сетевой адаптер фирмы Kingston.
Узлы соединены с помощью четырех коммутаторов Fast Ethernet и центрального двенадцатипортового коммутатора Gigabit Ethernet фирмы 3Com.
Типичным образцом массивно-параллельной кластерной вычислительной системы являются МВС-1000M (коммуникационная сеть – Myrinet 2000, скорость обмена информацией 120–170 Мбайт/сек, вспомогательные – Fast и Gigabit Ethernet) и МВС-15000ВС.
Требование максимальной эффективности использования ресурсов вычислительных мощностей (как процессорных, так и оперативной и дисковой памяти) отдельных процессоров кластера неизбежно приводит к снижению "интеллектуальности" операционной системы вычислительных узлов до уровня мониторов; с другой стороны, предлагаются распределенные кластерные операционные системы – например, Amoeba, Chorus, Mach и др.
Специально для комплектации аппаратной части вычислительных кластеров выпускаются Bladed - сервера (*) – узкие вертикальные платы, включающие процессор, оперативную память (обычно 256 – 512 МБайт при L2-кэше 128 – 256 КБайт), дисковую память и микросхемы сетевой поддержки; эти платы устанавливаются в стандартные "корзины" формата 3U шириной 19І и высотой 5,25І до 24 штук на каждую (240 вычислительных узлов на стойку высотою 180 см). Для снижения общего энергопотребления могут применяться расходующие всего единицы ватт (против 75 W для P4 или 130 W для кристаллов архитектуры IA-64) процессоры Transmeta Crusoe серии TM 5x00 с технологией VLIW; при этом суммарная потребляемая мощность при 240 вычислительных узлах не превышает 1 кВт.
2.4.3 Коммуникационные технологии, используемые при создании массово-параллельных суперкомпьютеров
Важным компонентом массово-параллельных компьютеров является коммуникационная среда – набор аппаратных и программных средств, обеспечивающих обмен сообщениями между процессорами. Фактически коммуникационная среда в данном случае является аналогом общей шины традиционных электронно-вычислительных машин и посему оказывает сильнейшее влияние на производительность всей вычислительной системы.
Заключение
Параллельнoe программирование представляет собой целое направление смежных вопросов, включающих аппаратную поддержку, анализ структуры алгоритмов с целью выявления параллелизма и алгоритмические языки для программирования параллельных задач.
Технологии параллельных вычислений в настоящее время бурно развиваются в связи с требованиями мировой науки и технологий.
Достаточно часто приходится сталкиваться с такими задачами, которые, представляя немалую ценность для общества, не могут быть решены с помощью относительно медленных компьютеров офисного или домашнего класса. Единственная надежда в этом случае возлагается на компьютеры с большим быстродействием, которые принято называть суперкомпьютерами. Только машины такого класса могут справиться с обработкой больших объемов информации. Это могут быть, например, статистические данные или результаты метеорологических наблюдений, финансовая информация. Иногда скорость обработки имеет решающее значение. Это составление прогноза погоды и моделирование климатических изменений. Чем раньше предсказано стихийное бедствие, тем больше возможностей подготовиться к нему. Важной задачей является моделирование лекарственных средств, расшифровка генома человека, разведка месторождений нефти и газа и другие объемные задачи, решение которых возможно с помощью суперкомпьютеров и кластерных систем.
Сегодняшняя проблема – явный недостаток аппаратных средств для параллельных вычислений в учебных и научных учреждениях, что не дает возможности всестороннего освоения соответствующих технологий; часто практикуемое чисто теоретическое изучение предмета приводит скорее к негативным, чем к позитивным следствиям. Только сейчас появляются технологии, позволяющие ввести практику параллельных вычислений в большинство учебных и производственных лабораторий.
Создание эффективных параллельных программ требует намного более серьезного и углубленного анализа структуры алгоритмов, нежели при традиционно-последовательном программировании, причем некоторые подходы невозможно реализовать без серьезного изменения мышления программистов.
Наряду с теоретическим анализом для получения практически значимых результатов необходима постоянная практика в создании параллельных программ.
Список использованной литературы
С. Немнюгин, О. Стесик. Параллельное программирование для многопроцессорных вычислительных систем
Воеводин В.В., Воеводин Вл.В. Параллельные вычисления. -СПб.: БХВ-Петербург, 2004. -608 с.
Гарви М.Дейтел. Введение в операционные системы (пер. с англ. Л.А.Теплицкого, А.Б.Ходулева, Вс.С.Штаркмана под редакцией Вс.С. Штаркмана). -М.: Мир, 1987 (электронная версия deepweb, 2004)
Гергель В.П., Стронгин Р.Г. Основы параллельных вычислений для многопроцессорных вычислительных систем (учебное пособие, изд. 2, дополненное). -Н.Новгород.: изд. ННГУ им. Н.И.Лобачевского, -2003 (электронная версия pilger.mgapi.edu/metods/1441/basic_pr.zip).
Корнеев В.В. Вычислительные системы. -М.: Гелиос АРВ, -2004, -512 с.
Лацис А.О. Как построить и использовать суперкомпьютер. -М.: Бестселлер, 2003.-240 с.
Крюков В.А.. Разработка параллельных программ для вычислительных кластеров и сетей. // Информационные технологии и вычислительные системы. -М.: № U2,2003.
Шпаковский Г.И. Организация параллельных ЭВМ и суперскалярных процессоров. // Учеб. пособие. -Минск.: Белгосуниверситет, 1996. -296 с. (электронная версия pilger.mgapi.edu/metods/1441/spakovsk.zip)
Шпаковский Г.И., Серикова Н.В. Программирование для многопроцессорных систем в стандарте MPI. -Минск:, БГУ, 2002. -325 с. (электронная версия cluster.bsu/download/book_PDF.pdf, pilger.mgapi.edu/metods/1441/pos_mpi.pdf)
Андрианов А.Н., Бугеря А.Б., Ефимкин К.Н., Задыхайло И.Б. Норма. Описание языка. Рабочий стандарт. //Препринт ИПМ им.М.В.Келдыша РАН, № 120, 1995, -50 с.8.
Информационно-аналитические материалы по параллельным вычислениям (электронная версия parallel