Кластерный анализ
КЛАСТЕРНЫЙ АНАЛИЗ В ЗАДАЧАХ СОЦИАЛЬНО-ЭКОНОМИЧЕСКОГО ПРОГНОЗИРОВАНИЯ
Введение в кластерный анализ.
При анализе и прогнозировании социально-экономических явлений исследователь довольно часто сталкивается с многомерностью их описания. Это происходит при решении задачи сегментирования рынка, построении типологии стран по достаточно большому числу показателей, прогнозирования конъюнктуры рынка отдельных товаров, изучении и прогнозировании экономической депрессии и многих других проблем.
Методы многомерного анализа - наиболее действенный количественный инструмент исследования социально-экономических процессов, описываемых большим числом характеристик. К ним относятся кластерный анализ, таксономия, распознавание образов, факторный анализ.
Кластерный анализ наиболее ярко отражает черты многомерного анализа в классификации, факторный анализ – в исследовании связи.
Иногда подход кластерного анализа называют в литературе численной таксономией, численной классификацией, распознаванием с самообучением и т.д.
Первое применение кластерный анализ нашел в социологии. Название кластерный анализ происходит от английского слова cluster – гроздь, скопление. Впервые в 1939 был определен предмет кластерного анализа и сделано его описание исследователем Трионом. Главное назначение кластерного анализа – разбиение множества исследуемых объектов и признаков на однородные в соответствующем понимании группы или кластеры. Это означает, что решается задача классификации данных и выявления соответствующей структуры в ней. Методы кластерного анализа можно применять в самых различных случаях, даже в тех случаях, когда речь идет о простой группировке, в которой все сводится к образованию групп по количественному сходству.
Большое достоинство кластерного анализа в том, что он позволяет производить разбиение объектов не по одному параметру, а по целому набору признаков. Кроме того, кластерный анализ в отличие от большинства математико-статистических методов не накладывает никаких ограничений на вид рассматриваемых объектов, и позволяет рассматривать множество исходных данных практически произвольной природы. Это имеет большое значение, например, для прогнозирования конъюнктуры, когда показатели имеют разнообразный вид, затрудняющий применение традиционных эконометрических подходов.
Кластерный анализ позволяет рассматривать достаточно большой объем информации и резко сокращать, сжимать большие массивы социально-экономической информации, делать их компактными и наглядными.
Важное значение кластерный анализ имеет применительно к совокупностям временных рядов, характеризующих экономическое развитие (например, общехозяйственной и товарной конъюнктуры). Здесь можно выделять периоды, когда значения соответствующих показателей были достаточно близкими, а также определять группы временных рядов, динамика которых наиболее схожа.
Кластерный анализ можно использовать циклически. В этом случае исследование производится до тех пор, пока не будут достигнуты необходимые результаты. При этом каждый цикл здесь может давать информацию, которая способна сильно изменить направленность и подходы дальнейшего применения кластерного анализа. Этот процесс можно представить системой с обратной связью.
В задачах социально-экономического прогнозирования весьма перспективно сочетание кластерного анализа с другими количественными методами (например, с регрессионным анализом).
Как и любой другой метод, кластерный анализ имеет определенные недостатки и ограничения: В частности, состав и количество кластеров зависит от выбираемых критериев разбиения. При сведении исходного массива данных к более компактному виду могут возникать определенные искажения, а также могут теряться индивидуальные черты отдельных объектов за счет замены их характеристиками обобщенных значений параметров кластера. При проведении классификации объектов игнорируется очень часто возможность отсутствия в рассматриваемой совокупности каких-либо значений кластеров.
В кластерном анализе считается, что:
а) выбранные характеристики допускают в принципе желательное разбиение на кластеры;
б) единицы измерения (масштаб) выбраны правильно.
Выбор масштаба играет большую роль. Как правило, данные нормализуют вычитанием среднего и делением на стандартное отклоненение, так что дисперсия оказывается равной единице.
Задача кластерного анализа.
Задача кластерного анализа заключается в том, чтобы на основании данных, содержащихся во множестве Х, разбить множество объектов G на m (m – целое) кластеров (подмножеств) Q1, Q2, …, Qm, так, чтобы каждый объект Gj принадлежал одному и только одному подмножеству разбиения и чтобы объекты, принадлежащие одному и тому же кластеру, были сходными, в то время, как объекты, принадлежащие разным кластерам были разнородными.
Например, пусть G включает n стран, любая из которых характеризуется ВНП на душу населения (F1), числом М автомашин на 1 тысячу человек (F2), душевым потреблением электроэнергии (F3), душевым потреблением стали (F4) и т.д. Тогда Х1 (вектор измерений) представляет собой набор указанных характеристик для первой страны, Х2 - для второй, Х3 для третьей, и т.д. Задача заключается в том, чтобы разбить страны по уровню развития.
Решением задачи кластерного анализа являются разбиения, удовлетворяющие некоторому критерию оптимальности. Этот критерий может представлять собой некоторый функционал, выражающий уровни желательности различных разбиений и группировок, который называют целевой функцией. Например, в качестве целевой функции может быть взята внутригрупповая сумма квадратов отклонения:
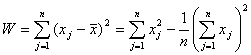
где xj - представляет собой измерения j-го объекта.
Для решения задачи кластерного анализа необходимо определить понятие сходства и разнородности.
Понятно то, что объекты i-ый и j-ый попадали бы в один кластер, когда расстояние (отдаленность) между точками Хi и Хj было бы достаточно маленьким и попадали бы в разные кластеры, когда это расстояние было бы достаточно большим. Таким образом, попадание в один или разные кластеры объектов определяется понятием расстояния между Хi и Хj из Ер, где Ер - р-мерное евклидово пространство. Неотрицательная функция d(Хi , Хj) называется функцией расстояния (метрикой), если:
а) d(Хi , Хj) ³ 0, для всех Хi и Хj из Ер
б) d(Хi, Хj) = 0, тогда и только тогда, когда Хi = Хj
в) d(Хi, Хj) = d(Хj, Хi)
г) d(Хi, Хj) £ d(Хi, Хk) + d(Хk, Хj), где Хj; Хi и Хk - любые три вектора из Ер.
Значение d(Хi, Хj) для Хi и Хj называется расстоянием между Хi и Хj и эквивалентно расстоянию между Gi и Gj соответственно выбранным характеристикам (F1, F2, F3, ..., Fр).
Наиболее часто употребляются следующие функции расстояний:
1. Евклидово
расстояние d2(Хi , Хj) = 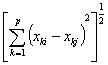
2. l1 - норма d1(Хi , Хj) = 
3. Сюпремум -
норма d¥ (Хi , Хj) = sup
k = 1, 2, ..., р
4. lp - норма dр(Хi , Хj) = 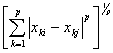
Евклидова метрика является наиболее популярной. Метрика l1 наиболее легкая для вычислений. Сюпремум-норма легко считается и включает в себя процедуру упорядочения, а lp - норма охватывает функции расстояний 1, 2, 3,.
Пусть n измерений Х1, Х2,..., Хn представлены в виде матрицы данных размером p ´ n:
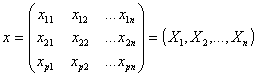
Тогда расстояние между парами векторов d(Хi , Хj) могут быть представлены в виде симметричной матрицы расстояний:
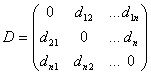
Понятием, противоположным расстоянию, является понятие сходства между объектами Gi. и Gj. Неотрицательная вещественная функция S(Хi ; Хj) = Sij называется мерой сходства, если :
1) 0£ S(Хi , Хj)<1 для Хi ¹ Хj
2) S(Хi , Хi) = 1
3) S(Хi , Хj) = S(Хj , Хi)
Пары значений мер сходства можно объединить в матрицу сходства:
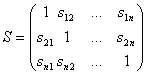
Величину Sij называют коэффициентом сходства.
1.3. Методы кластерного анализа.
Сегодня существует достаточно много методов кластерного анализа. Остановимся на некоторых из них (ниже приводимые методы принято называть методами минимальной дисперсии).
Пусть Х - матрица наблюдений: Х = (Х1, Х2,..., Хu) и квадрат евклидова расстояния между Хi и Хj определяется по формуле:
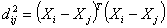
1) Метод полных связей.
Суть данного метода в том, что два объекта, принадлежащих одной и той же группе (кластеру), имеют коэффициент сходства, который меньше некоторого порогового значения S. В терминах евклидова расстояния d это означает, что расстояние между двумя точками (объектами) кластера не должно превышать некоторого порогового значения h. Таким образом, h определяет максимально допустимый диаметр подмножества, образующего кластер.
2) Метод максимального локального расстояния.
Каждый объект рассматривается как одноточечный кластер. Объекты группируются по следующему правилу: два кластера объединяются, если максимальное расстояние между точками одного кластера и точками другого минимально. Процедура состоит из n - 1 шагов и результатом являются разбиения, которые совпадают со всевозможными разбиениями в предыдущем методе для любых пороговых значений.
3) Метод Ворда.
В этом методе в качестве целевой функции применяют внутригрупповую сумму квадратов отклонений, которая есть ни что иное, как сумма квадратов расстояний между каждой точкой (объектом) и средней по кластеру, содержащему этот объект. На каждом шаге объединяются такие два кластера, которые приводят к минимальному увеличению целевой функции, т.е. внутригрупповой суммы квадратов. Этот метод направлен на объединение близко расположенных кластеров.
4) Центроидный метод.
Расстояние между двумя кластерами определяется как евклидово расстояние между центрами (средними) этих кластеров:
d2 ij = (`X –`Y)Т(`X –`Y) Кластеризация идет поэтапно на каждом из n–1 шагов объединяют два кластера G и p, имеющие минимальное значение d2ij Если n1 много больше n2, то центры объединения двух кластеров близки друг к другу и характеристики второго кластера при объединении кластеров практически игнорируются. Иногда этот метод иногда называют еще методом взвешенных групп.
1.4 Алгоритм последовательной кластеризации.
Рассмотрим Ι = (Ι1, Ι2, … Ιn) как множество кластеров {Ι1}, {Ι2},…{Ιn}. Выберем два из них, например, Ι i и Ι j, которые в некотором смысле более близки друг к другу и объединим их в один кластер. Новое множество кластеров, состоящее уже из n-1 кластеров, будет:
{Ι1}, {Ι2}…, {Ι i , Ι j}, …, {Ιn}.
Повторяя процесс, получим последовательные множества кластеров, состоящие из (n-2), (n-3), (n–4) и т.д. кластеров. В конце процедуры можно получить кластер, состоящий из n объектов и совпадающий с первоначальным множеством Ι = (Ι1, Ι2, … Ιn).
В качестве меры расстояния возьмем квадрат евклидовой метрики di j2. и вычислим матрицу D = {di j2}, где di j2 - квадрат расстояния между
Ι i и Ι j:
| Ι1 | Ι2 | Ι3 | …. | Ιn | |
| Ι1 | 0 | d122 | d132 | …. | d1n2 |
| Ι2 | 0 | d232 | …. | d2n2 | |
| Ι3 | 0 | …. | d3n2 | ||
| …. | …. | …. | |||
| Ιn | 0 |
Пусть расстояние между Ι i и Ι j будет минимальным:
di j2 = min {di j2, i ¹ j}. Образуем с помощью Ι i и Ι j новый кластер
{Ι i , Ι j}. Построим новую ((n-1), (n-1)) матрицу расстояния
| {Ι i , Ι j} | Ι1 | Ι2 | Ι3 | …. | Ιn | |
| {Ι i ; Ι j} | 0 | di j21 | di j22 | di j23 | …. | di j2n |
| Ι1 | 0 | d122 | d13 | …. | d12n | |
| Ι2 | 0 | di j21 | …. | d2n | ||
| Ι3 | 0 | …. | d3n | |||
| Ιn | 0 |
(n-2) строки для последней матрицы взяты из предыдущей, а первая строка вычислена заново. Вычисления могут быть сведены к минимуму, если удастся выразить di j2k,k = 1, 2,…, n; (k ¹ i ¹ j) через элементы первоначальной матрицы.
Исходно определено расстояние лишь между одноэлементными кластерами, но надо определять расстояния и между кластерами, содержащими более чем один элемент. Это можно сделать различными способами, и в зависимости от выбранного способа мы получают алгоритмы кластер анализа с различными свойствами. Можно, например, положить расстояние между кластером i + j и некоторым другим кластером k, равным среднему арифметическому из расстояний между кластерами i и k и кластерами j и k:
di+j,k = ½ (di k + dj k).
Но можно также определить di+j,k как минимальное из этих двух расстояний:
di+j,k = min (di k + dj k).
Таким образом, описан первый шаг работы агломеративного иерархического алгоритма. Последующие шаги аналогичны.
Довольно широкий класс алгоритмов может быть получен, если для перерасчета расстояний использовать следующую общую формулу:
di+j,k = A(w) min(dik djk) + B(w) max(dik djk), где
A(w) =  , если dik £ djk
A(w) =  , если dik > djk
B(w) = , если dik £ djk
B(w) =  , если dik > djk
где ni и nj - число элементов в кластерах i и j, а w – свободный параметр, выбор которого определяет конкретный алгоритм. Например, при w = 1 мы получаем, так называемый, алгоритм «средней связи», для которого формула перерасчета расстояний принимает вид:
di+j,k