Кластерный анализ
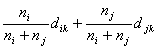
В данном случае расстояние между двумя кластерами на каждом шаге работы алгоритма оказывается равным среднему арифметическому из расстояний между всеми такими парами элементов, что один элемент пары принадлежит к одному кластеру, другой - к другому.
Наглядный смысл параметра w становится понятным, если положить w ® ¥. Формула пересчета расстояний принимает вид:
di+j,k = min (di,k djk)
Это будет так называемый алгоритм «ближайшего соседа», позволяющий выделять кластеры сколь угодно сложной формы при условии, что различные части таких кластеров соединены цепочками близких друг к другу элементов. В данном случае расстояние между двумя кластерами на каждом шаге работы алгоритма оказывается равным расстоянию между двумя самыми близкими элементами, принадлежащими к этим двум кластерам.
Довольно часто предполагают, что первоначальные расстояния (различия) между группируемыми элементами заданы. В некоторых задачах это действительно так. Однако, задаются только объекты и их характеристики и матрицу расстояний строят исходя из этих данных. В зависимости от того, вычисляются ли расстояния между объектами или между характеристиками объектов, используются разные способы.
В случае кластер анализа объектов наиболее часто мерой различия служит либо квадрат евклидова расстояния
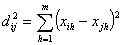
(где xih, xjh - значения h-го признака для i-го и j-го объектов, а m - число характеристик), либо само евклидово расстояние. Если признакам приписывается разный вес, то эти веса можно учесть при вычислении расстояния
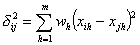
Иногда в качестве меры различия используется расстояние, вычисляемое по формуле:
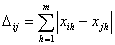
которые называют: "хэмминговым", "манхэттенским" или "сити-блок" расстоянием.
Естественной мерой сходства характеристик объектов во многих задачах является коэффициент корреляции между ними
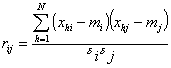
где mi ,mj ,di ,dj - соответственно средние и среднеквадратичные отклонения для характеристик i и j. Мерой различия между характеристиками может служить величина 1 - r. В некоторых задачах знак коэффициента корреляции несуществен и зависит лишь от выбора единицы измерения. В этом случае в качестве меры различия между характеристиками используется ô1 - ri j ô
1.5 Число кластеров.
Очень важным вопросом является проблема выбора необходимого числа кластеров. Иногда можно m число кластеров выбирать априорно. Однако в общем случае это число определяется в процессе разбиения множества на кластеры.
Проводились исследования Фортьером и Соломоном, и было установлено, что число кластеров должно быть принято для достижения вероятности a того, что найдено наилучшее разбиение. Таким образом, оптимальное число разбиений является функцией заданной доли b наилучших или в некотором смысле допустимых разбиений во множестве всех возможных. Общее рассеяние будет тем больше, чем выше доля b допустимых разбиений. Фортьер и Соломон разработали таблицу, по которой можно найти число необходимых разбиений. S(a, b) в зависимости от a и b (где a - вероятность того, что найдено наилучшее разбиение, b - доля наилучших разбиений в общем числе разбиений) Причем в качестве меры разнородности используется не мера рассеяния, а мера принадлежности, введенная Хользенгером и Харманом. Таблица значений S(a, b) приводится ниже.
Таблица значений S(a, b)
| b a | 0.20 | 0.10 | 0.05 | 0.01 | 0.001 | 0.0001 |
| 0.20 | 8 | 11 | 14 | 21 | 31 | 42 |
| 0.10 | 16 | 22 | 29 | 44 | 66 | 88 |
| 0.05 | 32 | 45 | 59 | 90 | 135 | 180 |
| 0.01 | 161 | 230 | 299 | 459 | 689 | 918 |
| 0.001 | 1626 | 2326 | 3026 | 4652 | 6977 | 9303 |
| 0.0001 | 17475 | 25000 | 32526 | 55000 | 75000 | 100000 |
Довольно часто
критерием объединения (числа кластеров) становится изменение соответствующей
функции. Например, суммы квадратов отклонений: 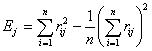
Процессу группировки должно соответствовать здесь последовательное минимальное возрастание значения критерия E. Наличие резкого скачка в значении E можно интерпретировать как характеристику числа кластеров, объективно существующих в исследуемой совокупности.
Итак, второй способ определения наилучшего числа кластеров сводится к выявлению скачков, определяемых фазовым переходом от сильно связанного к слабосвязанному состоянию объектов.
1.6 Дендограммы.
Наиболее известный метод представления матрицы расстояний или сходства основан на идее дендограммы или диаграммы дерева. Дендограмму можно определить как графическое изображение результатов процесса последовательной кластеризации, которая осуществляется в терминах матрицы расстояний. С помощью дендограммы можно графически или геометрически изобразить процедуру кластеризации при условии, что эта процедура оперирует только с элементами матрицы расстояний или сходства.
Существует много способов построения дендограмм. В дендограмме объекты располагаются вертикально слева, результаты кластеризации – справа. Значения расстояний или сходства, отвечающие строению новых кластеров, изображаются по горизонтальной прямой поверх дендограмм.
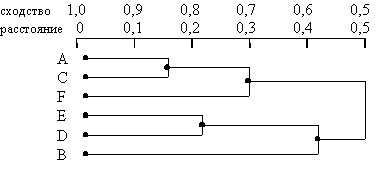
Рис1
На рисунке 1 показан один из примеров дендограммы. Рис 1 соответствует случаю шести объектов (n=6) и k характеристик (признаков). Объекты А и С наиболее близки и поэтому объединяются в один кластер на уровне близости, равном 0,9. Объекты D и Е объединяются при уровне 0,8. Теперь имеем 4 кластера:
(А, С), (F), (D, E), (B).
Далее образуются кластеры (А, С, F) и (E, D, B), соответствующие уровню близости, равному 0,7 и 0,6. Окончательно все объекты группируются в один кластер при уровне 0,5.
Вид дендограммы зависит от выбора меры сходства или расстояния между объектом и кластером и метода кластеризации. Наиболее важным моментом является выбор меры сходства или меры расстояния между объектом и кластером.
Число алгоритмов кластерного анализа слишком велико. Все их можно подразделить на иерархические и неиерархические.
Иерархические алгоритмы связаны с построением дендограмм и делятся на:
а) агломеративные, характеризуемые последовательным объединением исходных элементов и соответствующим уменьшением числа кластеров;
б) дивизимные (делимые), в которых число кластеров возрастает, начиная с одного, в результате чего образуется последовательность расщепляющих групп.
Алгоритмы кластерного анализа имеют сегодня хорошую программную реализацию, которая позволяет решить задачи самой большой размерности.
1.7 Данные
Кластерный анализ можно применять к интервальным данным, частотам, бинарными данным. Важно, чтобы переменные изменялись в сравнимых шкалах.
Неоднородность единиц измерения и вытекающая отсюда невозможность обоснованного выражения значений различных показателей в одном масштабе приводит к тому, что величина расстояний между точками, отражающими положение объектов в пространстве их свойств, оказывается зависящей от произвольно избираемого масштаба. Чтобы устранить неоднородность измерения исходных данных, все их значения предварительно нормируются, т.е. выражаются через отношение этих значений к некоторой величине, отражающей определенные свойства данного показателя. Нормирование исходных данных для кластерного анализа иногда проводится посредством деления исходных величин на среднеквадратичное отклонение соответствующих показателей. Другой способ сводиться к вычислению, так называемого, стандартизованного вклада. Его еще называют Z-вкладом.
Z-вклад показывает, сколько стандартных отклонений отделяет данное наблюдение от среднего значения:
 , где xi – значение данного наблюдения, – среднее, S – стандартное отклонение.
Среднее для Z-вкладов является нулевым и стандартное отклонение равно 1.
Стандартизация позволяет сравнивать наблюдения из различных распределений. Если распределение переменной является нормальным (или близким к нормальному), и средняя и дисперсия известны или оцениваются по большим выборным, то Z-вклад для наблюдения обеспечивает более специфическую информацию о его расположении.
Заметим, что методы нормирования означают признание всех признаков равноценными с точки зрения выяснения сходства рассматриваемых объектов. Уже отмечалось, что применительно к экономике признание равноценности различных показателей кажется оправданным отнюдь не всегда. Было бы, желательным наряду с нормированием придать каждому из показателей вес, отражающий его значимость в ходе установления сходств и различий объектов.
В этой ситуации приходится прибегать к способу определения весов отдельных показателей – опросу экспертов. Например, при решении задачи о классификации стран по уровню экономического развития использовались результаты опроса 40 ведущих московских специалистов по проблемам развитых стран по десятибалльной шкале:
обобщенные показатели социально-экономического развития – 9 баллов;
показатели отраслевого распределения занятого населения – 7 баллов;
показатели распространенности наемного труда – 6 баллов;
показатели, характеризующие человеческий элемент производительных сил – 6 баллов;
показатели развития материальных производительных сил – 8 баллов;
показатель государственных расходов – 4балла;
«военно-экономические» показатели – 3 балла;
социально-демографические показатели – 4 балла.
Оценки экспертов отличались сравнительно высокой устойчивостью.
Экспертные оценки дают известное основание для определения важности индикаторов, входящих в ту или иную группу показателей. Умножение нормированных значений показателей на коэффициент, соответствующий среднему баллу оценки, позволяет рассчитывать расстояния между точками, отражающими положение стран в многомерном пространстве, с учетом неодинакового веса их признаков.
Довольно часто при решении подобных задач используют не один, а два расчета: первый, в котором все признаки считаются равнозначными, второй, где им придаются различные веса в соответствии со средними значениями экспертных оценок.
1.8. Применение кластерного анализа.
Рассмотрим некоторые приложения кластерного анализа.
Деление стран на группы по уровню развития.
Изучались 65 стран по 31 показателю (национальный доход на душу населения, доля населения занятого в промышленности в %, накопления на душу населения, доля населения, занятого в сельском хозяйстве в %, средняя продолжительность жизни, число автомашин на 1 тыс. жителей, численность вооруженных сил на 1 млн. жителей, доля ВВП промышленности в %, доля ВВП сельского хозяйства в %, и т.д.)
Каждая из стран выступает в данном рассмотрении как объект, характеризуемый определенными значениями 31 показателя. Соответственно они могут быть представлены в качестве точек в 31-мерном пространстве. Такое пространство обычно называется пространством свойств изучаемых объектов. Сравнение расстояния между этими точками будет отражать степень близости рассматриваемых стран, их сходство друг с другом. Социально-экономический смысл подобного понимания сходства означает, что страны считаются тем более похожими, чем меньше различия между одноименными показателями, с помощью которых они описываются.
Первый шаг подобного анализа заключается в выявлении пары народных хозяйств, учтенных в матрице сходства, расстояние между которыми является наименьшим. Это, очевидно, будут наиболее сходные, похожие экономики. В последующем рассмотрении обе эти страны считаются единой группой, единым кластером. Соответственно исходная матрица преобразуется так, что ее элементами становятся расстояния между всеми возможными парами уже не 65, а 64 объектами – 63 экономики и вновь преобразованного кластера – условного объединения двух наиболее похожих стран. Из исходной матрицы сходства выбрасываются строки и столбцы, соответствующие расстояниям от пары стран, вошедших в объедение, до всех остальных, но зато добавляются строка и столбец, содержащие расстояние между кластером, полученным при объединении и прочими странами.
Расстояние между вновь полученным кластером и странами полагается равным среднему из расстояний между последними и двумя странами, которые составляют новый кластер. Иными словами, объединенная группа стран рассматривается как целое с характеристиками, примерно равными средним из характеристик входящих в него стран.
Второй шаг анализа заключается в рассмотрении преобразованной таким путем матрицы с 64 строками и столбцами. Снова выявляется пара экономик, расстояние между которыми имеет наименьшее значение, и они, так же как в первом случае, сводятся воедино. При этом наименьшее расстояние может оказаться как между парой стран, так и между какой-либо страной и объединением стран, полученным на предыдущем этапе.
Дальнейшие процедуры аналогичны описанным выше: на каждом этапе матрица преобразуется так, что из нее исключаются два столбца и две строки, содержащие расстояние до объектов (пар стран или объединений – кластеров), сведенных воедино на предыдущей стадии; исключенные строки и столбцы заменяются столбцом и строкой, содержащими расстояния от новых объединений до остальных объектов; далее в измененной матрице выявляется пара наиболее близких объектов. Анализ продолжается до полного исчерпания матрицы (т. е. до тех пор, пока все страны не окажутся сведенными в одно целое). Обобщенные результаты анализа матрицы можно представить в виде дерева сходства (дендограммы), подобного описанному выше, с той лишь разницей, что дерево сходства, отражающее относительную близость всех рассматриваемых нами 65 стран, много сложнее схемы, в которой фигурирует только пять народных хозяйств. Это дерево в соответствии с числом сопоставляемых объектов включает 65 уровней. Первый (нижний) уровень содержит точки, соответствующие каждых стране в отдельности. Соединение двух этих точек на втором уровне показывает пару стран, наиболее близких по общему типу народных хозяйств. На третьем уровне отмечается следующее по сходству парное соотношение стран (как уже упоминалось, в таком соотношении может находиться либо новая пара стран, либо новая страна и уже выявленная пара сходных стран). И так далее до последнего уровня, на котором все изучаемые страны выступают как единая совокупность.
В результате применения кластерного анализа были получены следующие пять групп стран:
афро-азиатская группа;
латино-азиатская группа;
латино-среднеземнаморская группа;
группа развитых капиталистических стран (без США)
США
Введение новых индикаторов сверх используемого здесь 31 показателя или замена их другими, естественно, приводят к изменению результатов классификации стран.
2. Деление стран по критерию близости культуры.
Как известно маркетинг должен учитывать культуру стран (обычаи, традиции, и т.д.).
Посредством кластеризации были получены следующие группы стран:
арабские;
ближневосточные;
скандинавские;
германоязычные;
англоязычные;
романские европейские;
латиноамериканские;
дальневосточные.
3. Разработка прогноза конъюнктуры рынка цинка.
Кластерный анализ играет важную роль на этапе редукции экономико-математической модели товарной конъюнктуры, способствуя облегчению и упрощению вычислительных процедур, обеспечению большей компактности получаемых результатов при одновременном сохранении необходимой точности. Применение кластерного анализа дает возможность разбить всю исходную совокупность показателей конъюнктуры на группы (кластеры) по соответствующим критериям, облегчая тем самым выбор наиболее репрезентативных показателей.
Кластерный анализ широко используется для моделирования рыночной конъюнктуры. Практически основное большинство задач прогнозирования опирается на использование кластерного анализа.
Например, задача разработки прогноза конъюнктуры рынка цинка.
Первоначально было отобрано 30 основных показателей мирового рынка цинка:
Х1 - время
Показатели производства:
Х2 - в мире
Х3 -