История статистики
ρx/y = 1 –  ,
где di - разности рангов; n - число пар рангов.
Для определения тесноты связи между тремя и более признаками применяется ранговый коэффициент согласия - коэффициент конкордации, который вычисляется по формуле:
w =  ,
где m - количество факторов;
n - число наблюдений;
S - сумма квадратов отклонений рангов.
Величина коэффициента конкордации более 0,5 показывает, что между исследуемыми величинами имеется тесная зависимость.
Если при определении тесноты связи с помощью приведенных ранговых коэффициентов имеются связные ранги, т.е. если двум или более показателям присвоен один и тот же ранг, то расчеты проводятся по формулам:
коэффициент Спирмена: ρx/y = 1 – 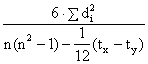 ;
коэффициент конкордации: w = 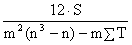 ,
где T =  (t3 – t), а t - количество связных рангов по отдельным показателям.
При исследовании социальных явлений и процессов большое значение имеет изучение качественных показателей и признаков, не имеющих количественной оценки:
| a | b | a + b |
| c | d | c + d |
| a + c | b + d | a + b + c + d |
Для определения тесноты связи двух качественных признаков, каждый из которых состоит только из двух групп, применяются коэффициенты ассоциации и контингенции. Для их вычисления строится таблица, которая показывает связь между двумя явлениями, каждое из которых должно быть альтернативным, т.е. состоящим из двух качественно отличных друг от друга значений признака (например, хороший, плохой).
Коэффициенты вычисляются по формулам:
A =  - ассоциации;
K = 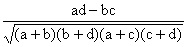 - контингенции.
Коэффициент контингенции всегда меньше коэффициента ассоциации. Связь считается подтвержденной, если A ³ 0,5, или K ³ 0,3.
Если каждый из качественных признаков состоит более чем из двух групп, то для определения тесноты связи возможно применение коэффициента взаимной сопряженности Пирсона. Этот коэффициент вычисляется по формуле:
C =  ,
где j2 - показатель взаимной сопряженности.
Расчет коэффициента взаимной сопряженности проводится по следующей схеме:
| Группа признака A | Группа признака В | Итого | ||
| B1 | B2 | B3 | ||
| A1 | f1 | f2 | f3 | n1 |
| A2 | f4 | f5 | f6 | n2 |
| A3 | f7 | f8 | f9 | n3 |
| m1 | m2 | m3 |
Расчет j2 проводится так:
по первой строке 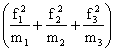 : n1 = L1;
по второй строке 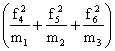 : n2 = L2;
по третьей строке 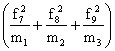 : n3 = L3;
Следовательно, j2 = L1 + L2 + L3 – 1.
Интерпретация непараметрических коэффициентов связи в некоторых случаях, особенно когда они имеют отрицательное значение, затруднительна. Их абсолютные значения могут изменяться в пределах от 0 до 1. Чем ближе абсолютные значения к единице, тем теснее связь между исследуемыми признаками.
Корреляция и регрессия. Традиционные методы корреляционно-регрессионного анализа позволяют не только оценить тесноту связи, но и выразить эту связь аналитически. Применению корреляционно-регрессионного анализа должен предшествовать качественный, теоретический анализ исследуемого социально-экономического явления или процесса.
Связь между двумя факторами аналитически выражается уравнениями:
прямой  = a0 + a1x;
гиперболы = a0 +  ;
параболы = a0 + a1x + a2x2 (или
другой ее степени);
степенной функции  .
Параметр a0 показывает усредненное влияние на результативный признак неучтенных (не выделенных для исследования) факторов. Параметр a1 - коэффициент регрессии показывает, на сколько изменяется в среднем значение результативного признака при увеличении факторного на единицу. На основе этого параметра вычисляются коэффициенты эластичности, которые показывают изменение результативного признака в процентах в зависимости от изменения факторного признака на 1%:
Э = a1∙ .
Для определения параметров уравнений используется метод наименьших квадратов, на основании которого строится соответствующая система уравнений.
Теснота связи при линейной зависимости измеряется с помощью линейного коэффициента корреляции:
r =  ,
а при криволинейной зависимости с помощью корреляционного отношения:
h =  .
Расчет коэффициентов регрессии несколько осложняется, если ряды по исследуемым факторам сгруппированы, а связь криволинейная.
Если зависимость между двумя факторами выражается уравнением гиперболы
= a0 + ,
то система уравнений для определения параметров a0 и a1 такова:
na0 + a1∑ = ∑y;
a0∑ + a1∑ = ∑y.
Для определения параметров уравнения регрессии,
выраженного степенной функцией , приводят функцию к линейному виду: lg= lga0 + a1lgx, отсюда система уравнений для определения параметров
запишется:
n∙lga0 + a1∑lgx = ∑lgy;
lga0∑lgx + a1∑(lgx)2 = ∑lgy∙lgx.
Зависимость между тремя и более факторами называется множественной или многофакторной корреляционной зависимостью. Линейная связь между тремя факторами выражается уравнением:
 = a0 + a1x + a2z,
а система нормальных уравнений для определения неизвестных параметров a0, a1, a2 будет следующей:
na0 + a1∑x + a2∑z = ∑y;
a0∑x + a1∑x2 + a2∑zx = ∑yx;
a0∑z + a1∑xz + a2∑z2 = ∑yz.
Теснота связи между тремя факторами измеряется с помощью множественного (совокупного) коэффициента корреляции:
R = 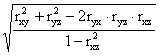 ,
где rij - парные коэффициенты корреляции между соответствующими факторами.
Для более углубленного анализа вычисляются частные коэффициенты корреляции.
Дисперсионный анализ связи. При небольшом числе наблюдений исследовать влияние одного или нескольких факторных признаков на результативный можно, используя методы дисперсионного анализа. Дисперсионный анализ проводится расчетом дисперсий: общей, межгрупповой и внутригрупповой. Общую дисперсию называют дисперсией комплекса, межгрупповую - факторной, внутригрупповую - остаточной.
Дисперсионный анализ заключается в сравнении факторной и остаточной дисперсий. Если различие между ними значимо, то факторный признак, т.е. признак, положенный в основание группировки, оказывает существенное влияние на результативный. При исследовании воздействия на результативный признак только одного факторного, т.е. однофакторного комплекса дисперсии вычисляются:
дисперсия комплекса 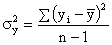 ;
факторная дисперсия 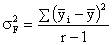 ;
остаточная дисперсия 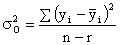 ,
где n – 1, r – 1, n – r - соответствующие числа степеней свободы;
r - число уровней (групп).
На основании дисперсий проводится расчет критерия Фишера Fp. Если расчетное значение больше табличного, т.е. Fp > Fa, то существенность влияния факторного признака подтверждается.
Тема 10. Выборочное наблюдение
Главными вопросами теории выборочного наблюдения, требующими практического закрепления на основе решения задач и выполнения упражнений, являются:
- определение предела случайной ошибки репрезентативности для различных типов выборочных характеристик с учетом особенностей отбора;
- определение объема выборки, обеспечивающего необходимую репрезентативность выборочной характеристики, с учетом особенностей отбора.
Ошибка репрезентативности, или разность между выборочной и генеральной характеристикой (средней, долей), возникающая в силу несплошного наблюдения, в основе которого лежит случайный отбор, рассчитывается как предел наивероятной ошибки. В качестве уровня гарантийной вероятности обычно берется 0,954 или 0,997. Тогда предел ошибки определяется величиной удвоенной или утроенной средней ошибки выборки: D = 2m при P = 0,954; D = 3m при P = 0,997, или в общем виде D = tm (t - коэффициент, связанный с вероятностью, гарантирующей результат).
Величина средней ошибки выборки различна для отдельных разновидностей случайного отбора. При наиболее простой системе - собственно-случайном повторном отборе - средняя ошибка определяется следующими формулами:
индивидуальный отбор:
m =  =
 ,
где σ2 - общая дисперсия признака;
n - число отобранных единиц наблюдения;
групповой (гнездовой, серийный) отбор:
m =  =
 ,
где δ2 - межгрупповая дисперсия;
r - число отобранных групп (гнезд, серий) единиц наблюдения.
При практических расчетах ошибок репрезентативности необходимо учитывать следующее:
1. Вместо генеральной дисперсии используется соответствующая выборочная дисперсия. Так, вместо общей дисперсии доли в генеральной совокупности берется общая дисперсия частости:
 = w(1 – w) вместо
 = pq.
2. В случае бесповторного способа отбора (а также механического) следует иметь в виду поправки (K) к ошибке повторной выборки на бесповторность отбора:
K =  < 1 или K = < 1.
Очевидно, что пользоваться этой поправкой целесообразно лишь тогда, когда относительный объем выборки составляет заметную часть генеральной совокупности (не менее 10%, тогда K £ 0,95).
3. При районированном отборе из типических групп единиц генеральной совокупности используется средняя из частных (групповых) дисперсий. Так, при индивидуальном отборе, пропорциональном размерам типических групп, имеем:
D = 2m =  =
 при P = 0,954,
где  - частная дисперсия
i-й группы;
ni - объем выборки в i-й группе.
Определение ошибок выборочных характеристик позволяет установить наивероятные границы нахождения соответствующих генеральных показателей:
для средней:  ,
где  - генеральная средняя;
 - выборочная средняя;
 - ошибка выборочной
средней;
для доли: p = w ± Dw,
где p - генеральная доля;
w - выборочная доля (частость);
Dw - ошибка выборочной доли.
Пример. С вероятностью 0,954 нужно определить границы среднего веса пачки чая для всей партии, поступившей в торговую сеть, если контрольная выборочная проверка дала следующие результаты (первые две графы табл. 10.1).
Таблица 10.1
Результаты взвешивания чая
| Вес, г (x) | Количество пачек (m) | Расчетные графы | |||
| x¢ | m¢ | x¢m¢ | (x¢)2m¢ | ||
| 48 - 49 | 20 | -1 | 2 | -2 | 2 |
| 49 - 50 | 50 | 0 | 5 | 0 | 0 |
| 50 - 51 | 20 | +1 | 2 | 2 | 2 |
| 51 - 52 | 10 | +2 | 1 | 2 | 4 |
| Итого: | 100 | – | 10 | 2 | 8 |
1. Средний вес пачки чая по выборке:
=  ´ K + x0 =
 ´ 1 + 49,5 = 49,7 г.
2. Выборочная дисперсия веса пачки чая:
σ2 = 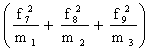 =
 = 0,76.
3. Средняя ошибка выборочной средней:
 = =
 = 0,087 г.
4. Предел для ошибки с вероятностью 0,954:
D = 2m = 0,174 г » 0,2 г.
5. Границы генеральной средней: