Адаптивное параметрическое оценивание квадратно-корневыми информационными алгоритмами
Содержание
| Введение………………………………………………………………………………….…. | 3 |
| 1. Общие выкладки из теории……………………………………………………………... | 6 |
| 1.1. Общая постановка проблемы идентификации………..………………………… | 6 |
| 1.2. Оценки максимального правдоподобия………………………………………… | 7 |
| 1.3. Методы минимизации функций многих переменных…………….……………. | 9 |
| 1.4. Метод квадратно-корневого информационного фильтра(ККИФ)...…………... | 11 |
| 2. Оценивание параметров по методу максимального правдоподобия с использова-нием квадратно-корневых информационных фильтров……………….………………... | 13 |
| 2.1. Постановка задачи...……………………………………………………………… | 13 |
| 2.2. Функция правдоподобия и ее представление в терминах ККИФ……………... | 15 |
| 2.3. Градиент функции максимального правдоподобия……………………………. | 18 |
| 2.4. Значения производных переменных ККИФ……………………………………. | 20 |
| 2.5. Описание алгоритма..…………………………………………………………….. | 23 |
| 3. Эксперименты и выводы...………………………………………………………….…... | 26 |
| Заключение…………………………………………………………………………….…… | 55 |
| Список используемой литературы………………………………………………………... | 56 |
Введение
С давних пор человечество затрачивает огромные усилия на установление закономерностей происходящих в природе явлений. Первичным в процессе познания всегда являются результаты наблюдений. Они представляют собой отправной пункт к модели, к абстрактному мышлению, а уже от модели осуществляется переход к практической деятельности. Очевидно, что эта схема познания применима независимо от того, идет ли речь о естественном или искусственном объекте. Создание абстрактной модели обычно связано со «сжатием» информации, содержащейся в результатах наблюдений. Это объясняется тем, что каждый отдельный результат наблюдений является случайным, поэтому построение адекватной модели реального объекта может быть осуществлено только на основе многократных наблюдений. Случайность каждого результата наблюдений объясняется, с одной стороны, принципиальной невозможностью учесть все многообразие факторов, действующих на данный конкретный объект, каким бы простым он ни казался на первый взгляд, и сложными взаимосвязями этих факторов, а с другой стороны, несовершенством естественных или искусственных средств наблюдения.
Построение модели по результатам наблюдений представляет собой формализацию, необходимую для определения основных признаков, связей, закономерностей, присущих объекту-оригиналу, и отсеивания второстепенных признаков. Во многих случаях модель, принятая при проектировании, существенно отличается от реального объекта, что значительно уменьшает или сводит на нет эффективность разработанной системы управления. В связи с этим возникло одно из новых и важных направлений в теории управления, связанное с построением модели на основании наблюдений, полученных в условиях функционирования объекта по его входным и выходным переменным. Это направление известно в настоящее время как идентификация систем.
Задача идентификации формулируется следующим образом: по результатам наблюдений над входными и выходными переменными системы должна быть построена оптимальная в некотором смысле модель, т.е. формализованное представление этой системы.
В зависимости от априорной информации об объекте управления различают задачи идентификации в узком и широком смысле. Задача идентификации в узком смысле состоит в оценивании параметров и состояния системы по результатам наблюдений над входными и выходными переменными, полученными в условиях функционирования объекта. При этом известна структура системы и задан класс моделей, к которому данный объект относится. Априорная информация об объекте достаточно велика.
Априорная информация об объекте при идентификации в широком смысле отсутствует или очень бедная, поэтому приходится предварительно решать большое число дополнительных задач. К этим задачам относятся: выбор структуры системы и задание класса моделей, оценивание степени стационарности и линейности объекта и действующих переменных, оценивание степени и формы влияния входных переменных на выходные, выбор информативных переменных и др. К настоящему времени накоплен большой опыт решения задач идентификации в узком смысле. Методы же решения задач идентификации в широком смысле начали разрабатываться только в последние годы, и здесь результаты значительно скромнее, что в первую очередь можно объяснить чрезвычайной трудностью задачи.
Целью данной дипломной работы является исследование нового метода параметрической идентификации основанного на синтезе метода максимального правдоподобия и метода квадратно-корневого информационного фильтра (ККИФ), сравнение его с другими существующими алгоритмами с точки зрения вычислительной точности, быстродействия и сложности, а также реализация данного метода на ЭВМ.
В первой главе данного дипломного проекта дана общая постановка задачи параметрической идентификации, а также общие сведения об оценке максимального правдоподобия и методах минимизации функций многих переменных. Также в этой главе рассмотрены ключевые моменты метода квадратно-корневого информационного фильтра, показаны его преимущества и недостатки перед стандартным фильтром Калмана.
Во второй главе показано, как вычислить оценку максимального правдоподобия итеративным способом при помощи характеристического уравнения, которое включает в себя градиент обратного логарифма функции правдоподобия и информационной матрицы Фишера. В разделе 2.2 второй главы выведено выражение для функции правдоподобия, используя выходные значения естественным образом генерирующиеся ККИФ. В разделах 2.3 и 2.4 показан способ получения градиента обратного логарифма функции правдоподобия и формулы для информационной матрицы Фишера, а полный алгоритм для их подсчета представлен в разделе 2.5.
В третьей главе изложены результаты экспериментов, направленных на выявления основных преимуществ и недостатков изложенного алгоритма в сравнении с другими методами параметрической идентификации.
В заключении данного дипломного проекта будут подведены итоги проделанной работы.
1. Общие выкладки из теории
1.1. Общая постановка проблемы идентификации
Основной задачей системного анализа является определение выходного сигнала системы по известному входному сигналу и характеристикам системы. Здесь обсуждается задача, которую иногда называют обратной задачей системного анализа, по заданным входному и выходному сигналам определить уравнения, описывающие поведение системы. Т.е. необходимо получить правило или такую связь,
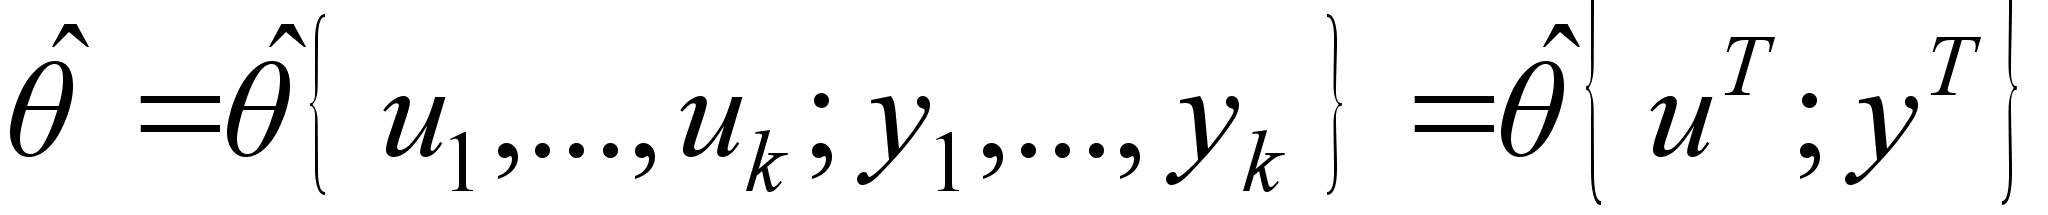
которая позволяла
бы приписать
неизвестному
параметру
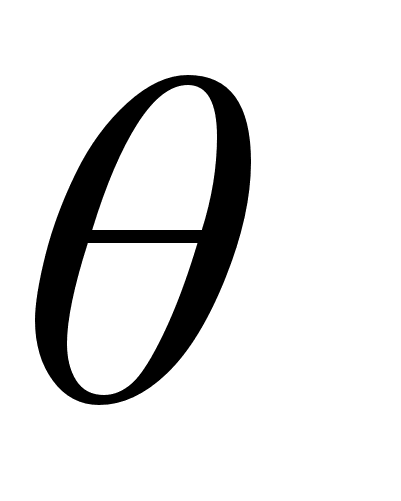 рассматриваемого
объекта некоторое
числовое значение
(оценку)
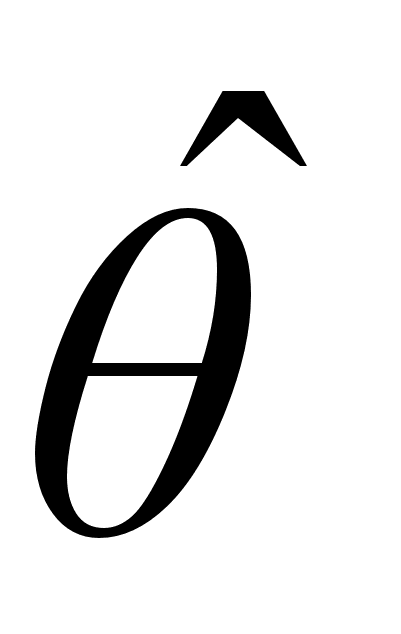 ,
причем эта
оценка зависит
от последовательности
наблюдений
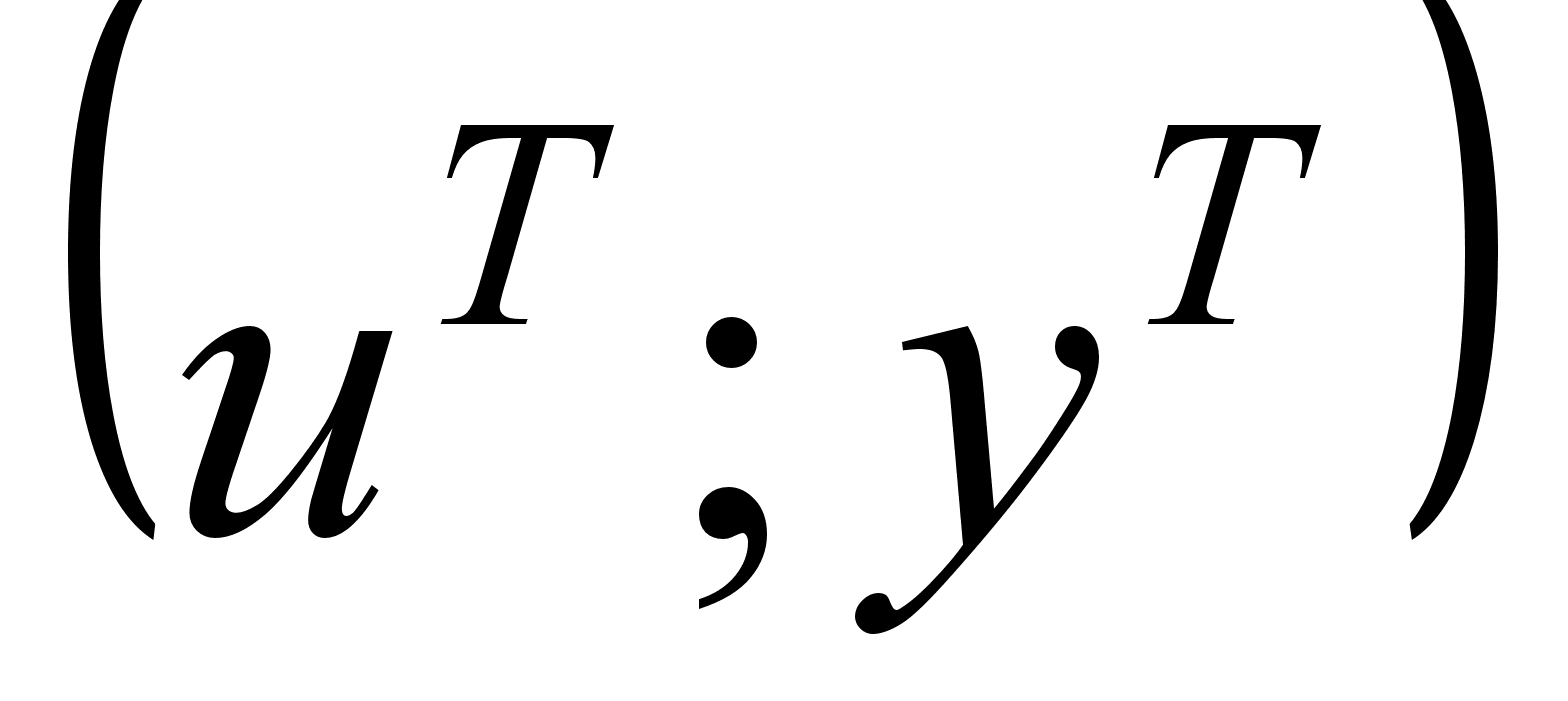 ,
где
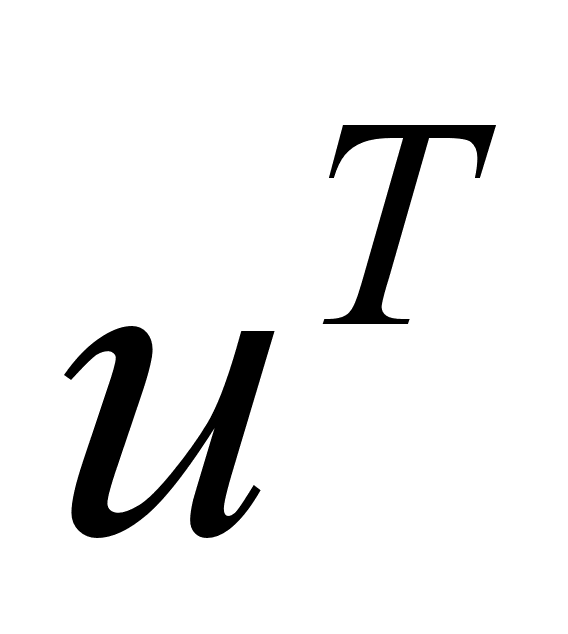 -
есть управление.
Рассматриваемая
ситуация изображена
на рис.1.
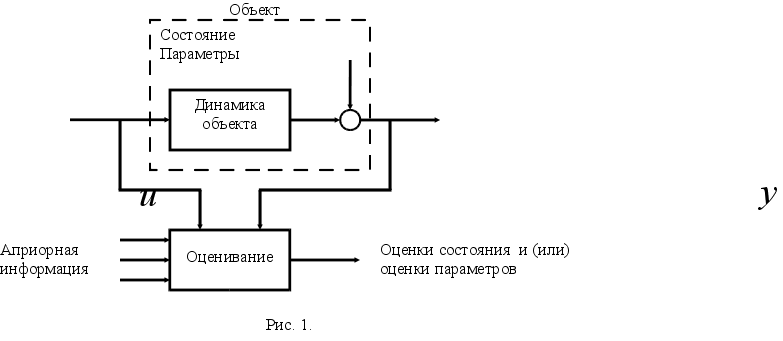
Часто подразумевается, что идентификация начинается из ”ничего” без всякой априорной информации об объекте. Но в большинстве технических задач такое предположение не реалистично; из структуры объекта и, по крайней мере, частичного понимания его функционирования можно извлечь определенную априорную информацию и, в частности, вид структуры модели. В этом случае остается только получить информацию о числовых значениях ряда параметров (коэффициентов дифференциальных уравнений, описывающих динамику объекта, и т. д.). В результате задача идентификации сводится к задаче оценивания параметров. Под оцениванием параметров понимается экспериментальное определение значений параметров, характеризующих динамику поведения объекта, в предположении, что структура модели объекта известна.
При оценивании используют различные виды оценок, которые различаются объемом исходной информации об объекте. Например, при нахождении оценки по методу наименьших квадратов предполагается, что динамика объекта может быть аппроксимирована выбранной моделью. При получении ”марковских” оценок считается также известной ковариационная матрица шума. Для вычисления оценок максимального правдоподобия необходимо знание плотности вероятности измеряемого случайного процесса. Байесовские оценки, или оценки с минимальным риском, требуют знания априорных плотностей вероятности неизвестных параметров и величины штрафа за ошибки.
В данной работе мы будем рассматривать частный случай показанной выше ситуации, т.е. рассмотрим параметрическое оценивание параметров динамической системы без управления, а неизвестные параметры будем оценивать методом максимального правдоподобия.
1.2. Оценка максимального правдоподобия
Известно, что
при оценивании
существенный
интерес представляет
информация
о рассматриваемых
параметрах,
в частности
плотность
вероятности
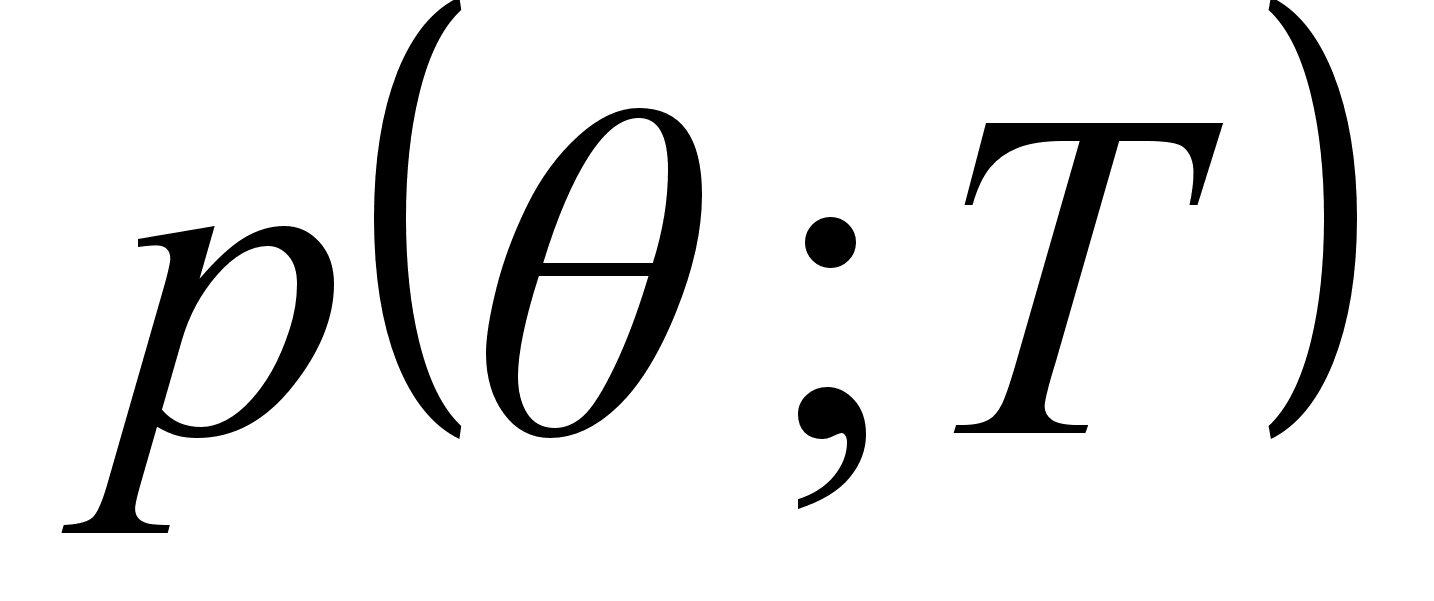 или
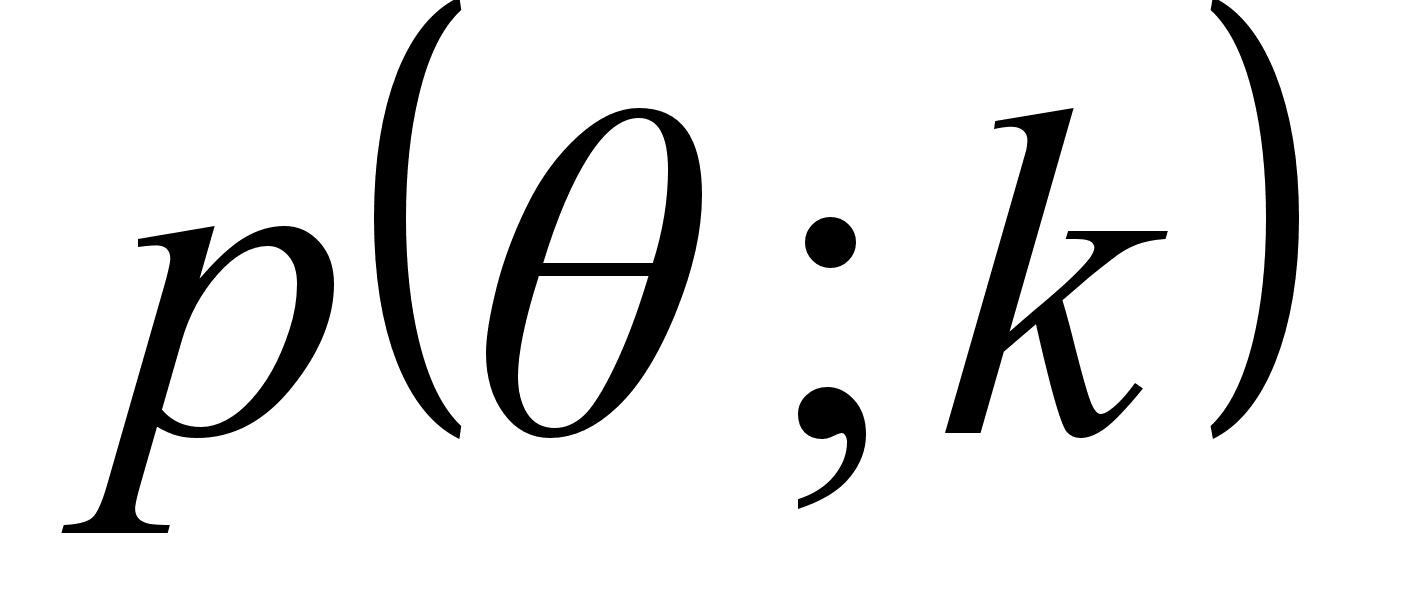 .
Эта функция
зависит от
продолжительности
интервала
наблюдений
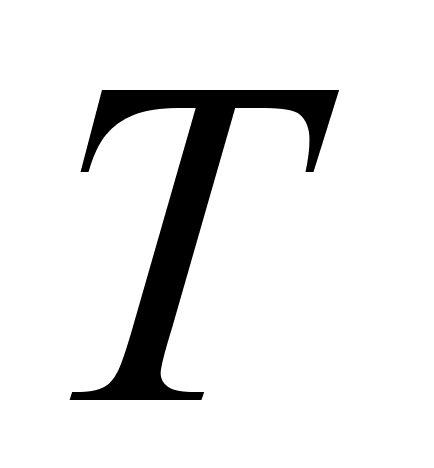 или, что то же
самое, от размера
выборки
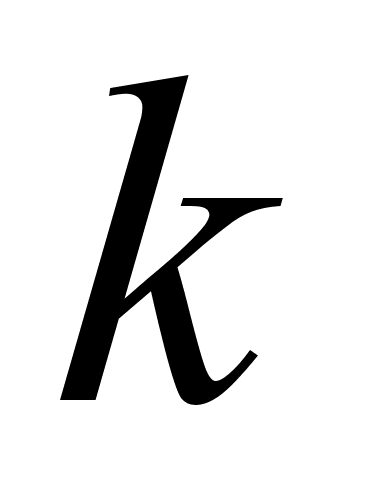 и представляет
собой наиболее
полную информацию,
которую можно
получить, применяя
статистические
методы.
Пусть известна
плотность
вероятности
шума
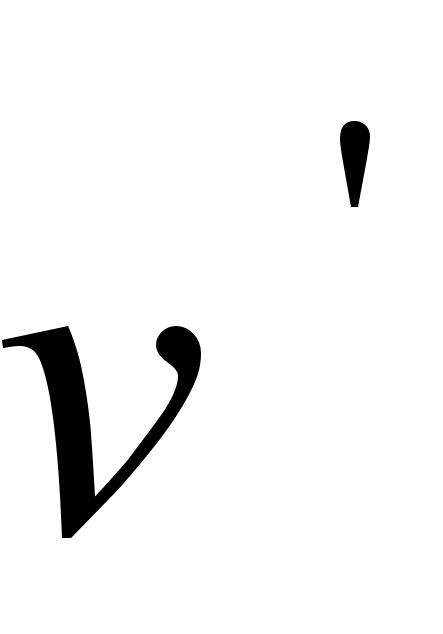 .
По ней можно
рассчитать
плотность
вероятности
измерений
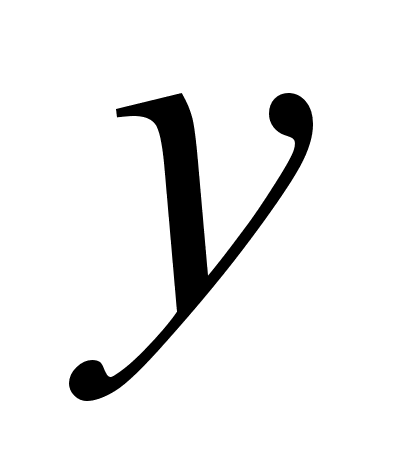 ,
которая зависит
от параметров
объекта
и обозначается
через
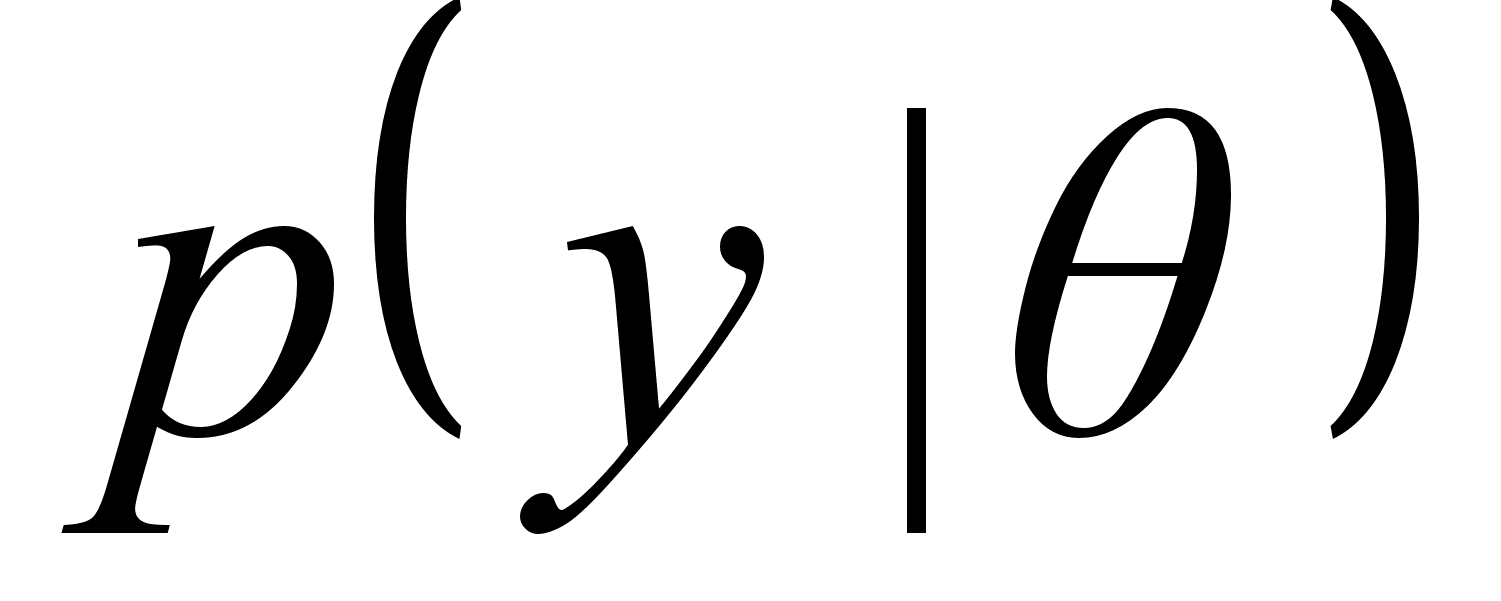 .
Также положим,
что априорное
распределение
вероятностей
параметра
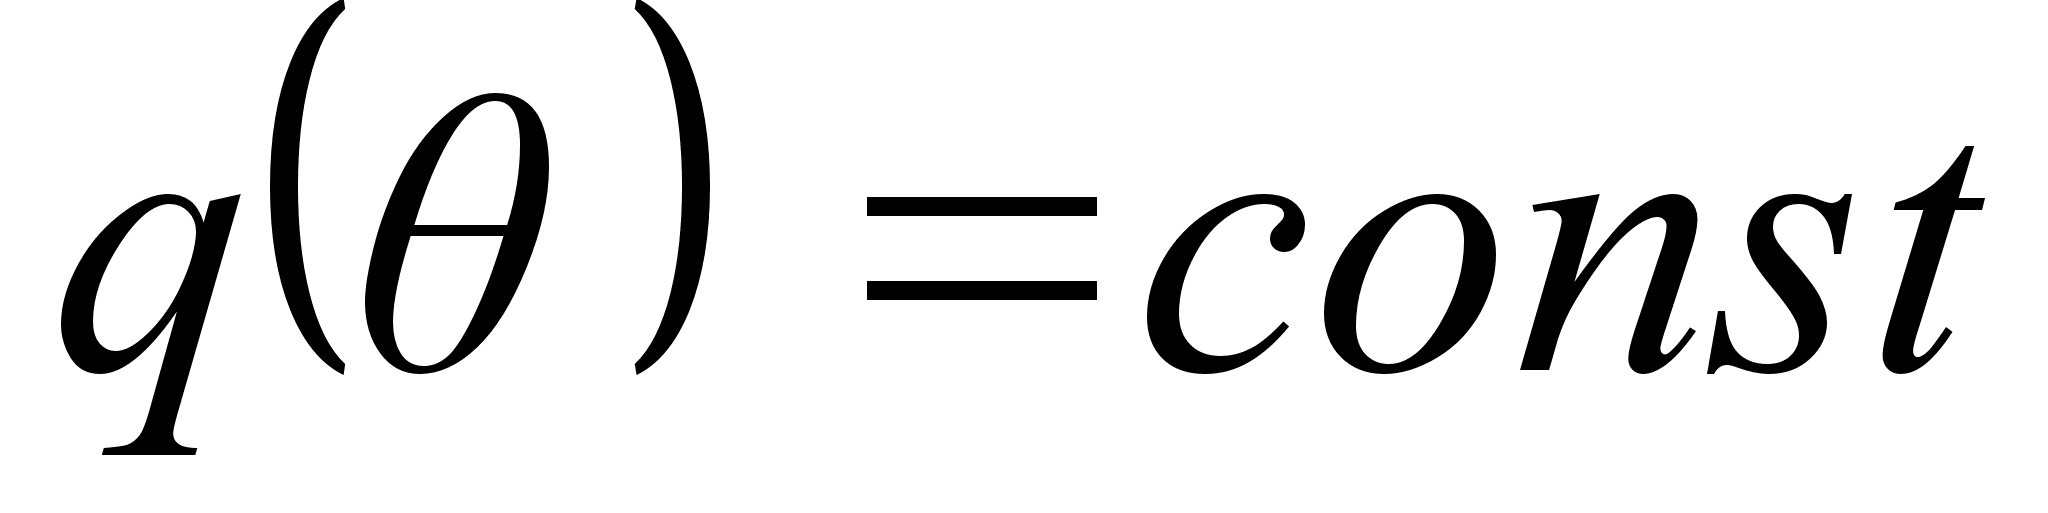 в области возможных
значений параметра.
Тогда разумно
выбирать
,
совпадающее
со значением
,
максимизирующим
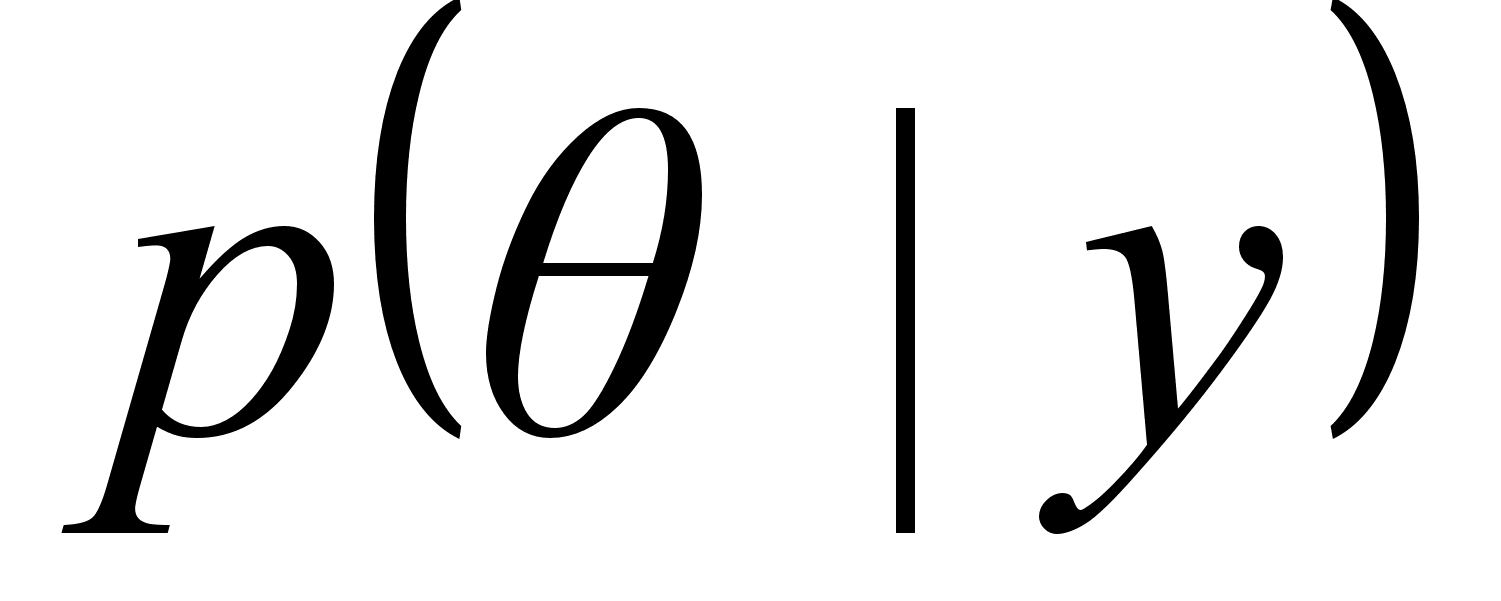 .
В соответствии
с формулой
Байеса
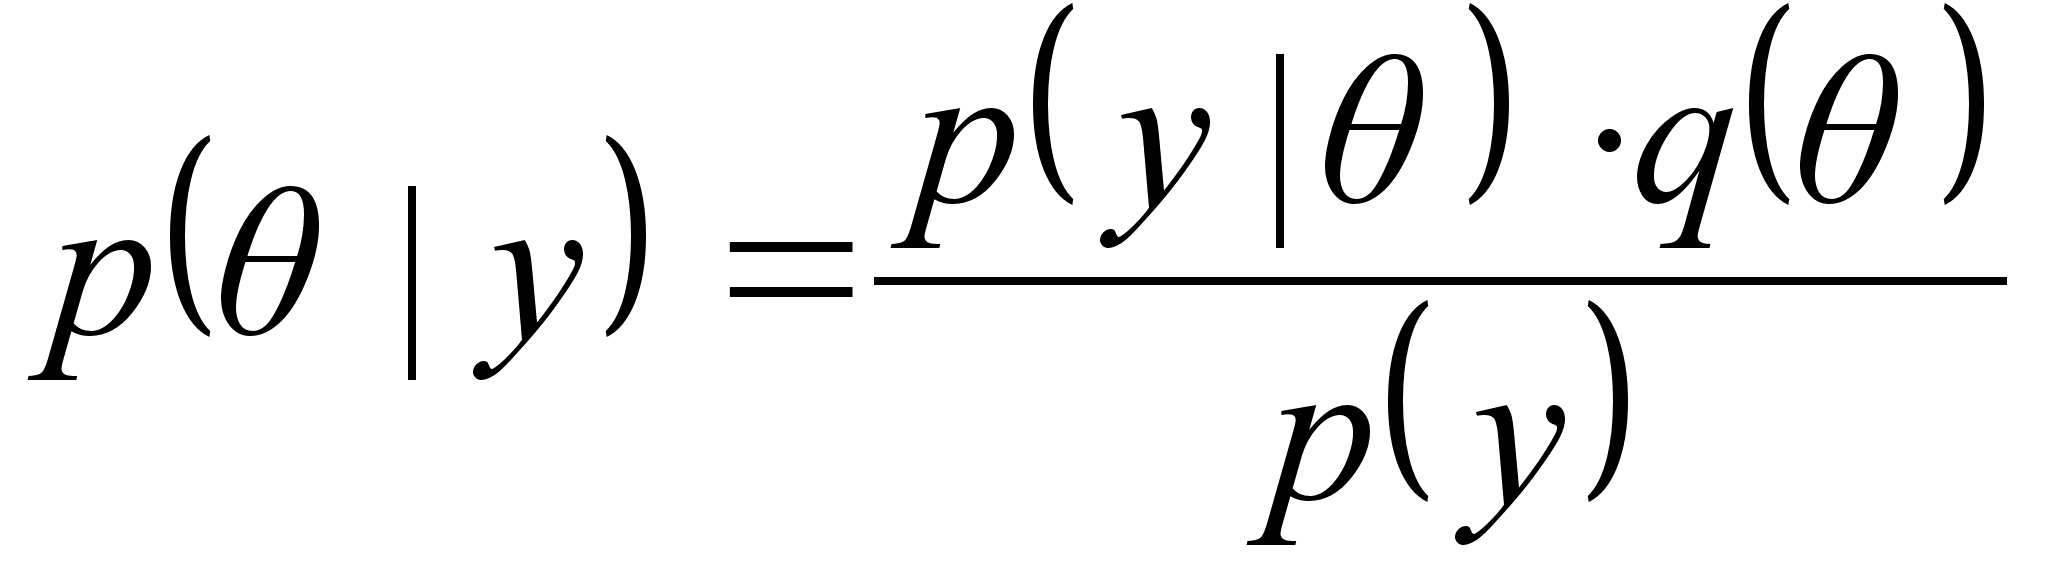
для произвольного
имеем
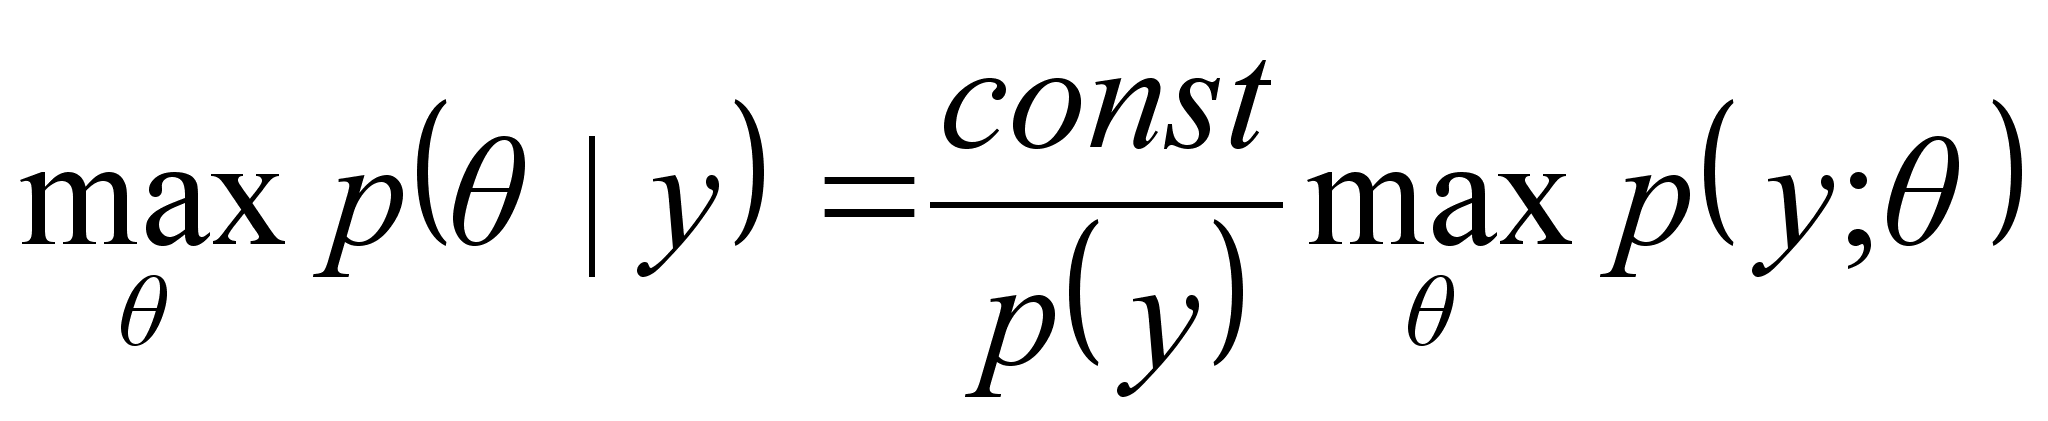 .
Априорная плотность вероятности имеет вид
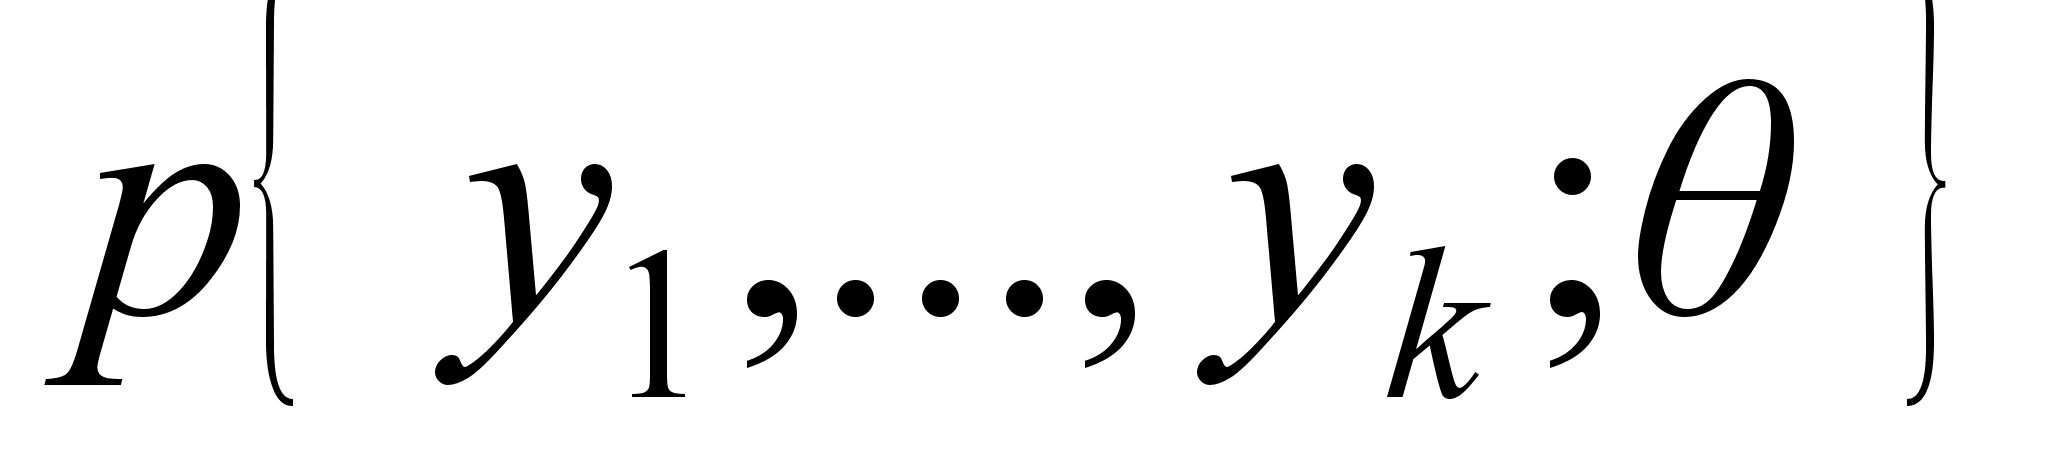
Апостериори
после измерений
выборочных
значений
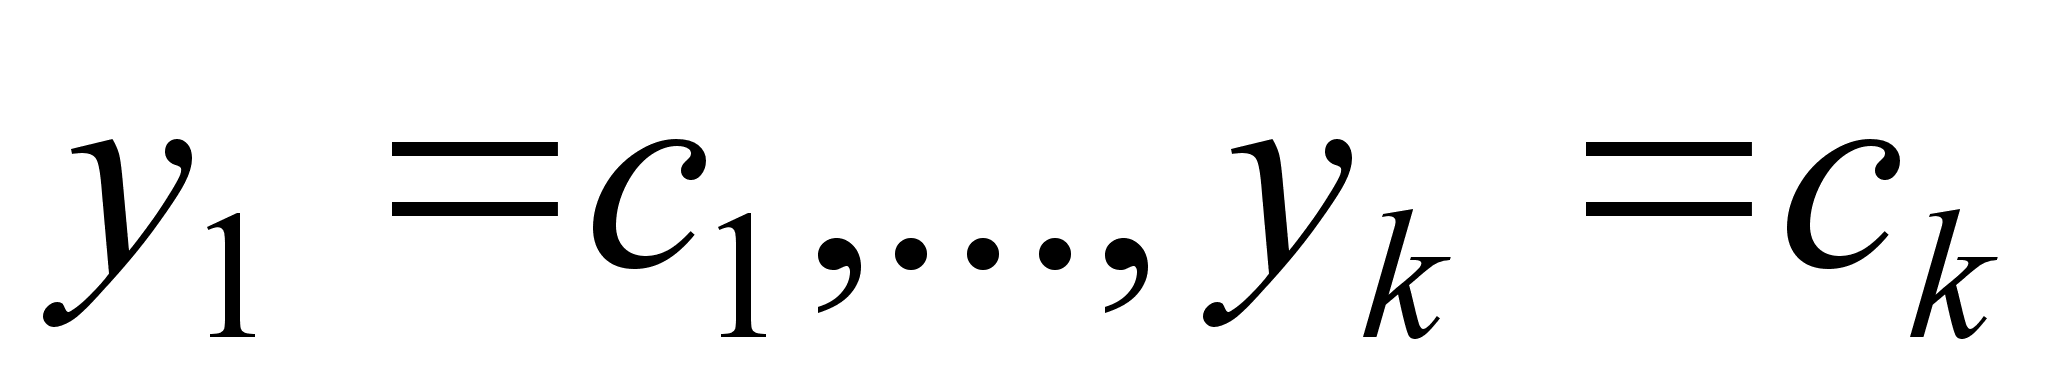 ,
или
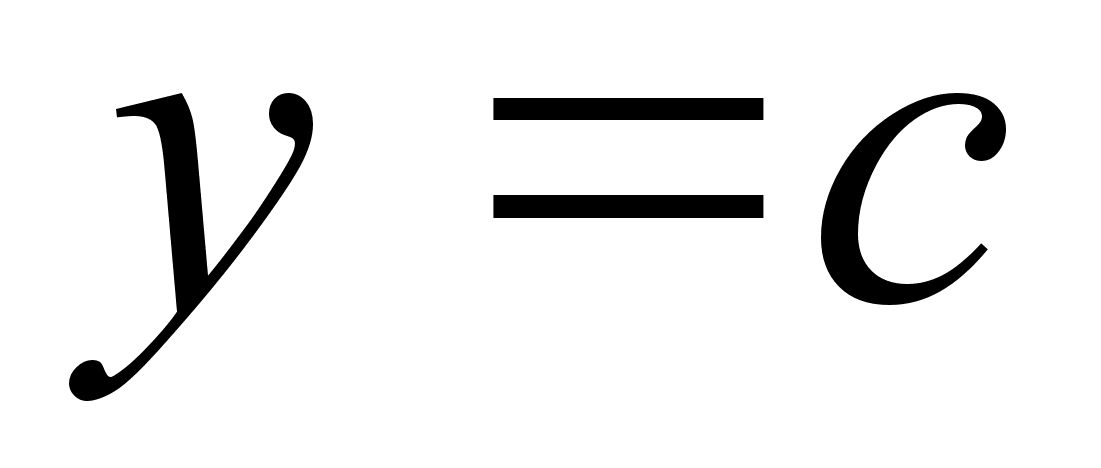 ,
совместная
плотность
вероятности
обозначается
как
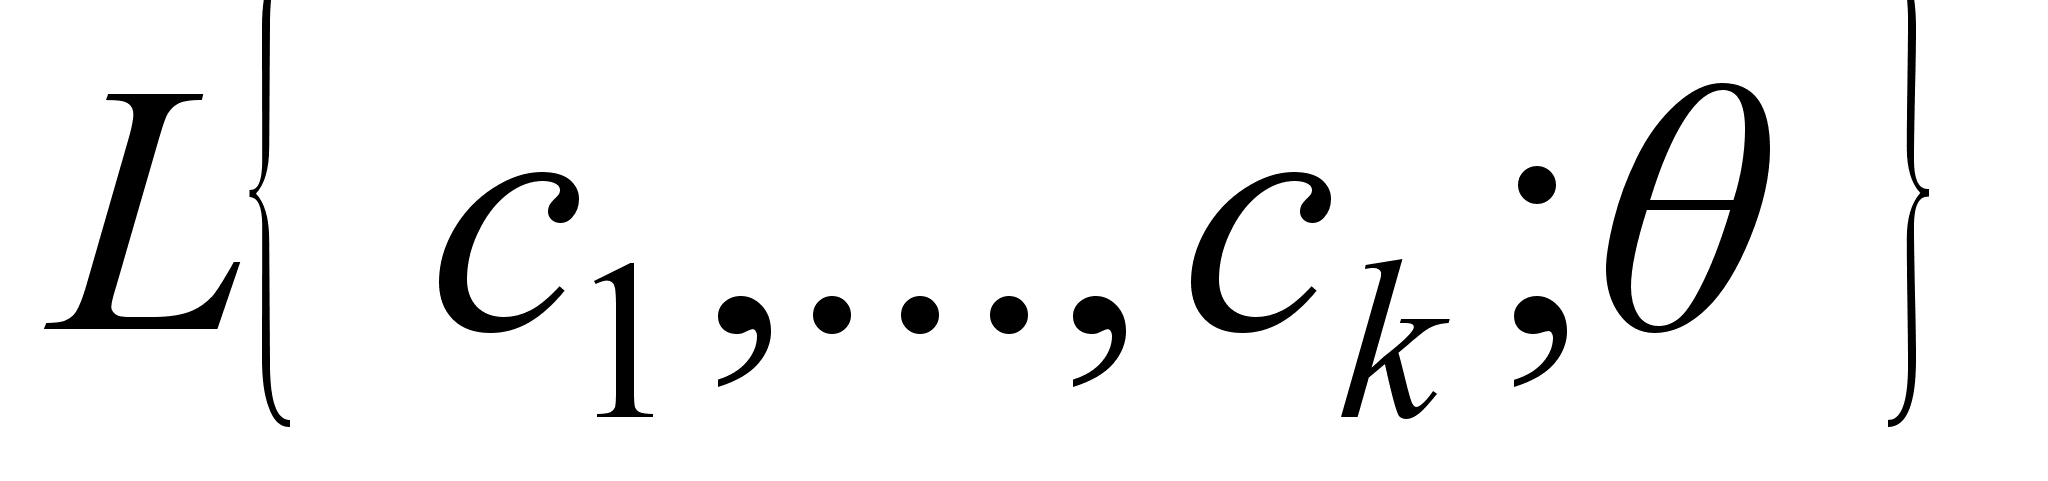
и называется
функцией
правдоподобия.
По функции
правдоподобия
находиться
оценка
,
причем логично
выбирать такое
значение
,
которое максимизирует
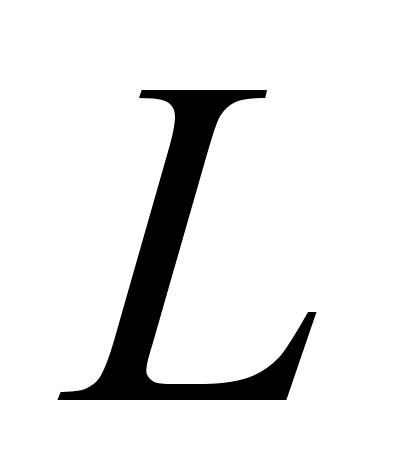 .
Тогда необходимое
условие максимума
имеет вид
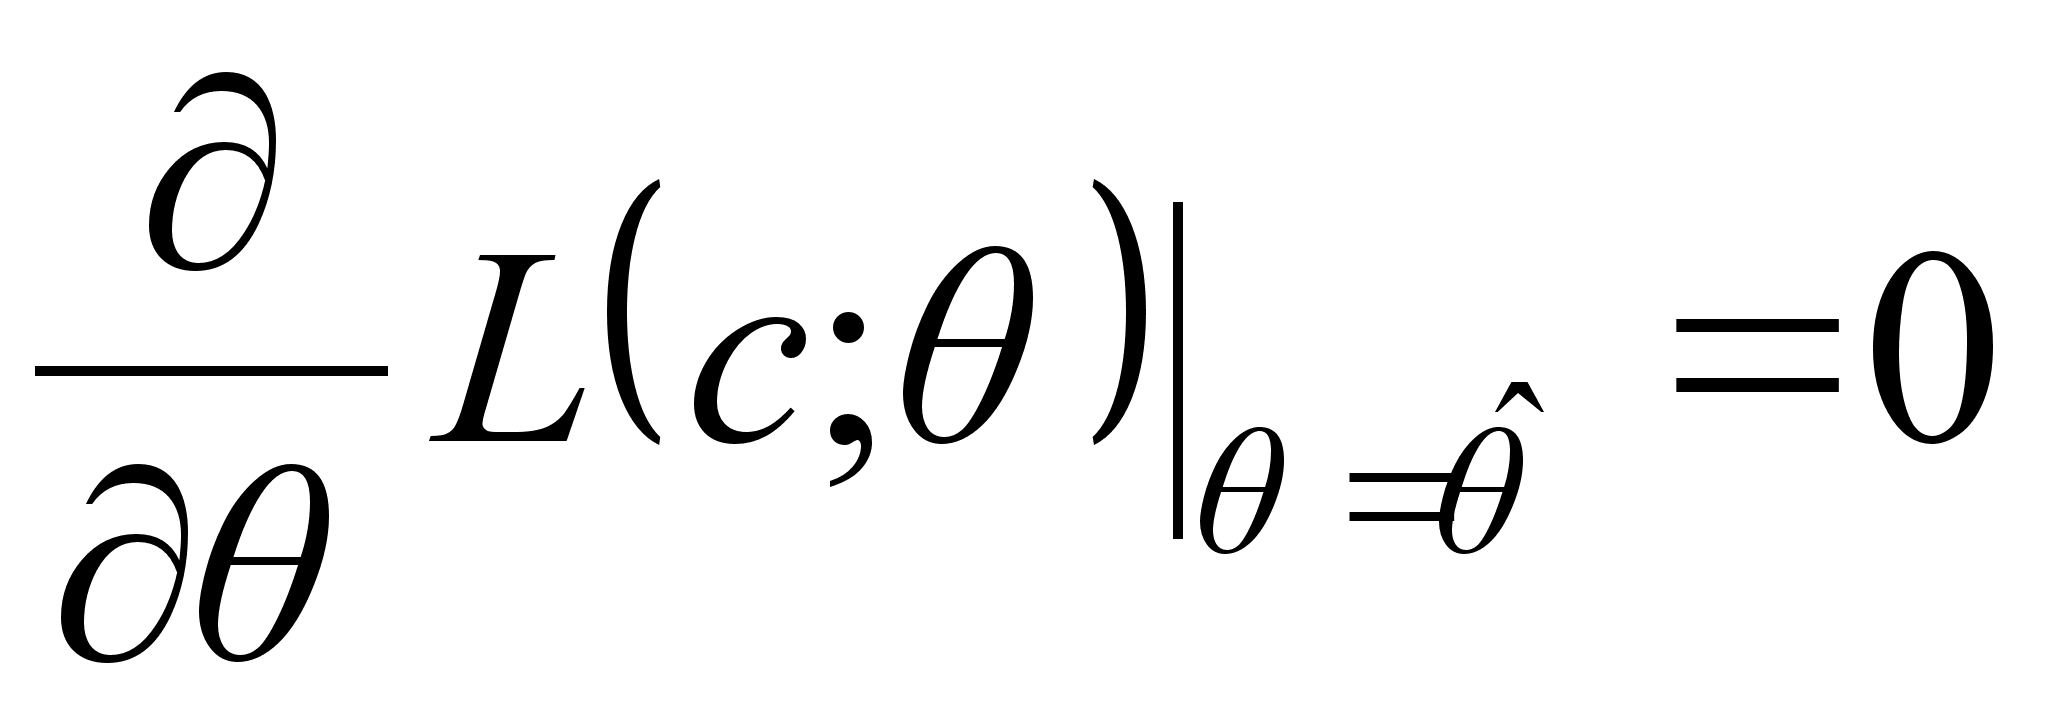
или в силу монотонности логарифма
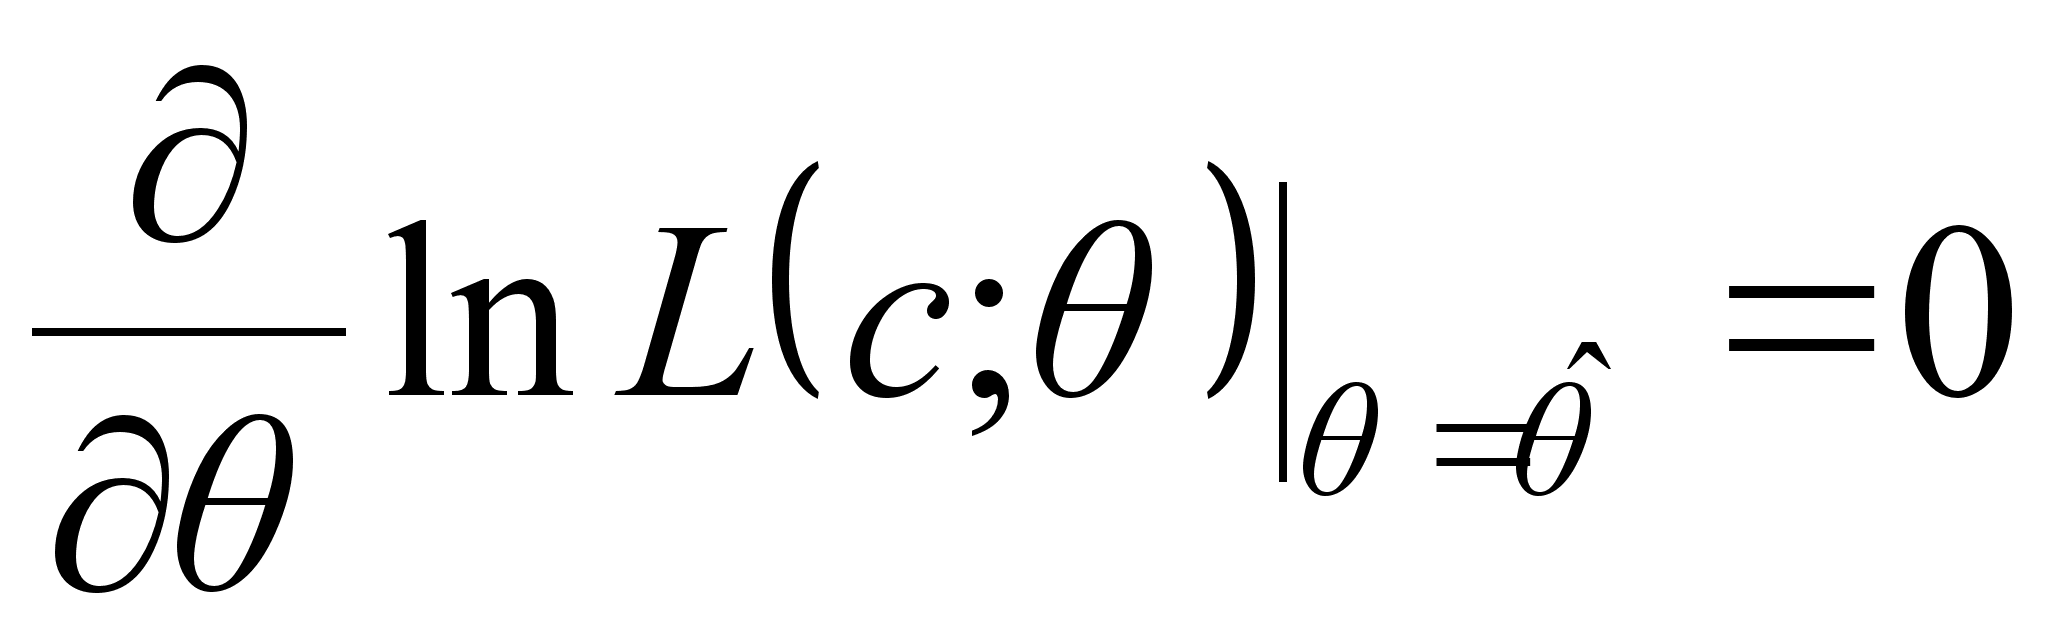
Эту формулу
называют уравнением
правдоподобия
и, отыскивая
решение этой
системы уравнений,
которое обеспечивает
наибольшее
значение
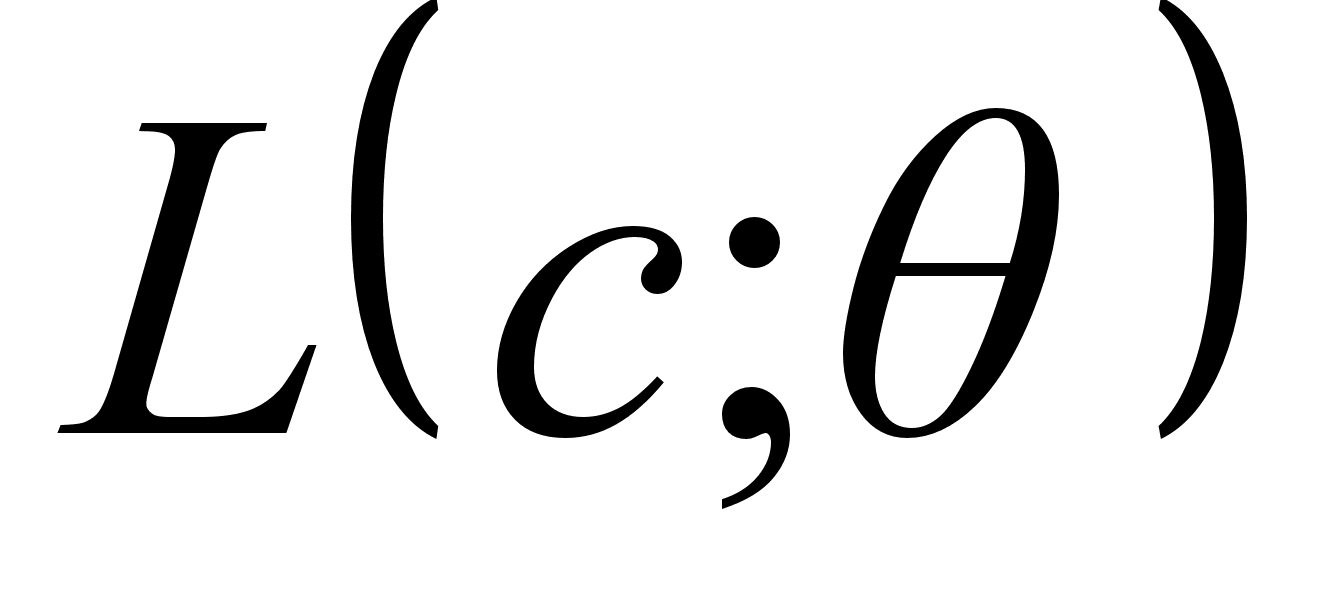 или
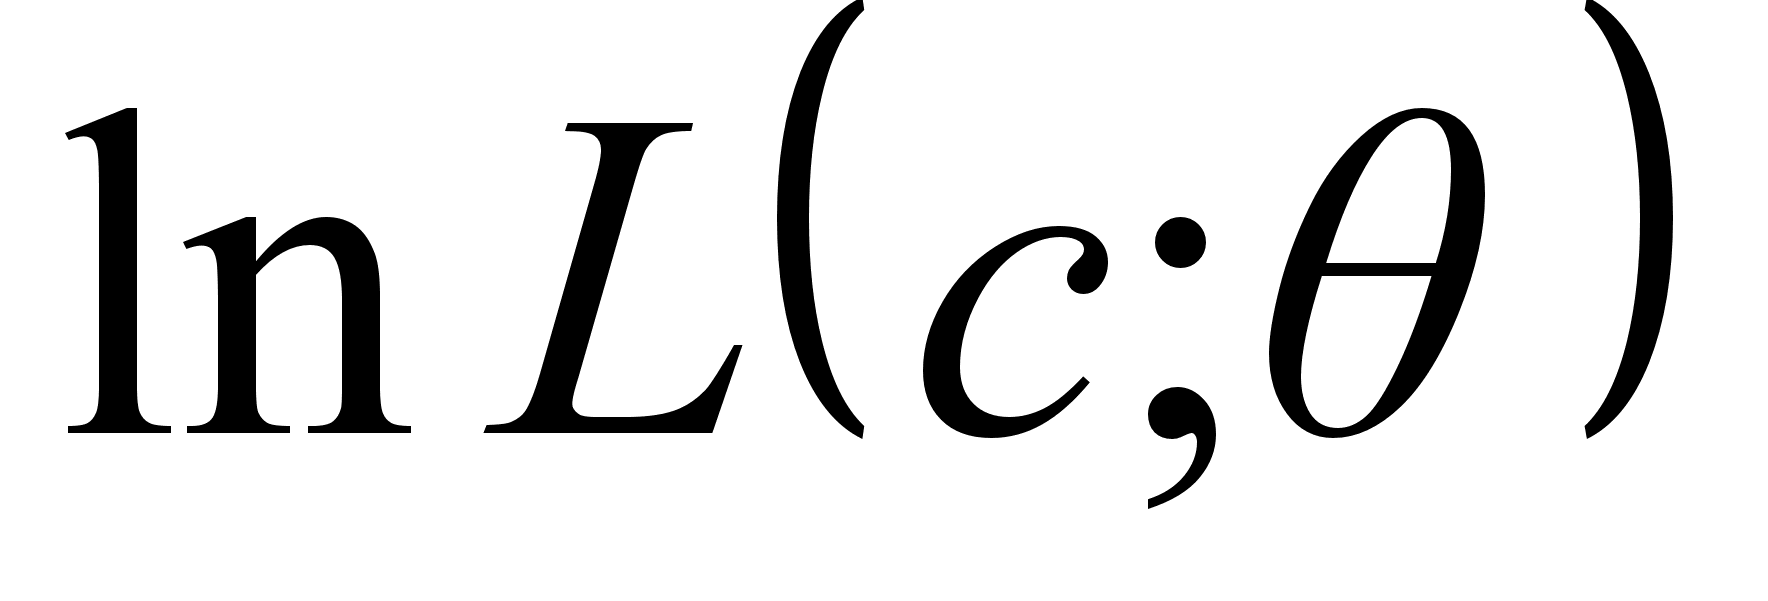 ,
находим оценку
максимального
правдоподобия,
а, находя оценку
максимального
правдоподобия,
мы тем самым
находим неизвестные
параметры
системы.
Таким образом,
задача оценивания
может быть
сформулирована
как задача
нахождения
наибольшего
(наименьшего)
значения некоторого
функционала.
Но т.к. значения
параметров
непосредственному
наблюдению
не доступны,
то критерием
выбора оптимума
должен быть
функционал
от выходных
сигналов или
от математического
ожидания ошибок
оценок параметров.
Примером такого
функционала
может служить
либо функция
правдоподобия,
либо ее логарифм.
Т.е. если
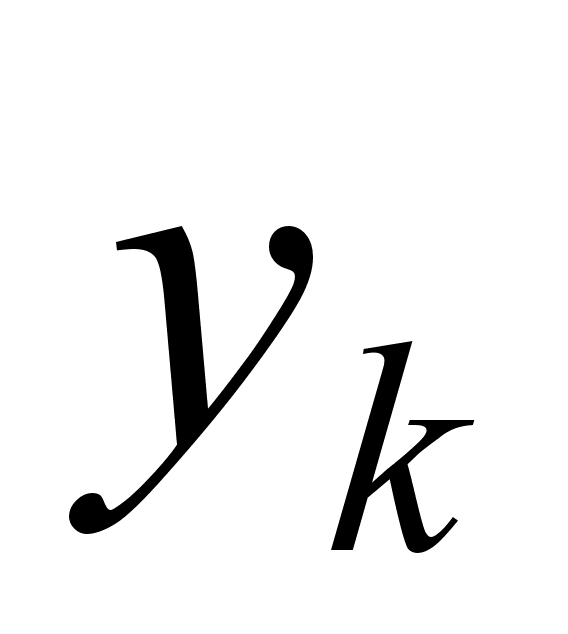 -
это выход объекта,
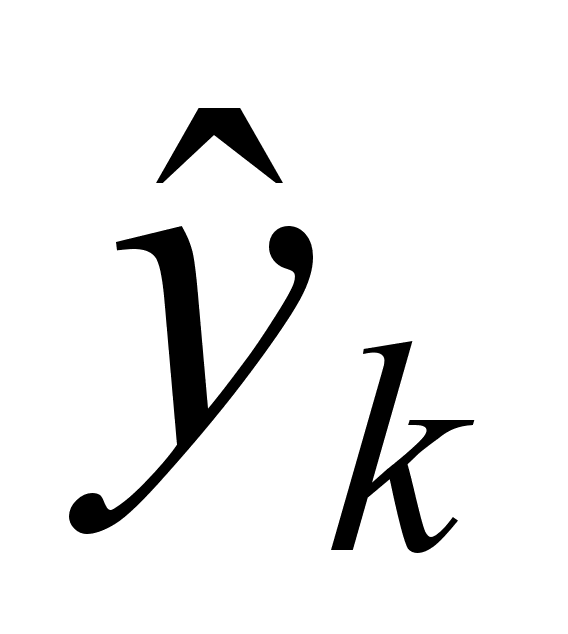 -соответствующий
выход модели
и, также когда,
невязки ошибок
предсказания
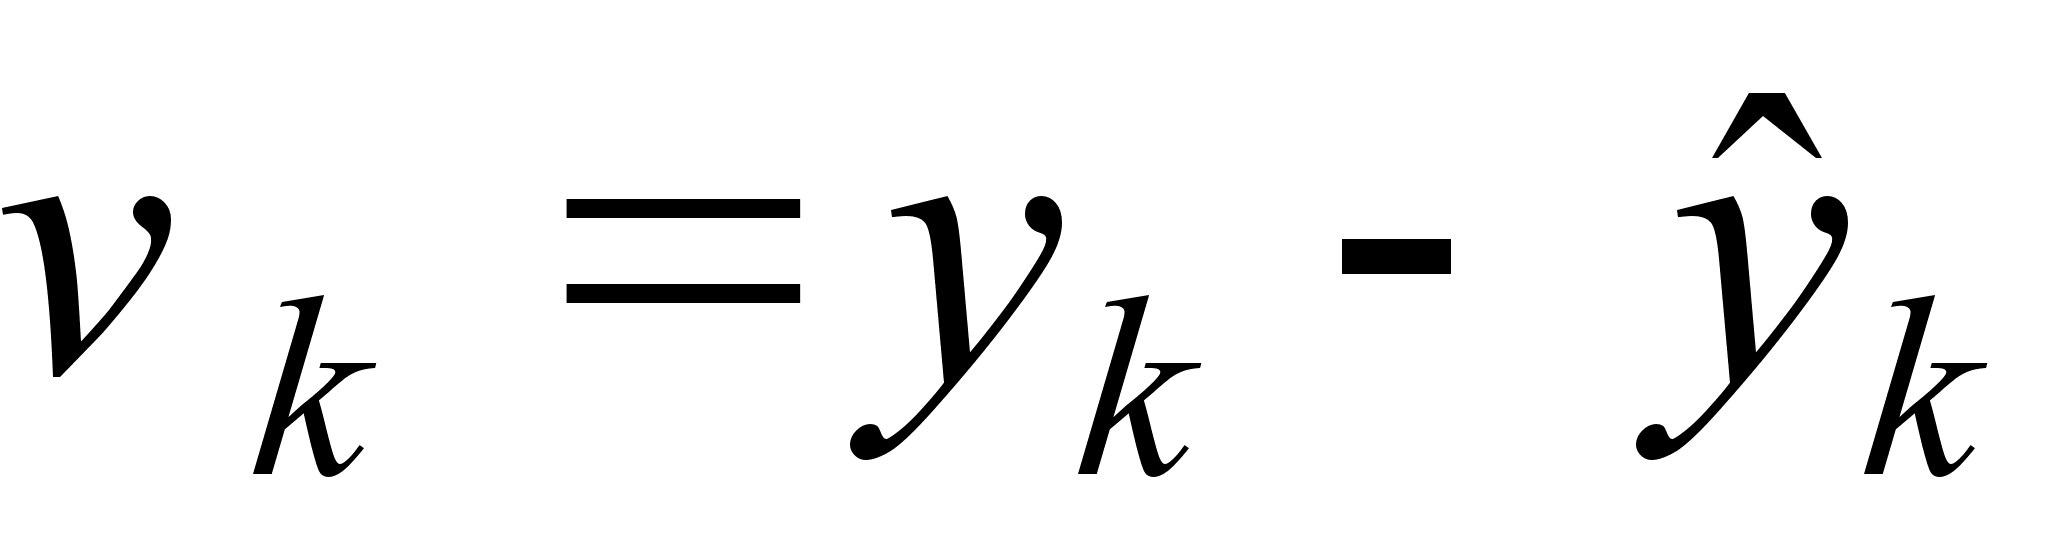 являются независимыми
и имеют гауссовское
совместное
распределение
с нулевым средним
и матрицами
ковариаций
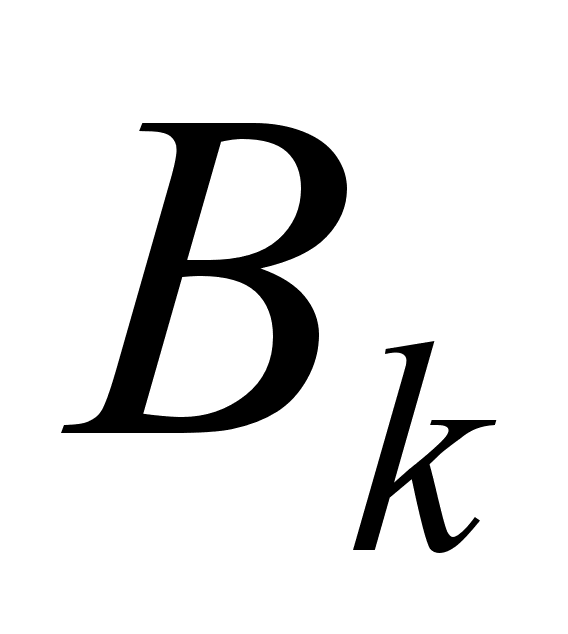 ,
тогда выражение
для обратного
логарифма
функции максимального
правдоподобия
имеет следующий
вид:
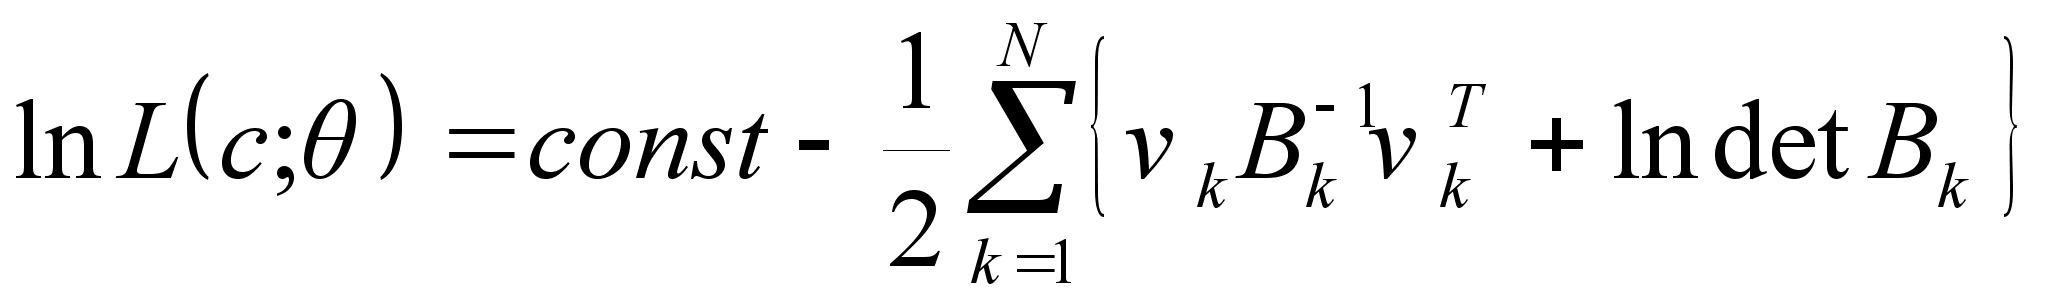
Тогда нахождение оценки максимального правдоподобия эквивалентно минимизации следующего функционала:
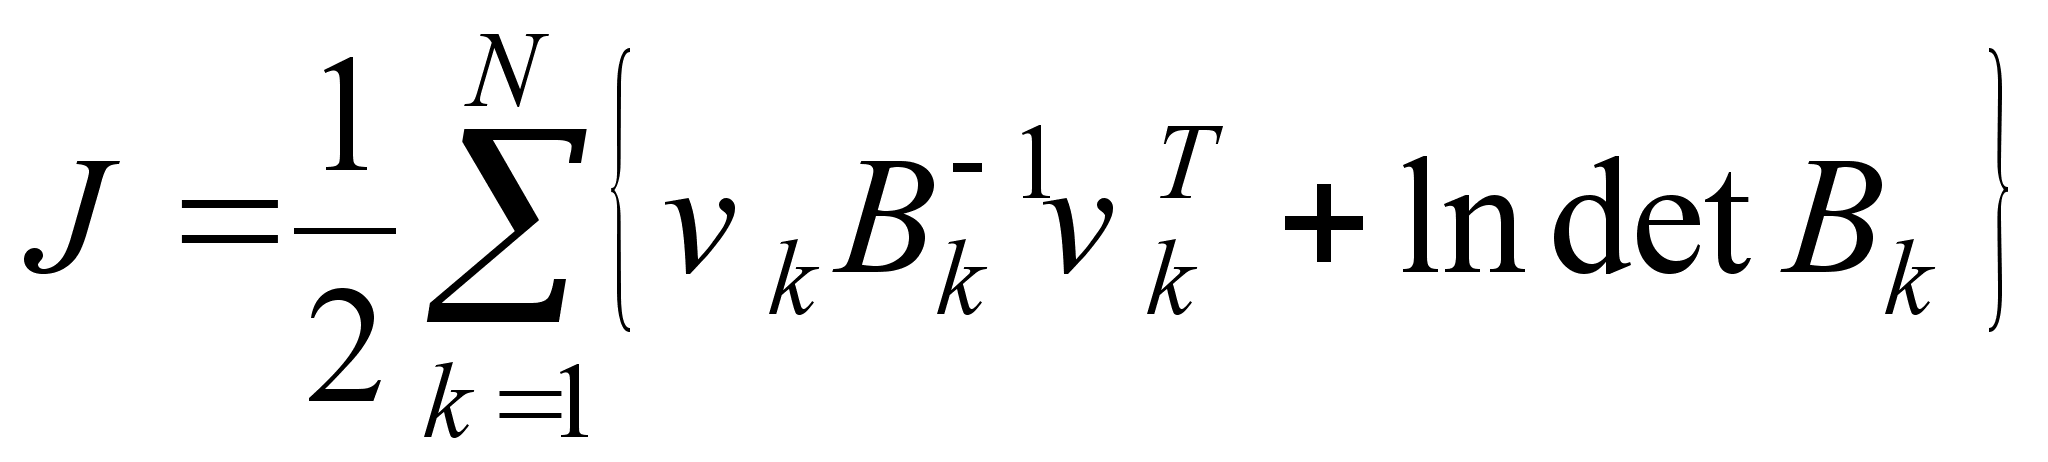 (1.2.1)
Тогда
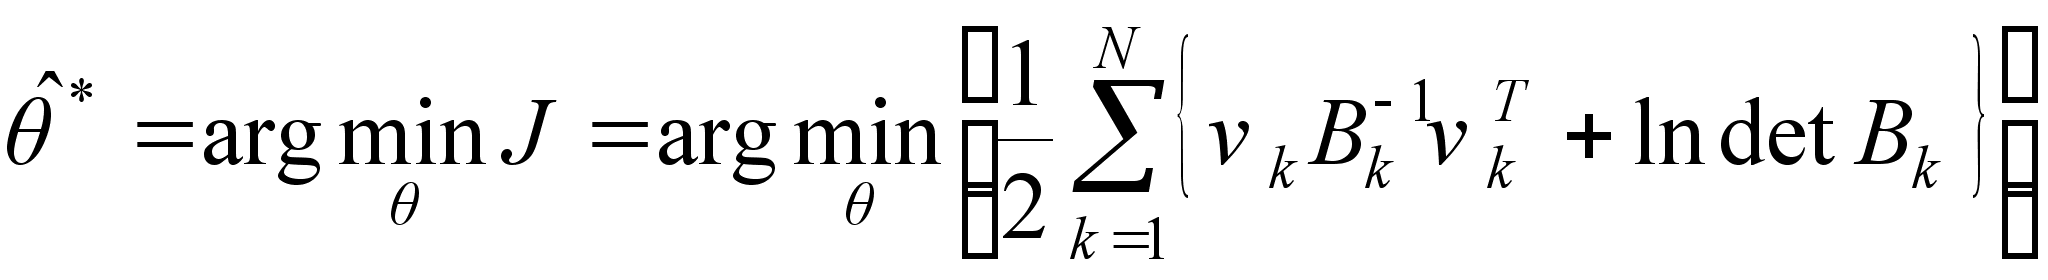
1.3. Методы минимизации функций многих переменных
Критерием выбора оптимума, в нашем случае этим критерием есть выражение (1.2.1), является функция (функционал) многих переменных и для ее минимизации будем использовать наиболее известные и часто применяемые методы минимизации функций многих переменных.
В общем случае будем рассматривать задачу
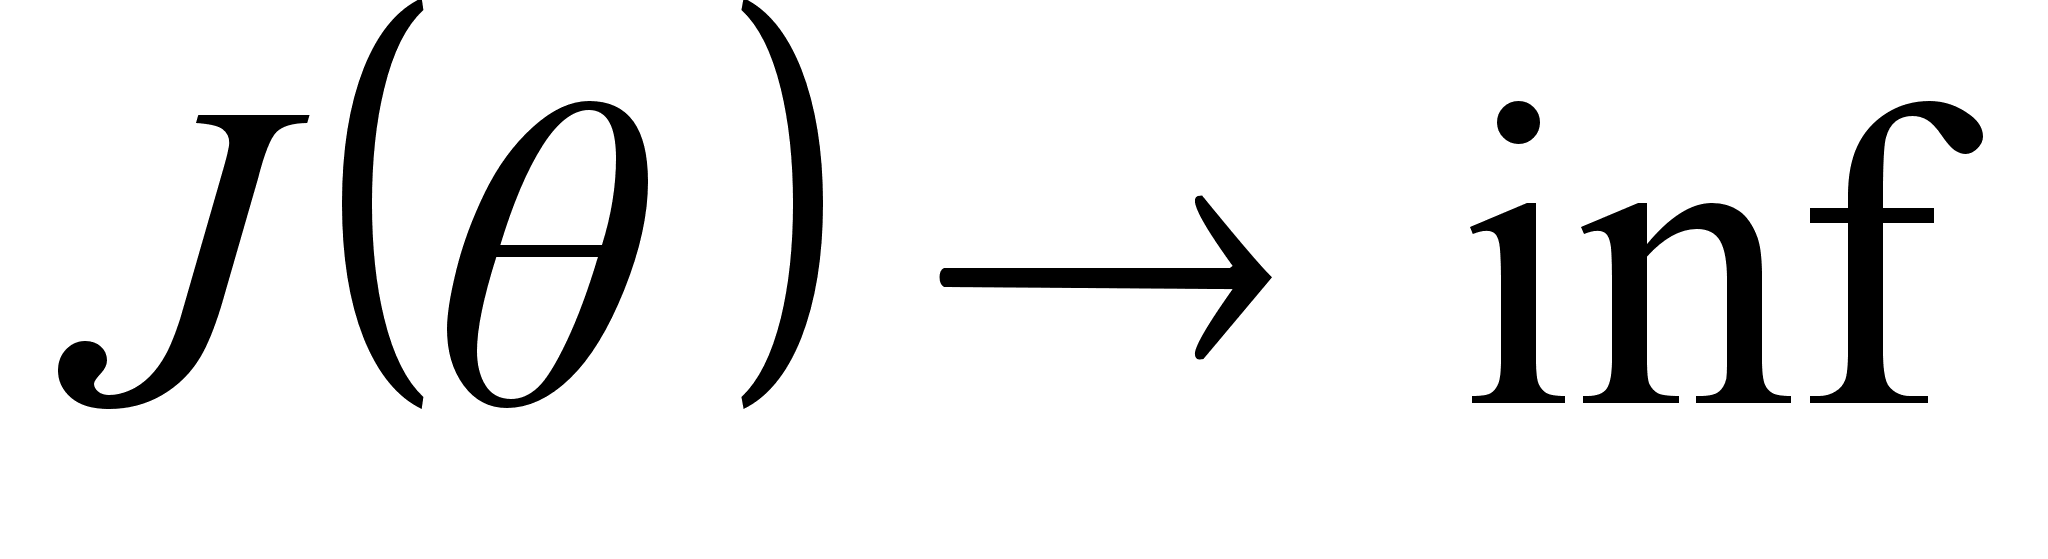 (1.3.1)
предполагая,
что функция
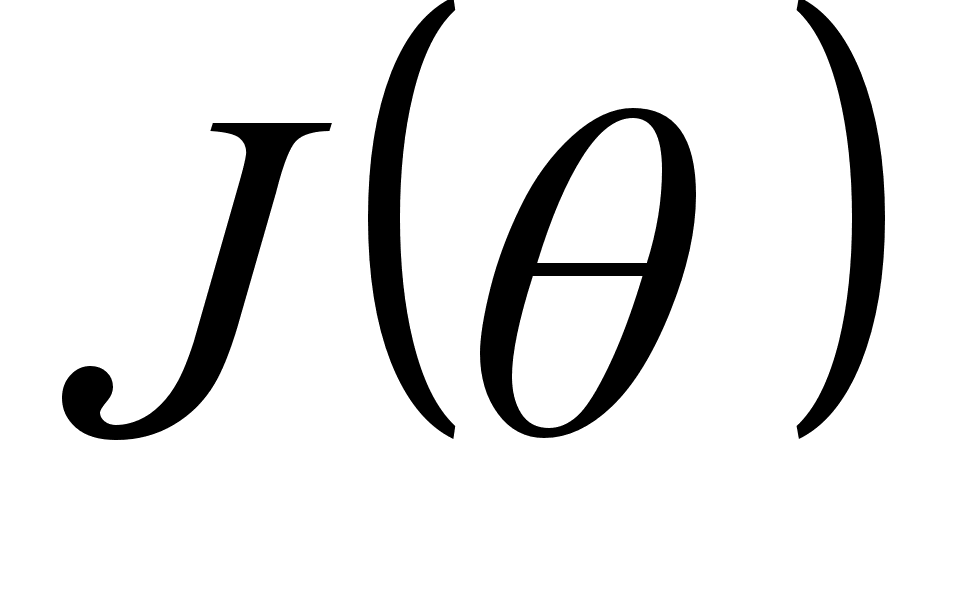 непрерывно
дифференцируема
на
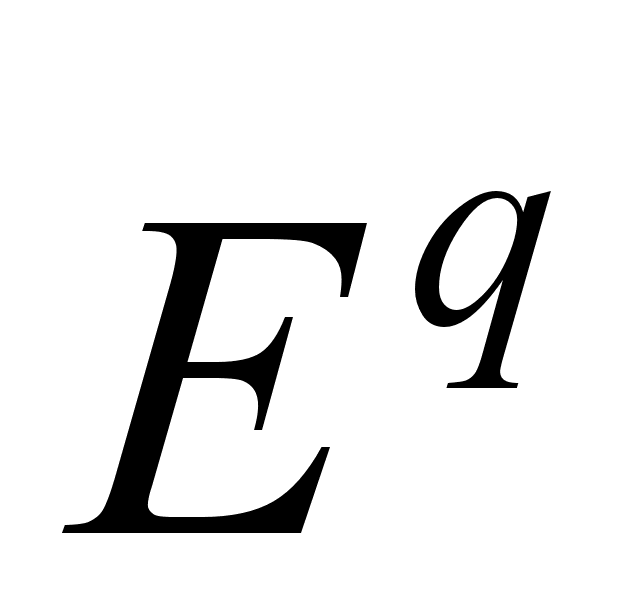 .
Согласно определению
дифференцируемости
функции
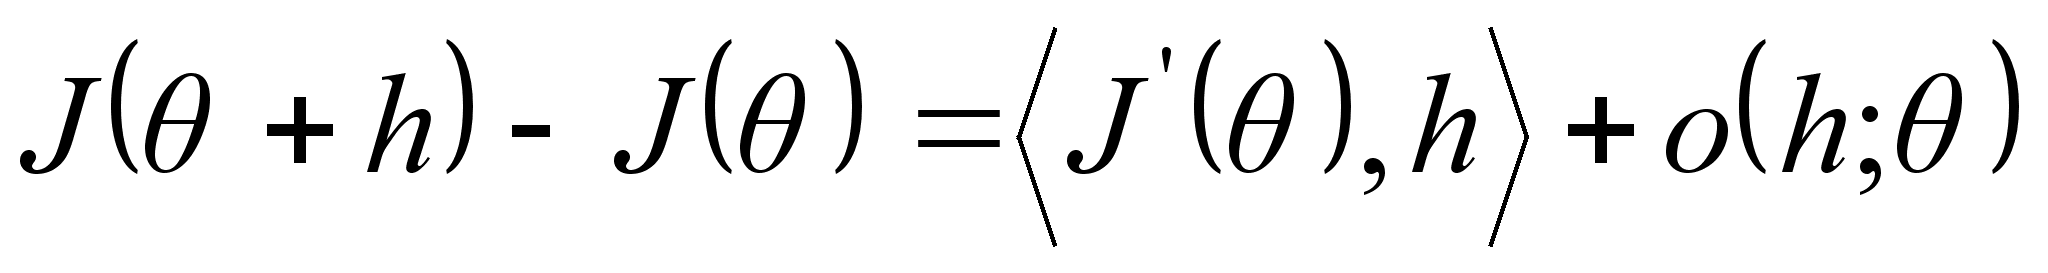 (1.3.2)
где
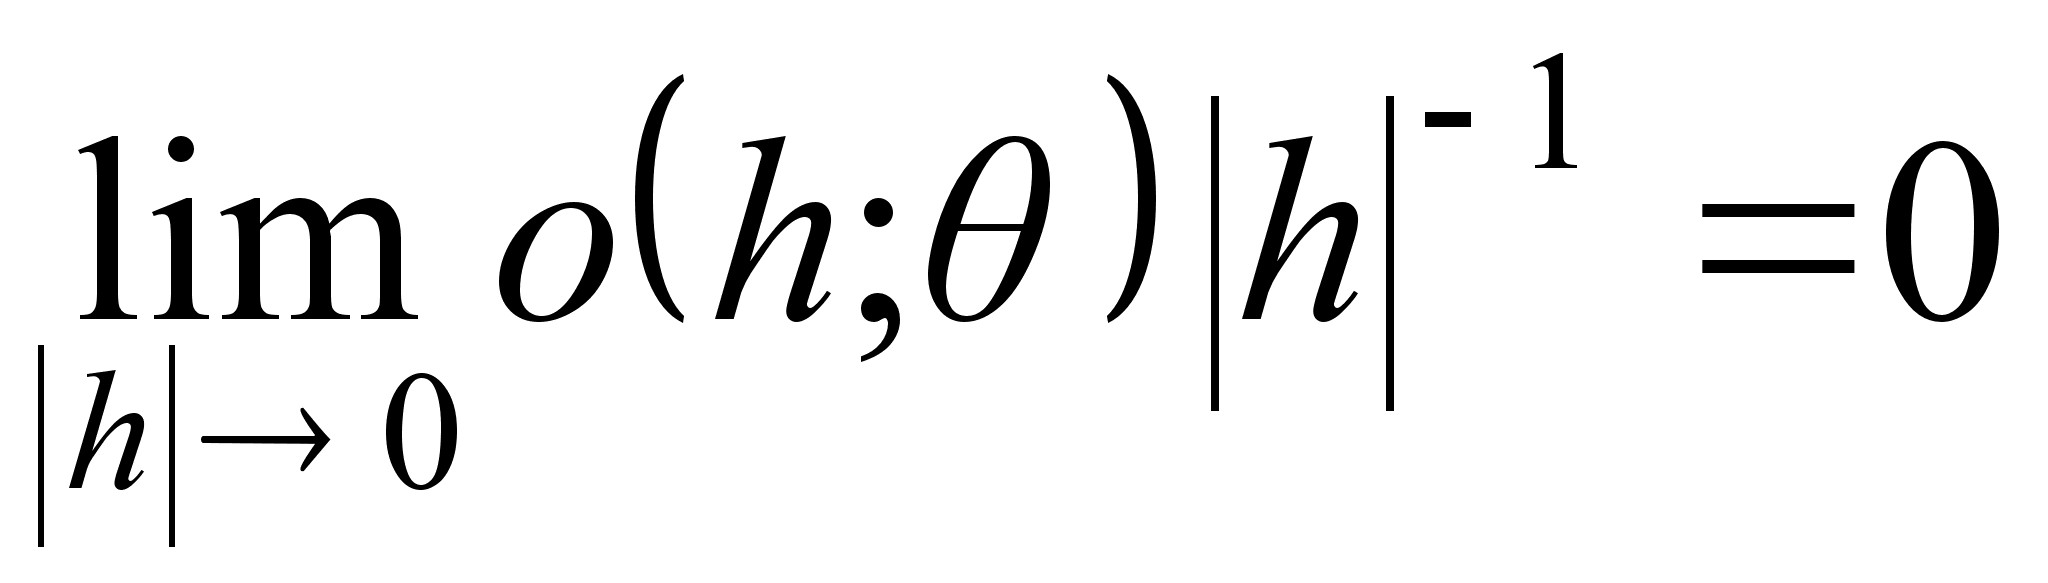 .
Если
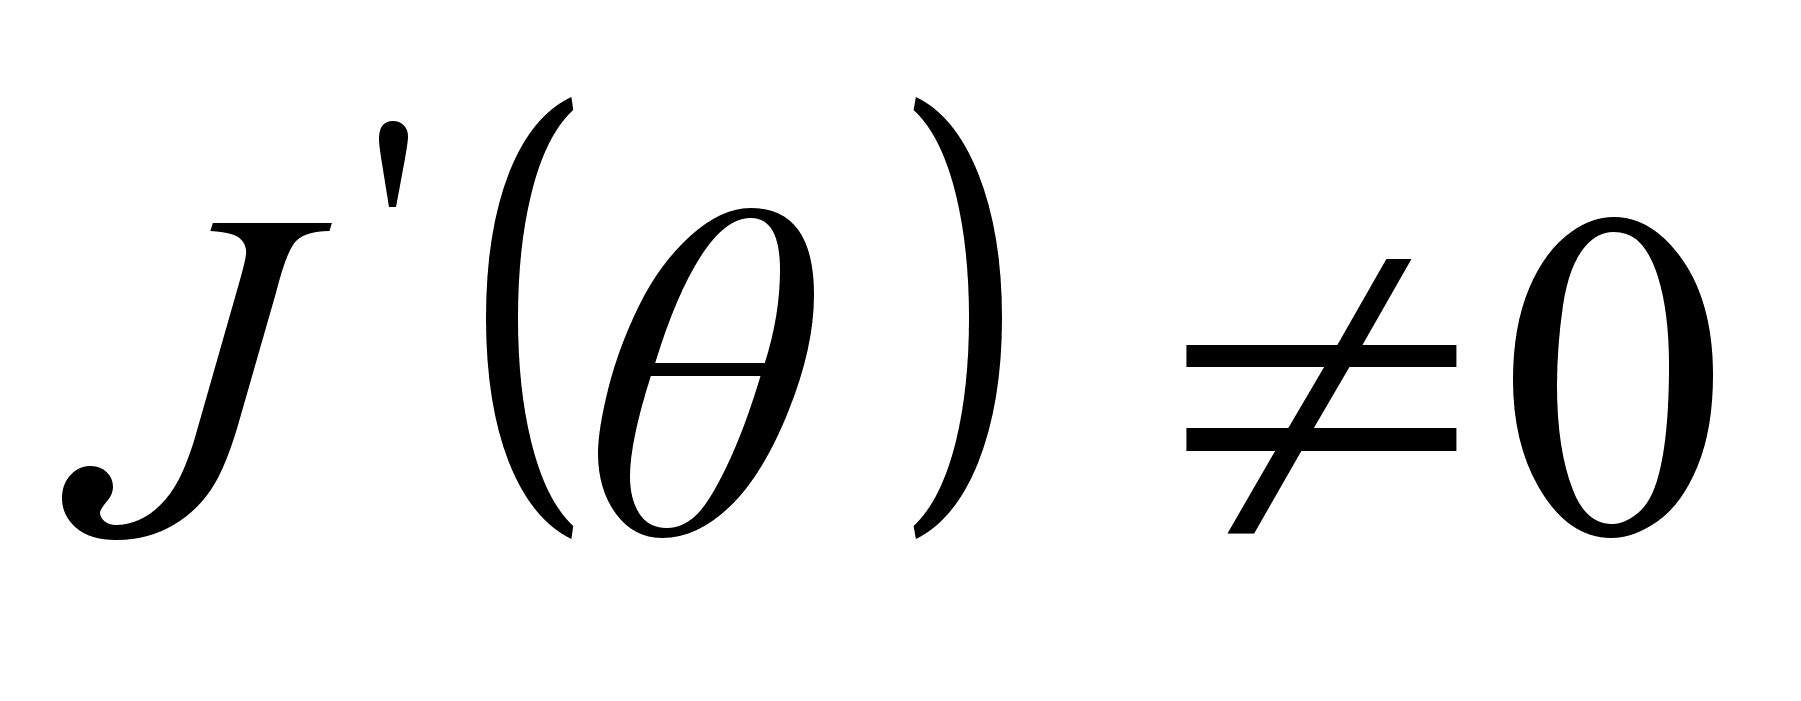 ,
то при достаточно
малых
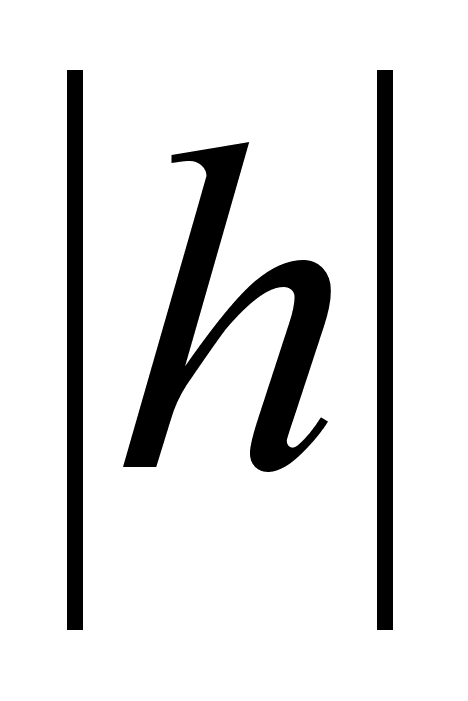 главная часть
приращения
(1.3.2) будет определяться
дифференциалом
функции
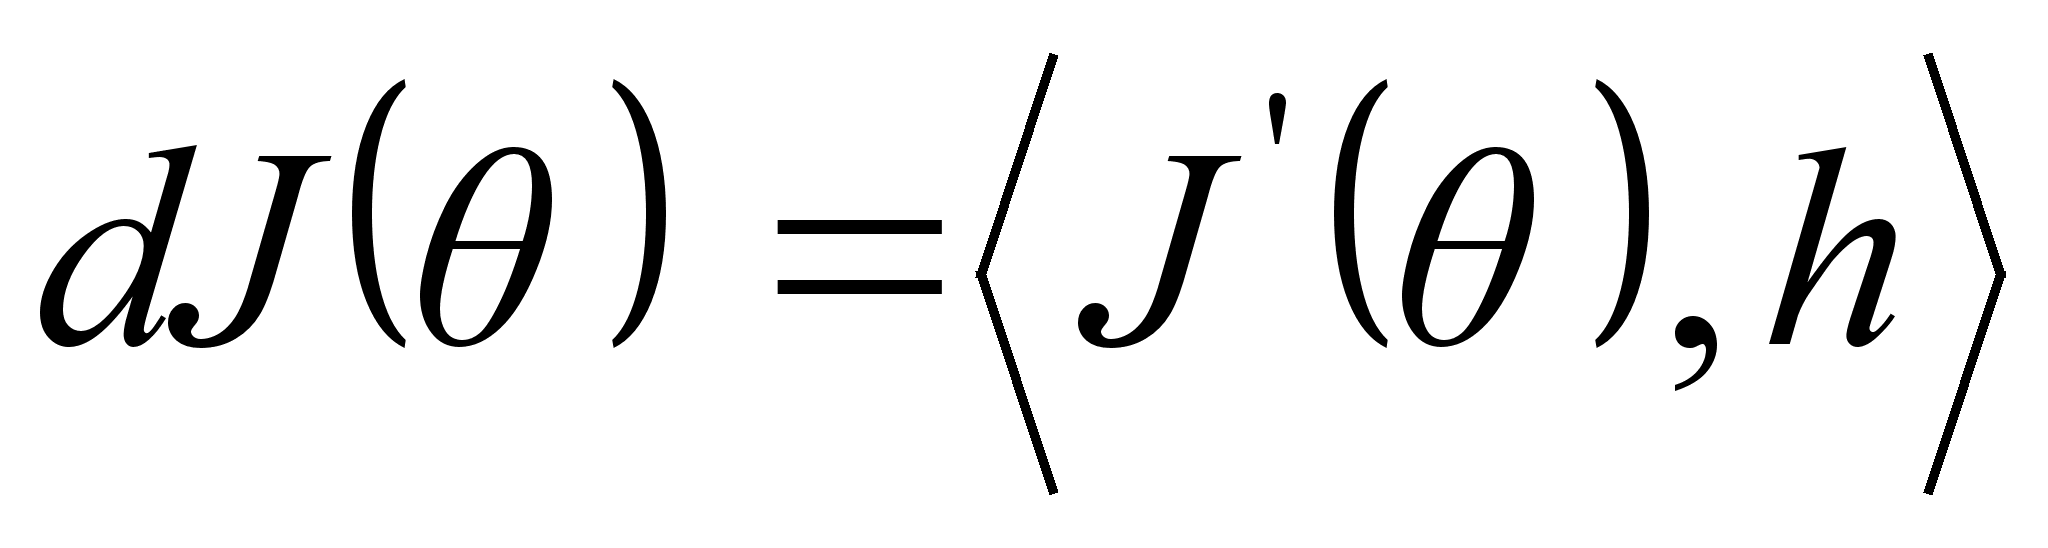 .
Справедливо
неравенство
Коши-Буняковского
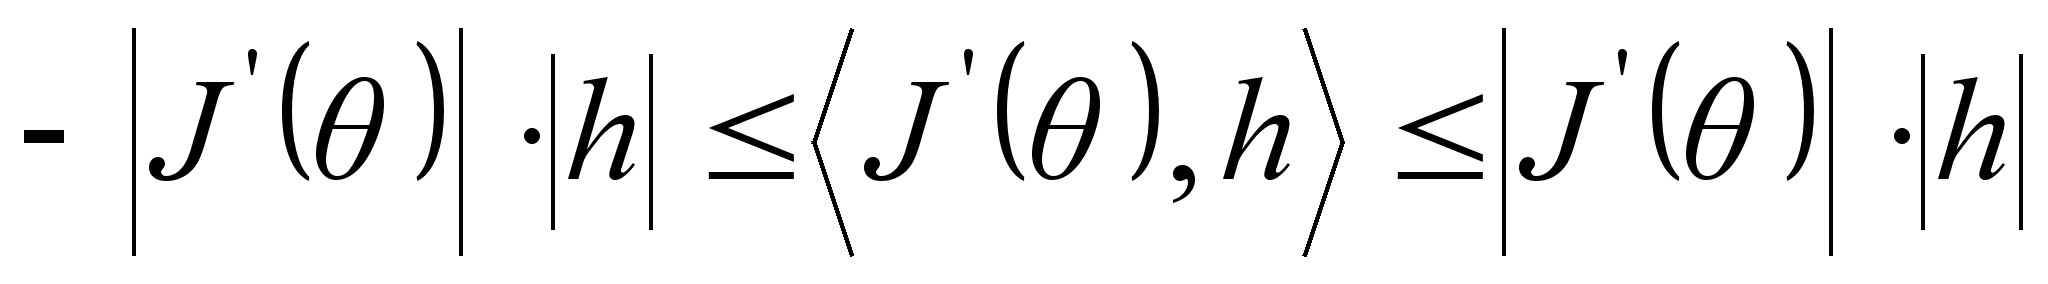 ,
причем если
,
то правое неравенство
превращается
в равенство
только при
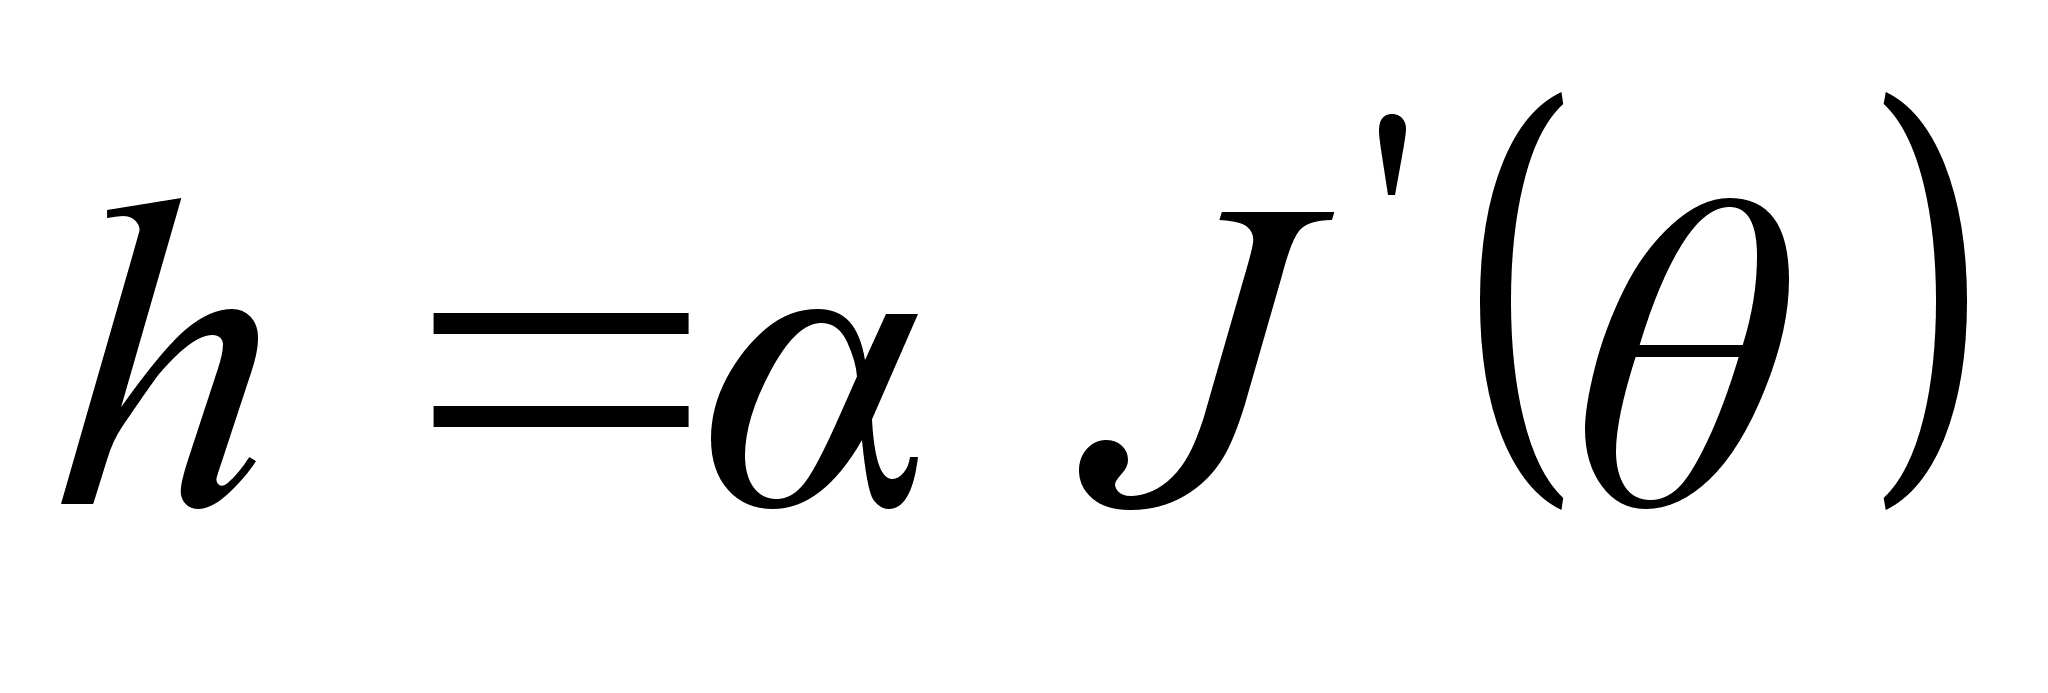 ,
а левое неравенство
– только при
,
где
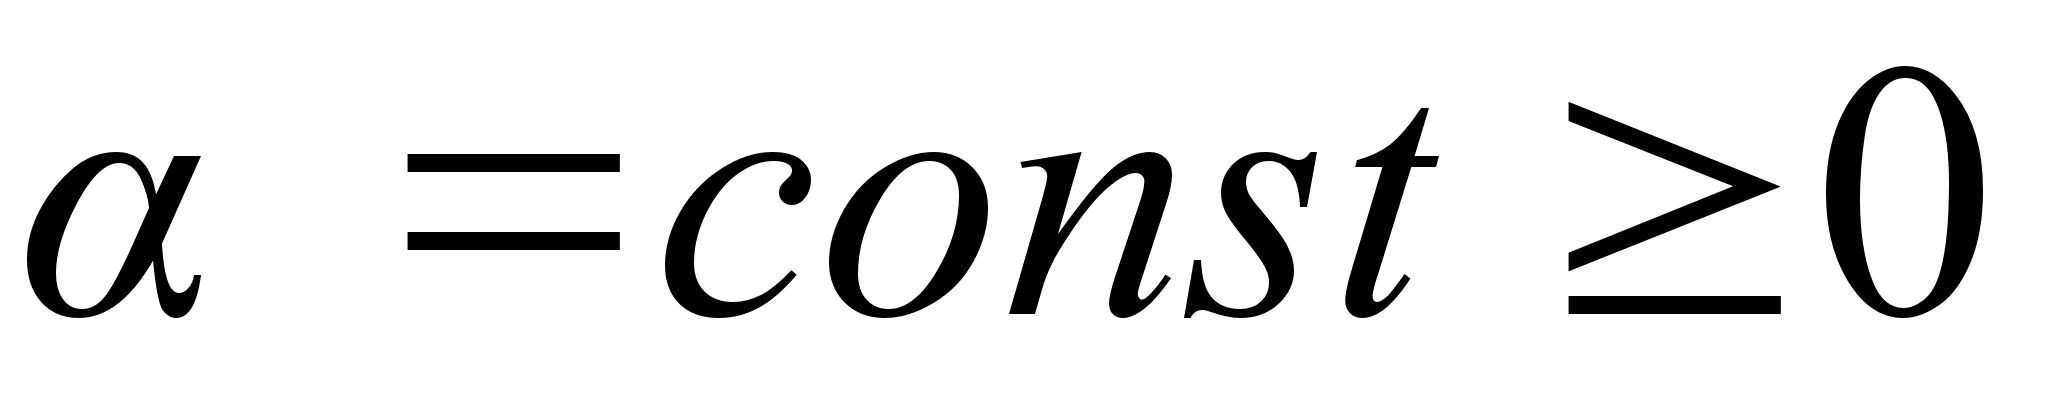 .
Отсюда ясно,
что при
направление
наибыстрейшего
возрастания
функции
в точке
совпадает с
направлением
градиента
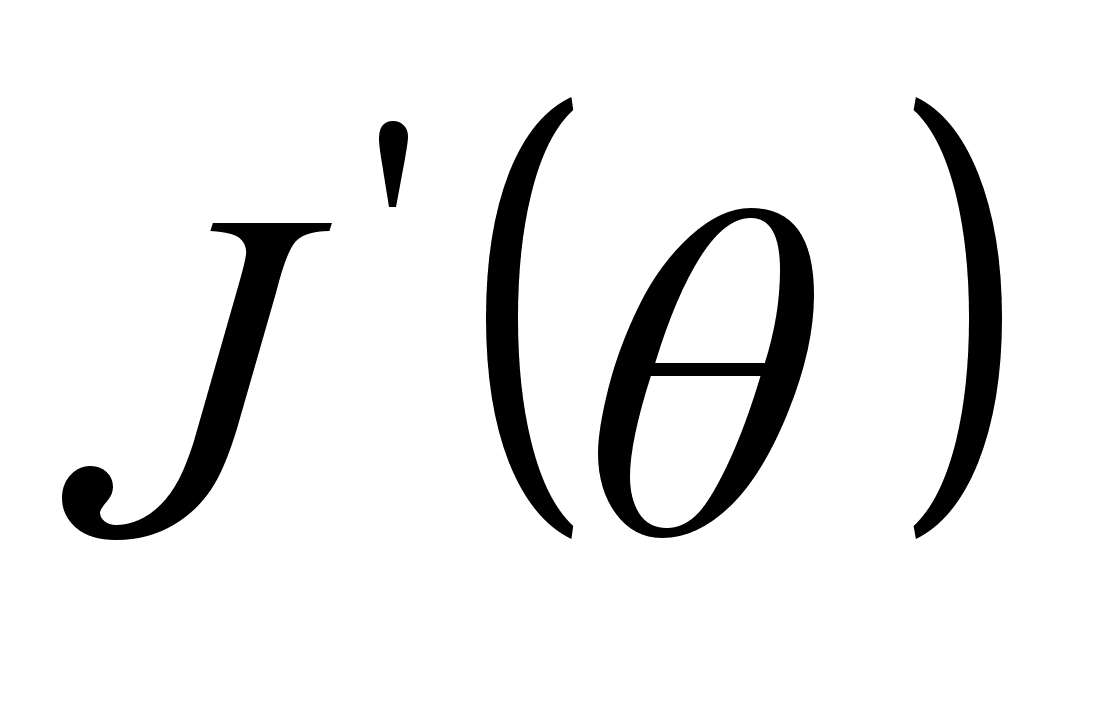 ,
а направление
наибыстрейшего
убывания – с
направлением
антиградиента
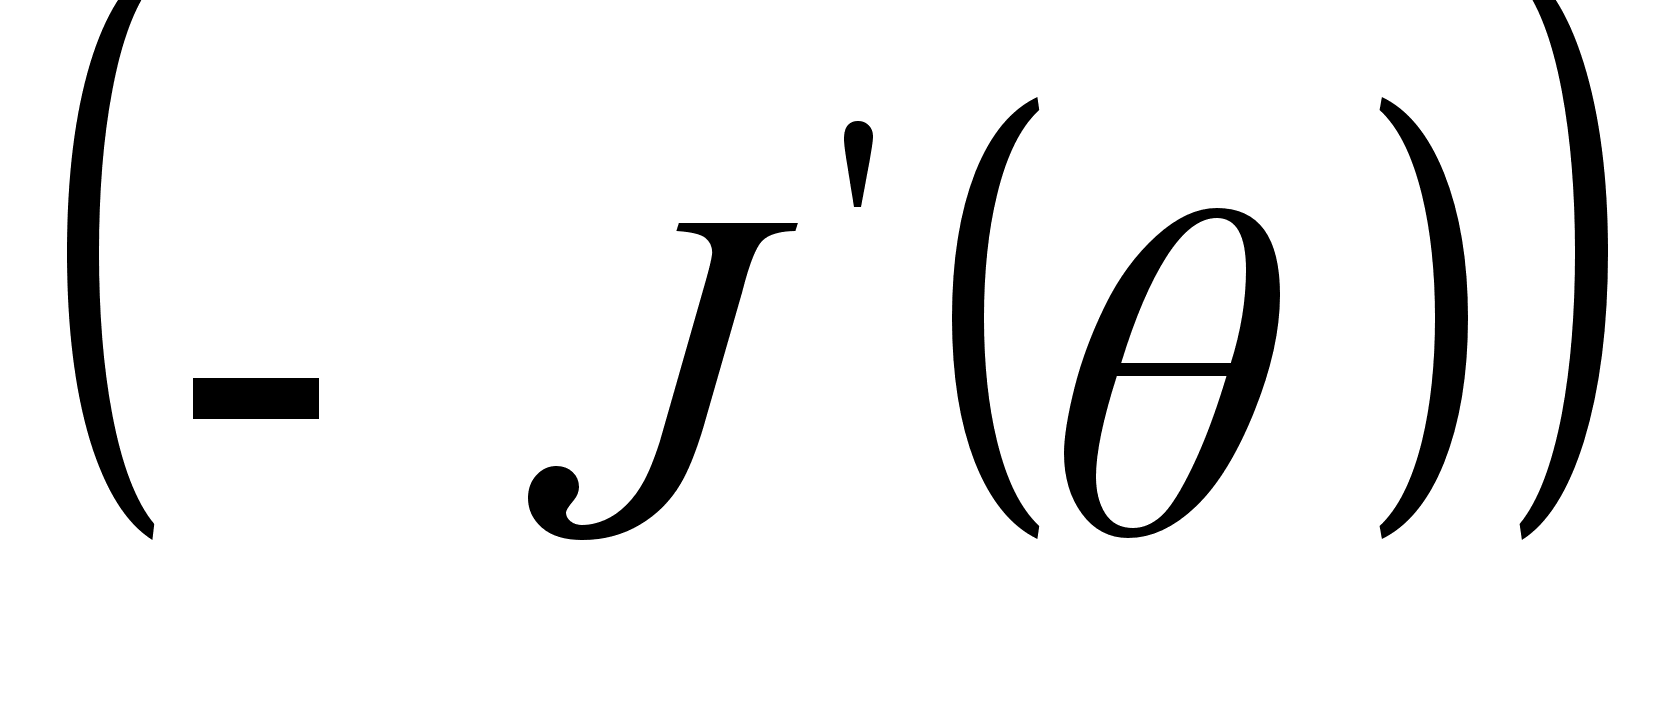 .
Это замечательное свойство градиента лежит в основе ряда итерационных методов минимизации функций. Одним из таких методов является градиентный метод, к описанию которого мы переходим.
Градиентный метод. Будем считать, что некоторая точка
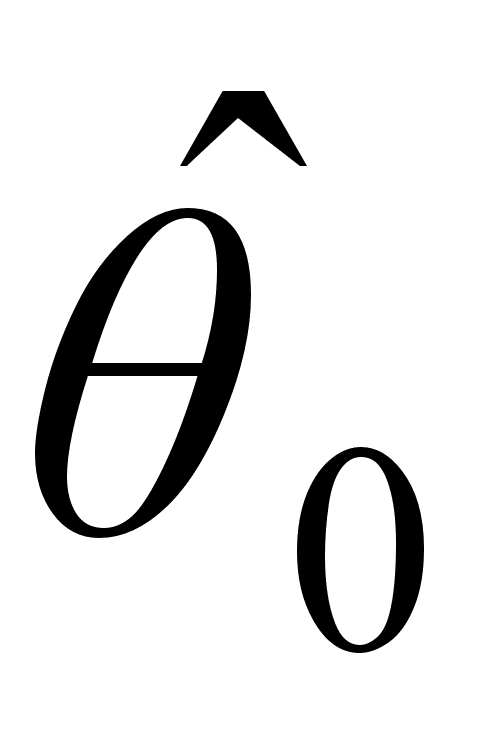 уже выбрана.
Тогда метод
заключается
в построении
последовательности
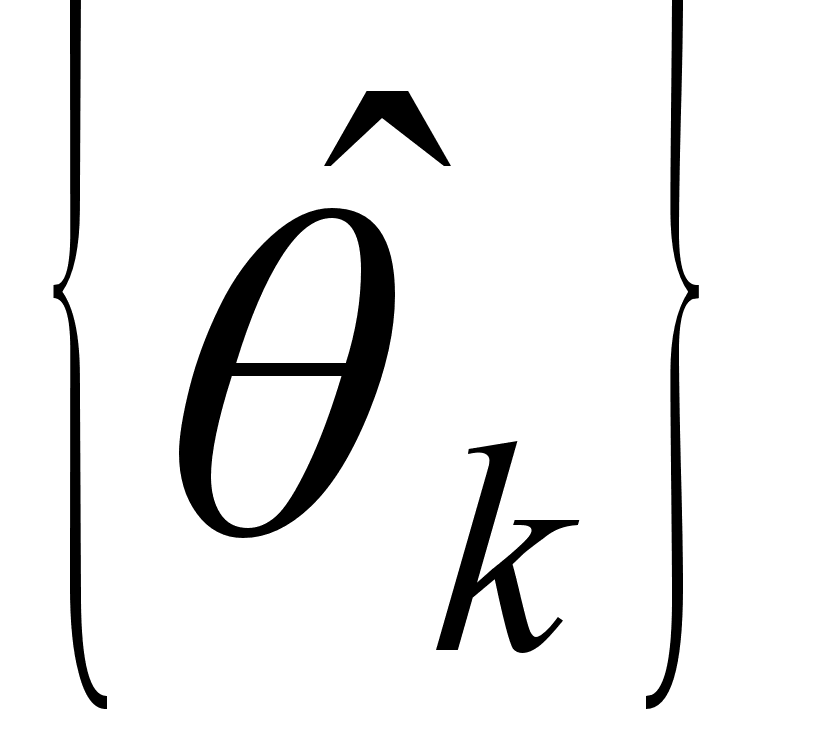 по правилу:
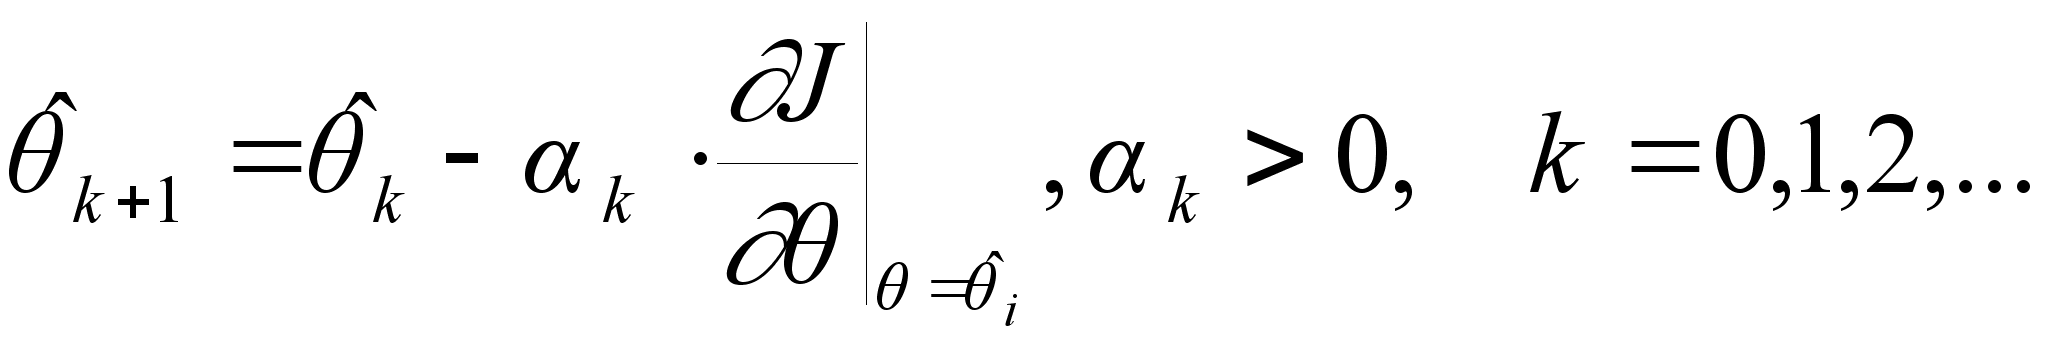
Существуют
различные
способы выбора
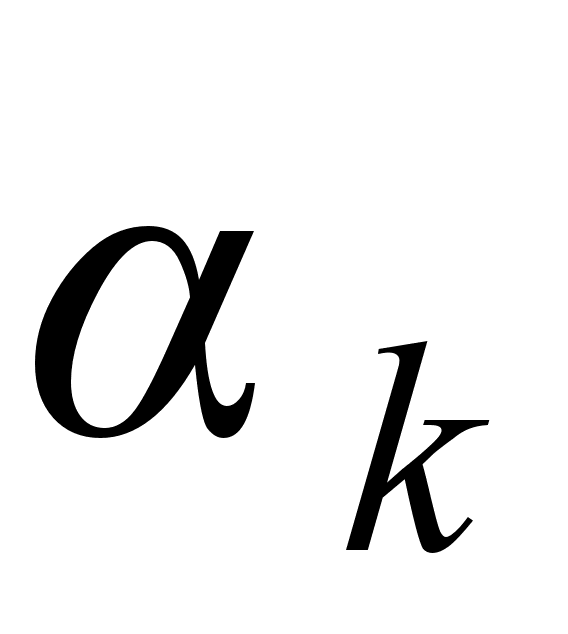 в данном методе,
но на практике
нередко довольствуются
нахождением
какого-либо
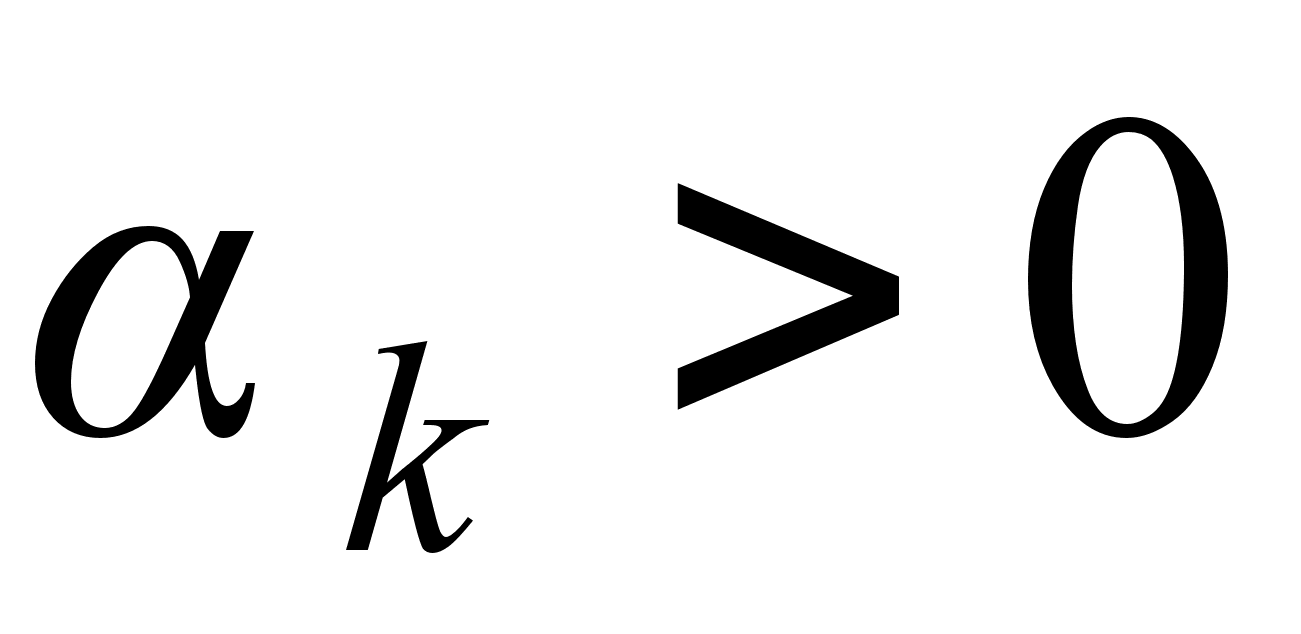 ,
обеспечивающего
условие монотонности:
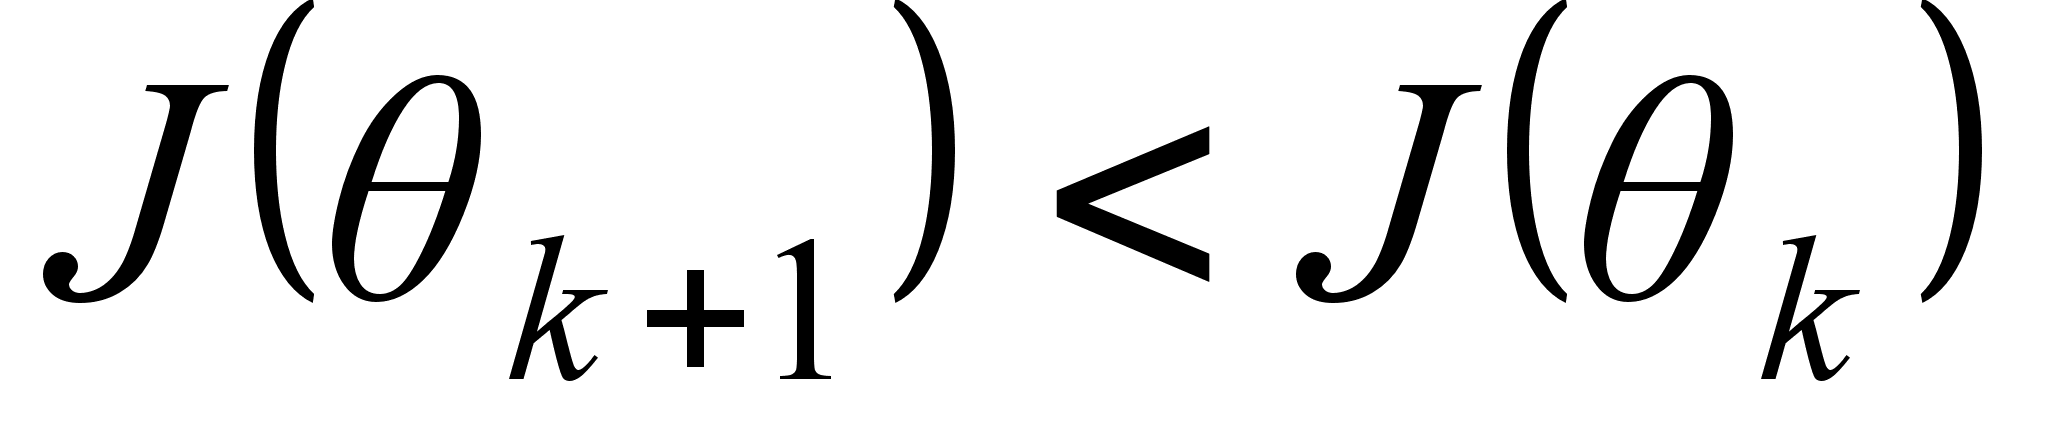 .
С этой целью
задаются какой-либо
постоянной
и на каждой
итерации метода
берут
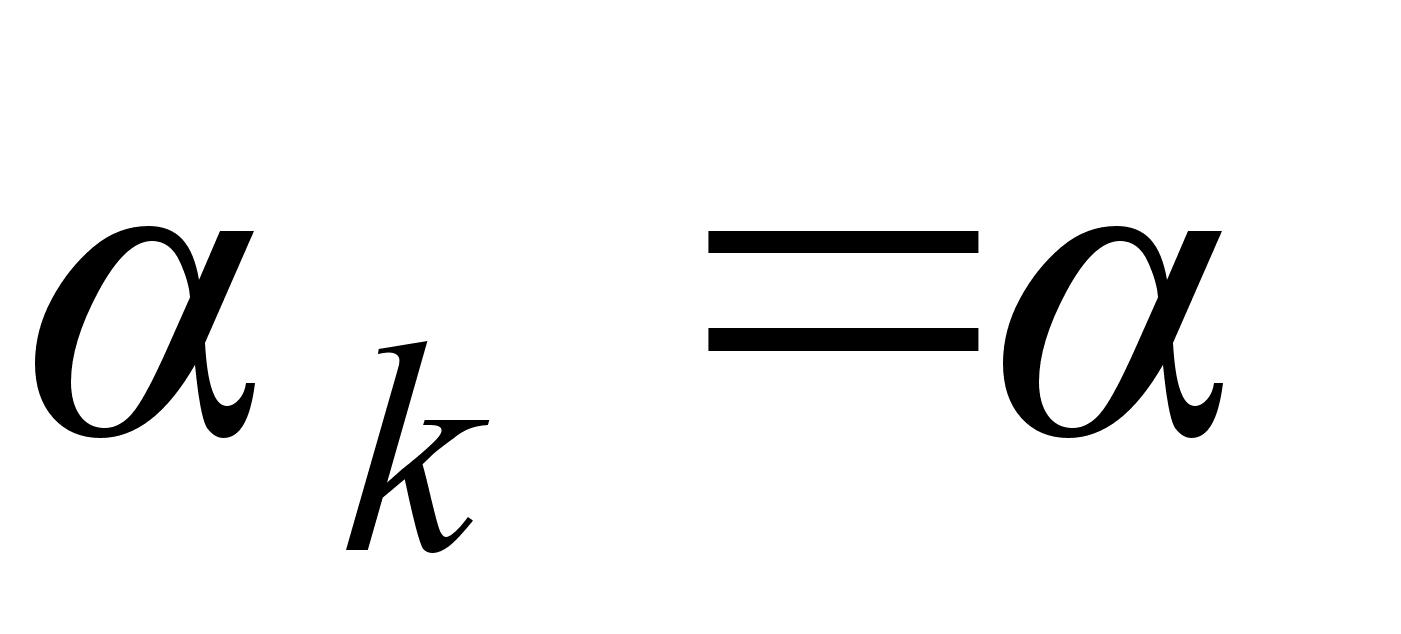 .
При этом для
каждого
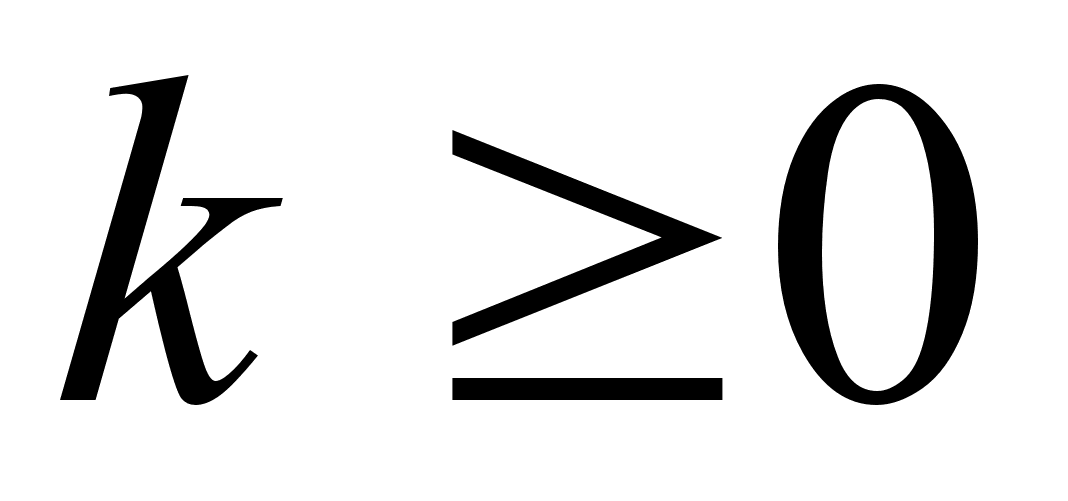 проверяют
условие монотонности,
и в случае его
нарушения
дробят до тех
пор, пока не
восстановится
монотонность
метода.
МетодНьютона. Градиентный метод является методом первого порядка, поскольку использует лишь первые производные минимизируемой функции. Однако если минимизируемая функция дважды непрерывно дифференцируема и производные вычисляются достаточно просто, то возможно применение метода минимизации второго порядка, которые используют квадратичную часть разложения этой функции в ряд Тейлора. Широко известный метод Ньютона представляет собой итерационный процесс:
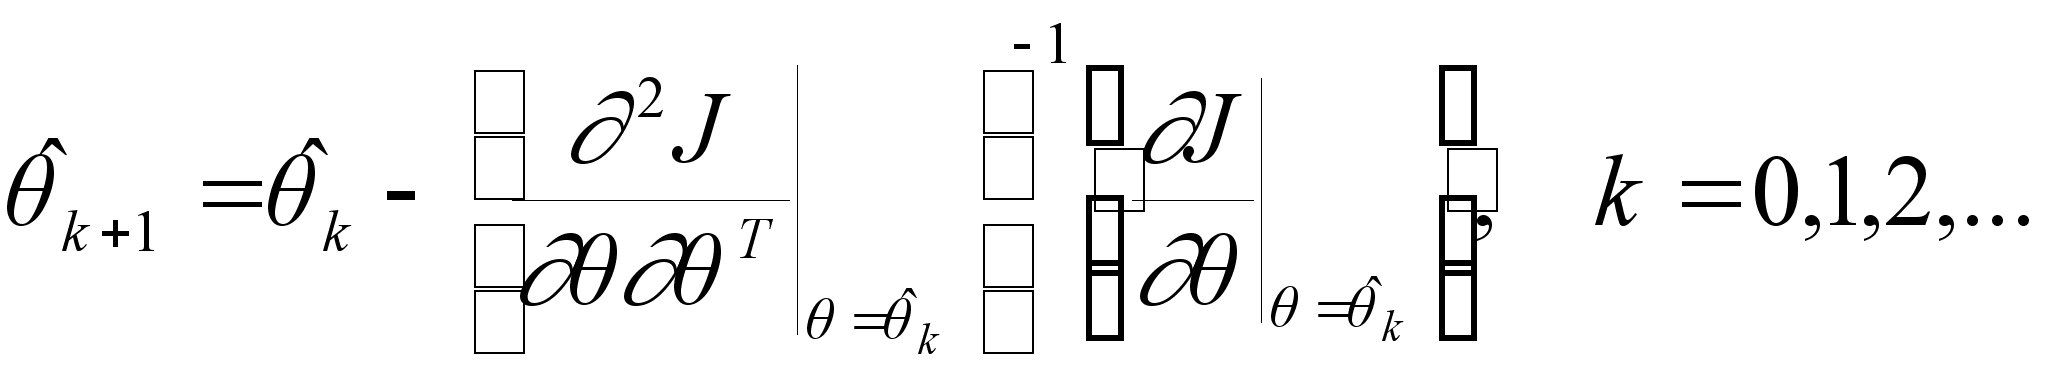
Метод сопряженных направлений. Метод сопряженных направлений является методом использующим лишь градиент функционала и описывается следующим образом:
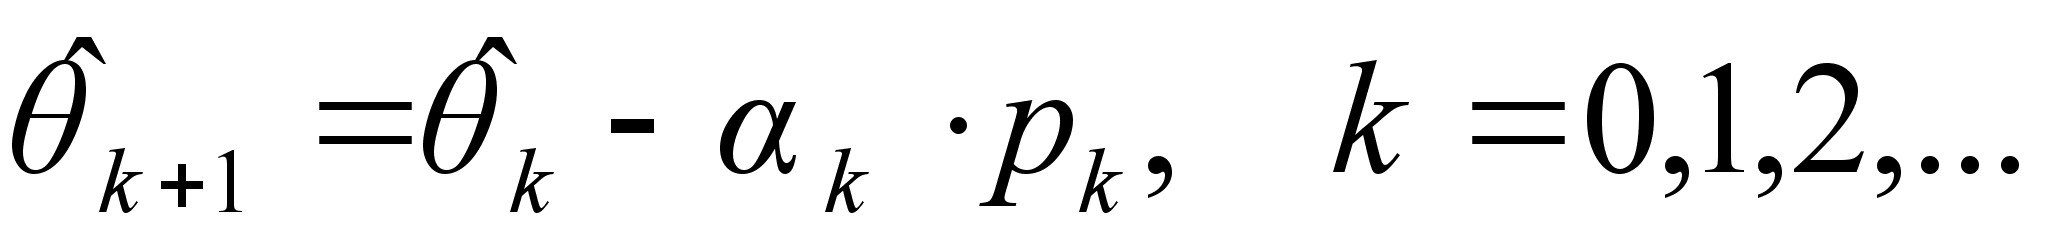 ,
где величина
находится из
условия
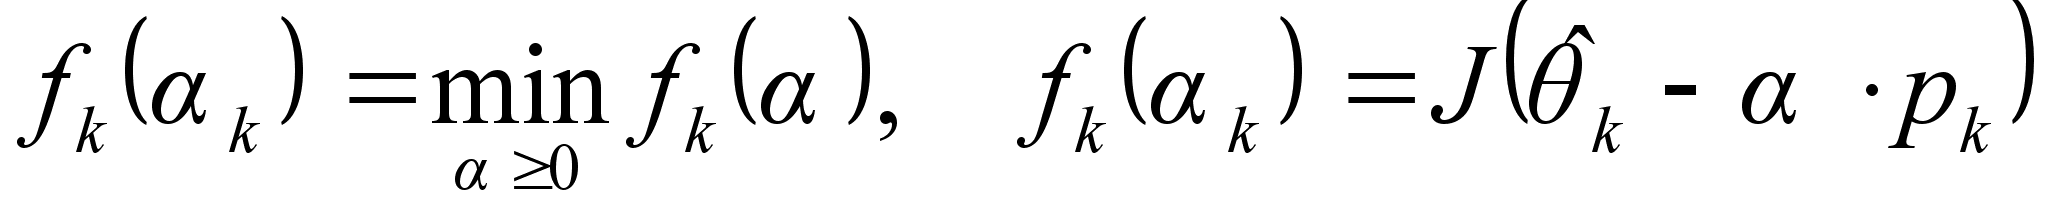 ,
а
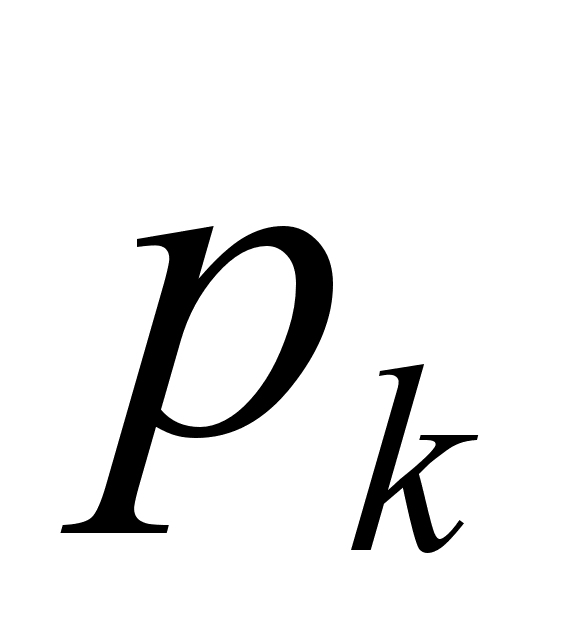 вычисляется
из следующих
формул
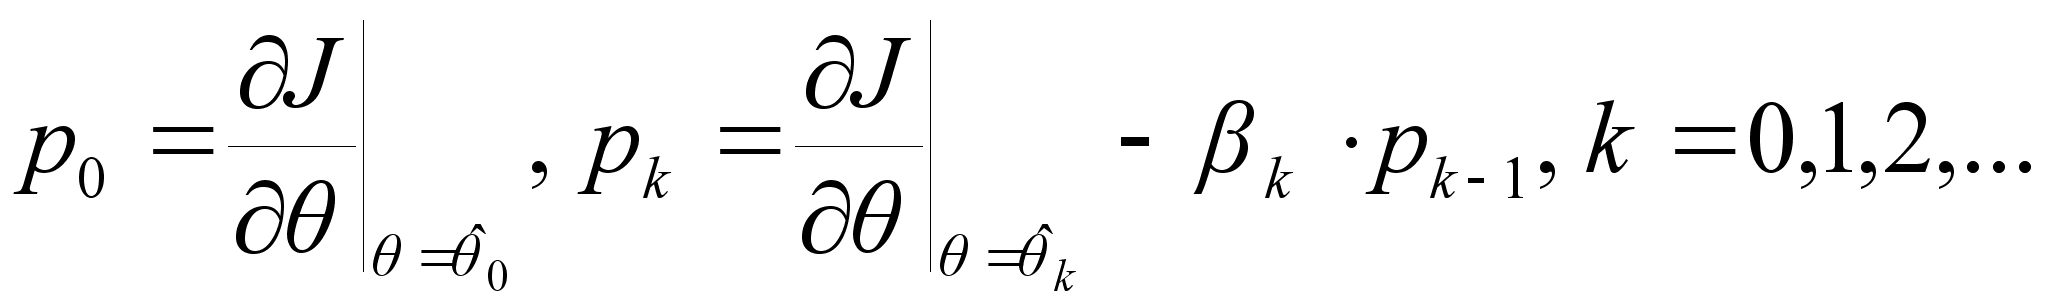
Точное определение
величины
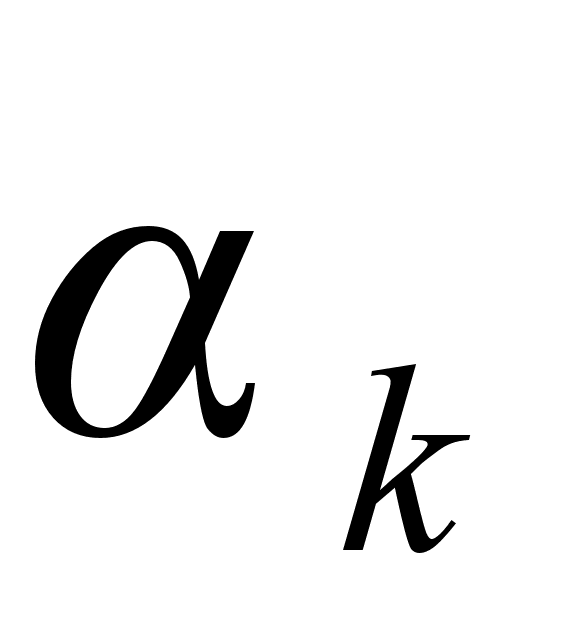 возможно лишь
в редких случаях,
поэтому реализация
каждой итерации
метода будет
сопровождаться
неизбежными
погрешностями.
Эти погрешности,
накапливаясь,
могут привести
к тому, что векторы
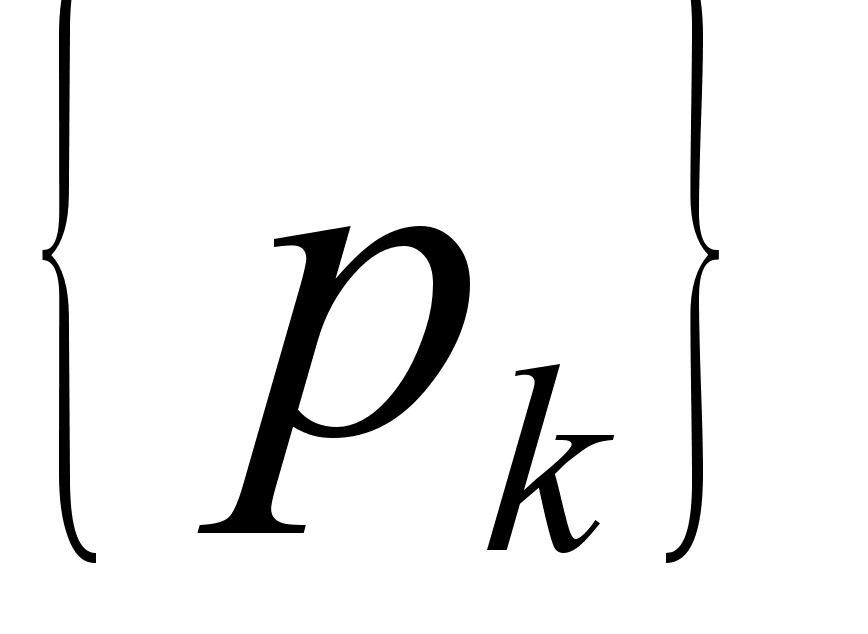 перестают
указывать
направление
убывания функции,
и сходимость
метода может
нарушиться.
Чтобы бороться
с этим явлением,
метод сопряженных
направлений
время от времени
обновляют,
полагая
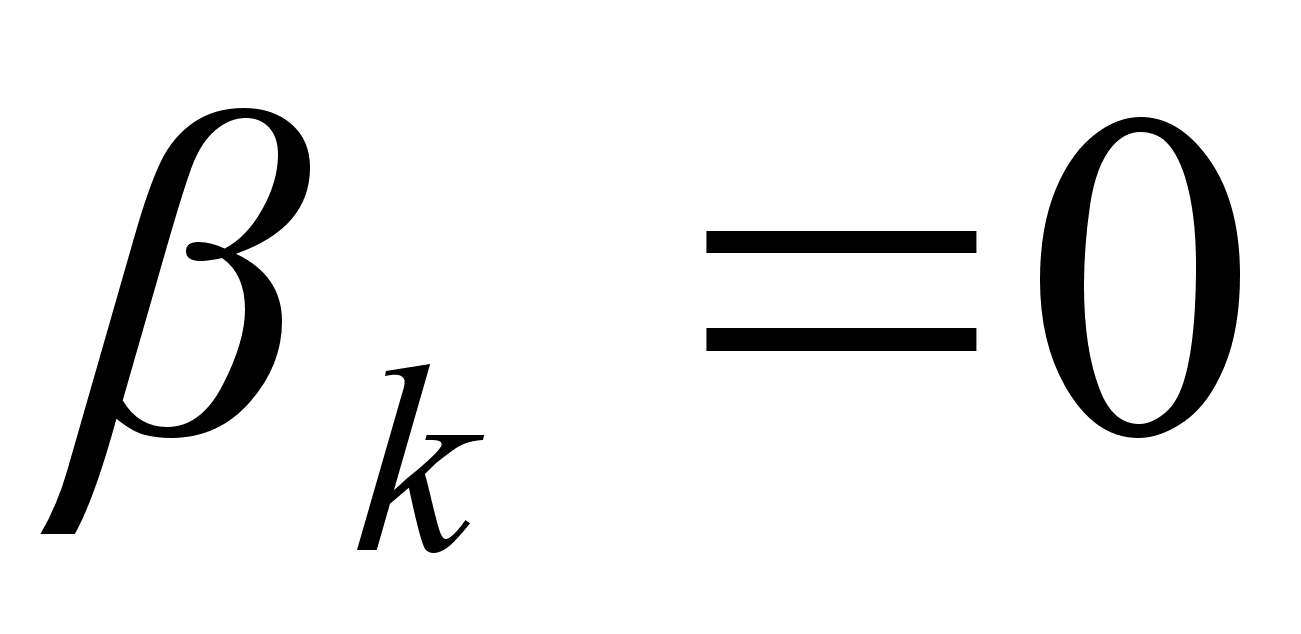 .
1.4. Метод квадратно-корневого информационного фильтра(ККИФ)
Пусть динамическая система с дискретным временем дана в следующем виде:
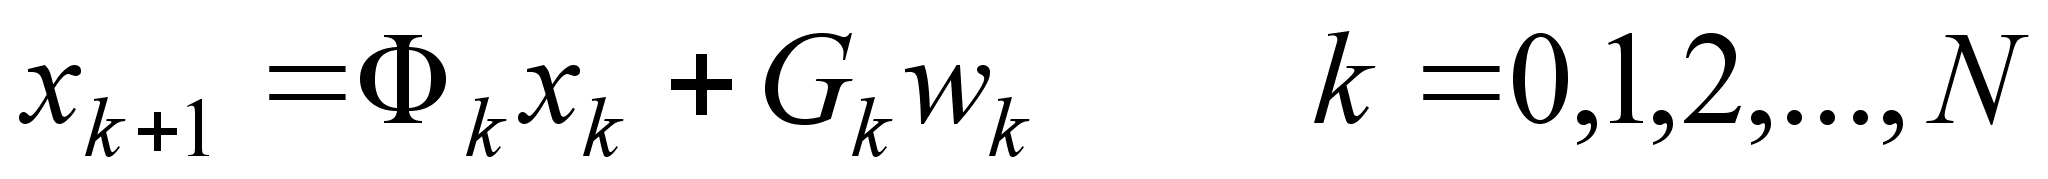 (1.4.1)
где вектор
состояния
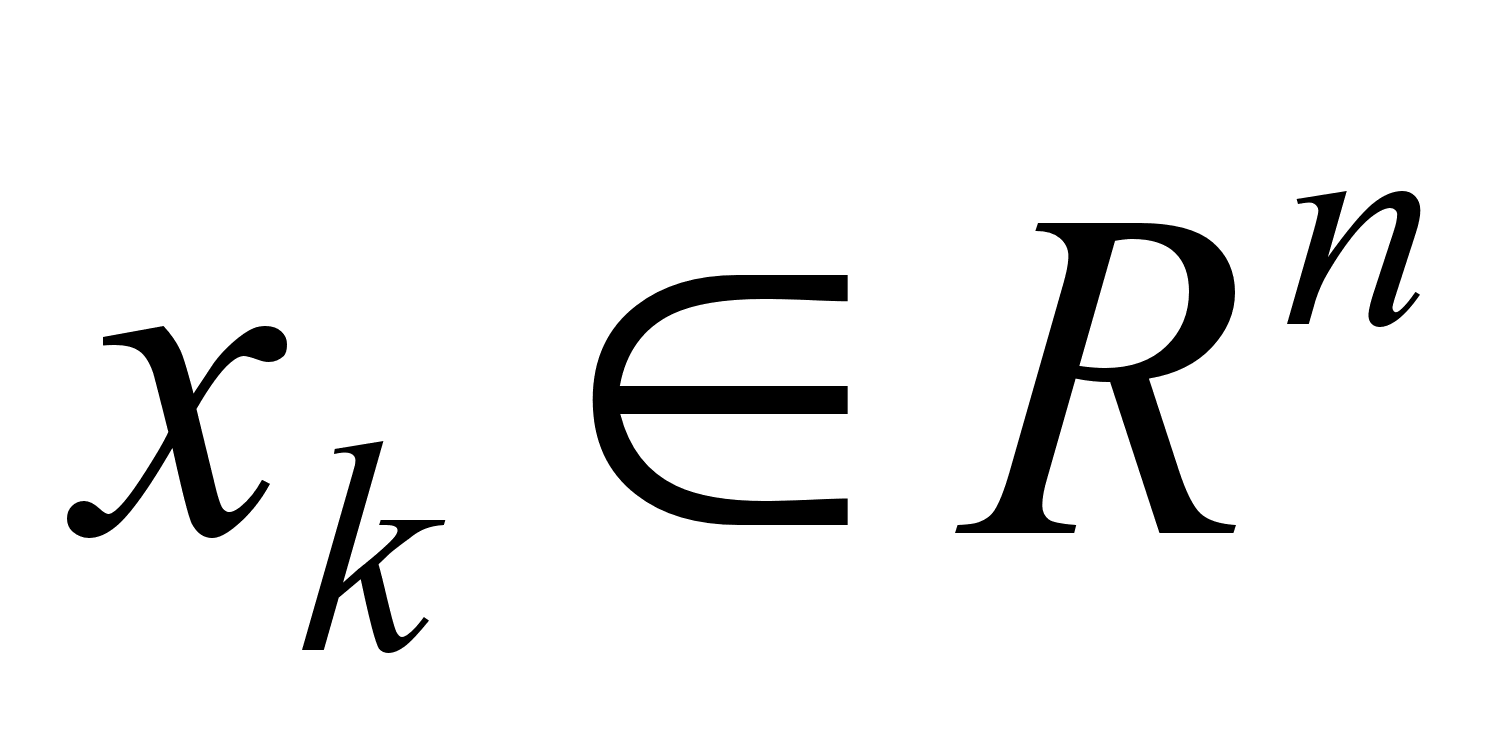 ,
матрица переходов
из состояния
в состояние
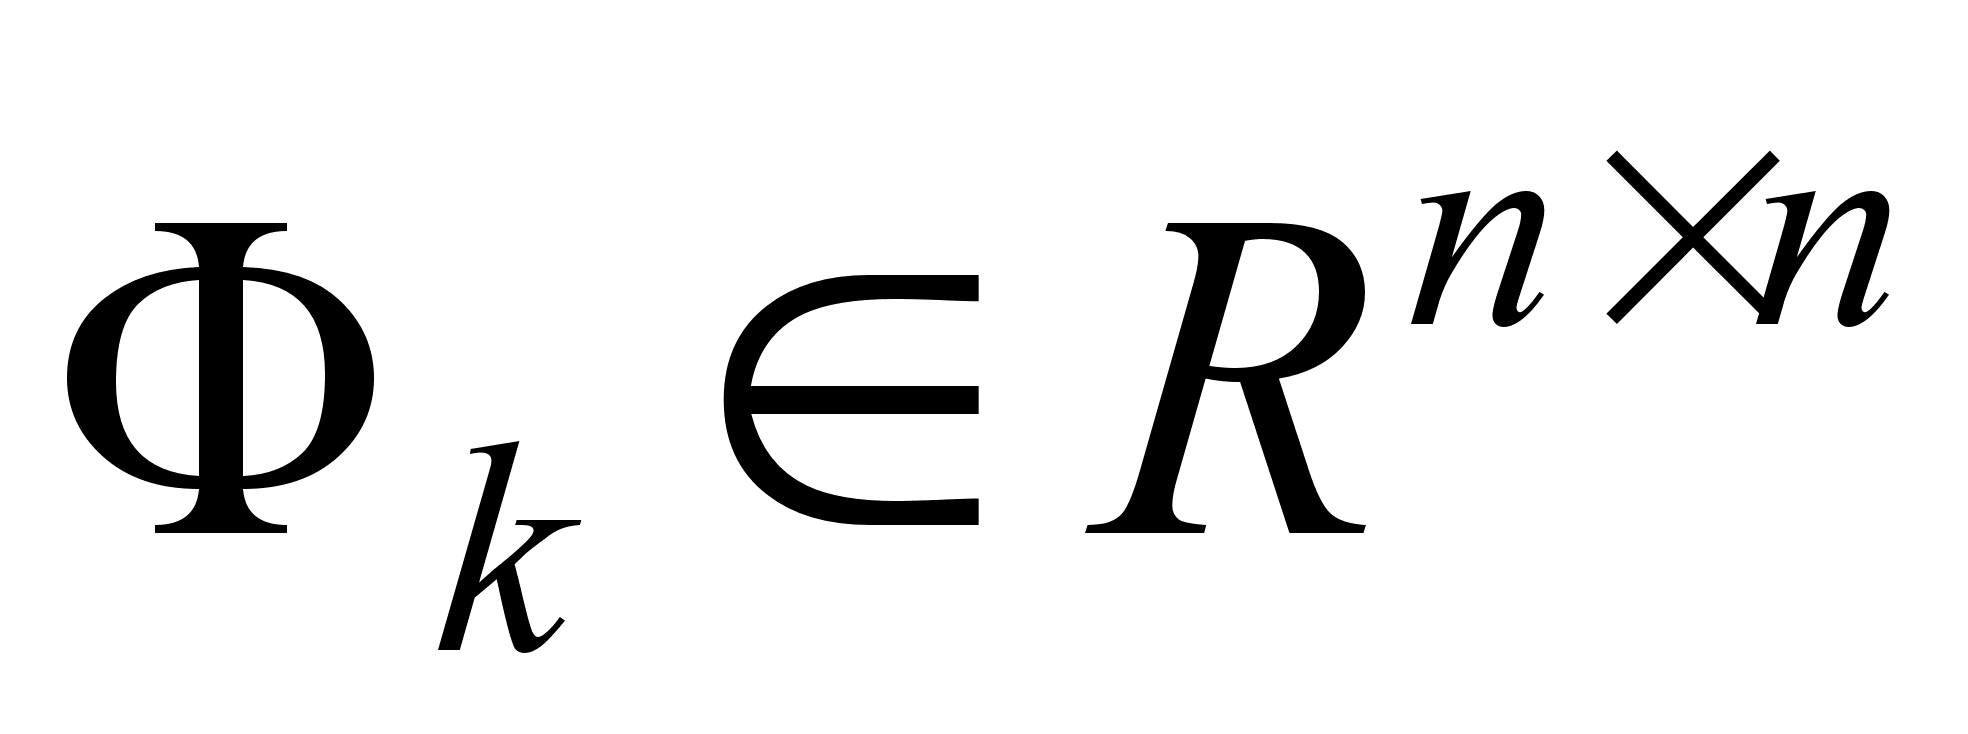 ,
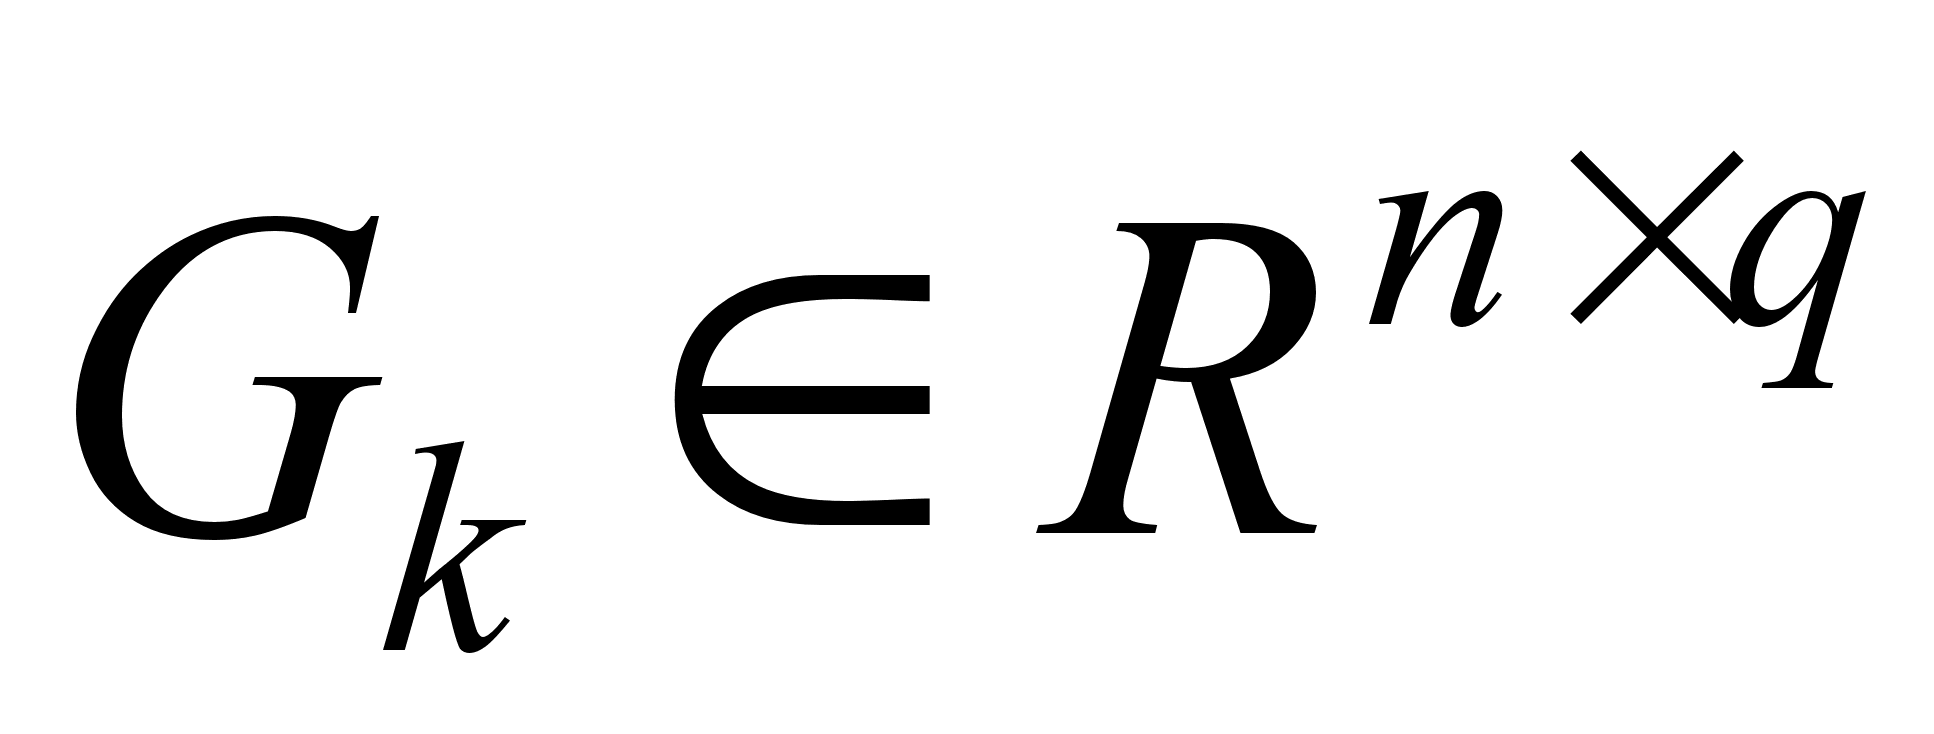 и
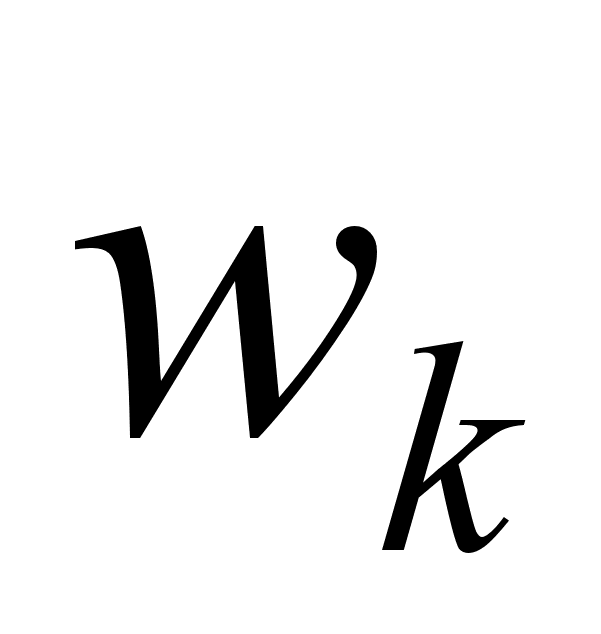 -
случайный
процесс, представляющий
собой белый
гауссовый шум
с нулевым средним
и ковариацией
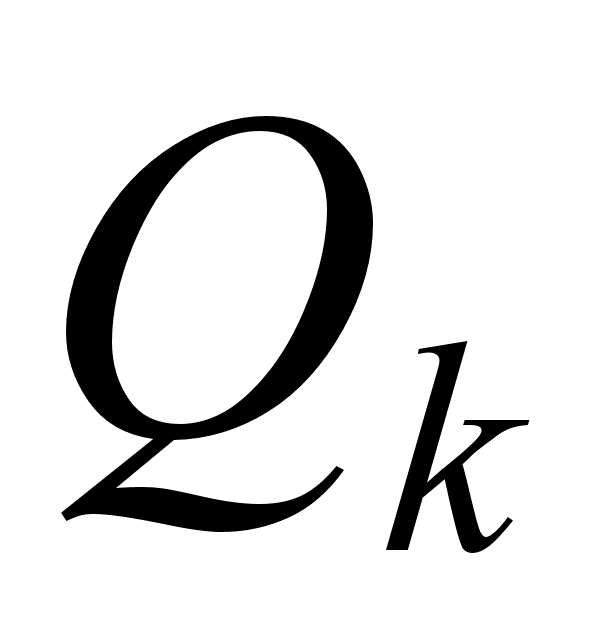 ,
т.е.
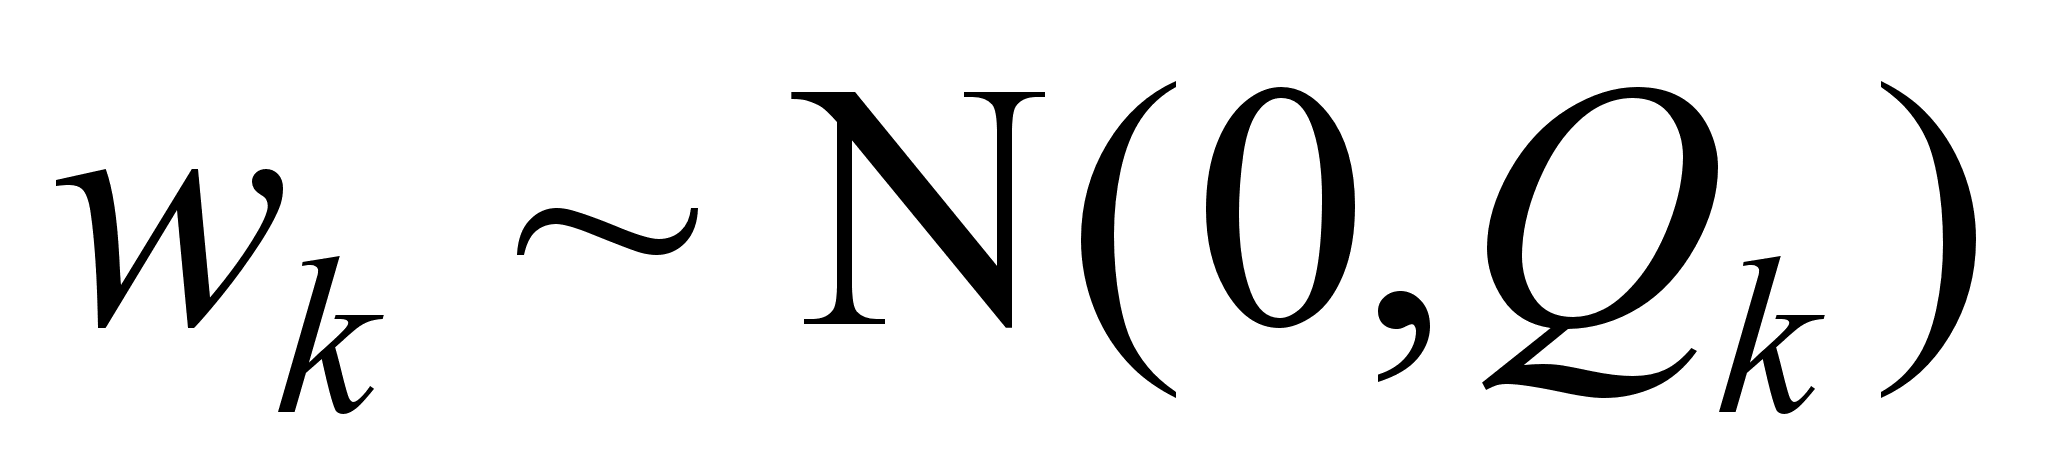 .
Пусть множество наблюдений задается уравнением:
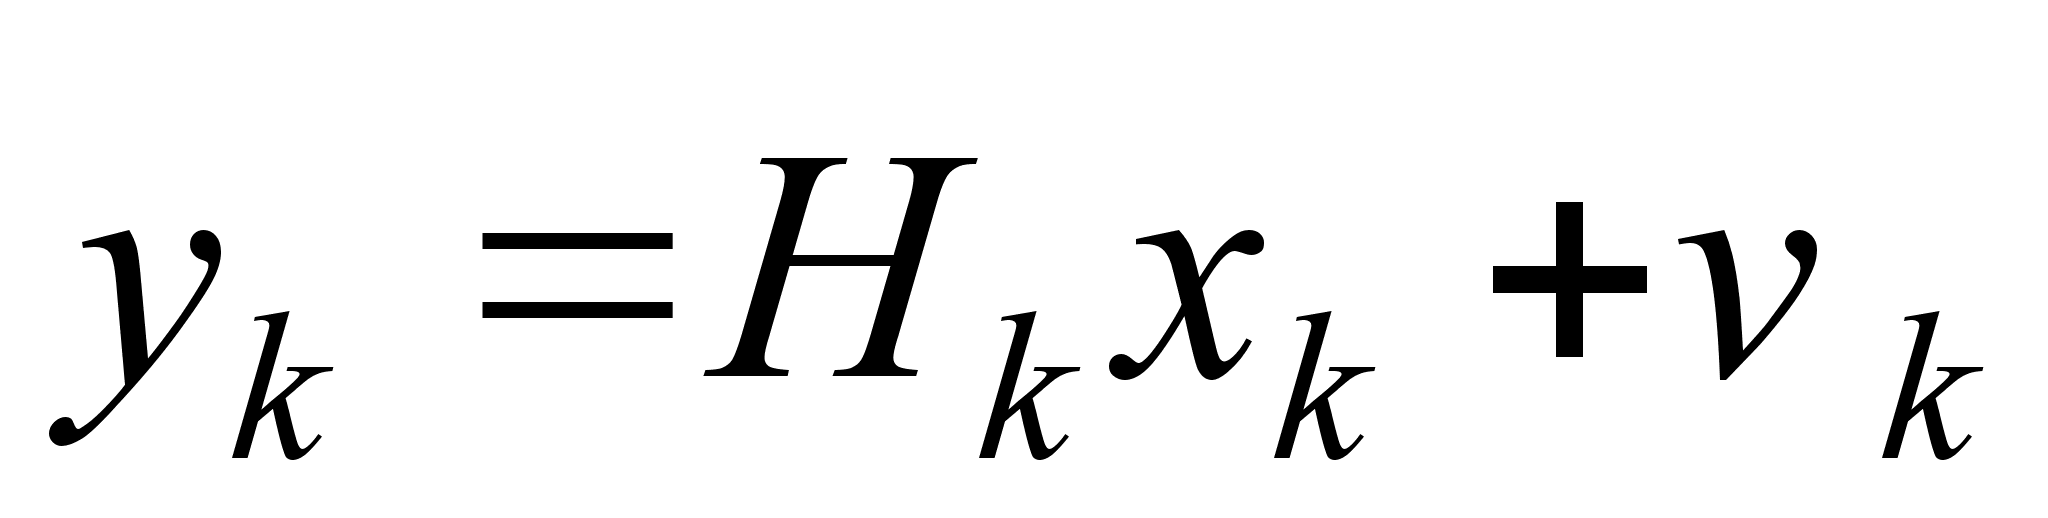 (1.4.2)
где вектор
наблюдения
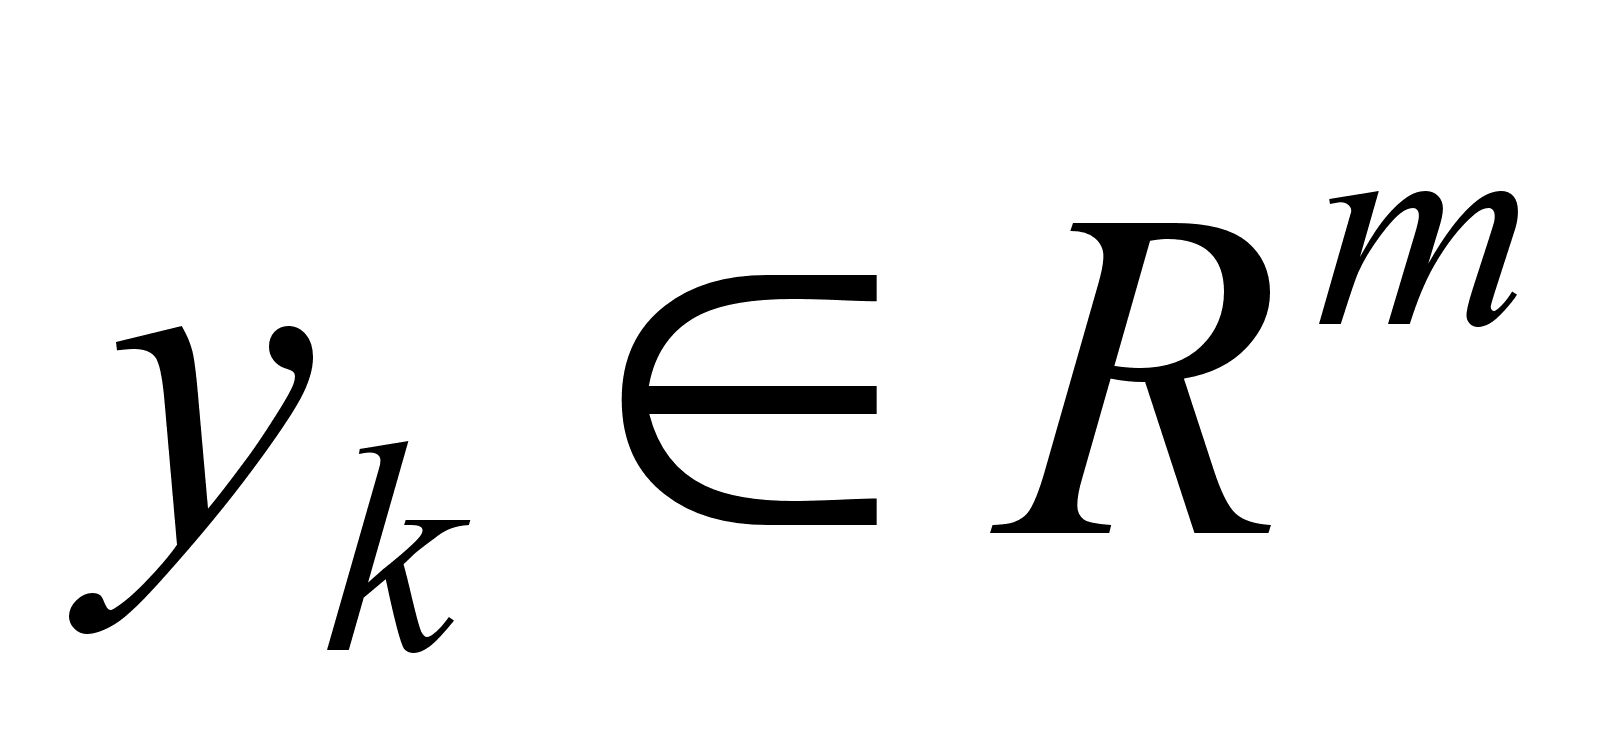 ,
матрица наблюдений
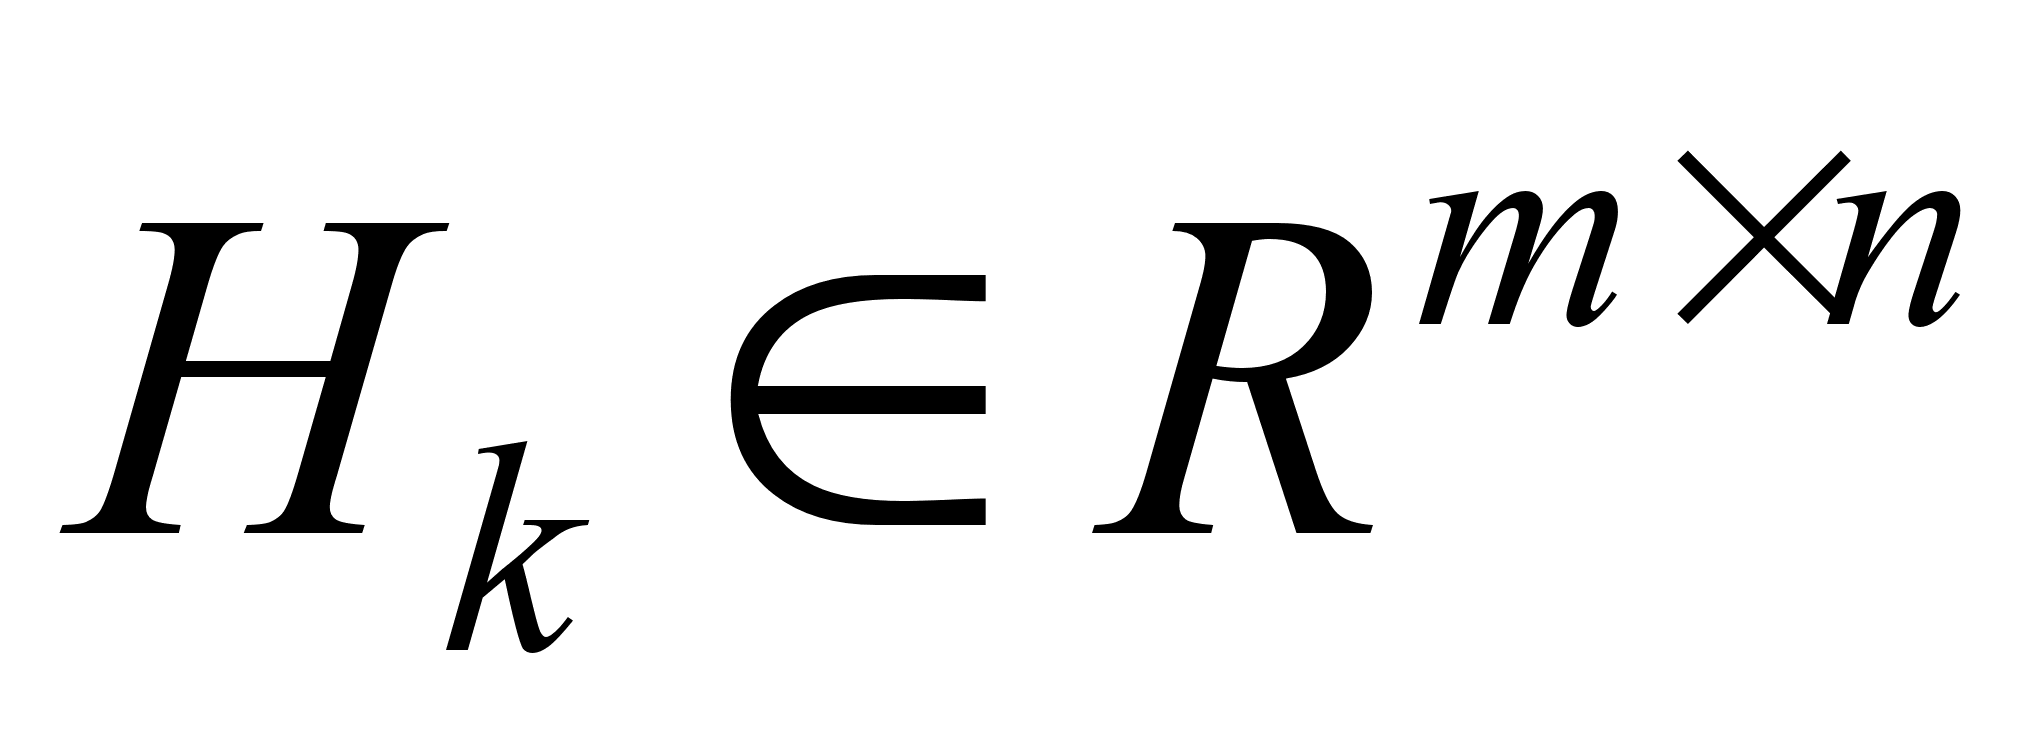 ,
и
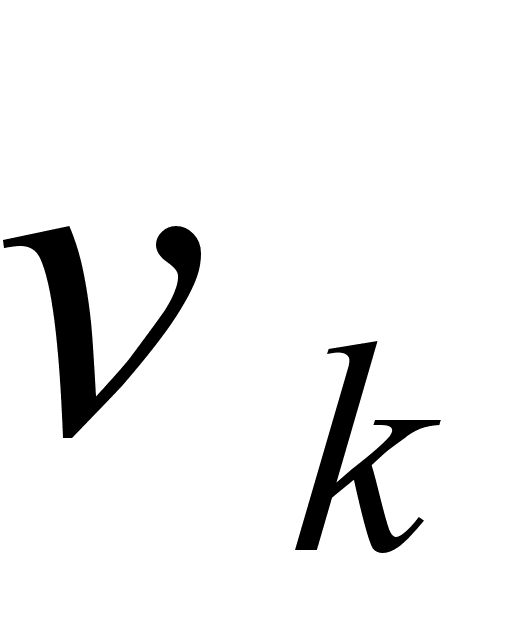 -
шум:
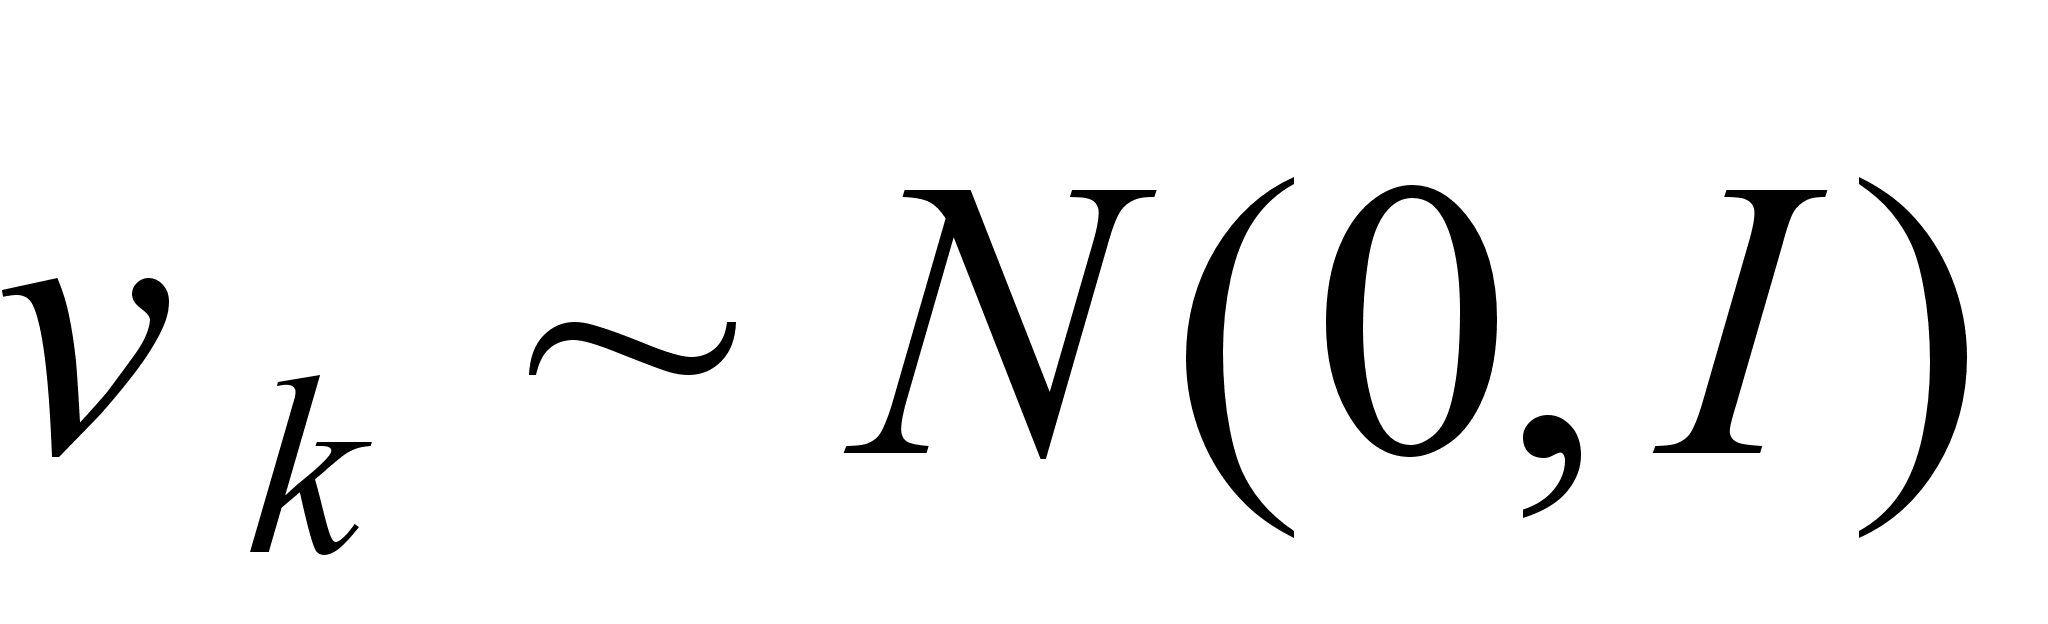 .
Предположим,
что мы имеем
априорный
информационный
массив
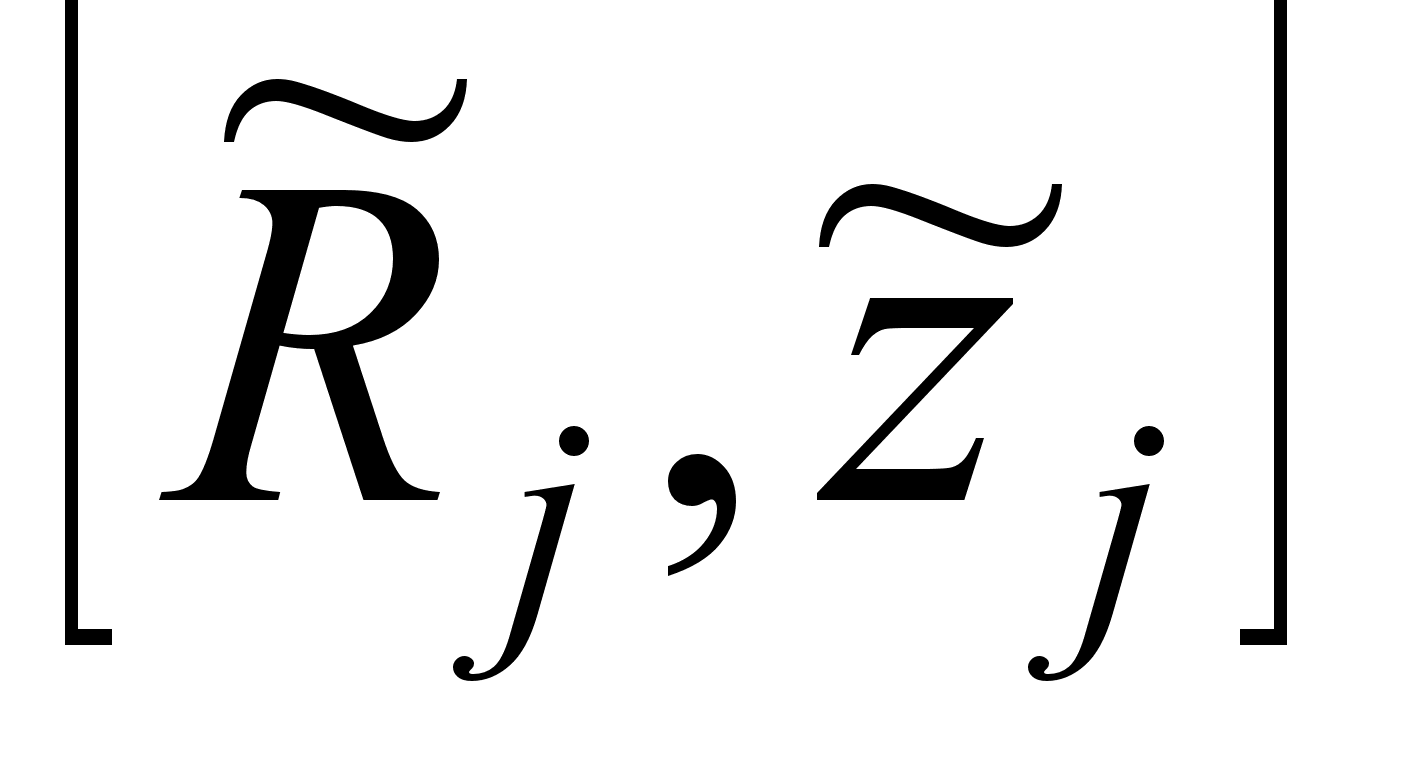 ,
где
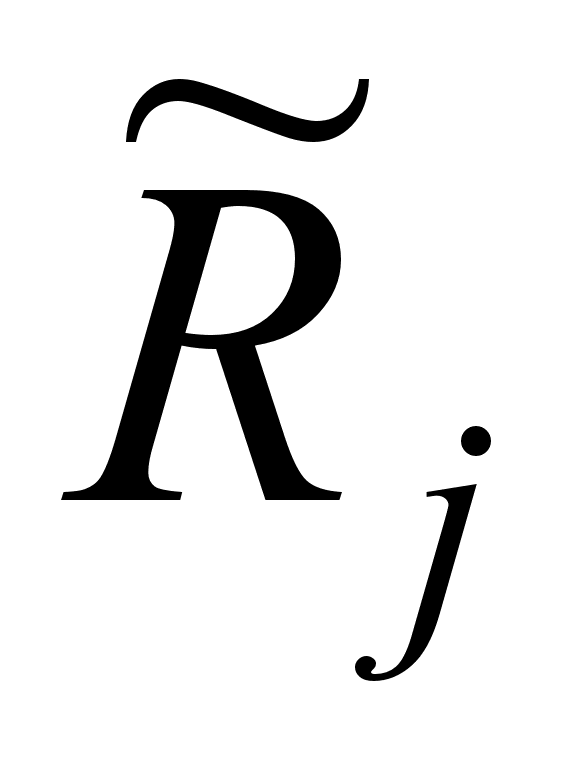 -
невырожденная
априорная
ковариация
и оценки
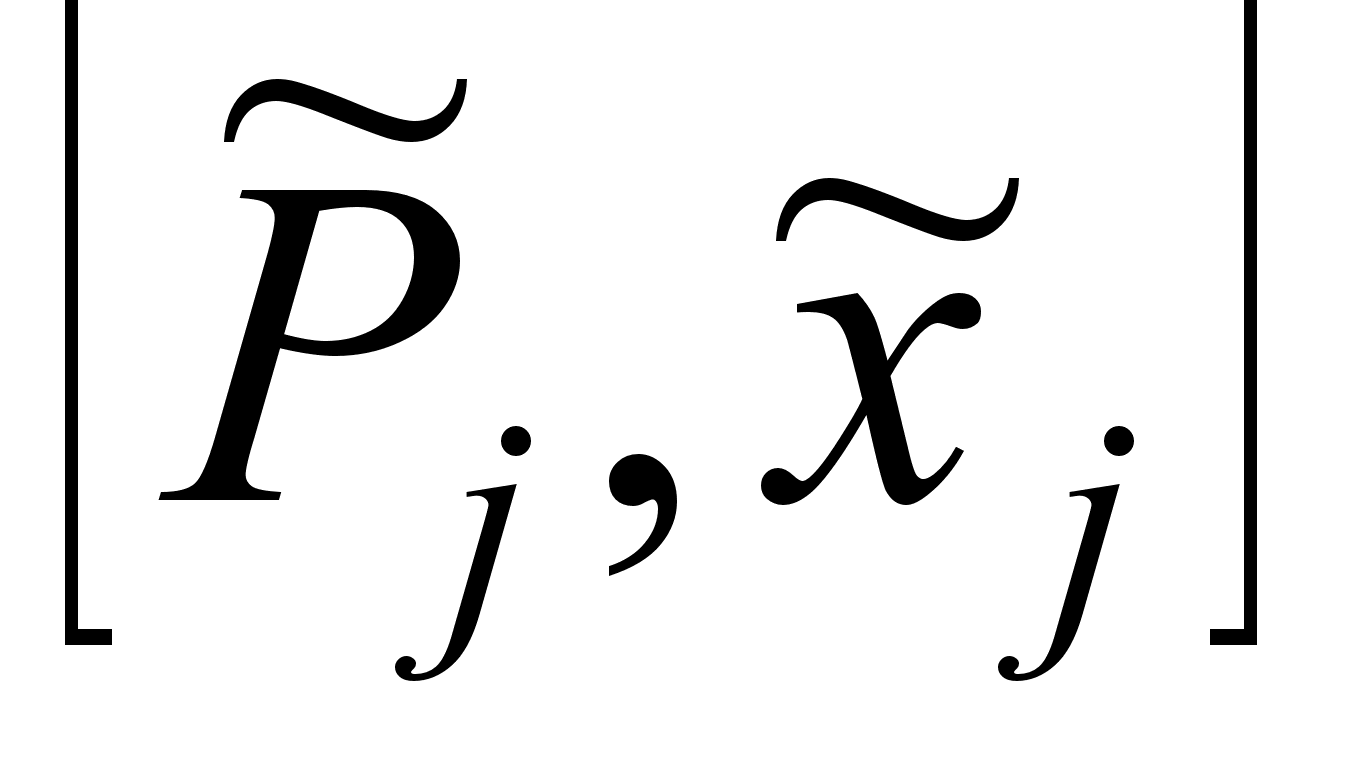 относятся к
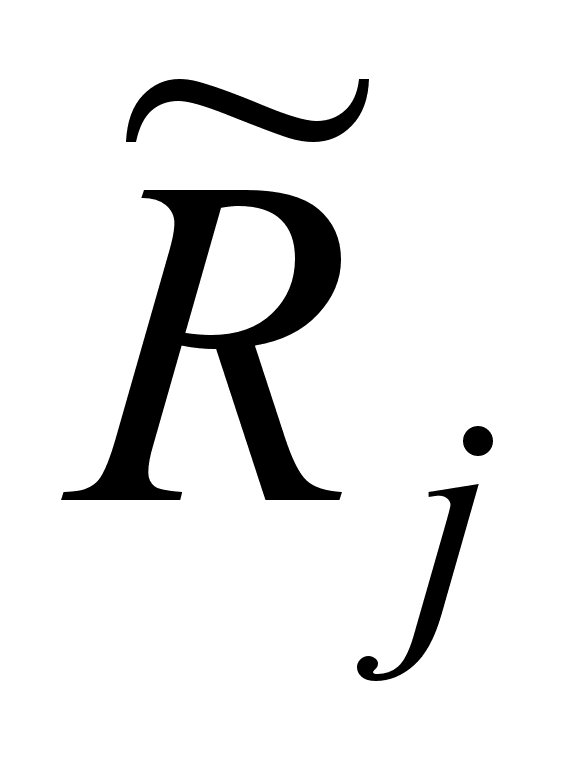 и
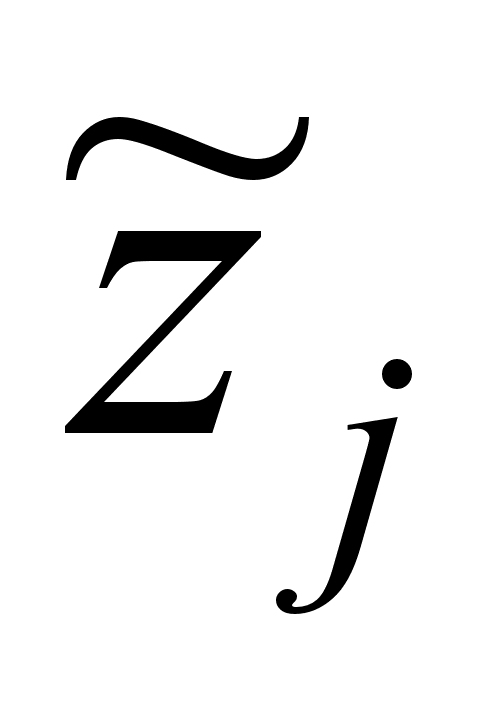 следующим
образом:
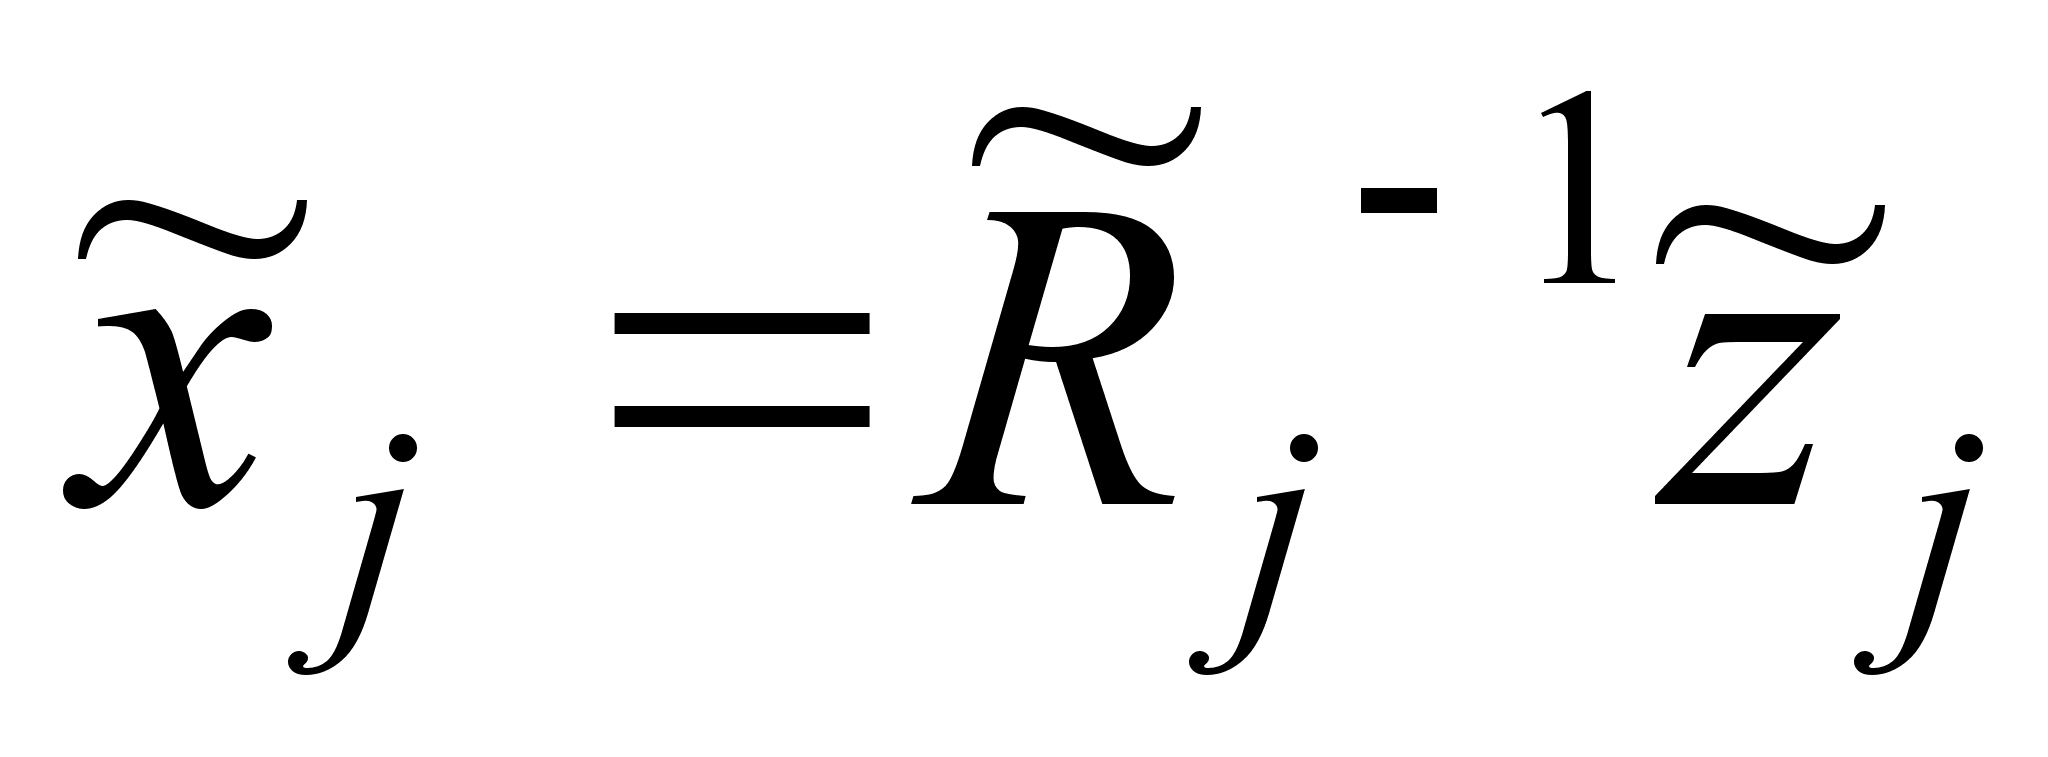 ;
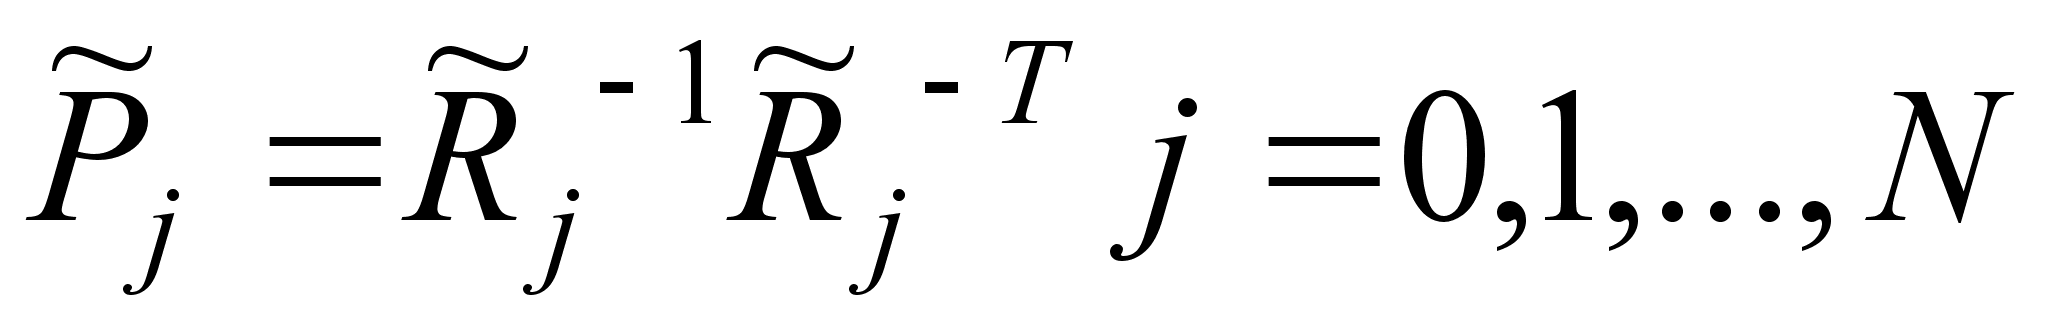 (1.4.3)
где
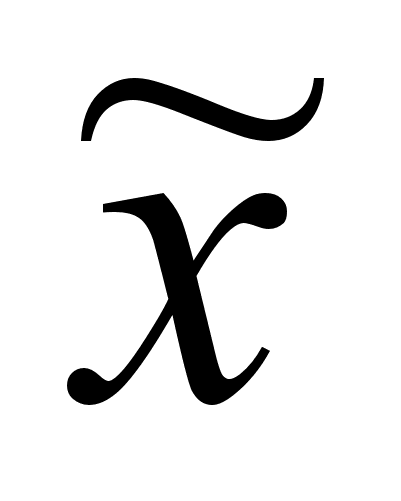 есть
экстраполяционная
оценка вектора
состояния, а
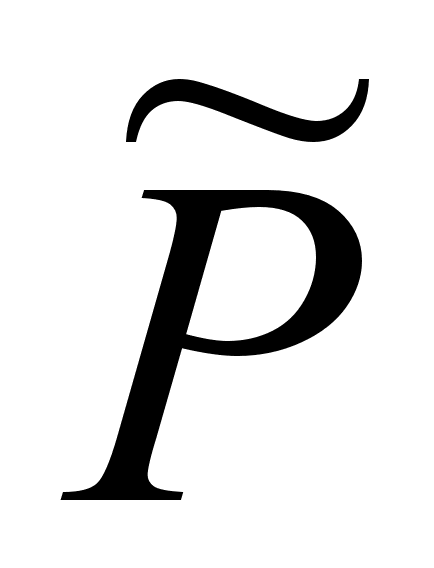 -
матрица ковариации
ошибки экстраполяционной
оценки.
Замечание: Для
отфильтрованной
оценки и ее
матрицы ковариаций
связь с информационным
массивом
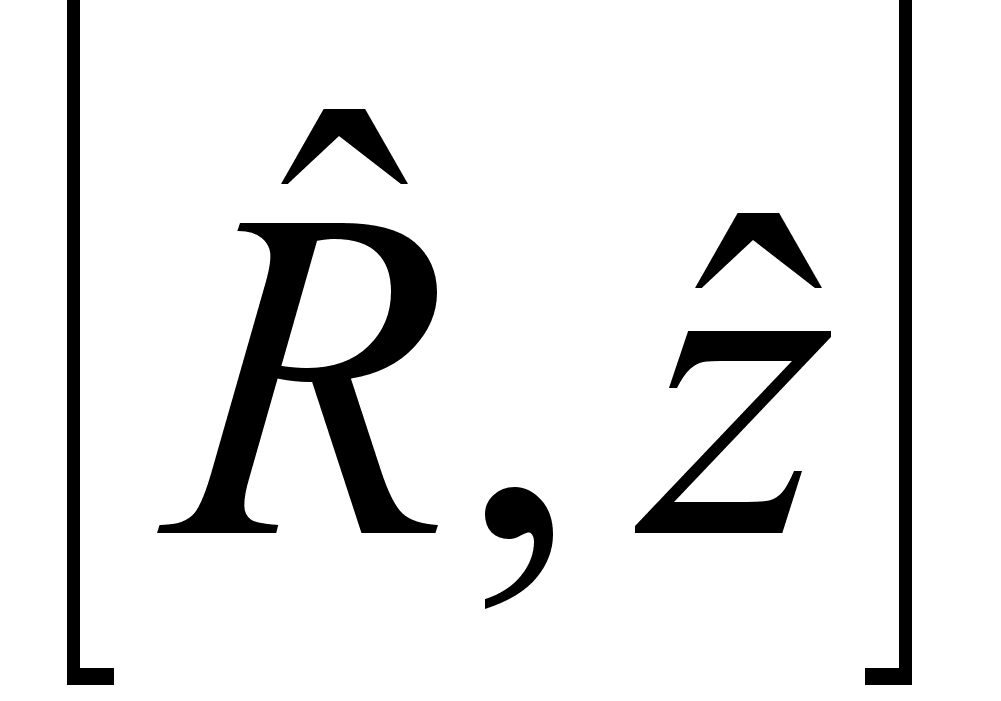 аналогична.
Предполагая,
что
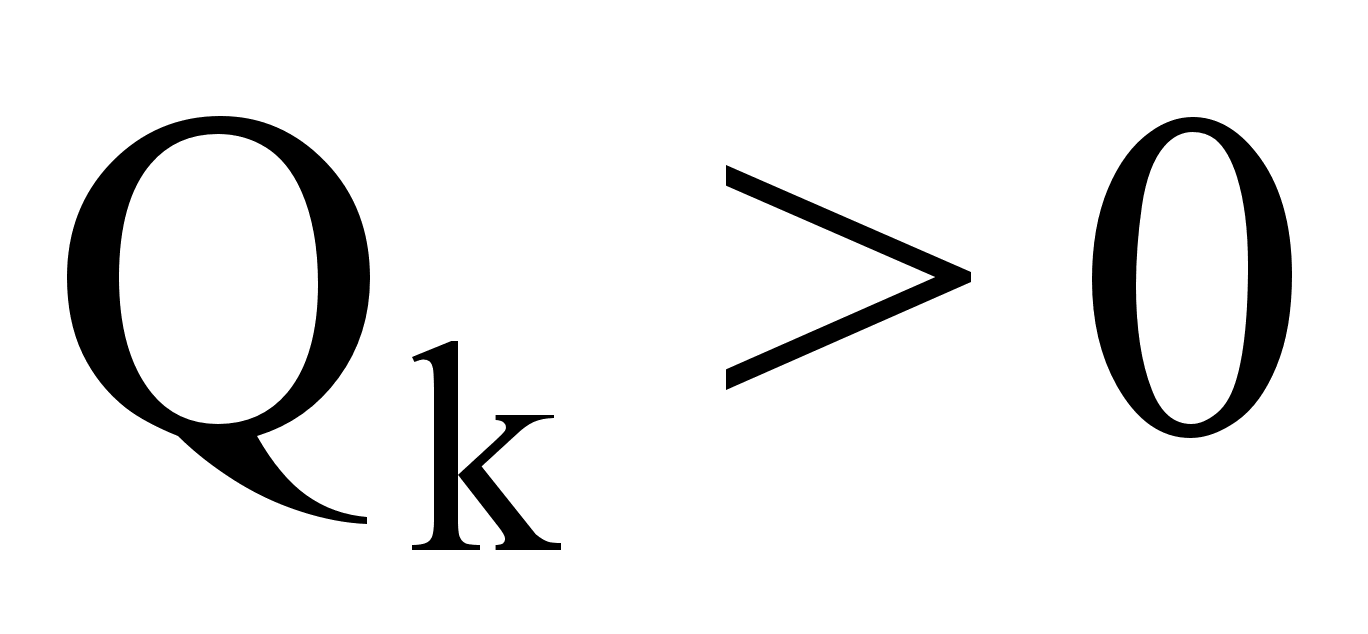 мы можем записать
следующее
равенство:
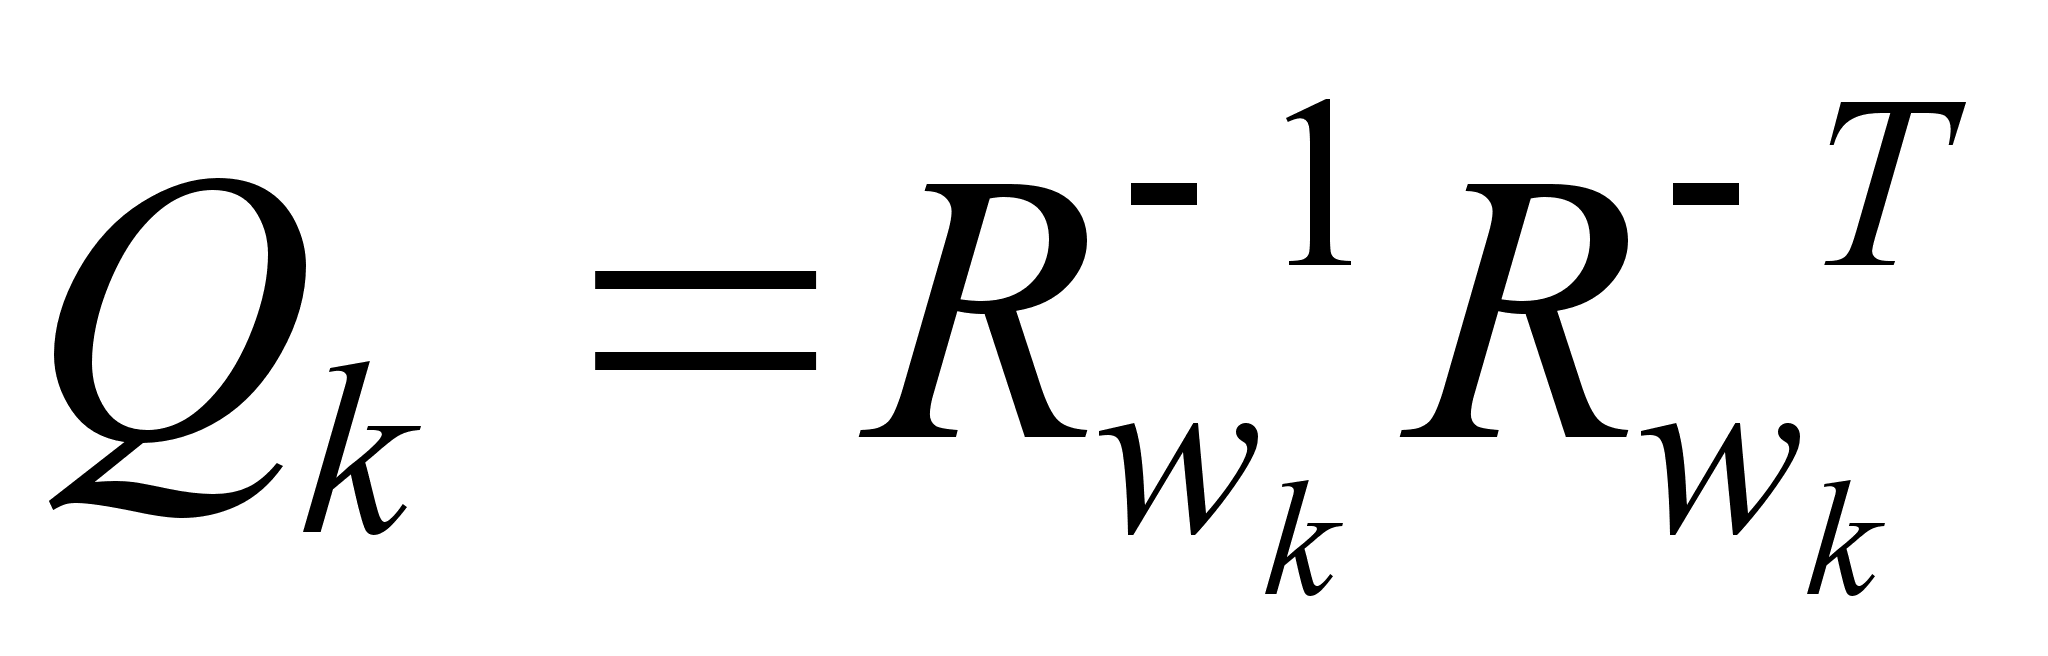 (1.4.4)
Тогда модель наблюдений и предсказания выглядит следующим образом:
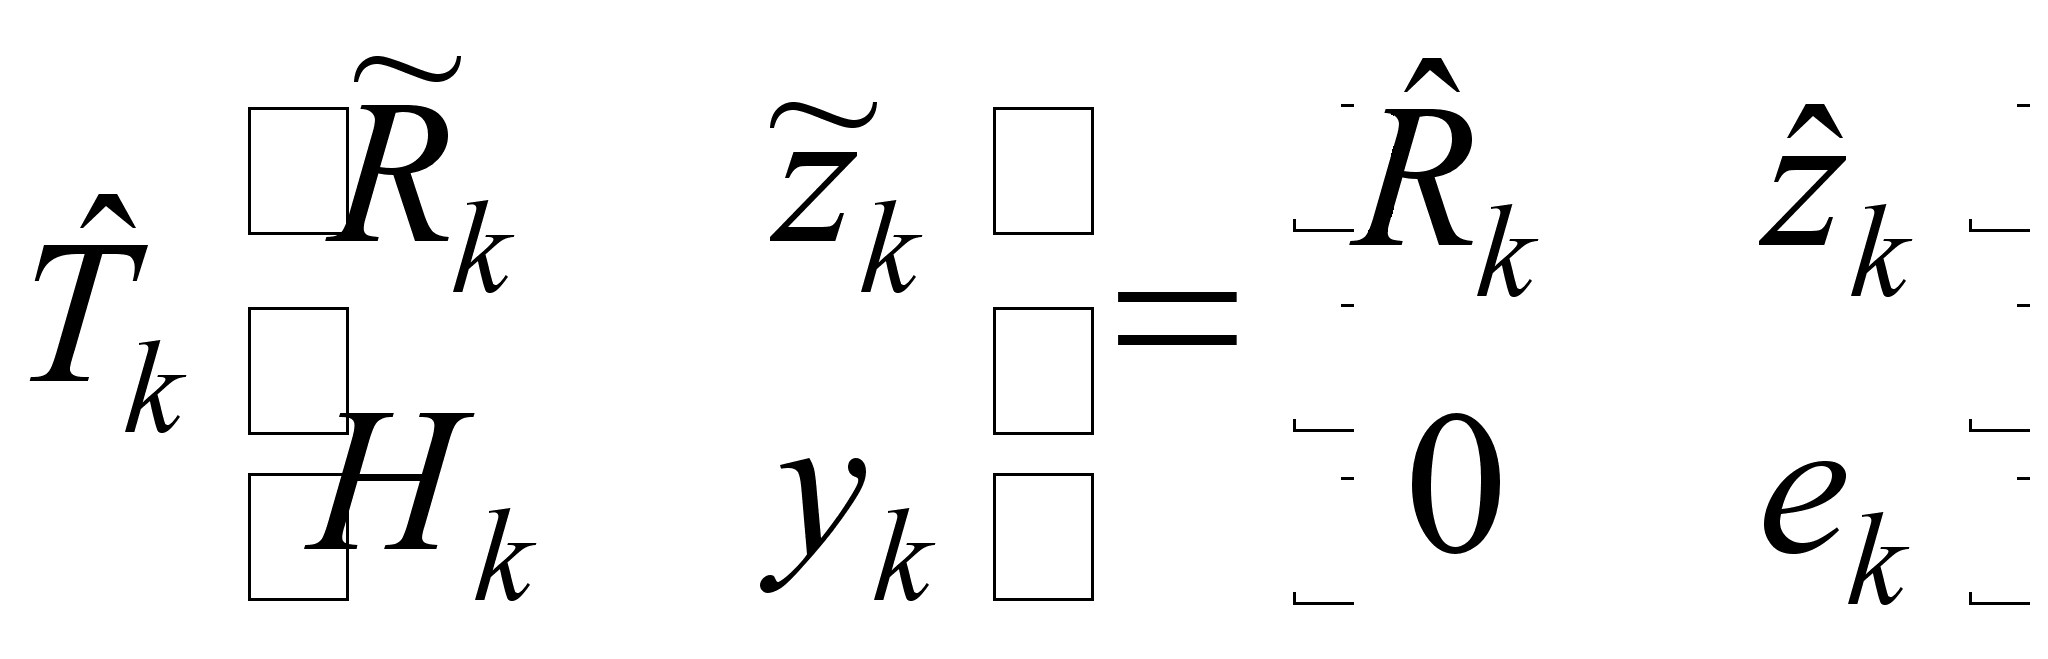 (1.4.5)
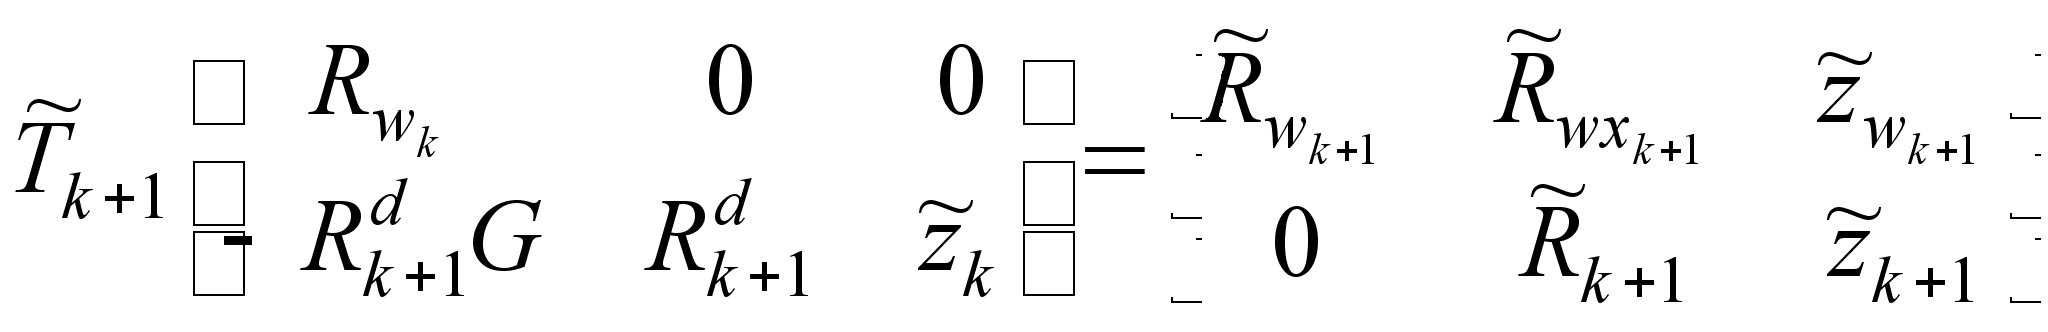 (1.4.6)
где
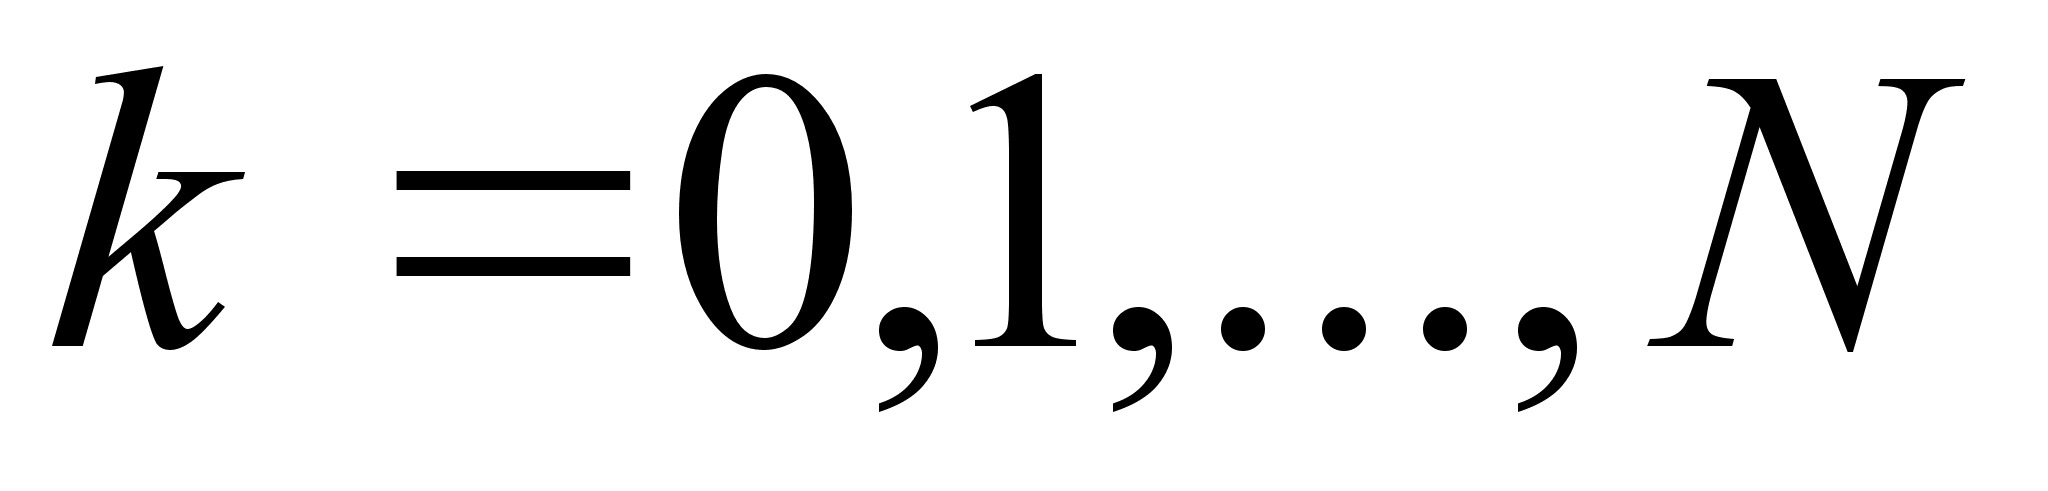 ,
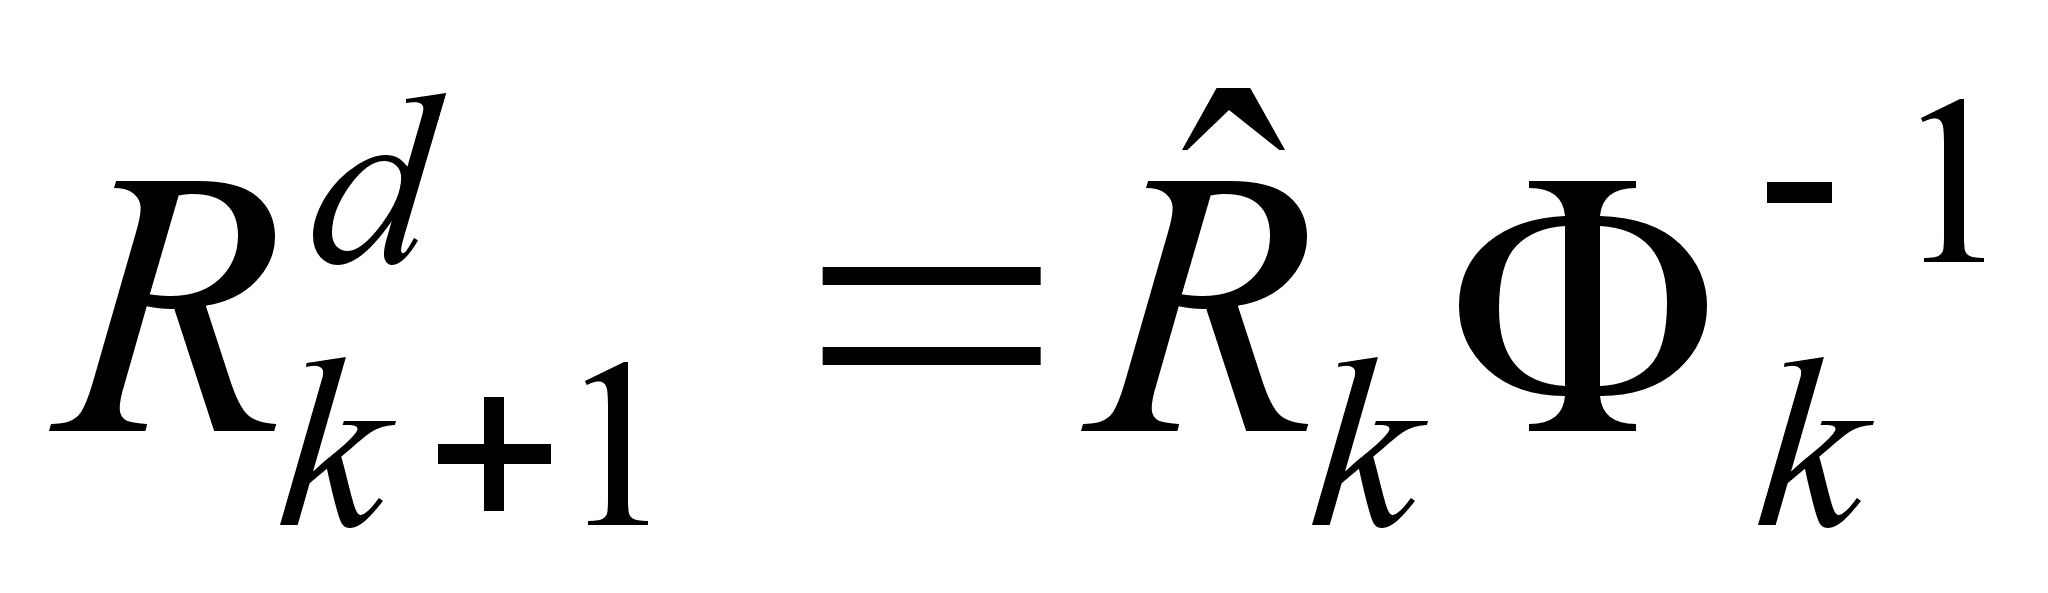 ,
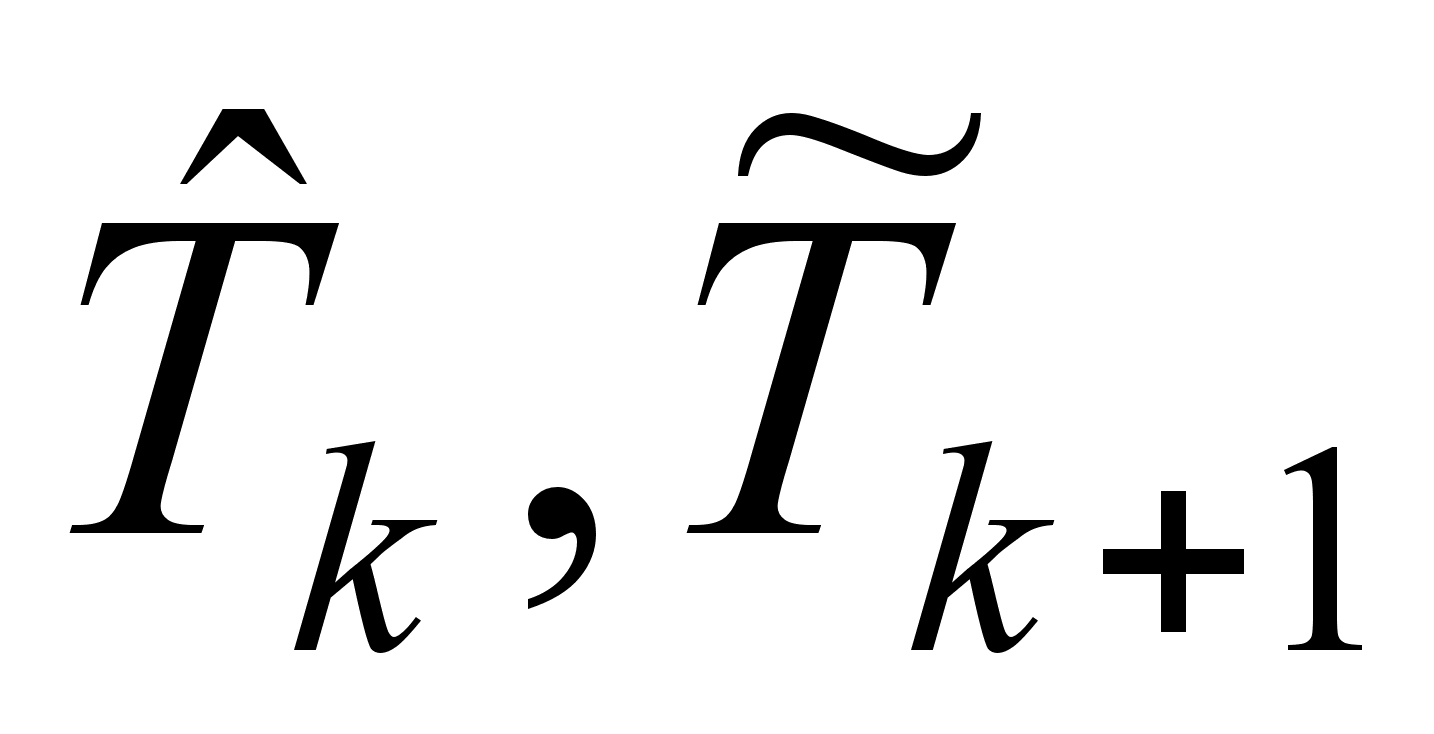 -
ортогональные
матрицы такие,
что матрицы
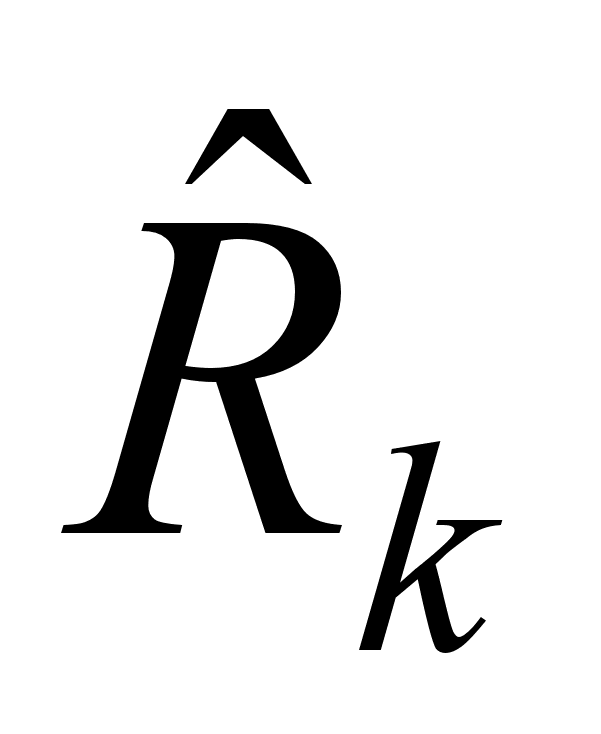 и
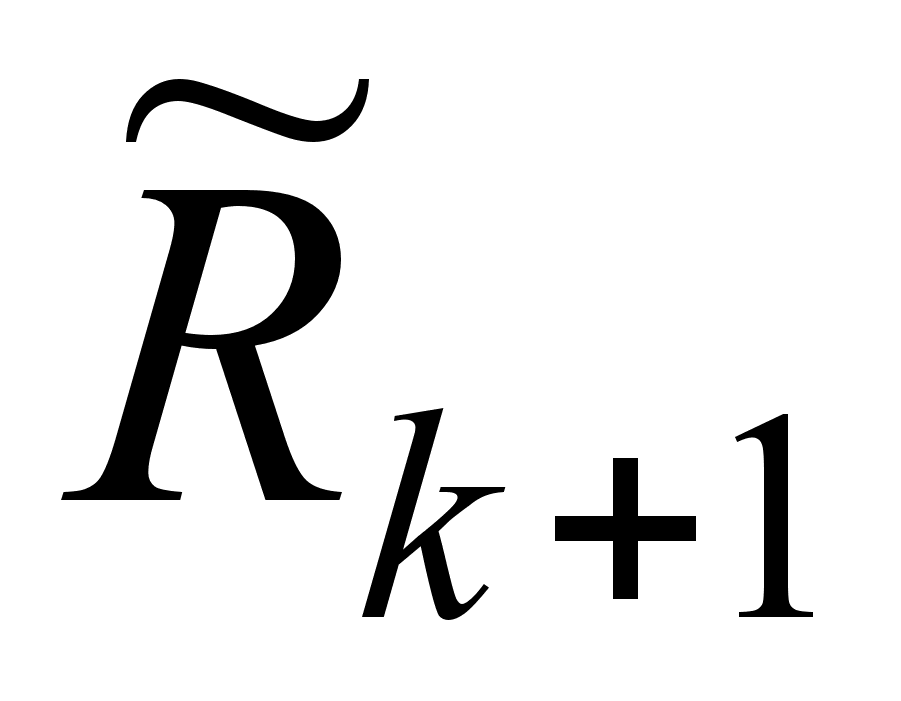 являются
верхнетреугольными,
а
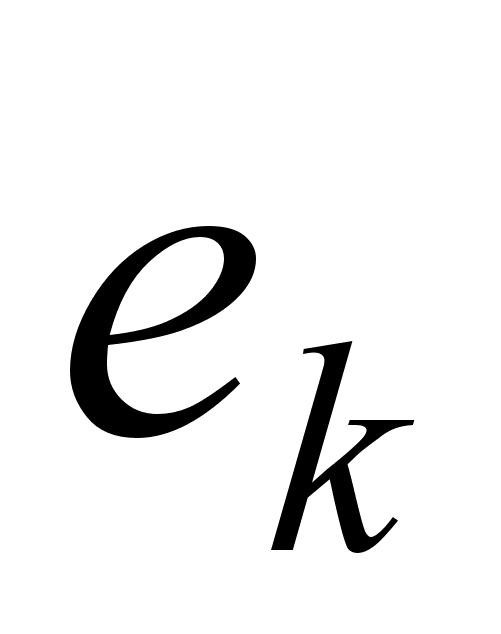 - остаточная
ошибка, соответствующая
решению наименьших
квадратов.
Заметим, что уравнения (1.4.5) и (1.4.6) эквивалентны уравнениям фильтра Калмана (доказательство данного факта см. в [2]). Но в отличие от традиционного фильтра Калмана, ККИФ позволяет избежать численной неустойчивости, являющейся результатом вычислительных погрешностей, поскольку вместо матриц ковариаций ошибки оценок на этапах экстраполяции и обработки измерений, по своей природе положительно определенных, ККИФ оперирует с их квадратными корнями. А это значит, что вычисления квадратного корня равносильно счету с двойной точностью для ковариации ошибок и кроме того устраняется опасность утраты матрицей ковариаций свойства положительно определенности. Недостатком данного метода является присутствие операций извлечения квадратного корня.
2. Оценивание параметров по методу максимального правдоподобия с использованием квадратно-корневых информационных фильтров
Вычисление оценки максимального правдоподобия может быть итеративно выполнено при помощи характеристического уравнения, которое включает в себя градиент обратного логарифма функции правдоподобия и информационную матрицу Фишера. Вычисления функции правдоподобия и информационной матрицы Фишера требуют применения фильтра Калмана (а также его производных для каждого параметра оценивания), который, как известно, не обладает достаточной устойчивостью. Поэтому для вычисления оценки максимального правдоподобия итеративным образом будем использовать ККИФ.
2.1. Постановка задачи
Пусть динамическая система с дискретным временем дана в следующем виде:
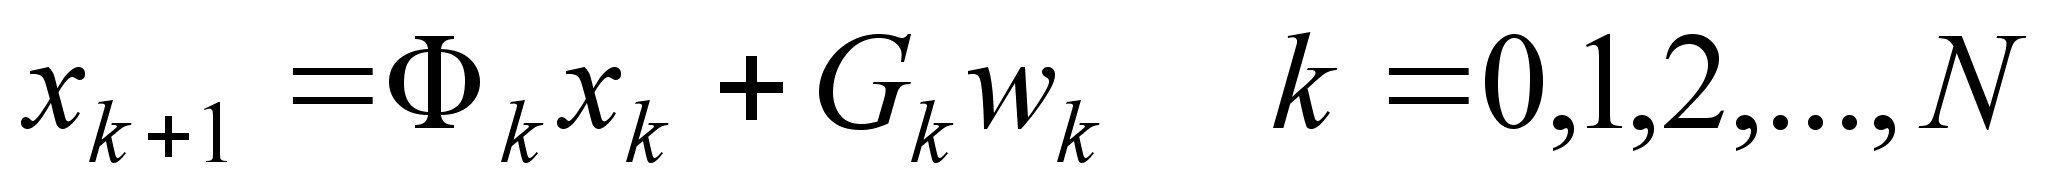 (2.1.1)
где вектор
состояния
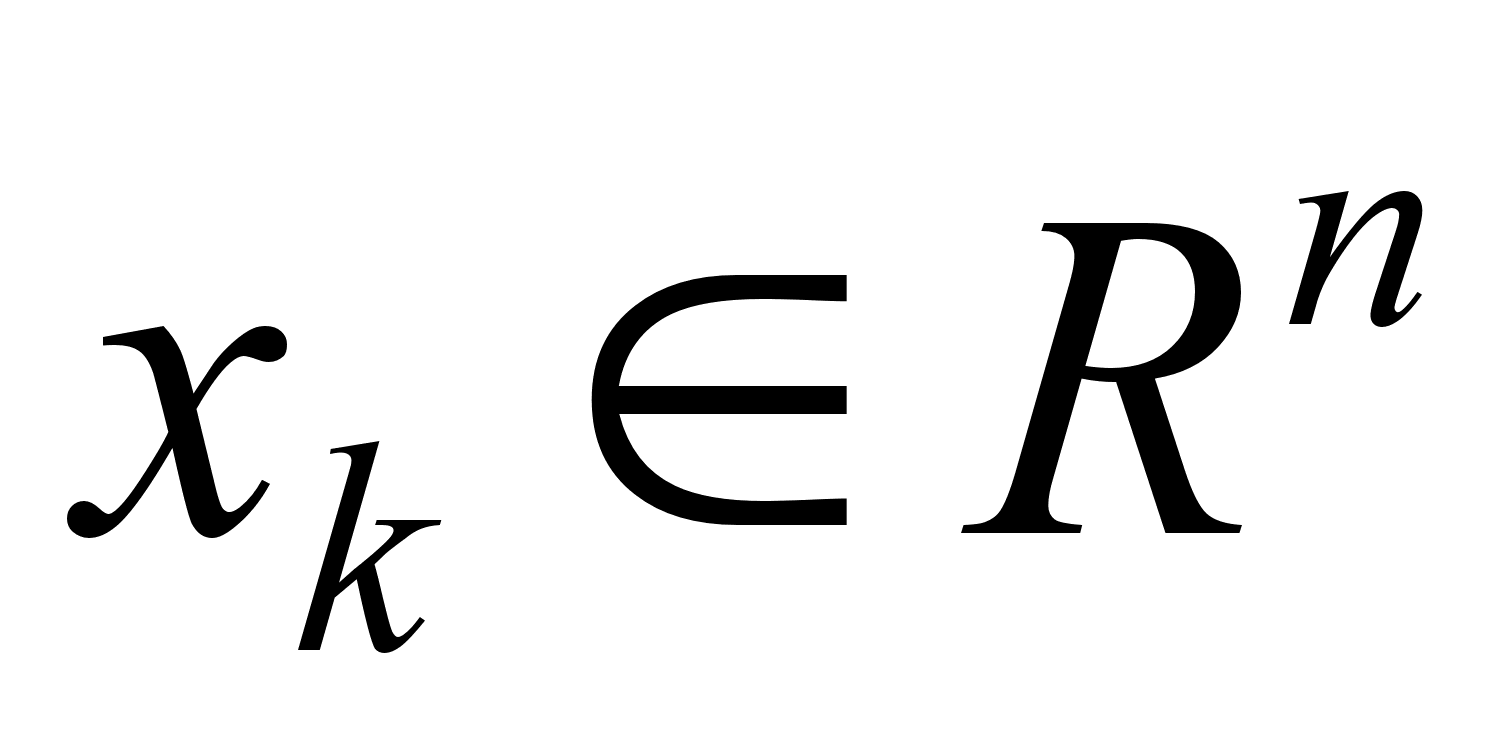 ,
матрица переходов
из состояния
в состояние
,
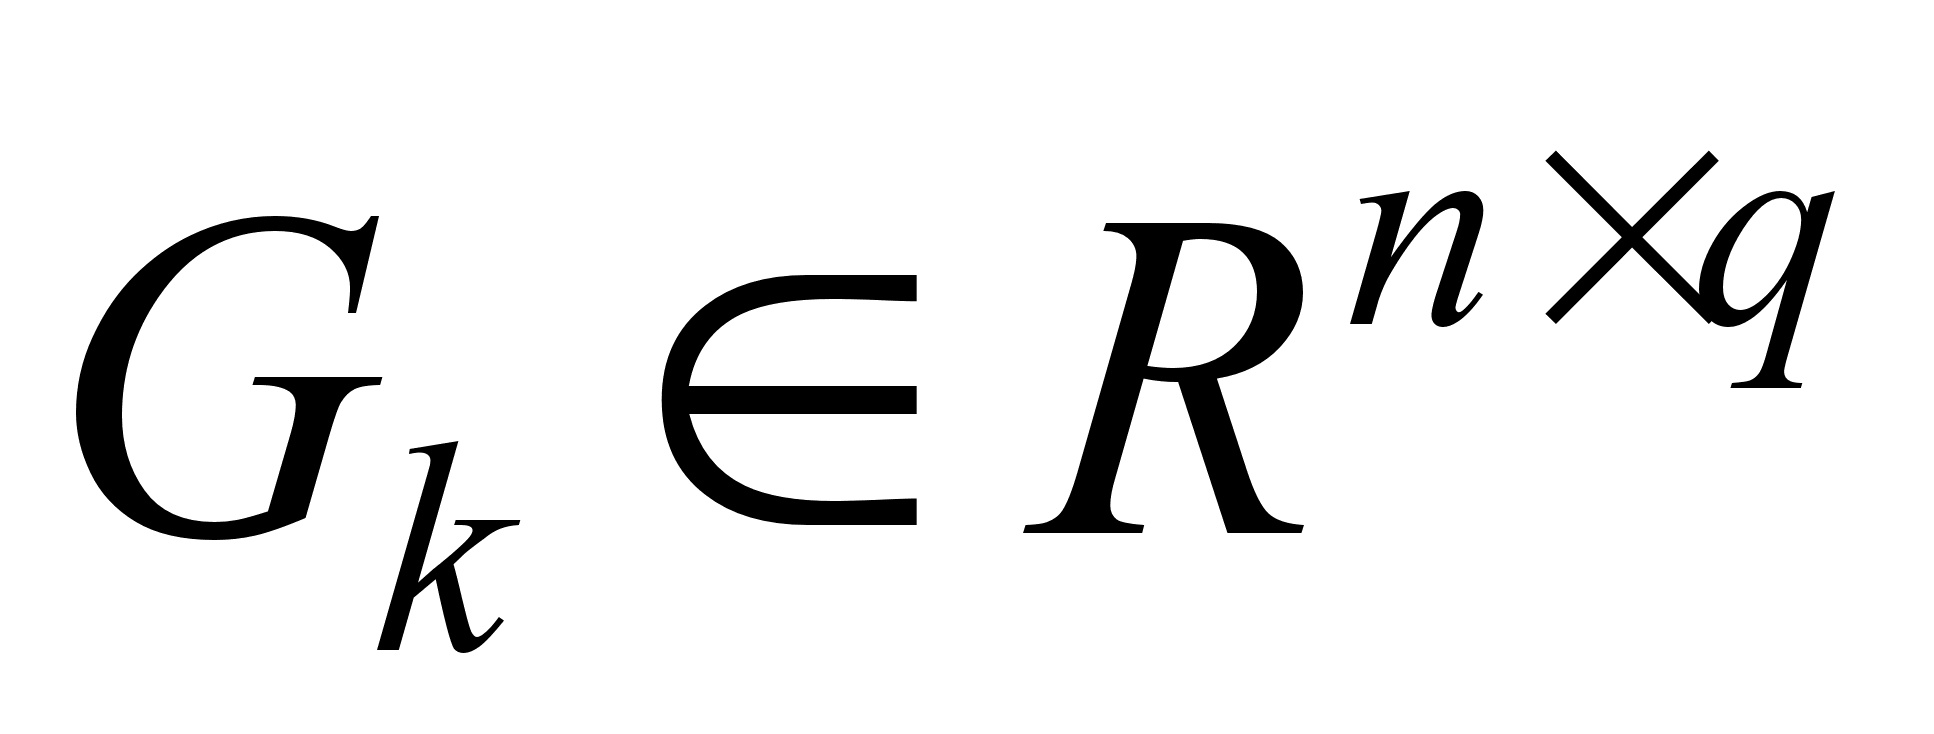 и
-
случайный
процесс, представляющий
собой белый
гауссовый шум
с нулевым средним
и ковариацией
,
т.е.
.
Пусть множество
наблюдений
задается уравнением:
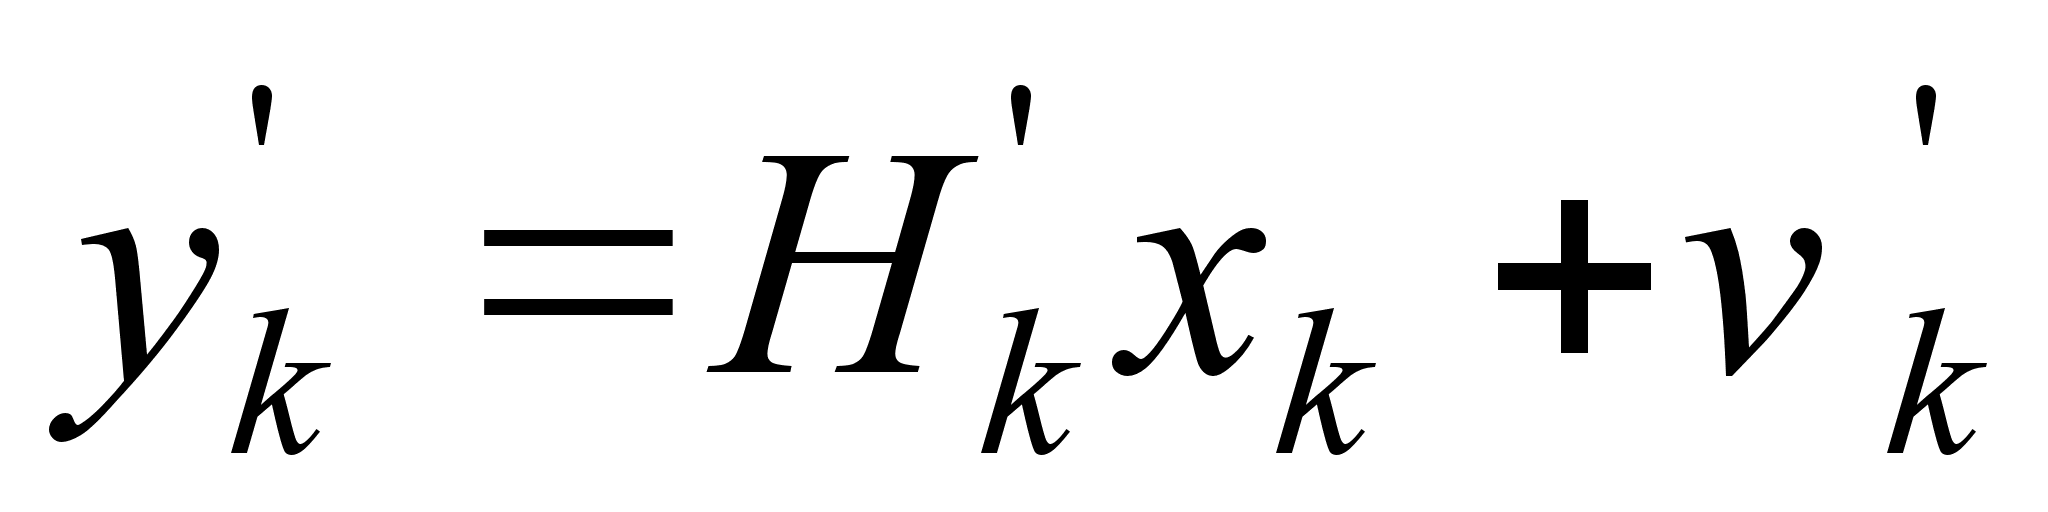 (2.1.2)
где вектор
наблюдения
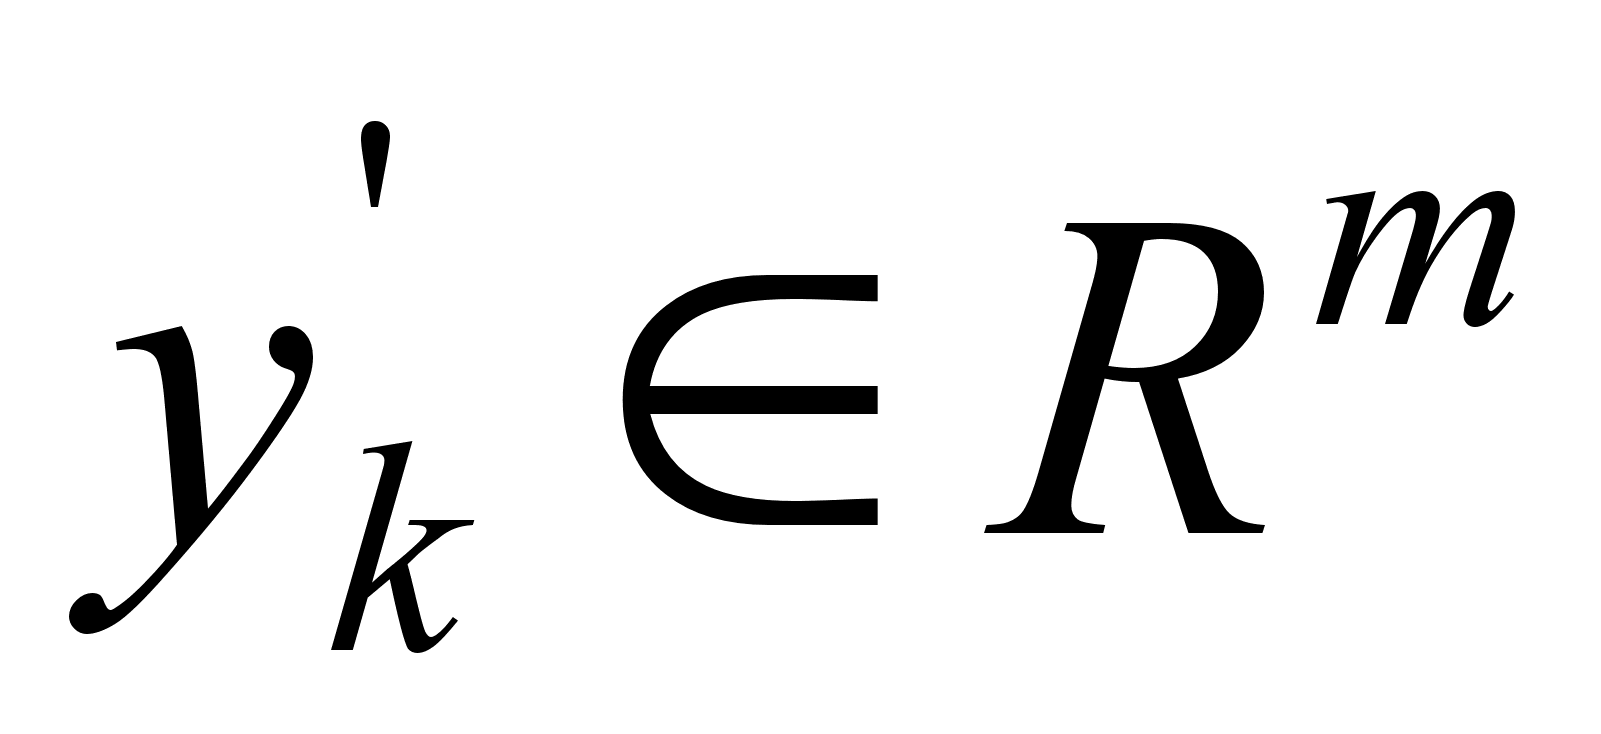 ,
матрица наблюдений
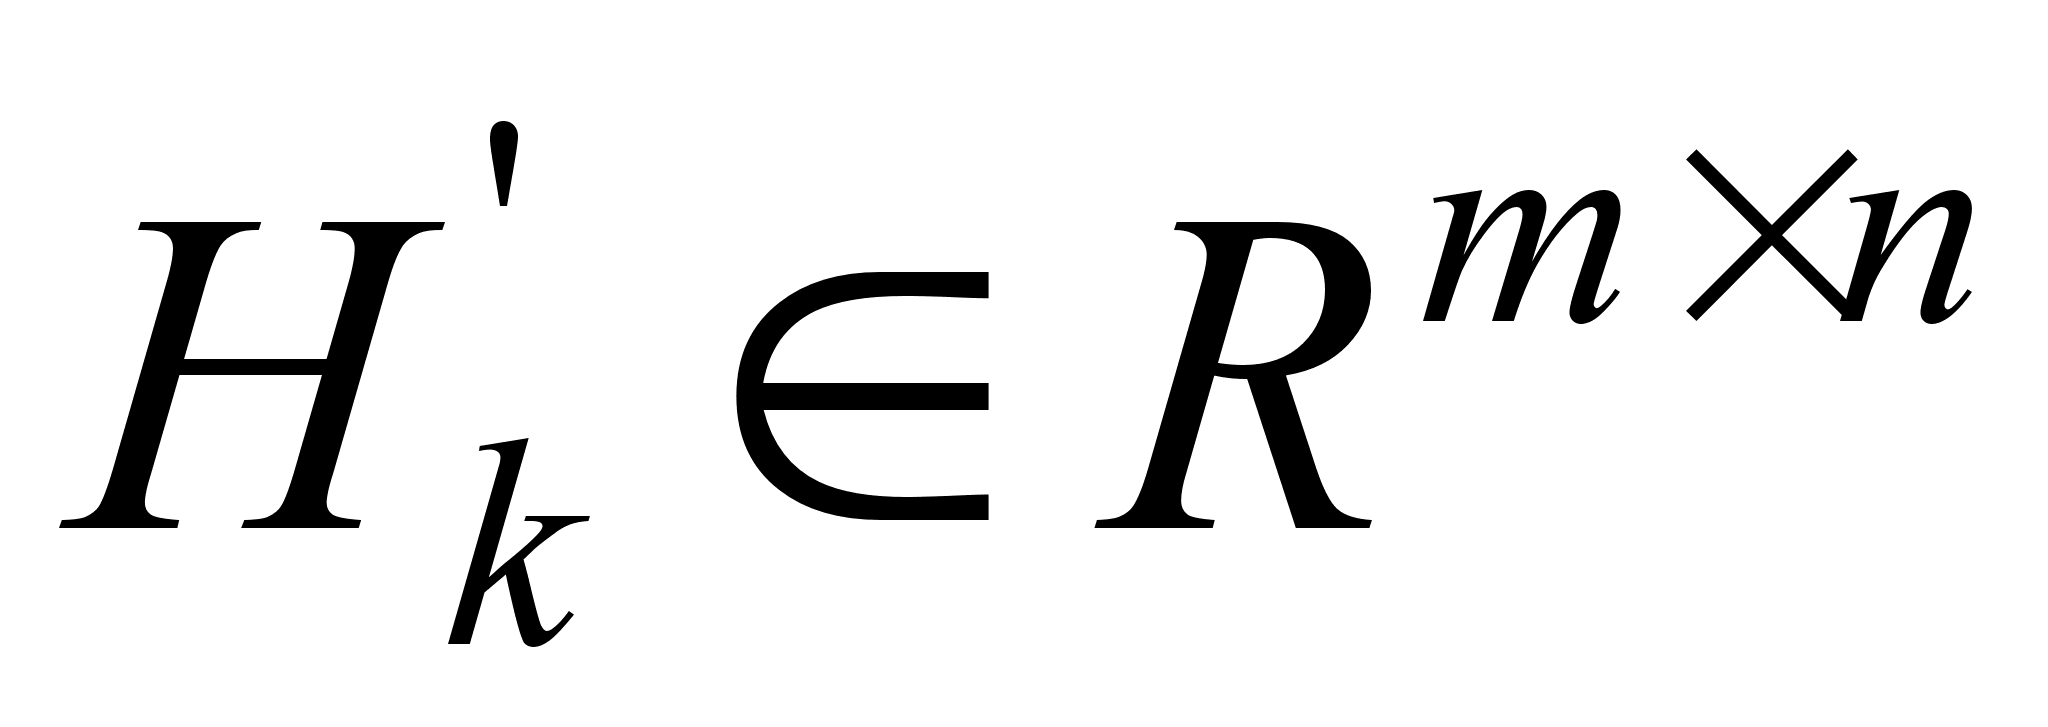 ,
и
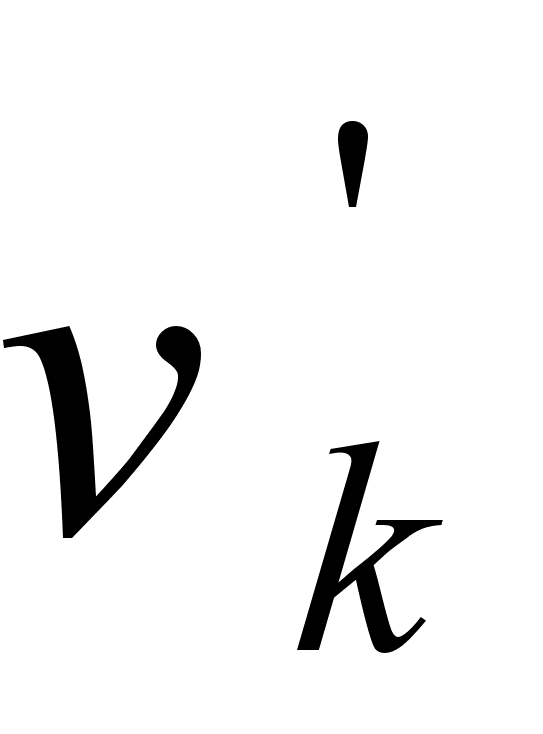 -
шум:
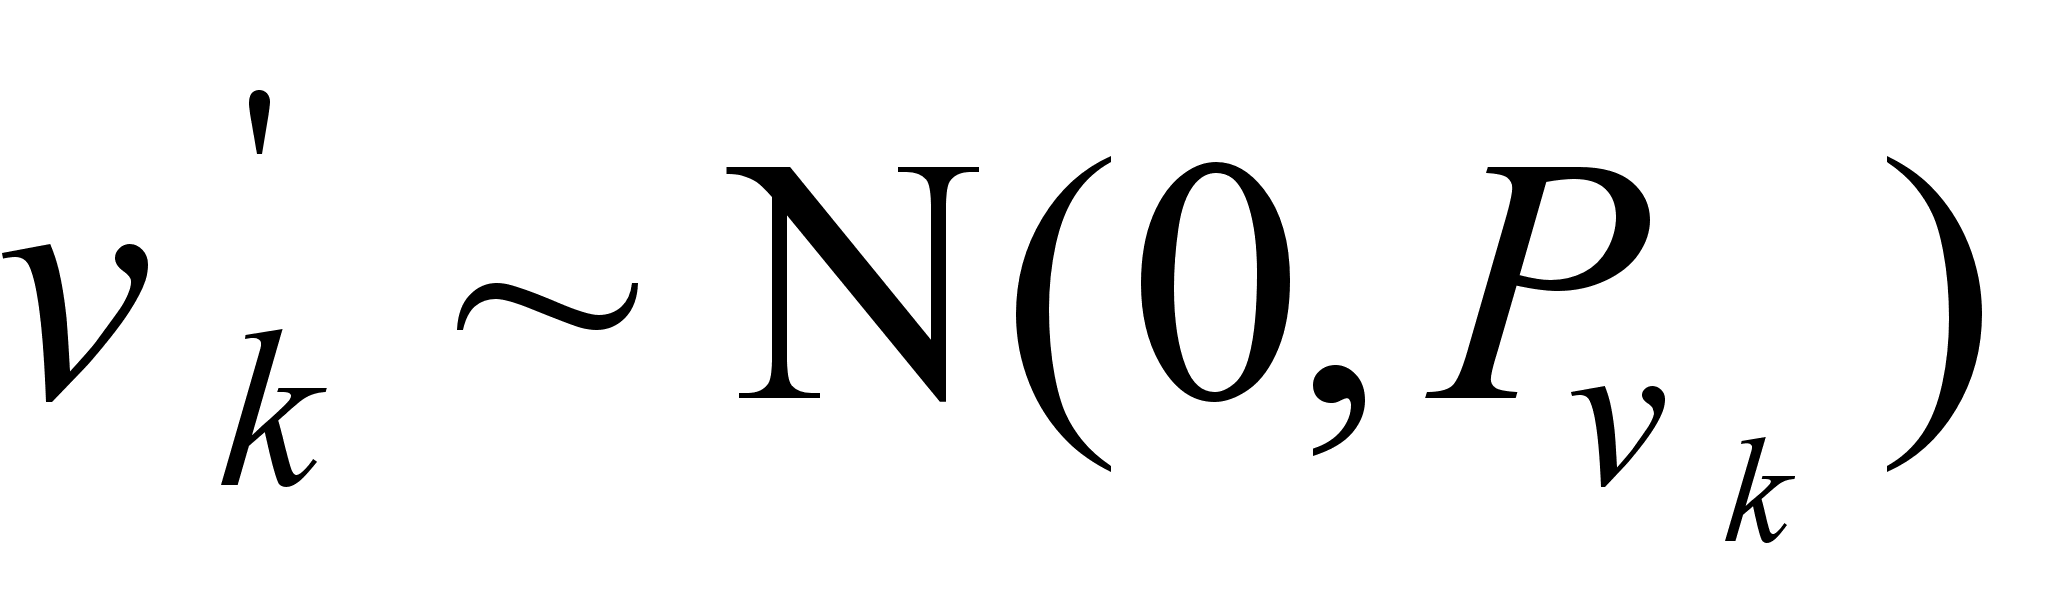 .
Пусть также,
матрицы
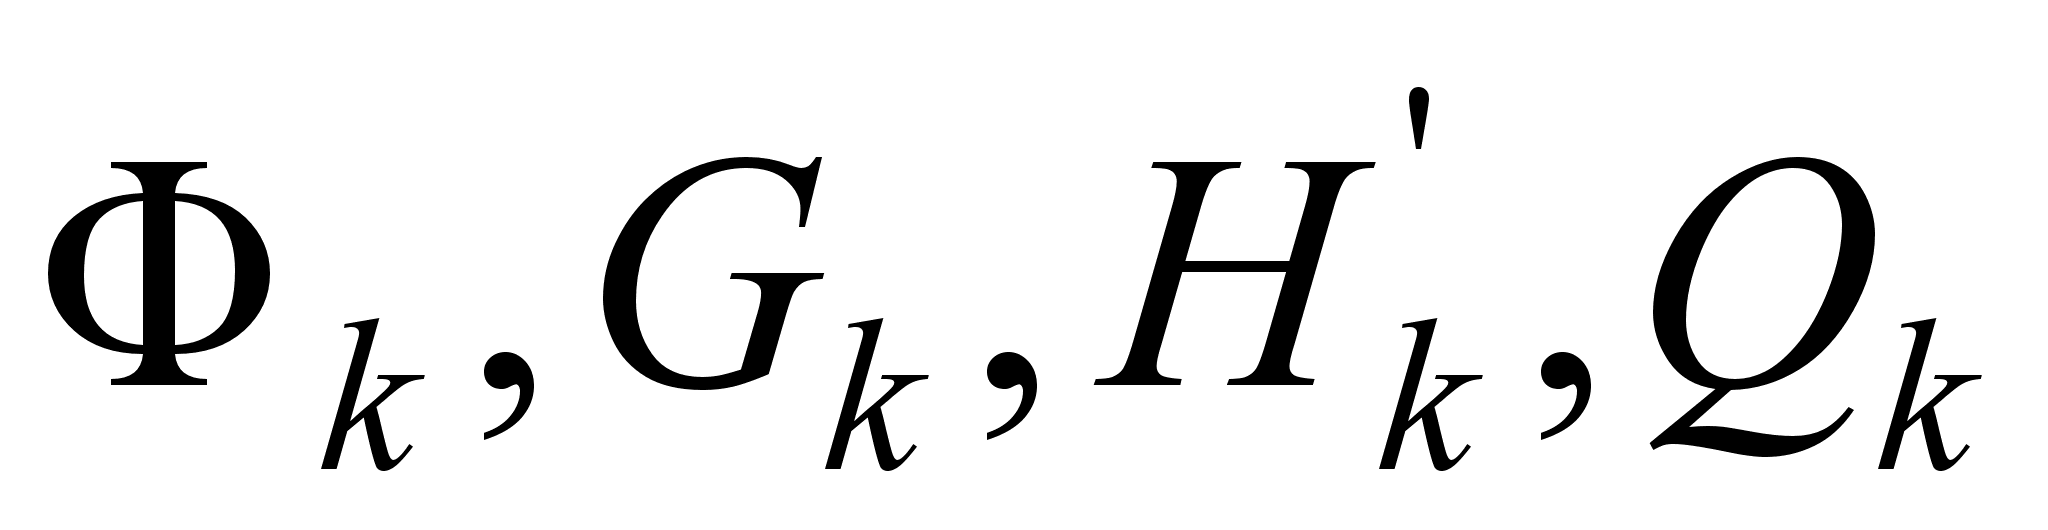 и
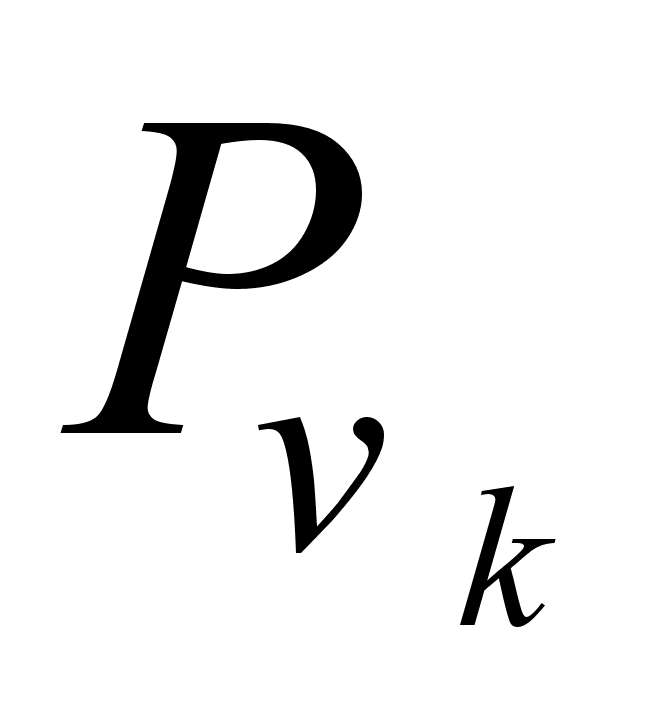 являются функциями
неизвестного
векторного
параметра
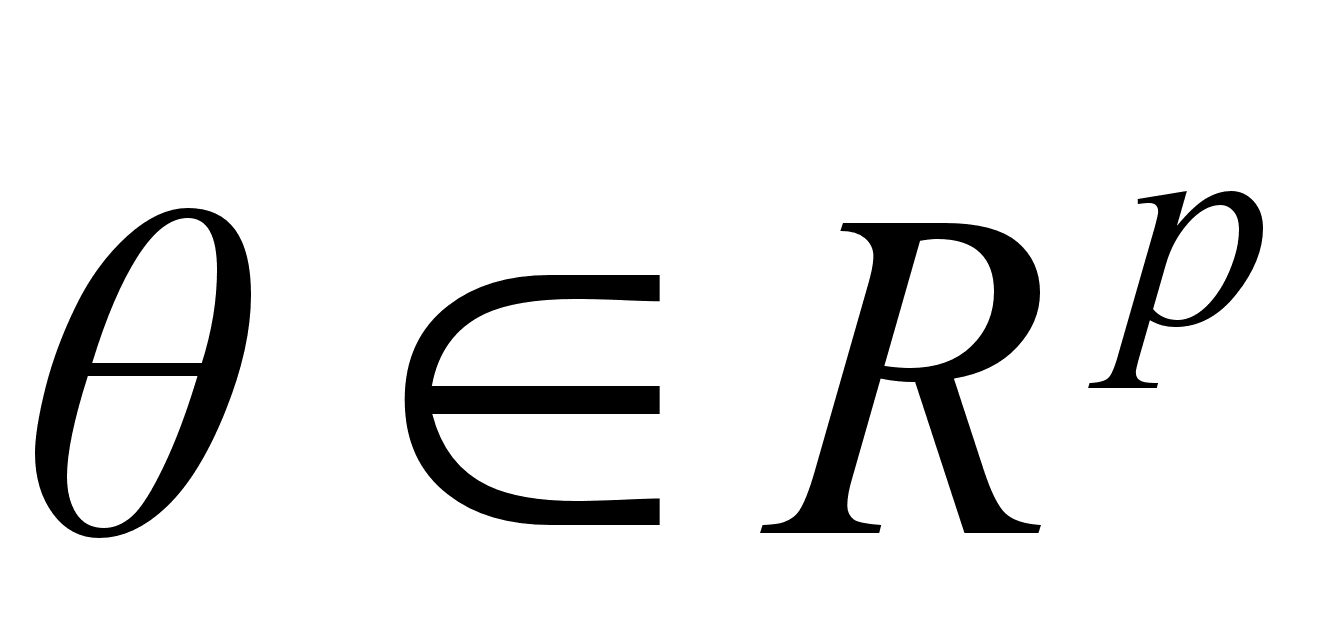 .
Оценкой максимального
правдоподобия
является такое
значение оцениваемых
параметров
,
которое максимизирует
вероятность
события, при
котором наблюдения,
сгенерированные
с подстановкой
оцениваемых
параметров,
совпадают с
действительными
значениями
наблюдений
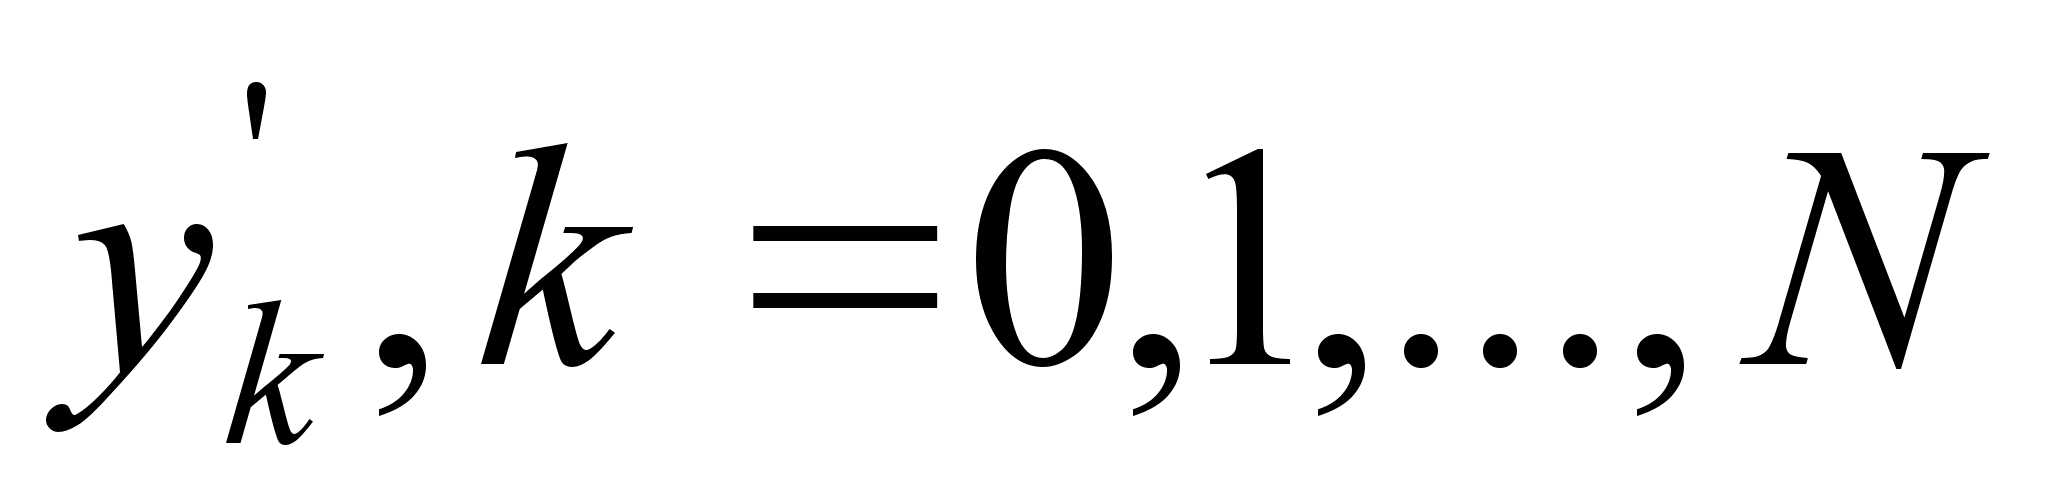 .
Эта процедура
эквивалентна
минимизации
обратного
логарифма
функции плотности
условной вероятности,
т.е. обратный
логарифм функции
правдоподобия
представляется
как:
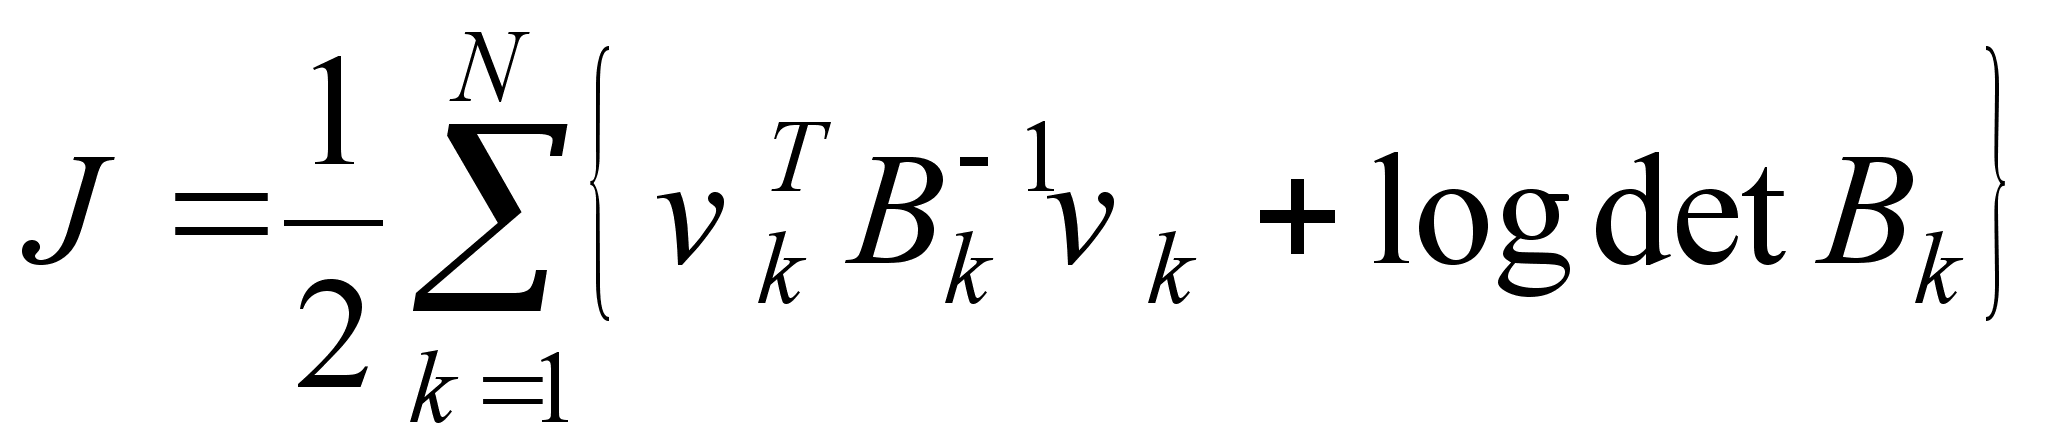 (2.1.3)
где
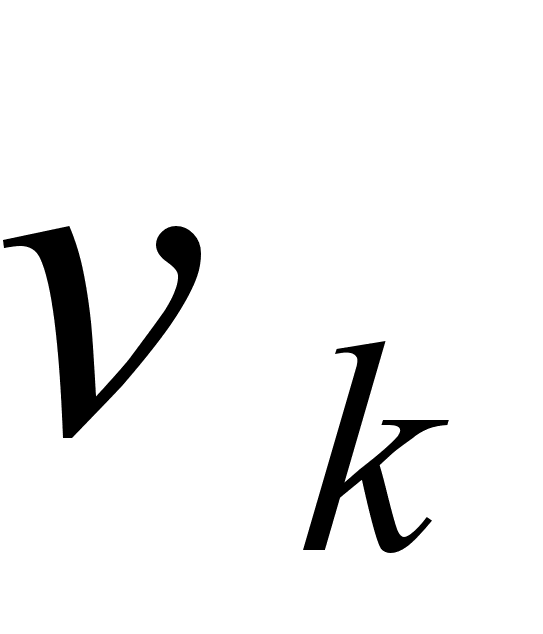 и
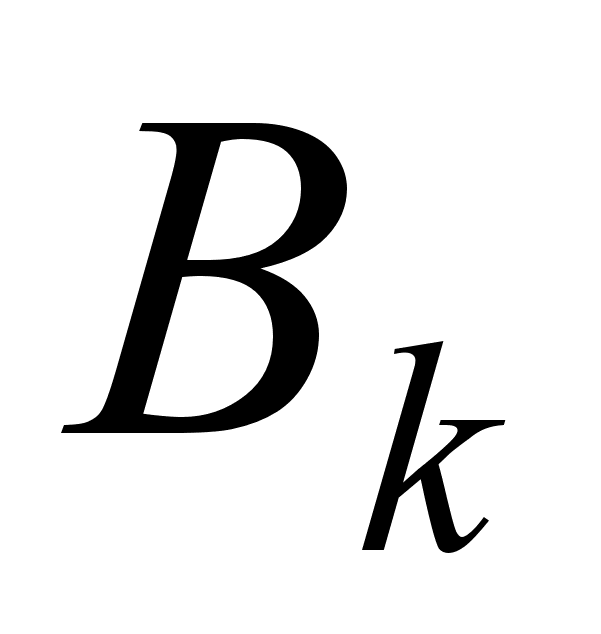 -
вычисляются
согласно схеме
фильтра Калмана
следующим
образом:
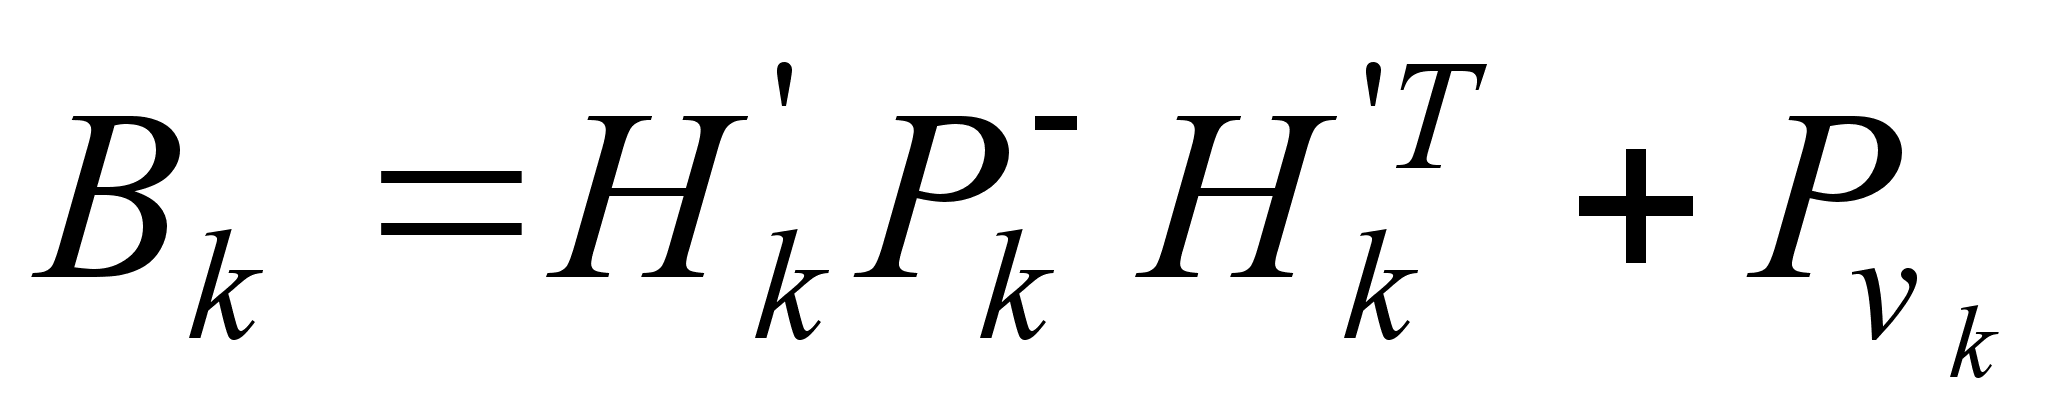 (2.1.4)
где
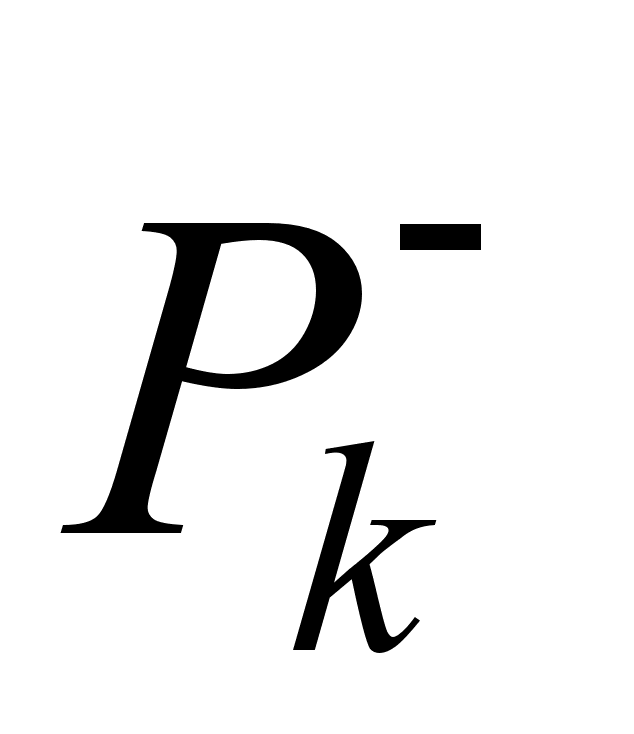 есть ковариационная
матрица ошибки
экстраполяционной
оценки.
Запишем другие характеристики фильтра Калмана, которые нам понадобятся в дальнейшем:
Матрица Калмана:
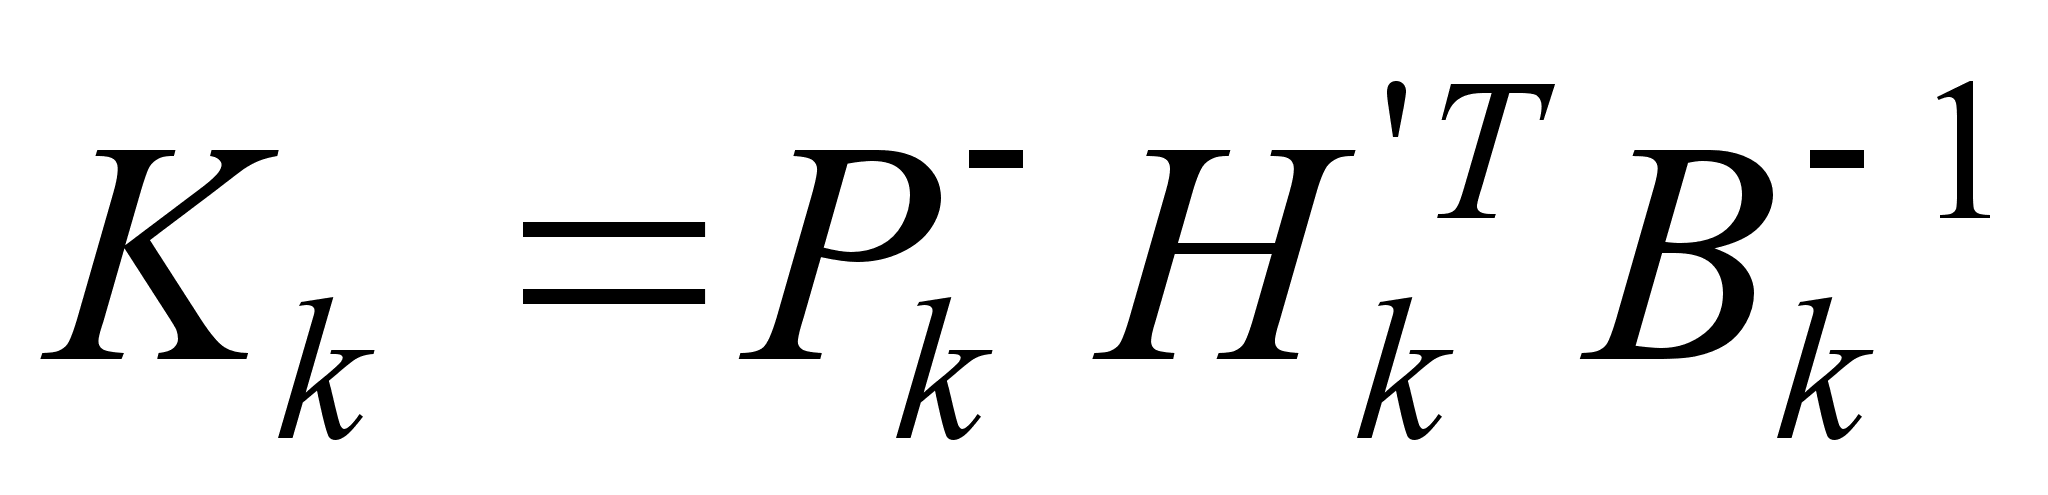 (2.1.5)
Матрица ковариаций измененной по последним данным ошибки:
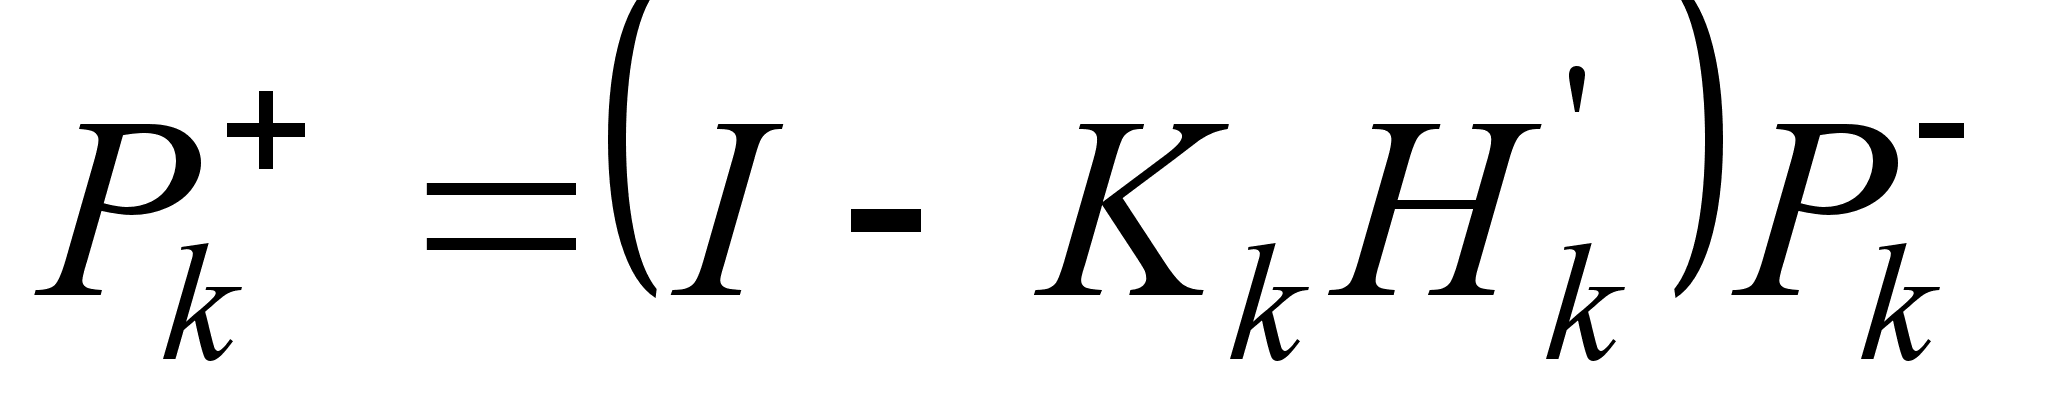 (2.1.6)
Невязка:
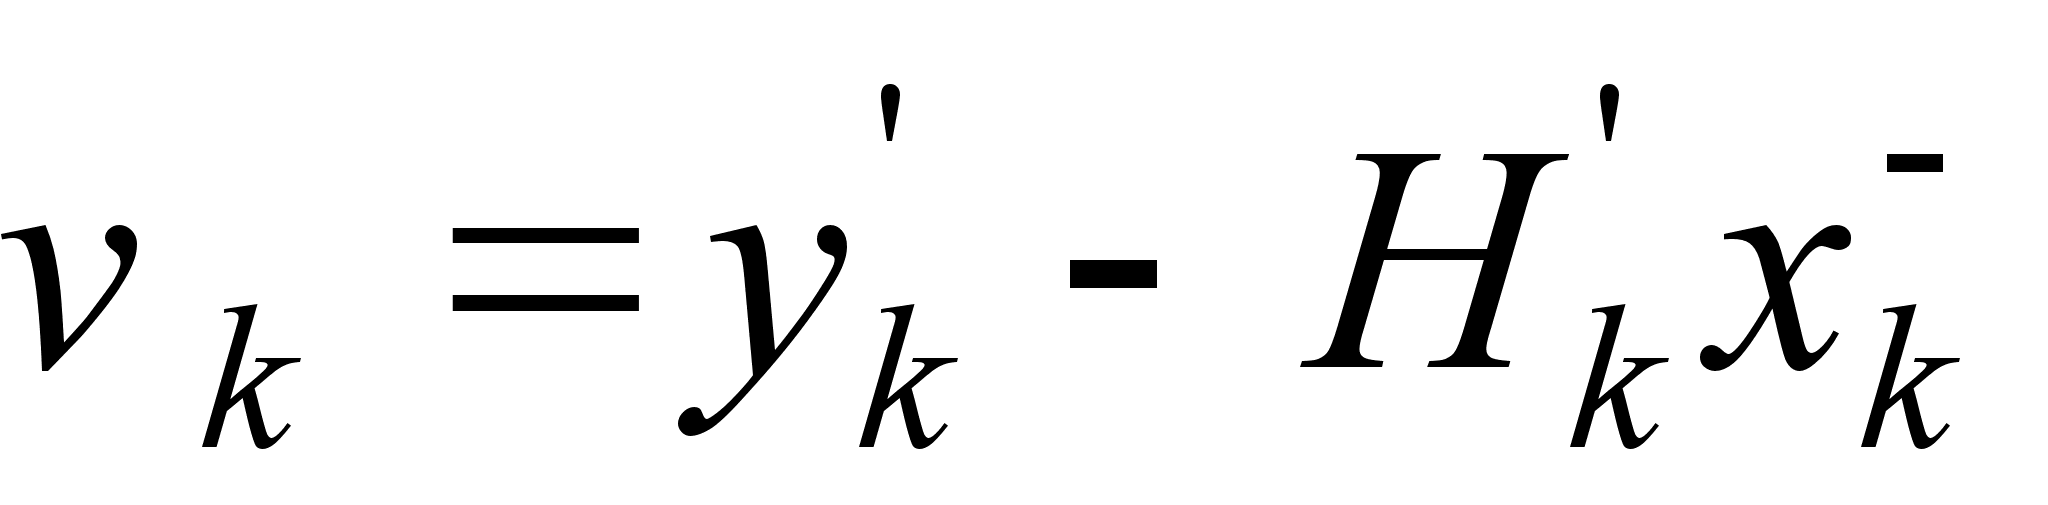 (2.1.7)
Измененная оценка:
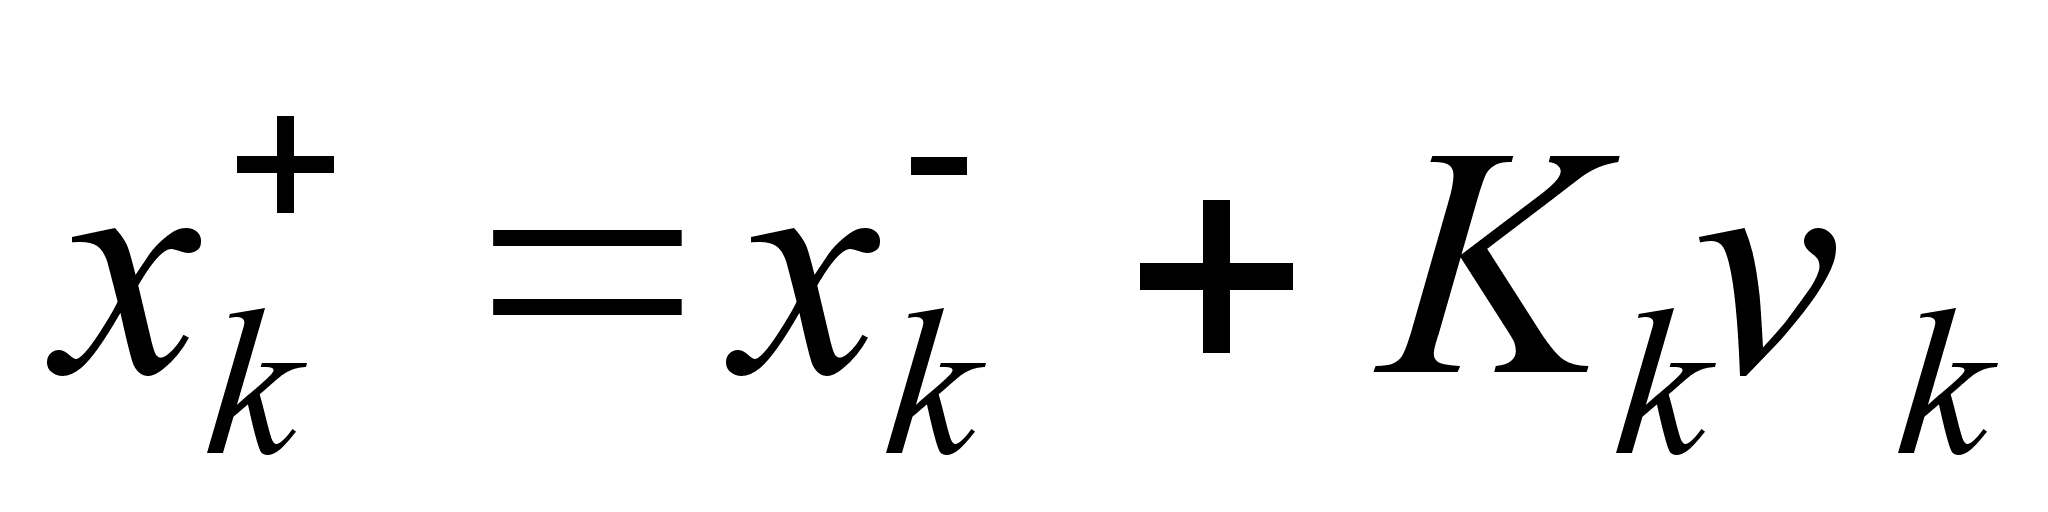 (2.1.8)
Вычисление оценки максимального правдоподобия может быть осуществлено итеративно по следующей формуле:
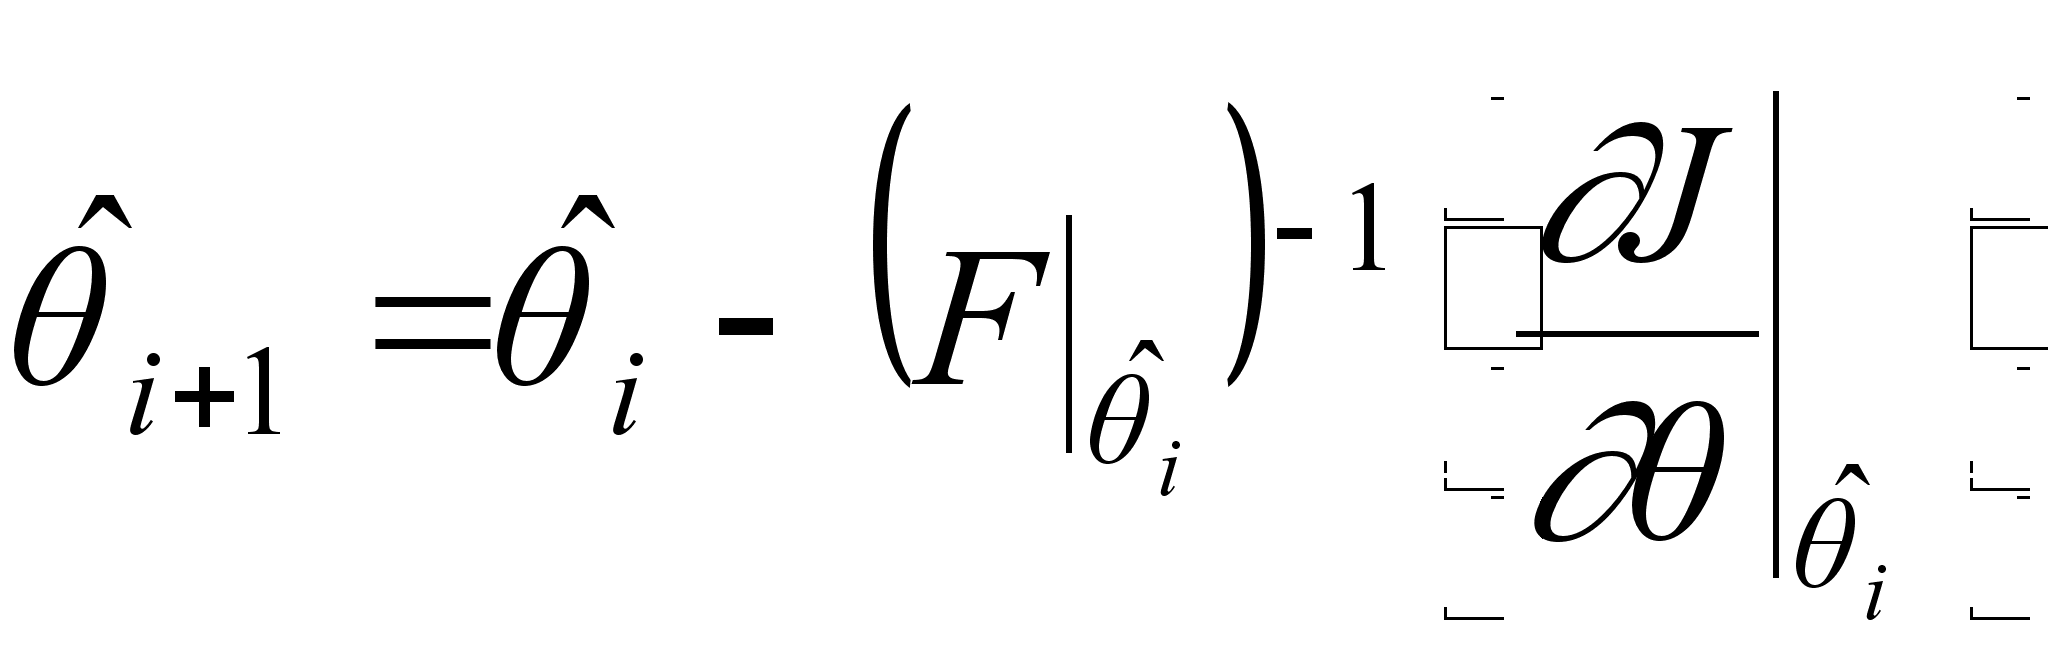 (2.1.9)
где
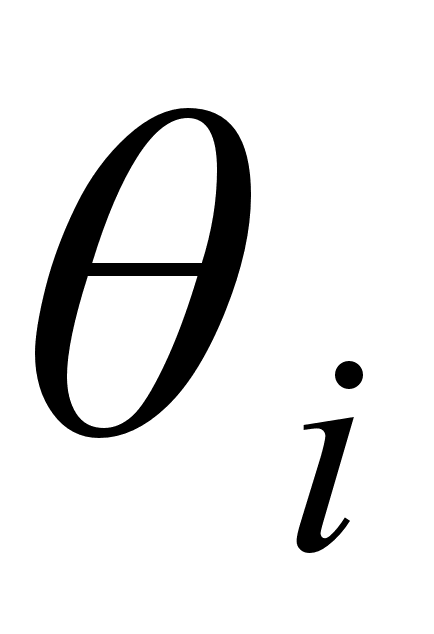 - оцениваемый
векторный
параметр;
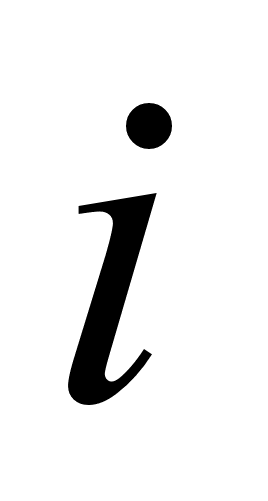 - индекс, определяющий
номер итерации;
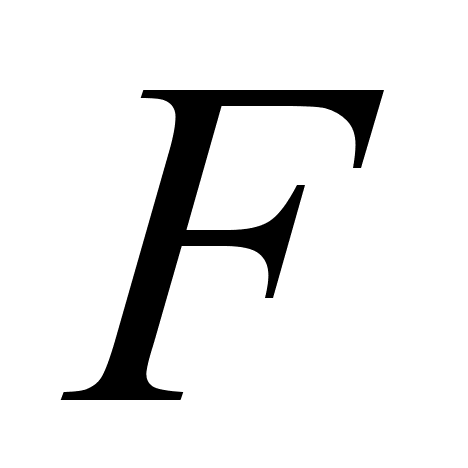 - информационная
матрица Фишера;
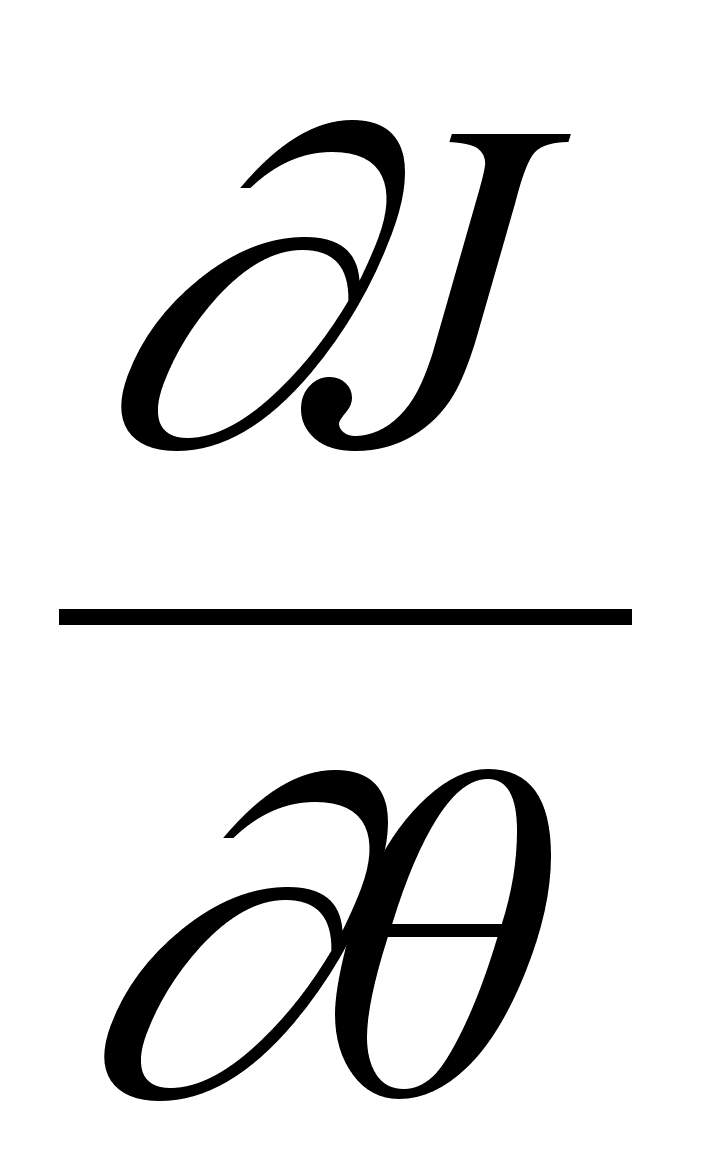 - градиент обратного
логарифма
функции максимального
правдоподобия.
Стоит заметить,
что итеративные
алгоритмы,
подобные (2.1.9), в
среднем сходятся
за меньшее
число шагов,
чем те алгоритмы,
которые включают
в себя только
вычисления
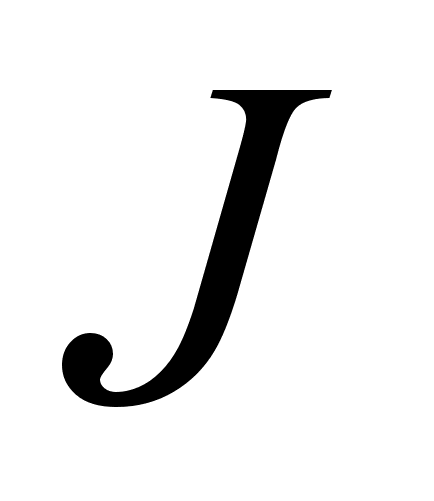 .
С другой стороны,
алгоритмы,
содержащие
и
,
требуют больше
вычислений
на каждом шаге.
Модель наблюдений, в случае ККИФ, выглядит следующим образом:
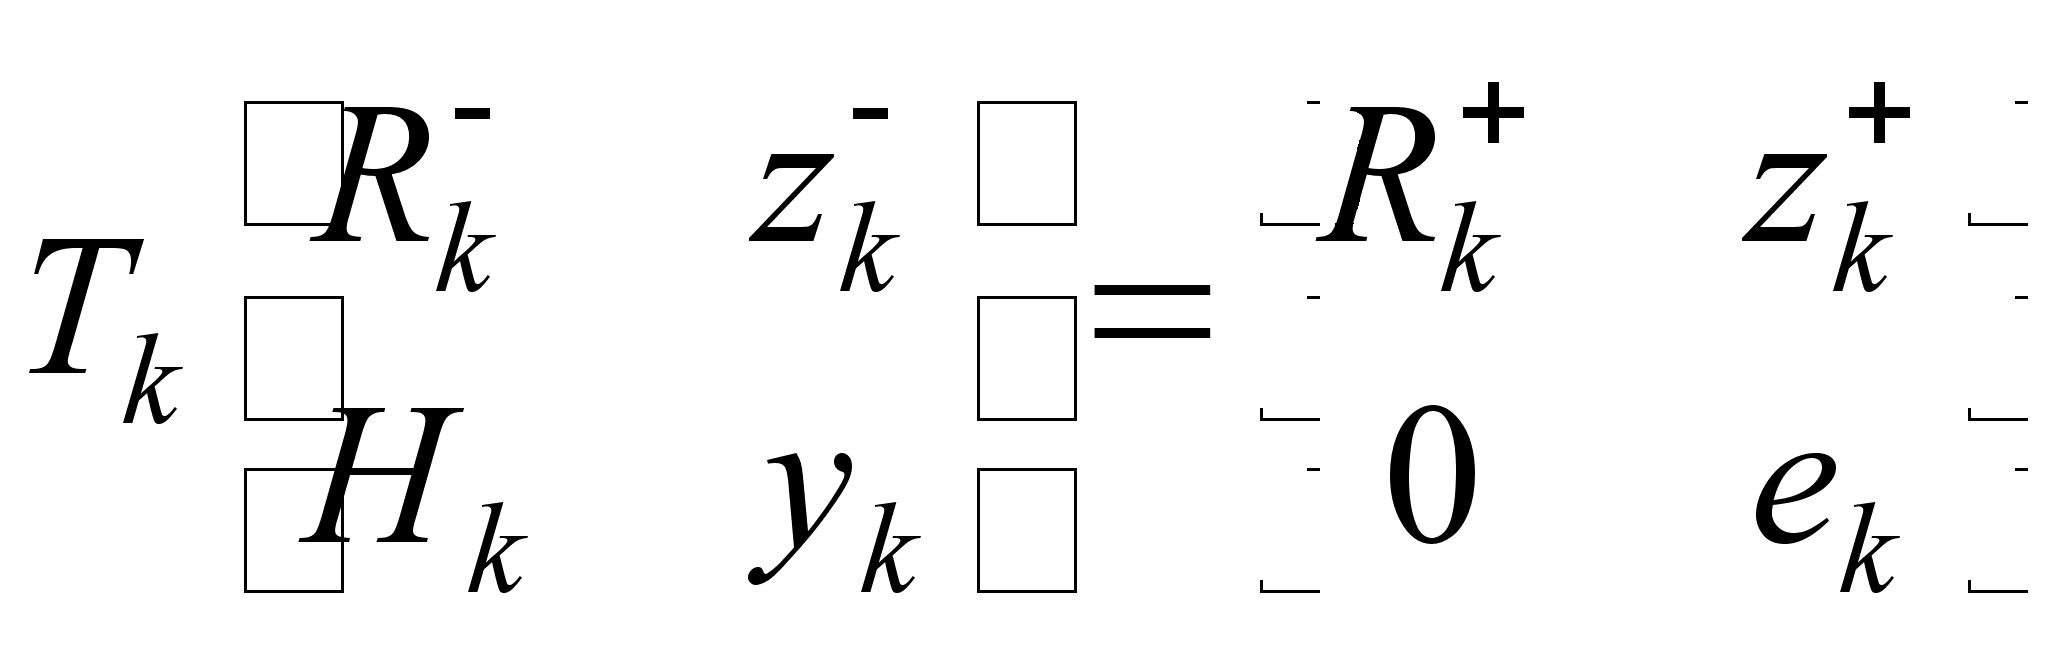 (2.1.10)
где
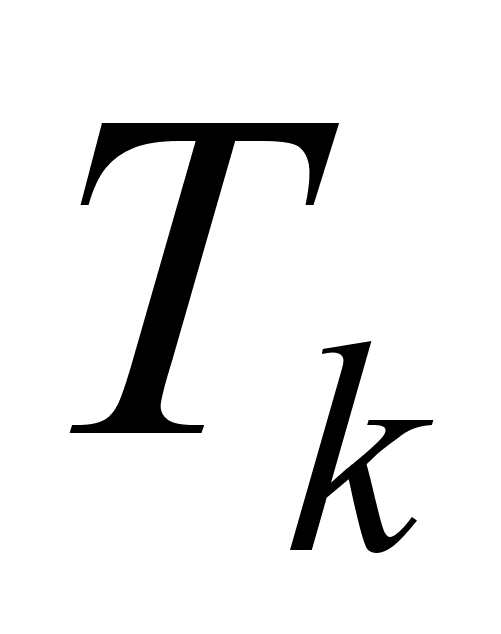 - ортогональная
матрица такая,
что
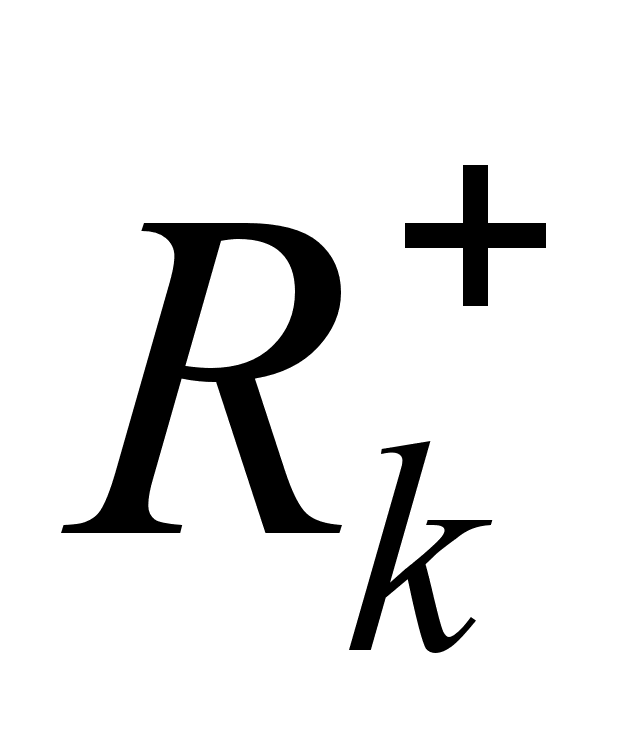 -
верхнетреугольная.
Также,
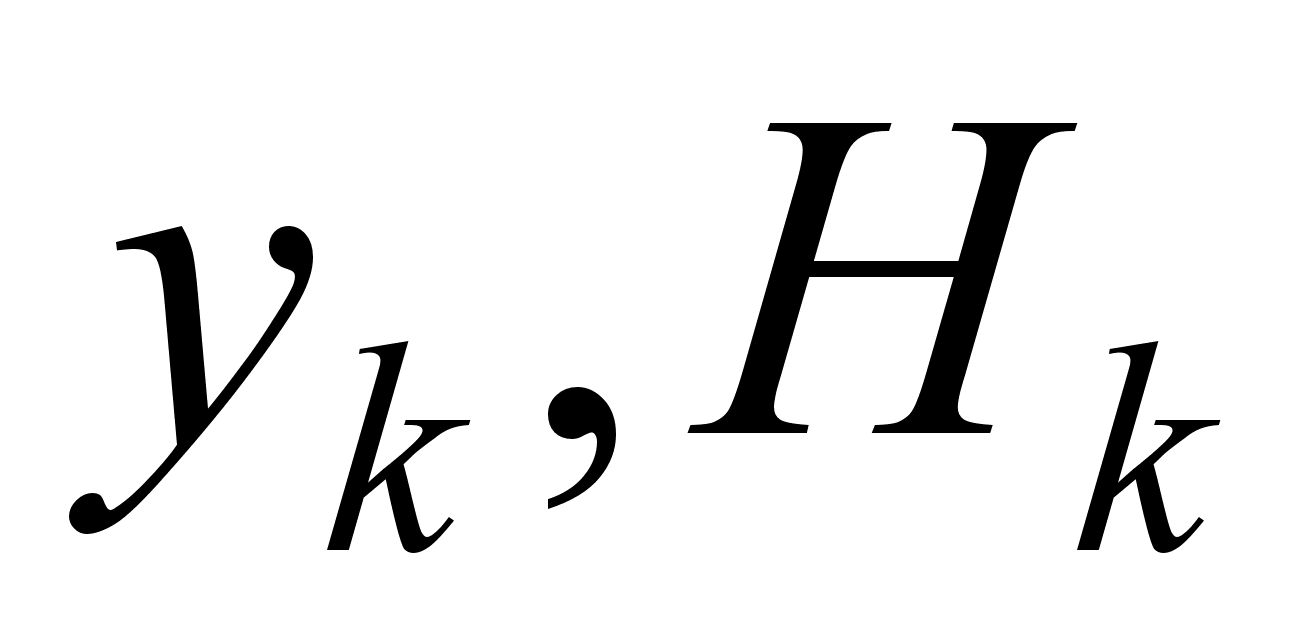 согласно (2.1.2)
имеют вид:
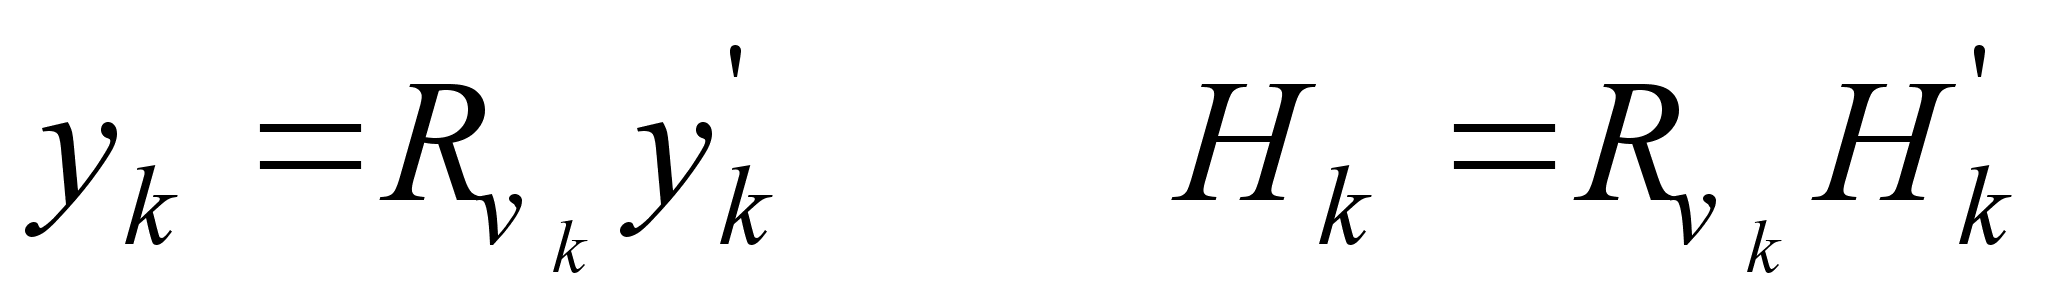 (2.1.11)
где
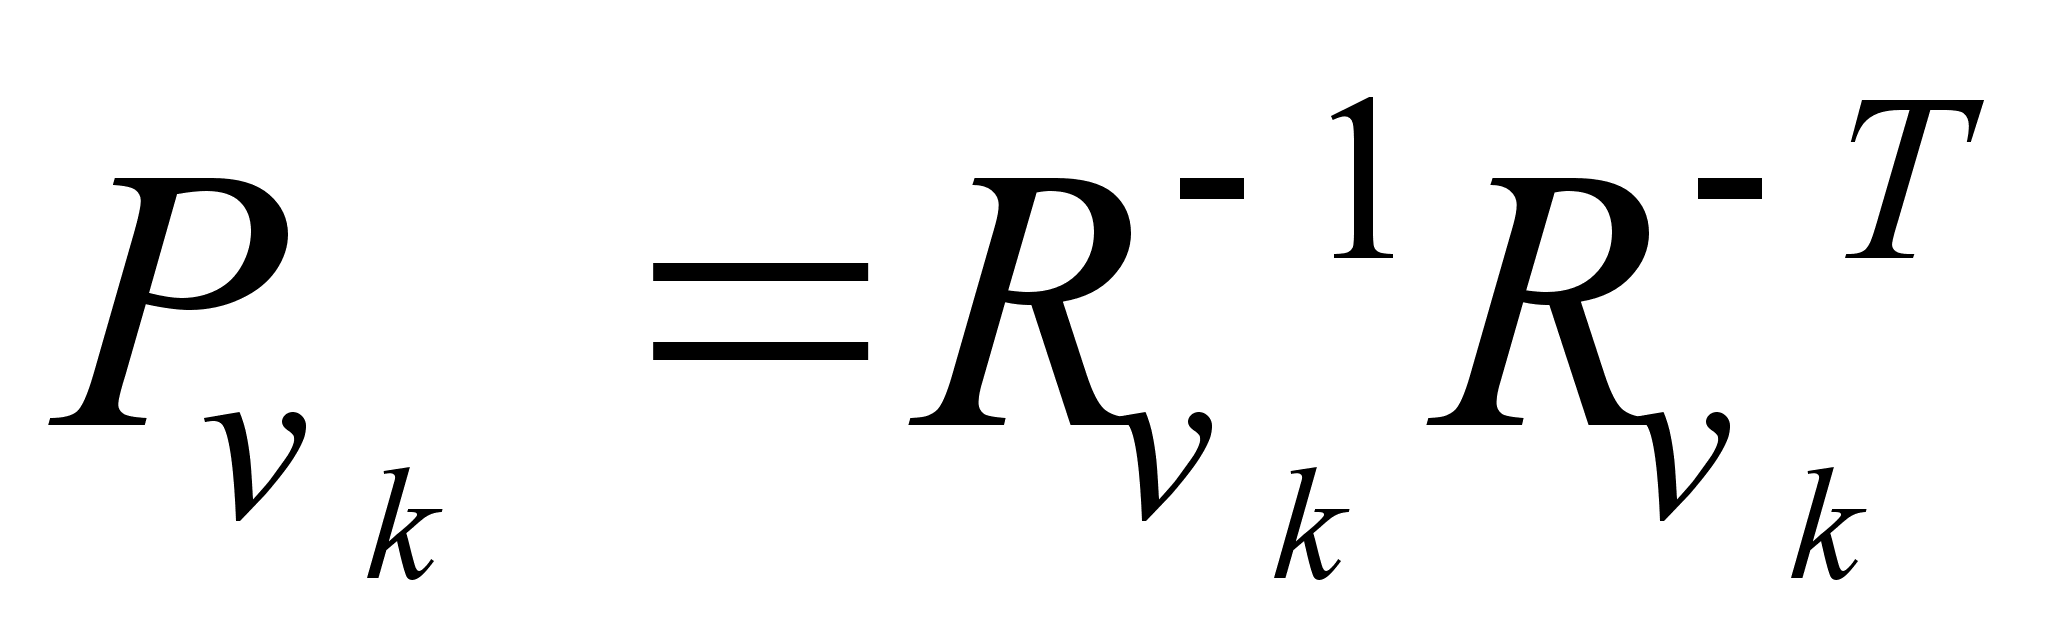 (2.1.12)
тогда шум наблюдения имеет единичную ковариацию, что удовлетворяет ККИФ.
Шаг предсказывания ККИФ, описывается следующим образом:
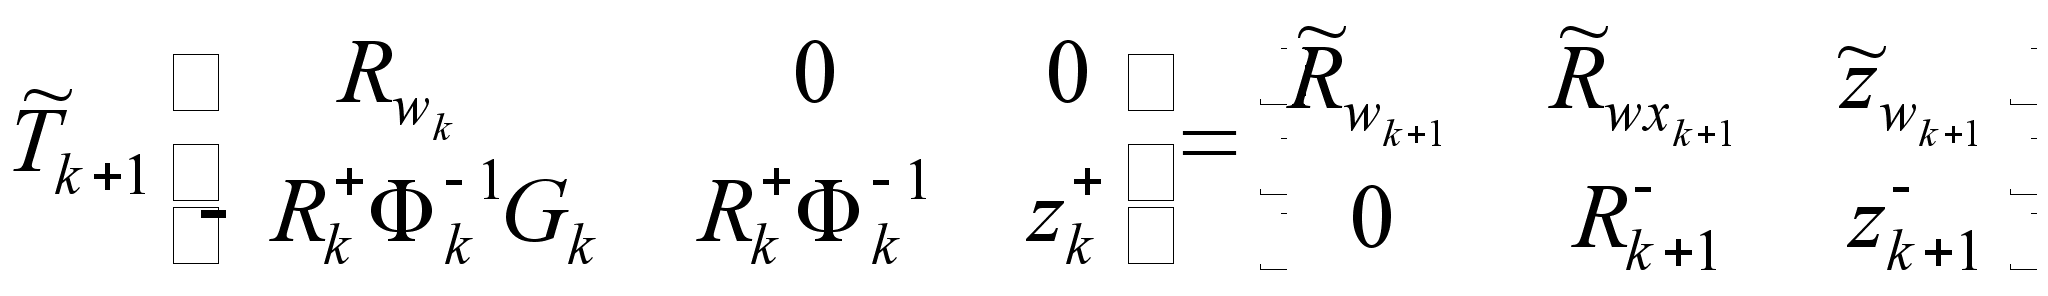 (2.1.13)
где матрица
представляется
уравнением
(1.4.4),
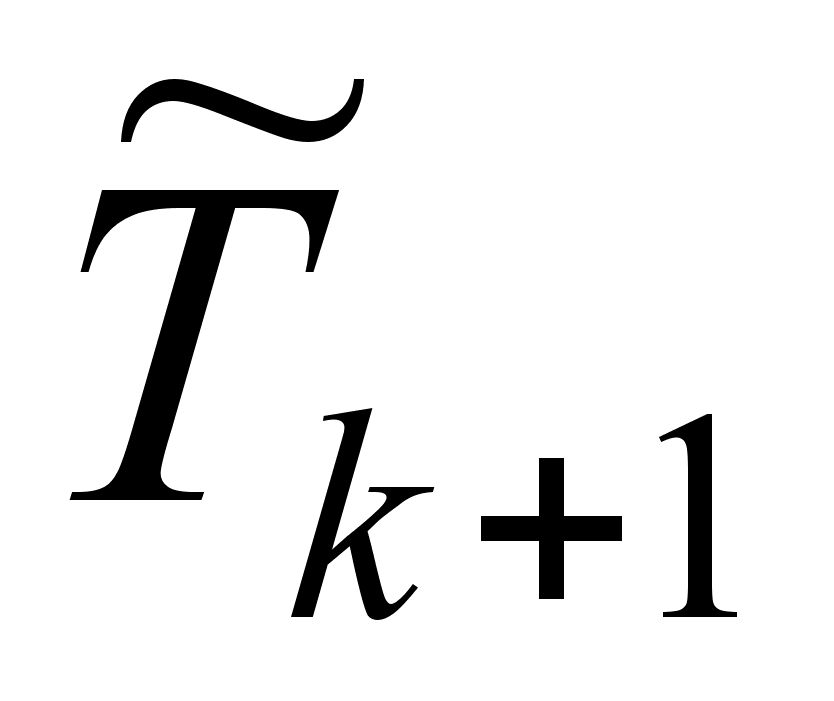 -
ортогональная
матрица