Теория вероятностей
Свойство «отсутствия последействия» состоит в том, что вероятность появления k событий в любом промежутке времени не зависит от того, появлялись или не появлялись события в моменты времени, предшествующие началу рассматриваемого промежутка. Другими словами, предыстория потока не влияет на вероятности появления событий в ближайшем будущем.
Свойство ординарности состоит в том, что появление двух или более событий за малый промежуток времени практически невозможно. Другими словами, вероятность появления более одного события за малый промежуток времени пренебрежимо мала по сравнению с вероятностью появления только одного события.
Интенсивностью потока называют среднее число событий, которые появляются в единицу времени.
Если постоянная интенсивность потока известна, то вероятность появления k событий простейшего потока за время t определяется формулой Пуассона
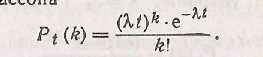
Замечание. Поток, обладающий свойством стационарности, называют стационарным; в противном случае—нестационарным.
Вопрос 23
(на отдельном листе)
Вопрос 24
Н.С.В. Х имеет нормальное распределение вероятностей с параметром а и сигма>0, если ее плотность распределения имеет вид: р(х)=1/(корень квадратный из 2пи *сигма) * е в степени –1/2*(x-a/сигма)*2. Если Х имеет нормальное распределение, то будем кратко записывать это в виде Х прибл. N(a,сигма). Так как фи(х)=1/(корень из 2пи)*е в степени –х*2/2 – плотность нормального закона распределения с параметрами а=0 и сигма=1, то функция Ф(х)=1/(корень из 2пи)* интеграл от –бесконечности до х е в степени –t*2/2dt, с помощью которой вычисляется вероятность P{a<=мюn-np/(корень из npq)<=b}, является функцией распределения нормального распределения с параметрами а=0, сигма=1.
Вопрос 25
Функцией (или интегралом вероятностей) Лапласа называется функция
П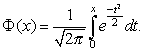
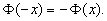 ри
решении задач,
как правило,
требуется найти
значение функции
по известному
значению аргумента
или, наоборот,
по известному
значению функции
требуется найти
значение аргумента.
Для этого пользуются
таблицей значений
функции Лапласа
и учитывают
следующие
свойства функции

1 0.
Функция Лапласа
нечётная, т.е.
20. Функция
Лапласа монотонно
возрастающая,
причём ( практически
можно считать,
что уже при
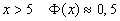 .
Так при
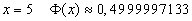 ).
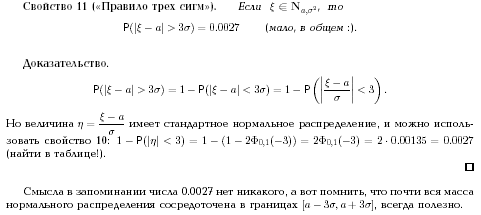
Вопрос 26
Неравенство Чебышева: Если известна дисперсия С.В., то с ее помощью можно оценить вероятность отклонения этой величины на заданное значение от своего мат. ожидания, причем оценка вероятности отклонения зависит лишь от дисперсии. Соответствующую оценку вероятности дает неравенство Чебышева. Неравенство Чебышева является частным случаем более общего неравенства, позволяющего оценить вероятность события, состоящего в том, что С.В. Х превзойдет по модулю произвольное число t>0. P{|X – MX|>=t}<=1/t*2 M(X – MX)*2=1/t*2 DX – неравенство Чебышева. Оно справедливо для любых С.В., имеющих дисперсию; оценка вероятности в нем не зависит от закона распределения С.В. Х.
Под законом больших числе понимается обобщенное название группы теорем, утверждающих, что при неограниченном увеличении числа испытаний средние величины стремятся к некоторым постоянным.
Теорема Чебышева: Если последовательность попарно независимых С.В. Х1,Х2,Х3,…,Xn,… имеет конечные мат. ожидания и дисперсии этих величин равномерно ограничены (не превышают постоянного числа С), то среднее арифметическое С.В. сходится по вероятности к среднему арифметическому их мат. ожиданий, т.е. если эпселен – любое положительное число, то: lim при n стремящемся к бесконечности P(|1/n сумма по i от 1 до n Xi – 1/n сумма по i от 1 до n M(Xi)|<эпселен)=1. В частности, среднее арифметическое последовательности попарно независимых величин, дисперсии которых равномерно ограничены и которые имеют одно и тоже мат. ожидание а, сходится по вероятности к мат. ожиданию а, т.е. если эпселен – любое положительное число, то: lim при n стремящемся к бесконечности P(|1/n сумма по i от 1 до n Xi – a|<эпселен)=1.
Теорема Бернулли: Если вероятность успеха в каждом из п независимых испытаний постоянна и равна р, то для произвольного, сколь угодно малого ε > 0 справедливо предельное равенство
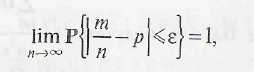
где т — число успехов в серии из п испытаний.
Вопрос 27
Локальная теорема Лапласа. Вероятность того, что в n независимых испытаниях, в каждом из которых вероятность появления события равна р(0<p<1), событие наступит ровно k раз (безразлично, в какой последовательности), приближенно равна (тем точнее, чем больше n). Pn(k)=1/(корень из npq)*фи(х). Здесь Фи(х)=1/(корень из 2пи)*е в степени –х*2/2, x=k – np/(корень из npq). Интегральная теорема Лапласа. Вероятность того, что в n независимых испытаниях, в каждом из которых вероятность появления события равна р(0<p<1), событие наступит не меньше k1 раз и не более k2 раз, приближенно равна: P(k1;k2)=Ф(х’’) – Ф(х’). Здесь Ф(х)=1/(корень из 2пи) * интеграл от0 до х е в степени –(z*2/2)dz – функция Лапласа, х’=(k1 – np)/(корень из npq), х’’=(k2 – np)/(корень из npq).
Вопрос 28
Двумерной называют С.В. (Х,Y), возможные значения которой есть пары чисел (x,y). Составляющие Х и Y, рассматриваемые одновременно, образуют систему двух С.В. Дискретной называют двумерную величину, составляющие которой дискретны. Непрерывной называют двумерную величину, составляющие которой непрерывны. Законом распределения Д.С.В. называют соответствие между возможными значениями и их вероятностями. Функция распределения вероятностей Д.С.В. называют функцию F(X,Y), определяющую для каждой пары чисел (х,y) вероятность того, что Х примет значение, меньшее х, при этом Y примет значение, меньшее y: F(x,y)=P(X<x,Y<y). Свойства:1) Значения функции распределения удовлетворяют двойному неравенству: 0<=F(x,y)<=1. 2) Функция распределения есть неубывающая функция по каждому аргументу:F(x2,y)>=F(x1,y), если х2>x1. F(x,y2)>=F(x,y1), если y2>y1. 3) Имеют место предельные соотношения: 1) F(-бесконечность, у)=0, 2) F(x,-бесконечность)=0, 3) F(-бесконечность, -бесконечность)=0, 4) F(бесконечность, бесконечность)=1. 4) а) при у=бесконечность функция распределения системы становится функцией распределения составляющей Х: F(x,бесконечность)=F1(x). Б) при х=бесконечность функция распределения системы становится функцией распределения составляющей У: F(бесконечность, у)=F2(y).
Вопрос 29
Вопрос 30
Корреляционным моментом СВ и называется мат. ожидание произведения отклонений этих СВ. =М((—М())*(—М()))
Для вычисления корреляционного момента может быть использована формула:
=М(*)—М()*М() Доказательство: По определению =М((—М())*(—М())) По свойству мат. ожидания
=М(—М()—М()+М()*М())=М()—М()*М()—М()*М()+М()*М()=М()—М()*()
Предполагая, что и независимые СВ, тогда =М()—М()*М()=М()*М()—М()*М()=0; =0. Можно доказать, что если корреляционный момент=0, то СВ могут быть как зависимыми, так и независимыми. Если не равен 0, то СВ и зависимы. Если СВ и зависимы, то корреляционный момент может быть равным 0 и не равным 0. Можно показать, что корреляционный момент характеризует степень линейной зависимости между составляющими и . При этом корреляционный момент зависит от размерности самих СВ. Чтобы сделать характеристику линейной связи и независимой от размерностей СВ и , вводится коэффициент корреляции:
К=/()*() Коэффициент корреляции не зависит от разностей СВ и и только показывает степень линейной зависимости между и , обусловленную только вероятностными свойствами и . Коэффициент корреляции определяет наклон прямой на графике в системе координат (,) Свойства коэффициента корреляции.
-1<=К<=1
Если К =1, то линейная зависимость между и и они не СВ.
К>0, то с ростом одной составляющей, вторая также в среднем растет.
К<0, то с убыванием одной составляющей, вторая в среднем убывает.
D()=D()+D()2
Доказательство.
D()=M(()2)—M2()=M(22+2)—(M()M())2=M(2)2M()+M(2)—+M2()+2M()*M()—M2()=D()+D()2(M())—M()*M()=D()+D()2
Вопрос 31
Мат. статистика опирается на теорию вероятностей, и ее цель – оценить характеристики генеральной совокупности по выборочным данным. Генеральной совокупностью называется вероятностное пространство {омега,S,P} (т.е. пространство элементарных событий омега с заданным на нем полем событий S и вероятностями Р) и определенная на этом пространстве С.В. Х. Случайной выборкой или просто выборкой объема n называется последовательность Х1,Х2,…,Xn, n независимых одинаково распределенных С.В., распределение каждой из которых совпадает с распределением исследуемой С.В. Х. Иными словами, случайная выборка – это результат n последовательных и независимых наблюдений над С.В. Х, представляющей генеральную совокупность.
Вопрос 32
Расположив элементы выборки в порядке неубывания, получим вариационный ряд х1 х2, ...-, хп. Если в вариационном ряду есть повторяющиеся элементы, то выборку можно записать в виде статистического ряда распределения, т.е. в виде таблицы
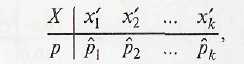
в которой
хi';
(i=
1, 2,..., к) —
это варианты
(расположенные
по возрастанию
различные
элементы выборки),
а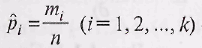
отвечающие этим значениям частости (здесь mi — частота варианты х'i, т.е. количество ее появлений в выборке). При этом, очевидно,
 Кривая
распределения
частости -
это ломаная
с вершинами
(х’i;
Pi).
Выборочное среднее (4.1.1) и выборочную дисперсию (4.1.8) при этом можно вычислить по формулам
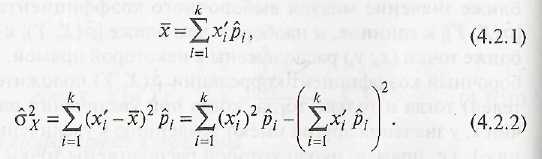
Для непрерывных случайных величин при достаточно больших объемах выборки п вместо статистического ряда распределения используют интервальный вариационный ряд
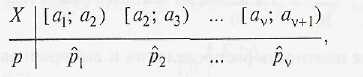
где v - число интервалов одинаковой ширины h = (xn-x1)/(1+3,322lgn) (х1 и хп - соответственно минимальный и максимальный элементы выборки; значение h рассчитывается с числом знаков после запятой, на единицу большим, чем в исходныхданных). Границы интервалов [aj, aj+i) рассчитываются по правилу: a1=x1-h/2, а2 = а1 + h, а3 = а2 + h, ...;
формирование интервалов заканчивается, как только для конца av+1 очередного интервала выполняется условие av+1 > хп. Выборочная ча-
стость
 где
mi
— число
вариант, попавших
в i-й
интервал
(i= 1,2, ...,v). Выборочным аналогом плотности распределения fx(x) случайной величины X служит выборочная плотность распределения
Вопрос 33
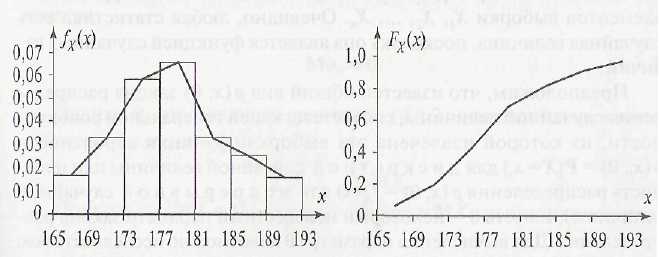
Выборочным аналогом плотности распределения fx(x) случайной величины X служит выборочная плотность распределения
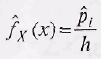 при
х [ai;
ai+1)
(i=
1, 2,..., V),
ее график называется
гис
тограммой,
а ломаная
с вершинами
в точках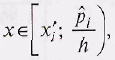 где
через
х’=(ai+ai+1)/2
обозначены
середины интервалов,
— полигоном
частот.
Выборочное среднее и выборочную дисперсию при этом вычисляют по формулам (4.2.1), (4.2.2)
соответственно, в которых к = v.
По выборочной плотности распределения легко построить выборочную функцию распределения, при
этом
линия, соединяющая
точки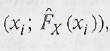 называется
кумулятой
Гистограмма (тонкая линия), полигон частот (полужирная линия) (а) и кумулята (б)
Вопрос 34
Вопрос 35
Прежде всего, от оценки θn хотелось бы требовать, чтобы по мере роста числа наблюдений п она стремилась к оцениваемому параметру, т.е. чтобы для любого сколь угодно малого Ј>0 было справедливо предельное равенство
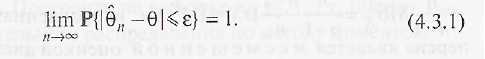
Также от «хорошей» оценки естественно требовать, чтобы она не содержала систематической ошибки, т.е. при любом фиксированном объеме выборки результат осреднения по всем возможным выборкам данного объема должен приводить к точному значению параметра:
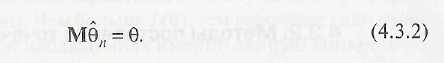
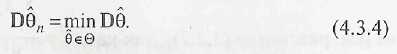
Наконец, от оценки θn желательно требовать, чтобы она была наиболее точной в некотором классе оценок в, т.е. имела минимальную дисперсию:
Вопрос 36
Статистической оценкой * неизвестного параметра теоретического распределения называют функцию f(X1,X2,…,Xn) от наблюдаемых С.В. X1,X2,…,Xn. Точечной называют статистическую оценку, которая определяется одним числом *=f(x1,x2,…,xn), где х1,х2,…,xn – результаты n наблюдений над количественным признаком Х (выборка). Несмещенной называют точечную оценку, мат. ожидание которой равно оцениваемому параметру при любом объеме выборки. Смещенной называют точечную оценку, мат. ожидание которой не равно оцениваемому параметру. Несмещенной оценкой генеральной средней (мат. ожидания) служит выборочная средняя: Хв=(сумма по i от 1 до k nixi)/n, где xi – варианта выборки, ni – частота варианты xi, n=сумма по i от 1 до k ni – объем выборки.
Вопрос 37
Вопрос38
Метод моментов точечной оценки неизвестных параметров заданного распределения состоит в приравнивании теоретических моментов соответствующим эмпирическим моментам того же порядка. Если распределение определяется одним параметром, то для его отыскания приравнивают один теоретический момент одному эмпирическому моменту того же порядка. Например, можно приравнять начальный теоретический момент первого порядка начальному эмпирическому моменту первого порядка: v1=M1. Учитывая, что v1=M(X) и М1=Хв, получим М(Х)=Хв. Если распределение определяется двумя параметрами, то приравнивают два теоретических момента двум соответствующим эмпирическим моментам того же порядка. Учитывая, что v1=M(X),M1=Хв,мю=D(X),m2=Dв, имеем систему: М(Х)=Хв, D(X)=Dв.
Метод наибольшего правдоподобия точечной оценки неизвестных параметров заданного распределения сводится к отысканию максимума функции одного или нескольких оцениваемых параметров. Д.С.В. Пусть Х – Д.С.В., которая в результате n опытов приняла возможные значения х1,х2,…,xn. Допустим, что вид закона распределения величины Х задан, но неизвестен параметр , которым определяется этот закон; требуется найти его точечную оценку *= (x1,x2,…,xn). Обозначим вероятность того, что в результате испытания величина Х примет значение xi через р(xi;). Функцией правдоподобия Д.С.В. Х называют функцию аргумента : L (x1,x2,…,xn;)=p(x1;)*p(x2;)…p(xn;). Оценкой наибольшего правдоподобия параметра называют такое его значение *, при котором функция правдоподобия достигает максимума. Функции L и lnL достигают максимума при одном и том же значении , поэтому вместо отыскания максимума функции L ищут, что удобнее, максимум функции lnL. Н.С.В. Пусть Х – Н.С.В., которая в результате n испытаний приняла значения х1,х2,…,xn. Допустим, что вид плотности распределения – функции f(x) – задан, но неизвестен параметр , которым определяется эта функция. Функцией правдоподобия Н.С.В. Х называют функцию аргумента : L(x1,x2,…,xn;)=f(x1;)*f(x2;)…f(xn;).
Вопрос 39
Интервальной называют оценку, которая определяется двумя числами – концами интервала, покрывающего оцениваемый параметр. Доверительный интервал – это интервал, который с заданной надежностью гамма покрывает заданный параметр
Интервальной оценкой (с надежностью гамма) среднего квадратического отклонения сигма нормально распределенного количественного признака Х по «исправленному» выборочному среднему квадратическому отклонению s служит доверительный интервал s(1-q)<сигма<s(1+q), при q<1; 0<сигма<s(1+q), при q>1. 3. Интервальной оценкой ( с надежностью гамма) неизвестной вероятности р биномиального распределения по относительной частоте w служит доверительный интервал ( с приближенными концами р1 и р2).
Вопрос 40
Интервальной называют оценку, которая определяется двумя числами – концами интервала, покрывающего оцениваемый параметр. Доверительный интервал – это интервал, который с заданной надежностью гамма покрывает заданный параметр. 1. Интервальной оценкой с надежностью гамма мат. ожидания а нормально распределенного количественного признака Х по выборочной средней Хв при известном среднем квадратическом отклонении сигма генеральной совокупности служит доверительный интервал: Хв – t(сигма/корень из n)<a<Хв+t(сигма/корень из n), где t(сигма/корень из n)=дельта – точность оценки, n – объем выборки, t – значение аргумента функции Лапласа Ф(t), при котором Ф(t)=гамма/2; при неизвестном сигма (и объеме выборки n<30) Хв – t гамма (s/корень из n)<a<Хв+t гамма (s/корень из n), где s-исправленное выборочное среднее квадратическое отклонение
Вопрос 41
Вопрос 42
В статистике рассматриваются гипотезы двух типов:
Параметрические – гипотезы о значении параметра известного распределения;
Непараметрические – гипотезы о виде распределения.
Обычно выделяют основную гипотезу – нулевую (H0). Пример: математическое ожидание признака , который распределен по нормальному закону и дисперсия его известна, а H0: M() = a. Предполагаем, что известна дисперсия Конкурирующая гипотеза имеет вид: H1: M() a;
H1: M() > a, либо H1: M() = a1. Для проверки гипотез используются критерии, и они представляют собой специальным образом подобранные СВ, k – точечный или приближенный закон, который известен.
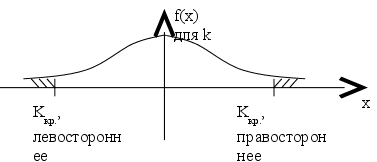
Обычно предполагается, что если гипотеза Н0 выполняется, то вычисляемая по выборочным данным kнабл. Этого критерия и гипотеза Н0 принимается, если kнабл. (kкритич. левостор.; kкритич. правостор.) Если kнабл. попадает в критическую область (все остальные значения k (- ; kкритич. лев.) (kкритич. прав. ; ), то гипотеза Н0 отвергается и принимается конкурирующая гипотеза Н1. При этом возможны ошибки двух типов: Первого рода: что гипотеза Н0 отвергается, в то время, как она верна. Вероятность этой ошибки: P(H1/H0) = - уровень значимости критерия. Критерий подбирается так, чтобы была как можно меньше. Второго рода: что отвергается гипотеза Н1, в то время, как она верна. = P(H0/H1) Мощностью критерия – (1-) - вероятность попасть точке-выборке в критическое множество, когда верна конкурирующая гипотеза.
1- = P(H1/H1)
Вопрос 43
Вопрос 44
По независимым выборкам, объемы которых n1, n2, извлеченным из нормальных генеральных совокупностей, найдены исправленные выборочные дисперсии s^2*x и s^2*y. Требуется сравнить эти дисперсии.
Правило I. Для того чтобы при заданном уровне значимости α, проверить нулевую гипотезу HQ: D(X) = D(Y) о равенстве генеральных дисперсий нормальных совокупностей при конкурирующей гипотезе Ho: D (X) > D (Y), надо вычислить наблюдаемое значение критерия (отношение большей исправленной дисперсии к меньшей)
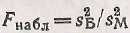
и по таблице критических точек распределения Фишера—Снедекора, по заданному уровню значимости а и числам степеней свободы k1=n1—1, k2 = n2—1 (k1—число степеней свободы большей исправленной дисперсии) найти критическую точку FKР(a; k1, k2). Если Fнабл < Fкр— нет оснований отвергнуть нулевую гипотезу. Если Fна,л > Fкр — нулевую гипотезу отвергают.
Правило 2. При конкурирующей гипотезе Н1: D(X)D(Y) критическую точку FKP (α/2; k1 ,k2) ищут по уровню значимости а/2 (вдвое меньшему заданного) и числам степеней свободы k1 и k2 (k1—число степеней свободы, большей дисперсии). Если FHАБЛ < Fкр — нет оснований отвергнуть нулевую гипотезу. Если Fнабл > Fкр — нулевую гипотезу отвергают.
Вопрос 45
Вопрос 46
Разобьем множество возможных значений случайной величины X Hav разрядов (для непрерывной случайной величины роль разрядов играют интервалы значений, а для дискретной — отдел ь-ные возможные значения или их группы). Выдвинем нулевую гипотезу Но: Fx(x) = Fтеор(x) (состоящую в том, что генеральная совокупность распределена по закону Fтеор(x)) при альтернативной гипотезе Н1: Fx(x) FTeop(x). Одним из критериев согласия выборочного и теоретического распределений (т.е. критериев соответствия генеральной совокупности определенному закону распределения) является критерий X^2 (критерий Пирсона), который основывается на том, что распределение статистики
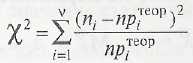
(где л, — число попаданий элементов выборки в i-й разряд, п - общее число элементов выборки, apiтеop — теоретическая вероятность попадания случайной величины Х в i-и разряд при условии истинности нулевой гипотезы) не зависит от выдвинутой гипотезы и определяется только числом степеней свободы k = v — l — 1, где v — число разрядов, аl— число оцениваемых параметров. Формулы закона распределения случайной величины X^2 довольно сложны, и мы их приводить не будем, но для этого распределения составлены таблицы значений X^2k;y таких, что Р{X2 < X^2k;y } = γ (табл. П. 3).
Если выбрать уровень значимости а, то надежность γ = 1 — а = — Р{X2 < X^2k;y } и критическая область определяется неравенством X2 набл< X^2k;y
Обратим внимание на то, что критерий Пирсона можно использовать только в том случае, когда nртеор5, поэтому разряды, для кото-, рых это условие не выполняется, необходимо объединить с соседними.
Вопрос 47
С помощью методов регрессионного анализа строятся и проверяются модели, характеризующие связь между одной эндогенной (зависимой) переменной и одной или более экзогенными (независимыми) переменными. Независимые переменные называются регрессором.
Направленность связи между переменными определяется путем предварительного обоснования и включается в модель в качестве исходной гипотезы. Задача регрессионного анализа – проверка статистической состоятельности модели, если данная гипотеза верна. Регрессионный анализ не в состоянии «доказать» гипотезу, он может лишь подтвердить ее статистически или отвергнуть.
Метод наименьших квадратов (МНК, англ. Ordinary Least Squares, OLS) является одним из основных методов определения параметров регрессионных уравнений, дающий наилучшие линейные несмещенные оценки (теорема Гаусса–Маркова).
Метод наименьших квадратов заключается в том, чтобы определить вид кривой, характер которой в наибольшей степени соответствует эмпирическим данным. Такая кривая должна обеспечить наименьшее значение суммы квадратов отклонений эмпирических значений величин показателя от значений, вычисленных согласно уравнению этой кривой:
Уравнение линейной регрессии. Обычно признак Y рассматривается как функция многих аргументов — x1, x2, x3, ...— и может быть записана в виде:
y = a + bx1 + cx2 + dx3 + ... ,
где:
а, b, с
и d
— параметры
уравнения,
определяющие
соотношение
между аргументами
и функцией. В
практике учитываются
не все, а лишь
некоторые
аргументы, в
простейшем
случае, как при
описании линейной
регрессии, —
всего один: y
= a + bx
В этом
уравнении
параметр а
— свободный
член; графически
он представляет
отрезок ординаты
(у) в системе
прямоугольных
координат.
Параметр b
называется
коэффициентом
регрессии. С
точки зрения
аналитической
геометрии b—
угловой коэффициент,
определяющий
наклон линии
регрессии по
отношению к
осям, координат.
В области
регрессионного
анализа этот
параметр показывает,
насколько в
среднем величина
одного признака
(Y)
изменяется
при изменении
на единицу меры
другого корреляционно
связанного
с Y
признака X.
Коэффициенты
уравнения
парной линейной
регрессии.
В случае линейной
зависимости
уравнение
регрессии
является уравнением
прямой линии.
Таких уравнений
два: Y = a1
+ by/xX
— прямое и X
= a2
+ bx/yY
— обратное,
где: a
и b
– коэффициенты,
или параметры,
которые надлежит
определить.
Значение
коэффициентов
регрессии
вычисляется
по формуле:
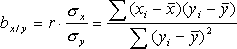
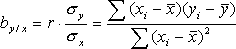
Коэффициенты
регрессии b
имеют размерность,
равную отношению
размерностей
изучаемых
показателей
X и
Y, и
тот же знак,
что и коэффициент
корреляции.
Коэффициенты
а
определяются
по формуле:

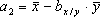
Определение параметров парной линейной регрессии
Определение
параметров
линейной регрессии
– одна из задач
регрессионного
анализа. Она
решается способом
наименьших
квадратов,
основанным
на требовании,
чтобы сумма
квадратов
отклонений
вариант от
линии регрессии
была наименьшей.
Этому требованию
удовлетворяет
следующая
система нормальных
уравнений:
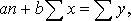
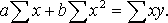
Формулы для определения параметров а и b принимают следующие выражения:
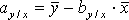
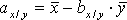
Уравнение линейной регрессии можно выразить в виде отклонений вариант от их средних арифметических:
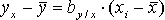
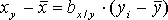
В таком случае система нормальных уравнений для определения параметров а и b будет следующая:
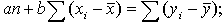
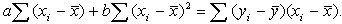
Система уравнений парной линейной регрессии:
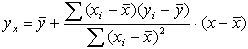
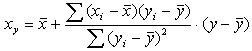
Эти уравнения удобны для определения параметров при отыскивании эмпирических уравнений регрессии в практической работе для точности прогнозирования результатов.
Вопрос 49
Временным рядом будем называть таблицу, в верхней строке которой находится счетное множество моментов времени (с постоянной дискретностью, напр. t=2, 5, 8, 11,...), в нижней - значение некоторого показателя Y. Предположим, без ограничения общности, что Y является функцией времени. Все другие факторы, кроме времени, оказывающие влияние на Y, аккумулируем и считаем. что они представляют собой случайный процесс Z(t), математическое ожидание которого равно нулю. Таким образом Yt=f(t)+Z(t). Функция f(t) - детерминированная составляющая, она называется трендом.