Математическая статистика
называют ковариацией случайных величин, которая также служит мерой связи, но без непосредственного учета дисперсий.
Различие между такими двумя показателями парной связи СВ достаточно существенное.
· Коэффициент корреляции определяет степень, тесноту линейной связи между величинами и является безразмерной величиной.
· Ковариация двух СВ определяет эту связь безотносительно к ее виду и является величиной размерной.
Множественная корреляцияВ ряде случаев статистического анализа приходится решать вопрос о связях нескольких (более 2) СВ или вопрос о множественной корреляции.
Пусть X, Y и Z – случайные величины, имеющие математические ожидания M(X), M(Y), M(Z) и среднеквадратичные отклонения s x ,s y, s z соответственно. Тогда можно найти парные коэффициенты корреляции Rxy, Rxz, Ryz по приведенной выше формуле.
Но этого явно недостаточно – ведь мы на каждом из трех этапов попросту забывали о наличии третьей СВ! Поэтому в случаях множественного корреляционного анализа иногда требуется отыскивать т. н. частные коэффициенты корреляции — например, оценка виляния Z на связь между X и Y производится с помощью коэффициента
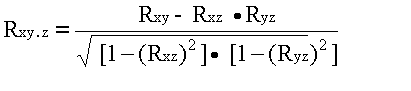
И, наконец, можно поставить вопрос — а какова связь между данной СВ и совокупностью остальных? Ответ на такие вопросы дают коэффициенты множественной корреляции RX.YZ, RY.XZ, RZ.XY, формулы для вычисления которых построены по тем же принципам — учету связи одной из величин со всеми остальными в совокупности.
Проверка статистических гипотез Понятие статистической гипотезы
Как уже отмечалось, основным занятием статистика–прикладника является чаще всего решение вопроса о том, что и как можно извлечь из наблюдений над случайной величиной (выборочных её значений) для последующего использования в практике.
Скажем, для некоторой экономической задачи требуется знание длины очереди автомашин, ожидающих технического обслуживания, а эта величина хоть и выражается целым числом, но является случайной.
Очень редко задачи такого рода имеют “теоретическую платформу” – хотя бы в части закона распределения СВ, не говоря уже о внутренних параметрах этого распределения или его моментах. Чаще всего в нашем распоряжении нет практически ничего, кроме некоторого количества наблюдений за значениями СВ и … необходимости решать задачу.
Выражаясь чисто научным языком, современный подход к статистическим задачам в последние два десятилетия заключается в использовании непараметрической статистики, а не традиционных, классических методов, которые применимы только при заранее известных законах распределений.
Но и в первом, и во втором случаях одной из важнейших задач профессионального статистика является проверка выдвинутых им же предположений или гипотез.
Чем же отличаются статистические гипотезы от обычных, житейских предположений? Прежде всего, тем, что статистических гипотез всегда две и они взаимоисключающие. Одна из них (обычно та, которую предполагают отклонить) носит название нулевой гипотезы Њ0, вторая – альтернативная гипотеза Њ1 всегда отрицает нулевую, противостоит ей.
Вся “хитрость” заключается именно в нулевой гипотезе – её надо построить, сформулировать так, чтобы иметь возможность найти интересующие нас вероятности в условиях истинности этой гипотезы.
Пусть мы исследуем игральную кость – “проверяем” ее симметричность. Ясно, что в качестве нулевой гипотезой надо считать предположение о полной симметрии кости.
Ведь если Њ0 верна, то вероятности выпадения всех шести цифр на гранях будут одинаковы – по 1/6 . А вот выдвижение в качестве нулевой гипотезы предположения об асимметрии кости ничего бы не дало – в этом случае мы ничего не можем сказать о значениях вероятностях выпадения цифр.
С процедурами проверки статистических гипотез неразрывно связано еще одно, непривычное для обычных расчетных работ, понятие уровня значимости результатов наблюдений.
В самом начале курса уже упоминался метод выделения редких событий – вероятность которых не превышает 5 %. Конечно, это значение является чисто условным – в некоторых случаях редкими считают события с вероятностью не более 1 %.
Теория вероятностей позволяет обосновать деление случайных событий на три класса – обычные, редкие и исключительные. При этом наблюдение события исключительного дает основания считать, что причины его наступления являются уже неслучайными – имеет место влияние некоторого фактора.
Будем далее использовать 5 % уровень значимости, как это принято почти во всех прикладных направлениях статистики, в том числе и в экономике.
Итак, если наблюдения относятся к событиям редким (с вероятностью до 5 %), то такие наблюдения и результаты их обработки будем называть статистически значимыми. Как же так, спросите вы, – вероятность мала, а предлагается считаться с ней. Все очень просто – если мы вычислили вероятность некоторого результата наблюдения в условиях основной гипотезы и она (априорная вероятность) оказалась очень малой, то чем она меньше, тем больше у нас оснований отвергнуть Њ0. С другой стороны, если мы увидели очень редкое событие – выпадение 10 гербов при 15 подбрасываниях монетки, то значимость такого наблюдения чрезвычайно высока – гипотезу о симметрии вполне можно отбросить.
Критерии статистических гипотез
Если мы пытаемся решить некоторую статистическую задачу, то в большинстве случаев нам придется заниматься не столько математическими выкладками и числовыми расчетами, сколько принимать решение – какую из выдвинутых нами же статистических гипотез принять (или – какую из них отвергнуть).
Так вот, решающее правило, согласно которому мы будем действовать, принято называть статистическим критерием. К сожалению, не существует единого, универсального критерия значимости – их приходится разрабатывать в теории и использовать на практике применительно к особенностям конкретных задач.
Вместе с тем, любому критерию значимости присуще одно и то же свойство – во всех случаях мы не получим категоричного указания на “истинную” гипотезу, прямого ответа на вопрос – какую из гипотез нам принять.
Еще более непривычным для человека с навыками искать и находить ответы в расчетных задачах, будет сама форма ответа на вопрос о сравнении гипотез Њ0 и Њ1 – например, в таком виде "если отбросить нулевую гипотезу, то вероятность ошибки такого действия не превосходит 3 % ".
Дальше уже наше дело, принять или отвергнуть ту или иную гипотезу – теория большего дать не в состоянии. Надо понять различие между выделенным утверждением и вроде бы аналогичным – "вероятность верности гипотезы Њ1 составляет 97%" . Все между тем очень просто – вычислить возможно только вероятность ошибочности Њ0 и не более того!
Пусть мы интересуемся симметрией обычной монетки и собираемся проводить эксперименты – подбрасывать её и фиксировать результаты. Выдвинем гипотезу – монета симметрична. Если мы собираемся произвести N подбрасываний и по их итогам проверить гипотезу, должны просчитать вероятности выпадения 0, 1, 2 и т.д. до N “гербов”. Конечно, можно выполнить расчеты и после окончания опыта – всё равно это будут априорные вероятности по своей сути.
Проиллюстрируем это на рассмотренной ранее ситуации 8 экспериментов с монеткой. Предположим, что частости появления возможных исходов уже вычислены – в таких случаях говорят о наличии выборочного распределения вероятностей. Для нашего эксперимента такое распределение имеет вид:
Таблица 4–1
|
Число наблюдений гербов k |
0 |
1 |
2 |
3 |
4 |
5 |
6 |
7 |
8 |
|
Вероятность P(X =k) в 1 / 256 |
1 |
8 |
28 |
56 |
70 |
56 |
28 |
8 |
1 |
|
Вероятность P(X £ k) в 1 / 256 |
1 |
9 |
37 |
93 |
163 |
219 |
247 |
255 |
256 |
Если мы в результате эксперимента получили сумму гербов S = 1, то вероятность наблюдать такую сумму (и менее вероятное значение S=0) составляет для симметричной монетки P(S <2) = (1+8) / 256 @ 0.036. Можно, однако, рассуждать и иначе. Ведь мы наблюдали в том же опыте 7 появлений “решки”. Вероятность наблюдать такое и менее вероятное число 8 составляет точно столько же – P(S>6) = (1+8) / 256 @ 0.036. Осталось построить решающее правило – критерий для принятия окончательного решения в отношении выдвинутых гипотез (основной Њ0 и альтернативной Њ1).
Заметим, что при выдвинутой нами основной гипотезе Њ0:(p=q) альтернативную гипотезу можно выдвигать по разному:
Њ1: (p#q) – монета несимметрична, ненаправленная гипотеза, требующая использования двухсторонних вероятностей;
Њ1: (p<q) – монета несимметрична и при этом “герб” легче, направленная гипотеза, достаточно односторонних вероятностей.
Применим оба приема построения критерия в условиях нашего примера.
· Нулевая гипотеза Њ0: (p=q). Альтернативная гипотеза Њ1: (p#q).
Уровень значимости a =0.05. Итог наблюдений при N=8: S= 1 .
Вероятность такого итога при условии, что нулевая гипотеза верна составляет
P(S<2)+ P(S>6) @ 0.072, т.е. больше порогового значения
Решение: нулевую гипотезу не отвергаем, монетку считаем симметричной.
· Нулевая гипотеза Њ0: (p=q). Альтернативная гипотеза Њ1: (p<q).
Уровень значимости a =0.05. Итог наблюдений при N=8: S= 1 .
Вероятность такого итога при условии, что нулевая гипотеза верна составляет P(S<2) @ 0.036, т.е. меньше уровня значимости.
Решение: нулевую гипотезу отвергаем, монетку считаем направленно несимметричной.
Возможно у вас возникло сомнение в части первого способа оценки статистических гипотез – ведь герб наблюдался всего один раз из восьми и, тем не менее, гипотеза о симметрии монетки не отбрасывается.
На самом деле всё правильно и обосновано – смысл нулевых гипотез Њ0 в первом и втором случае, несмотря на формальную тождественность, не одинакова. Суть дела заключена в формулировке альтернативных гипотез Њ1.
В первом случае Њ1 охватывает два события (p>q) или (p<q), а значит это более жесткое предположение. Во втором случае Њ1 связана только с одним событием (p<q), а значит она мягче, требует меньшего количества информации для признания ее истинной.
Ошибки при проверке статистических гипотезВыбирая окончательно в качестве рабочей одну из гипотез – нулевую или альтернативную, мы используем следующую логическую схему (алгоритм):
Не забудем, что отвергая Њ0, мы принимаем альтернативную Њ1 и наоборот. Пусть у нас уже есть правило, в соответствии с которым мы либо принимаем основную гипотезу Њ0, либо отвергаем её.
Как уже говорилось, контрольной цифрой является уровень значимости – вероятность a наблюдать то, что мы имеем после эксперимента, в случае если гипотеза Њ0 верна.
Пусть, к примеру, мы знаем вероятность данного наблюдения при истинности основной гипотезы и она равна 0.04. Мы вправе принять эту гипотезу – вероятность ошибиться меньше, чем a =0.05.
Конечно, приняв нулевую гипотезу, мы рискуем ошибиться. Степень риска можно найти очень просто – вероятность отбросить верную нулевую гипотезу (совершить ошибку первого рода или a –ошибку) составляет 5 %.
Но ведь можно совершить и другую ошибку – принять нулевую гипотезу, когда она на самом деле неверна (ошибка второго рода или b –ошибка). Величина эта зависит, прежде всего, от решающего правила – критерия принятия гипотез. Поэтому величину (1 –b ) принято называть мощностью критерия.
С определением вероятности ошибки второго рода дело обстоит не так просто – ее приходится вычислять. В первом приближении можно считать, что нам одинаково “вредны” ошибки как первого, так и второго рода. Более актуальным является вопрос – а как их избежать или хотя бы снизить вероятность их появления? К сожалению, в задачи курса не входит рассмотрение таких вопросов.
Достаточно знать, что в прикладной статистике существуют методы повышения эффективности критериев проверки статистических гипотез.
Кроме того, нельзя упускать из виду и "простой рецепт" снижения вероятностей ошибок как первого, так и второго рода – надо иметь побольше наблюдений.
Так, например, имеются достаточно надежные методы определения так называемых “критических” значений СВ. Эти значения для задач рассмотренных выше типов (с биномиальным распределением вероятностей) позволяют сразу же оценить возможность отбрасывания нулевой гипотезы – по данным о числе испытаний и числе