Валовий дохід від різних варіантів здійснення виробничої діяльності
У
випадку асиметричного
розподілу
точка, що відповідає
середньому
значенню ознаки
 =5330.08,
не ділитиме
інтервал [994;9948]
на рівні частини,
а буде зміщена
до якого-небудь
з кінців інтервалу.
Вибираємо
з двох інтервалів,
розділених
значенням
середньої
величини, інтервал
найменшої
довжини, для
чого порівнюємо
по модулю величини
 =5330.08-994=4336.08
і
 =9948-5330.081=4617.92.
Довжину
найменшого
з двох порівнюваних
інтервалів
поділяємо
навпіл і отримане
значення
 додаємо
до середнього
і
вичитаємо з
нього.
∆Y=4336.08/2=2168.04.
 =5330.08-2168.04=3162.04;
 =5411+2223,5=7498.12.
Одержуємо координати двох точок (3162.04) і (7498.12), які відзначаємо на числовій осі варіаційного ряду вліво і вправо від середнього значення:

 Дрібні
Середні
Великі
994 3162.04 5330.08 7498.12 9948
В результаті числова вісь, що відповідає ранжированому варіаційному ряду досліджуваної ознаки, розділяється на три інтервали [994;3162,04], [3162.04;7498,12] і [7498,12;9948], довжини яких можуть бути інтерпретовані як величини, що відмежовують дрібні, середні і великі одиниці сукупності.
Після встановлення меж інтервалів розробимо таблицю частот і часток та побудуємо гістограму розподілу підприємств.
Таблиця 2.5 – Групування підприємств за обсягом валового доходу, тис.грн.
|
Номер інтерва-лу, K |
Межі інтервалів |
Частота fk |
Кумулятивна частота,
|
Частка, wk=fk/n |
Кумулятивна частка,
|
| 1 | 994-1122 | 1 | 1 | 0,03 | 0,03 |
| 2 | 1122-8802 | 32 | 33 | 0,89 | 0,92 |
| 3 | 8802-9948 | 3 | 36 | 0,08 | 1 |
| Разом | 36 | 1 |


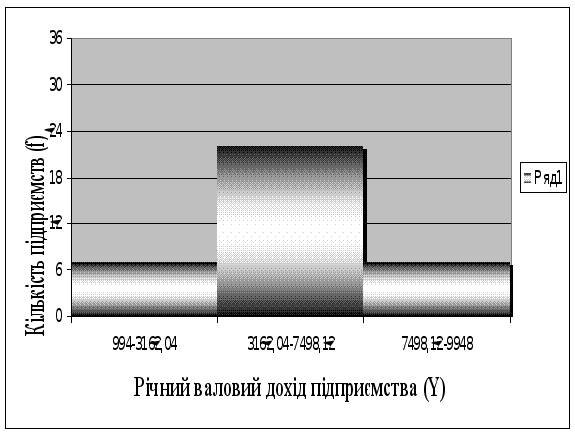
Рис. 2.1 - Гістограма розподілу значень Y
2.2.3 Розрахунок узагальнюючих характеристик і перевірка однорідності вибіркової сукупності
Наступний етап аналізу сукупності спостережень - розрахунок узагальнюючих характеристик досліджуваної статистичної сукупності. Цей розрахунок можна виконати за не згрупованими або згрупованими даними (на підставі частотної таблиці). Більш точними є результати, отримані з використанням не згрупованих даних.
У курсовій роботі розрахунок зазначених показників описової статистики виконаємо для кожної змінної за не згрупованими даними. Для розрахунку використаємо формули, що приведені в табл. 2.6.
Таблиця 2.6 – Формули для розрахунку узагальнюючих показників вибіркових сукупностей
| Узагальнюючі показники | Результативна змінна Y | Факторні змінні Xi |
| Середнє |
|
|
| Середнє квадратич-не відхилення |
|
|
| Коефіцієнт варіації |
|
|

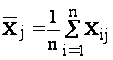
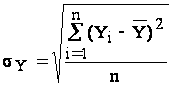
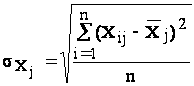
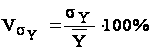
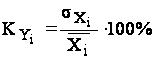
Примітка. 1) i-номер спостереження, i =1,2...,n; 36
2) j - номер чинника, j = 1,2,3,4,5
Таблиця 2.7 – Розрахунки узагальнюючих показників вибіркових сукупностей
| Узагальнюючі показники | Результативна змінна Y | Факторні змінні X1 | Факторні змінні Х2 | Факторні змінні Х3 | Факторні змінні Х4 | Факторні змінні Х5 |
| Середнє | 5330.08 | 3604.306 | 1293.528 | 1.467 | 2.723 | 3.996 |
| Середнє квадратич-не відхилення | 2234.139 | 1549.276 | 472.749 | 0,124 | 0,228 | 23,449 |
| Коефіцієнт варіації, | 42.984 | 36.547 | 35,326 | 8,453 | 8.373 | 586,812 |
Розрахунок виконується на підставі вихідних даних, приведених у табл. 2.3. Проаналізувавши дані таблиці 2.3, можна зробити такі висновки:
Сукупності
показників
У, Х1, Х2 та Х5 не
однорідні,
оскільки їх
коефіцієнти
варіації більші
ніж 33%. А сукупності
показників
Х3 та Х4 являються
однорідними,
бо значення
їх коефіцієнтів
варіації значно
менше 33%.Отже,
чим менше значення
коефіцієнта
варіації, тим
однорідніші
об'єкти досліджуваної
сукупності
і надійніше
рішення, прийняті
з використанням
описової статистики.
Сукупність
вважається
однорідною,
якщо
 .
Подальший аналіз проводимо по вибірці, що складається з 30 підприємств.
Формуємо нову таблицю вихідних даних.
Таблиця 2.8 – Вихідні дані до статистичного дослідження (зменшена вибірка)
| Порядковий номер | Значення змінних | |||||||
| групи | Підприєм-ства в групі | Спостере-ження, і | Yi | Xi1 | Хi2 | Xi3 | Xi4 | Xi5 |
| I | 4 | 2248 | 1848 | 753 | 1,216 | 2,454 | 2,985 | |
| 5 | 2325 | 1867 | 705 | 1,245 | 2,648 | 3,298 | ||
| 6 | 2514 | 1916 | 698 | 1,312 | 2,745 | 3,602 | ||
| 7 | 2651 | 1890 | 764 | 1,403 | 2,474 | 3,47 | ||
| II | 8 | 3780 | 2502 | 948 | 1,511 | 2,639 | 3,987 | |
| 9 | 3840 | 2541 | 961 | 1,511 | 2,644 | 3,996 | ||
| 10 | 3878 | 2507 | 969 | 1,547 | 2,587 | 4,002 | ||
| 11 | 3905 | 2559 | 999 | 1,526 | 2,562 | 3,909 | ||
| 12 | 3980 | 2632 | 990 | 1,512 | 2,659 | 4,02 | ||
| III | 13 | 4835 | 3231 | 1184 | 1,496 | 2,729 | 4,084 | |
| 14 | 4865 | 2847 | 1159 | 1,709 | 2,456 | 4,198 | ||
| 15 | 4819 | 3176 | 1066 | 1,517 | 2,979 | 4,521 | ||
| 16 | 4884 | 3374 | 1230 | 1,448 | 2,743 | 3,971 | ||
| 17 | 4911 | 3142 | 1187 | 1,563 | 2,647 | 4,137 | ||
| 18 | 4962 | 3175 | 1198 | 1,563 | 2,65 | 4,142 | ||
| IV | 19 | 5766 | 3802 | 1369 | 1,517 | 2,777 | 4,212 | |
| 20 | 5837 | 3835 | 1379 | 1,522 | 2,781 | 4,233 | ||
| 21 | 5849 | 3890 | 1407 | 1,504 | 2,765 | 4,157 | ||
| 22 | 5858 | 3946 | 1415 | 1,485 | 2,789 | 4,14 | ||
| 23 | 5963 | 4045 | 1447 | 1,474 | 2,795 | 4,121 | ||
| 24 | 5999 | 3968 | 1422 | 1,512 | 2,79 | 4,219 | ||
| V | 25 | 6736 | 4702 | 1568 | 1,433 | 2,999 | 4,296 | |
| 26 | 6820 | 4372 | 1585 | 1,56 | 2,758 | 4,303 | ||
| 27 | 6860 | 4498 | 1594 | 1,525 | 2,822 | 4,304 | ||
| 28 | 6894 | 4602 | 1627 | 1,498 | 2,829 | 4,237 | ||
| 29 | 6940 | 4550 | 1611 | 1,525 | 2,824 | 4,308 | ||
| VI | 30 | 7794 | 5104 | 1790 | 1,527 | 2,851 | 4,354 | |
| 31 | 7784 | 5097 | 1787 | 1,527 | 2,852 | 4,356 | ||
| 32 | 7975 | 5015 | 1828 | 1,59 | 2,743 | 4,363 | ||
| 33 | 8050 | 5168 | 1814 | 1,558 | 2,849 | 4,438 | ||
| Сума значень | 159522 | 105801 | 38454 | 44,836 | 81,84 | 122,363 | ||
| Середнє значення | 5317,4 | 3526,7 | 1281,8 | 1,495 | 2,728 | 4,079 | ||
Розраховуємо оптимальну кількість груп К з рівними інтервалами по формулі Стерджесса:
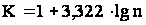 ,
K=1+3,322*lg30=6.
Розрахуємо ширину групувального інтервалу h:
h= =967.
Таблиця 2.9 – Групування підприємств по величині валового доходу, тис. грн.
|
Номер інтервалу, k |
Межі інтервалів |
Частота, fk |
Кумулятив-на частота,
|
Частка, wk=fk/n |
Кумулятивна частка,
|
| 1 | 2248-3215 | 4 | 4 | 0,133 | 0.133 |
| 2 | 3215-4182 | 5 | 9 | 0,167 | 0.3 |
| 3 | 4182-5149 | 6 | 15 | 0,201 | 0.501 |
| 4 | 5149-6116 | 6 | 21 | 0,2 | 0.701 |
| 5 | 6116-7083 | 5 | 26 | 0,167 | 0.868 |
| 6 | 7083-8050 | 4 | 30 | 0,133 | 1 |
| Разом | - | 30 | - | 1 | - |
Таблиця 2.10 – Розрахунки узагальнюючих показників вибіркових сукупностей
| Узагальнюючі показники | Результативна змінна Y | Факторні змінні X1 | Факторні змінні Х2 | Факторні змінні Х3 | Факторні змінні Х4 | Факторні змінні Х5 |
| Середнє | 5317,4 | 3526,7 | 1281,8 | 1,495 | 2,728 | 4,079 |
| Середнє квадратич-не відхилення | 1686.758 | 1043.374 | 340.578 | 0.095 | 0.133 | 0.334 |
| Коефіцієнт варіації | 31.721 | 29.585 | 26.57 | 6.355 | 4.875 | 8.188 |
2.3 Поширення вибіркових результатів на генеральну сукупність. Оцінка достатності обсягу вибірки
Кінцевою
метою вибіркового
спостереження
є характеристика
генеральної
сукупності.
Враховуючи,
що на основі
вибіркового
обстеження
не можна точно
оцінити досліджуваний
параметр генеральної
сукупності,
знайдемо межі,
у яких він
знаходиться.
Для цього необхідно
з імовірністю
0,95 визначити
граничну помилку
 вибіркової
середньої
результативного
показника
(середнього
доходу підприємств,
що входять у
вибірку), і довірчі
межі середнього
доходу
 всіх підприємств
генеральної
сукупності:
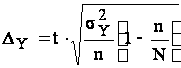 ,
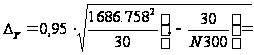 572.624
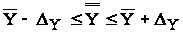 ,
де n – обсяг вибірки;
N – обсяг генеральної сукупності.
Обсяг вибірки повинен бути достатнім для отримання достовірних висновків про явище, що вивчається. У зв'язку з цим в курсовій роботі слід визначити, яким повинен бути обсяг вибірки для проведення дослідження. З цією метою розраховуємо мінімальний обсяг вибірки, необхідний для оцінки генеральної середньої результативного показника з 5-процентною помилкою на рівні довірчої вірогідності 0,95. Розрахунок виконуємо по формулі для безповторної власно-випадкової вибірки:
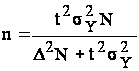 ,
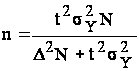 =
102.0345
де t – коефіцієнт довіри, що відповідає рівню довірчої імовірності 0,95 (t=1,96);
 –
припустима
гранична абсолютна
величина помилки
оцінки генеральної
середньої:

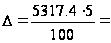 265.87
В результаті розрахунків виявилося, що фактичний обсяг вибірки менше мінімального. Визначаємо фактичну величину помилки оцінки генеральної середньої. Для цього формулу, по якій проводили розрахунок мінімального обсягу вибірки, перетворюємо. А потім підставляємо фактичне значення обсягу вибірки, дисперсії ознаки і коефіцієнта довіри і знаходимо відповідне їм значення помилки оцінки генеральної середньої.
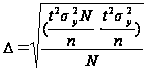

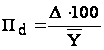
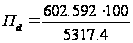 =11.332.
2.4 Аналіз закономірностей розподілу досліджуваних показників
З метою найбільш повного опису поводження досліджуваної ознаки в статистичних дослідженнях часто потрібно визначити закон її розподілу. У курсовій роботі зробимо це тільки для результативної перемінної.
В статистиці для опису поведінки випадкових дискретних і безперервних величин використовуються різні закони розподілу. Нормальний закон використовується для опису розподілу випадкових безперервних величин.
Досліджувана результативна змінна є неперервною величиною, тому що обсяг доходу підприємства не може бути представлений кінцевим набором чисел координатної осі. Дохід, теоретично, може приймати будь-яке значення від 0 до нескінченно великого числа, однак на практиці він обмежений через обмеженість ресурсів. Як показала практика, більшість явищ і подій у реальному житті можна звести до нормального закону і його модифікацій, тому саме цьому закону приділяється велика увага в теорії ймовірностей і статистиці. Нормальність розподілу характерна для збалансованих об'єктів, що не мають різких переходів і розходжень. Тому бажано, щоб результативний показник мав розподіл, близький до нормального.
Для перевірки гіпотези про нормальність розподілу результативного показника по даним вибірки будуємо гістограму та полігон розподілу емпіричних значень.
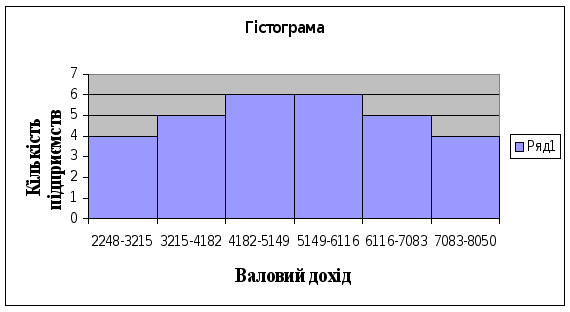
Рис. 2.2 - Гістограма розподілу емпіричних значень
Розраховуємо моду та медіану по даним вибірки за формулами:
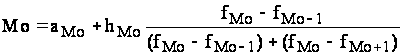 ,
де
 – нижня межа
модального
інтервалу;
 –
величина
модального
інтервалу;
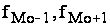 – частоти
відповідно
в попередньому
і наступним
за модальним
інтервалах.
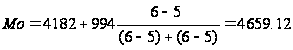
Графічно моду визначають по гістограмі. Для цього виберемо найвищий прямокутник, який і є модальним. Далі праву верхню вершину прямокутника, що передує модальному (частота fMо-1), з'єднуємо із правою верхньою вершиною модального прямокутника (частота fMо), а ліву верхню вершину цього прямокутника – з лівою верхньою вершиною прямокутника, наступного за модальним (частота fMо+1). З точки перетинання опускаємо перпендикуляр на горизонтальну вісь. Основа перпендикуляра покаже значення моди Мо.
При обчисленні медіани спочатку знаходимо інтервал, що містить медіану. Медіанним є інтервал, накопичена частота якого дорівнює чи перевищує половину всього обсягу сукупності.
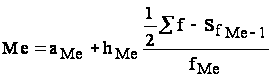 ,
де
 – нижня межа
медіанного
інтервалу;
 – ширина
медіанного
інтервалу;
 – накопичена
частота інтервалу,
передуючого
медіанному;
 – частота
медіанного
інтервалу.
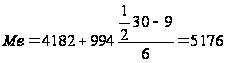
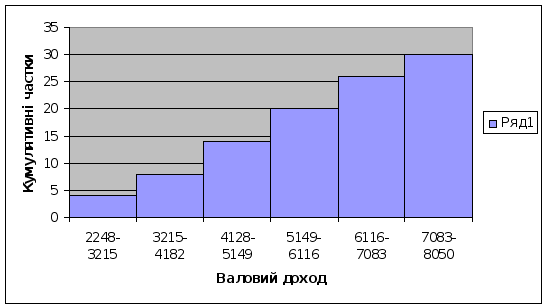
Рис. 2.3 Графічне визначення медіани
Графічно медіана визначаємо по кумуляті. Останню ординату кумуляти, рівну сумі всіх частот або часток, ділимо навпіл. З отриманої точки проводимо перпендикуляр до кумуляти. Абсциса точки перетинання і дає значення медіани.
Співвідношенням
моди, медіани
і середньої
арифметичної
користаються
для розпізнавання
симетричності
варіації. Необхідною,
але недостатньою
умовою симетричності
є рівність
трьох характеристик:
 =Ме=Mо.
У рядах із
правосторонньою
асиметрією