Комплексная статистическая обработка экспериментальных данных
Министерство образования и науки Украины
Пояснительная записка
к курсовой работе
по дисциплине Статистика
Комплексная статистическая обработка экспериментальных данных
Реферат
Объектом исследования данной работы является комплексный анализ сгенерированных выборок случайных величин и подбор их закона распределения.
Целью работы является изучение методов и приемов анализа статистической информации, получение навыков и опыта работы в пакете STATISTICA.
В данной работе применялись широко используемые статистические методы обработки и анализа данных.
Результатом работы является освоение методов обработки данных статистического наблюдения, их анализа с помощью обобщающих показателей, установление теоретических законов распределения случайных величин и доказательство адекватности этих законов.
Данную курсовую работу можно использовать в качестве наглядного пособия по обработке статистических данных для различных учебных целей и задач.
Задание на курсовой проект
По специально сгенерированному имитатору получить последовательности случайных чисел двух типов:
а)
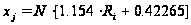 ,
где
 – номер варианта,
 - номер измерения
случайной
величины,
 – случайное
число, возвращаемое
при обращении
к стандартной
функции выбранного
языка программирования
– датчику случайных
чисел.
б)
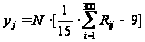 .
Для исследований предусмотреть следующие объёмы измерений для каждой из случайных величин: 100, 200, …, 1000 (объёмы выборок).
Произвести статистический анализ каждой из полученных выборок для двух случайных величин в следующей последовательности:
а) найти размах варьирования;
б) определить целесообразное количество групп по формуле Стерджесса, построить группировку и интервальный ряд;
в) привести графическое изображение полигона частот, гистограммы, кумуляты и эмпирической функции распределения;
г) вычислить
и проанализировать
точечные оценки
 и
 для простого
и интервального
рядов; построить
и проанализировать
зависимость
величины точечной
оценки от объема
выборки и от
номера эксперимента
(10 выборок для
объема выборки
1000);
д) построить
доверительные
интервалы для
и
 ,
используя
различные
значения
доверительной
вероятности
(0,9; 0,95; 0,975; 0,995; 0,999) и проанализировать
зависимость
длины доверительного
интервала от
объёма выборки
и от величины
доверительной
вероятности;
е) вычислить и проанализировать медиану, коэффициент вариации, коэффициент асимметрии и эксцесс, моду; проанализировать зависимости числовых характеристик от объема выборки;
ж) оценить однородность каждой из выборок, используя:
1) коэффициент вариации;
2) метод
 -статистик
Ирвина.
з) определить, близки ли к нормальному распределению полученные эмпирические распределения на основе:
1) анализа числовых характеристик положения и вариации;
2) на основе критерия согласия Пирсона;
и) по виду гистограмм выдвинуть гипотезу о предполагаемых законах распределений исследуемых случайных величин, определить оценки параметров предполагаемых распределений (метод моментов и максимального правдоподобия) и проверить гипотезу о законе распределения по критерию Пирсона.
Введение
С давних пор человечество осуществляло учет многих сопутствующих его жизнедеятельности явлений и предметов, а также связанных с ними вычислений. Люди получали разносторонние, хотя и различающиеся полнотой сведения на различных этапах общественного развития. Данные учитывались повседневно в процессе принятия хозяйственных решений, а в обобщенном виде и на государственном уровне – при определении направления экономической и социальной политики, характера внешнеполитической деятельности.
Выполняя самые разнообразные функции сбора, систематизации и анализа сведений, характеризующих экономическое и социальное развитие общества, статистика всегда играла роль главного поставщика факторов для управленческих, научно-исследовательских и прикладных практических нужд различного рода структур, организаций и населения. Роль статистики в нашей жизни настолько значительна, что люди, часто не задумываясь и не осознавая, постоянно используют элементы статистической методологии в повседневной практике.
Применяя статистические методы в экономических исследованиях, можно осуществлять стратегическое планирование, а также анализировать и прогнозировать рыночную конъюнктуру, уменьшая степень неопределенности в отношении внешнего окружения.
С увеличением объемов информации, становится актуальным вопрос ее компьютерной обработки. Получение навыков обработки и анализа экспериментальных данных с помощью компьютера, например, в пакете STATISTICA дает возможность получить полную информацию об исследуемом объекте и найти оптимальное решение конкретной поставленной задачи.
1. Генерация исходных данных
В данной курсовой работе вместо статистического наблюдения используются случайные величины, сгенерированные по следующим формулам:
1) непрерывная случайная величина X, определяемая по формуле 1.1;
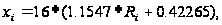 (1.1)
2) непрерывная случайная величина У, определяемая по формуле 1.2.
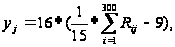 (1.2)
где
 ,
 - значения случайной
величины X
и У в различных
опытах;
 - случайное
число, равномерно
распределенное
на отрезке [0,
1], возвращаемое
при обращении
к стандартной
функции на
выбранном языке
программирования
к датчику случайных
чисел; Для генерации
исходных данных
были использованы
следующие
методы:
1) Для случайной
величины
 в окне Variable
в поле Long
Name была введена
формула 1.3:
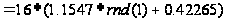 (1.3)
2) Для случайной
величины
 был создан
программный
имитатор в
модуле STATISTICA
BASIC. Реализация
алгоритма
генерации
данных в модуле
STATISTICA BASIC
приведена в
приложении
А.
В результате были получены выборки, объемом 100, 200…1000 значений для каждой из случайных величин.
2. Первичная обработка результатов наблюдения
2.1 Построение вариационного ряда
Вариационный ряд - упорядоченные по возрастанию значения признака.
Построение вариационного ряда в пакете STATISTICA производилось следующим образом:
в модуле Basic Statistics and Tables: Analysis → Frequency tables → кнопка Variables для выбора переменной → отметили All distinct values → ОК.
Размах варьирования
– абсолютная
величина разности
между максимальным
 и минимальным
 значениями
(вариантами)
изучаемого
признака:
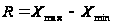 (2.1)
Построение размаха варьирования в пакете STATISTICA производилось следующим образом:
в модуле Basic Statistics and Tables: Analysis → Descriptive statistics → Variables (выбрать переменную) → нажали Box & whisker plot for all variables → выбрали Median / Quart. / Range → ОК.
Значения размаха варьирования для заданных выборок в таблице 2.1.
Таблица 2.1 – Размах варьирования для заданных выборок
|
|
|
|||||
| Выборка |
|
|
|
|
|
|
| 100 | 25,201 | 6,993 | 18,209 | 28,805 | 2,429 | 26,376 |
| 500 | 25,110 | 6,984 | 18,126 | 33,695 | 0,196 | 33,499 |
| 1000 | 25,237 | 6,711 | 18,466 | 33,962 | -1,574 | 35,536 |


Случайная
величина
имеет меньший
размах, чем
случайная
величина
.
2.2 Группировка статистических данных
Число групп определяется по формуле Стерджесса (2.2):
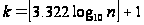 ,
(2.2)
где
 – количество
групп;
 – объем выборки.
После определения числа групп следует определить интервалы группировки - значения варьирующего признака, лежащие в определенных границах. Величина равного интервала определяется по формуле (2.3):

 ,
где
– число групп
интервалов,
– размах
выборки .
Ниже приведены значения числа групп интервалов для всех выборок:
При
 :
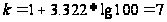 .
При
 :
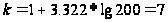 .
При
 :
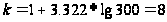 .
При
 :
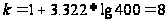 .
При
 :
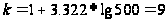 .
При
 :
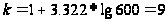 .
При
 :
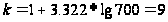 .
При
 :
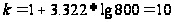 .
При
 :
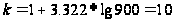 .
При
 :
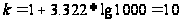 .
Построение интервального ряда в пакете STATISTICA производилось следующим образом:
а) Analysis→Frequency tables→Variables(выбрали переменную);
б) установили количество интервалов в “No. of exact intervals”, посчитанных по формуле Стерджесса;
в) установили флажки в Display options:
Cumulative frequencies – накопленные частоты;
Percentages - частости;
Cumulative percentages – накопленные частости.
Интервальные ряды по каждой выборке для случайных величин X и Y приведены в таблицах 2.2-2.7 и Д.1-Д.14.
Таблица 2.2 -
Интервальный
ряд СВ
при
| Частота | Кумул. частота | Процент | Кумул. процент | |
| 5,475289<x<=8,510050 | 8 | 8 | 8,00000 | 8,0000 |
| 8,510050<x<=11,54481 | 15 | 23 | 15,00000 | 23,0000 |
| 11,54481<x<=14,57957 | 16 | 39 | 16,00000 | 39,0000 |
| 14,57957<x<=17,61433 | 18 | 57 | 18,00000 | 57,0000 |
| 17,61433<x<=20,64909 | 20 | 77 | 20,00000 | 77,0000 |
| 20,64909<x<=23,68385 | 13 | 90 | 13,00000 | 90,0000 |
| 23,68385<x<=26,71862 | 10 | 100 | 10,00000 | 100,0000 |
Таблица 2.3 -
Интервальный
ряд СВ
при
| Частота | Кумул. частота | Процент | Кумул. процент | |
| 5,850935<x<=8,116734 | 25 | 25 | 5,00000 | 5,0000 |
| 8,116734<x<=10,38253 | 62 | 87 | 12,40000 | 17,4000 |
| 10,38253<x<=12,64833 | 64 | 151 | 12,80000 | 30,2000 |
| 12,64833<x<=14,91413 | 55 | 206 | 11,00000 | 41,2000 |
| 14,91413<x<=17,17993 | 70 | 276 | 14,00000 | 55,2000 |
| 17,17993<x<=19,44573 | 64 | 340 | 12,80000 | 68,0000 |
| 19,44573<x<=21,71153 | 74 | 414 | 14,80000 | 82,8000 |
| 21,71153<x<=23,97733 | 59 | 473 | 11,80000 | 94,6000 |
| 23,97733<x<=26,24313 | 27 | 500 | 5,40000 | 100,0000 |
Таблица 2.4 -
Интервальный
ряд СВ
при
| Частота | Кумул. частота | Процент | Кумул. процент | |
| 5,745344<x<=7,797069 | 50 | 50 | 5,00000 | 5,0000 |
| 7,797069<x<=9,848795 | 106 | 156 | 10,60000 | 15,6000 |
| 9,848795<x<=11,90052 | 134 | 290 | 13,40000 | 29,0000 |
| 11,90052<x<=13,95225 | 88 | 378 | 8,80000 | 37,8000 |
| 13,95225<x<=16,00397 | 117 | 495 | 11,70000 | 49,5000 |
| 16,00397<x<=18,05570 | 121 | 616 | 12,10000 | 61,6000 |
| 18,05570<x<=20,10742 | 107 | 723 | 10,70000 | 72,3000 |
| 20,10742<x<=22,15915 | 117 | 840 | 11,70000 | 84,0000 |
| 22,15915<x<=24,21087 | 111 | 951 | 11,10000 | 95,1000 |
| 24,21087<x<=26,26260 | 49 | 1000 | 4,90000 | 100,0000 |
Таблица 2.5 -
Интервальный
ряд СВ
при
| Частота | Кумул. | Процент | Кумул. | |
| 0,231076<x<=4,627075 | 1 | 1 | 1,00000 | 1,0000 |
| 4,627075<x<=9,023072 | 6 | 7 | 6,00000 | 7,0000 |
| 9,023072<x<=13,41907 | 20 | 27 | 20,00000 | 27,0000 |
| 13,41907<x<=17,81507 | 31 | 58 | 31,00000 | 58,0000 |
| 17,81507<x<=22,21107 | 22 | 80 | 22,00000 | 80,0000 |
| 22,21107<x<=26,60706 | 17 | 97 | 17,00000 | 97,0000 |
| 26,60706<x<=31,00306 | 3 | 100 | 3,00000 | 100,0000 |
Таблица 2.6 -
Интервальный
ряд СВ
при
| Частота | Кумул. | Процент | Кумул. | |
| -1,89766<x<=2,289667 | 2 | 2 | 0,40000 | 0,4000 |
| 2,289667<x<=6,476997 | 21 | 23 | 4,20000 | 4,6000 |
| 6,476997<x<=10,66433 | 59 | 82 | 11,80000 | 16,4000 |
| 10,66433<x<=14,85166 | 125 | 207 | 25,00000 | 41,4000 |
| 14,85166<x<=19,03899 | 147 | 354 | 29,40000 | 70,8000 |
| 19,03899<x<=23,22632 | 99 | 453 | 19,80000 | 90,6000 |
| 23,22632<x<=27,41365 | 39 | 492 | 7,80000 | 98,4000 |
| 27,41365<x<=31,60098 | 7 | 499 | 1,40000 | 99,8000 |
Таблица 2.7 -
Интервальный
ряд СВ
при
| Частота | Кумул. | Процент | Кумул. | |
| -3,54794<x<=0,400491 | 5 | 5 | 0,50000 | 0,5000 |
| 0,400491<x<=4,348925 | 9 | 14 | 0,90000 | 1,4000 |
| 4,348925<x<=8,297359 | 61 | 75 | 6,10000 | 7,5000 |
| 8,297359<x<=12,24579 | 177 | 252 | 17,70000 | 25,2000 |
| 12,24579<x<=16,19423 | 279 | 531 | 27,90000 | 53,1000 |
| 16,19423<x<=20,14266 | 267 | 798 | 26,70000 | 79,8000 |
| 20,14266<x<=24,09110 | 154 | 952 | 15,40000 | 95,2000 |
| 24,09110<x<=28,03953 | 38 | 990 | 3,80000 | 99,0000 |
| 28,03953<x<=31,98797 | 8 | 998 | 0,80000 | 99,8000 |
| 31,98797<x<=35,93640 | 2 | 1000 | 0,20000 | 100,0000 |
2.3 Графическое изображение рядов распределения
Графическое изображение интервальных рядов включает построения полигона частот, гистограммы и кумуляты.
В пакете STATISTICA построение полигона происходит следующим образом:
а) Analysis → Frequency tables → Variables (выбрать переменную);
б) установить количество интервалов в “No. of exact intervals”;
в) Frequency tables → Count;
г) нажать правую кнопку мыши и из выпадающего списка выбрать “Custom Graphs”;
д) 2D Graphs → Graph Type → Line Plot. [1]
Построение кумуляты:
а)Analysis → Frequency tables → Variables (выбрать переменную);
б) установить количество интервалов в “No. of exact intervals”;
в) Frequency tables → Cumul. Count;
г) нажать правую кнопку мыши и выбрать “Custom Graphs”;
д) 2D Graphs → Graph Type
→ Line Plot (Bar
).
Построение гистограммы происходит следующим образом:
а) Analysis → Frequency tables → Variables (выбрать переменную);
б) установить количество интервалов в “No. of exact intervals”;
в) Frequency tables → Percent;
г) нажать правую кнопку мыши и из выпадающего списка выбрать “Custom Graphs”;
д) 2D Graphs → Graph Type
→ Bar
2.4 Точечные оценки средних показателей
Точечная оценка математического ожидания по вариационному ряду вычисляется по формуле (2.4):

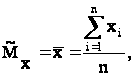
где
 – значения
элементов
выборки.
Оценка дисперсии по вариационному ряду вычисляется по формуле (2.5).

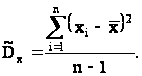
Вычисление оценки математического ожидания по интервальному вариационному ряду осуществляется по формуле (2.6):

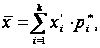
где
 –
середина
-го
интервала;
 – статистическая
вероятность
(частость) попадания
в
-тый
интервал.
Оценка дисперсии для интервального ряда вычисляется по формуле (2.7):

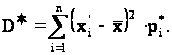
Вычисление точечных оценок по вариационному ряду в пакете STATISTICA:
Analysis → Descriptive statistics → Categorization → Number of intervals (установить количество интервалов) → More statistics → Mean, Variance. [2]
Значения точечных оценок математического ожидания и дисперсии для простого и интервального рядов приведены в таблице 2.8.
Таблица 2.8 – Оценки математического ожидания и дисперсии
| Выборка | Математическое ожидание | Дисперсия | ||
| Простой ряд | Интервальный ряд | Простой ряд | Интервальный ряд | |
|
|
16,254 | 16,279 | 27,849 | 28,517 |
|
|
16,189 | 16,174 | 26,259 | 26,598 |
|
|
15,950 | 16,006 | 27,608 | 28,330 |
|
|
16,668 | 16,936 | 31,125 | 31,113 |
|
|
15,989 | 16,007 | 30,406 | 31,242 |
|
|
15,792 | 15,740 | 27,059 | 28,636 |
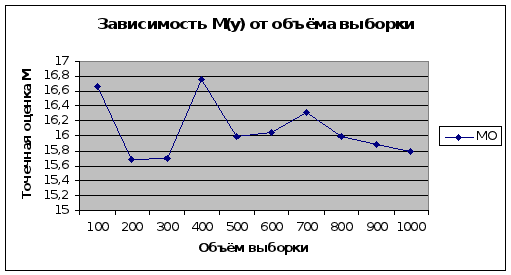
Из приведенных данных видно, что полученные оценки математического ожидания и дисперсии по вариационному (простому) и интервальному рядам имеют близкие значения. Причем, чем больше объем выборки, тем более точный результат. От номера эксперимента, то есть от количества испытаний величины точечной оценки не зависят. Это видно на рисунках 2.25 – 2.32.
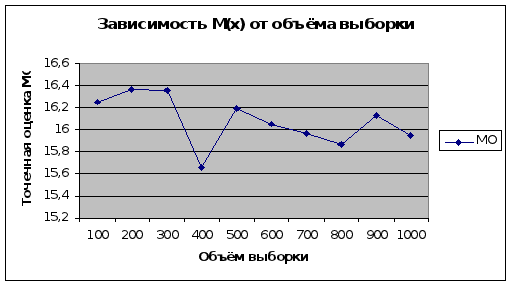
Рисунок
2.25 - Зависимость
 от объема выборки
для
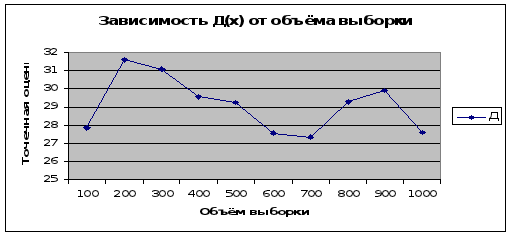
Рисунок
2.26 - Зависимость
 от объема выборки
для