Имитационная модель СТО с использованием программы С++
3) Свойством ординарности, которое выражает практическую невозможность одновременного поступления двух или более требований (вероятность такого события неизмеримо мала по отношению к рассматриваемому промежутку времени, когда последний устремляют к нулю).
При простейшем потоке требований распределение требований, поступающих в систему подчиняются закону распределения Пуассона:
вероятность  того, что в обслуживающую систему за время t поступит именно k требований:
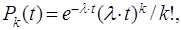
где . - среднее число требований,
поступивших на обслуживание в единицу времени.
На практике условия простейшего потока не всегда строго выполняются. Часто имеет место нестационарность процесса (в различные часы дня и различные дни месяца поток требований может меняться, он может быть интенсивнее утром или в последние дни месяца). Существует также наличие последействия, когда количество требований на отпуск товаров в конце месяца зависит от их удовлетворения в начале месяца. Наблюдается и явление неоднородности, когда несколько клиентов одновременно пребывают на склад за материалами. Однако в целом пуассоновский закон распределения с достаточно высоким приближением отражает многие процессы массового обслуживания.
Кроме того, наличие пуассоновского потока требований можно определить статистической обработкой данных о поступлении требований на обслуживание. Одним из признаков закона распределения Пуассона является равенство математического ожидания случайной величины и дисперсии этой же величины, т.е.

Одной из важнейших характеристик обслуживающих устройств, которая определяет пропускную способность всей системы, является время обслуживания.
Время обслуживания одного
требования ( )- случайная величина, которая может изменятся в большом
диапазоне. Она зависит от стабильности работы самих обслуживающих устройств,
так и от различных параметров, поступающих в систему, требований (к примеру,
различной грузоподъемности транспортных средств, поступающих под погрузку или
выгрузку.
Случайная величина полностью характеризуется законом распределения, который определяется на
основе статистических испытаний.
На практике чаще всего принимают гипотезу о показательном законе распределения времени обслуживания.
Показательный закон распределения времени обслуживания имеет место тогда, когда плотность распределения резко убывает с возрастанием времени t. Например, когда основная масса требований обслуживается быстро, а продолжительное обслуживание встречается редко. Наличие показательного закона распределения времени обслуживания устанавливается на основе статистических наблюдений.
При показательном законе
распределения времени обслуживания вероятность  события, что время обслуживания продлиться не более чем t, равна:
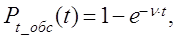
где v - интенсивность обслуживания одного требования одним обслуживающим устройством, которая определяется из соотношения:
 , (1)
где 
 - среднее время обслуживания
одного требования одним обслуживающим устройством.
Следует заметить, что если закон распределения времени обслуживания показательный, то при наличии нескольких обслуживающих устройств одинаковой мощности закон распределения времени обслуживания несколькими устройствами будет также показательным:
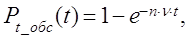
где n - количество обслуживающих устройств.
Важным параметром СМО
является коэффициент загрузки  , который определяется как отношение
интенсивности поступления требований к интенсивности обслуживания v.
 (2)
где a - коэффициент загрузки; - интенсивность поступления требований в
систему; v - интенсивность обслуживания одного требования одним
обслуживающим устройством.
Из (1) и (2) получаем, что
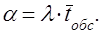
Учитывая, что - интенсивность
поступления требований в систему в единицу времени, произведение  показывает количество
требований, поступающих в систему обслуживания за среднее время обслуживания
одного требования одним устройством.
Для СМО с ожиданием количество обслуживаемых устройств п должно быть строго больше коэффициента загрузки (требование установившегося или стационарного режима работы СМО) :
 .
В противном случае число поступающих требований будет больше суммарной производительности всех обслуживающих устройств, и очередь будет неограниченно расти.
Для СМО с отказами и
смешанного типа это условие может быть ослаблено, для эффективной работы этих
типов СМО достаточно потребовать, чтобы минимальное количество обслуживаемых
устройств n было не меньше коэффициента загрузки
: 
1.3 Процесс имитационного моделирования
Как уже было отмечено ранее, процесс последовательной разработки имитационной модели начинается с создания простой модели, которая затем постепенно усложняется в соответствии с требованиями, предъявляемыми решаемой проблемой. В процессе имитационного моделирования можно выделить следующие основные этапы:
1. Формирование проблемы : описание исследуемой проблемы и определение целей исследования.
2. Разработка модели: логико-математическое описание моделируемой системы в соответствии с формулировкой проблемы.
3. Подготовка данных: идентификация, спецификация и сбор данных.
4. Трансляция модели: перевод модели на язык, приемлемый для используемой ЭВМ.
5. Верификация: установление правильности машинных программ.
6. Валидация: оценка требуемой точности и соответствие имитационной модели реальной системе.
7. Стратегическое и тактическое планирование: определение условий проведения машинного эксперимента с имитационной моделью.
8. Экспериментирование: прогон имитационной модели на ЭВМ для получения требуемой информации.
9. Анализ результатов: изучение результатов имитационного эксперимента для подготовки выводов и рекомендаций по решению проблемы.
10. Реализация и документирование: реализация рекомендаций, полученных на основе имитации, составление документации по модели и ее использованию.
Рассмотрим основные этапы имитационного моделирования. Первой задачей имитационного исследования является точное определение проблемы и детальная формулировка целей исследования. Как правило, определение проблемы является непрерывным процессом , который обычно осуществляется в течении всего исследования. Оно пересматривается по мере более глубокого понимания исследуемой проблемы и возникновения новых ее аспектов.
Как только сформулировано начальное определение проблемы, начинается этап построения модели исследуемой системы. Модель включает статистическое и динамическое описание системы. В статистическом описании определяются элементы системы и их характеристики, а в динамическом- взаимодействие элементов системы, в результате которых происходит изменение ее состояния во времени.
Процесс формирования модели во многом является искусством. Разработчик модели должен понять структуру системы, выявить правила ее функционирования и суметь выделить в них самое существенное, исключив ненужные детали. Модель должна быть простой для понимания и в то же время достаточно сложной, чтобы реалистично отображать характерные черты реальной системы. Наиболее важными являются принимаемые разработчиком решения относительно того, верны ли принятые упрощения и допущения, какие элементы и взаимодействия между ними должны быть включены в модель. Уровень детализации модели зависит от целей ее создания. Необходимо рассматривать только те элементы, которые имеют существенное значение для решения исследуемой проблемы. Как на этапе формирования проблемы, так и на этапе моделирования необходимо тесное взаимодействие между разработчиком модели и ее пользователями. Кроме того, тесное взаимодействие на этапах формулирования проблемы и разработки модели создает у пользователя уверенность в правильности модели, поэтому помогает обеспечить успешную реализацию результатов имитационного исследования.
На этапе разработки модели определяются требования к входным данным. Некоторые из этих данных могут уже быть в распоряжении разработчика модели, в то время как для сбора других потребуется время и усилия. Обычно значение таких входных данных задаются на основе некоторых гипотез или предварительного анализа. В некоторых случаях точные значения одного (и более) входных параметров оказывают небольшое влияние на результаты прогонов модели. Чувствительность получаемых результатов к изменению входных данных может быть оценена путем проведения серии имитационных прогонов для различных значений входных параметров. Имитационная модель, следовательно, может использоваться для уменьшения затрат времени и средств на уточнение входных данных. После того как разработана модель и собраны начальные входные данные, следующей задачей является перевод модели в форму, доступную для компьютера.
На этапах верификации и валидации осуществляется оценка функционирования имитационной модели. На этапе верификации определяется, соответствует ли запрограммированная для ЭВМ модель замыслу разработчика. Это обычно осуществляется путем ручной проверки вычисления, а также может быть использован и ряд статистических методов.
Установление адекватности имитационной модели исследуемой системы осуществляется на этапе валидации. Валидация модели обычно выполняется на различных уровнях. Специальные методы валидации включают установление адекватности путем использования постоянных значений всех параметров имитационной модели или путем оценивания чувствительности выходов к изменению значений входных данных. В процессе валидации сравнение должно осуществляться на основе анализа как реальных, так и экспериментальных данных о функционировании системы.
Условия проведения машинных прогонов модели определяется на этапах стратегического и тактического планирования. Задача стратегического планирования заключается в разработке эффективного плана эксперимента, в результате которого выясняется взаимосвязь между управляемыми переменными, либо находится комбинация значений управляемых переменных, минимизация или максимизация имитационной модели. В тактическом планировании в отличии от стратегического решается вопрос о том, как в рамках плана эксперимента провести каждый имитационный прогон, чтобы получить наибольшее количество информации из выходных данных. Важное место в тактическом планировании занимают определение условий имитационных прогонов и методы снижения дисперсии среднего значения отклика модели.
Следующие этапы в процессе имитационного исследования- проведение машинного эксперимента и анализ результатов- включают прогон имитационной модели на ЭВМ и интерпретацию полученных выходных данных. Последним этапом имитационного исследования является реализация полученных решений и документирование имитационной модели и ее использование. Ни одни из имитационных проектов не должен считаться законченным до тех пор, пока их результаты не были использованы в процессе принятия решений. Успех реализации во многом зависит от того, насколько правильно разработчик модели выполнил все предыдущие этапы процессов имитационного исследования. Если разработчик и пользователь работали в тесном контакте и достигли взаимопонимания при разработке модели и ее исследовании, то результат проекта скорее всего будет успешно внедряться. Если же между ними не было тесной взаимосвязи, то, несмотря на элегантность и адекватность имитационного моделирования, сложно будет разработать эффективные рекомендации.
Вышеперечисленные этапы редко выполняются в строго заданной последовательности, начиная с определения проблемы и кончая документированием. В ходе имитационного моделирования могут быть сбои в прогонах модели, ошибочные допущения, от которых в дальнейшем приходится отказываться, переориентировки целей исследования, повторные оценки и перестройки модели. Такой процесс позволяет разработать имитационную модель, которая дает верную оценку альтернатив и облегчает процесс принятия решений.
Глава 2. Распределения и генераторы псевдослучайных чисел
Ниже будут использованы следующие обозначения:
X - случайная величина; f(х) - функция плотности вероятности X; F(х) - функция вероятности X;
а - минимальное значение;
b - максимальное значение;
m – мода;
μ -математическое ожидание М[Х]; σ2 —дисперсия М[(Х-μ)2];
σ -среднеквадратичное отклонение; α-параметр функции плотности вероятности;
β - параметр функции плотности вероятности.
2.1 Виды распределений
2.1.1 Равномерное распределение
Функция плотности вероятности равномерного распределения задает одинаковую вероятность для всех значений, лежащих между минимальным и максимальным значениями переменной. Другими словами, вероятность того, что значение попадает в указанный интервал. пропорциональна длине этого интервала. Применение равномерного распределения часто вызвано полным отсутствием информации о случайной величине, кроме ее предельных значений. Равномерное распределение называют также прямоугольным.
f (t) = при а ≤ t ≤ Ь.
Среднее
значение распределения равно μ =  , дисперсия равна σ2=
 .
Равномерно распределенная случайная величина X на отрезке [а, b] выражается через равномерно распределенную на отрезке [0, 1] случайную величину R формулой
X = а + (b - а) *R
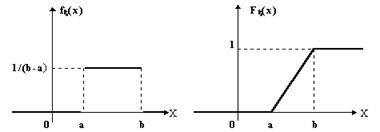
Рис.1 Графики функции распределения и плотности распределения:
2.1.2 Треугольное распределение
Треугольное распределение является более информативным, чем равномерное. Для этого распределения определяются три величины - минимум, максимум и мода. График функции плотности состоит из двух отрезков прямых, одна из которых возрастает при изменении X от минимального значения до моды, а другая убывает при изменении X от значения моды до максимума. Значение математического ожидания треугольного распределения равно одной трети суммы минимума, моды и максимума. Треугольное распределение используется тогда, когда известно наиболее вероятное значение на некотором интервале и предполагается кусочно-линейный характер функции плотности. Функция плотности вероятности треугольного распределения имеет вид:
|
|


μ= , σ2=
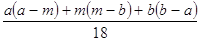 .
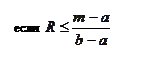
Треугольно распределенная случайная X связана со случайной величиной R, распределенной равномерно на [0,1], соотношением:
|
 .
|

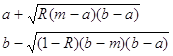
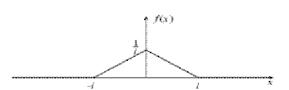
Рис.2 График плотности треугольного распределения
2.1.3 Экспоненциальное (показательное) распределение
Если вероятность того, что один и только один результат наступит на интервале Δt, пропорциональна Δt и если наступление результата не зависит от наступления других результатов, величины интервалов между результатами распределены экспоненциально. Другими словами, работа, продолжительность которой экспоненциально распределена имеет одинаковую вероятность завершения в течение любого последующего периода времени Δt. Таким образом, работа, выполняемая за t единиц времени, имеет ту же вероятность окончания в последующий период Δt, что и только что начатая работа. Подобное отсутствие временной обусловленности называется марковским свойством или свойством отсутствия последействия. Существует прямая связь между предположением об экспоненциальности распределения продолжительности работы и марковским свойством. Экспоненциальное распределение предполагает значительную вариабельность переменной. Если математическое ожидание продолжительности работы равно 1/α, то дисперсия равна 1/α2. По сравнению с большинством остальных распределений экспоненциальное обладает большей дисперсией.
Функция распределения:

|