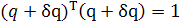Метод анализа главных компонентов регрессионной модели измерений средствами нейронных сетей
Размещено на /
Дипломная работа
на тему
Метод анализа главных компонентов регрессионной модели измерений средствами нейронных сетей
Содержание
Список сокращений
Введение
1. Организация нейронных сетей для вычисления дисперсионных характеристик случайных сигналов
1.1 Архитектуры нейронных сетей
1.2 Однослойные сети прямого распространения
1.3 Многослойные сети прямого распространения
1.4 Инварианты в структуре нейронной сети
1.5 Анализ главных компонентов алгоритмами самообучения нейронных сетей
1.5.1 Структура анализа главных компонентов
1.5.2 Основные представления данных
1.5.3 Матричная формулировка алгоритма самообучения
1.5.4 Анализ главных компонентов на основе фильтра Хебба
1.5.5 Исследование сходимости при решении главной компоненты сигнала
1.5.6 Оптимальность обобщенного алгоритма Хебба
1.5.7 Алгоритм GHA в сжатом виде
2. Оценка параметров регрессионных уравнений при аппроксимации дисперсионных распределений методом АГК
2.1 Организация наблюдений и регрессионные методы оценки параметров
2.2.1 Оценивание по конечному числу наблюдений
2.1.2 Оценки по методу наименьших квадратов
2.2 Нейронные сети и статистические характеристики
2.3 Различие нейронных сетей и статистики
2.4 Нейронные сети и статистические экспертные системы
2.5 Сети интервальных нейронов
2.6 Сети и свойства численных структур регрессионного анализа
2.6.1 Идея сингулярного разложения матрицы данных
2.6.2 Линейный МНК
2.7 Нелинейные решения проблем стандартного МНК
2.7.1 Аппроксимация линейным или нелинейным МНК
2.7.2 Нелинейный МНК с использованием гессиана или без него
2.7.3 Нелинейный МНК как обратная коммуникация
2.8 Решение параметров регрессионного уравнения с использованием аппроксимации ковариационной матрицы по данным ГК при обучении НС
Заключение
Библиографический список использованной литературы
Список сокращений
АГК – анализ главных компонент;
БД – база данных;
ИТ – информационные технологии;
МНК – метод наименьших квадратов;
НС – нейронные сети;
ОС – операционная система;
ПК – персональный компьютер;
ПО – программное обеспечение;
ЦОС – цифровая обработка сигналов;
ЭВМ – электронная вычислительная машина;
Введение
Одно из современных направлений технических исследований – поиск адаптивных методов адаптации и формул нейронных сетей к традиционным задачам цифровой обработки сигналов (анализ Фурье, свертка) и регрессионному анализу (МНК и его модификации). Причем данные задачи НС решает путем перевода пространства данных в пространство признаков, фактически изменяя входные размерности и формируя гиперпространства для поиска решения. НС имеет универсальную структуру, что бы напрямую моделировать решение задач ЦОС и ряд косвенных методов получения характеристик стохастических сред, которые потом можно использовать традиционными способами оценки параметров регрессионных моделей на основе свойств отношения корреляций и спектров исходных регрессий.
Формирование пространства признаков с помощью унарных операторов, или их вещественных аналогов – ортогональных операторов (при ограниченной Евклидовой норме) – это основная особенность нейронных сетей, отличающая результат ее решений от методов ЦОС, регрессионного и спектрального анализа. Подобия их решений сеть находит на элементах анализа в пространстве признаков и самый простой способ обучения сети работает эффективней, чем, например, классический метод ЦОС при попытке того же разделения данных на признаки. Только специфичная формула сети прямого распространения способна с минимальной трудностью для алгоритмов ЭВМ построить систему независимых подмножеств – ортогональных подпространств собственных векторов, образующих совокупность унарных операторов преобразования пространства данных в пространство признаков той же или отличной размерности. Это принципиальное отличие НС от методов регрессионного анализа, у которых унарный оператор зависит от характеристик исходной среды и строится, например, минимизацией Евклидовой нормы вектора ошибки. Вектор имеет размерность только входного пространства данных, а условия для критерия его минимизации часто оказываются тривиальными, а отклонения, например в сторону корреляции нормируемых помех, уже приводит к несостоятельному результату оценки параметров или матрица корреляции данных, являющаяся основой минимизируемого функционала ошибки, становится вырожденной. В свою очередь, НС, преобразует пространство данных в пространство признаков, выполняя задачу статистического распознавания. Каждый признак на выходе нейрона получает собственный набор ортогональных векторов в виде весов этого нейрона, значения всех признаков в ортонормированных базисах также взаимно ортогональны. Это следует понимать как разложение исходного пространства данных в прямую сумму собственных подпространств, где собственными векторами являются веса нейронов, а собственными числами – значении их выходов после стадии самообучения. Эта общность на уровне линейных пространств способна порождать множество задач в области прикладного анализа в различных дисциплинах, с той разницей, что стадия анализа в НС наряду с компонентом анализа вычисляет совокупность собственных подсистем векторов в качестве унарного оператора, или ортогонального матричного оператора, например в виде ограниченной Евклидовой нормы.
Главной задачей в статистическом распознавании является выделение признаков или извлечение признаков. Под выделением признаков понимается процесс, в котором пространство данных преобразуется в пространство признаков, теоретически имеющее ту же размерность, что и исходное пространство. Однако обычно преобразования выполняются таким образом, чтобы пространство данных могло быть представлено сокращенным количеством "эффективных" признаков. Это актуально и для регрессионных сред, где часть «незначащих» дисперсий ковариационной матрицы данных могут быть значительно меньше дисперсии помех, что приводит к несостоятельной оценке параметров регрессионных моделей. По существу цель преобразования стохастической среды в пространство признаком можно разделить на два существенных направления: выделение характеристик среды для методов корреляционного и дисперсионного анализа; изменение размерности исходных данных среды с потерей несущественных признаков в плане минимума их среднеквадратичной ошибки. Эти два направления должны выполнить задачу обеспечения регрессионных методов невырожденными унитарными операторами, когда априорной информации об ошибках измерений недостаточно или она трудно извлекаема из исходных данных среды.
Анализ главных компонентов осуществляет выделение главных признаков на этапе анализа; сокращает размерности, игнорируя незначащие величины признаков; при синтезе исходных данных проводит линейное преобразование, при котором сокращение будет оптимальным в смысле среднеквадратической ошибки. При осуществлении метода НС на исходных данных стохастической среды, собственными числами (выход нейрона) являются распределения дисперсий, собственные вектора (веса нейрона) – ортонормированная система собственного числа, образующая с ним собственное подпространство, где путем настройки ориентации весов решается задача экстремума для дисперсии. Совокупности дисперсий образуют диагональную матрицу – численный аналог корреляционной матрицы исходных данных, а совокупность весовых собственных подпространств формирует унарный, в вещественном смысле ортогональный, оператор. Матричное произведение ортонормированной системы и входной реализации случайной величины анализируют главные компоненты признаков, а дуальная операция признаков относительно ортогональной матрицы воссоздает исходный вектор данных стохастической среды. При этом выделяются главные признаки в дисперсионном распределении (диагональный оператор собственных чисел) при свойстве маленькой дисперсии отдельных компонентов. Таким образом, АКГ максимизирует скорость уменьшения дисперсии и вероятность правильного выбора. Алгоритмы обучения НС, основанные на принципах Хебба, после стадии самообучения НС осуществляют анализ главных компонентов интересующего вектора данных. Основным объектом АГК для регрессионного и дисперсионного анализа являются дисперсионные распределения, полученные дисперсионным зондом при настройке собственных подпространств в виде весов НС. Но, в отличие от критерия минимизации регрессионных методов, здесь применяется критерий определения таких единичных векторов из совокупности весов нейрона, для которых дисперсионный зонд принимает экстремальные значения. После настройки весов однослойной сети имеется решение – диагональная матрица, состоящая из собственных значений корреляционной матрицы данных (ортогональное преобразование подобия) и ортогональная матрица из объединения собственных векторов. Матричное произведение этих объектов приводит к результату, или получению числового оригинала дисперсий – корреляционной матрицы данных. То есть сама матрица корреляции может быть выражена в терминах своих собственных векторов и собственных значений по выражению спектральной теоремы. Преобразование подобия, спектральные операции синтеза данных являются теми общностями, на которые следует обратить внимание при регрессионном моделировании, если традиционные методы при малости априорной информации не позволяют получить достаточный объем данных из характеристик стохастической среды.
Еще раз уточним различие принципов АГК и оценивания параметров статистических регрессионных моделей в достижении одной цели – получения характеристик стохастических сред, в особенности наиважнейшей из них – корреляционной функции входного пространства данных. Именно разница принципов позволяет достигать результата при нехватке априорной информации – если мала априорная информация о помехах, то решение обращается к дисперсионным моделям случайных реализаций с их собственным ортонормированным пространством.
• Проекции дисперсий реализации случайной величины в ортонормированном векторном пространстве помех должны быть минимальны. Тем самым минимизируется корреляция аддитивных помех с выходом модели. Преимущество подхода – исследуется только модель шума, физическая природа полезного сигнала игнорируется. При этом параметры подбираются стохастически и функция оценки имеет определенный тип распределения.
• При АГК наоборот учитывается корреляционная модель сигнала, определяется ортогональный оператор таким образом, что бы проекции коэффициентов, предоставляемые корреляционной матрицей, были максимальны. Тогда на выходе нейронов в пространстве признаков формируются скаляры – дисперсии исходных реализаций случайной величины, или собственные числа корреляционной матрицы. Это преобразование подобия – результат самообучения сети, по результату которого возможно спектральное воссоздание корреляционной матрицы с максимальными дисперсиями в пространстве данных. Это и есть противоположность минимальной дисперсии данных в ортонормированном пространстве вектора помех. Максимум дисперсий данных в АГК и минимум функционала ошибки регрессионных линейных статических методов способствуют состоятельным оценкам решения.
Теперь можно сделать выводы, касающиеся продукции анализа главных компонентов по отношению к регрессионному анализу.
• Собственные векторы матрицы корреляции случайного вектора данных с нулевым средним определяют настраиваемые веса НС; они представляют основные направления, вдоль которых дисперсионный зонд (выхода нейронов) принимает экстремальные значения.
• Экстремальные значения дисперсионного зонда – это собственные числа корреляционной матрицы входных данных; последовательность чисел образует преобразование подобия этой матрицы в виде диагонального оператора.
Формально результат анализа – это проекции вектора данных на основные направления, представленные единичными векторами в виде весов каждого нейрона НС. Эти проекции называются главными компонентами и их количество соответствует размерности вектора данных.
Итак, выбрав тему работы на принципах АГК, нужно представлять выполняемые задачи как проблемы математического анализа на граничном пересечении технологий и методов корреляционной оценки параметров стохастических моделей и адаптивных алгоритмов пространственных преобразований. Для основного объема работы следует выбрать три формулы АГК на базе ортогонального оператора, полученного средствами НС.
• Формула ортогонального преобразования получения подобия корреляционной матрицы данных – диагонального оператора из дисперсий пространства данных.
• Формула анализа – вычисление проекции вектора реализации случайной величины в каждой ортогональной подсистеме собственных векторов.
• Спектральная формула синтеза ковариационной матрицы по исходной реализации случайного вектора данных.
Формула синтеза исходных данных с сокращением размерности может не приниматься во внимание, так как она в основном относится к задачам распознавания образов в пространстве признаков; проблема текущей темы – расчет скалярных и векторных величин в пространстве признаков НС для решения плохо обусловленных задач регрессионного анализа.
Актуальность работы: возможность использования эффективных численных методов на алгоритмах ЭВМ при решении регрессионных методов, но в условиях дефицита априорной информации о помехах.
Целю работы является разработка технологии применения метода АГК в решении плохо обусловленных задач статического регрессионного анализа.
Основные задачи, определенные в соответствии с поставленной целью квалификационной работы:
– анализ существующих методов идентификации статических моделей статистических объектов;
– анализ основных проблем решения регрессионных задач линейными методами при дефиците априорной информации о помехах;
– изучение пространственных характеристик АГК и структур НС при обработке ими стохастических сред;
– создание на основе выявленных критериев состоятельности методов АГК описания принципов адаптации АГК к проблемам регрессионного анализа;
– модернизация классических технологий получения дисперсионных характеристик стохастических сред алгоритмами самообучения НС в пространстве признаков;
– составление алгоритмов на основе АГК, содействующие регрессионному анализу, тесты эталонных моделей с истинными параметрами;
– составление ряда рекомендаций по использованию разработанных адаптивных алгоритмов с корреляционными методами получения оценок для регрессионных моделей.
1. Организация нейронных сетей для вычисления дисперсионных характеристик случайных сигналов
1.1 Архитектура сетей
Структура нейронных сетей тесно связана с используемыми алгоритмами обучения. Классификация алгоритмов обучения будет приведена в следующей главе, а вопросы их построения будут изучены в последующих главах. В данном разделе мы сосредоточим внимание на архитектурах сетей (структурах).
В общем случае можно выделить три фундаментальных класса нейросетевых архитектур.
1.2 Однослойные сети прямого распространения
В многослойной нейронной сети нейроны располагаются по слоям. В простейшем случае в такой сети существует входной слой (input layer) узлов источника, информация от которого передается на выходной слой (output layer) нейронов (вычислительные узлы), но не наоборот. Такая сеть называется сетью прямого распространения (feedforward) или ацикличной сетью (acyclic). На рис. 1.1 показана структура такой сети для случая четырех узлов в каждом из слоев (входном и выходном). Такая нейронная сеть называется однослойной (single-layer network), при этом под единственным слоем подразумевается слой вычислительных элементов (нейронов). При подсчете числа слоев мы не принимаем во внимание узлы источника, так как они не выполняют никаких вычислений.
1.3 Многослойные сети прямого распространения
Другой класс нейронных сетей прямого распространения характеризуется наличием одного или нескольких скрытых слоев (bidden layer), узлы которых называются скрытыми нейронами (hidden neuron), или скрытыми элементами (hidden unit). Функция последних заключается в посредничестве между внешним входным сигналом и выходом нейронной сети. Добавляя один или несколько скрытых слоев, мы можем выделить статистики высокого порядка.
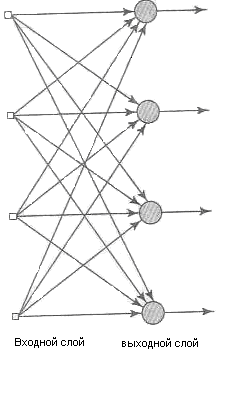
Рисунок 1.1 - Сеть прямого распространения с одним слоем нейронов
Такая сеть позволяет выделять глобальные свойства данных помощью локальных соединений за счет наличия дополнительных синаптических связей и повышения уровня взаимодействия нейронов. Способность скрытых нейронов выделять статистические зависимости высокого порядка особенно существенна, когда размер входного слоя достаточно велик.
Узлы источника входного слоя сети формируют соответствующие элементы шаблона активации (входной вектор), которые составляют входной сигнал, поступающий на нейроны (вычислительные элементы) второго слоя (т.е. первого скрытого слоя). Выходные сигналы второго слоя используются в качестве входных для третьего слоя и т.д. Обычно нейроны каждого из слоев сети используют в качестве входных сигналов выходные сигналы нейронов только предыдущего слоя. Набор выходных сигналов нейронов выходного (последнего) слоя сети определяет общий отклик сети на данный входной образ, сформированный узлами источника входного (первого) слоя. Сеть, показанная на рис. 1.1, называется сетью 10-4-2, так как она имеет 10 входных, 4 скрытых и 2 выходных нейрона. В общем случае сеть прямого распространения с m входами, h1нейронами первого скрытого слоя, h2 нейронами второго скрытого слоя и q нейронами выходного слоя называется сетью m — h1— h2—q-
Нейронная сеть, показанная на рис. 1.1, считается полносвязной (fully connected) в том смысле, что все узлы каждого конкретного слоя соединены со всеми узлами смежных слоев. Если некоторые из синаптических связей отсутствуют, такая сеть называется неполносвязной (partially connected).
1.4 Инварианты в структуре нейронной сети
Рассмотрим следующие физические явления.
Если исследуемый объект вращается, то соответствующим образом меняется и его образ, воспринимаемый наблюдателем.
В когерентном радаре, обеспечивающем информацию об амплитуде и фазе источников окружающей среды, эхо от движущегося объекта смещено по частоте. Это связано с эффектом Доплера, который возникает при радиальном движении объекта наблюдения относительно радара.
Диктор может произносить слова как тихим, так и громким голосом, как медленно, так и скороговоркой.
Для того чтобы создать систему распознавания объекта, речи или эхо-локации, учитывающую явления такого рода, необходимо принимать во внимание диапазон трансформаций (transformation) наблюдаемого сигнала. Соответственно основным требованием при распознавании образов является создание такого классификатора, который инвариантен к этим трансформациям. Другими словами, на результат классификации не должны оказывать влияния трансформации входного сигнала, поступающего от объекта наблюдения.
Существуют как минимум три приема обеспечения инвариантности нейронной сети классификации к подобным трансформациям.
1. Структурная инвариантность (invariance by structure). Инвариантность может быть привнесена в нейронную сеть с помощью соответствующей структуризации. В частности, синаптические связи между отдельными нейронами сети строятся таким образом, чтобы трансформированные версии одного и того же сигнала вызывали один и тот же выходной сигнал. Рассмотрим для примера нейросетевую классификацию входного сигнала, которая должна быть инвариантна по отношению к плоскому вращению изображения относительно своего центра. Структурную инвариантность сети относительно вращения можно выразить следующим образом. Пусть Wji — синаптический вес нейрона j, связанного с пикселем i входного изображения. Если условие Wji = Wjk выполняется для всех пикселей j и k, лежащих на равном удалении от центра изображения, нейронная сеть будет инвариантной к вращению. Однако, для того чтобы обеспечить инвариантность относительно вращения, нужно дублировать синаптические веса Wji всех пикселей, равноудаленных от центра изображения. Недостатком структурной инвариантности является то, что количество синаптических связей изображения даже среднего размера будет чрезвычайно велико.

Рисунок 1.2 - Диаграмма системы, использующей пространство инвариантных признаков
2. Инвариантность по обучению (invariance by training). Нейронные сети обладают естественной способностью классификации образов. Эту способность можно использовать для обеспечения инвариантности сети к трансформациям. Сеть обучается на множестве примеров одного и того же объекта, при этом в каждом примере объект подается в несколько измененном виде (например, снимки с разных ракурсов). Если количество таких примеров достаточно велико и если нейронная сеть обучена отличать разные точки зрения на объект, можно ожидать, что эти данные будут обобщены и сеть сможет распознавать ракурсы объекта, которые не использовались при обучении. Однако с технической точки зрения инвариантность по обучению имеет два существенных недостатка. Во-первых, если нейронная сеть была научена распознавать трансформации объектов некоторого класса, совсем не обязательно, что она будет обладать инвариантностью по отношению к трансформациям объектов других классов. Во-вторых, такое обучение является очень ресурсоемким, особенно при большой размерности пространства признаков.
3. Использование инвариантных признаков (invariant feature space). Третий метод создания инвариантного нейросетевого классификатора проиллюстрирован на рис. 1.2. Он основывается на предположении, что из входного сигнала можно выделить информативные признаки, которые описывают самую существенную информацию, содержащуюся в наборе данных, и при этом инвариантны к трансформациям входного сигнала. При использовании таких признаков в нейронной сети не нужно хранить лишний объем информации, описывающей трансформации объекта. В самом деле, при использовании инвариантных признаков отличия между разными экземплярами одного и того же объекта могут быть вызваны только случайными факторами, такими как шум. Использование пространства инвариантных признаков имеет три важных преимущества. Во-первых, уменьшается количество, признаков, которые подаются в нейронную сеть. Во-вторых, ослабляются требования к структуре сети. И, в-третьих, гарантируется инвариантность всех объектов по отношению к известным трансформациям. Однако этот подход требует хорошего знания специфики проблемы.
Итак, из вышесказанного можно сделать вывод, что использование инвариантных признаков является наиболее подходящим методом для обеспечения инвариантности нейросетевых классификаторов.
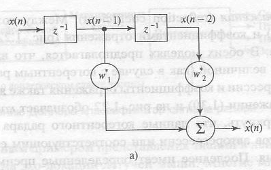
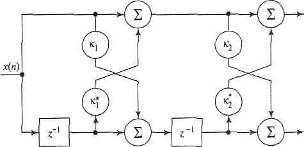
Рисунок 1.3 - Модель авторегрессии второго порядка: модель фильтра на линии задержки с отводами (а) и модель решетчатого фильтра (б).
Чтобы проиллюстрировать идею пространства инвариантных признаков, рассмотрим в качестве примера систему когерентного радара, используемую авиадиспетчерами, во входном сигнале которой может содержаться информация, поступающая от самолетов, стаи птиц и некоторых погодных явлений. Сигнал радара, отраженный от различных целей, имеет разные спектральные характеристики. Более того, экспериментальные исследования показали, что сигнал такого радара можно промоделировать с помощью авторегрессионного процесса (AR-процесса) среднего порядка (autoregressive process of moderate order). AR-процесс представляет собой особый вид регрессионной модели, описываемой следующим образом:
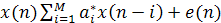 (1.1)
где
 —
коэффициенты
(coefficient)
авторегрессии;
М — порядок
модели (model
order);
x(n)
— входной сигнал
(input
signal);
e(n)
— помеха
(error),
представляющая
собой белый
шум. Модель,
описанная
формулой (1.1),
представляет
собой фильтр
на линии задержки
с отводами
(tapped-delay-line
filter),
показанный
на рис. 1.3, а
для М
= 2. Аналогично,
ее можно представить
как решетчатый
фильтр (lattice
filter),
показанный
на рис. 1.3, б, коэффициенты
которого называются
коэффициентами
отражения
(reflection
coefficient).
Между коэффициентами
авторегрессии
(рис. 1.3, а) и коэффициентами
отражения (рис.
1.3, б) существует
однозначное
соответствие.
В обеих моделях
предполагается,
что входной
сигнал x(n)
является комплексной
величиной (как
в случае с
когерентным
радаром), в которой
коэффициенты
авторегрессии
и коэффициенты
отражения также
являются
комплексными.
Звездочка в
выражении (1.1)
и на рис. 1.3 обозначает
комплексное
сопряжение.
Здесь важно
подчеркнуть,
что данные
когерентного
радара можно
описать множеством
коэффициентов
авторегрессии
или соответствующим
ему множеством
коэффициентов
отражения.
Последнее имеет
определенные
преимущества
в плане сложности
вычислений.
Для него существуют
эффективные
алгоритмы
получения
результата
непосредственно
из входных
данных. Задача
выделения
признаков
усложняется
тем фактом, что
движущиеся
объекты характеризуются
переменными
доплеровскими
частотами,
которые зависят
от скорости
объекта относительно
радара и создают
искажения в
спектре коэффициентов
отражения, по
которым определяются
признаки. Для
того чтобы
обойти эту
сложность, в
процессе вычисления
коэффициентов
отражения
следует использовать
инвариантность
Доплера (Doppler
invariance).
Угол фазы первого
коэффициента
отражения
принимается
равным доплеровской
частоте сигнала
радара. Соответственно
для всех коэффициентов
выполняется
нормировка
относительно
доплеровской
частоты, устраняющая
влияние сдвига
доплеровской
частоты. Для
этого определяется
новое множество
коэффициентов
отражения кm,
связанных с
множеством
исходных
коэффициентов
отражения Кm
следующим
соотношением:
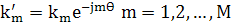 (1.2)
где
q
— фазовый угол
первого коэффициента
отражения.
Операция, описанная
выражением
(1.2), называется
гетеродинированием
(heterodyning).
Исходя из этого,
набор инвариантных
к смещению
Доплера признаков
(Doppler-invariant
radar
feature)
представляется
нормированными
коэффициентами
отражения
к'1,к'2, ...,
 -где
 —
единственный
коэффициент
этого множества
с вещественным
значением. Как
уже отмечалось,
основными
категориями
объектов, выделяемых
радарной установкой,
являются стаи
птиц, самолеты,
погодные явления
и поверхность
земли. Первые
три категории
объектов являются
движущимися,
в то время как
последняя —
нет Гетеродинные
спектральные
параметры эха
радара от земли
аналогичны
соответствующим
параметрам
эха от самолета.
Отличить эти
два сигнала
можно по наличию
у эха от самолета
небольшого
смещения Доплера.
Следовательно,
классификатор
радара должен
содержать
постпроцессор.
Он обрабатывает
результаты
классификации
с целью идентификации
класса земли.
Препроцессор
(preprocessor)
обеспечивает
инвариантность
признаков по
отношению к
смещению Доплера,
в то время как
постпроцессор
использует
смещение Доплера
для разделения
объектов "самолет"
и "земля" в
выходном сигнале.
1.5 Анализ главных компонентов алгоритмами самообучения нейронных сетей
Главной задачей в статистическом распознавании является выделение признаков (feature selection) или извлечение признаков (feature extraction). Под выделением признаков понимается процесс, в котором пространство данных (data space) преобразуется в пространство признаков (feature space), теоретически имеющее ту же размерность, что и исходное пространство. Однако обычно преобразования выполняются таким образом, чтобы пространство данных могло быть представлено сокращенным количеством "эффективных" признаков. Таким образом, остается только существенная часть информации, содержащейся в данных. Другими словами, множество данных подвергается сокращению размерности (dimensionality reduction). Для большей конкретизации предположим, что существует некоторый вектор х размерности т, который мы хотим передать с помощью i чисел, где i < т. Если мы просто обрежем вектор х, это приведет к тому, что среднеквадратическая ошибка будет равна сумме дисперсий элементов, "вырезанных" из вектора х. Поэтому возникает вопрос: "Существует ли такое обратимое линейное преобразование Т, для которого обрезание вектора Тх будет оптимальным в смысле среднеквадратической ошибки?" Естественно, при этом преобразование Т должно иметь свойство маленькой дисперсии своих отдельных компонентов. Анализ главных компонентов (в теорий информации он называется преобразование Карунена—Лоева (Karhunen-Loeve transformation)) максимизирует скорость уменьшения дисперсии и, таким образом, вероятность правильного выбора. В этой главе описываются алгоритмы обучения, основанные на принципах Хебба, которые осуществляют анализ главных компонентов интересующего вектора данных.
Пусть X — m-мерный случайный вектор, представляющий интересующую нас среду. Предполагается, что он имеет нулевое среднее значение
 ,
где E — оператор статистического ожидания. Если X имеет ненулевое среднее, можно вычесть это значение еще до начала анализа. Пусть q—единичный вектор (unit vector) размерности т, на который проектируется вектор X. Эта проекция определяется как скалярное произведение векторов X и q:
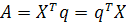 (1.3)
при ограничении
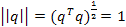 (1.4)
Проекция А представляет собой случайную переменную со средним значением и с дисперсией, связанными со статистикой случайного вектора X. В предположении, что случайный вектор X имеет нулевое среднее значение, среднее значение его проекции А также будет нулевым:
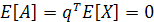
Таким образом, дисперсия А равна
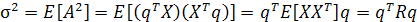 (1.5)
Матрица R размерности т х т является матрицей корреляции случайного вектора X. определяемой как ожидание произведения случайного вектора X самого на себя:
 (1.6)
Матрица R является симметричной, т.е.
 (1.7)
Из этого следует, что если а и b — произвольные векторы размерности т х 1, то
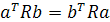 (1.8)
Из
выражения (1.5)
видно, что дисперсия
 2 проекции
А является
функцией единичного
вектора q.
Таким образом,
можно записать:
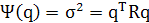 (1.9)
на основании чего ψ(q) можно представить как дисперсионный зонд (variance probe).
1.5.1 Структура анализа главных компонентов
Следующим вопросом, подлежащим рассмотрению, является поиск тех единичных векторов q, для которых функция ψ(q) имеет экстремальные или стационарные значения (локальные максимумы и минимумы) при ограниченной Евклидовой норме вектора q. Решение этой задачи лежит в собственной структуре матрицы корреляции R. Если q — единичный вектор, такой, что дисперсионный зонд ψ(q) имеет экстремальное значение, то для любого возмущения 6q единичного вектора q выполняется!
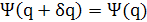 (1.10)
Из определения дисперсионного зонда можем вывести следующее соотношение:
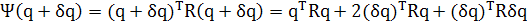 ,
где во второй строке использовалось выражение (1.8). Игнорируя слагаемое второго порядка (δq)TRδq и используя определение (1.9), можно записать следующее:
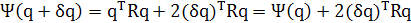 (1.11)
Отсюда, подставляя (1.10) в (1.11), получим:
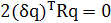 ,
(1.12)
Естественно, любые возмущения δq вектора q нежелательны; ограничим их только теми возмущениями, для которых норма возмущенного вектора q+δq остается равной единице, т.е.
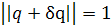
или, что эквивалентно,