Метод анализа главных компонентов регрессионной модели измерений средствами нейронных сетей
 ,
где
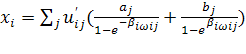 ,
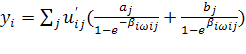 ,
 -
обратная температура.
Интервальное значение, которое принимает i-й нейрон при данном воздействии, равно
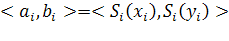 ,
где
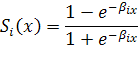
Передаточная
функция интервального
нейрона приблизительно
отражает идею
монотонности
по отношению
к операции
интервального
включения. Это
означает, что
при
 ,
если вход j-го
нейрона лежит
в интервале
 ,
то выход i-
го нейрона,
определенный
по классической
функции Ферми,
обязательно
попадет в интервал
.
Интервальные
нейроны могут
являться элементами
многослойных
персептронов.
В этом случае
их состояния
вычисляются
последовательно,
начиная от
входного слоя
к выходному.
Для сетей
интервальных
нейронов может
быть построено
обобщение
метода обратного
распространения
ошибки, описание
которого выходит
за рамки нашего
курса.
2.6 Сети и свойства численных структур регрессионного анализа
Простой итерационный алгоритм сингулярного разложения матриц допускает простую высокопараллельную (в том числе, нейросетевую) реализацию. Сингулярное разложение матриц (англ. Singular value decomposition) необходимо для решения многих задач анализа данных. В том числе, анализ главных компонент сводится к сингулярному разложению матрицы центрированных данных.
2.6.1 Идея сингулярного разложения матрицы данных
Если
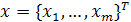 —
матрица, составленная
из векторов-строк
центрированных
данных, то выборочная
ковариационная
матрица
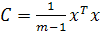 и задача
о спектральном
разложении
ковариационной
матрицы
 превращается
в задачу о
сингулярном
разложении
матрицы данных
X.
Число
σі0
называется
сингулярным
числом
матрицы
 тогда
и только тогда,
когда существуют
правый и
левый сингулярные
векторы:
такие
 -мерный
вектор-строка
 и
 -мерный
вектор-столбец
 (оба единичной
длины), что выполнено
два равенства:
 ;

Пусть
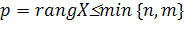 —
ранг матрицы
данных. Сингулярное
разложение
матрицы данных
X— это её
представление
в виде
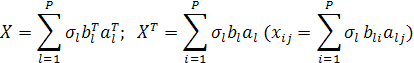
где
 —
сингулярное
число,
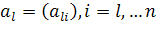 —
соответствующий
правый сингулярный
вектор-столбец,
а
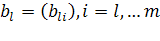 — соответствующий
левый сингулярный
вектор-строка
(
 ).
Правые сингулярные
векторы-столбцы
 ,
участвующие
в этом разложении,
являются векторами
главных компонент
и собственными
векторами
эмпирической
ковариационной
матрицы
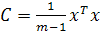 ,
отвечающими
положительным
собственным
числам
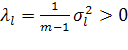 .
Хотя
формально
задачи сингулярного
разложения
матрицы данных
и спектрального
разложения
ковариационной
матрицы совпадают,
алгоритмы
вычисления
сингулярного
разложения
напрямую, без
вычисления
спектра ковариационной
матрицы, более
эффективны
и устойчивы.
Это следует
из того, что
задача сингулярного
разложения
матрицы
лучше
обусловлена,
чем задача
разложения
матрицы
:
для ненулевых
собственных
и сингулярных
чисел
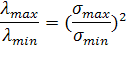
Простой итерационный алгоритм сингулярного разложения
Основная
процедура —
поиск наилучшего
приближения
произвольной
m x n матрицы
 матрицей
вида
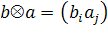 (где b—
m-мерный
вектор, а a—
n-мерный
вектор) методом
наименьших
квадратов:
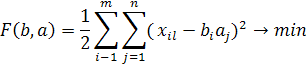
Решение
этой задачи
дается последовательными
итерациями
по явным формулам.
При фиксированном
векторе
 значения
 ,
доставляющие
минимум форме
F(b,a),
однозначно
и явно определяются
из равенств

Аналогично,
при фиксированном
векторе
определяются
значения:
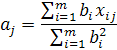
B качестве
начального
приближения
вектора
 возьмем
случайный
вектор единичной
длины, вычисляем
вектор b,
далее для этого
вектора
 вычисляем
вектор
и
т. д. Каждый шаг
уменьшает
значение F(b,a).
В качестве
критерия остановки
используется
малость относительного
уменьшения
значения
минимизируемого
функционала
F(b,a)за
шаг итерации
(∆F/F)
или малость
самого значения
F.
В
результате
для матрицы
X=( )получили
наилучшее
приближение
матрицей
 вида
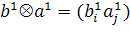 (здесь верхним
индексом обозначен
номер итерации).
Далее, из матрицы
 вычитаем
полученную
матрицу
,
и для полученной
матрицы уклонений
 вновь ищем
наилучшее
приближение
 этого же вида
и т. д., пока, например,
норма
 не станет достаточно
малой. В результате
получили итерационную
процедуру
разложения
матрицы X
в виде суммы
матриц ранга
1, то есть
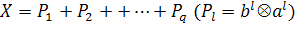 .
Полагаем
 и нормируем
векторы
 :
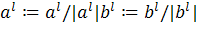 В результате
получена
аппроксимация
сингулярных
чисел
 и
сингулярных
векторов (правых
—
 и
левых —
 ).
К достоинствам этого алгоритма относится его исключительная простота и возможность почти без изменений перенести его на данные с пробелами, а также взвешенные данные.
Существуют
различные
модификации
базового алгоритма,
улучшающие
точность и
устойчивость.
Например, векторы
главных компонент
 при
разных
l должны
быть ортогональны
«по построению»,
однако при
большом числе
итерации (большая
размерность,
много компонент)
малые отклонения
от ортогональности
накапливаются
и может потребоваться
специальная
коррекция
на
каждом шаге,
обеспечивающая
его ортогональность
ранее найденным
главным компонентам.
Для квадратных симметричных положительно определённых матриц описанный алгоритм превращается в метод прямых итераций для поиска собственных векторов.
2.6.2 Линейный МНК
Задача аппроксимации линейным МНК в матричной форме записывается, как
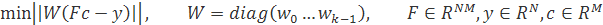
Иногда к задаче добавляются ограничения:
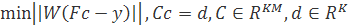
Здесь c обозначает искомый вектор коэффициентов. Столбцы матрицы F соответствуют базисным функциям (всего M столбцов), строки - экспериментальным точкам (всего N строк), Fij содержит значение j-ой базисной функции в i-ой точке набора данных. Вектор y содержит значения аппроксимируемой функции в точках, соответствующих строкам матрицы F. Матрица W является диагональной матрицей весовых коэффициентов, элементы которой соответствуют важности той или иной точки. Матрица C задает дополнительные ограничения, которым должна удовлетворять аппроксимируемая функция - минимум ошибки ищется среди функций, точно удовлетворяющих заданным ограничениям. В такой формулировке задача сводится к решению системы линейных уравнений. Полученная система линейных уравнений, как правило, является переопределенной - число уравнений намного больше числа неизвестных. Для решения используется основанный на QR-разложении солвер. Сначала матрица A представляется в виде произведения прямоугольной ортогональной матрицы Q и квадратной верхнетреугольной матрицы R. Затем решается система уравнений Rx = Q Tb. Если матрица R вырождена, алгоритм использует SVD-разложение, которое позволяет добиться решения независимо от свойств матрицы коэффициентов. Трудоемкость решения такой задачи составляет O(N·M 2).
Модуль lsfit содержит четыре подпрограммы для линейной аппроксимации: LSFitLinear (простейшая задача - нет ограничений, W - единичная матрица), LSFitLinearW (взвешенная аппроксимация без ограничений), LSFitLinearC (аппроксимация с ограничениями, без весовых коэффициентов) и LSFitLinearWC (аппроксимация с индивидуальными весовыми коэффициентами и ограничениями).
2.7 Нелинейные решения проблем стандартного МНК
2.7.1 Аппроксимация линейным или нелинейным МНК
Метод наименьших квадратов (часто называемый МНК) обычно упоминается в двух контекстах. Во-первых, широко известно его применение в регрессионном анализе, как метода построения моделей на основе зашумленных экспериментальных данных. При этом помимо собственно построения модели обычно осуществляется оценка погрешности, с которой были вычислены её параметры, иногда решаются и некоторые другие задачи. Во-вторых, МНК часто применяется просто как метод аппроксимации, без какой-либо привязки к статистике. На этой странице МНК рассматривается как метод аппроксимации. Также следует отметить, что модуль lsfit, рассматриваемый на этой странице, решает задачи общего вида. Модули для работы с полиномами, сплайнами, рациональными функциями содержат подпрограммы схожей функциональности, позволяющие осуществлять аппроксимацию этими функциями.
2.7.2 Нелинейный МНК: с использованием гессиана или без него
Нелинейная задача МНК значительно сложнее линейной: аппроксимант уже не представляется в виде линейной комбинации базисных функций. Для аппроксимации используется функция общего вида, зависящая от M аргументов и K параметров:
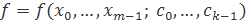
Нам известны значения аргументов x в N точках, требуется найти значения параметров c, при которых отличие f от заданных значений y будет минимально. Задача при этом имеет следующую формулировку:
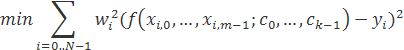
Для решения используется метод Левенберга-Марквардта, реализованный в модуле minlm. Алгоритм использует ту же схему обратной коммуникации для вычисления значения функции, что и модуль minlm - вам необходимо ознакомиться с ней перед использованием алгоритма. Как и в модуле minlm, пользователь может выбирать несколько схем оптимизации: FG (использование функции f и её градиента) и FGH (использование функции, градиента и гессиана). Пользователь может задать индивидуальные весовые коэффициенты (на что указывает суффикс W) или решать задачу без них. Итого имеем четыре версии подпрограмм для оптимизации: LSFitNonlinearWFG, LSFitNonlinearFG, LSFitNonlinearWFGH, LSFitNonlinearFGH.
В случае оптимизации с использованием схемы FG (градиент известен, гессиан неизвестен) возможны две ситуации: "дорогой" градиент, трудоемкость вычисления которого равна O((M+K) 2), и "дешевый" градиент, трудоемкость вычисления которого существенно ниже, чем O((M+K) 2). Первый вариант - это градиент, вычисленный при помощи разностной схемы, либо аналитический градиент сложной функции. Второй вариант - аналитический градиент функции с регулярной структурой, допускающей ускоренное вычисление градиента (пример: обучение нейронных сетей). Во втором случае можно использовать гибридный вариант алгоритма Левенберга-Марквардта, входящий в состав ALGLIB - этот вариант позволяет значительно ускорить решение задач с "дешевыми" градиентами. "Стоимость" градиента обозначается параметром CheapFG подпрограмм LSFitNonlinearWFG и LSFitNonlinearFG.
Замечание 1
Если для оптимизации используется гессиан, то всегда используется гибридный алгоритм - в таких задачах его применение всегда оправдано.
Замечание 2
Предпочтительным вариантом является использование аналитического градиента. Из-за возможных проблем с низкой точностью не рекомендуется использовать для вычисления градиента разностную схему. Если вы все же используете её, ни в коем случае не используйте двухточечную схему - используйте как минимум четырехточечную схему.
2.7.3 Нелинейный МНК какобратная коммуникация
Алгоритм аппроксимации в ходе своей работы должен получать значения функции/градиента/... в выбранных им точках. В большинстве программных пакетов эта проблема решается путем передачи указателя на функцию (C++, Delphi) или делегата (C#), который осуществляет эту операцию.
Пакет ALGLIB, в отличие от других библиотек, использует для решения этой задачи обратную коммуникацию. Когда требуется вычислить значение функции (или её производных), состояние алгоритма сохраняется в специальной структуре, после чего управление возвращается в вызвавшую программу, которая осуществляет все вычисления и снова вызывает вычислительную подпрограмму.
Таким образом, работа с алгоритмом аппроксимации осуществляется в следующей последовательности:
Подготовка структуры данных LSFitState при помощи одной из подпрограмм инициализации алгоритма (LSFitNonlinearWFG, LSFitNonlinearFG, LSFitNonlinearWFGH, LSFitNonlinearFGH).
Вызов подпрограммы LSFitNonlinearIteration.
Если подпрограмма вернула False, работа алгоритма завершена и минимум найден (сам минимум может быть получен при помощи подпрограммы LSFitNonlinearResults).
Если подпрограмма вернула True, подпрограмма требует информацию о функции. В зависимости от того, какие поля структуры LSFitState установлены в True (ниже этот вопрос рассмотрен более подробно), вычислите функцию/градиент/гессиан.
После того, как вся требуемая информация загружена в структуру LSFitState, требуется повторно вызвать подпрограмму LSFitNonlinearIteration.
Для обмена информацией с пользователем используются следующие поля структуры LSFitState:
LSFitState.X[0..M-1] – массив, хранящий координаты точки, информация о которой запрашивается алгоритмом
LSFitState.C[0..K-1] – массив, хранящий значение параметров функции
LSFitState.F – в это поле следует поместить значение функции F (если оно было запрошено)
LSFitState.G[0..K-1] – в это поле следует поместить градиент df(x,c)/dci (если он был запрошен)
LSFitState.H[0..K-1,0..K-1] – в это поле следует поместить гессиан d 2f(x,c)/dcij ^2 (если он был запрошен)
В зависимости от того, что именно требуется вычислить, подпрограмма LSFitNonlinearIteration может устанавливать в True одно и только одно из следующих полей:
NeedF – сигнализирует о том, что требуется вычислить значение функции F
NeedFG – сигнализирует о том, что требуется вычислить значения функции F и градиента F
NeedFGH – сигнализирует о том, что требуется вычислить значение функции F, градиент F и гессиан F
2.8 Решение параметров регрессионного уравнения с использованием аппроксимации ковариационной матрицы по данным ГК при обучении НС
Актуальность работы определяется проблемой регрессионных методов, когда оценка параметров затруднена дефицитом априорной информации о помехах или обратная автоковариационная матрица входных регрессоров является вырожденной. Целевое направление работы – создание алгоритма оценки параметров регрессионной модели измерений при аппроксимации дисперсионных характеристика методом главных компонентов. Основная решаемая задача заключается в нахождении соотношения характеристик главных компонентов и регрессионных уравнений. Эффективность достигается за счет решения главных компонентов средствами нейронных сетей на основе фильтра Хебба.
пространственный стохастический адаптивный алгоритм регрессионный
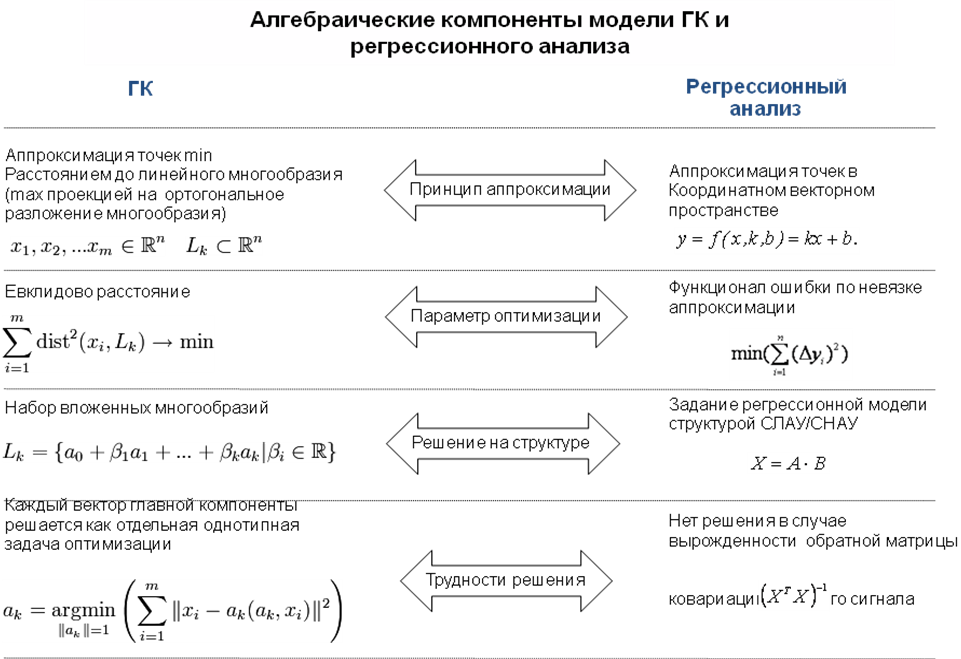
Рисунок 2.3 - Алгебраические компоненты модели ГК и регрессионного анализа
Конкретно в текущей работе было выполнены следующие этапы построения представляемого метода (рис. 2.3):
– рассмотрение алгебраической модели данных метода главных компонентов для выявления структурных соотношений с регрессионным анализом;
– анализ структуры и метода обучения нейронных сетей для решения аппроксимации ковариации входного сигнала методом главных компонент;
– поиск оптимального параметра отклика регрессионными методами и по данным анализа главных компонентов;
– решение поверхности отклика по данным АГК, в условиях, когда обратная матрица автоковариации входных регрессоров вырождена.
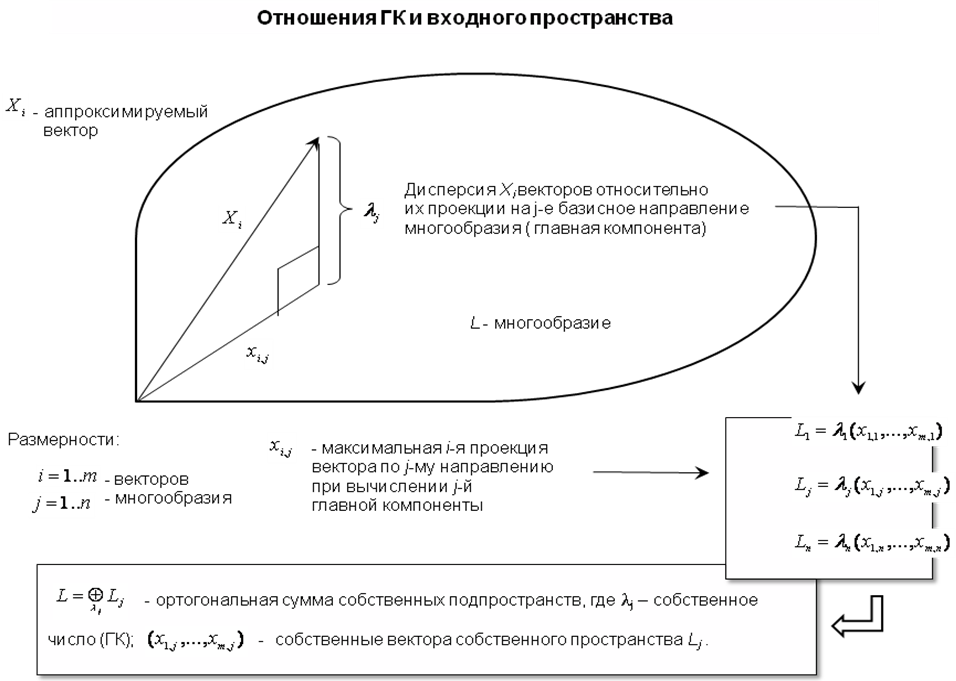
Рисунок 2.4 - Отношения ГК и входного пространства
В основе метода главных компонентов находится задача наилучшей аппроксимации конечного множества точек линейными многообразиями типа прямых и плоскостей (рис. 2.4). Эти линейные многообразия определяются ортонормированным набором векторов, линейных по параметрам. По входным координатам, относительно каждого базиса многообразия, рассчитывается минимальная квадратичная сумма до их проекции. Таким образом, формируется главная компонента, связанная с максимальной дисперсией проекции входа относительно элемента базиса. Совокупность проекций отдельного направления и их главная компонента в свою очередь образуют собственные подпространства, ортогональные по отношению друг к другу.
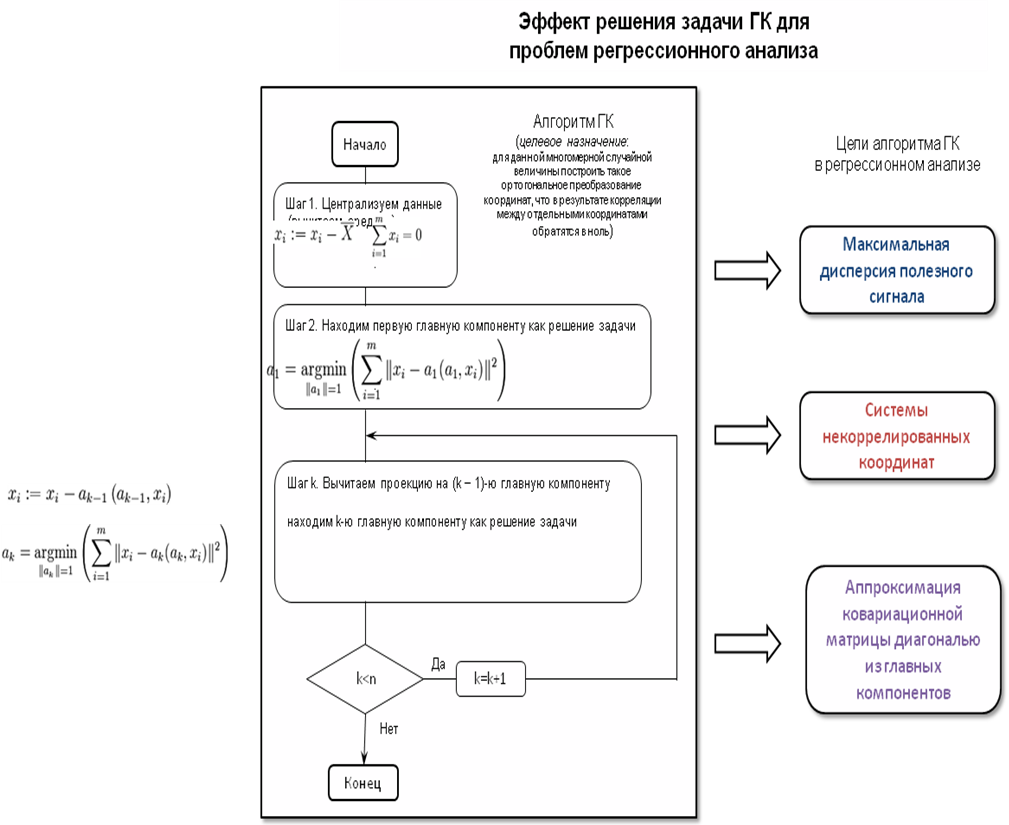
Рисунок 2.5 - Эффект решения задачи ГК для проблем регрессионного анализа
Таким образом, формируется распределение максимальных дисперсий аппроксимируемых точек в пространстве компонент (рис. 2.5). Проекция искажений, или помех, ортогональна и не коррелированны с данными. То есть дисперсия помех минимальна, что соответствует задачам регрессионного анализа. Но расчет всех главных компонентов – аналитически сложная задача оптимизации. Эффект ее решения это нахождение:
- максимальной дисперсии полезного сигнала;
- системы некоррелированных координат;
- аппроксимация ковариационной матрицы диагональю из дисперсий проекций по данным ГК.
При этом ортонормированный базис для собственных векторов существует всегда. Даже если спектр ковариационной матрицы вырожден, то есть когда она является сингулярной и не решает оценки параметров регрессионной модели.
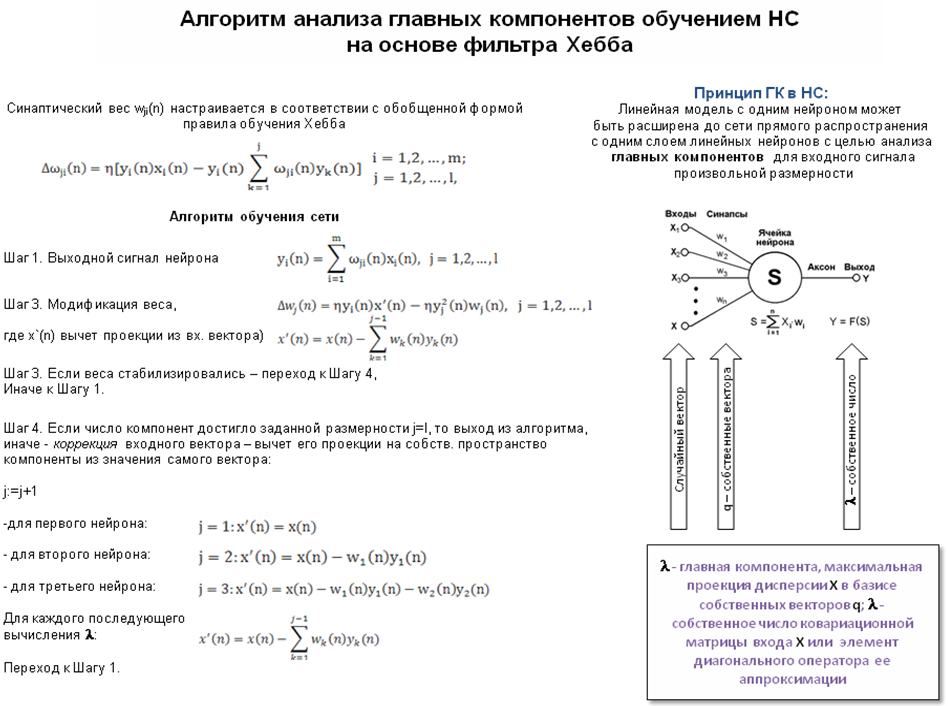
Рисунок 2.6 - Алгоритм анализа главных компонентов обучением НС на основе фильтра Хебба
С целью анализа главных компонентов для входного сигнала произвольной размерности возможно применение технологии обучения нейронных сетей (рис. 2.6). Сеть прямого распространения с одним слоем линейных нейронов, модифицируемая по обобщенному правиле Хебба, образует устройство - фильтр Хебба. Фильтр извлекает главные компоненты из входного сигнала в пространстве собственных векторов, которыми являются