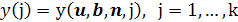Метод анализа главных компонентов регрессионной модели измерений средствами нейронных сетей
Исходя из этого, в свете равенства (1.4) требуется, чтобы для возмущения первого порядка δq выполнялось соотношение
 (1.13)
Это значит, что возмущения δq должны быть ортогональны вектору q и, таким образом, допускаются только изменения в направлении вектора q.
Согласно соглашению, элементы единичного вектора q являются безразмерными в физическом смысле. Таким образом, можно скомбинировать (1.12) и (1.13), введя дополнительный масштабирующий множитель l, в последнее равенство с той же размерностью, что и вхождение в матрицу корреляции R. После этого можно записать следующее:
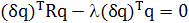 ,
или, эквивалентно,
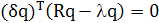 ,
(1.14)
Для того чтобы выполнялось условие (1.14), необходимо и достаточно, чтобы
 (1.15)
Это — уравнение определения таких единичных векторов q, для которых дисперсионный зонд ψ (q) принимает экстремальные значения.
В уравнении (1.15) можно легко узнать задачу определения собственных значений (eigenvalue: problem) из области линейной алгебры. Эта задача имеет нетривиальные решения (т.е. q ≠ 0) только для некоторых значений l, которые называются собственными значениями (eigenvalue) матрицы корреляции R. При этом соответствующие векторы q называют собственными векторами (eigenvector). Матрица корреляции характеризуется действительными, неотрицательными собственными значениями. Соответствующие собственные векторы являются единичными (если все собственные значения различны). Обозначим собственные значения матрицы R размерности т х т как l1, l2,,.., lm, а соответствующие им собственные векторы -q1, q2,...,qm соответственно. Тогда можно записать следующее:
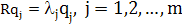 (1.16)
Пусть соответствующие собственные значения упорядочены следующим образом:
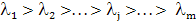 , (1.17)
При этом l1 будет равно lmax. Пусть из соответствующих собственных векторов построена следующая матрица размерности т х т:
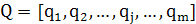 (1.18)
Тогда систему т уравнений (1.16) можно объединить в одно матричное уравнение:
 (1.19)
где А — диагональная матрица, состоящая из собственных значений матрицы R:
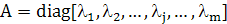 (1.20)
Матрица Q является ортогональной (унитарной) в том смысле, что векторы-столбцы (т.е. собственные векторы матрицы R) удовлетворяют условию ортогональности:
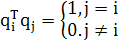 (1.21)
Выражение (1.21) предполагает, что собственные значения различны. Эквивалентно, можно записать:

из чего можно заключить, что обращение матрицы Q эквивалентно ее транспонированию:
 (1.22)
Это значит, что выражение (8.17) можно переписать в форме, называемой ортогональным преобразованием подобия (orthogonal similarity transformation):
 (1.23)
или в расширенной форме:
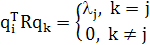 (1.24)
Ортогональное преобразование подобия (1.23) трансформирует матрицу корреляции R в диагональную матрицу, состоящую из собственных значений. Сама матрица корреляции может быть выражена в терминах своих собственных векторов и собственных значений следующим образом:
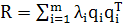 (1.25)
Это
выражение
называют спектральной
теоремой (spectral
theorem).
Произведение
векторов
 имеет
ранг 1 для всех
i.
Уравнения (1.23) и (1.25) являются двумя эквивалентными представлениями разложения по собственным векторам (eigencomposition) матрицы корреляции R.
Анализ главных компонентов и разложение по собственным векторам матрицы R являются в сущности одним и тем же; различается только подход к задаче. Эта эквивалентность следует из уравнений (1.9) и (1.25), из которых ясно видно равенство собственных значений и дисперсионного зонда, т.е.
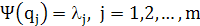 (1.26)
Теперь можно сделать выводы, касающиеся анализа главных компонентов.
Собственные векторы матрицы корреляции R принадлежат случайному вектору X с нулевым средним значением и определяют единичные векторы q j, представляющие основные направления, вдоль которых дисперсионный зонд Ψ(qj) принимает экстремальные значения.
Соответствующие собственные значения определяют экстремальные значения дисперсионного зонда Ψ(uj)
1.5.2 Основные представления данных
Пусть вектор данных х является реализацией случайного вектора X.
При наличии т возможных значений единичного вектора q следует рассмотреть т возможных проекций вектора данных х. В частности, согласно формуле (1.3)
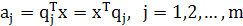 (1.27)
где aj — проекции вектора х на основные направления, представленные единичными векторами qj. Эти проекции aj- называют главными компонентами (principal component). Их количество соответствует размерности вектора данных х. При этом формулу (1.27) можно рассматривать как процедуру анализа (analysis).
Для того чтобы восстановить вектор исходных данных х непосредственно из проекций aj, выполним следующее. Прежде всего объединим множество проекций { aj | j = 1,2,..., m} в единый вектор:
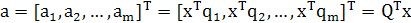 (1.28)
Затем перемножим обе части уравнения (1.28) на матрицу Q, после чего используем соотношение (1.22). В результате исходный вектор данных х будет реконструирован в следующем виде:
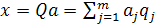 (1.29)
который можно рассматривать как формулу синтеза. В этом контексте единичные векторы qj будут представлять собой пространства данных. И в самом деле, выражение (1.29) является не чем иным, как преобразованием координат, в соответствии с которым точки х пространства данных преобразуются в соответствующие точки а пространства признаков.
1.5.3 Матричная формулировка алгоритмасамообучения
Для удобства выкладок введем следующие обозначения:
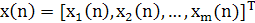 (1.30)
и
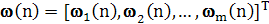 (1.31)
Входной вектор x(n) и вектор синаптических весов w(n) обычно являются реализациями случайных векторов. Используя это векторное представление, выражение (1.26) можно переписать в форме скалярного произведения:
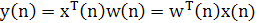 (1.32)
Аналогично, выражение (1.30) можно переписать в следующем виде:
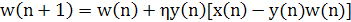 (1.33)
Подставляя (1.32) в (1.33), получим:
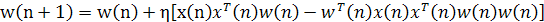 (1.34)
Алгоритм обучения (1.34) представляет собой нелинейное стохастическое разностное уравнение (nonlinear stochasticс difference equation), которое делает анализ сходимости этого алгоритма сложным с математической точки зрения. Для того чтобы обеспечить базис для анализа сходимости, немного отвлечемся от поставленной задачи и обратимся к общим методам анализа сходимости стохастических алгоритмов аппроксимации.
1.5.4 Анализ главных компонентов на основе фильтра Хебба
Описанный в предыдущем разделе фильтр Хебба извлекает первый главный компонент из входного сигнала. Линейная модель с одним нейроном может быть расширена до сети прямого распространения с одним слоем линейных нейронов с целью анализа главных компонентов для входного сигнала произвольной размерности.
Для большей конкретизации рассмотрим сеть прямого распространения, показанную на рис. 8.6. В ней сделаны следующие допущения относительно структуры:
Все нейроны выходного слоя сети являются линейными.
Сеть имеет т входов и I выходов. Более того, количество выходов меньше количества входов (т.е. I <т).
Обучению подлежит только множество синаптических. весов {wji}, соединяющих узлы i входного слоя с вычислительными узлами j выходного слоя, где i = l,2,...,m; j = 1,2,..., l.
Выходной сигнал уi, (п) нейрона j в момент времени п, являющийся откликом на множество входных воздействий {xi(п) i = 1,2,..., m}, определяется по следующей формуле (рис. 8.7, а):
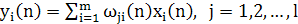 (1.35)
Синаптический вес wji(n) настраивается в соответствии с обобщенной формой правила обучения Хебба:
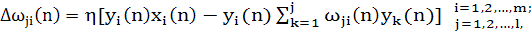 (1.36)
где wji(n) — коррекция, применяемая к синаптическому весу wji(n) в момент времени n; η — параметр скорости обучения. Обобщенный алгоритм обучения Хеббa (generalized Hebbian algorithm — GHA) (1.36) для слоя из l нейронов включает в себе алгоритм (8.39) для одного нейрона в качестве частного случая, т.е. для l = 1.
Для того чтобы заглянуть вглубь обобщенного алгоритма обучения Хебба, перепишем уравнение (8.80) в следующем виде:
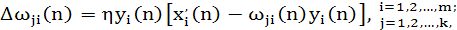 (1.37)
где
х (п)
— модифицированная
версия i-го
элемента входного
вектора х(n),
являющаяся
функцией индекса
j,
т.е.
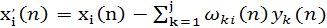 (1.38)
Для конкретного
нейрона j
алгоритм,
описанный
выражением
(1.37), имеет ту же
математическую
форму, что и
(8.39), за исключением
того факта, что
в (1.38) входной
сигнал xi(n)
заменен
его модифицированным
значением
х(n).
Теперь можно
сделать следующий
шаг и переписать
выражение
(1.37) в форме, соответствующей
постулату
обучения Хебба:
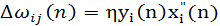 (1.39)
где
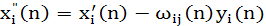 (1.40)
Таким образом, принимая во внимание
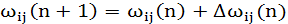 (1.41)
и
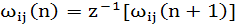 (1.42)
где z-1 — оператор единичной задержки, можно построить граф передачи сигнала показанный на рис. 1.4, б, для обобщенного алгоритма Хебба. Из этого графа видно,
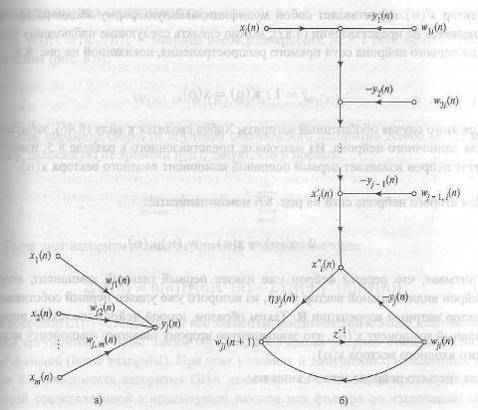
Рисунок 1.4 - Представление обобщенного алгоритма Хебба в виде графа передачи сигнала: граф уравнения (1.35) (а); граф выражений (1.36), (1.37) (б)
что сам алгоритм (согласно его формулировке в (1.41)) базируется на локальной форме реализации. Учтем также, что выход уi(n), отвечающий за обратную связь на графе передачи сигнала (см. рис. 1.4, б), определяется по формуле (1.35). Представление Для эвристического понимания того, как обобщенный алгоритм Хебба работает на самом деле, в первую очередь запишем версию алгоритма (1.37) в матричном представлении:
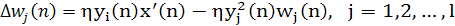 (1.43)
где
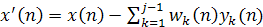 (1.44)
Вектор х'(п) представляет собой модифицированную форму входного вектора. Основываясь на представлении (1.43), можно сделать следующие наблюдения. Для первого нейрона сети прямого распространения:
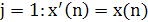
Для этого случая обобщенный алгоритм Хебба сводится к виду (1.33), записанному для одиночного нейрона. Из материала, представленного в разделе 1.5.4, известно, что этот нейрон извлекает первый основной компонент входного вектора х(п).
1. Для второго нейрона сети можно записать:
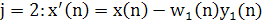
Учитывая, что первый нейрон уже извлек первый главный компонент, второй нейрон видит входной вектор x'(n), из которого уже удален первый собственный вектор матрицы корреляции R. Таким образом, второй нейрон извлекает первый главный компонент х'(n), что эквивалентно второму главному компоненту исходного входного вектора х(n).
2. Для третьего нейрона можно записать:
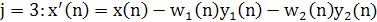
Предположим, что первые два нейрона уже сошлись к первому и второму главным компонентам. Значит, третий нейрон видит входной вектор x'(n), из которого удалены первый и второй собственные векторы. Таким образом, он извлекает первый главный компонент вектора х'(n), что эквивалентно третьему главному компоненту исходного входного вектора х(n).
3. Продолжая эту процедуру для оставшихся нейронов сети прямого распространения, получим, что каждый из выходов сети, обученный с помощью обобщенного алгоритма Хебба (1.37), представляет собой отклик на конкретный собственный вектор матрицы корреляции входного вектора, причем отдельные выходы упорядочены по убыванию ее собственных значений.
Этот метод вычисления собственных векторов аналогичен методу, получившему название процесса исчерпания. Он использует процедуру, аналогичную ортогонализации Грама-Шмидта.
Представленное здесь описание "от нейрона к следующему нейрону" было приведено для упрощения изложения. На практике все нейроны в обобщенном алгоритм Хебба совместно работают на обеспечение сходимости.
1.5.5 Исследование сходимостипри решении главной компоненты сигнала
Пусть W(n) ={wji(n)} — матрица весов размерности т х l сети прямого распространения:
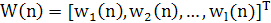 (1.45)
Пусть параметр скорости обучения обобщенного алгоритма Хебба (1.45) имеет форму, зависящую от времени η(n), такую, что в пределе
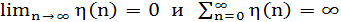 (1.46)
Тогда этот алгоритм можно переписать в матричном виде:
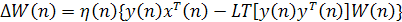 (1.47)
где оператор LT[-] устанавливает все элементы, расположенные выше диагонали матрицы аргументов, в нуль. Таким образом, полученная матрица становится нижней треугольной (lower triangular). При этих условиях и допущениях, изложенных в разделе 8.4, сходимость алгоритма GHA доказывается с помощью процедуры, аналогичной представленной в предыдущем разделе для фильтра по извлечению максимального собственного значения. В связи с этим можно сформулировать следующую теорему.
Если элементы матрицы синоптических весов W(n) на шаге п = 0 принимают случайные значения, то с вероятностью 1 обобщенный алгоритм Хебба (8.91) будет сходиться к фиксированной точке, a WT(n) достигнет матрицы, столбцы которой являются первыми l собственными векторами матрицы корреляции R размерности т х т входных векторов размерности m x l, упорядоченных по убыванию собственных значений.
Практическое значение этой теоремы состоит в том, что она гарантирует нахождение обобщенным алгоритмом Хебба первых l собственных векторов матрицы корреляции R, в предположении, что соответствующие собственные значения отличны друг от друга. При этом важен и тот факт, что в данном случае не требуется вычислять саму матрицу корреляции R: ее первые l собственных векторов вычисляются непосредственно на основании входных данных. Полученная экономия вычислительных ресурсов может быть особенно большой, если размерность входного пространства т достаточно велика, а требуемое количество собственных векторов, связанных с l наибольшими собственными значениями матрицы корреляции R, является лишь небольшой частью размерности т.
Данная теорема о сходимости сформулирована в терминах зависящего от времени параметра скорости обучения x(n). На практике этот параметр обычно принимает значение некоторой малой константы Т. В этом случае сходимость гарантируется в смысле среднеквадратической ошибки синаптических весов порядка т|.
В исследовались свойства сходимости алгоритма GHA (1.47). Проведенный в работе анализ показал, что увеличение параметра т) ведет к более быстрой сходимости и увеличению асимптотической среднеквадратической ошибки (что интуитивно предполагалось). Среди прочего в этой работе точно показана обратная зависимость между точностью вычислений и скоростью обучения.
1.5.6 Оптимальность обобщенного алгоритма Хебба
Предположим, что в пределе можно записать:
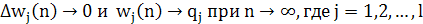 (1.48)
и
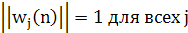 (1.49)
Тогда предельные значения q1,q2,...,qi; векторов синаптических весов нейронов сети прямого распространения (см. рис. 8.5) представляют собой нормированные собственные векторы (normalized eigenvector), ассоциированные с l доминирующими собственными значениями матрицы корреляции R, упорядоченными по убыванию собственных значений. Таким образом, для точки равновесия можно записать следующее:
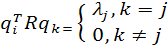 (1.50)
где l1 > l2 > ... > li .
Для выхода нейрона j получим предельное значение:
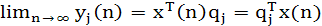 (1.51)
Пусть Yj(n) — случайная переменная с реализацией yj(n). Взаимная корреляция (cross-correlation) между случайными переменными Yj(n) и Yk(n) в равновесном состоянии записывается в виде
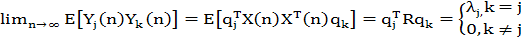 (1.52)
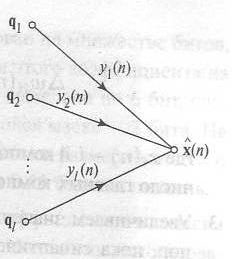
Рисунок 1.5 - Представление в виде графа передачи сигнала процесса восстановления вектора
Следовательно, можно утверждать, что в точке равновесия обобщенный алгоритм Хебба (1.47) выступает в роли средства собственных значений (eigen-analyzer) входных данных.
Пусть х^(n) — частное значение входного вектора х(n), для которого предельные условия (1.48) удовлетворяются при j = l — 1. Тогда из матричной формы (8.80) можно получить, что в пределе
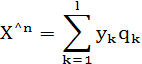
Это значит, что для заданных двух множеств величин — предельных значений q1,q2,…,ql векторов синаптических весов нейронов сети прямого распространения и соответствующих выходных сигналов y1 ,у2,…,yl — можно построить линейную оценку по методу наименьших квадратов (linear least-squares estimate) значения х^(n) входного вектора х(n), В результате формулу (1.52) можно рассматривать как одну из форм восстановления данных (data reconstruction) (рис. 1.4). Обратите внимание, что в свете дискуссии, этот метод восстановления данных имеет вектор ошибки аппроксимации, ортогональный оценке х^(n).
1.5.7 Алгоритм GHA в сжатом виде
Вычисления, выполняемые обобщённым алгоритмом Хебба (GHA), являются простыми, и их можно описать следующей последовательностью действий.
1. В момент времени n = 1 инициализируем синаптические веса ωji сети случайными малыми значениями. Назначаем параметру скорости обучения Ш] некоторое малое положительное значение.
2. Для
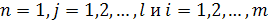 вычислим:.
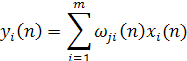
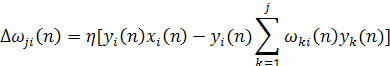
где xi(n) — i-й компонент входного вектора х(п) размерности т х 1; l- требуемое число главных компонентов.
3.Увеличиваем значение n на единицу, переходим к шагу 2 и продолжаем до пор, пока синаптические веса wji не достигнут своих установившихся (steady-state) значений. Для больших п синаптические веса wji нейрона j сходятся к i-му компоненту собственного вектора, связанного с j-м собственным значением матрицы корреляции входного вектора х(n).
2. Оценка параметров регрессионных уравнений при аппроксимации дисперсионных распределений методом АГК
2.1 Организация наблюдений и регрессионные методы оценки параметров
2.1.1 Оценивание по конечному числу наблюдений
До сих пор предполагалось, что все математические ожидания могут быть вычислены, т. е. известна совместная плотность распределения р (х1,, . . ., хт, у). Так бывает довольно редко. Обычно необходимо оценивать параметры, используя конечное число наблюдений, а именно выборочные значения. Таким образом, оценка должна быть функцией этих выборочных значений, которые фактически представляют собой наблюдаемые значения реализаций случайных величин. Это означает, что оценка тоже случайная величина и может быть охарактеризована плотностью вероятности. Качество оценки зависит от этой функции и, в частности, от среднего значения и дисперсии.
Излагаемые методы имеют длинную историю. Уже в 1795 г. Гаусс использовал их при исследовании движения планет. В наши дни они применяются, например, при определении параметров орбит спутников. Следует отметить что, помимо обычных регрессионных моделей
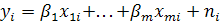
где ni — случайная величина, в литературе рассматриваются также авторегрессионная модель
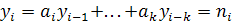
и обобщенная регрессионная модель
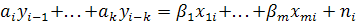
Обозначения. Теперь посмотрим, как получаются оценки. Пусть наблюдается выходной сигнал объекта у, который состоит из отклика на входное воздействие и, шума объекта и ошибок измерений. В момент j-го измерения выходной сигнал имеет вид