Шпоры к ГОС экзаменам Воронеж, 2004г.)
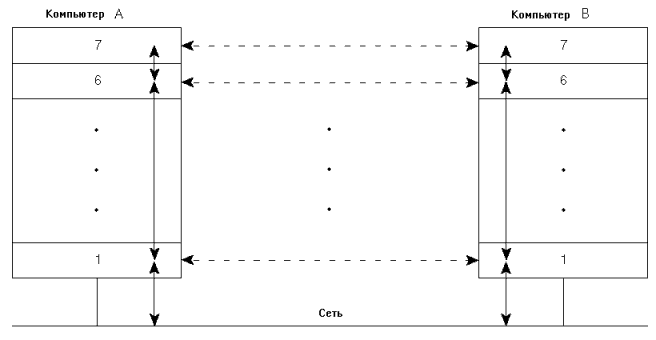
Программа на компьютере А взаимодействует с уровнем 7 (верхний уровень), тот, в свою очередь, с уровнем 6 и так далее, до уровня 1. На этом уровне информация передается в сетевую среду. После передачи через сетевую среду информация попадает на уровень 1 компьютера B и последовательно передается на верхние уровни, пока не достигнет прикладной программы на этом компьютере. Несмотря на то, что каждый уровень на компьютере А взаимодействует лишь с соседним уровнем на этом же компьютере, его реальной задачей является передача информации на одноименный уровень компьютера B (с уровня 1-А на уровень 1-B, 2-A - 2-B и т.д.). Такое взаимодействие между одноименными уровнями разных систем требуется по той причине, что каждый уровень должен выполнять свои определенные задачи. Выполнение этих задач возможно при взаимодействии одноименных уровней разных систем. В реальной сети прямого взаимодействия между одноименными уровнями разных систем не происходит. Вместо этого каждый уровень (за исключением крайних) системы передает информацию (взаимодействует) соседнему (сверху или снизу, в зависимости от направления передачи данных) уровню той же системы. Каждый уровень пользуется услугами нижележащего и предоставляет свои услуги вышележащему уровню. Взаимодействие между соседними уровнями показано на рисунке.
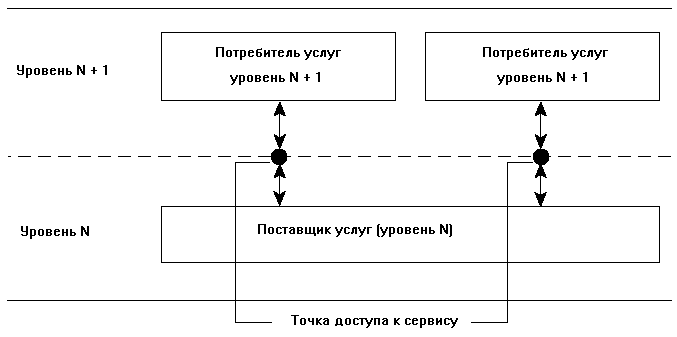
Предположим, что уровень 5 системы А должен взаимодействовать с аналогичным уровнем системы В. Для того, чтобы сделать это уровень 5-А должен сначала передать информацию на уровень 4-А (использовать сервис уровня 4). Уровень 4, в свою очередь, является пользователем услуг уровня 3 (последний в этом случае выступает в качестве поставщика услуг). Услуги для вышележащего уровня обеспечиваются в точках доступа к сервису (service access point - SAP), которые являются просто местом передачи запросов вышележащего уровня нижележащему. Как показано на рисунке, уровень N может являться поставщиком услуг для нескольких потребителей уровня N+1.
Форматы передачи информации
Эталонная модель OSI
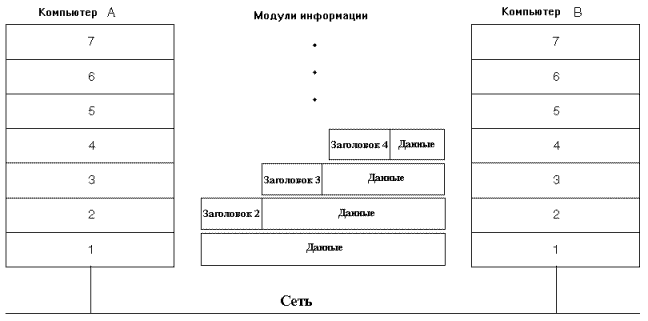
Для представления сетевых протоколов и систем обычно используется эталонная модель OSI (Open System Interconnect), разработанная международным комитетом по стандартизации ISO (International Organization for Standardization). Стек протоколов представляется в виде 7-уровневой структуры, показанной на рисунке.
|
Компьютер 1 |
Обмен данными |
Компьютер 2 |
|
Прикладной v |
<==============> |
Прикладной v |
|
^ Представление v |
<==============> |
^ Представление v |
|
^ Сеансовый v |
<==============> |
^ Сеансовый v |
|
^ Транспортный v |
<==============> |
^ Транспортный v |
|
^ Сетевой v |
<==============> |
^ Сетевой v |
|
^ Канальный v |
<==============> |
^ Канальный v |
|
^ Физический v |
Среда передачи <==============> |
^ Физический v |
|
^ v |
^ v |
В рамках модели OSI взаимодествие двух систем представляется фактически в виде двух моделей - горизонтальной и вертикальной:
в рамках горизонтальной модели рассматривается прямое взаимодействие (обмен данными) одинаковых уровней в двух конечных точках (хостах); для организации такого взаимодействия в каждой из конечных точек должны поддерживаться одинаковые протоколы для данного уровня;
в вертикальной модели рассматривается обмен информацией (взаимодействие) между соседними уровнями одной системы с использованием интерфейсов API; в этой модели каждый уровень может предоставлять свои услуги вышележащему уровню и пользоваться услугами нижележащего уровня (крайние уровни модели в этом смысле представляют исключение - прикладной уровень предоставляет свои услуги пользователю, а сетевой уровень не пользуется сервисом других уровней)
|
Физический
уровень |
Физический уровень отвечает за подключение к физической среде передачи (медь, оптика. радио). Этот уровень получает кадры данных от канального уровня и преобразует их в оптические или электрические сигналы, соответствующие значениям битов в потоке данных. Эти сигналы посылаются через среду передачи на приемный узел. На физическом уровне определяются свойства среды передачи, включая: типы кабелей и разъемов разводку контактов в разъемах схему кодирования сигналов для значений 0 и 1 (модуляция) |
К числу наиболее распространенных спецификаций физического уровня относятся: EIA-RS-232-C, CCITT V.24/V.28 - механические/электрические характеристики несбалансированного последовательного интерфейса. EIA-RS-422/449, CCITT V.10 - механические, электрические и оптические характеристики сбалансированного последовательного интерфейса. IEEE 802.3 -- CSMA/CD (Ethernet) IEEE 802.5 -- Token Ring |
|
Канальный
уровень |
Канальный уровень обеспечивает формирование, передачу и прием кадров данных. Этот уровень обслуживает запросы сетевого уровня и использует сервис физического уровня для приема и передачи пакетов. Спецификации IEEE 802.x делят канальный уровень на два подуровня: управление логическим каналом (LLC) и управление доступом к среде (MAC). LLC обеспечивает обслуживание сетевого уровня, а подуровень MAC регулирует доступ к разделяемой физической среде. |
Наиболее часто на канальном уровне используются протоколы: HDLC для последовательных соединений IEEE 802.2 LLC (тип I и тип II) обеспечивают управление доступом (MAC) для сред 802.x Ethernet Token Ring FDDI X.25 Frame relay PPP |
|
Сетевой
уровень |
Сетевой уровень отвечает за деление пользователей на группы (адресацию) и управление сетью. На этом уровне происходит маршрутизация пакетов на основе преобразования MAC-адресов в сетевые адреса. Сетевой уровень обеспечивает передачу пакетов на транспортный уровень. |
Наиболее часто на сетевом уровне используются протоколы: IP - протокол Internet IPX - протокол межсетевого обмена X.25 (частично этот протокол реализован на уровне 2) CLNP - сетевой протокол без организации соединений |
|
Транспортный уровень Transport Layer |
Транспортный уровень определяет протоколы обмена сообщениями и обеспечивает сквозное управление потоколм данных через сеть. |
Наиболее распространенные протоколы транспортного уровня включают: TCP - протокол управления передачей NCP - Netware Core Protocol SPX - упорядоченный обмен пакетами TP4 - протокол передачи класса 4 |
|
Сеансовый
уровень |
Сеансовый уровень отвечает за организацию и поддержку соединений между сессиями, администрирование и безопасность сети. | |
|
Уровень
представления |
Уровень представления отвечает за возможность диалога между приложениями на разных машинах. Этот уровень обеспечивает преобразование данных (кодирование, компрессия и т.п.) прикладного уровня в поток информации для транспортного уровня. |
На уровне представляения вам наиболее часто будут встречаться протоколы: DNS LDAP NetBIOS/IP |
|
Прикладной
уровень |
Прикладной уровень отвечает за доступ приложений в сеть. Задачами этого уровня является копирование файлов, обмен почтовыми сообщениями и управление сетью. |
К числу наиболее распространенных протоколов прикладного уровня относятся: FTP - протокол копирования файлов TFTP - упрощенный протокол копирования файлов X.400 - электронная почта Telnet - удаленный доступ в сеть SMTP - простой протокол почтового обмена CMIP - общий протокол управления информацией SNMP - простой протокол управления сетью NFS - сетевая файловая система FTAM - метод доступа для копирования файлов |
Модели представления данных в БД: реляционные, иерархические, сетевые. (16)
Существует большое разнообразие сложных типов данных, но исследования, проведенные на большом практическом материале, показали, что среди них можно выделить несколько наиболее общих. Обобщенные структуры называют также моделями данных, т.к. они отражают представление пользователя о данных реального мира.
Любая модель данных должна содержать три компоненты:
структура данных - описывает точку зрения пользователя на представление данных.
набор допустимых операций, выполняемых на структуре данных. Модель данных предполагает, как минимум, наличие языка определения данных (ЯОД), описывающего структуру их хранения, и языка манипулирования данными (ЯМД), включающего операции извлечения и модификации данных.
ограничения целостности - механизм поддержания соответствия данных предметной области на основе формально описанных правил.
Иерархические системы
Типичным представителем (наиболее известным и распространенным) является Information Management System (IMS) фирмы IBM. Первая версия появилась в 1968 г. До сих пор поддерживается много баз данных, что создает существенные проблемы с переходом как на новую технологию БД, так и на новую технику.
Иерархические структуры данных
Иерархическая БД состоит из упорядоченного набора деревьев; более точно, из упорядоченного набора нескольких экземпляров одного типа дерева. Тип дерева состоит из одного "корневого" типа записи и упорядоченного набора из нуля или более типов поддеревьев (каждое из которых является некоторым типом дерева). Тип дерева в целом представляет собой иерархически организованный набор типов записи.
Пример типа дерева (схемы иерархической БД):
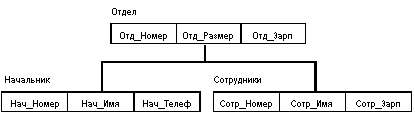
Здесь Отдел является предком для Начальник и Сотрудники, а Начальник и Сотрудники - потомки Отдел. Между типами записи поддерживаются связи. База данных с такой схемой могла бы выглядеть следующим образом (мы показываем один экземпляр дерева):
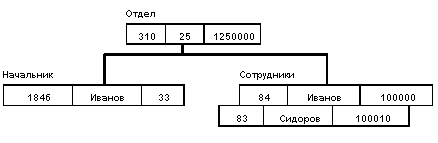
Все экземпляры данного типа потомка с общим экземпляром типа предка называются близнецами. Для БД определен полный порядок обхода - сверху-вниз, слева-направо. В IMS использовалась оригинальная и нестандартная терминология: "сегмент" вместо "запись", а под "записью БД" понималось все дерево сегментов.
Манипулирование данными
Примерами типичных операторов манипулирования иерархически организованными данными могут быть следующие:
Найти указанное дерево БД (например, отдел 310);
Перейти от одного дерева к другому;
Перейти от одной записи к другой внутри дерева (например, от отдела - к первому сотруднику);
Перейти от одной записи к другой в порядке обхода иерархии;
Вставить новую запись в указанную позицию;
Удалить текущую запись.
Ограничения целостности
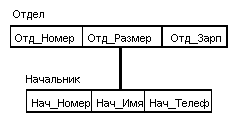
Автоматически поддерживается целостность ссылок между предками и потомками. Основное правило: никакой потомок не может существовать без своего родителя. Заметим, что аналогичное поддержание целостности по ссылкам между записями, не входящими в одну иерархию, не поддерживается (примером такой "внешней" ссылки может быть содержимое поля Каф_Номер в экземпляре типа записи Куратор). В иерархических системах поддерживалась некоторая форма представлений БД на основе ограничения иерархии. Примером представления приведенной выше БД может быть иерархия
Сетевые системы
Типичным представителем является Integrated Database Management System (IDMS) компании Cullinet Software, Inc., предназначенная для использования на машинах основного класса фирмы IBM под управлением большинства операционных систем. Архитектура системы основана на предложениях Data Base Task Group (DBTG) Комитета по языкам программирования Conference on Data Systems Languages (CODASYL), организации, ответственной за определение языка программирования Кобол. Отчет DBTG был опубликован в 1971 г., а в 70-х годах появилось несколько систем, среди которых IDMS.
Сетевые структуры данных
Сетевой подход к организации данных является расширением иерархического. В иерархических структурах запись-потомок должна иметь в точности одного предка; в сетевой структуре данных потомок может иметь любое число предков. Сетевая БД состоит из набора записей и набора связей между этими записями, а если говорить более точно, из набора экземпляров каждого типа из заданного в схеме БД набора типов записи и набора экземпляров каждого типа из заданного набора типов связи. Тип связи определяется для двух типов записи: предка и потомка. Экземпляр типа связи состоит из одного экземпляра типа записи предка и упорядоченного набора экземпляров типа записи потомка. Для данного типа связи L с типом записи предка P и типом записи потомка C должны выполняться следующие два условия:
Каждый экземпляр типа P является предком только в одном экземпляре L;
Каждый экземпляр C является потомком не более, чем в одном экземпляре L.
На формирование типов связи не накладываются особые ограничения; возможны, например, следующие ситуации:
Тип записи потомка в одном типе связи L1 может быть типом записи предка в другом типе связи L2 (как в иерархии).
Данный тип записи P может быть типом записи предка в любом числе типов связи.
Данный тип записи P может быть типом записи потомка в любом числе типов связи.
Может существовать любое число типов связи с одним и тем же типом записи предка и одним и тем же типом записи потомка; и если L1 и L2 - два типа связи с одним и тем же типом записи предка P и одним и тем же типом записи потомка C, то правила, по которым образуется родство, в разных связях могут различаться.
Типы записи X и Y могут быть предком и потомком в одной связи и потомком и предком - в другой.
Предок и потомок могут быть одного типа записи.
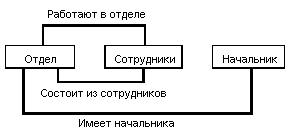
Простой пример сетевой схемы БД:
Манипулирование данными
Примерный набор операций может быть следующим:
Найти конкретную запись в наборе однотипных записей (инженера Сидорова);
Перейти от предка к первому потомку по некоторой связи (к первому сотруднику отдела 310);
Перейти к следующему потомку в некоторой связи (от Сидорова к Иванову);
Перейти от потомка к предку по некоторой связи (найти отдел Сидорова);
Создать новую запись;
Уничтожить запись;
Модифицировать запись;
Включить в связь;
Исключить из связи;
Переставить в другую связь и т.д.
Ограничения целостности
В принципе их поддержание не требуется, но иногда требуют целостности по ссылкам (как в иерархической модели).
Базовые понятия реляционных баз данных
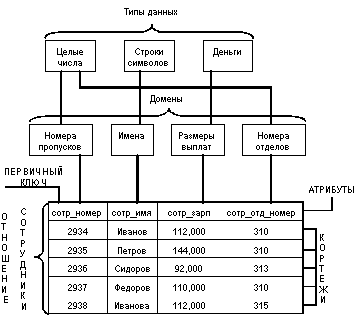
Основными понятиями реляционных баз данных являются тип данных, домен, атрибут, кортеж, первичный ключ и отношение. Для начала покажем смысл этих понятий на примере отношения СОТРУДНИКИ, содержащего информацию о сотрудниках некоторой организации:
Тип данных
Понятие тип данных в реляционной модели данных полностью адекватно понятию типа данных в языках программирования. Обычно в современных реляционных БД допускается хранение символьных, числовых данных, битовых строк, специализированных числовых данных (таких как "деньги"), а также специальных "темпоральных" данных (дата, время, временной интервал). Достаточно активно развивается подход к расширению возможностей реляционных систем абстрактными типами данных (соответствующими возможностями обладают, например, системы семейства Ingres/Postgres). В нашем примере мы имеем дело с данными трех типов: строки символов, целые числа и "деньги".
Домен
Понятие домена более специфично для баз данных, хотя и имеет некоторые аналогии с подтипами в некоторых языках программирования. В самом общем виде домен определяется заданием некоторого базового типа данных, к которому относятся элементы домена, и произвольного логического выражения, применяемого к элементу типа данных. Если вычисление этого логического выражения дает результат "истина", то элемент данных является элементом домена. Наиболее правильной интуитивной трактовкой понятия домена является понимание домена как допустимого потенциального множества значений данного типа. Например, домен "Имена" в нашем примере определен на базовом типе строк символов, но в число его значений могут входить только те строки, которые могут изображать имя (в частности, такие строки не могут начинаться с мягкого знака). Следует отметить также семантическую нагрузку понятия домена: данные считаются сравнимыми только в том случае, когда они относятся к одному домену. В нашем примере значения доменов "Номера пропусков" и "Номера групп" относятся к типу целых чисел, но не являются сравнимыми. Заметим, что в большинстве реляционных СУБД понятие домена не используется, хотя в Oracle V.7 оно уже поддерживается.
Схема отношения, схема базы данных
Схема отношения - это именованное множество пар {имя атрибута, имя домена (или типа, если понятие домена не поддерживается)}. Степень или "арность" схемы отношения - мощность этого множества. Степень отношения СОТРУДНИКИ равна четырем, то есть оно является 4-арным. Если все атрибуты одного отношения определены на разных доменах, осмысленно использовать для именования атрибутов имена соответствующих доменов (не забывая, конечно, о том, что это является всего лишь удобным способом именования и не устраняет различия между понятиями домена и атрибута). Схема БД (в структурном смысле) - это набор именованных схем отношений.
Кортеж, отношение
Кортеж, соответствующий данной схеме отношения, - это множество пар {имя атрибута, значение}, которое содержит одно вхождение каждого имени атрибута, принадлежащего схеме отношения. "Значение" является допустимым значением домена данного атрибута (или типа данных, если понятие домена не поддерживается). Тем самым, степень или "арность" кортежа, т.е. число элементов в нем, совпадает с "арностью" соответствующей схемы отношения. Попросту говоря, кортеж - это набор именованных значений заданного типа. Отношение - это множество кортежей, соответствующих одной схеме отношения. Иногда, чтобы не путаться, говорят "отношение-схема" и "отношение-экземпляр", иногда схему отношения называют заголовком отношения, а отношение как набор кортежей - телом отношения. На самом деле, понятие схемы отношения ближе всего к понятию структурного типа данных в языках программирования. Было бы вполне логично разрешать отдельно определять схему отношения, а затем одно или несколько отношений с данной схемой. Однако в реляционных базах данных это не принято. Имя схемы отношения в таких базах данных всегда совпадает с именем соответствующего отношения-экземпляра. В классических реляционных базах данных после определения схемы базы данных изменяются только отношения-экземпляры. В них могут появляться новые и удаляться или модифицироваться существующие кортежи. Однако во многих реализациях допускается и изменение схемы базы данных: определение новых и изменение существующих схем отношения. Это принято называть эволюцией схемы базы данных. Обычным житейским представлением отношения является таблица, заголовком которой является схема отношения, а строками - кортежи отношения-экземпляра; в этом случае имена атрибутов именуют столбцы этой таблицы. Поэтому иногда говорят "столбец таблицы", имея в виду "атрибут отношения". Когда мы перейдем к рассмотрению практических вопросов организации реляционных баз данных и средств управления, мы будем использовать эту житейскую терминологию. Этой терминологии придерживаются в большинстве коммерческих реляционных СУБД. Реляционная база данных - это набор отношений, имена которых совпадают с именами схем отношений в схеме БД. Как видно, основные структурные понятия реляционной модели данных (если не считать понятия домена) имеют очень простую интуитивную интерпретацию, хотя в теории реляционных БД все они определяются абсолютно формально и точно.
Основные принципы ООП: инкапсуляция, полиморфизм, наследование. (12)
Все языки OOP, включая С++, основаны на трёх основополагающих концепциях, называемых инкапсуляцией, полиморфизмом и наследованием. Рассмотрим эти концепции.
Инкапсуляция
Инкапсуляция (encapsulation) - это механизм, который объединяет данные и код, манипулирующий зтими данными, а также защищает и то, и другое от внешнего вмешательства или неправильного использования. В объектно-ориентированном программировании код и данные могут быть объединены вместе; в этом случае говорят, что создаётся так называемый "чёрный ящик". Когда коды и данные объединяются таким способом, создаётся объект (object). Другими словами, объект - это то, что поддерживает инкапсуляцию. Внутри объекта коды и данные могут быть закрытыми (private). Закрытые коды или данные доступны только для других частей этого объекта. Таким образом, закрытые коды и данные недоступны для тех частей программы, которые существуют вне объекта. Если коды и данные являются открытыми, то, несмотря на то, что они заданы внутри объекта, они доступны и для других частей программы. Характерной является ситуация, когда открытая часть объекта используется для того, чтобы обеспечить контролируемый интерфейс закрытых элементов объекта. На самом деле объект является переменной определённого пользователем типа. Может показаться странным, что объект, который объединяет коды и данные, можно рассматривать как переменную. Однако применительно к объектно-ориентированному программированию это именно так. Каждый элемент данных такого типа является составной переменной.
Полиморфизм
Полиморфизм (polymorphism) (от греческого polymorphos) - это свойство, которое позволяет одно и то же имя использовать для решения двух или более схожих, но технически разных задач. Целью полиморфизма, применительно к объектно-ориентированному программированию, является использование одного имени для задания общих для класса действий. Выполнение каждого конкретного действия будет определяться типом данных. Например для языка Си, в котором полиморфизм поддерживается недостаточно, нахождение абсолютной величины числа требует трёх различных функций: abs(), labs() и fabs(). Эти функции подсчитывают и возвращают абсолютную величину целых, длинных целых и чисел с плавающей точкой соответственно. В С++ каждая из этих функций может быть названа abs(). Тип данных, который используется при вызове функции, определяет, какая конкретная версия функции действительно выполняется. В С++ можно использовать одно имя функции для множества различных действий. Это называется перегрузкой функций (function overloading). В более общем смысле, концепцией полиморфизма является идея "один интерфейс, множество методов". Это означает, что можно создать общий интерфейс для группы близких по смыслу действий. Преимуществом полиморфизма является то, что он помогает мнижать сложность программ, разрешая использование того же интерфейса для задания единого класса действий. Выбор же конкретного действия, в зависимости от ситуации, возлагается на компилятор. Вам, как программисту, не нужно делать этот выбор самому. Нужно только помнить и использовать общий интерфейс. Пример из предыдущего абзаца показывает, как, имея три имени для функции определения абсолютной величины числа вместо одного, обычная задача становится более сложной, чем это действительно необходимо. Полиморфизм может применяться также и к операторам. Фактически во всех языках программирования ограниченно применяется полиморфизм, например, в арифметических операторах. Так, в Си, символ + используется для складывания целых, длинных целых, символьных переменных и чисел с плавающей точкой. В этом случае компилятор автоматически определяет, какой тип арифметики требуется. В С++ вы можете применить эту концепцию и к другим, заданным вами, типам данных. Такой тип полиморфизма называется перегрузкой операторов (operator overloading). Ключевым в понимании полиморфизма является то, что он позволяет вам манипулировать объектами различной степени сложности путём создания общего для них стандартного интерфейса для реализации похожих действий.
Наследование
Наследование (inheritance) - это процесс, посредством которого один объект может приобретать свойства другого. Точнее, объект может наследовать основные свойства другого объекта и добавлять к ним черты, характерные только для него. Наследование является важным, поскольку оно позволяет поддерживать концепцию иерархии классов (hierarchical classification). Применение иерархии классов делает управляемыми большие потоки информации. Например, подумайте об описании жилого дома. Дом - это часть общего класса, называемого строением. С другой стороны, строение - это часть более общего класса - конструкции, который является частью ещё более общего класса объектов, который можно назвать созданием рук человека. В каждом случае порождённый класс наследует все, связанные с родителем, качества и добавляет к ним свои собственные определяющие характеристики. Без использования иерархии классов, для каждого объекта пришлось бы задать все характеристики, которые бы исчерпывающи его определяли. Однако при использовании наследования можно описать объект путём определения того общего класса (или классов), к которому он относится, с теми специальными чертами, которые делают объект уникальным. Наследование играет очень важную роль в OOP.
Распределенные БД. Однородные и разнородные БД. Технология клиент-сервер. (18)
Распределенные базы данных
Основная задача систем управления распределенными базами данных состоит в обеспечении средства интеграции локальных баз данных, располагающихся в некоторых узлах вычислительной сети, с тем, чтобы пользователь, работающий в любом узле сети, имел доступ ко всем этим базам данных как к единой базе данных. При этом должны обеспечиваться: простота использования системы; возможности автономного функционирования при нарушениях связности сети или при административных потребностях; высокая степень эффективности.
Разновидности распределенных систем
Возможны однородные и неоднородные распределенные базы данных. В однородном случае каждая локальная база данных управляется одной и той же СУБД. В неоднородной системе локальные базы данных могут относиться даже к разным моделям данных. Сетевая интеграция неоднородных баз данных - это актуальная, но очень сложная проблема. Многие решения известны на теоретическом уровне, но пока не удается справиться с главной проблемой - недостаточной эффективностью интегрированных систем. Заметим, что более успешно практически решается промежуточная задача - интеграция неоднородных SQL-ориентированных систем. Понятно, что этому в большой степени способствует стандартизация языка SQL и общее следование производителей СУБД принципам открытых систем.
Архитектура "клиент-сервер"
Применительно к системам баз данных архитектура "клиент-сервер" интересна и актуальна главным образом потому, что обеспечивает простое и относительно дешевое решение проблемы коллективного доступа к базам данных в локальной сети. В некотором роде системы баз данных, основанные на архитектуре "клиент-сервер", являются приближением к распределенным системам баз данных, конечно, существенно упрощенным приближением, но зато не требующим решения основного набора проблем действительно распределенных баз данных.
Клиенты и серверы локальных сетей
В основе широкого распространения локальных сетей компьютеров лежит известная идея разделения ресурсов. Высокая пропускная способность локальных сетей обеспечивает эффективный доступ из одного узла локальной сети к ресурсам, находящимся в других узлах.
Развитие этой идеи приводит к функциональному выделению компонентов сети: разумно иметь не только доступ к ресурсами удаленного компьютера, но также получать от этого компьютера некоторый сервис, который специфичен для ресурсов данного рода и программные средства для обеспечения которого нецелесообразно дублировать в нескольких узлах. Так мы приходим к различению рабочих станций и серверов локальной сети.
Рабочая станция предназначена для непосредственной работы пользователя или категории пользователей и обладает ресурсами, соответствующими локальным потребностям данного пользователя. Специфическими особенностями рабочей станции могут быть объем оперативной памяти (далеко не все категории пользователей нуждаются в наличии большой оперативной памяти), наличие и объем дисковой памяти (достаточно популярны бездисковые рабочие станции, использующие внешнюю память дискового сервера), характеристики процессора и монитора (некоторым пользователям нужен мощный процессор, других в большей степени интересует разрешающая способность монитора, для третьих обязательно требуются средства убыстрения графики и т.д.). При необходимости можно использовать ресурсы и/или услуги, предоставляемые сервером.
Сервер локальной сети должен обладать ресурсами, соответствующими его функциональному назначению и потребностям сети. Заметим, что в связи с ориентацией на подход открытых систем, правильнее говорить о логических серверах (имея в виду набор ресурсов и программных средств, обеспечивающих услуги над этими ресурсами), которые располагаются не обязательно на разных компьютерах. Особенностью логического сервера в открытой системе является то, что если по соображениям эффективности сервер целесообразно переместить на отдельный компьютер, то это можно проделать без потребности в какой-либо переделке как его самого, так и использующих его прикладных программ.
Примерами сервером могут служить:
сервер телекоммуникаций, обеспечивающий услуги по связи данной локальной сети с внешним миром;
вычислительный сервер, дающий возможность производить вычисления, которые невозможно выполнить на рабочих станциях;
дисковый сервер, обладающий расширенными ресурсами внешней памяти и предоставляющий их в использование рабочим станциями и, возможно, другим серверам;
файловый сервер, поддерживающий общее хранилище файлов для всех рабочих станций;
сервер баз данных фактически обычная СУБД, принимающая запросы по локальной сети и возвращающая результаты.
Сервер локальной сети предоставляет ресурсы (услуги) рабочим станциям и/или другим серверам.
Принято называть клиентом локальной сети, запрашивающий услуги у некоторого сервера и сервером - компонент локальной сети, оказывающий услуги некоторым клиентам.
Системная архитектура "клиент-сервер"
Понятно, что в общем случае, чтобы прикладная программа, выполняющаяся на рабочей станции, могла запросить услугу у некоторого сервера, как минимум требуется некоторый интерфейсный программный слой, поддерживающий такого рода взаимодействие (было бы по меньшей мере неестественно требовать, чтобы прикладная программа напрямую пользовалась примитивами транспортного уровня локальной сети). Из этого, собственно, и вытекают основные принципы системной архитектуры "клиент-сервер".
Система разбивается на две части, которые могут выполняться в разных узлах сети, - клиентскую и серверную части. Прикладная программа или конечный пользователь взаимодействуют с клиентской частью системы, которая в простейшем случае обеспечивает просто надсетевой интерфейс. Клиентская часть системы при потребности обращается по сети к серверной части. Заметим, что в развитых системах сетевое обращение