Кодеры речи
Глава1 Кодеры формы.
Кодеры формы характеризуются способностью сохранять основную форму речевого сигнала. Кодеры формы не являются специфичными для речи в том смысле, что они с успехом работают с любой формой входного сигнала, и их применение ограничено только пределами амплитуды и шириной полосы. Сохраняя огибающую формы сигнала, подобные кодеры работают по принципу выборка-выборка, и их характеристики эффективно измеряются отношением сигнал/шум (ОСШ), так как квантование является основным источником искажений формы выходного сигнала.
ИКМ — первый мировой стандарт кодирования речи со скоростью 64 кбит/с с логарифмическим сжатием (по μ-закону для Северной Америки и А-закону для Европы). ИКМ-кодер является кодером формы и все еще широко используется в цифровых системах. ИКМ со скоростью 64 кбит/с в основном используется как предварительное звено низкоскоростных речевых кодеров, поскольку ее характеристики считаются очень высококачественными. Позже был разработан стандарт на адаптивную дифференциальную ИКМ (АДИКМ) со скоростью 32 кбит/с. Снижение скорости цифрового потока наполовину было достигнуто благодаря использованию адаптивного предсказания и адаптивных квантователей для устранения избыточности речи. Некоторые другие кодеры, например с дельта-модуляцией и плавно изменяющейся крутизной (CVSDM — Continuous Variable Slope Delta Modulation) на скорости 32 кбит/с, используются для решения специфичных задач. Хотя подобные высокоскоростные алгоритмы кодирования малоэффективны, они, тем не менее, остаются самыми эксплуатируемыми системами и, возможно, будут оставаться таковыми еще некоторое время.
Импульсно-кодовая модуляция ИКМ (РСМ – Pulse Code Modulation). Рекомендация G.711
При построении систем цифровой передачи непрерывных сообщений принципиальным моментом является определение полосы частот, требуемой для обеспечения заданного качества воспроизведения переданного сообщения. Вообще говоря, для высококачественной передачи речевого сообщения требуется полоса не менее 10 кГц.
Однако для достижения удовлетворительного уровня разборчивости при передаче речи по телефонным каналам достаточно передать спектр в полосе 300...3400 Гц. Именно такой спектр звуковых частот обычно передается в современных системах передачи речевой информации.
Как
правило, максимальная
частота передаваемого
спектра аудиосигнала
выбирается
равной
 ,а
частота дискретизации
 (например,
рекомендации
G.711, G.721), хотя в ряде
случаев с целью
повышения
качества передачи
используются
и более высокие
значения этих
величин (например,
рекомендация
G.722).
При
использовании
ИКМ дискретизированное
сообщение
подвергается
квантованию
по L
уровням (рис.
1.1), в результате
чего каждому
значению
 ставится в
соответствие
число
 ,
 ,
представленное
n-разрядной
комбинацией
двоичного кода.
Для
достижения
приемлемого
качества
восприятия
восстановленного
речевого сообщения
при равномерном
(простом) квантовании
необходимо
 .
Столь большое
число
 уровней квантования
при
требует скорости
передачи символов
в канале не
менее
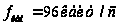 .
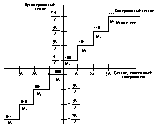
Рисунок 5.8
Однако
в связи с тем,
что при восприятии
речи человеческим
ухом в области
больших мгновенных
значений
 оказываются
допустимыми
значительно
большие искажения
сообщения, чем
в области малых
мгновенных
значений, требуемое
число уровней
квантования
может быть
существенно
снижено путем
использования
неравномерного
квантования,
используя
компрессию
исходного
сообщения по
логарифмическому
закону с последующим
равномерным
квантованием
при сравнительно
малом числе
уровней (например,
при
 или путем
соответствующего
цифрового
преобразования
(цифровой компрессии)
сообщения,
предварительно
преобразованного
в цифровую
форму при
сравнительно
большом исходном
числе уровней
квантования
(например, при
 ).
Оптимальный квантователь имеет преимущества, если динамический диапазон входного сигнала фиксирован и достаточно мал. Характеристики квантователя быстро ухудшаются, мощность сигнала изменяется относительно значения, на которое он был рассчитан. Хотя этим процессом можно управлять, нормализуя входной сигнал и приводя его к единому диапазону, для правильного определения масштаба амплитуды восстановленного после квантователя сигнала потребуется дополнительно несколько бит, необходимых для передачи динамического диапазона сигнала в определенные моменты времени.
Для
обработки
входных речевых
сигналов с
большим динамическим
диапазоном
используются
два закона
сжатия, называемые
импульсно-кодовой
модуляцией
по закону
 (А-ИКМ)
и по закону μ
(μ-ИКМ).
В обеих схемах
характеристика
отношения
сигнал/шум
квантования
(ОСШкв)
должна быть
близка к характеристике
для простого
квантователя.
Вместе с тем
характеристики
А-ИКМ
и μ-ИКМ
существенно
не изменяются
и остаются
сравнительно
постоянными
в большом диапазоне
уровней входного
сигнала. По
сравнению с
простыми
квантователями
(рис. 1.1) квантователи
сжатия требуют
меньше бит на
входную выборку
для определенного
динамического
диапазона
сжатия и меньшего
ОСШкв.
В квантователях
сжатия уровни
квантования
находятся в
области малых
амплитуд, которые
увеличиваются
при увеличении
диапазона
входного сигнала.
Благодаря этому
при квантовании
речевых сигналов,
у которых максимум
функции распределения
вероятностей
находится в
начале координат,
наиболее часто
встречающиеся
малые амплитуды
квантуются
с большей точностью,
чем менее вероятные
большие амплитуды,
что приводит
к значительно
лучшим, Чем у
простого
квантователя,
характеристикам.
Сжатие по А-закону определяется зависимостью:
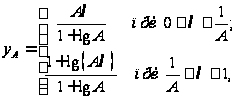 52
где A — параметр сжатия с типовыми значениями 86 (Северо-Американская ИКМ) и 87,56 (Европейская ИКМ) для семибитных речевых квантователей.
Сжатие по μ-закону определяется выражением
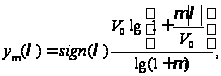 52
где
V0
задается формулой
 ,
в которой L
– нагрузочный
фактор, a
 –
среднеквадратическое
значение входного
речевого сигнала.
Типовое значение фактора сжатия μ равно 255. Выражение (1.1) показывает, что А-закон — это комбинация логарифмической кривой, используемой для больших амплитуд, и линейного участка, используемого на малых амплитудах. μ-закон не является в точности линейным или логарифмическим ни в одном диапазоне, однако является приблизительно линейным для малых амплитуд и приблизительно логарифмическим для больших амплитуд. Сравнение между квантователем по μ-закону и оптимальным квантователем показало, что оптимальный квантователь дает выигрыш 4 дБ, однако может иметь более высокий уровень фонового шума, когда канал свободен, и его динамический диапазон сведен к минимальному диапазону входного сигнала. Поэтому наиболее предпочтителен логарифмический квантователь.
Цифровое преобразование непрерывного речевого сообщения в соответствии с рекомендацией G.711 (рис. 1.2) используется наиболее часто.
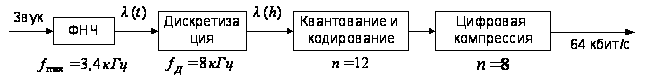
Рисунок 5.8
При
этом
;
частота дискретизации
.
После равномерного
квантования
при числе уровней
 и
предварительного
кодирования
производится
цифровая компрессия,
в результате
чего длина
кодовой комбинации
уменьшается
до
разрядов. Результатом
преобразования
является двоичная
последовательность,
передаваемая
со скоростью
64 кбит/с.
Из различных систем адаптивной ИКМ (АИКМ) наибольшее распространение получила система блочной ИКМ (БИКМ), оторую часто называют системой с почти мгновенным компандированием (NIC — Near Instantaneous Companding).
Отсчеты n-разрядного АЦП разбивают на блоки по N отсчетов. В каждом блоке находят отсчет с максимальным для данного блока уровнем. Этому уровню соответствует определенный номер старшего значащего разряда (j), и все старшие разряды в комбинациях этого блока будут нулевыми. Записанный в двоичном коде номер этого разряда образует масштабную информацию, которая из-за своей важности, как правило, защищается помехоустойчивым кодом. В результате масштабная информация вместе с проверочными символами образует m-значную комбинацию, которую добавляют к основной информации.
Основная информация формируется выбором k разрядов из n исходных разрядов, причем первым (старшим) разрядом является разряд с номером, описанным в масштабной информации.
Основная
информация
для каждого
из блоков
объединяется
с масштабной
в единый цифровой
поток. Результирующая
скорость цифрового
потока на выходе
системы БИКМ
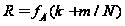 .
На практике,
как правило,
используют
следующие
параметры:
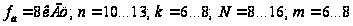 .
При одинаковых условиях передачи БИКМ дает лучшее качество, чем ИКМ. Поэтому можно снизить скорость передачи до 32.. .56 кбит/с.
Дифференциальная импульсно-кодовая модуляция ДИКМ (DPCM – Differencial Pulse Code Modulation)
Наряду
с ИКМ применяются
и более эффективные
цифровые методы
передачи речи.
В частности,
с целью снижения
требований
к пропускной
способности
канала можно
использовать
наличие корреляции
между отчетными
значениями
передаваемого
сообщения.
Такой метод
называется
передачей с
предсказанием.
При этом последовательность
значений
поступает на
один вход вычитающего
устройства
(рис. 1.3,а), в то время
как на другой
вход поступает
предсказанное
значение
 ,
полученное
тем или иным
методом в устройстве
предсказания
на основе анализа
как предыдущих
отсчетных
значений сообщения,
так и текущих
передаваемых
значений на
входе вычитающего
устройства.
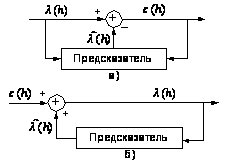
Рисунок 5.8
На
приемном конце
значения сообщения
 восстанавливаются
путем добавления
принятого
сигнала ошибки
предсказания
 к предсказываемому
значению
(рис. 1.3,б).
В системе
с дифференциальной
импульсно-кодовой
модуляцией
(ДИКМ) отсчетные
значения
ошибки предсказания
подвергаются
квантованию
с переходом
к значениям
 аналогично
тому, как это
делается при
использовании
обычной ИКМ,
однако при
существенно
меньшем числе
уровней квантования.
Таким образом,
при одинаковом
качестве передачи
речи метод ДИКМ
позволяет
использовать
меньшее число
разрядов n в
кодовых комбинациях
по сравнению
с ИКМ. При этом
существует
большое число
различных
вариантов
реализации
метода ДИКМ,
наиболее типичный
из которых
представлен
на рис. 1.4.
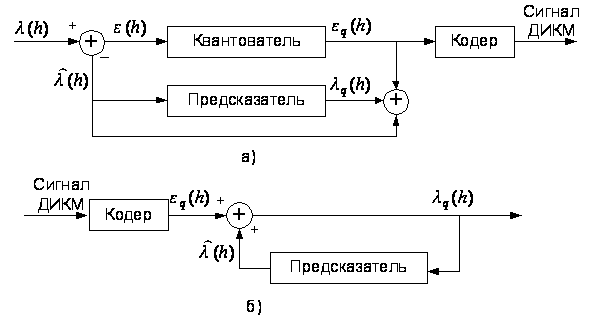
Рисунок 5.8
При этом имеют место соотношения:
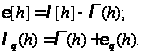 52
Классификационными признаками кодеров ДИКМ считаются наличие блока линейного предсказания авторегрессионных последовательностей (предсказателя) и использование многоуровневого (больше двух уровней) квантователя. Блок линейного предсказания может состоять из двух частей — долговременного и кратковременного предсказателей. В канал передается разность истинного и предсказанного значений сигнала (сигнал-остаток, он же – погрешность предсказания). Системы с ДИКМ обеспечивают такое качество восстановления сигнала, которое сопоставимо с предоставляемым ИКМ, и на порядок более высокую помехоустойчивость.
Эффективность метода ДИКМ может быть повышена путем пере хода к адаптивной дифференциальной импульсно-кодовой модуляции АДИКМ.
Адаптивная дифференциальная импульсно-кодовая модуляция (ADPCM — Adaptive Differencial Pulse Code Modulation). Рекомендации G.721 и G.726
ADPCM – один из наиболее общепринятых и давно используемых алгоритмов сжатия речи, который регламентируется стандартом G.726, был принят в 1984 г. Этот алгоритм дает практически такое же качество воспроизведения речи, как и РСМ, однако для передачи информации при его использовании требуется всего 32 кбит/с. Метод основан на том, что в аналоговом сигнале, передающем речь, невозможны резкие скачки интенсивности. Поэтому, если кодировать не саму амплитуду сигнала, а ее изменение по сравнению с предыдущим значением, то можно обойтись меньшим числом разрядов. В ADPCM изменение уровня сигнала кодируется четырехразрядным числом, при этом частота измерения амплитуды сигнала сохраняется неизменной.
Все методы кодирования, основанные на определенных предположениях о форме сигнала, плохо работают в ситуации, когда сигнал может передаваться с резкими скачками амплитуды. Именно такой вид имеет аудиосигнал, генерируемый модемам или факсимильными аппаратами. Современные системы обмена информацией, поддерживающие цифровые линии связи, умеют распознавать факсимильный обмен и передают соответствующие сигналы непосредственно в цифровом виде, не преобразуя их в аудиосигнал.
Нелинейный
15-уровневый
адаптивный
квантователь
используется
для квантования
разностного
сигнала
 .
Перед квантованием
сигнал
логарифмируется
по основанию
2 и масштабируются
посредством
коэффициента
 ,
который вычисляется
с помощью блока
адаптации
масштабного
коэффициента.
Для
определения
квантованного
уровня
используются
четыре двоичных
символа (три
для амплитуды
и один для знака).
Четырехбитовый
выход квантователя
 образует выходной
цифровой сигнал
со скоростью
32 кбит/с, который
одновременно
подается на
инверсный
адаптивный
квантователь
и блок управления
скоростью
адаптации
масштабного
коэффициента
квантователя.
Квантованная
версия разностного
сигнала
 формируется
путем масштабирования
с использованием
специальной
величины
,
выделяемой
из нормализованной
характеристики
квантователя,
и дальнейшей
трансформации
результата
из логарифмического
представления.
Блок
адаптации
масштабного
коэффициента
квантователя
вычисляет
— масштабный
коэффициент
для квантователя
и инверсного
квантователя.
На его входы
подаются
четырехбитовые
выходные сигналы
квантователя
и параметр
управления
скоростью
адаптации
 .
Основной принцип, реализуемый при масштабировании, заключается в бимодальной адаптации:
– быстрой – для сигналов (например, речевых), которые дают разностные сигналы с большими флуктуациями;
–медленной – для сигналов (например, данных в диапазоне тональных частот, тонов), которые дают разностные сигналы с малыми флуктуациями.
Управление скоростью адаптации производится с помощью комбинации быстрого и медленного масштабных коэффициентов.
Быстрый
(нефиксированный)
масштабный
коэффициент
 вычисляется
рекурсивно
в логарифмическом
представлении
с основанием
2 из результирующего
логарифмического
масштабного
коэффициента:
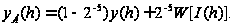 52
Как
правило,
лежит в пределах
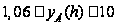 .
Дискретная
функция
 определяется
табличным
образом. Множитель
(1 – 2-5) вводит
ограниченную
память в процесс
адаптации таким
образом, что
состояния
кодера и декодера
сходятся при
ошибках передачи.
Медленный
(фиксированный)
масштабный
коэффициент
 получается
из
с помощью операции
фильтрации
нижних частот:
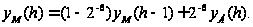 52
Затем быстрый и медленный масштабные коэффициенты объединяются для получения результирующего масштабного коэффициента:
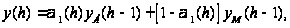 52
где
 .
Управление
скоростью
адаптации.
Предполагается,
что управляющий
параметр
 может принимать
значения в
диапазоне [0,
1]. Для речевых
сигналов он
стремится к
единице, Для
сигналов, данных
в диапазоне
тональных
частот и одночастотных
сигналов он
стремится к
нулю. Величина
коэффициента
определяется
мерой скорости
изменения
величины разностного
сигнала.
Адаптивный
предсказатель
и калькулятор
восстановленного
сигнала.
Первоначальная
функция адаптивного
предсказателя
заключается
в вычислении
оценки
 разностного
сигнала
.
Используются
две структуры
адаптивного
предсказателя
– каскад первого
порядка, моделирующий
нули, и каскад
второго порядка,
моделирующий
полюсы во входном
сигнале.
Детектор тона и перехода. С целью улучшения рабочих характеристик для сигналов, поступающих с выходов модемов с частотной манипуляцией, работающих в режиме кодовых комбинаций, определен двухступенчатый процесс декодирования. Сначала производится детектирование сигнала с ограниченной полосой (например, тона), в результате чего квантователь может быть переведен в быстрый режим адаптации.
Упрощенная и развернутая структурные схемы декодера АДНКМ приведены на рис. 1.6,а и 1.7,б соответственно. Декодер включает схему, идентичную цепи обратной связи кодера, преобразователь линейной ИКМ в сигнал по законам А или μ и устройство установки синхронного кодирования.
Устройство установки синхронного кодирования предотвращает накопление искажений, имеющих место при синхронном последовательном кодировании (АДИКМ-ИКМ-АДИКМ, другие цифровые соединения). Установка синхронного кодирования достигается путем подстройки проходного кода ИКМ таким образом, чтобы попытаться устранить искажения квантования в следующем каскаде кодирования АДИКМ.
Функции основных блоков декодера и кодера совпадают и поэтому ниже не рассматриваются.
Вокодеры
Вокодер (от английских слов voice – голос и coder – кодировщик) представляет собой устройство, осуществляющее параметрическое компандирование речевых сигналов. Компрессия речевых сигналов на передающем конце канала связи производится в анализаторе, выделяющем из речевого сигнала медленно меняющиеся составляющие, которые передаются по каналу связи в виде кодовых посылок. На приемном конце с помощью местных источников сигналов, управляемых принятыми параметрами, синтезируется речевой сигнал.
Работа вокодеров основана на моделировании человеческой речи с учетом ее характерных особенностей. Вместо непосредственного измерения амплитуды вокодер преобразует входной сигнал в некий другой, похожий на исходный. Причем измеряемые характеристики речевого сигнала используются для подгонки параметров в принятой модели речевого сигнала. Именно эти параметры и передаются приемнику, который по ним восстанавливает исходный речевой сигнал. По существу, речь идет о синтезе речи. Естественно, что измерение искажений отношения сигнал/шум бесполезно для вокодеров, и, следовательно, необходимы другие субъективные оценки, такие, как средняя экспертная оценка, диагностический рифмованный тест, диагностическая оценка приемлемости и др. Вокодеры можно разделить на два класса: речеэлементные и параметрические.
В речеэлементных вокодерах при передаче распознаются произнесенные элементы речи (например, фонемы) и передаются только их номера. На приеме эти элементы создаются по правилам речеобразования или берутся из памяти устройства. Область применения фонемных вокодеров – линии командной связи, речевое управление и говорящие автоматы информационно-справочной службы. Практически в таких вокодерах происходит автоматическое распознавание слуховых образов, а не определение параметров речи.
В параметрических вокодерах из речевого сигнала выделяют два типа параметров:
параметры, характеризующие огибающую спектра речевого сигнала, (фильтровую функцию);
параметры, характеризующие источник речевых колебаний (генераторную функцию), – частота основного тона, ее изменение во времени, моменты появления и исчезновения основного тона, шумового сигнала.
По этим параметрам на приеме синтезируют речь.
По принципу определения параметров фильтровой функции речи различают вокодеры:
• полосные канальные (channel);
• формантные;
• ортогональные;
• липредеры (с линейным предсказанием речи);
• гомоморфные.
В полосных вокодерах спектр речи делится на 7-20 полос (каналов) аналоговыми или цифровыми полосовыми фильтрами. Большее число каналов в вокодере дает большую натуральность и разборчивость. С каждого полосового фильтра сигнал поступает на детектор и фильтр низких частот с частотой среза Fcp. Таким образом, сигналы на выходе каждого канала изменяются с частотой менее Fcp. Их передача возможна в аналоговом или цифровом виде.
В формантных вокодерах огибающая спектра речи описывается комбинацией формант (резонансных частот голосового тракта). Основные параметры формант – центральная частота, амплитуда и ширина полосы частот.
В ортогональных вокодерах огибающая мгновенного спектра раскладывается в ряд по выбранной системе ортогональных базисных функций. Вычисленные коэффициенты этого разложения передаются на приемную сторону. Распространение получили гармонические вокодеры, использующие разложение в ряд Фурье.
Вокодеры с линейным предсказанием (LPC — Linear Prediction Coding, или липредеры, основаны на оригинальном математическом аппарате. Они получили наибольшее распространение и будут ниже рассмотрены более подробно.
Гомоморфная обработка позволяет разделить генераторную и фильтровую функции, образующие речевой сигнал.
Из-за сложности определения параметров генераторной функции появились полувокодеры (VE — Voice Excited Vocoder), в которых вместо сигналов основного тона и тон-шума используется полоса речевого сигнала. Полоса частот до 800. .. 1000 Гц кодируется АДИКМ, АДМ (адаптивная дельта модуляция) или с помощью линейного предсказания малого порядка, а в некоторых моделях передается в аналоговом виде. Известны разные типы полувокодеров-липредеров: VELP — Voice Excite Linear Prediction; RELP — Residue Excited Linear Prediction.
Вокодеры VELP используют голосовое возбуждение и коэффициент линейного предсказания (КЛП). В вокодерах RELP по исходному сигнал также вычисляются КЛП. Так как КЛП описывает фильтровую функцию, то сигнал ошибки (остатка) предсказания содержит информацию о генераторной функции речи и передается на приемную сторону (возможно ее сжатие методами АДИКМ, АДМ или помощью линейного предсказания малого порядка).
Характеристики вокодеров. Качество речи вокодеров являет функцией скорости передачи, производительности и задержки обработки. Если вокодеры предназначены для телефонии по Интернет, разработчики продукции должны учитывать эти характеристики, между которыми существует строгая зависимость. Например, низкоскоростные вокодеры обычно имеют большую задержку и более низкое качество речи, чем высокоскоростные.
Скорость. Так как вокодер совместно использует канал связи и часто перегруженную сеть предприятия или Интернет с другими информационными потоками, максимальная скорость должна была бы быть как можно ниже, особенно для приложений малых офисов. В настоящее время большинство вокодеров работают на фиксированной скорости вне зависимости от характеристик входного сигнала, однако целью современных разработок являются вокодеры с переменной скоростью. Для приложений по одновременной передаче речи и данных компромиссом является создание алгоритмов сжатия пауз в качестве части стандарта кодирования. Общим решением является использование фиксированной скорости для речи и низкой скорости для фоновых шумов. Способ выполнения механизма сжатия пауз важен для повышения качества передачи речи, однако часто выигрыш от компрессии пауз не реализуется. Проблемой является то, что при больших фоновых шумах сложно провести различия между речью и шумом. Другая проблема заключается в том, что если механизм сжатия пауз неправильно выявил состояние речи, начало речи может быть «отрезано», что значительно ухудшает разборчивость кодированной речи.
| Алгоритм | Описание |
|
Детектор активности речи (VAD) |
Определяет, является ли входной сигнал речью или фоновым шумом. Если сигнал считается речью, он кодируется на полной фиксированной скорости; если сигнал считается шумом, он кодируется на более низкой скорости |
| Генерация комфортного шума | Механизм действует на стороне приемника для воссоздания основной характеристики фонового шума |
Способ генерации комфортного пума должен быть таким, чтобы кодер и декодер оставались синхронизированными, даже если в течение некоторого интервала времени передача данных не осуществляется. Это позволяет сгладить переходы между сегментами активной и неактивной речи.
Производительность алгоритмa. Вокодеры частот выполняются на основе цифровых сигнальных процессоров (ЦСП). В соответствии с компьютерной терминологией их производительность может быть измерена в млн. операций в секунду, объеме памяти с произвольным доступом ОЗУ и объеме ПЗУ. Производительность определяет стоимость вокодера, поэтому при определении типа вокодера для тех или иных приложений разработчик должен сделать соответствующий выбор. В случаях, когда вокодер совместно использует процессор с другими приложениями, разработчик должен решить, сколько ресурсов можно выделить для вокодера. Вокодеры, использующие менее 15 млн. операций/с, считаются низкопроизводительными. Использующие 30 или более млн. операций/с – высокопроизводительными.
Увеличение производительности приводит к увеличению стоимости и большим затратам энергии. Энергетические затраты важны для приложений в портативной аппаратуре, так как при больших затратах энергии сокращается время между подзарядками батарей или возникает необходимость использовать батареи большей емкости, что, в свою очередь, приводит к большей цене и весу.
При синтезе и исследовании полосных вокодеров и полосных вокодеров с ЛПК используются различные модели речевого процесса. Наиболее точная модель речи представляет собой нестационарный случайный процесс с медленно меняющейся дисперсией и спектральной плотностью. При использовании подобной модели можно получить наиболее точный результат оценки качества вокодера.
Ортогональные вокодеры
Речевой
сигнал
 можно промоделировать
откликом на
возбуждающий
сигнал линейной
системы с импульсной
характеристикой
 с переменными
параметрами,
так что выходной
сигнал
 равен свертке
возбуждающего
сигнала и импульсного
отклика голосового
тракта при
условии, что
форма голосового
тракта неизменна.
Все разнообразие звуков получается путем изменения формы голосового тракта. Если форма голосового тракта изменяется медленно, то на коротких временных интервалах аппроксимация выходного сигнала сверткой возбуждающего сигнала и импульсного отклика голосового тракта справедлива. Если на коротком отрезке времени входной сигнал является периодическим, с постоянной входной частотой, то выходной сигнал также является периодическим. Такая модель справедлива для описания звонких звуков. Аналогично временному, преобразование речи может быть описано в частотной области, поскольку преобразование Фурье речевого сигнала равно произведению преобразований Фурье возбуждающего сигнала и импульсного отклика голосового тракта.
Частотная характеристика голосового тракта является гладкой функцией частоты и характеризуется акустическими резонансами, называемыми формантными частотами.
Поскольку при изменении различных звуков форма голосового тракта изменяется, то с течением времени будет изменяться и огибающая спектра речевого сигнала. Так, в частности, при изменении периода сигнала, возбуждающего звонкие звуки, частотный разнос между гармониками спектра будет также изменяться.
Таким образом, для адекватного описания речевого сигнала надо не только знать вид его спектра, но и то, как он изменяется во времени.
Основным параметром речевого сигнала, возбуждающего звонкий звук, является разнос гармоник основного тона, а характеристики голосового тракта достаточно полно определяются частотами формант.
Изложенное позволяет сделать вывод об удобстве частотного метода описания и преобразования речевых процессов на основе кратковременного спектрального анализа.
Рассмотрим основные принципы, положенные в основу построения ортогональных вокодеров.
Запишем
кратковременное
преобразование
Фурье
 дискретизированного
речевого процесса
в виде
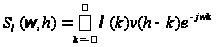 52
Здесь
 весовая функция,
сдвигаемая
во времени.
Соотношение (2.1) может быть переписано в двух формах. Первая форма имеет вид свертки
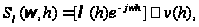 52
где
