Кодеры речи
 и
 (для каждого
из четырех
подсегментов)
8
бит на каждый
подсегмент;
векторному
квантованию
и кодированию
подвергаются
некоторые
функции от
 ,
и
Общий объем информации, выдаваемой для 20-мс сегмента речи, составляет 159 бит. Поскольку исходный объем информации на входе кодера составляет 1280 бит (160 выборок по 8 бит), кодер осуществляет сжатие информации более чем в 8 раз. Перед передачей в канал связи выходная информация кодера речи подвергается дополнительному канальному кодированию, причем разные параметры в зависимости от их важности для обеспечения качества речи кодируются с различной степенью избыточности.
Функционирование декодера осуществляется по следующему алгоритму. Сигнал возбуждения фильтра-синтезатора кратковременного предсказания формируется таким же образом, как и в синтезирующей схеме кодера:
по
номерам
 и
 из кодовых книг
выбираются
векторы возбуждения,
которые умножаются
соответственно
на коэффициенты
усиления
и
и складываются
с выходным
вектором
фильтра-синтезатора
долговременного
предсказания,
определяемого
параметрами
и τ.
Окончательно
сигнал возбуждения
фильтруется
фильтром-синтезатором
кратковременного
предсказания,
выполненного
в форме трансверсального
фильтра, т.е.
параметры
фильтра преобразуются
из коэффициентов
частотной
корреляции
 в коэффициенты
предсказания
 .
Для улучшения
субъективного
качества
синтезированной
речи выходной
сигнал фильтра-синтезатора
подвергается
цифровой адаптивной
постфильтрации
и с выхода
постфильтра
получается
восстановленный
цифровой речевой
сигнал.
Кодеры TETRA
TETRA (Trans-European Trunked Radio) представляет собой стандарт цифровой транкинговой радиосвязи, состоящий из ряда спецификаций, разработанных Европейским институтом телекоммуникационных стандартов ETSI.
TETRA — открытый стандарт, т.е. доступ к спецификациям TETRA свободен для всех заинтересованных сторон. В связи с этим оборудование различных производителей должно быть совместимо.
Стандарт TETRA создавался как единый общеевропейский цифровой стандарт. Стандарт разработай на основе технических решений и рекомендаций стандарта GSM и ориентирован на создание систем связи, эффективно и экономично поддерживающих совместное использование сетей различными группами пользователей с обеспечением секретности и защищенности информации.
Речевой
кодер TETRA основан
на модели кодирования
CELP – с линейным
предсказанием
с кодовым
возбуждением.
В этой модели
блок из N речевых
выборок синтезируется
путем фильтрации
соответствующей
обновленной
последовательности
из кодовой
книги, масштабированной
коэффициентом
усиления
 ,
с помощью двух
изменяющихся
во времени
фильтров.
Первый фильтр является фильтром долгосрочного предсказания (фильтром основного тона), цель которого – моделирование псевдопериодического речевого сигнала, а второй – фильтр краткосрочного предсказания – моделирует огибающую речевого спектра.
Передаточная характеристика долгосрочного фильтра (или фильтра синтеза основного тона) определяется формулой
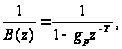
где
Т – задержка
основного тона;
 –
коэффициент
усиления основного
тона. Фильтр
синтеза основного
тона выполнен
как адаптивная
кодовая книга,
где для задержек,
меньших чем
длина подфрейма,
повторяется
последнее
возбуждение.
Краткосрочный фильтр синтеза определяется формулой
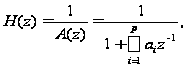
где
,
 ,
– параметры
линейного
предсказания;
р –
порядок предсказателя.
В кодере TETRA порядок
р =
10.
При способе анализа-через-синтез синтезированная речь вычисляется для всех кандидатов – последовательностей, составляя особую последовательность, которая и формирует выходной сигнал, наиболее близкий к исходному, в соответствии с взвешенной величиной измеренных искажений. Фильтр взвешивания, корректирующий ошибку предыскажений в области форманты спектра речи, определяется формулой
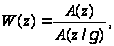 52
где
 – обратный
(инверсный)
фильтр линейного
предсказания;
 (используется
значение
 ).
Для взвешивающего
фильтра
 и фильтра синтеза
формант
 используются
квантованные
параметры
линейного
предсказания.
В алгебраическом CELP (ACELP) используется специальная кодовая книга, имеющая алгебраическую структуру. Эта алгебраическая структура имеет некоторые преимущества в отношении сохранения, сложности поиска и устойчивости (робастности). Кодер TETRA использует специальную динамическую алгебраическую кодовую книгу возбуждения, посредством которой, а также динамической матрицы формы образуются фиксированные векторы возбуждения. Матрица формы – это функция модели A(z) линейного предсказания. Главная ее роль – формировать векторы возбуждения в частотной области так, чтобы их энергии были сконцентрированы в наиболее важных частотных полосах. Используемая матрица формы является триангулярной Теплицевой матрицей низшего порядка, сформированной из импульсного отклика фильтра:
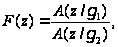 52
где
A(z) — инверсный
фильтр линейного
предсказания
(в конкретных
реализациях
 и
 ).
В кодере TETRA используются фреймы речи по 30 мс. Это требуется для того, чтобы параметры краткосрочного предсказания вычислялись и передавались в каждом речевом фрейме. Речевой фрейм разделен на четыре подфрейма по 7,5 мс (60 выборок). Основной тон и параметры алгебраической кодовой книги также передаются в каждом подфрейме. В табл. 5.3 представлено распределение бит для кодера TETRA. Должно быть сформировано 137 бит для каждого фрейма по 30 мс, что в результате дает скорость 4567 бит/с.
Таблица 5.3
| Параметр | Номер сегмента | Всего в кадре | |||
| 1 | 2 | 3 | 4 | ||
| Коэффициенты линейного предсказания | 26 | ||||
| Период основного тона | 8 | 5 | 5 | 5 | 23 |
| Индекс алгебраической кодовой книги | 16 | 16 | 16 | 16 | 64 |
| Коэффициенты усиления | 6 | 6 | 6 | 6 | 24 |
| Всего | 137 | ||||
Кодеры стандарта АРСО 25
АРСО 25 – стандарт транкинговой радиосвязи, описывающий структуру цифровой транкинговой системы и некоторые ее интерфейсы. Для цифровой передачи речи стандарт АРСО 25 предусматривает использование кодера IMBE (Improved MultiBand Excitation, модифицированный метод многополосного возбуждения). Кодер формирует цифровой поток со скоростью 4,4 кбит/с. Для исправления ошибок в цифровом речевом сигнале используется избыточное кодирование, порождающее дополнительный цифровой поток со скоростью 2,8 кбит/с.
Цифровой речевой сигнал передается кадрами длительностью 180 мс. Два речевых кадра образует суперкадр длительностью 360 мс. Перед передачей речи следует преамбула длительностью 82,5 мс, которая содержит синхропакет (48 бит), идентификатор сети (64 бита), служащий для предотвращения конфликтов между радиостанциями, работающими на одной частоте; информацию для алгоритма шифрования, идентификатор ключа алгоритма шифрования и другие служебные идентификаторы (всего 126 бит). Кадры речи, кроме собственно речевой информации, содержат дополнительную информацию (управления связью, канала сигнализации и т.д.)
Речевой IMBE-кодер основан на модели речи, которая относится к моделям с многополосным возбуждением (МВЕ). Основная идея работы кодера состоит в разделении цифрового речевого входного сигнала на перекрывающиеся речевые сегменты (или фреймы) с использованием окна Кайзера. Затем для определенного фрейма оценивается набор параметров.
Речевой MBE-кодер является вокодером, т.е. он не кодирует входной речевой сигнал выборка за выборкой, а синтезирует сигнал, который содержит ту же информацию для восприятия человеком, что и исходный речевой сигнал. Заметим, что когда речь не является вокализованнной, исходный и синтезированный сегменты речи могут не иметь никакого сходства во временной области.
Речевой MBE-кодер имеет два основных преимущества перед ранее используемыми вокодерами: во-первых, он основан на МВЕ речевой модели, которая является более устойчивой, чем традиционные речевые модели в рассмотренных вокодерах; во-вторых, данный метод использует более сложный алгоритм оценки параметров модели речевого синтеза речевого сигнала из параметров модели.
Главное отличие речевых традиционных вокодеров от модели МВЕ состоит в сигнале возбуждения. В обычных речевых моделях для каждого речевого сегмента используется единственное решение вокал/невокал. В отличие от этого речевая модель МВЕ разделяет сигнал возбуждения на несколько неперекрывающихся частотных полос и принимает решение вокал/невокал для каждой частотной полосы. Это позволяет представить сигнал возбуждения для определенного речевого сегмента в виде смеси периодической (вокализованной) энергии и шумоподобной (невокализованной) энергии. Из-за этих множественных определений вокал/невокал эта модель называется моделью с многополосным возбуждением. Такая речевая модель позволяет синтезировать речь с более качеством, чем традиционные модели. Кроме того, речевая модель МВЕ более устойчива к фоновому шуму.
В речевой
модели MBE сигнал
возбуждения
формируется
из сигнала
основного тона
(или основной
частоты) и решений
вокал/невокал.
Для вокализованной
речи сигнал
возбуждения
является
периодической
импульсной
последовательностью,
в которой расстояние
между импульсами
определяется
периодом основного
тона
 .
Для невокализованной
речи сигнал
возбуждения
представляет
собой белый
шум. Периодический
спектр создается
из взвешенной
периодической
последовательности
импульсов,
которая полностью
определяется
окном взвешивания
и периодом
основного тона.
Его спектр
формируется
из взвешенной
последовательности
случайного
шума.
Обычно алгоритмы для оценки параметров возбуждения и алгоритмы для оценки параметров огибающей спектра работают независимо. Эти параметры оцениваются на основе нескольких критериев без ясных оснований, насколько синтезированная речь должна быть близка к исходной. Это может проявиться в том, что синтезированный спектр будет слегка отличаться от исходного.
В речевом IMBE-кодере параметры возбуждения и огибающей спектра оцениваются одновременно так, что синтезированный спектр является самым близким к исходному речевому спектру.
Блок-схема алгоритма анализа показана на рис. 5.7.
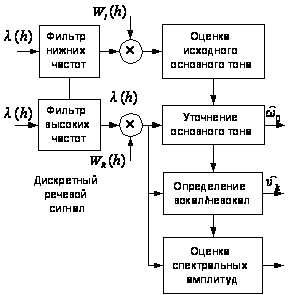
Рисунок 5.8
Параметры МВЕ модели речи, которые должны быть оценены для каждого речевого фрейма следующие:
период основного тона (или основная частота);
решение вокал/невокал;
спектральные амплитуды, характеризующие огибающую спектра.
В декодере вокализированная и невокализированная компоненты синтезируются отдельно и на заключительной стадии объединяются для получения полного речевого сигнала. Алгоритмы, которые используются для синтеза вокализированных и невокализированных частей речи, основаны на двух различных способах.
Невокализованная часть речи генерируется из гармоник, которые объявлены невокализованными. Для каждого фрейма речи блок случайного шума взвешивается и преобразуется с помощью быстрого преобразования Фурье. Области спектра, которые соответствуют вокализованным гармоникам, принимаются равными нулю.
Так как вокализованная речь моделируется ее индивидуальными гармониками в частотной области, на стороне декодера она восстанавливается как совокупный сигнал регулируемых генераторов. Каждой гармонике вокализованной области фрейма поставлен в соответствие генератор, который характеризуется частотой и фазой. Однако из-за того, что вокализованная часть речи не является периодической на интервалах, состоящих нескольких фреймов анализа, отклонения от ожидаемых параметров соседних фреймов могут вызвать скачки по концам фреймов, что приведет к значительному ухудшению качества речи. Для разрешения этой проблемы во время синтеза проверяются параметры текущего и предыдущего фреймов для уверенности, что на границе фреймов происходит плавный переход. Это делается для того, чтобы на границах фреймов вокализированная речь была непрерывной. Для обеспечения непрерывности в начале и конце фрейма речи функция амплитуды линейно интерполируется между значениями оценок для текущего и предыдущего фреймов.
Синтез речи в IMBE-декодере требует информации об основной частоте, решении вокал/невокал, величине спектральных составляющих и фазе вокализованных гармоник. Так как фазы вокализованных гармоник можно предсказать, информация о фазе не передается между кодером и декодером. Основная частота (основой тон) квантуется с половинной точностью выборки во временной области, причем возможный диапазон тона перекрывается восемью битами. Peшение вокал/невокал является двоичным числом и не требует квантования. Общее распределение бит для каждого фрейма приведено в табл. 5.4.
Таблица 5.4.
Распределение бит IMBE-кодера в системе АРСО 25
| Параметр | Число бит |
| Основная частота | 8 |
| Информация вокал/невокал | b |
| Спектральные амплитуды | 79 – b |
| Синхронизация | 1 |
Число полос, на которые разбивается речевой фрейм в частотной области, зависит от основного тона фрейма, но не превышает 12.
Таким образом, в кодере IMBE фрейм речи имеет длительность 20 мс, содержит 144 бита, из которых 56 используются для канального кодирования, 88 – для кодирования параметров речевой модели. Кодер работает на скорости 4,4 кбит/с. Скорость передачи в канале – 7,2 кбит/с.
Кодирование речи в системе INMARSAT-M
Для системы мобильной спутниковой связи INMARSAT была выбрана улучшенная версия речевого кодера МВЕ, описанного в предыдущем параграфе как версия стандарта на скорости 6,4 кбит/с для наземных систем подвижной связи. Размер фрейма кодера 20 мс. При этом обеспечивается кодирование источника и канала с помощью 128 бит на каждый фрейм. Из этих 128 бит 45 (2,25 кбит/с) зарезервированы для коррекции ошибок, а оставшиеся 83 бита (4,15 кбит/с) разделены между различными параметрами речи, как показано в табл. 5.5.
Таблица 5.5
Распределение бит в системе INMARSAT-M
| Параметр | Число бит |
| Основная частота | 8 |
| Информация вокал/невокал | b |
| Спектральные амплитуды | 75 – b |
Синтез речи в МВЕ декодере требует информации об основной частоте, решении вокал/невокал, спектральных величинах и фазах вокализированных гармоник. Так как фазы вокализированных гармоник можно предсказать, информация о фазе не передается от кодера к декодеру. Основная частота (основной тон) обычно квантуется с половинной точностью выборки во временной области, причем возможный диапазон тона перекрывается восемью битами. Решение вокал/невокал является двоичным числом и не требует квантования. Набор спектральных величин требует большей точности и эффективности квантования. Общее распределение бит для каждого фрейма следующее:
1) восемь бит для точного квантования тона;
2) b бит для решения вокал/невокал, где b – число полос принятия решения вокал/невокал;
3) оставшиеся биты для квантования гармоник.
Так
как число гармоник
зависит от
основного тона,
который изменяется,
число бит,
присваиваемых
для решения
вокал/невокал,
может также
изменяться.
Типичное число
вокализированных/невокализированных
полос равно
12 (4), что означает,
что максимальное
число бит для
описания
вокал/невокал
равно 12. Общее
число бит
 для квантования
гармоник определяется
формулой
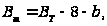
где
максимум b
равен 12;
 – общее число
бит для фрейма.
Рассмотрим способ квантования, используемый в системе INMARSAT-M.
Квантование
основной частоты.
Основная частота
квантуется
при преобразовании
ее в эквивалентный
период основного
тона
.
Значения периода
основного тона
обычно ограничены
диапазоном
 .
В системе МВЕ,
предназначенной
для работы
на скорости
6,4 кбит/с, этот
параметр
равномерно
квантуется
с использованием
8 бит при размере
шага 0,5, что дает
возможность
обеспечить
половинную
точность выборки.
Кодирование
решений вокал/невокал.
b решений
вокал/невокал
являются двоичными
числами, поэтому
могут быть
закодированы
с использованием
одного бита
для каждой
полосы решения.
Система на
скорости передачи
2,4 кбит/с использует
максимум 12 полос,
каждая с шириной
 Гармоники вне
b полос
вокал/невокал
приняты
невокализированными.
Квантование спектральных величин. Перед квантованием спектральных величин для уменьшения их изменения используется этап предсказания.
Остатки
предсказания
группируются
в шесть последовательных
блоков, содержащих
 остаточных
выборок каждый.
Каждый блок
преобразуется
по частоте с
использованием
дискретного
косинусоидального
преобразования
(ДКП) размером
.
Постоянные составляющие L шести ДКП-блоков (первые коэффициенты) группируются как вектор и квантуются с использованием кодовой книги шестибитового скалярного усиления и десятибитового вектора формы. Коэффициенты более высокого порядка М квантуются с использованием скалярных квантователей, где в процессе присвоения бит распределяются оставшиеся биты в соответствии с важностью для субъективного восприятия каждой величины. Блок-схема общей процесса квантования величин показана на рис. 5.8.
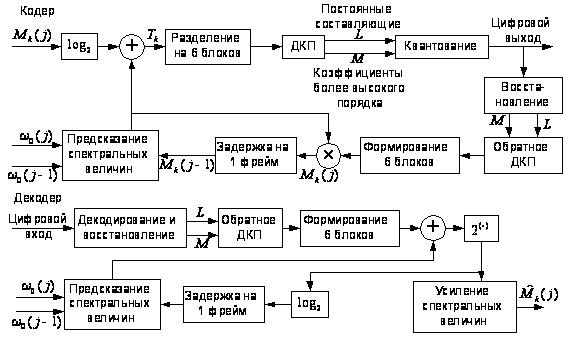
Рисунок 5.8
После правильного восстановления спектральных величин МВЕ-кодер пытается улучшить качество восприятия синтезированной речи с использованием усилителя. Усиление спектральных величин выполняется генерированием набора спектральных весов из принятых параметров текущего фрейма.
В типичном МВЕ-кодере большая часть бит выделена для квантования спектральных величин. В случае системы INMARSAT-M, где кодер источника работает на скорости 4,15 кбит/с при скорости фреймов 50 Гц, только 20 (8+ 12) бит используются для формирования информации об основном периоде и информации «вокал/невокал». Остальные биты используются для квантования спектральных величин. Таким образом, для успешного синтеза речи необходимо точно знать основной период. Для покрытия речевого спектра 4 кГц достаточно 12 полос вокал/невокал. В результате общая скорость кодера может быть уменьшена за счет более эффективного квантования величин. В системе INMARSAT-M все спектральные величины, кроме шести, проквантованы с использованием скалярных квантователей. Сокращение скорости можно добиться также за счет векторного квантования всех величин. Однако, так как число спектральных величин может изменяться от 9 до более чем 60 в зависимости от основной частоты, векторную кодовую книгу, учитывающую эти изменениями, создать очень сложно. Поэтому целесообразно векторное квантование использовать только для основной формы спектра, которая может быть принята независимой от основной частоты.
Перспективы кодирования речи.
В данной главе будут коротко рассмотрены перспективы использования различных речевых кодеков в сетях связи общего пользования.
Рассмотрим некоторые параметры наиболее распространенных кодеков сетей общего пользования.
Однако, кроме кодеков ИКМ по G.711, на ССОП в настоящее время применяются аналого-цифровые преобразователи других типов, использующие те или иные способы компрессии речи и поэтому имеющие меньшую скорость передачи цифрового сигнала по сравнению со стандартным кодеком ИКМ. Основные области применения низкоскоростных кодеков: • системы подвижной связи (в частности, цифровые сотовые и транкинговые системы); • аппаратура DCME (в небольшом количестве используется на сети ОАО «Ростелеком»); • абонентские компьютерные и мультимедийные терминалы, аппараты IP-телефонии;
• цифровые беспроводные телефоны.
Таблица 6.1. Наиболее распространенные кодеки.
| Кодек | Наименование | Скорость кбит/с |
Стандарт |
| Standard PCM | Стандартный ИKM кодек для сетей с коммутацией каналов | 64 | ITU-T G.711 |
| GSM-FR PRE-LTP | Кодек 1-го поколения GSM с возбуждением регулярной последовательностью импульсов и долговременным предсказанием | 13 | ETSIGSM 06.16 |
| GSM-HR VCELP | Кодек GSM (с «половинной» скоростью) с линейным предсказанием и возбуждением векторной суммой | 5,6 | ETSIGSM 06.20 |
| GSM-EFR ACELP | Кодек 2-го поколения GSM с алгебраическим кодовым возбуждением и линейным предсказанием | 12,2 | ETSIGSM 06.60 |
| Videophone ACELP | Речевой кодек для мультимедийной связи с алгебраическим кодовым возбуждением и линейным предсказанием | 5,3 | ITU-T G.723.1 |
| Videophone MP-MLQ | Речевой кодек для мультимедийной связи с многоимпульсным квантованием по критерию правдоподобия | 6,3 | ITU-T G.723.1 |
| ADPCM | Кодек АДИКМ (адаптивной дифференциальной ИКМ) | 40, 32, 24, 16 | ITU-T G.726 |
| LD-CELP | Кодек с линейным предсказанием, с кодовым возбуждением и малой задержкой | 16, 12, 8, 9, 6 |
ITU-T G.728 |
| CS-ACELP | Кодек с линейным предсказанием, алгебраическим кодовым возбуждением и сопряженной структурой | 8 |
ITU-T G.729 |
Низкоскоростным кодекам свойственны определенные ухудшения параметров, влияющие на качество передачи речи, по сравнению со стандартным кодеком ИКМ. Важно, что эти ухудшения накапливаются при тандемном включении как однородных, так и разнородных низкоскоростных кодеков.
Следует отметить следующие основные факторы, влияющие на качество передачи речи при использовании кодеков:
• искажения квантования;
• временная задержка;
• амплитудно-частотные искажения;
• битовые ошибки;
• проскальзывания;
• потеря кадров;
• потеря пакетов.
Планирование речевых соединений требует обязательного учета ухудшений, вносимых каждым переходом А-Ц и Ц-А, и определения на этой основе допустимого количества таких переходов. Для этой цели используется так называемая Е-модель, разработанная ETSI и рекомендуемая МСЭ-Т при планировании речевых соединений «из конца в конец». Эта модель позволяет в комплексе учесть практически все ухудшающие факторы.
Наиболее важным параметром Е-модели является коэффициент ухудшения за счет аппаратуры, обозначаемый Ic. Чем больше этот коэффициент, тем большую долю деградации вносит данная аппаратура (конкретно – кодек). В табл. 6.2 для сравнения показаны значения для различных кодеков.
Таблица 6.2
| Кодек | Скорость кбит/с | Стандарт | Ic (G.113) |
| Standard PCM | 64 | ITU-T G.711 | 0 |
| GSM-FR PRE-LTP | 13 | ETSIGSM 06.16 |
20 (25-42)* |
| GSM-HR VCELP | 5,6 | ETSIGSM 06.20 |
23 (32-45)* |
| GSM-EFR ACELP | 12,2 | ETSIGSM 06.60 |
5 (15-35)* |
| Videophone ACELP | 5,3 | ITU-T G.723.1 | 19 |
| Videophone MP-MLQ | 6,3 | ITU-T G.723.1 | 15 |
| ADPCM | 40, 32, 24, 16 | ITU-T G.726 | 2, 7, 25, 50 |
| LD-CELP | 16, 12, 8, 9, 6 |
ITU-T G.728 |
7, 20 |
| CS-ACELP | 8 |
ITU-T G.729 |
10 |
| * – при наличии битовых ошибок | |||
Проблема задержки сигнала. Среди многих факторов, влияющих на качество передачи речи, можно отметить задержку сигнала в терминалах и узлах сети.
Желательной является задержка, не превышающая 150 мс, поскольку кроме задержки следует учитывать и другие ухудшающие факторы. Как уже указывалось, задержка, вносимая стандартными кодеками ИКМ, незначительна и составляет меньше 0,4 мс.
Существенное увеличение задержки по сравнению со стандартными кодеками ИКМ дают низкоскоростные кодеки. В частности, только сами кодеки в терминалах GSM вносят задержку в 60 мс, что эквивалентно времени прохождения через волоконно-оптическую линию связи (ВОЛС) длиной 12000 км. Процедура «фрейминга» (формирования кадров) на радиоинтерфейсе добавляет еще 35 мс задержки.
В табл. 6.3 представлены задержки, вносимые речевыми кодеками (МСЭ-Т G.114) различных типов, и соответствующие эквивалентные длины ВОЛС. Из таблицы следует, что задержки в низкоскоростных кодеках весьма велики, что делает дополнительные перекодировки практически недопустимыми. При этом нельзя упускать из виду повышенные задержки в таких сетевых элементах как шлюзы, маршрутизаторы и т. д.
Таблица 6.3
| Кодек | Стандарт | Средняя задержка, мс | Эквивалентная длина ВОЛС, км |
| Standard PCM | ITU-T G.711 | 0,375 | 75 |
| GSM-FR RPE-LTR | ETSI GSM 06.10 | 95 | 19000 |
| GSM-HR VCELP | ETSI GSM 06.20 | 95 | 19000 |
| GSM-EFRACELP | ETSI GSM 06.60 | 95 | 19000 |
| Videophone ACE LP | ITU-TG.723.1 | 97,5 | 19500 |
| Videophone MP-MLQ | ITU-T G.723.1 | 97,5 | 19500 |
| ADPCM | ITU-T G.726 | 0,375 | 75 |
| LD-CELP | ITU-T G.728 | 1.875 | 375 |
| CS-ACELP | ITU-T G.729 | 35 | 7000 |
Таким образом, приходится делать выбор между качеством связи и шириной канала поэтому задача проектирования наиболее качественных кодеков для низкоскоростных каналов с высоким уровнем помех весьма актуальна.
Рассмотрим наиболее эффективные, сегодня методы практической реализации низкоскоростных (1,2—2,4 кбит/с) MELP-вокодеров. предназначенных для работы в канале с высоким процентом канальных ошибок, и основные направления совершенствования данных методов.
В качестве базового алгоритма вокодера был выбран алгоритм MELP–2400, разработанный фирмой Texas Instruments и выигравший открытый конкурс по замене кодека федерального стандарт США FS-1016. Данный алгоритм основан на традиционной параметрической модели кодирования с линейным предсказанием и, кроме того, содержит ряд дополнительных особенностей:
• вся рабочая область частот делится на пять полос; в каждой из которых принимается решение о классе сигнала возбуждения — «шумовой» или «голосовой». Таким образом суммарный сигнал возбуждения является смешанным;
• форма «голосового» сигнала возбуждения реконструируется в декодере с помощью амплитуд коэффициентов Фурье, вычисленных в анализирующей части вокодера:
• для реализации одиночных импульсов возбуждения применяются «апериодические» импульсы;
• с целью улучшения «натуральности» звучания синтезированной речи применяются дисперсионный и адаптивный фильтры.
Суммарный список параметров, передаваемых от колера к декодеру за один речевой фрейм длительностью 22.5 мс, представлен в табл. 6.4.
Таблица 6.4.
| Параметр |
«Голосовой» фрейм (бит) |
«Шумовой» фрейм (бит) |
| Линейные спектральные пары | 25 | 25 |
| Амплитуды преобразования Фурье сигнала возбуждения | 8 | – |
| Коэффициенты усиления (2 за фрейм) | 8 | 8 |
| Период основного тона, общая озвученность фрейма | 7 | 7 |
| Озвученность по полосам | 4 | – |
| Флаг периодичности | 1 | – |
| Защита от ошибок | – | 13 |
| Синхробит | 1 | 1 |
| Всего за кадр, 22.5 мс | 54 | 54 |
Выбранный вокодер обеспечивает хорошее звучание синтезированной речи при скорости битового потока 2,4 кбит/с и величине битовых ошибок не более.
Задача практической реализации низкоскоростного вокодера, имевшего приемлемое качество синтезированной речи при ошибках в канале до 5%, решалась в два этапа. Первоначально была снижена скорость битового речевого потока до 1,2 кбит/с без существенной деградации качества выходного речевого сигнала. Далее были выбраны оптимальные в смысле качества синтезированной речи коды, исправляющие ошибки, и разработан метод замены выбитых речевых параметров на интерполированные значения параметров предшествующих фреймов. После этого суммарная скорость потока информационных и проверочных бит составила 2,4 кбит/с.
Вокодер с битовой скоростью 1,2 кбит/с. При понижении скорости битового потока основное внимание уделялось сохранению разборчивости речи. Анализ алгоритма MELP–2400 показал, что амплитуды преобразования Фурье сигнала возбуждения отвечают в основном за узнаваемость диктора и передачу интонации. Поэтому в спроектированном вокодере MELP–1200 они не используются. Передача коэффициента усиления один раз за фрейм также не приводит к существенному ухудшению разборчивости. Для дальнейшего понижения битовой скорости была разработана техника передачи линейных спектральных пар (ЛСП) только по четным фреймам с помощью адаптивного выбора фреймов на основе решетчатой структуры с критичными изменениями. Для нечетных фреймов вектор ЛСП находился с помощью интерполяционных методов. Также для уменьшения числа бит была использована частота границы голосовой активности с двухбитовой кодировкой.
Суммарный список параметров алгоритма MELP-1200, передаваемых от кодера к декодеру за один речевой фрейм длительностью 45 мс, представлен в табл. 6.5.
Таблица 6.5
| Параметр |
«Голосовой» фрейм (бит) |
«Шумовой» фрейм (бит) |
| Линейные спектральные пары | 25 | 25 |
| Амплитуды преобразования Фурье сигнала возбуждения | – | – |
| Коэффициенты усиления (2 за фрейм) | 5+5 | 5+5 |
| Период основного тона, общая озвученность фрейма | 7+7 | 7+7 |
| Озвученность по полосам | 2+2 | – |
| Флаг периодичности | 1 | 1 |
| Защита от ошибок | – | – |
| Синхробит | – | – |
| Всего за кадр, 22.5 мс | 54 | 50 |
Вокодер с битовой скоростью 2,4 кбит/с для работы в каналах с величиной ошибок до 5% (MELP–C–2400). Для исправления ошибок битового потока было исследовано несколько классов кодов. Наиболее оптимальными в смысле качества восстановленной речи оказались коды Хэмминга (8,4), позволяющие исправлять одиночную ошибку в четырех информационных битах и определять наличие ошибки в 2 бита, а также коды Голея (23,12), исправляющие три ошибки в двенадцати информационных битах. При проектировании был сделан выбор в пользу кодов Хэмминга. В результате к 54 информационным битам добавлялись 54 проверочных, и общая скорость битового потока составила 2,4 кбит/с.
Предлагаемый алгоритм построения низкоскоростного вокодера MELP—С-2400 был промоделирован на персональном компьютере с использованием языка программирования «СИ» при представлении данных в формате с фиксированной запятой. Для определения качества синтезированной речи использовалась диагностическая мера приемлемости (Diagnostic Acceptability Measure — DAM). Для этой цели были использованы шесть wav-файлов с мужскими голосами и шесть wav-файлов с женскими голосами, которые затем прослушивались на выходе тракта 30 слушателями, после чего определялась средняя оценка мнений — MOS. Такой метод называется методом субъективной оценки качества.
Таким образом, на основании полученных результатов можно сделать следующие выводы:
1. Вокодер MELP-I200 имеет разборчивость синтезированной речи близкую к вокодеру MELP-2400 и может быть использован в каналах с пропускной способностью 1,2 кбит/с,
2. При битовых ошибках в канале более 1% вокодер MELP—С-2400 существенно улучшает качество синтезированной речи.
Что касается улучшения качества корректирующих кодов, то наиболее целесообразным представляется применение сверточных кодов со скоростью 1/3. Как показывают исследования, в этом случае при использовании схемы декодера Виттерби с мягким решением приемлемое качество речи можно обеспечивать при вероятности канальной ошибки до 10%. В каналах с памятью эффективным может оказаться применение каскадных кодов (например, последовательное кодирование кодами Рида-Соломона или сверточными кодами) или турбокодов.
Дальнейшее понижение скорости битового потока вокодера возможно при использовании модифицированных кодовых книг, отражающих возможные сочетания ЛСП, и суммарного векторного кодирования речевых параметров. При этом ожидаемая скорость речепреобразующих устройств может не превысить 800 бит/с при словесной разборчивости речи не менее 90%.
Далее рассмотрим кодеки и протоколы, непосредственно используемые в IP-телефонии. Эта тема очень важна, так как есть