Кодеры речи
В алгоритмах
кодирования
с «анализом
через синтез»
повышение
эффективности
информационного
уплотнения
речевых сигналов
производится,
преимущественно,
за счет сокращения
избыточности
последовательности
x(h),
которая осуществляет
возбуждение
синтезирующего
фильтра
 линейного
предсказания,
формирующего
огибающую
сигнала, с
коэффициентом
передачи
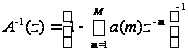 52
Для этой цели применяется также дополнительный фильтр с характеристикой
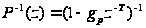 52
с
коэффициентом
предсказания
 и задержкой
на период основного
тона T.
Фильтр выполняет
функции генератора
квазипериодических
колебаний
голосовых
связок при
произношении
вокализованных
звуков.
В зависимости от способа описания сигнала x(h), поступающего на вход фильтра (3.9), можно выделить алгоритмы кодирования:
с возбуждением прореженной последовательности импульсов — MPLP (Multi Pulses Linear Prediction);
с самовозбуждением — SELP (Self Excited Linear Prediction);
с кодовым возбуждением — CELP
Экспериментально установлено, что кодовое возбуждение обеспечивает наиболее высокое качество кодирования речевого сигнала, в том числе и при наличии входных акустических помех.
CELP наиболее эффективно применяется при передаче речевого сигала в диапазоне скоростей от 4 до 6 кбит/с.
По
существу, в
алгоритме CELP
производится
векторное
квантование
последовательности
 ,
т.е. позиции
выборок и их
амплитуды в
сигнале многоимпульсного
возбуждения
оптимизируются
одновременно.
При том отрезок
(сегмент) сигнала
возбуждения
выбирается
из предварительно
формированной
постоянной
совокупности
– кодовой книги,
содержащей
достаточно
большое количество
реализаций,
например,
некоррелированного
гауссовского
шума. Выбранная
реализация
усиливается
и подается на
вход цепочки
фильтров (3.9) и
(3.8).
Поиск
оптимальных
значений
и Т
синтезатора
основного тона,
коэффициента
усиления и
номера элемента
кодовой книги
осуществляется
посредством
«анализа через
синтез». В канал
связи передаются
номер (индекс)
элемента кодовой
книги с соответствующим
коэффициентом
усиления, параметры
синтезатора
основного тона,
а также коэффициенты
линейного
предсказания,
характеризующие
состояние
голосового
тракта.
Являясь одной из самых распространенных, схема с линейным предсказанием и возбуждением от кода CELP является лучшей схемой AbS-LPC для низких скоростей. В CELP имеется линейный фильтр с изменяющимися во времени параметрами для выделения грубой и точной спектральной информации. Возбуждение выполняется путем перебора всех векторов из возбуждающей кодовой книги. Векторная последовательность, обеспечивающая минимальную взвешенную ошибку, считается оптимальным возбуждением. Процедура AbS в CELP требует больших вычислительных ресурсов, а основная кодовая книга является результатом очень большой исследовательской работы. Хотя CELP является сложным методом, он способен синтезировать речь с высоким качеством даже на низких скоростях. Вариант кодирования CELP выбран для многих систем голосовой связи.
Хотя CELP, главным образом, ориентирован на низкие скорости, на нем базируются многие стандарты. Испытания показывают его приемлемость и для высоких скоростей. Стандарт для скорости 16 кбит/с с малой задержкой (LD-CELP — Low-Delay CELP) будет рассмотрен ниже.
Рекомендации G.723.1 и G.729
Рекомендация G.723.1 определяет кодовое представление, которое может использоваться на очень низких скоростях для компрессии речевых или других аудиосигналов в средствах мультимедиа. В кодере, реализующем рекомендации G.723.1, принципиальным приложением является низкоскоростная видеотелефония как часть общего семейства стандартов Н.324.
Кодер обеспечивает работу на двух скоростях — 5,3 и 6,3 кбит/с. Более высокая скорость обеспечивает лучшее качество. Тем не менее, и более низкая скорость обеспечивает хорошее качество и предоставляет разработчикам систем связи дополнительные возможности. И кодер и декодер должны обязательно поддерживать обе скорости. Существует возможность переключения скоростей. Возможно также изменение рабочей скорости с использованием прерывистой передачи и заполнение шумом пауз.
Кодер G.723.1 оптимизирован для сжатия речи с высоким качеством на установленной скорости при ограниченной полосе. Музыка и другие аудиосигналы также могут быть подвергнуты компрессии с использованием этого кодера, однако, не с таким же высоким качеством, как речь.
Кодер G .723.1 преобразует речь или другие аудиосигналы во фреймы длительностью 30 мс. Кроме того, существует возможность просмотра фреймов на скорости 7,5 мс, что приводит к общей алгоритмической задержке 37,5 мс. Дополнительные задержки возникают из-за:
времени, затрачиваемого на обработку данных в кодере и декодере;
времени передачи по линии связи;
дополнительной буферной задержки протокола мультиплексирования.
Кодер G.723.1 предназначен для работы с цифровыми сигналами после предварительной фильтрации полосы аналогового телефонного канала (рекомендации G.712), дискретизации с частотой 8 кГц и преобразования в 16-битную линейную ИКМ последовательность для передачи на вход кодера. Выходной сигнал декодера преобразуется обратно в аналоговый сигнал аналогичным образом. Другие характеристики входа/выхода такие же, как и определенные рекомендациями G.711 для 64-битной ИКМ. Перед кодированием данные должны быть преобразованы в 16-битную ИКМ последовательность или в соответствующий формат после декодирования из 16-битной ИКМ.
Кодер,
основанный
на принципах
кодирования
методом «анализ
через синтез»
с линейным
предсказанием,
минимизирует
взвешенный
сигнал ошибки,
работает с
блоками (фреймами)
по 240 выборок
каждый, что в
частоте дискретизации
8 кГц эквивалентно
длительности
30 мс. Каждый фрейм
проходит через
фильтр верхних
частот для
удаления постоянной
составляющей,
а затем разделяется
на четыре субфрейма
по 60 выборок в
каждом. Для
каждого субфрейма
используется
фильтр десятого
порядка кодера
с линейным
предсказанием.
Для последнего
субфрейма
коэффициенты
LPC-фильтра квантуются
с использованием
прогнозирующего
квантизатора
вектора разбиения
(PSVQ). Квантованные
LPC-коэффициенты
используются
для создания
кратковременного
взвешивающего
фильтра, который
применяется
для фильтрации
всего фрейма
и для получения
взвешенной
оценки речевого
сигнала. На
основе этой
оценки для
каждых двух
субфреймов
(120 выборок) вычисляется
период основного
тона
 .
Оценка тона
представляется
блоками по 120
выборок. Период
основного тона
лежит в диапазоне
от 18 до 142 выборок.
С помощью вычисленной заранее оценки периода тона создается фильтр формы гармонического шума. Комбинация из фильтра синтеза LPC, фильтра взвешивания формант, фильтра формы гармонического шума используется для синтеза импульсной характеристики, необходимой для дальнейших вычислений.
Оценки
периода основного
тона
и импульсного
отклика используются
при работе
предсказателя
тона пятого
порядка. Период
тона вычисляется
как приращение
относительной
оценки периода
основного тона.
На декодер
передаются
тоновый период
и разностные
величины. На
следующем этапе
аппроксимируются
непериодические
составляющие
возбуждения.
Для высокой
скорости используется
многоимпульсное
возбуждение
с квантованием
и алгоритмом
максимального
правдоподобия
(MP-MLQ), а для низких
скоростей –
алгебраическое
кодовое возбуждение.
Рекомендации ITU-T G.729 содержат описание алгоритма кодирования речевых сигналов на скорости 8 кбит/с с использованием алгебраического линейного предсказания с кодовым возбуждением с сопряженной структурой (CS-ACELP).
Подобный кодер создан для работы с цифровыми сигналами, полученными после предварительной обработки аналогового входного сигнала фильтром низкой частоты, дискретизации с частотой 8 кГц и дальнейшем преобразованием в линейную ИКМ для подачи на вход кодера. Выходной сигнал декодера конвертируется обратно в аналоговый сигнал подобным же образом. Другие характеристики входа/выхода определяются аналогично рекомендациями G.711 для ИКМ последовательностей со скоростью 64 кбит/с. После декодирования данные должны быть преобразованы из 16-битовой линейной ИКМ в требуемый формат.
Кодер CS-ACELP основан на модели с линейным предсказанием с кодовым возбуждением (CELP) и работает с фреймами речи по 10 мс, соответствующих 80 выборкам. Каждый фрейм речевого сигнала длительностью 10 мс анализируется для выделения параметров CELP-модели (коэффициенты фильтра линейного предсказания, индексы адаптивной и фиксированной кодовых книг и коэффициенты усиления). Эти параметры кодируются и передаются на приемную сторону. Распределение бит параметров кодера показано в табл. 3.1.
Таблица 3.1
Распределение бит для алгоритма CS-ACELP на скорости 8 кбит/с (фреймы по 10 мс)
| Параметр | Кодовое слово | Субфрейм 1 | Субфрейм 2 | В целом на фрейм |
| Пары линейного спектра | LU, L1, L2, L3 | |||
| Задержка адаптивной кодовой книги | P1, Р2 | 8 | 5 | 13 |
| Проверка задержки тона | Р0 | 1 | 1 | |
| Индекс фиксированной кодовой книги | CT, С2 | 13 | 13 | 26 |
| Запись фиксированной кодовой книги | S1, S2 | 4 | 4 | 8 |
| Усиления кодовой книги (этап 1) | GA1, GA2 | 3 | 3 | 6 |
| Усиления кодовой книги (этап 2) | GBl, GB2 | 4 | 4 | 8 |
| Всего | 80 |
На стороне декодера эти параметры используются для восстановления параметров возбуждения и фильтра синтеза. Как показано на рис. 3.3, речь восстанавливается при фильтрации этого возбуждения фильтром кратковременного синтеза, который основан на фильтре линейного предсказания десятого порядка. Долговременный фильтр (или фильтр синтеза тона) выполняется с использованием адаптивной кодовой книги. После синтеза речи происходит дополнительное сглаживание в постфильтре.
Входной сигнал поступает на фильтр высоких частот и масштабируется в блоке предварительной обработки, после чего подвергается последующему анализу. Анализ с линейным предсказанием (LP-анализ) выполняется один раз для фрейма длительностью 10 мс с целью вычисления коэффициентов фильтра линейного предсказания, которые затем преобразуются в пары линейного спектра (Line Spectrum Pairs, LSP) и квантуются (18 бит) с использованием двухэтапного векторного квантования с предсказанием.
Сигнал возбуждения выбирается с использованием поисковой процедуры «анализ через синтез», при которой ошибка между исходной и восстанавливаемой речью минимизируется в соответствии с измерением взвешенных искажений. Это выполняется путем фильтрации сигнала ошибки фильтром взвешивания, коэффициенты которого извлечены из неквантованного LP-фильтра.
Параметры возбуждения (параметры фиксированной и адаптивной кодовых книг) определены для субфрейма длительностью 5 мс (40 выборок). Коэффициенты квантованного и неквантованного фильтра с линейным предсказанием используются для второго субфрейма, в то время как в первом субфрейме используются интерполированные коэффициенты LP-фильтра.
Задержка
основного тона
оценивается
один раз для
фрейма длиной
10 мс на основе
взвешенного
речевого
сигнала. Затем
для каждого
субфрейма
повторяются
следующие
операции.
Искомый сигнал
 вычисляется
при фильтрации
остаточного
линейного
предсказания
во взвешивающем
фильтре синтеза
 .
При фильтрации
ошибки начальные
состояния
этих фильтров
обновляются.
Это эквивалентно
результату
выделения
нулевого входного
отклика взвешивающего
фильтра синтеза
из взвешенного
речевого сигнала.
Вычисляется
импульсная
характеристика
 взвешивающего
фильтра синтеза,
после чего
выполняется
анализ тона
для нахождения
задержки адаптивной
кодовой книги
путем анализа
значения задержки
вблизи основного
тона с использованием
искомого сигнала
и импульсной
характеристики
.
Задержка тона
кодируется
восемью битами
в первом субфрейме
и пятью битами
во втором
субфрейме.
Искомый сигнал
используется
при поиске
фиксированной
кодовой книги
для нахождения
оптимального
возбуждения.
Семнадцатибитовая
алгебраическая
кодовая книга
используется
для возбуждения
фиксированной
кодовой книги.
Коэффициенты
усиления вкладов
адаптивной
и фиксированной
кодовых книг
— это векторы,
квантованные
семью битами.
Индексы параметров кодовых книг выделяются из принятого потока бит и декодируются для получения следующих параметров кодера, соответствующих речевому фрейму длиной 10 мс: LP-коэффициенты (коэффициенты линейного предсказания), две частичные задержки тона, два вектора фиксированной кодовой книги и два набора коэффициентов адаптивной и фиксированной кодовых книг. Коэффициенты LSP интерполируются и преобразуются в коэффициенты LP-фильтра для каждого субфрейма. Для каждого субфрейма выполняются следующие шаги:
восстанавливается возбуждение путем добавления векторов адаптивной и фиксированной кодовых книг с соответствующими им коэффициентами усиления;
восстанавливается речь путем пропускания через фильтр LP-синтеза;
восстанавливаемый речевой сигнал пропускается через ступень постобработки, которая включает адаптивный постфильтр, состоящий из долговременного и кратковременного постфильтров синтеза, фильтр высоких частот и операцию масштабирования.
Кодер кодирует речь и другие аудиосигналы по фреймам длительностью 10 мс. В результате осуществляется задержка 5 мс, что приводит в результате к общей алгоритмической задержке 15 мс. Все дополнительные задержки при практическом исполнении такого кодера обусловлены следующими причинами:
временем обработки, необходимым для операции кодирования и декодирования;
временем передачи по линиям связи;
задержкой мультиплексирования, когда аудиоданные объединяются с другими данными.
Таким образом, рекомендация G.729 предусматривает фреймы возбуждения по 5 мс и формирует четыре импульса. Фрейм из 40 выборок разделяется на четыре части. Первые три имеют восемь возможных позиций для импульсов, четвертая — шестнадцать. Из каждой части выбирается по одному импульсу. В результате образуется четырехимпульсный ACELP возбуждения кодовой страницы (табл. 3.2).
Таблица 3.2
Параметры кодеров
| Параметры кодера | Кодер | ||
| G.729 | G.729A | G.723.1 | |
| Скорость бит, кбит/с | 8 | 8 | 5,3…6,3 |
| Размер фрейма, мс | 10 | 10 | 30 |
| Размер подфрейма, мс | 5 | 5 | 7,5 |
| Алгебраическая задержка, мс | 15 | 15 | 37,5 |
| Быстродействие, млн. оп./с | 20 | 10 | 14…20 |
| Объем ПЗУ, байт | 5,2 К | 4 К | 4,4 К |
| Качество | Хорошее | Хорошее | Хорошее |
Для режима 5,3 кбит/с рекомендация G.723.1 предусматривает фреймы возбуждения длительностью 7,5 мс и также использует четырехимпульсное ACELP-возбуждение кодовой страницы. Для скорости 6,3 кбит/с используется технология многоимпульсного возбуждения с квантованием и алгоритмом максимального правдоподобия (MP-MLQ). В этом случае позиции фреймов группируются в подгруппы с четными и нечетными номерами. Для определенного номера импульса из четной последовательности (пятый или шестой в зависимости от того, является ли сам фрейм четным или нечетным) используется последовательный многоимпульсный поиск. Похожий поиск повторяется для подфреймов с нечетными номерами. Для возбуждения выбирается группа с минимальными общими искажениями.
На стороне декодера информация кодера с линейным предсказанием (LPC) и информация адаптивной и фиксированной кодовой книг демультиплексируется и используется для реконструкции выходного сигнала. Для этих целей используется адаптивный постфильтр. В случае кодера G.723.1 сигнал возбуждения перед прохождением через фильтр синтеза LPC пропускается через LT (long-term — долговременный) постфильтр и ST (short-term — кратковременный) постфильтр.
LD-CELP (Long-Delay CELP). Рекомендация G.728
В Рекомендации содержится описание алгоритма кодирования речевых сигналов на скорости 16 кбит/с с помощью линейного предсказания с кодированием сигнала возбуждения с малой задержкой. Алгоритм LD-CELP описывает работу кодера и декодера.
В алгоритме LD-CELP сохранена суть метода CELP, представляющего собой метод «анализа через синтез» путем поиска сигналов в кодовой книге. Для получения алгоритмической задержки порядка 0,625 мс используется адаптация предсказателей и уровней сигнала возбуждения по выходу. Передается только индекс сигнала возбуждения, найденный в кодовой книге. Обновление коэффициентов предсказания производится с помощью LPC-анализа ранее квантованной речи. Уровень возбуждения обновляется с помощью информации, содержащейся в ранее квантованном сигнале возбуждения. Размер блока для адаптации вектора сигнала возбуждения и уровня составляет всего лишь пять отсчетов. Обновление взвешивающего фильтра, учитывающего восприятие, производится с помощью LPC-анализа неквантованной речи.
После выполнения преобразования сигнала ИКМ по закону А или μ в линейный ИКМ-сигнал входной сигнал делится на блоки по пять последовательных отсчетов. Для каждого входного блока кодер пропускает каждый из 1024 векторов кодовой книги (хранящихся в кодовой книге сигнала возбуждения) через устройство масштабирования уровня сигнала возбуждения и синтезирующий фильтр. Из полученных в результате пропускания всех 1024 векторов-кандидатов квантованного сигнала кодер определяет один, минимизирующий величину взвешенной по частоте среднеквадратической ошибки относительно вектора входного сигнала. 10-битовый индекс, соответствующий наилучшему вектору в кодовой книге, который соответствует наилучшему вектору-кандидату квантованного сигнала, передается в декодер. На следующем этапе для обновления памяти фильтра и подготовки к кодированию следующего вектора сигнала наилучший кодовый вектор проходит через устройство масштабирования уровня сигнала возбуждения и синтезирующий фильтр. Коэффициенты синтезирующего фильтра и уровень сигнала возбуждения периодически обновляются путем адаптации по выходу, базирующейся на квантованном сигнале, масштабированном по уровню, и сигнале возбуждения.
Индекс в книге векторного квантования (VQ) возбуждения представляет собой единственную информацию, которая в явной форме передается из кодера в декодер. Три других типа параметров: уровень сигналa возбуждения, коэффициенты синтезирующего фильтра и коэффициенты взвешивающего фильтра, учитывающего восприятие, обновляются периодически. Эти параметры получаются путем адаптации по выходу из сигналов, которые появляются до текущего вектора сигнала. Уровень сигнала возбуждения обновляется для каждого вектора, а коэффициенты взвешивающего фильтра, учитывающего восприятие, и коэффициенты синтезирующего фильтра обновляются для каждых четырех векторов (т.е. для каждых 20 отсчетов или для периода обновления длительностью 2,5 мс). Следует отметить, что хотя последовательность обработки в алгоритме имеет цикл адаптации, равный четырем векторам (20 отсчетов), емкость основного буфера составляет только один вектор (пять отсчетов). Такая малая емкость буфера позволяет получить задержку при передаче в одном направлении менее 2 мс.
Многополосное кодирование и кодирование с адаптивным преобразованием
Среди методов кодирования с частотным разбиением известны две технологии: многополосное кодирование — SBC (Sub-Band Coding) и кодирование с адаптивным преобразованием — АТС (Adaptive Transform Coding). Основной принцип обеих схем — разделение спектра входного на несколько частотных поддиапазонов (полос), которые затем кодируются отдельно. В SBC набор фильтров выполнен так, что разбивает входной речевой сигнал обычно на 4-16 широких частотных поддиапазонов (широкополосный анализ). В АТС для обеспечения более точных частотных показателей число поддиапазонов увеличено до 128-256 (узкополосный анализ).
Многополосное кодирование обычно рассматривается как метод кодирования формы сигнала, который использует широкополосный кратковременный анализ и синтез. После разделения речевого спектра на несколько поддиапазонов низшая частота каждого из них приводится к нулю, затем поддиапазон дискретизируется в соответствии с частотой Найквиста (минимальной частотой дискретизации), квантуется, кодируется, мультиплексируется и передается. В приемнике поддиапазоны демультиплексируются, декодируются и переводятся обратно в их частотные позиции. Результирующие сигналы поддиапазонов затем складываются для получения аппроксимированного исходного речевого сигнала.
IP-телефония
Основные стандарты кодирования речи, применяемые в 1Р-телефонии, приведены в табл. 4.1.
Таблица 4.1
Стандарты ITU-T по кодированию речи, применяемые в IP-телефонии
| Стандарт | Описание |
|
G.711 |
Импульсно-кодовая модуляция 64 кбит/с (ИКМ) (А-закон и μ-закон) |
| G.722 | Широкополосные кодеры, работающие на скорости 64, 56 или 48 кбит/с |
| G.726 | Рекомендации по кодерам АДИКМ, которые охватывают G721 и G723 |
| G.727 | АДИКМ, работающие на скоростях 40, 32, 24 или 16 кбит/с |
| G.728 | Вокодеры с линейным предсказанием, с кодовым возбуждением, с низкой задержкой, скорость 16 кбит/с (LD-CELP) |
| G.729 | Вокодеры с линейным предсказанием, с алгебраическим кодовым возбуждением, с сопряженной структурой, скорость 8 кбит/с (CS-ACELP) |
| G.723.1 | Низкоскоростные вокодеры для связей мультимедиа, работающие на скорости 6,3 и 5,3 кбит/с |
Каждая из приведенных в таблице рекомендаций ITU может служить основой для передачи речи по Интернету и другим сетям, так как все они обеспечивают низкие скорости передачи и достаточно просты в реализации персональным компьютером или в микропроцессорном исполнении.
Основной целью проектирования кодеров является уменьшение скорости передачи речи при безусловном сохранении требуемого уровня качества речи для конкретного приложения. Приложения по передаче речи в Интернет или Интранет могут быть либо самостоятельными, либо в форме мультимедиа. Так как мультимедиа подразумевают наличие нескольких средств кодирования речи, для таких приложений подразумевается, что поток речевых данных передается по линии связи совместно с другими сигналами. Некоторые из таких приложений могут включать:
одновременную передачу речи и видео;
приложения с одновременной цифровой передачей речи и данных (DSVD);
одновременную передачу речи и факса.
Особенности функционирования каналов для передачи речевых данных и прежде всего сети Интернет, а также возможные варианты построения систем телефонной связи на базе Интернет предъявляют ряд специфических требований к речевым кодерам (вокодерам). Благодаря пакетному принципу передачи и коммутации речевых данных отпадает необходимость кодирования и синхронной передачи одинаковых по длительности фрагментов речи.
Наиболее целесообразным и естественным для систем IP-телефонии является применение кодеров с переменной скоростью кодирования речевого сигнала. В основе кодера речи с переменной скоростью лежит классификатор входного сигнала, определяющий степень его информативности и, таким образом, задающий метод кодирования и скорость передачи речевых данных. Наиболее простым классификатором речевого сигнала является детектор активности речи (VAD — Voice Activity Detector), который выделяет во входном речевом сигнале активную речь и паузы. При этом фрагменты сигнала, классифицируемые как активная речь, кодируются каким-либо из известных алгоритмов (как правило, методом CELP) с типичной скоростью 4…8 кбит/с. Фрагменты, классифицированные как паузы, кодируются и передаются с очень низкой скоростью (порядка 0,1.. .0,2 кбит/с) или не передаются вообще. Передача минимальной информации о паузных фрагментах предпочтительна.
С помощью более эффективных классификаторов входного сигнала может более детально осуществляться классификация фрагментов, соответствующих активной речи. Это позволяет оптимизировать выбор стратегии кодирования (скорости передачи данных), выделяя для особо ответственных за качество речи участков речевого сигнала большее число бит (соответственно большую скорость), для менее ответственных – меньше бит (меньшую скорость). В результате могут быть достигнуты еще более низкие средние скорости (2...4 кбит/с) при высоком качестве синтезируемой речи.
Передатчик состоит из кодера речи, VAD, усреднителя фоновых шумов и переключателя на канал, который управляется выходом VAD. Когда на вход есть речь, передатчик постоянно включен. Во время пауз передатчик выключается, но после определенного времени, которое должно быть достаточно коротким, передатчик снова включается на один фрейм, чтобы передать информацию о среднем фоне для точного генерирования в приемнике комфортного шума. На приемной стороне, если определено наличие речи, происходит нормальный синтез. Если определено наличие паузы, выполняется одно из двух действий. Если не передается новой информации о фоне, используются существующие параметры шума, генерируется комфортный шум и используется для текущего фрейма. Если передаются новые параметры фонового шума, то старые параметры заменяются на вновь декодированные, а за тем генерируется новый комфортный шум. Обычно, на стороне декодера также используется индикатор «хороший/плохой» фрейм, чтобы показать верны или нет декодированные параметры, и если нет, используется замена фрейма. Эффективность DTX зависит от точности VAD.
Кодеры стандарта D-AMPS
Цифровой стандарт мобильной радиосвязи D-AMPS (Digital Advanced Mobile Phone Service), принятый в США в 1990 г., по своим функциональным возможностям и предоставляемым услугам приближается к стандарту GSM. Стандарт D-AMPS не принят в европейских странах, за исключением России, где он в основном ориентирован на региональное использование.
Блок предварительной обработки выполняет следующие функции:
предварительную цифровую фильтрацию входного сигнала с целью подъема верхних частот, на долю которых в спектре речевого сигнала приходится меньшая мощность;
«нарезание» сигнала на сегменты по 160 выборок (20 мс).
Для
каждого 20-мс
сегмента оцениваются
параметры
фильтра кратковременного
линейного
предсказания
– 10 коэффициентов
частичной
корреляции
 ,
 (порядок предсказания
М
= 10), которые
непосредственно
кодируются
для передачи
в канал связи
без каких-либо
дополнительных
преобразований,
и оценивается
амплитудный
множитель р,
определяющий
энергию сегмента
речи.
Сигнал
с выхода предварительной
обработки
фильтруется
фильтром-анализатором
кратковременного
линейного
предсказания
A(z),
имеющего форму
трансверсального
линейного
фильтра, для
чего коэффициенты
частичной
корреляции
 преобразуются
в коэффициенты
линейного
предсказания
 .
Выходной
сигнал фильтра
кратковременного
предсказания
(остаток предсказания
 )
используется
для оценки
параметров
фильтра
 долговременного
предсказания
– задержки
τ и
коэффициента
предсказания
 ,
причем параметры
долговременного
предсказания
оцениваются
в отдельности
для каждого
из четырех
подсегментов
по 40 выборок,
на которые
разделяется
сегмент из 160
выборок.
Для
каждого из
подсегментов
определяются
параметры
сигнала возбуждения.
Для этого в
составе кодера
используется
схема, аналогичная
входящей в
состав декодера,
которая включает
фильтры-синтезаторы
кратковременного
 и
долговременного
 предсказания
и две кодовые
книги и реализует
метод «анализа-через-синтез».
Каждая из кодовых
книг сигнала
возбуждения
содержит 128 кодовых
векторов, по
40 элементов в
каждом.
Все кодовые векторы одной книги являются элементами 7-мерного линейного подпространства в 40-мерном пространстве. Каждая кодовая книга, содержащая 128 векторов, задается семью базисными векторами и 128 кодовыми словами (7-элементными векторами коэффициентов линейных комбинаций) с однобитовыми элементами.
Сигнал
возбуждения
фильтр синтезатора
кратковременного
предсказания,
в соответствии
со схемой декодера
рис. 5.4, является
суммой векторов
возбуждения
из двух кодовых
книг и вектора
с выхода фильтра
синтезатора
долговременного
предсказания.
Векторы возбуждения
из кодовых книг
до подачи на
сумматор умножаются
на соответствующие
коэффициенты
усиления
 и
 ,
а входным сигналом
фильтра-синтезатора
долговременного
предсказания
является, в
зависимости
от участка
сегмента, выходной
сигнал того
же фильтр или
суммарный
сигнал возбуждения
фильтра-синтезатора
кратковременного
предсказания.
Параметры
сигнала возбуждения
– номера векторов
возбуждения
 и
 из первой и
второй кодовых
книг и соответствующие
коэффициенты
усиления
и
– определяются
по критерию
минимума
среднеквадратичной
ошибки на выходе
фильтра-синтезатора
кратковременного
предсказания,
входящего в
состав кодера.
Предварительно
базисные векторы
обеих кодовых
книг ортогонализируются:
для первой
книги – по отношению
к выходному
вектору фильтра-синтезатора
долговременного
предсказания,
для второй
книги – по отношению
к тому же выходному
вектору и к
базисным векторам
первой книги.
В результате выходная информация кодера речи для 20-мс сегмента включает:
• параметры
фильтра кратковременного
линейного
предсказания
– 10 коэффициентов
частичной
корреляции
,
,
и амплитудный
множитель
р
– один набор
на весь сегмент;
• параметры
фильтра долговременного
линейного
предсказания
– коэффициент
предсказания
и задержку τ
– для каждого
из четырех
подсегментов;
• параметры
сигнала возбуждения
– номера
и
векторов возбуждения
из двух кодовых
книг и соответствующие
коэффициенты
усиления
и
– для каждого
из четырех
подсегментов.
В табл. 5.2 приведено содержание выходной информации кодера с указанием числа бит, используемых для кодирования.
Таблица 5.2
Кодирование выходной информации кодера речи стандарта D-AMPS
| Передаваемые параметры | Число бит | Примечание |
|
Параметры
кратковременного
предсказания
(коэффициенты
частичной
корреляции
|
38 |
|
| Амплитудный множитель (энергия сегмента) р | 5 | |
| Задержка фильтра долговременного предсказания τ (для каждого из четырех подсегментов) | 28 | 7 бит на каждый подсегмент |
|
Номера
векторов
возбуждения
|
56 |
h и i2 по 7 бит |
|
Коэффициенты
усиления
Если Вам нужна помощь с академической работой (курсовая, контрольная, диплом, реферат и т.д.),
обратитесь к нашим специалистам. Более 90000 специалистов готовы Вам помочь.
Бесплатные корректировки и доработки. Бесплатная оценка стоимости работы.
Нужна помощь в написании работы?
Мы - биржа профессиональных авторов (преподавателей и доцентов вузов). Пишем статьи РИНЦ, ВАК, Scopus.
Помогаем в публикации. Правки вносим бесплатно.
Похожие рефераты: |
 – 6
бит;
 – по
5 бит;
 – по
4 бита;
 – по
3 бита;
 – 2
бита