Машины, которые говорят и слушают
В4
особенностями произношения, но и формы, включающие случайные сегменты, маркированные квазифонетическими метками, появление которых связано с неидеальностью автоматической фонетической сегментации и маркировки нашим алпаратурно-програмыным методом, вызванной, например, изменением интенсивности речевого сигнала.
В дальнейшем будем рассматривать влияние двух обстоятельств на формирование эталонных поверхностных форм слов рабочего словаря, учитывая, что поверхностные формы, связанные о особенностями произношения и матрицей ошибок квазифонемной классификации, можно построить вручную (или автоматически,исполь-ауя таблицу акустико-фонодогических правил, хранящуюся в памяти, и прилагаемых к базовой квазифонетической цепочке), а поверхностные формы w . , обусловленные особенностями аппаратуры выделения информативных признаков, можно получить, анализируя статистику реализации квазифояетических цепочек слов рабочего словаря, полученных с помощью ЭВМ. Получение этой статистики не всегда обязательно, особенно если рассматриваются слова,контраст-ные по своим акустическим свойствам. Предварительную оценку сложности распознавания слов можно сделать аналогично оценке сложности фонетического алфавита - по фонетической структуре слов, вычисляя апостериорную словесную неопределенность и не исследуя статистики реализации.
Все эталоны слов и^у б W рабочих словарей должны быть представлены последовательностью маркированных фонетическими метками отрезков, где квазифонемы должны делиться на опорные, обязательные для данного слова (определяющие базовую форму и, как Правило, присутствующие во всех поверхностях), и "вспомогательные", трудноклассифицируемые. Трудноклаосифицируемые сегменты должны быть расчленены (хотя бы грубо) на несколько квазифонетических элементов, если длина этих сегментов выше пороговой (это делает на первом этапе человек на основании знаний фонетической структуры возможных форм каждого слова). Опорными сегментами слова следует считать маркированные отрезки которые при их маркировке квазифонетичаскими метками допускают суммарную ошибку ниже ввристически определенного порога.
При автоматическом распознавании выбор эталонов (из словаря эталонов) должен быть в первую очередь обусловлен наличием в Поступившей на вход реализации опорных, обязательных маркированных сегментов о. с учетом того, что за счет иеидеадьности сегментации общее число сегментов входной реализации может не совпадать с возможным числом сегментов эталонного графа,за счет Неопорных сегментов, образующихся или выпадающих случайно.
У5
Сшибки классификации дают появление "путающихся" поверхностных форм (представленных последовательностью квазифонеы) дяя различных слов словаря. Будем считать, что матрица ошибок при распознавании слов априори формируется таким образом, что (при сходстве поверхностных форм различных слов словаря) более часто встречающиеся поверхностные формы слов одного класса (при заданном алфавите квазифонем) считаются относящимися к словам только этого класса, а редко встречающиеся сходные поверхностные формы для других слов словаря дают ошибки распознавания. Впрочем, используя синонимию или семантико-синтаксические ограничения при распознавании пословно произносимых фраз. Всегда следует добиваться того, чтобы подобные случаи не происходили (трудности представляют слова, входящие в одну семантико-сиитаксическую группу,которые нельзя заменить синонимами, например, названия цифр).
Следует отметить, что принятые решения о принадлежности поступившей на вход реализации к тому или иному классу следует делать но эталонам с одинаковым числом опорных сегментов и с учетом верификации сяова, всякий раз используя эвристически выбранные пороги достоверности, в общем случае разные для различных слов. Так, для принятия окончательного решения о принадлежности входной реализации Уд. к классу Wy необходимо выбрать
и w, , который ооответ-
два наиболее вероятных кандидата
— —— - . ^ ствуют вероятности p(v,/u7y] и ^(i^/г^ ), и проверить,удовлетворяются ли условия:
WM,)>^,;
Р^/^-Р^/^,)^^
где А^ - пороговое значение вероятности того, что входная реализация соответствует олову у/, ; Ay, - пороговые значения разности условных вероятностей принадлежности входной реализации
г1д. классам и
vf. ,
при которых
принимается
решение о клас-
сификации у^ .
Пороговые значения /Зд,/!,, выбираются экспериментально по заданной системе используемых фонетических признаков,а также требуемых точности распознавания и вероятности отказов от распознавания. В случае, если подбором порогов заданные требования к системе распознавания не удается выполнить, следует провести более детальный анализ неопорных сегментов, иди попытаться улучшить систему признаков. В ряде случаев дяя удовлетворения заданных в системе требований следует использовать синонимию.
66
Рассмотрим далее более конкретно, как оценить лексическую неопределенность словаря V языка речевого общения неадаптивной системы автоматического распознавания. Аналогично тому, как оценивалась неопределенность алфавита фонем, можно определить сложность распознавания входного словаря V , состоящего из R слов, и вычислить эквивалентный размер входного словаря. При этом необходимо получить вероятности p(v^/w,) одиэости областей призна-хового описания слов i^, « V, ur, б W, г= /7Д. 3s /75. которые представляются в виде последовательности фонетических единиц (фонетической транскрипции слов). Далее оценим вероятности p(ff^/v7y).
Как уже отмечалось, на основе лингвистических знаний, эта-жоны слов Wy (. W представляются в вида фонетических ( вернее, квазифонетических) цепочек,совокупность которых описывается графом с конечным числом состояния, а каждая фонема - признаками способа и места образования. Слову VT, соответствует одна или несколько траекторий (цепочек поверхностных форм) на графе (количество траекторий зависит от метода произношения и характеристики диктора). Направленный граф f (W,) представляет все фонемы этахона сяова иг, б W , который имеет uf, поверхностных форм, k= !, 2, . . ., А-з ; uly = U'1Л ; каждая поверхностная форма
^ e w, содержит
,.^,-...^ Пусть р ( иГу)
ur, e 1= l(3.k) опорных квааифонем, т.е. иг,), } I-- /,2,..., 1(з, k).
априорная вероятность появления слова u^eW на выходе блока лексического распознавания, а априорная вероят-
р (vfs„ ) • При
ность иГу поверхностной формы этого же оаова этом выполняются условия
л, « Р(Щ,)= Z: Р(^) ; Ј/?(ur,)=/.
Необходимо отметить, что количество опорных сегментов в поверхностных формах слов выходного словаря различно, т.е. предел изменения индекса I зависит как от номера слова, так и от его поверхностной формы I = I (.з, k}.
Для того,чтобы осуществить оценку неверной классификации слов словаря на стадии лексического распознавания по фонетической структуре этих слов, выполним операцию разбиения всех поверхностных форм эталонов слов на М фонетических групп с одинаковым количеством опорных сегментов 1= I (з) . При этом слова, поверхностные формы которых принадлежат разным группам, не будут Путаться между собой, поскольку их легко классифицировать по числу "опорных" фонем, составляющих слова.
8?
Вообще говоря, можно представить себе фонетические группы эталонных поверхностных форм, отличающиеся не только числом опорных фонем, но и их характером, а также порядком следования.Если учесть все три фактора, позволяющие разбить эталоны на существенно большее число фонетических групп, то дальнейшие рассуждения можно отнести к каждой из этих групп. Для простоты,однако, будем считать, что мы имеем М фонетических групп, в каждой из которых одинаковое число опорных сегментов. В практических задачах при разбиении на группы следует учитывать все эти факторы, однако необходимо строго ограничивать число различных опорных сегментов, выбирая лишь те, которые не путаются между собой и характеризуются групповыми признаками места образования - ударные гласные, смычные, фрикативные [81,60] .
Итак, допустим, что существует М фонетических групп слов W, , W^, . . . , W^ , . .., W^ , в каждой из которых^ одинаковое число опорных квазифонем. Общее число эталонов И/= U W^ , а количество фонем, составляющих: слова (длина фонетической цепочки) каждой группы, об означим через I ; т= /,/И.
Представляя таким образом слова словаря на входе СРР и используя матрицы ошибочной классификации фонем, составляющих слова
/Кй/&)-[Ру], (2.5) можно оценить вероятности p^(v /Wy) спутывания поверхностных
форм слов внутри каждой группы слов следующим образом:
где
t = t, 2, . . . , t^ - длина фонетической цепочки группы слов ^ , а^ е ^ , Ь„ е иг,.В общем случае одно и ъо же слово Wy может иметь К, поверхностных форм, имеющих разное число фонетических элементов и попадающих в разные группы слов W^, . Поэтому общую условную вероятность "спутывания" слов словаря определим
(2.8)
P(v^/w,l= Г P(w^) р^ ( ^ /г^-) .
Для определения потери информации в СРР, которая рассматривается как канал перэдачи информации, в случае распознавания слов используем выражение
86
(2.9)
KV/W)-- -Z p(w,)i p(v^/ w^ locj^ p( v^ /v/,).
/ (V/W)
Тогда 2 определяет эквивалентный размер словаря —
число альтернативных слов на входе системы распознавания, а
2й v) - фактический объем входного словаря, где
R
Х
г'1
(2.10)
Эти выражения,
аналогичные
формулам
(2.4), (2.5), оценивающим
фонетическую
неопределенность,
являются критерием
оценки лексической
неопределенности.
Они определяют
сложность
распознавания
словаря и позволяют
судить о качестве
СРР. При автоматической
маркировке,
наряду с ошибками
неверной
кдассификации
фонем, существуют,
как уже отмечалось,
ошибки неверной
сегментации,
приводящие
к слиянию отрезков,
соответствующих
смежным фонемам,
в один сегмент
или расчленению
отрезка, соответсвувщего
одной фонеме,
на несколько
смежных фонем
разных классов.
При выборе
альтернативных
слов словаря
надо следить
за тем, чтобы
неприятности
такого рода
не вызывали
подобия
последовательностей
фонетических
единиц, соответствующих
разным словам.
Для этого
необходимо
использовать
матрицы, отражающие
возможные
варианты
сегментации
слов словаря
и частоты
встречаемости
тех или иных
вариантов
сегментации,
соответствующих
различит
поверхностным
фориам слов.
Так как информация
о словах, содержащихся
в фонемах,избыточна,
то часто при
оценке различимости
слов словаря
вполне достаточно
использовать
опорные фонемы,
допускающие
минимум ошибок
расчленения
и слияния. Поэтому
в формуле
(
§
2.3. О языке описания
данных в системе
автоматического
речевого запроса
информации
2.3.1.
Понятийный
язык и двухступенчатое
иерархическое
построение
его грамматического
представления.
Информационные
системы, стояь
распространившиеся
в настоящее
время, требувФ
общения с
ними с помощью
устной речи
на языяв, близком
к естественному.
Необходимая
нам информация
должна быть
выдана по запросу
Зак.480
89
последовательности понятийных дескрипторов, которую человек может произнести, не используя жесткого порядка следования этих дескрипторов. Такое представление совокупности дескрипторов - понятийного поля не только обеспечивает естественность запроса информации из базы данных, но и фактически не увеличивает времени поиска релевантной информации, так как при этом учитываются отношения между понятиями и используется иерархический принцип с ыниыой иерархией, обеспечиваемой перестраиваемой структурой дорического дерева. В связи с этим можно представить общую грамматику 6 формирования понятийного поля, включающего посведо-вательность предложений, которые дают информацию о структуре дег.криптов, в виде иерархически связанных граыиатик верхнего и нижнего уровней. (Процесс формирования свободных от ошибок словесных цепочек, полученных в результате автоматического распознавания слов и устного редактирования, рассматривать здесь не будем .) Грамматика верхнего уровня G" определяет общую структуру понятийного поля, а языки, обусловленные грамматиками нижних уровней б[ , конкретизируют порождение предложений на уровне формирования понятийных фраз. Грамматика G" допускает появление понятий (они выражены запросными фразами S^ ), формирующих смысл запроса, в произвольном чередовании. Иными словами, порождающая грамматика последовательности понятий - есть простей-вая грамматика типа 0 (по Хомскому), в которой нетерминальными символами vh являются обобщенный дескриптор понятийного поля (поисковый образ запроса) и понятийный уровень, а терминальными V - конкретное наименование понятий (названия уровней) ^ . Нетерминальный символ { обобщенный дескриптор понятийного поля j является начальным символом S в грамматике в", а правила вывода р сводятся к допустимости перестановок терминальных символов s.—^s-.такчто для понятий s,,Sg,...,5^ язык, обусловленный этой грамматикой, допускает К ' предложений длины К , в каждом из которых все понятия различны:
S, , S, , . . . , S„ ; ^ , s, , • • • , ^ ; 5,. S,, S, ,. .., 5^ .
Вообще говоря, грамматики типа 0 допускают бесконечное количество словесных цепочек (предложений) различной длины, составленных из терминальных символов. Если считать, что нас интересуют словесные цепочки с неповторяющимися терминальными символами, и представлять обобщенный дескриптор понятийного поля цепочками переменной длины J = f -L К , то число N возможных предложений, используемых для работы и допускаемых языком этой гр^матикм, ^^., ^^
90
Каждый из терминальных символов грамматики в° в свою очередь является начальным (и нетерминальным) символом порождающей грамматики второго уровня (7, , накладывающей или не нак-
ограничения на формирование предложений в t'-ru понятийного уровня (рис.2.3).
ладывающей ограничения на формирование предложений в рамках каждого t-ru понятийного ур
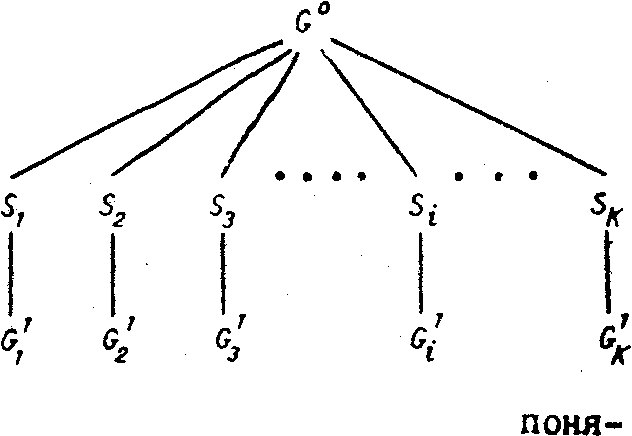
Рис. 2.3. Порождения тийных полей
Отметим, что в зависимости от особенностей терминального словаря каждого уровня и привычки пользователей к произношению фраз этого уровня на естественном языке порождающая грамматика с начальным (нетерминальным) символом, полученным на предыдущем уровне, может быть нулевого, первого, второго иди третьего типа, определяемого соответствующими правилами вывода.Далее мы рассмотрим оценку грамматической сложности языка (с точки зрения автоматического распознавания речи) на уровне
формирования предложений с учетом произношения слов, являющихся
Go терминальными символами грамматики , и покажем, что означает
"подстройка под словарь и язык" в неадаптивных системах автоматического распознавания слов. Языки, определяемые грамматиками б", (7/, G',...,(?/,..., G^ (рис. 2.3), будем называть языками системы распознавания речи, подразумевая, что с точки зрения автоматического распознавания слова, являющиеся терминальньгми символами грамматики высшего уровня, также конкурируют между собой и определяют начальный символ сети (графа), которой представляется языком СРР.
2.2.2. Оценка сложности языка с точки зрения автоматичес-кого распознавания пословно произносимых предложений. Синтаксис и семантика языка СРР, определяемых грамматилаки {G^} , накладывают ограничения на порядок следования слов в предложении в характер возможных словосочетаний. Эти ограничения существенно облегчают задачу распознавания речи вследствие сокращения общего поискового пространства признаков.
Для приближенной оценки грамматической сложности языка СРР рассмотрим грамматику автоматического языка как наиболее простого и наиболее поддающегося количественному анализу.Грамматики Нулевого, первого и второго типов, как было указано ранее, также можно использовать для формирования предложений в СРР, однако их количественные характеристики подучить сложнее. и тому же ряд закономерностей, характерных дяя языков, оаисываяицихся грамматиками
91
большей сложности, можно выявить и на самом простом языке, относящееся к частным случаям языков нулевого, первого и второго типов и наиболее используемом при формировании предложений в современных системах распознавания речи.
Правила подстановки в грамматиках третьего типа (автоматных) имеют вид А = а В или А —- В , где А, В с 1^ и а, Ь (. 'i . Для языка СРР А и В характеризуют названия смысловых групп, а а , Ь - названия слов в смысловых группах - подсдоварях. Грамматика автономного языка определяется множеством внутренних состояний s„3 ,. . .,s^,..., ss и правилом перехода в следующее состояние .
Следовательно, после слова с номером i(n) из группы слов s с S может следовать слово из подсловаря s^, с s . Кроме того, заданы S и S - состояния, которыми соответствен
KG)
но начинаются и кончаются фразы. Например, предложение имеет структуру
l.(G)=S„v, v. ,.
где veS,, v, e S,, . т = /, 2, . . . , I
Оценим синтаксическую сложность автоматного языка средним коэффициентом ветвления К^р , который определяется средним числом возможных слов в каждой точке дерева ветвления:
К,
ср
i м -—Z К,
N l-i
(2.К)
количест-
^десь К^ - коэффициент ветвления в точке i ; N во точек ветвления.
Средний коэффициент ветвления удовлетворительно описывает синтаксическую сложность языка тогда, когда появления слов в предложении равновероятны.
Если средняя длина предложения /^д , то произведениями Z^„ «/<- можно оценивать грамматическую сложность рассматриваемых языков речевого запроса и даже в какой-то мере (очень приближенно) сравнивать точность автоматического распознавания пословно произносимых фраз. Но эта оценка не учитывает фонетических особенностей подсловарей. К тому же в реальных условиях различные слов8 словаря речевого общения имеют разные вероятности при формировании фраа. Для учета этих факторов будут использованы квазифонетическое представление поверхностных форм слов (см.п.2.2.2) и стохастическая порождающая грамматика, у которой задано вероятностное распредеаенме правил образований предложений рц из слов в
i/
92
»аждой точке ветвления 1= 1,п нкя выполняется условие
При этом для всех точек ветвле-
(2.13)
где К- - количество возможных слов в точке I (коэффициент ветвления). Тогда вероятность получения фразы l(G)6i(G) в результате применения t правил подстановок равно произведению вероятностей примененных при этом выводе правил образования. Отметим, «то число слов, составляющих предложения, может быть различное И зависит от количества правил,примененных при формировании данного предложения.
Определим энтропию Н(/-} языка /(0) .Для этого обозначим через L^ множество всех фраз длины п слов, допускаемых грамматикой G:
|
через ЮЛИЯ |
р(^) |
/ -и1^ ^п-Ч '•••' |
f(n) |
Лп) '-г '• • • |
|
| - вероятность |
•s • • • • ' получения |
фразы /(0) | |||
|
HU |
) |
языка речевого общения | |||
(2.14)
if/)) f(n) •} ^ • • • • • '-г ' • • •)•
Тогда эн-
г(л)н^-^, ^ ^О^/^О, (2.15) где Т - максимальная длина предложения. Естественно, что
(2.16)
г z pa^)=f.
/,., iyki, г
В случае, когда различные предложения, порождаемые грамматикой G , имеют разные смысловые интерпретации, тогда энтропия Языка характеризует его возможность передавать информации. В соответствии с теорией кодирования информации число возможных фраз языка с энтропией H(Z) будет 2н(t), и это значение определяет размер входного языка.
Для определения сложности (неопределенности) распознавания языка речевого обшения рассмотрим процесс распознавания предложения в виде последовательности распознавания слов из подсловарей данного уровня, размеры которых определяются коэффициентами ветвления К^ . Тогда для оценки сложности распознавания языка необходимо оценить сложность распознавания всех N подсловарей
93
этого
уровня, где
вероятностью
P(Vf,
} применения'
каждом узле дерева стохастической автоматной грамматики. Имея условные вероятности р. (v^/Шс) ошибочного распознавания слов каждого из подсловарей и рассматривая CPF как канал передачи информации, определяем потери информации /„ду в случае распознавания предложений, произносимых пословно, следующим образом:
к к;
Ј
с?
Обычно интересуются, как распределены потери информации по различным понятийным уровням S^ и различным узлам графа, представлякщего автоматную грамматику уровня. Важно знать,в каком узле языка общения "тонкое место" и как его устранить.
Для общей оценки сложности распознавания предложений, которые произносятся пословно в соответствии с заданной грамматикой G , можно пользоваться выражением 2 "" , которое определяет среднее число возможных альтернативных фраз на входе в СРР. В случае, если СРР работает баз ошибок, при пословном произношении фразы на выходе системы всегда одно предложение.
Формула (2.17) оценивает сложность распознавания фраз языка речевого общения СРР. При этом отметим, что эта мера зависит как от фонетической структуры слов словаря, так и от грамматических правил образования предложений. В практических СРР при
распознавании языка необходимо, чтобы /„ была близка к нулю
^пот < ] порог • (РВД11118 ошибки при распознавании слов можно устранить словами устного автоматического редактирования .) Если