Машины, которые говорят и слушают
5. Модуль "Звук-2" использует правила перевода букв (графем) в звуки для порождения фонетической последовательности, если модуль "Декомпозиция" не смог полностью превратить слова в последовательность лексических морфем. После превращения последовательности букв в последовательность фонетических символов этот модуль использует полный набор правил лексического ударения, определяющих контур ударности для этого слова (эти правила, например, определяют Правильность произношения аффикса ate в словах eyatematio и eyetemeUze).
При синтезе речи используется набор модулей, обеспечивающих порождение входной речевой водны:
- модуль "Просодика"» определяющий для каждой фонемы формируемого предложения частоту основного тона, длительность и интенсивность (ударность);
68
- модуль "Синтез", используя фонетические метки и проводи-ивокую ш«формацию, каждые б мо порождает параметры, достаточные •ля управления цифровой модель» речевого тракта, формирующей от-очеты речевой волны. Модуль "Синтез" - ато большая программа, мализуккцая алгоритм фонетического синтеза речи по правилам с дополнительным наложением просодического контура;
- модуль "Речь" превращает полученную последовательность десантных отсчетов в речевую волну, используя цифроаналоговый Преобразователь.
В [133] рассмотрена интерактивная система исследования речи tiK; , чозвояяищая в диалоговом режиме изучать и модернн-ащювать правила преобразования "текст - фонема", что дает возможность получать более качественную синтетическую речь. Система spy использует три вида правил преобразования (рис.1.4):
1) правила модификации текста, модифицирующие начальную тек-стоьуь строку и связанные с ней признаки;
2) правила конверсии, формирующие цепочку фонем и связанную в ней матрицу признаков на основе информации, имеющейся в модифицированной текстовой строке;
3) правила модификации признаков, которые изменяют матрицу признаков, формируемую правилами конверсии.
Рассмотрим алгоритм преобразования "текст-фонема",реализованный в [I33J , на примере преобразования слова.
На вход программы преобразования поступает слово, каждой букве которого соответствует присоединенный признак, определяющий глаонке или согласные звуки, соответствующие етим буквам:
с буква
согл..
(символы)
(присоединенные)
признаки
a r L п д
буква буква букяа буква буква
глад. оогл. глао. согл. глас.
На аерьом
уровне текстовая
цепочка и связанная
о ней матрица
Признаков
модифицируются
множеством
правил модификации
текста. б»н
аравиле могут
устранять,
добамнгь и
заменять символы,а
так-*•
делать соответствуххцие
ыодифхнации
матрицы признаков.
Правила ч^дифинации
•мжста, например,
вводят символ
е*' после гласного,
»»
которым следует
один или два
согласных, и
перед суффиксами
69
Текст и признаки
Правила модификации текста (ТМ-правила)
Модифицированный текст и признаки
Правила конверсии (С-правила)
Фонемы и признаки
( W-правила)
Правила модификации признаков Модифицированные признаки
Рис. 1.4. Три уровня правил преобразования "текст-фонема1' системы SRS
sharing
+s/?are+. ing+
Ce] [C]
Правила модификации текста I. 0---e+/l/c[?,2L{ed|^}
Пракиха конверсии
И. а—р/_с[* соп}е^
Правила модификации признаков
3. [tfns—-[-tens'] /_ [+ ret]
Применение ТМ-оравмя к сяоэу carlna дает:
< с а г е + i n (f буква буква букм буква буква буква буква соги. глас. согя. гяас. пас. согя. согд.
Таким обозом, эти аравияа вводят новую букву е , а также опредедяшт границу модемы "+" и суффикса " •". (Введенные си»»-воям служ*»т важной частью иравия контекста, которые исоояьауются С- и / М-правияами.)
Модифицированный текст и связанные с ним признаки далее обрабатываются С-оравмяаыи, которые формируют фонетическую цепочку из последовательности буке, полученных на предыдущем ваге. С-иравияо (рис. 1.Ь ), например, показывает, что буква "а" произносится, как "е", когда она предшествует одиночной согяас-ной, за которой сявдует эаканчиваиаая морфему буква "е". (Это
70
Оравию применяется к "а" в w»e Bathing,гд,» звуки " th " проиэ. косятся как один согяасный, но не к "а" в слове taxina , где •х'1 произносится как два согласных.) Результат применения всех оравил конверсии к сдову carinq позвояяет пожучить ояедующгю вались:
9
согл. взрывной,
подъема, альвеолярный велярный, передний звонкий
+ А- е г -+. I n согл. гдас. согя. глас. con. взрывной, среднего ретро- верхнего назальный, велярный, пид-ьеыа, Фявчсный подъема, гяухой передний
Если правила модификации текста изменяют текстовую цепочку непосредственно, то С-правила формируют ноаую цепочку (фонем) на основе tm{iupuaiyiH. заключенной в текстовой цепочке, F/И-пра-
•ила модифицируют фонетическую цепочку, применяя прарила контекстной зависимости х матрице признаков и включая или устраняя соот катет йущяв сегменты. Так. ГМ -правило устанавливает, что напряженный гласный становится напряженным перед ретрофлексными звуками. Другии /^"дравидом яуяяетая правило объединения п и д , когда произносится п . Все эти правила использовались совместно с английскими правилами порождения параметров, соответствующих фонемам, для похучения речевой волны.
В [%] рассматривается математическое обеспечение однокристальной микроЭВМ модели <»20, преднааначенной для обработки сигналов. Благодаря наличию аналоговых входных и выходных схем М высокому быстродействию она легко может быть перестроена для синтеза речи. На атой микроЭВМ можно реализовывать различий способы синтеза речи. Описаны программы, моделирующие работу генератора голосовых импульсов (программа формирует ряд асимметричных треугольных импульсов), а также генератор шумового сигнала, который моделируется при помощи генератора псевдослучайных чи~ Св*. Для моделирования передаточных функций речеобразумаего тра-«»а разработаны программы модификации выходных значений сигна-
*ов, поступающих с выхода генератора голосовых импульсов и гене-Р»тора шумовых сигналов. Для втого применяют моделирование рекурсивных фильтров с переменными временными параметрами и ыиогоавен-чах. В [96] приведена типичная программа для одного звена ччогозввнного фнютра, управляемого параметром, который иивет раз-чые значения для различных звеньев. Отмечается, что для пос-•Ровния типичного синтезатора речи требуется два микропроцессора ®20; первый обеспечивает работу генератора воабуадаицих сигна-
71
лов и моделирование нескольких первых звеньев многозвенного фидьтра, а второй - для остальных звеньев этого фильтра. Для построения форматного синтезатор»» достаточно воспользоваться одним микропроцессором 2920. Речевой тракт моделируется здесь последовательностью рекурсивных фильтров второго порядка (в [96] при» водится программа такого фильтра). Для удовлетворительного синтеза последовательно включают не менее трех звеньев,моделирующих три форманта.
1.4.6. Отечественные системы автоматического речевого вывода. Основные работы по автоматическому синтезу речи связаны с построением параметрических синтезаторов [6,43, 48-50, 53, 70, 75]. Некоторые из систем речевого вывода информации из ЭВМ внедрены в опытную эксплуатацию [43,48] , другие - близки к внедрению [6, 70,78] , третьи - используются в экспериментальных установках [50, 56] .
Развитие работ по построению систем автоматического речевого вывода ведется в нашей стране в широком диапазоне - от фо" немных синтезаторов до словесных и даже фразовых временных компиляторов.
Если в работах первого направления, при которых фонема рассматривается как набор заданной последовательности движения артикулятороа в артикулчторной программе, стремятся к компактности представления генерируемого речевого сообщения и универсальности, обеспечивающей речевое отображение произвольной текстовой информации, то в компилятивных временных синтезаторах второго направления делается упор на разборчивость и естественность скомпилированных высказываний (в ущерб универсальности и компактности представления сигнала).
Одним из наиболее типичных синтезаторов параметрического типа является ортогональный синтезатор речи [48] . Синтезатор предназначен для выцачи голосом из ЭВЫ в телефонный канал счетов-справок о стоимости состоявшихся междугородных переговоров городской телефонной сети. Речевой сигнал (слово ограниченного по объему словаря) представлен временными изменениями параметров сигнала - логарифмов огибающей амплитудных спектров. Речевые ответы (фразы) вначале формируются в виде списков номеров слоя, речевые эквиваленты которых затем посегментно объединяются и выводятся на синтезатор. Отмечается, что разборчивость синтезируемых фраз близка к 100%, скорость вывода речевого сигнала на синтезатор равна 12 бит/с.
При артикуяяторно-форматном синтезе речи по печатному тексту L6.^] в качестве минимального артикуяяторного компдйкса
72
используется элементарный слог, представленный набором артикуля-торных команд способа и места образования входящих в него фонем. Процесс реализации слога делится на три основные фазы: переходная фаза от предыдущего слога к данному, фаза реализации согласной фонемы и фаза реализации гласной. Синтезатор учитывает просодические характеристики естественной речи, а также то обстоятельство. что в ней могут встретиться сочетания согласных и гласных фон-эы. Система синтеза в последнем случае вводит фиктивные согласные и гласные, разбивая речевой поток не слоги,причем фиктивным звукам приписывается длительность, равная нулю. Для автоматического задания интонационных характеристик фраз в синтезируемой текстовой информации выделяются ранжированные единицы:
фраза, синтагма, фонетическое слово, слог. При автоматической обработке синтезируемого текста определяется число единиц ранга К в единице ранга K-I, номер логически выцеденной единицы ранга К, а также тип интонации.
Для моделирования алгоритмов синтеза использовалась универсальная мини-ЭВМ, обдацаищая быстродействием 200 тыс. операций в I с и оперативной памятью 16 кбайт. Объем программ нодедм синтеза речи составляет 1200 32-разрядных команд. В настоящее время принципы технической реализации артикуляционного синтезатора легли в основу разработки стандартного устройства речевого вывода с микропроцессорным управлением для ЕС ЭВМ [б] . Появились первые синтезаторы, основанные на параметрах линейного предсказания [55,78].
В нашей стране и за рубежом появляется также интерес к устройствам речевого вывода, основанным на компиляции речевого сигнала, соответствующего фразам, из более мелких отрезков речевой волны: слов, слогов, аллофонов ['44,96]. Подобные синтеза-Юры предназначены для информирования пользователей ограниченным количеством типов фраз, часто вполне достаточным. Большие же затраты памяти для хранения в цифровом виде элементов, из которых формируются фразы, не так страшны, потому что новые виды запоминающих устройств (например, на цилиндрических магнитных до-хенах) позволят хранить в малых объемах десятки мегабайт. В СССР работы по компиаятивному выводу ориентированы на использование в качестве основного элемента синтеза как слов, так и схо-^в. Предполагается, что такой синтезатор компилятивного типа ^УДет изготовлен серийно.
Зак.480
ГОВОРЯЩИЕ и понимающие речь машины строятся сейчас на основе ЭВМ, которые включают, как правило, микропроцессоры и другие большие интегральные схемы. А ЭВМ работают с числами, перерабатывают цифровую информацию. Лучше сказать так: все, что перерабатывает вычислительная машина, должно быть представлено в виде чисел. В понятие «все» входят, в частности, сигналы, получаемые с датчиков. Сюда относят сигналы, получаемые медиками (кардиограммы, энцефаллограммы), и различные технические шумы, например шумы двигателя, по которым ЭВМ может определить причину его неисправности, геофизические (шумы подземных недр и моря), биологические шумы (разговоры дельфинов, пение птиц, мяуканье кошек и лай собак, кваканье лягушек), различные двумерные сигналы (изображения). Сюда же относят и человеческую речь. В этом разделе рассмотрим, как речь (речевой сигнал) превращается в набор чисел и какие превращения с этими числами происходят до того, как «умная» машина произнесет нужную фразу или поймет с'!ысл высказывания.
Но мы должны помнить, что основные приборы и способы обработки сигналов, превращенных в набор чисел, можно использовать и для работы с любыми сигналами, поступающими с соответствующих датчиков информации, сигналами не обязательно речевой природы. Цифровые методы анализа открывают поистине безграничные возможности вычислительной техники. Ученые показали, что если у непрерывно изменяющегося во времени сигнала брать достаточно близко расположенные друг к другу цифровые отсчеты, то последовательность этих отсчетов будет почти полностью отражать все свойства этих сигналов. При обратном преобразовании этих цифр в речь она будет слышна без искажений. Это значит, что достаточно представить речевой сигнал в цифровом виде, в виде,
64
удобном для машинной обработки, и можно применять всю мощь программных средств ЭВМ для расшифровки смысла речевого сообщения в системах, понимающих речь. В говорящих же машинах используют обратное преобразование: «цифры — речевой сигнал». Полученную программно в виде последовательности чисел речь пропускают через специальные преобразователи «цифровая последовательность—электрическое напряжение» («цифра—аналог»). Далее речевой сигнал можно подавать на наушники или динамический громкоговоритель, преобразующие электрический сигнал в колебание мембраны, или рупоры (диффузора) динамика, которые колеблют воздух в соответствии с электрическим сигналом, поступающим на вход.
Напомним, что сам речевой сигнал изменяется во времени достаточно быстро. Это объясняется особенностями его образования — фильтрацией сигналов возбуждения импульсов воздушного давления, толчков воздуха, поступающих с голосовых связок при их колебании, т. е. через открытые голосовые связки из легких при выдохе через резонансную систему (артикуляторные органы — гортань. язык, полости рта и носа). Свойства же речеобразующего тракта из-за его инерционности меняются медленно. И в вычислительной машине в цифровой форме крайне желательно получать и хранить медленно меняющиеся параметры голосового тракта и источника — частоты основного тона, формантные частоты, определяющие характер самого речевого сигнала. Поэтому здесь рассмотрим и способы получения параметров речеобразующего тракта — формант и различных связанных с ними характеристик, которые иногда будем называть информативными параметрами. Изменение главного параметра голосового источника — частоты основного тона—относится к просодическим характеристикам речи, некоторые методы его получения уже были рассмотрены.
Если по информативным параметрам и их изменениям во времени (используя модели речеобразования) можно восстановить речевую волну или распознать ее смысл (на основе модели речевос-приятия), то, кроме как с параметрами, вроде бы ни с чем и работать не надо. Параметры эти очень удобны, слабо меняются во времени, поэтому их гораздо меньше, чем цифровых отсчетов са-'
5 Заказ № 901
65
мого сигнала. Значит, меньший объем памяти можно занять под высказывание, которое анализируется или генерируется. Значит, меньше времени потребует машинная обработка при распознавании. Значит, меньшими машинными ресурсами можно снабдить систему автоматического распознавания или синтеза речи и тем сильно снизить ее стоимость. Но как автоматически получить эти параметры (признаки, лежащие в основе машинных моделей распознавания и синтеза речи)? Ведь при построении понимающих речь машин, например, мы имеем на входе машины лишь речевой сигнал. Как от него перейти к параметрам? Только создав аппаратуру, которая их выделяет и позволяет вводить в ЭВМ в цифровой форме, или разработав алгоритмы и соответствующие программы, которые по оцифрованному речевому сигналу или по спектру позволяют получать эти параметры программным способом. В связи с этим вводить в ЭВМ информацию о речевом сигнале в цифровой форме можно тремя способами. Первый способ осуществляется с помощью универсального прибора-преобразователя «аналог—цифра», который дает возможность вводить в память ЭВМ отдельные отсчеты речевого сигнала в виде последовательности чисел.
Второй способ включает сложный преобразователь, позволяющий вводить в ЭВМ информацию о спектре сигнала за относительно короткие временные интервалы. Обычно такая информация вводится с гребенки аналоговых полосовых фильтров, каждый из которых пропускает лишь ограниченный диапазон частот. Вместе же фильтры гребенки перекрывают весь частотный диапазон речевого сигнала, прошедшего через технические устройства (микрофон и микрофонный усилитель). Использование устройств речевого ввода этого типа позволяет получать в памяти ЭВМ в цифровом виде картинку так называемой «видимой речи», динамическую спектрограмму, которая раньше создавалась с помощью спектроанали-заторов, сонографов-приборов, сыгравших большую роль в изучении речи и ее параметров лингвистами. В настоящее время информация о кратковременном спектре может быть получена с помощью специализированных БИС и СБИС цифровой обработки
66
сигналов, которые реализуют гребенку фильтров цифровыми методами.
И, наконец, третий способ — это устройства ввода в ЭВМ выделяемых аналоговым способом непосредственно из речевой волны главных параметров речеобразующего тракта, а также просодических параметров — формантных частот, усредненной мгновенной частоты, усредненной интенсивности сигнала, частоты основного тона и некоторых других признаков. Все эти параметры или их эквиваленты, вообще говоря, можно получить программно по оцифрованной речи аналого-цифровым преобразователем или по спектру сигнала. Устройства ввода третьего типа позволяют получать эти параметры аналоговым способом в процессе произнесения предложения.
В связи с широким распространением микропроцессоров и микроЭВМ, которые становятся основным инструментом анализа речи, и появлением микропроцессорных систем, обеспечивающих обработку оцифрованных речевых сигналов (введенных с универсальных аналого-цифровых преобразователей) с огромной скоростью, достигающей сотен миллионов операций в секунду, далее будут рассмотрены методы первичной цифровой обработки речи. Эти методы лежат в основе современных систем автоматического распознавания и синтеза речи и связаны с получением текущей автокорреляции сигнала, энергетического спектра, параметров линейного предсказания, гомоморфной обработки, а также клиппированной речи. Будет обращено внимание на использование специализированных устройств ввода в ЭВМ информации об информативных признаках речевого сигнала.
2.1. УСТРОЙСТВА ВВОДА РЕЧЕВОЙ ИНФОРМАЦИИ В ЭВМ
Аналого-цифровое преобразование. Преобразователь типа «аналог—цифра» — это устройство, дающее возможность вводить в ЭВМ дискретные отсчеты речевого Сигнала, представлять непрерывную речевую волну последовательностью чисел, сохраняя все основные свойства сигнала. Как правило, такой ввод применяется,
5*
67
когда не хотят пользоваться аналоговой аппаратурой выделения речевых параметров и когда анализ сигнала не обязательно осуществлять в реальном масштабе времени. Работа с оцифрованным речевым сигналом, вводимым непосредственно с аналого-цифрового преобразователя, обеспечивает более гибкую последующую обработку речи в ЭВМ программными методами.
Теорема отсчетов, связывающая дискретные отсчеты аналогового сигнала и сохранение частотных составляющих сигнала, была предложена еще в 1933 году В. А. Котельниковым: если сигнал x(t) не содержит частотных составляющих выше Fc Гц, то его можно полностью определить собственными значениями в моменты, отстающие друг от друга на 1/2 Fc секунд. Интуитивное подтверждение этой теоремы состоит в том, что если сигнал x(t) не содержит частот выше критической частоты Fc, то он не может существенно изменить свое значение за время, меньше половины периода наивысшей частоты. Согласно теореме отсчетов, таким образом, сигнал как функцию времени можно восстановить по значениям в точках отсчета х(кТ), если частота отсчета Ро==1/Г не меньше удвоенной критической частоты Fc. Предположение теоремы отсчетов о существовании критической частоты не является сильным ограничением, так как все физические устройства в принципе не допускают произвольно высоких частот, не пропуская их, обрезая. Во всех реальных технических приложениях всегда исходят из того, что существует некая Fc для любых аналоговых сигналов.
При вводе в ЭВМ дискретных отсчетов речевого сигнала пользуются, как правило, стандартными преобразователями «аналог— код». Действия аналого-цифровых преобразователей основаны на электрическом преобразовании дискретизированных аналоговых сигналов в соответствующую последовательность двоичных чисел. Это преобразование выполняется различными способами, включая линейную импульсно-кодовую модуляцию, дифференциальную им-пульсно-кодовую модуляцию, дельта-модуляцию, адаптивную дельта-модуляцию и другие методы, о чем можно прочесть в специальных книгах по аналого-цифровым преобразователям.
Наиболее распространенными в настоящее время аналого-циф-ровыми преобразователями являются преобразователи, использую
68
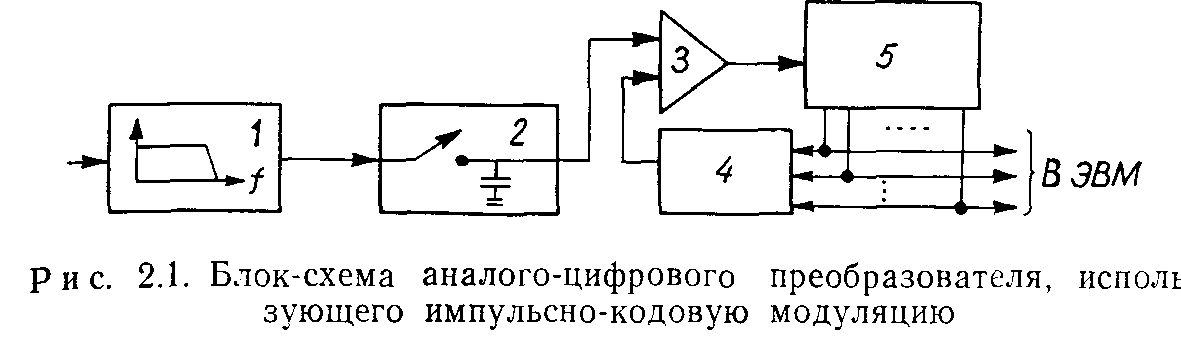
щие линейную импульсно-кодовую модуляцию. На входе системы (рис. 2.1) стоит фильтр нижних частот /, ослабляющий высокочастотные компоненты сигнала, лежащие выше критической частоты Fc. Аналого-цифровое преобразование сигнала включает два этапа. На первом этапе значение аналогового напряжения в момент измерения запоминается на некоем «аналоговом» запоминающем элементе, в качестве которого используется обычный электрический конденсатор. На втором этапе напряжение, «запоминаемое» на конденсаторе, измеряется с определенной точностью, и двоичный код числа, наиболее близкий напряжению на конденсаторе, передается в память ЭВМ.
Сигнал, пройдя через низкочастотный фильтр ./, в определенный момент запоминания сигнала поступает на электрический конденсатор 2. который быстро заряжается до величины напряжения, равного значению напряжения на выходе фильтра. Далее заряженный конденсатор отключается от питающей, входной цепи на время измерения «запоминаемого» на емкости напряжения и хранит его в течение всего времени измерения, не разряжаясь. Аналоговая схема 3 сравнивает напряжение сигнала, хранящееся на емкости, с калибровочным, «компенсирующим» напряжением. Это напряжение автоматически получается на выходе схемы 4, которая преобразует некий код, двоичное число на входе в аналоговое напряжение, являясь таким образом цифроаналоговым преобразователем.
В формировании двоичного кода на входе схемы 4 основную роль играет схема 5, которая называется регистром запоминания последовательных аппроксимаций. Попытаемся разобраться, что это
69
за схема. В вычислительной технике понятие «регистр» является одним из основных понятий. Регистр — это узел ЭВМ, состоящий из нескольких параллельно соединенных двоичных электронных запоминающих элементов — триггеров. Каждый из триггеров хранит только один разряд двоичного числа. Если регистр состоит из 10 триггеров, то можно сказать, что он может запоминать только десятиразрядное двоичное число. Различают старший разряд запоминающего регистра, где хранится старший разряд кода, соответствующего двоичному числу, и последующие младшие разряды. Вес каждого разряда в два раза меньше веса соседнего, стоящего слева разряда регистра.
Аналого-цифровой преобразователь устроен так, что на запоминающем регистре вначале (во время цикла измерения напряжения на емкости) старший разряд триггера устанавливается принудительно в единичное состояние. Это означает, что значение «компенсирующего» напряжения, вырабатываемого схемами 4 и 5, в два раза меньше, чем возможное напряжение на емкости.
Если напряжение на емкости выше, чем напряжение на выходе цифроаналогового преобразователя, то схема сравнения 3 вырабатывает такой сигнал, что в единичное состояние устанавливается соседний, стоящий рядом со старшим разряд регистра 5. А это уже означает, что на следующем шаге сравнения двоичного числа с напряжением на емкости / компенсирующее напряжение будет составлять 3/4 от максимально возможного напряжения на запоминающей емкости. Если же при первом сравнении напряжение на емкости ниже, чем компенсирующее напряжение, поступающее с выхода схемы 4, то старший разряд регистра 5 обнуляется, а соседний все равно устанавливается в единичное состояние, означающее, что на втором шаге сравнения компенсирующее напряжение будет составлять 1/4 от максимального значения, которое может запоминать емкость /. Такое сравнение продолжается до тех пор, пока не будут опрошены все разряды регистра 5, до самого младшего. Понятно поэтому, почему регистр 5 называется регистром последовательных аппроксимаций,—мы последовательно приближаемся ко все более точному измерению напряжения на емкости. После того, как произошла проверка самого младшего разряда, на
70
регистре хранится число, наиболее точно аппроксимирующее сигнал, хранящийся на емкости ./. Этот двоичный код и пересылается в ЭВМ, после чего переходим к измерению следующего отсчета сигнала, поступающего на емкость с выхода фильтра / в момент подключения его к запоминающему конденсатору 2. Такой способ ана-лого-цифрового преобразования называют поразрядным взвешиванием.
Отметим, что большие перспективы в использовании универсальных аналого-цифровых преобразователей открываются в связи с мультипроцессорной реализацией различных методов цифровой обработки сигналов — дискретного преобразования Фурье, линейного предсказания, цифровой фильтрации и др. Для исследовательских целей этот тип ввода речевых сигналов в ЭВМ наиболее применим и в настоящее время, так как он достаточно гибок и позволяет сохранять все частотные составляющие речевых сигналов. Применяют аналого-цифровые преобразователи и в тех случаях, когда необходимо использовать фильтры с такими характеристиками, которые трудно реализовать на реальных физических элементах, а также в случаях, когда требуется частое изменение параметров фильтра, используемого при анализе сигнала, или подбор характеристик фильтра и когда реальный масштаб времени анализа не обязателен. Кроме того, ввод с аналого-цифрового преобразователя может оказаться целесообразным (и единственно возможным), когда ставится задача поиска информативных речевых параметров (не обязательно чисто спектральных) на значительном статистическом материале, собираемом в архиве речевых произнесений в цифровой форме.
Ввод сигнала с гребенки аналоговых фильтров. Второй тип ввода речевых сигналов в ЭВМ — это ввод сигналов с гребенки аналоговых полосовых фильтров, перекрывающих частотный диапазон речи, прошедшей через технические устройства (микрофон—микрофонный усилитель— (возможно) канал передачи). Информация с гребенки фильтров о медленно меняющихся огибающих сигнала с каждого фильтра поступает на электронный коммутатор (переключатель), который обеспечивает последовательное подключение напряжения с выхода каждого фильтра к аналого-цифровому преобра-
71
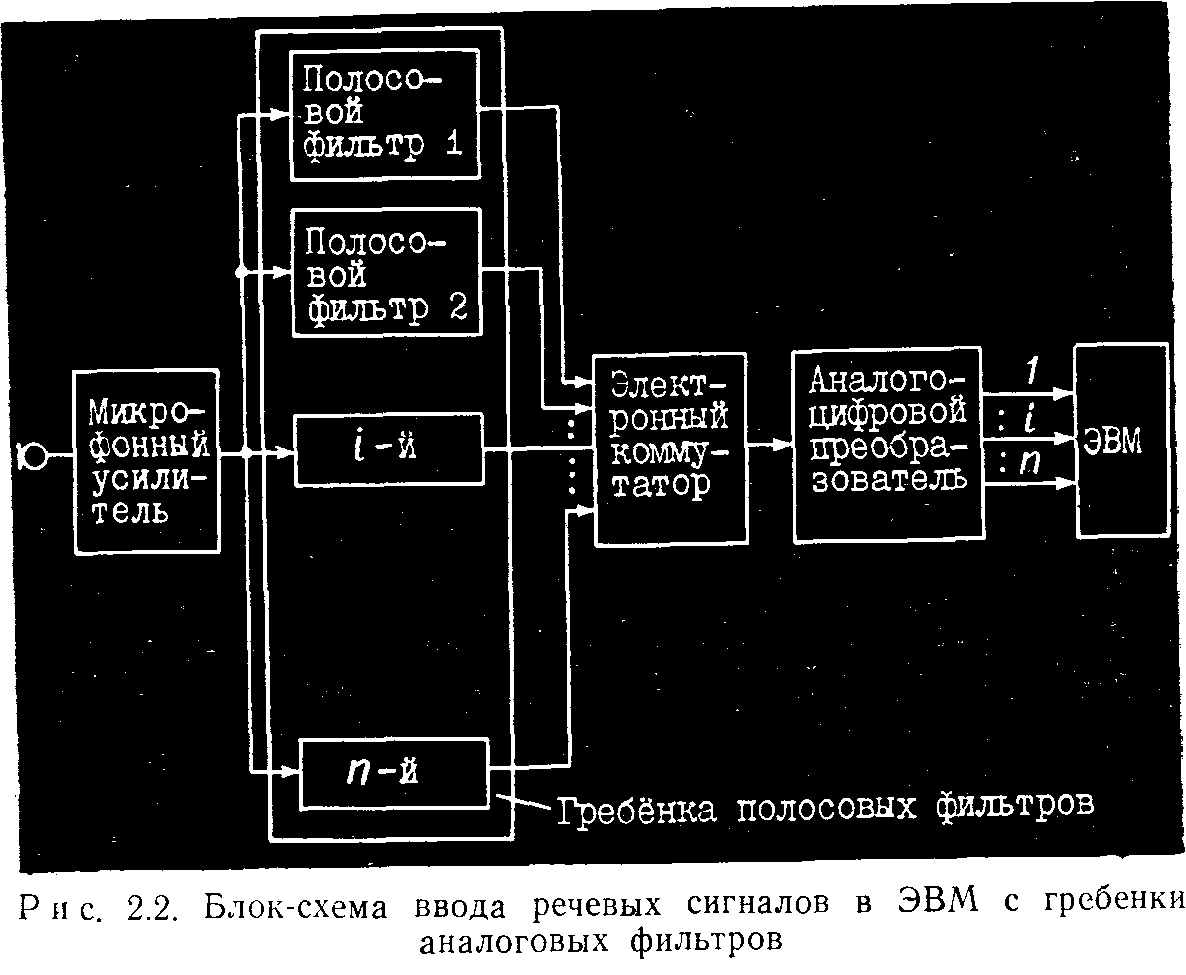
зователю. Коды с аналого-цифрового преобразователя (информация на выходе гребенки) с более низкой, чем при первом типе скоростью ввода, определяемой частотой опроса гребенки (частотой квантования), поступают в ЭВМ (рис. 2.2).
Достоинство этого способа заключается в том, что в памяти ЭВМ после ввода сигнала находится уже непосредственно динамическая спектрограмма речевого сигнала (картина «видимой речи»), и нет необходимости тратить машинное время на цифровое моделирование фильтров. Современные практические системы автоматического распознавания речи широко используют этот способ ввода информации о речевом сигнале, позволяющий автоматически анализировать полученные аналоговым способом медленно меняющиеся параметры тракта речеобразования.
72
. Этот тип устройств ввода речи обладает рядом недостатков. Что во-первых, то, что в них трудно изменить характеристики (Ьильтров (их средние частоты и полосы пропускания)—если они однажды вычислены и реализованы «в железе», то перейти к (Ьильтрам с другими характеристиками весьма непросто. Во-вторых, с гребёнки полосовых фильтров поступает много избыточной информации, что не только чрезмерно загружает память ЭВМ, но и приводит к тому, что программы надежного выделения основных параметров речеобразующего тракта, а также просодических параметров .достаточно сложны. Иногда формантные параметры мгновенную частоту основного тона, среднюю интенсивность (громкость) относят к наиболее информативным параметрам в отличие от параметров, представляющих просто энергию в полосах частот общего спектра сигнала. Гребёнка фильтров дает слишком много информации, так как энергия в полосах частот характеризует не только звуки речи, но и индивидуальные особенности речеобразующего тракта, эмоциональное состояние человека и т. д.
В связи с этим гребёнку фильтров используют, как правило, в дикторозависимых системах автоматического распознавания речи, работающих с предварительной настройкой на голос диктора и набор слов—рабочий словарь. Иногда такие системы называют адаптивными. В системах, работающих без предварительной настройки на голос конкретного диктора, которые иногда называют неадаптивными, используют гребенку для получения параметров следующего уровня распознавания речи, более независимых от дикторского произношения. Однако для систем автоматической диагностики заболеваний органов речеобразования, распознавания эмоционального состояния диктора и его индивидуальности использование гребёнки полосовых фильтров как первичного анализатора оказывается весьма эффективным. Для неадаптивных же систем автоматического' распознавания смысла сообщения, работающих от голоса произвольного диктора, полосовые фильтры, как правило, являются вспомогательными средствами первичного анализа.
Еще раз отметим, что алгоритмы автоматического распознавания смысла произнесенного только по картине видимой речи оказываются достаточно сложными. К тому же использование только
73.
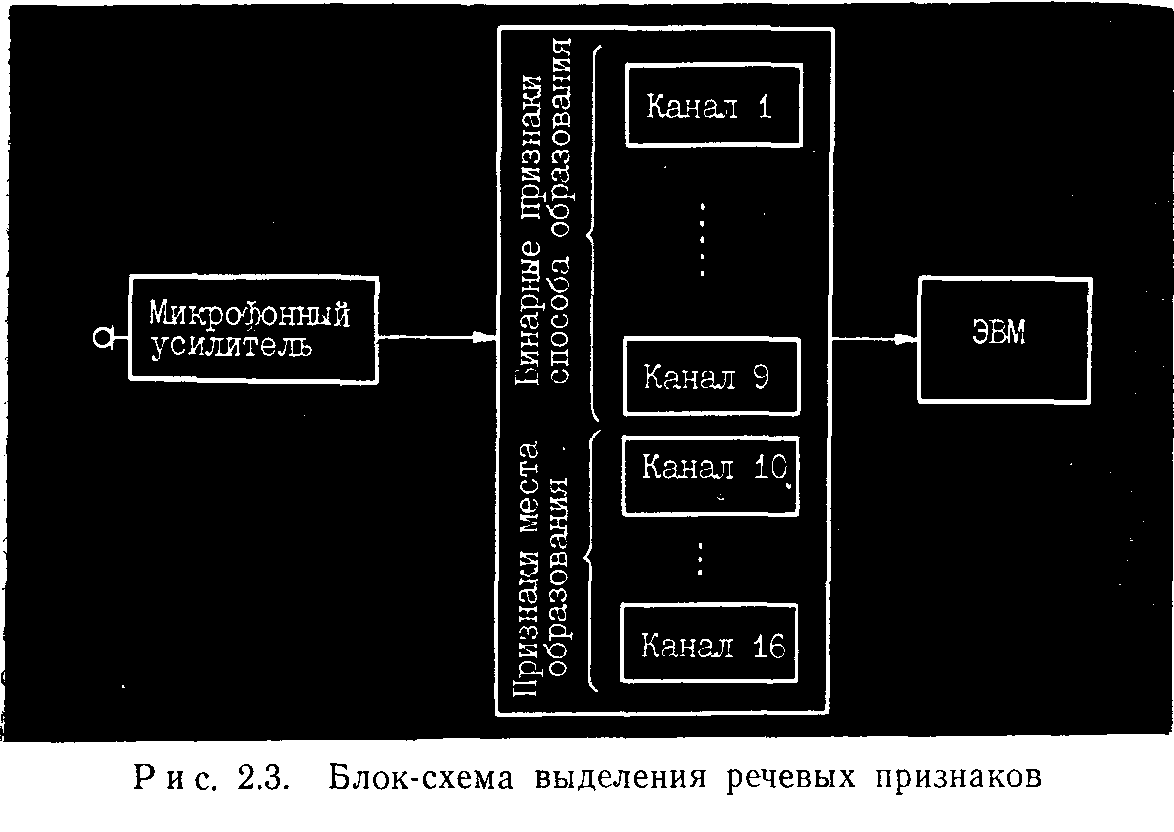
гребенки фильтров не позволяет эффективно анализировать такие звуки речи, как глухие взрывные, длительность которых сравнима <: временем нарастания энергии на фильтре.
Ввод в ЭВМ информативных речевых параметров. Следствием развития системы ввода