Регресійний аналіз інтервальних даних
Тоді
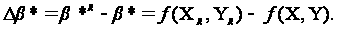
Введемо поняття нотни.
Означення:
Величину
максимально
можливого (по
абсолютній
величині) відхилення,
викликаного
похибками
спостережень
 ,
відомого статистику
значення f(y)
від істинного
значення f(x),
тобто
Nf(x) = sup | f(y) - f(x) |,
де супремум
береться по
безлічі можливих
значень вектора
похибки
,
будемо називати
нотною.
Якщо функція f має частинні похідні другого порядку, а обмеження на похибку мають вигляд
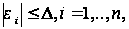 (3.1.4)
причому
 мало, то збільшення
функції f з
точністю до
нескінченно
малих більш
високого порядку
описується
головним лінійним
членом, тобто
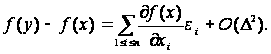
Щоб одержати
асимптотичний
(при
 )
вираз для нотни,
досить знайти
максимум і
мінімум лінійної
функції (головного
лінійного
члена) на кубі,
заданому нерівностями
(4.1.4). Легко бачити,
що максимум
досягається,
якщо покласти
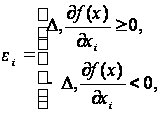
а мінімум,
що відрізняється
від максимуму
тільки знаком,
досягається
при
 .
Отже, нотна з
точністю до
нескінченно
малих більше
високого
порядку має вигляд
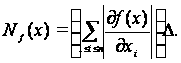 (3.1.5)
Цей вираз назвемо асимптотичною нотною.
Покладемо:
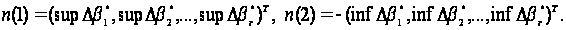
Будемо називати n(1) нижньою нотною, а n(2) верхньою нотною.
Припустимо, що при безмежному зростанні числа вимірів n, тобто при
 вектора n(1),
n(2) прямують до
постійних
значень
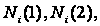 відповідно.
Тоді
 будемо називати
нижньою асимптотичною
нотною, а
 -
верхньою
асимптотичною
нотною.
Розглянемо
довірчу множину
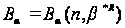 для вектора
параметрів
 ,
тобто замкнута
зв'язна множина
точок в r-мірному
евклідовому
просторі така,
що
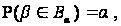 де α
- довірча ймовірність,
що відповідає
Bα (α
≈ 1). Інакше
кажучи,
є область розсіювання
випадкового
вектора
 з довірчою
ймовірністю
α і
числом досвідів
n.
З визначення верхньої й нижньої нотни треба, щоб завжди
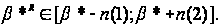
Відповідно
до визначення
нижньої асимптотичної
нотни й верхньої
асимптотичної
нотни можна
вважати, що
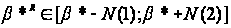 при досить
великій кількості
спостережень
n. Цей багатомірний
інтервал описує
r-мірний гіперпаралелепіпед
P.
Розіб'ємо
P на L гіперпаралелепіпедів.
Нехай
 - внутрішня
точка k-го
гіперпаралелепіпеда.
З огляду на
властивості
довірчої множини
і спрямовуючи
L до нескінченності,
можна стверджувати,
що
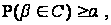
де
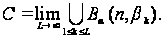
Таким
чином, безліч
C характеризує
невизначеність
при оцінюванні
вектора
.
Його можна
назвати довірчою
множиною в
статистиці
інтервальних
даних.
Введемо
деяку міру
М(X), що характеризує
"величину"
множини
 .
По визначенню
міри вона задовольняє
умові: якщо
 і
 то
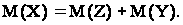
Прикладом такої міри є площа для r = 2 і об’єма для r = 3. Тоді:
М(C) = М(P) + М(F), (3.1.6)
де F = C P. Тут М(F) характеризує міру статистичної невизначеності, у більшості випадків вона спадає при збільшенні числа досвідів n. У той же час М(P) характеризує міру інтервальної невизначеності, і, як правило, М(P) прагне до деякої постійної величини при збільшенні числа досвідів n. Нехай тепер потрібно знайти те число досвідів, при якому статистична невизначеність становить δ-ю частина загальної невизначеності, тобто
М(F) = δ М(C), (4.1.7)
де δ < 1. Тоді, підставивши співвідношення (4.1.7) у рівність (4.1. 6) і вирішивши рівняння відносно n, одержимо шукане число досвідів. В асимптотичній математичній статистиці інтервальних даних воно називається "раціональним обсягом вибірки".
3.2 Метод найменших квадратів для лінійної моделі
Розглянемо найбільш важливий для практики окремий випадок МНК, коли модель є лінійною.
Для простоти опису перетворень пронормуємо змінні хij,уi. Наступним чином:
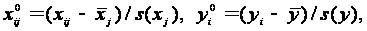
де
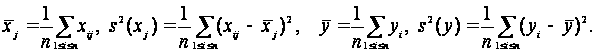
Тоді
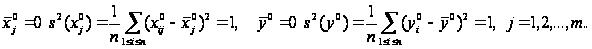
Надалі будемо вважати, що розглянуті змінні пронормовані описаним образом, і верхні індекси опустимо. Для полегшення демонстрації основних ідей приймемо досить природні припущення.
1. Для розглянутих змінних існують наступні межі:
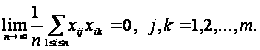
2. Кількість
досвідів n таке,
що можна користуватися
асимптотичними
результатами,
отриманими
при

3. Погрішності виміру задовольняють одному з наступних типів обмежень:
Тип 1. Абсолютні погрішності виміру обмежені згідно (4.1.3):
Тип 2. Відносні погрішності виміру обмежені:
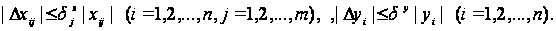
Тип 3. Обмеження накладені на суму погрішностей:
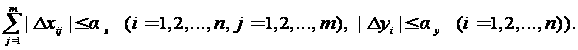
Перейдемо до обчислення нотни оцінки МНК. Справедлива рівність:
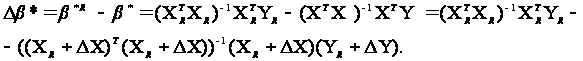
Скористаємося наступною теоремою з теорії матриць.
Теорема. Якщо функція f(λ) розкладається в степеневий ряд у колі збіжності |λ – λ0| < r, тобто
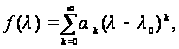
то це розкладання зберігає силу, якщо скалярний аргумент замінити будь-якою матрицею А, характеристичні числа якої λk, k = 1,…,n, лежать всередині кола збіжності.
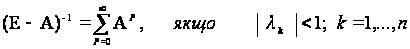
Легко переконатися, що:
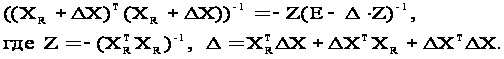
Це випливає з послідовності рівностей:
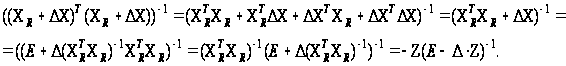
Застосуємо наведену вище теорему з теорії матриць, припускаючи
А = Δ Z і приймаючи, що власні числа цієї матриці задовольняють нерівності |λk|<1. Тоді одержимо:
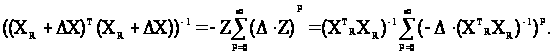
Підставивши останнє співвідношення на закінчення згаданої теореми, одержимо:
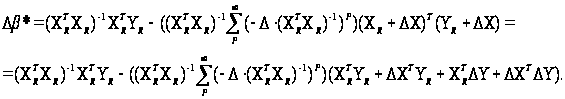
Для подальшого аналізу знадобиться допоміжне твердження. Виходячи із припущень 1-3, доведемо, що:
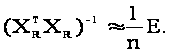
Доведення. Справедлива рівність
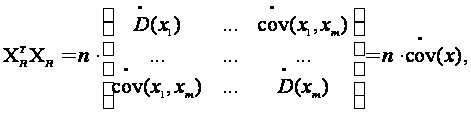
де
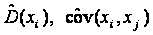 - спроможні і
незміщені
оцінки дисперсій
і коефіцієнтів
коваріації,
тобто
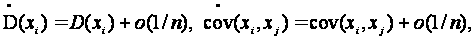
тоді
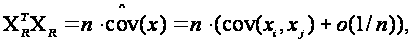
де
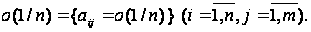
Інакше кажучи, кожен елемент матриці, позначеної як о(1/n), є нескінченно малою величиною порядку 1/n. Для розглянутого випадку cov(x) = E, тому
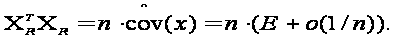
Припустимо, що n досить велике і можна вважати, що власні числа матриці о(1/n) менше одиниці по модулю, тоді
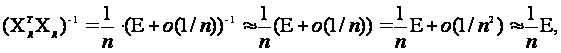
що і було потрібно довести.
Підставимо
доведене асимптотичне
співвідношення
у формулу для
приросту*,одержимо
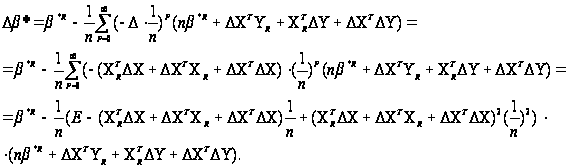
Виразимо
Δ*
відносно приросту
ΔХ, ΔY
до 2-гo порядку
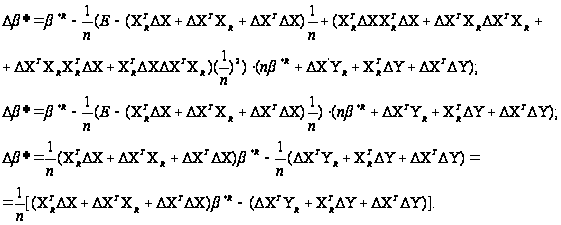
Перейдемо від матричної до скалярної форми, опускаючи індекс (R):
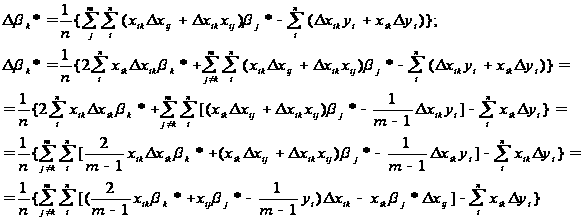
Будемо
шукати max(|Δk*|)
по Δxij
і Δyi
(i=1,…, п;j=1,…, m). Для
цього розглянемо
всі три раніше
введених типи
обмежень на
похибки виміру.
Тип 1 (абсолютні похибки виміру обмежені). Тоді:
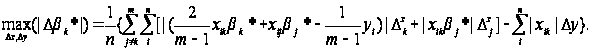
Тип 2 (відносні похибки виміру обмежені). Аналогічно одержимо:
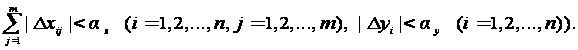
Тип З
(обмеження
накладені на
суму похибок).
Припустимо,
що |Δk*|
досягає максимального
значення при
таких значеннях
погрішностей
Δxij
і Δyi,
які ми позначимо як:
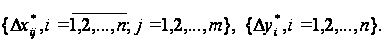
тоді:
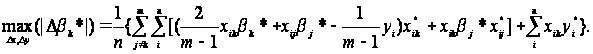
Через лінійність останнього вираження і виконання обмеження типу 3:
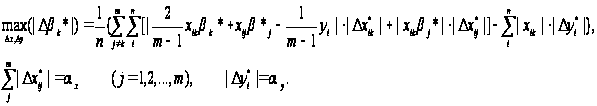
Для спрощення запису зробимо наступні заміни:
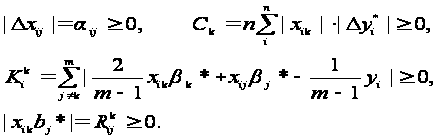
Тепер для досягнення поставленої мети можна сформулювати наступне завдання, що розділяється на m типових завдань оптимізації:
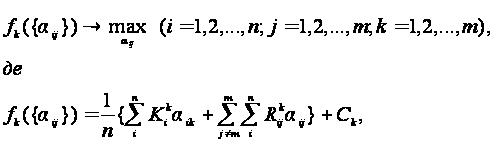
при обмеженнях
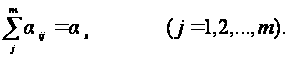
Перепишемо функції, що мінімізуємо, в наступному вигляді:
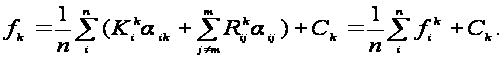
Очевидно, що fik > 0.
Легко бачити, що
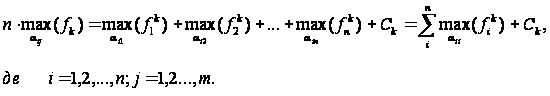
Отже, необхідно вирішити nm завдань
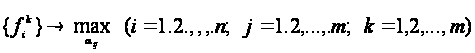
при обмеженнях "типу рівності":
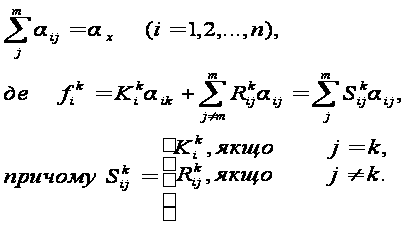
Сформульоване завдання пошуку екстремуму функції. Воно легко вирішується. Оскільки
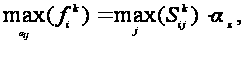
то максимальне відхилення МНК - оцінки k-ого параметра дорівнює
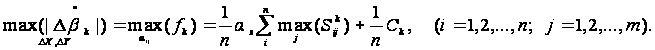
3.3 Парна регресія
Найбільш простий і одночасно найбільше широко застосовуваний окремий випадок парної регресії розглянемо докладніше. Модель має вигляд
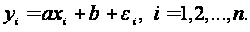 (3.3.1)
Тут xi
- значення фактора
(незалежної
змінної),
 - значення відгуку
(залежної змінної),
 - статистичні
похибки,
- невідомі параметри,
оцінювані
методом найменших
квадратів.
Модель (3.3.1) може
бути записана
у вигляді:
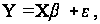 (3.3.2)
якщо покласти
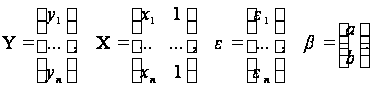
Природно прийняти, що похибки факторів описуються матрицею
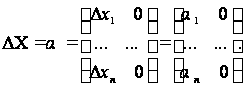
У розглянутій моделі інтервального методу найменших квадратів
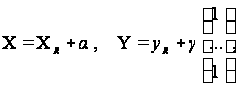
де X,
 -
спостережувані
значення фактора
і відгуку, XR,
yR - істині значення
змінних,
 - погрішності
вимірів змінних.
Нехай
 -
оцінка методу
найменших
квадратів,
обчислена за
спостережуваним
значенням
змінних,
 - аналогічна
оцінка, знайдена
за істинним
значенням.
Відповідно
до раніше проведених
міркувань
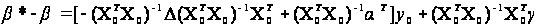 (3.3.3)
з точністю
до нескінченно
малих більш
високого порядку
по
 і
 .
У формулі (3.3.3)
використане
позначення
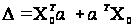 .
Обчислимо праву
частину в (3.3.3),
виділимо головний
лінійний член
і знайдемо
нотну.
Легко бачити, що
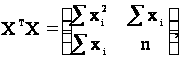 (3.3.4)
де підсумовування проводиться від 1 до n. Для спрощення позначень надалі і до кінця дійсного пункту не будемо вказувати ці межі підсумовування. З (3.3.4) випливає, що
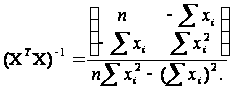 (3.3.5)
Легко підрахувати, що
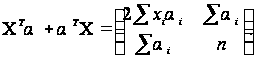 (3.3.6)
Покладемо
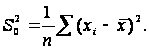
Тоді
знаменник в
(3.3.5) дорівнює
 .
З (3.3.5) і (3.3.6) випливає,
що
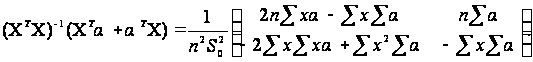 (3.3.7)
Тут і далі опустимо індекс і, по якому проводиться підсумовування. З (3.3.5) і (3.3.7) випливає:
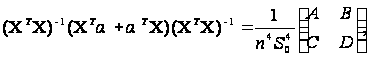 (3.3.8)
де
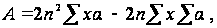
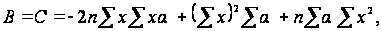
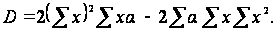
Обчислимо основний множник в (3.3.3)
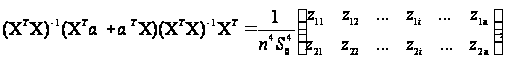 (3.3.9)
де
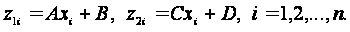
Перейдемо
до обчислення
другого члена
з
 в (3.3.3). Маємо
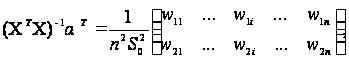 (3.3.10)
де
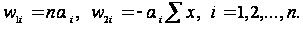
Складаючи
праві частини
(3.3.9) і (3.3.10) і помножуючи
на у, одержимо
остаточний
вид члена з
 в (3.3.3):
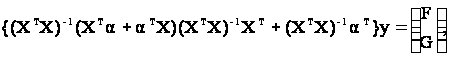 (3.3.11)
де
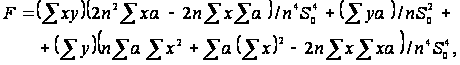
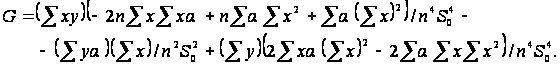
Для обчислення нотни виділимо головний лінійний член. Спочатку знайдемо частинні похідні. Маємо
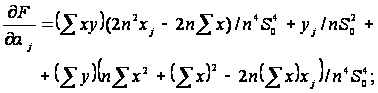 (3.3.12)
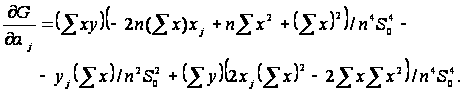
Якщо обмеження мають вигляд
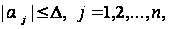
то максимально
можливе відхилення
оцінки а* параметра
а через погрішності
 таке:
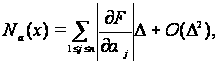 (3.3.13)
де похідні задані формулою (3.3.12).
Розділ IV. Програмний продукт «Інтервальне значення параметрів»
4.1 Текст програми
restart:with(LinearAlgebra):
Klassic ocenki_parametrov:
> ocenki_parametrov:=proc(viborka,nomer_zavis_koord)
local kol_strok,kol_stolbcov,matrica_X,vektor_Y_1,vektor_Y,
X_transpon,otvet_prom,otvet;
kol_strok:=RowDimension(viborka):
kol_stolbcov:=ColumnDimension(viborka):
matrica_X:=DeleteColumn(viborka,nomer_zavis_koord..nomer_zavis_koord):
vektor_Y_1:=DeleteColumn(viborka,1..nomer_zavis_koord-1):
vektor_Y:=DeleteColumn(vektor_Y_1,2..kol_stolbcov-nomer_zavis_koord+1):
X_transpon:=Transpose(matrica_X):
otvet_prom:=MatrixInverse(MatrixMatrixMultiply(X_transpon,matrica_X)):
otvet:=MatrixMatrixMultiply(MatrixMatrixMultiply(otvet_prom,X_transpon),vektor_Y):
end proc:
Notna ocenki_parametrov:
> notna_ocenki_parametrov:=proc(viborka,nomer_zavis_koord,pogr)
local kol_strok, kol_stolbcov, matrica_X,vektor_Y_1, vektor_Y,
n,m,j,k,c,i,pogr_Y,pogr_X,vector_beta,pod_sum_vnutr,summa_vnutr,sum_vnesh,pod_summa_2,summa_2,summa;
global otv:
kol_strok:=RowDimension(viborka):
kol_stolbcov:=ColumnDimension(viborka):
matrica_X:=DeleteColumn(viborka,nomer_zavis_koord..nomer_zavis_koord):
vektor_Y_1:=DeleteColumn(viborka,1..nomer_zavis_koord-1):
vektor_Y:=DeleteColumn(vektor_Y_1,2..kol_stolbcov-nomer_zavis_koord+1):
m:=kol_stolbcov-1:
n:=kol_strok:
pod_sum_vnutr:=array(1..n):
summa_vnutr:=array(1..m):
sum_vnesh:=array(1..m):
pod_summa_2:=array(1..n):
summa_2:=array(1..m):
summa:=array(1..m):
pogr_Y:=pogr[nomer_zavis_koord]:
pogr_X:=array(1..m):
for i to m do
if i<nomer_zavis_koord then
pogr_X[i]:=pogr[i]:
else pogr_X[i]:=pogr[i+1]:
end if:
end do:
vector_beta:=ocenki_parametrov(viborka,nomer_zavis_koord):
for k to m do
for j to m do
for i to n do
pod_sum_vnutr[i]:=abs(2*matrica_X[i,k]*vector_beta[k,1]/(m-1) +matrica_X[i,j]*vector_beta[j,1]-
vektor_Y[i,1]/(m-1))*pogr_X[k] +abs(matrica_X[i,k]*vector_beta[j,1])*pogr_X[j]:
end do:
summa_vnutr[j]:=sum('pod_sum_vnutr[ii]','ii'=1..n):
end do:
sum_vnesh[k]:=sum('summa_vnutr[jj]','jj'=1..k-1)+sum('summa_vnutr[jj]','jj'=k+1..m):
for c to n do
pod_summa_2[c]:=abs(matrica_X[c,k]):
end do:
summa_2[k]:=sum('pod_summa_2[d]','d'=1..n)*pogr_Y:
summa[k]:=(sum_vnesh[k]+summa_2[k])/n:
end do:
otv:=summa:
end proc:
Final
> interval_znachen_param:=proc(viborka,nomer_zavis_koord,pogr)
Local razmer,massiv_interv_koeff,parametric,notna,i:
global interv:
razmer:=ColumnDimension(viborka)-1:
massiv_interv_koeff:=array(1..razmer):
interv:=Matrix(1..razmer,1..2):
parametri:=ocenki_parametrov(viborka,nomer_zavis_koord,pogr):
notna:=notna_ocenki_parametrov(viborka,nomer_zavis_koord,pogr):
for i to razmer do
massiv_interv_koeff[i]:=parametri[i,1]:
interv[i,1]:=massiv_interv_koeff[i]-notna[i]:
interv[i,2]:=massiv_interv_koeff[i]+notna[i]:
end do:
interv:
end proc:
> generator_viborki:=proc(DIGITS,obem_vibork,distrib,parametr)
global VIBORK:
local i:
Digits:=DIGITS:
VIBORK:=array(1..obem_vibork):
if distrib=NORMAL then
for i to obem_vibork do
VIBORK[i]:=stats[random, normald[0,parametr]](1):
end do:
VIBORK:
end if:
end proc:
> real_viborka:=proc(DIGITS,kol_razb,distrib,parametr,model)
global mass_Y,mass_X1,mass_X2:
local oshibki,nom,i,j:
mass_Y:=array(1..(kol_razb+1)^2):
mass_X1:=array(1..(kol_razb+1)^2):
mass_X2:=array(1..(kol_razb+1)^2):
oshibki:=generator_viborki(DIGITS,(kol_razb+1)^2,distrib,parametr):
nom:=0:
for i from 0 to kol_razb do
for j from 0 to kol_razb do
nom:=nom+1:
mass_Y[nom]:=eval(model,{x1=i/kol_razb,x2=j/kol_razb})+oshibki[nom]:
mass_X1[nom]:=evalf(i/kol_razb):
mass_X2[nom]:=evalf(j/kol_razb):
end do:
end do:
mass_Y:
end proc:
> okrug_real_viborka:=proc(DIGITS,digits_okrug,kol_razb,distrib,
parametr,model)
global VIB:
local okrug_mass_Y,okrug_mass_X1,okrug_mass_X2:
Digits:=digits_okrug:
okrug_mass_Y:=array(1..(kol_razb+1)^2):
okrug_mass_X1:=array(1..(kol_razb+1)^2):
okrug_mass_X2:=array(1..(kol_razb+1)^2):
VIB:=Matrix(1..(kol_razb+1)^2,1..3):
okrug_mass_Y:=real_viborka(DIGITS,kol_razb,distrib,parametr,model):
okrug_mass_X1:=mass_X1:
okrug_mass_X2:=mass_X2:
for i to (kol_razb+1)^2 do
VIB[i,1]:=okrug_mass_Y[i]:
VIB[i,2]:=okrug_mass_X1[i]:
VIB[i,3]:=okrug_mass_X2[i]:
end do:
VIB:
end proc:
> with(plots):
grafic_ocenok:=proc(DIGITS,digits_okrug,kol_razb,distrib,parametr,model,pogr,perek)
global ViBVreM,INTERVAL:
local gg1n,gg1v,s, gg2n,gg2v,ggg1n,g1, ggg2n,g2,g21,
ggg2v,g22,ggg1v:
gg1n:=array(2..kol_razb):
gg1v:=array(2..kol_razb):
for s from 2 to kol_razb do
ViBVreM:=okrug_real_viborka(DIGITS,digits_okrug,s,distrib,parametr,model):
INTERVAL:=interval_znachen_param(ViBVreM,1,pogr):
gg1n[s]:=INTERVAL[1,1]:
gg1v[s]:=INTERVAL[1,2]:
gg2n[s]:=INTERVAL[2,1]:
gg2v[s]:=INTERVAL[2,2]:
end do:
ggg1n:=[seq([b,gg1n[b]],b=2..kol_razb)]:
g1:=plot(ggg1n,'colour'='blue',legend="Нижня межа");
ggg1v:=[seq([b,gg1v[b]],b=2..kol_razb)]:
g2:=plot(ggg1v,'colour'='green',legend="Верхня межа");
ggg2n:=[seq([b,gg2n[b]],b=2..kol_razb)]:
g21:=plot(ggg2n,'colour'='blue',legend="Нижня межа");
ggg2v:=[seq([b,gg2v[b]],b=2..kol_razb)]:
g22:=plot(ggg2v,'colour'='green',legend="Верхня межа");
if perek =1 then
gt:=plot(2,t=0..kol_razb,'colour'='red',legend="Істинне значення"):
display([g1,g2,gt],'title'="Обчислення першого коефіціента регресіі",'titlefont'=[TIMES,BOLD,18]):
else
gt:=plot(-4,t=0..kol_razb,'colour'='red',legend="Істинне значення"):
display([g21,g22,gt],'title'="Обчислення другого коефіціента регресіі",'titlefont'=[TIMES,BOLD,18]):
end if:
end proc:
4.2 Опис програми
Основним результатом дипломної роботи є програмний продукт. В роботі представлена програма під назвою «Інтервальне значення параметрів», яка реалізує знаходження інтервалів для коефіцієнтів регресії. Під час роботи ця програма використовує допоміжні процедури, які обчислюють класичну оцінку коефіцієнтів регресії та нотну. Програма написана в прикладному математичному пакеті Maple, який являється одним з самих потужних інтелектуальних систем комп`ютерної алгебри. Результати програми представлені на графіках.
Програма складається з чотирьох процедур та реалізації графічного інтерфейсу.
Спочатку відбувається підключення необхідних модулів:
restart;
with(LinearAlgebra):
with(plots):
with(stats):
Надалі розглянемо процедури, які були використані в даній програмі.
Розглянемо процедуру під назвою ocenki_parametrov. Ця процедура отримує вхідні дані, які вводить користувач та знаходить оцінки коефіцієнтів лінійної регресії за допомогою методу найменших квадратів (МНК). В ній оголошені такі змінні: viborka– це вибірка з якою ми будемо працювати, вона вводиться з клавіатури користувачем; nomer_zavis_koord –вектор Y.
В процедурі задані локальні змінні, які використовуються у якомусь невеликому відрізку програми, це може бути невеликий цикл тощо.
В якості
локальних
змінних оголошенні
kol_strok- кількість
строк матриці
matrica_X що вводиться
з клавіатури
користувачем,
kol_stolbcov- кількість
стовпчиків
даної матриці,
X_transpon- транспонована
матриця до
матриці Х, vektor_Y-
вектор спостережень,
otvet- вектор-стовпчик
оцінок коефіцієнтів,
що знаходяться
за формулою
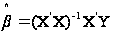 .
otvet:=MatrixMatrixMultiply(MatrixMatrixMultiply(otvet_prom,X_transpon),vektor_Y):.
Розглянемо процедуру під назвою Notna ocenki_parametrov. Ця процедура отримує вхідні дані, які вводить користувач та знаходить нотну. В ній оголошені такі змінні: viborka– це вибірка з якою ми будемо працювати, вона вводиться з клавіатури користувачем; nomer_zavis_koord –вектор Y, pogr – це похибка, її користувач визначає самостійно і