Статистичний аналіз тенденцій захворюваності в Україні
Далі
позначимо
 =
Х
 .
Елементи вектора
e
= Y –
= Y – Х
= (In
- Х(Х'Х)-1Х')Y
= (In
- Р)Y
(1.1.7)
називаються залишками (ми позначили тут скорочено Х(Х'Х)-1Х' через Р). Мінімальне значення ε'ε називається залишковою сумою квадратів (RSS)).
RSS
= (Y - Х)'(Y
- Х)=
Y'Y
- 2Х'
Y +
'Х'Х
=
= Y’Y
-
'Х'
Y +
'[Х'Х
- Х'Y] =
= Y'Y
-'Х'Y
(1.1.8)
Або
RSS
= Y'Y
-
'Х'Х
(1.1.9)
Відмітимо,
що
і е єдині.
Оскільки
 = Х
= Х(Х'Х)-1Х'Y
= РY, то
Р є матрицею
лінійного
перетворення,
яке є ортогональним
проектуванням
n-мірного
евклідова
простору Еn
на Ω.
Аналогічно
In
- Р є матрицею
ортогонального
проектування
Еn
на
 - ортогональне
доповнення
до Ω
в Еn.
Тому вираз Y
= РY + (In
- Р)Y є
єдиним ортогональним
розкладом
вектора Y
на дві складові,
одна з яких
лежить в Ω,
а інша
- в
.
Деякі основні
властивості
матриць Р і (In
- Р) наведено в
теоремі 1.1.1. Спочатку
сформулюємо
деякі означення.
Означення. Слідом trX матриці Х називають суму її діагональних елементів
trX = 1 + x21 + x32 + … + xnp-1
Означення. Матриця Р називається ідемпотентною, якщо Р2 = Р. Симетрична ідемпотентна матриця називається проекційною. Якщо Р – проекційна матриця, то trР = rankР.
Теорема 1.1.1.
(I) Матриці Р і In - Р симетричні та ідемпотентнi.
(II) rank[In - Р] = tr[In - Р] = n - р.
(III) (In - Р)Х = 0.
Доведення.
(I) Р' = (X(X'X)-1X')' = X((X'X)-1)'X' = X(X'X)-1X' = P
Отже, матриця Р є симетричною і (In - Р)' = In - Р' = In - Р. Крім того,
Р2 = X(Х'Х)-1Х'Х(Х'Х) -1X' = XIp (Х'Х)-1X' = Р,
і (In – Р)2 = In - 2Р + P2 = In – Р.
(II) Оскільки матриця In - Р симетрична та ідемпотентна, то вона проекційна і tr(In – Р) = rank(In – Р). Тоді
rank[In - Р] = tr[In - Р] = n - trР,
де
trР = tr[X (Х'Х)-1X'] = tr[Х'Х (Х'Х)-1] = trIp = р.
(In - Р)Х = Х - Х(Х'Х)-1Х'Х = Х - Х = 0.
Теорема доведена.
Теорема 1.1.2.
Нехай Р = X(Х'Х)-1X', тоді R(P) = R(X), тобто простір, породжений стовпцями матриці P є простором, породженим стовпцями матриці Х.
Доведення.
R(P) = {z: z = Pα} для деякого α, R(X) = {Y: Y = Xγ} для деякого γ.
Вибираємо
z R(P),
тоді z
= Pα.
Отже,
z = Pα = X(X'X)-1X'α = Xβ,
отже
zR(X).
Вибираємо
YR(X),
тоді Y
= Xγ
Y = Xγ = X(X'X)-1X'Xγ = X(X'X)-1X'Xγ = PY,
отже
YR(P).
Теорема доведена.
Теорема 1.1.3.
 (Y
-
 )
= 0 або
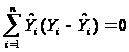
Доведення.
(Y
-
)
= {
= X = X(X'X)-1X'Y
= PY} = (PY)'(Y
– PY) =
Y'P'(1
– P)Y
= = Y'P(1
– P)Y
= Y'(P
– P2)Y
= Y'(P
– P)Y
= 0.
Теорема доведена.
Якщо
припустити,
що помилки ε
такі, що
 ,
то
M[]
= (X’X)-1X’M[Y]
= (X’X)-1X’X
β
= β
(1.1.9)
тобто
є незміщеною
оцінкою вектора
β.
Якщо, окрім
того, припустити,
що всi
εi,
і = 1, …, n
- некорельовані
і мають однакову
дисперсію,
тобто
соv[εi,
εj]
=
 ,
то D[ε] = σ2In,
D[Y] = D[Y - Xβ] = D[ε], отже D[Y] = σ2In.
Звідси одержуємо
D[]
= D[(Х'Х)-1Х'Y]
= сov((Х'Х)-1X'Y,
(Х'Х)-1X'Y)
=
= (X'X)-1X'cov(Y,Y)((X'X)-1X')' = (X'X)-1X'DYX(X'X)-1 =
= (X'X)-1X'σ2IX(X'X)-1 = σ2(X'X)-1(X'X) (X'X)-1 = σ2(X'X)-1 (1.1.10)
Виникає
таке питання:
чому за оцінку
вектора β
ми вибираємо
саме
(оцінку найменших
квадратів), а
не будь – яку
іншу оцінку?
Далі покажемо,
що в деякому
розумному класі
оцінок
j,
є оцінкою параметра
βj
з найменшою
дисперсією.
Цю оцінку
j
можна „виділити"
з вектора
= (0,
1,
...,
p-1)'
множенням зліва
на вектор-рядок
c', у якого
(j +1)-й
елемент рівний
одиниці, а всі
інші елементи
дорівнюють
нулю. Таку специфічну
властивість
оцінки
j,
можна узагальнити
на випадок
довільної
лінійної комбінації
а'.
Для цього
використовуємо
наступну теорему.
Теорема 1.1.4.
Нехай
- оцінка найменших
квадратів
вектора
 = Хβ.
Тоді в класі
всіх лінійних
незміщених
оцінок лінійної
комбінації
c'θ
оцінка
c'
є єдиною оцінкою,
яка має мінімальну
дисперсію.
(Будемо говорити,
що c'
є найкращою
лінійною незміщеною
оцінкою (НЛНО)
для c'θ)
Доведення.
Оцінку
найменших
квадратів
вектора
= Хβ
представимо
у вигляді
= X
= X(Х'Х)-1X'Y
= X(Х'Х)-1X'Y
= PY,
при цьому
PX = X(Х'Х)-1X'X = X(Х'Х)-1X'X = XI = X .
Перевіримо,
що c'
- лінійна незміщена
оцінка для c'θ.
Дійсно,
M[c']
= Mc'РY
= c'P
MY = c'Pθ
= c'PXβ
= c'Xβ
= c'θ
для
всіх θΩ
=
 [Х]
і c'
= c'PY
= (P'c)'Y
= (Рс)'Y.
Розглянемо
іншу лінійну
незміщену
оцінку для c'θ.
Тоді M[d'Y]
= c'θ
з одного боку,
а з іншого
M[d'Y] = d'MY = d'θ,
Тоді
c'θ
= d'θ
 (с' - d')θ
= 0
(с- d)'θ
= 0, тобто (c
- d)
 Ω = R(X).
Оскільки R(X) = R(P) в силу теореми 1.1.2, то
(c
– d)
R(P),
(c – d)'P
= 0
((c –
d)'P)'
= 0'
P(c
– d) = 0
Pc = Pd
Порахуємо
дисперсію
оцінки c':
Dc'
= D[(Рd)'Y]
= D[(Рd)'Y]
= Dd'P'Y
= cov(d'P'Y,
d'P'Y)
=
= d'P'cov(Y, Y)(d'P')' = d'PDYPd = d'Pσ2IPd = σ2d'Р2d = σ2 d'Рd,
Тоді
D[d'Y]
- D[c']
= D[d'Y]
- D[(Рd)'
Y] =
= d'DYd - σ2d'Pd = σ2d'd - σ2d'Pd =
= σ2(d'd - d'Рd) = σ2d'(In - Р)d = {In – P = (In – P)2} =
= σ2 d'(In - Р)(In - Р)d = {In – P = (In – P)'} =
= σ2 d'(In - Р)'(In - Р)d = σ2 [(In - Р)d]'[(In - Р)d] ≥ 0
Рівність нулю досягається тоді й тільки тоді, коли
(In - Р)d = 0
d – Pd = 0
d = Рd = Рс
Тоді
D(d'Y)
≥ D(c'),
при цьому c'θ
= d'θ.
Це і означає,
що c'
має мінімальну
дисперсію і
є єдиною оцінкою
з такою властивістю
в класі всіх
лінійних незміщених
оцінок лінійних
комбінацій
c'θ.
Теорема доведена.
Теорема доведена в припущенні, що матриця X має ранг p, так що Р = X (Х'Х)-1X', і θ =Хβ випливає, що β = (Х'Х)-1Х'θ.
Нехай
с' = а'(Х'Х)-1X',
тоді звідси
оцінка а'β
= a'(X’X)-1X'
= с'
є НЛНО з мінімальною
дисперсією
для а'β
при кожному
а.
Зауваження.
Якщо похибки
εі
незалежні й
однаково розподілені
ε
~
 або, в еквівалентній
формі, Y
~
 , то a'
має мінімальну
дисперсію серед
усіх незміщених
оцінок, а не
тільки в класі
лінійних незміщених
оцінок.
Зокрема,
МНК – оцінка
і,
і = 0, …, p
– 1 є також оцінкою
максимальної
правдоподібності,
і вона ефективна
оцінка для βі.
Якщо
ж розподіл εi
не є нормальним,
то МНК – оцінка
і
відрізняється
від оцінки
максимальної
правдоподібності.
В цьому випадку
МНК – оцінка
і
асимптотично
ефективна для
βі.
Оцінимо параметр σ2 = Dεi, але спочатку сформулюємо низку лем.
Лема 1.1.1. Нехай Y = Y(nЧ1) – випадковий вектор, А(nЧn) = A – симетрична матриця. Якщо MY = θ, DY = ∑, тоді математичне сподівання квадратичної форми Y'AY дорівнює
M(Y'AY) = tr(A∑) + θ'Aθ
.Наслідок
Якщо ∑ = σ2I, то tr(A∑) = σ2trA.
Лема 1.1.2.
Нехай маємо n незалежних випадкових величин Y1, Y2, …, Yn з середніми θ1, θ2, …, θn, однаковими дисперсіями μ2 та однаковими третіми та четвертими центральними моментами μ3 та μ4 відповідно (μr = M(Yi – θi)r). Якщо A = = А(nЧn) – симетрична матриця, а a – вектор – стовпець, утворений її діагональними елементами, тоді дисперсія квадратичної форми Y'AY дорівнює
D(Y'AY) = (μ4 – 3(μ2)2)a'a + 2(μ2)2trA2 + 4(μ2)2θ'A2θ + 4μ3θ'Aa
Теорема 1.1.4.
Якщо
М[Y] = Xβ, де Х = X(nЧp), rangX = p, D[Y] = σ2 In,
тоді оцінка
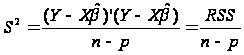
є незміщеною оцінкою для σ2.
Доведення.
Похибку ε запишемо у вигляді:
ε
= Y -
 = Y - Х
= {
= (X'X)-1X'Y
} = Y –
X(X'X)-1X'Y
=
= (In – X(X'X)-1X')Y = (In - Р)Y.
Тоді
(n - p)S2
= (Y
- X)'(Y
- X)
= ((In
– P)Y)'((In
– P)Y) = Y'(In
– P)'(In
– P)Y = {(In
– P)' = In
– P – симетрична}
=Y'(In
– P)2Y
= Y'(In
– P)Y.
Виразимо Y'(In – P)Y з рівності:
(Y – Xβ)'(In – P)(Y – Xβ) = Y'(In – P)Y – Y'(In – P)Xβ – (Xβ)'(In – P)Y + (Xβ)'(In – P)Xβ;
Y'(In – P)Y = (Y – Xβ)'(In – P)(Y – Xβ) + Y'(In – P)Xβ + (Xβ)'(In – P)Y - (Xβ)'(In – P)Xβ.
Порахуємо M(n – p)S2
M(n – p)S2 = MY'(In – P)Y = {лема 1.1.1} = M(Y – Xβ)'(In – P)(Y – Xβ) +
+ MY'(In – P)Xβ + M(Xβ)'(In – P)Y – M(Xβ)'(In – P)Xβ =
= M(Y – Xβ)'(In – P)(Y – Xβ) + (Xβ)'(In – P)Xβ + (Xβ)'(In – P)Xβ –
- (Xβ)'(In – P)Xβ = M(Y – MY)'(In – P)(Y – MY) =
=
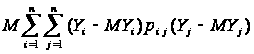 + (Xβ)'(In
– P)Xβ =
=
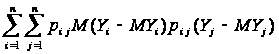 +
(Xβ)'(In
– P)Xβ =
=
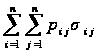 +
(Xβ)'(In
– P)Xβ =
= σ2(p11 + p22 + … + pnn) + β'X'(In – P)Xβ =
=
σ2tr(In
– P) + β'X'(In
– P)Xβ =
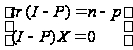 =
= σ2(n – p) + 0 = σ2(n – p)
Отже,
M(n –
p)S2
= σ2(n
– p)
MS2
= σ2.
Теорема доведена.
Виявляється,
що S2,
подібно до
,
має певні властивості
оптимальності,
які наведено
в наступній
теоремі.
Теорема 1.1.5.
Нехай Y1, Y2, …, Yn – незалежні випадкові величини, які мають однакові дисперсії μ2 = 3σ2 і однакові треті та четверті моменти μ3 і μ4. Якщо M[Y] = Xβ, де матриця Х = Х(n Ч p), rangX = p, то DY = σ2I і (n – p)S2 є єдиною невід’ємною квадратичною незміщеною оцінкою для (n – p)σ2, яка має мінімальну дисперсію при μ4 = 3σ4 або при рівності всіх діагональних елементів матриці P.
Доведення.
Оскільки σ2 > 0, то будемо розглядати тільки невід’ємні оцінки.
Нехай Y'АY незміщена квадратична оцінка для (n - р)σ2. Порахуємо математичне сподівання та дисперсію оцінки Y'АY
(n - р)σ2 = M[Y'АY] = σ2 trА + β'Х'АХβ
для
всіх β,
тоді trА
= n - р і
β'Х'АХβ
= 0 для всіх
β.
Отже, Х'АХ
= 0
 А-
додатньо
напіввизначена
симетрична
матриця
з Х'АХ