Статистичний аналіз тенденцій захворюваності в Україні
Позначимо а – вектор, утворений діагональними елементами матриці А і γ2 = (μ4 - 3σ4)/σ4, тоді згідно з лемою 1.1.2,
D[Y'АY] = (μ4 – 3(μ2)2)a'a + 2(μ2)2trA2 + 4(μ2)2(Xβ)'A2(Xβ) + 4μ3(Xβ)'Aa =
=
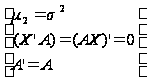 = (μ4
– 3(μ2)2)a'a
+ 2(σ2)2trA2
+ 4(σ2)2β'X'AXβ
+
+ 4μ3β'(AX)'a = σ4 γ2 а'а + 2σ4 trА2 . (1.1.11)
Далі розглянемо оцінку (n - р)S2, яка належить класу незміщених квадратичних оцінок для (n - р)σ2 згідно з теоремою 1.1.4
(n
- р)S2
= (Y
- X )’(Y
- X)
= Y(In
- Р)Y =
Y'RY
(де для стислості, введене позначення In - Р = R), trR2 = trR = n - р.
Розглянемо D[Y'RY]:
D[Y'RY] = σ4 γ2 r'r + 2σ4trR2 = σ4 γ2 r'r + 2σ4 (n - р). (1.1.12)
де r – вектор, утворений діагональними елементами матриці R.
Для того, щоб знайти достатні умови для мінімальності дисперсії оцінки Y'АY, покладемо А = R + D. Оскільки A та R симетричні, то матриця D також симетрична і trА = trR + trD.
Підставляємо: (n – p) = (n – p) + 0 таким чином, trD = 0. Оскільки АХ = 0, то АР = АХ(Х'Х)-1X' = 0, тоді
A = R + D
AP = RP + DP
AP = P – P2 + DP
0 = P – P + DP
DP = 0
Тоді
DR = D – DP = D – 0 = D
(останнє рівне також D = D' = RD, так як D симетрична).
Позначимо a = r + d, r – вектор діагональних елементів матриці R, d– вектор діагональних елементів матриці D.
A2 = (R + D)2 = R2 + DR + RD + D2 = R + 2D + D2
tr A2 = trR + 2trD + trD2 = (n - р) + trD2.
Підставляючи а = r + d і tr A2 в (1.1.11), одержуємо
D[Y'АY] = σ4 γ2 a'а + 2σ4trA2 = σ4 γ2(r + d)'(r + d) + 2σ4(n – p + trD2) =
= σ4 γ2(r' + d')(r + d) + 2σ4(n – p + trD2) =
= σ4 γ2(d'r + d'd + r'r + r'd) + 2σ4(n – p + trD2) =
=
σ4γ2
r'r
+ 2σ4(n
– p)
+ 2σ4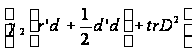 =
= D[Y'RY]
+ 2σ4
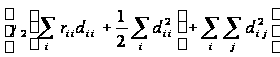 .
Щоб знайти оцінку з мінімальною дисперсією, потрібно мінімізувати D[Y'АY] за умов tr D = 0 і DR = D. У загальному випадку виконати таку мінімізацію досить важкою. Проте в двох важливих окремих випадках ця мінімізація виконується не важко. Перший випадок - це ситуація, коли γ2 = 0 При цьому
D[Y'AY]
= D[Y'RY]
+ 2σ2
Остання ж величина досягає мінімуму, коли dij = 0 для всіх i, j, тобто коли D = 0 і А = R. Другий випадок - це випадок рівності всіх діагональних елементів матриці Р. При цьому всі вони рівні р11 = p22 = … = pnn
trR
= trI – trP
= n – p
 tr Р = р.
Тому
р11 + p22 + … + pnn rii = p
npii
= p
pii
= p/n
Тоді діагональні елементи матриці R = (I – P) дорівнюють rii = 1 – pii = 1 – p/n = (n - р)/n для кожного і
D[Y'AY]
= D[Y'RY]
+ 2σ4(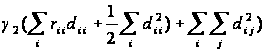 =
=
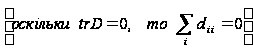 =
= D(Y'RY)
+ 2σ4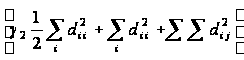 =
= D[Y'RY]
+ 2σ4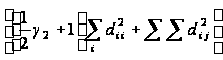 ,
(1.1.13)
Далі для будь–якої випадкової величини ξ виконується нерівність γ2 ≥-2. Дійсно,
0 ≤ D(ξ – Mξ)2 = M(ξ – Mξ)4 – (M(ξ - Mξ)2)2 = μ4 – (μ2)2 =
= μ4 – 3(μ2)2 + 2(μ2)2 = (μ2)2(μ4 / (μ2)2 – 3 + 2) =
=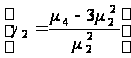 = (μ2)2(γ2
+ 2), отже γ2
≥ -2
отже D[Y'АY] досягає мінімуму, коли dij = 0 для всіх i, j. Таким чином, в обох випадках дисперсія виявляється мінімальною тоді і тільки тоді, коли А = R. Теорема доведена. Доведена теорема говорить про те, що незміщена квадратична оцінка для σ2, з мінімальною дисперсією існує тільки при певних обмеженнях, наведених в теоремі. У припущенні нормальності, тобто при γ2 = 0, оцінка S2 є незміщеною оцінкою для σ2, яка має мінімальну дисперсією в класі всіх незміщених оцінок, а не тільки в класі квадратичних незміщених оцінок. Раніше ми припускали відносно похибок εi, що M[ε] = 0 і D[ε] = σ2In. Якщо додатково припустити, що похибки εi розподілені нормально, тобто ε ~ Nn(0, σ2In) (отже Y ~ Nn(Xβ, σ2In)), то можна одержати низку наступних результатів, пов'язаних з розподілами.
Теорема 1.1.6. Якщо Y ~ Nn(Xβ, σ2In), де Х = Х(nЧp), rangX = p, тоді
~ Np(β,
σ2(X'X)-1);
(
- β)'X'X(
- β)/σ2
~
 ;
не залежить
від S2;
RSS/σ2
= (n – p)S2/σ2
~
 .
Доведення.
(I)
МНК – оцінка
вектора β
має вигляд
= (Х'Х)-1Х'Y,
тоді
= СY, де
C = (Х'Х)-1Х'
- матриця
розміру рЧn,
для якої rangС
= rang(Х'Х)-1Х'
= rangХ-1(Х')-1X'
= rangХ-1
= p. Вектор
Y ~ Nn(Xβ,
σ2In).
Генератриса
моментів для
вектора
дорівнює
M = M
 .
M(t)
= M=
M =
 = M
 =
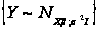 =
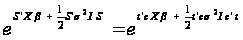 =
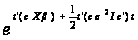
- генератриса
моментів
 ,
де cXβ
= (X’X)-1β
= β,
cσ2Ic’ = (X'X)-1X'σ2I((X'X)-1X')' = σ2(X'X)-1X'X(X'X)-1 = σ2(X'X)-1.
Генератриса функції моментів нормального розподілу ξ ~ N(a; σ2):
M(t)
= Metξ
=
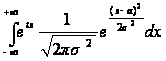 ,


Генератриса
моментів для
вектора
однозначно
визначає щільність
розподілу
вектора
і дорівнює M(t)
= Met',
 ,
t = (t1,
t2, …, tp)'
(II)
(
- β)'Х'Х(
- β)/σ2
=
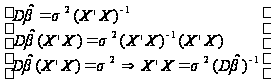 =
= (
- β)'(D)-1(
- β)
= (1
– β1,
…,
p
– βp)(D)-1 =
= (D)-1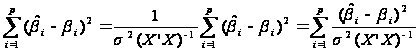
~ N(β;
σ2(X'X)-1),
- β
~ N(0;
σ2(X'X)-1),
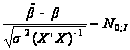 ,
тоді
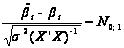 .
Отже,
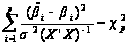 .
(III)
Необхідно
довести,
не залежить
від S2.
Порахуємо
cov(,Y-X)
cov(,
Y - X)
= cov((X'X)-1X'Y,
Y –
X(X'X)-1X'Y)
=
= cov((X'X)-1X'Y, Y - PY) = cov((X'X)-1X'Y, (I – P)Y) =
= (X'X)-1X'cov(Y, Y)(I – P)' = {(I – P)' = I – P} =
= (X'X)-1X'DY(I – P) = {DY = σ2} = (X'X)-1X'σ2I(I – P) =
= σ2(X'X)-1X'(I
– P) =
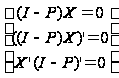 = 0
Залишилось скористатись наступною теоремою:
Нехай Y ~ N(Xβ; σ2I), U = AY, V = BY, матриця А1 складена з лінійно незалежних рядків матриці А, U1 = A1Y. Якщо cov(U, V) = 0, то
1) випадковий вектор U1 не залежить від V'V;
2) випадкові величини U'U та V'V незалежні.
Позначимо
U1
=
,
V = Y -
X,
U = U1
=
U1
= (X'X)-1X'Y,
V = Y - X
= (I – P)Y.
Оскільки
cov(U1,
V) = 0, тоді U1
=
не залежить
від V'V=(Y
- X)'(Y
- X)
= = (n – p)S2.
(IV) Розглянемо
Q1
= (Y –
Xβ)'(Y
– Xβ)
= (Y - X
+ Х(
- β))'(Y
- X
+ X(
- β)) =
= (Y
– X)'(Y
– X)
+ (Y –
X)'X
(
- β)
+ (
- β)'X'(Y
- X)
+
+ (
- β)'X'X
(
- β)
=
=
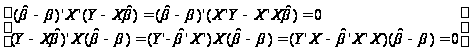 =

= (Y
– X)'(Y
– X)
+ (
- β)'X'X
(
- β)
= Q + Q2.
(1.1.15)
Тут ми позначили
(Y
- X)'(Y
- Х)
= Q, (-
β)'Х'Х(
- β) = Q2.
При цьому відношення
Q1/σ2
=
 =
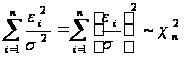 (εi
~ N(0; σ2),
εi
/σ ~ N(0;
1)), Q2/σ2
~
 .
Отже,
Q =
Q1
+ Q2,
Q1 ~
 ,
Q2 ~
 (n > p).
Тому Q/σ2
= Q1/σ2
– Q2/σ
~ ~
 .
Теорема доведена.
Нехай лінійна модель регресії має вигляд Y = Xβ + ε, X = X(n Ч p), rangX = p, ε ~ N(0; σ2I).
Необхідно оцінити параметр β, при лінійних обмеженнях H: Aβ = c,
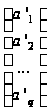
де А = А(q Чp) – відома матриця, c = c(qЧ1) – відомий вектор. (1.1.16)
Обмеження (1.1.16) можна переписати у вигляді:
H: Aβ = c
H:
 β
=
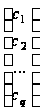 ,
де a'i – i-тий рядок матриці А
H: a'i β = ci , i = 1, 2, …, q.
Використаємо метод множників Лагранжа для розв’язання цієї задачі.
В подальшому будемо використовувати такий вираз:
λ1(a'1β – с1) + λ2(a'2β – с2) + … + λq(a'qβ – сq) =
=
(λ1,
λ2,
…, λq)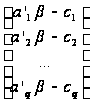 = λ'(Aβ
– c) =
(λ'(Aβ
– c))' =
= (Aβ – c)'λ = (β'A' - c')λ (1.1.17)
Мінімізуємо суму квадратів залишків ε'ε при лінійних обмеженнях H:
Aβ = c.
r = ε'ε + λ1(a'1β – с1) + … + λq(a'qβ – сq) = ε'ε + (β'A' - c')λ = (Y –