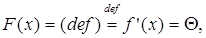Розвиток теорії надання банківських послуг на прикладі ДФ АБ "Правексбанк"
так, ні, не знаю, інше
______________________________________________
9. Ваше відношення до я кості обслуговування в нашому Банку?
позитивне, негативне, нейтральне, інше
______________________________
10. Ваші пропозиції щодо покращення нашої роботи:
_______________________________________________________________________________________________________________________________
Рис. 2.2 Анкета
Велике поширення в статистиці мають середні величини, бо вони характеризують якісні показники будь-якої діяльності.
Середня – це один з найбільш розповсюджених прийомів узагальнень. Правильне розуміння сутності середньої визначає її особливу значимість в умовах ринкової економіки, коли середня через одиночне і випадкове дозволяє виявити загальне і необхідне, виявити тенденцію закономірностей економічного розвитку. Середня величина – це узагальнюючий показник, у якому знаходить вираження дія загальних умов, закономірностей досліджуваного явища.
Статистичні середні розраховуються на основі масових даних правильно статистично організованого масового спостереження.. Однак статистична середня буде об’єктивна і типова, якщо вона розраховується по масовим даним для якісно однорідної сукупності. Середня величина є відображенням значень досліджуваної ознаки, отже, вимірюється в тій же розмірності, що і ця ознака. Кожна середня величина характеризує досліджувану сукупність по який-небудь одній ознаці. Щоб одержати повне і всебічне представлення про досліджувану сукупність по ряду істотних ознак, у цілому необхідно мати систему середніх величин, що можуть описати явище з різних сторін.
Середня арифметична проста (незважена) дорівнює сумі окремих значень ознаки діленої на кількість цих значень.
 , (2.1)
де  - сума окремих значень ознаки;
n – число одиниць сукупності.
Але середня величина – це абстрактна, узагальнююча характеристика ознаки досліджуваної сукупності, вона не показує будівлі сукупності, що дуже істотно для її пізнання. Середня величина не дає представлення про те, як окремі значення досліджуваної ознаки групуються навколо середньої, чи зосереджені вони поблизу чи значно відхиляються від неї. У деяких випадках окремі значення ознаки близько примикають до середньої арифметичної і мало від неї відрізняються. У таких випадках середня добре представляє всю сукупність. В інші, навпаки, окремі значення сукупності далеко знаходяться від середньої, і середня погано представляє всю сукупність.
Коливання окремих значень характеризують показники варіації. Більшість статистичних закономірностей виявляється через варіацію. Вивчаючи варіацію значень ознаки в сполученні з його частотними характеристиками, ми виявляємо закономірності розподілу. Розглядаючи варіацію однієї ознаки паралельно зі зміною іншого, ми виявляємо взаємозв’язок між цими ознаками чи його відсутність. Варіації в статистиці виявляються подвійно, або через зміни значень ознаки в окремих одиницях сукупності, або через наявність чи відсутність досліджуваної ознаки в окремих одиницях сукупності.
Вивчення варіації в статистиці має як самостійну мету, так є і проміжним етапом більш складних статистичних досліджень.
Під варіацією в статистиці розуміють такі кількісні зміни величини досліджуваної ознаки в межах однорідної сукупності, що обумовлені перехресним впливом дії різних факторів.
Аналіз систематичної варіації дозволяє оцінити ступінь залежності змін у досліджуваній ознаці від визначаючих її факторів. Наприклад, вивчаючи силу і характер варіації у сукупності, можна оцінити, наскільки однорідною є дана сукупність у кількісному, а іноді і якісному відношенні, а отже, наскільки характерною є обчислена середня величина. Ступінь близькості даних окремих одиниць до середнього виміряється низкою абсолютних, середніх і відносних показників. Серед них:
Дисперсія – показник, що характеризує розсіювання значень ознаки щодо його середньої величини. Дисперсія – це середнє квадратичне відхилення всіх варіантів ряду віл середньої арифметичної.
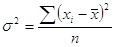 , (2.2)
де  - і-те значення ознаки;
 - середня арифметична ознаки;
n – число значень ознаки.
Середнє квадратичне відхилення – це узагальнююча характеристика абсолютних розмірів варіації ознаки в сукупності. Середнє квадратичне відхилення є мірилом надійності середньої. Чим менше середнє квадратичне відхилення, тим краще середня арифметична відбиває собою всю сукупність, що представляється. Середнє квадратичне відхилення – це квадратний корінь з дисперсії.
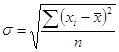 , (2.3)
де - і-те значення ознаки;
- середня арифметична ознаки;
n – число значень ознаки.
Незважаючи на логічну подібність, дисперсія є більш чуттєвим до варіації, а, отже, й частіше застосовуваним показником.
Оскільки числові характеристики випадкової величини ми не можемо визначити точно, а знаходимо тільки їх оцінку, виникає питання, а на скільки ж воно відрізняється від справжнього?
Нехай нас цікавить величина інтервалу ε на який відхилиться від справжньої оцінки числової характеристики, розраховане за результатами експериментальної вибірки. При цьому ми повинні наперед визначити ймовірність β, значення якої викликало б у нас довіру до цього інтервалу (тобто високу ймовірність – 0.8, 0.9, 0.95..). Цей інтервал так і називається – “довірчим”.
Отже нам треба зробити дію, зворотну визначенню ймовірності
P(| -Чх[X]|< ε)= β, (2.4)
де Чх[X] – справжнє значення числової характеристики випадкової величини;
 - оцінка цього значення.
Коли буде знайдено ε, то справжнє значення числової характеристики буде знаходитися в межах
- ε < Чх[X] <+ ε.
Розмір довірчого
інтервалу для кожної числової характеристики можна знайти із застосуванням
функції Лапласа (тут наведено варіант формули для квантиля таблиці t= ):
– для математичного сподівання або середнього
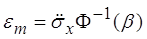 ; (2.5)
– для дисперсії
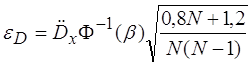 ; (2.6)
де,  ;
Ф-1(β)– зворотне значення функції Лапласа, тобто таке значення аргументу (квантиля), при якому функція Лапласа дорівнює β.
Для визначення взаємозв'язку між ознаками, які можна зранжувати, передусім на основі бальних оцінок, застосовуються методи рангової кореляції. Рангами називають числа натурального ряду, які згідно зі значеннями ознаки надаються елементам сукупності i певним чином упорядковують її. Ранжування проводиться за кожною ознакою окремо: перший ранг надасться найменшому значенню ознаки, останній — найбільшому або навпаки. Кількість рангів дорівнює обсягу сукупності. Очевидно, зі збільшенням обсягу сукупності ступінь «розпізнаваності» елементів зменшується. 3 огляду на те, що рангова кореляція не потребує додержання будь-яких математичних передумов щодо розподілу ознак, зокрема вимоги нормальності розподілу, рангові оцінки щільності зв'язку доцільно використовувати для сукупностей невеликого обсягу.
Для визначення міри зв'язку використовують коефіцієнт рангової кореляції, запропонований К. Спірменом.
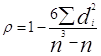 , (2.7)
де n – число одиниць сукупності
 - різниця рангів за ознакою х та за ознакою
у для і-ої одиниці сукупності.
Цей коефіцієнт має такі саме властивості, як i лінійний коефіцієнт кореляції: змінюється в межах від - 1 до + 1, водночас оцінює щільність зв'язку та вказує на його напрям.
Але при наявності співпадаючих значень вищенаведена формула не працює. Тому замість неї використовують коефіцієнт кореляції рангів Кенделла, який порівнює ранги для всіх пар одиниць сукупності, що заздалегідь підпорядковані по значенню признака х.
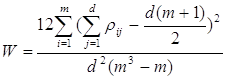 , (2.8)
де d – кількість експертів,
m – кількість критеріїв.
Його використання доцільне, оскільки при розрахунку цього коефіцієнта не використовуються самі значення рангів, а тільки встановлюється більше або менше ранг даної одиниці, тобто немає необхідності при тотожності значень ознаки розраховувати середній ранг.
Але незважаючи на всі переваги традиційних методів, основаних на формулах Пірсона, Спірмена и рангової конкордації Кенделла, вони часто не дають змоги отримати потрібний результат при недостатній погодженості об’єктів по одному з вимірювань та малому обсязі сукупності вимірювань. Крім того, подані формули потребують обробки при тотожності рангів об’єктів.
Для рішення даної проблеми пропонується використовувати модифікований коефіцієнт конкордації:
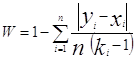 , (2.9)
де n - об’єм вибірки,
ki - кількість ознак по i-му елементу вибірки.
В разі, коли  вид (2.9) спрощується:
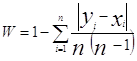 , (2.10)
Формула (2.10) є аналогом коефіцієнта конкордації Кенделла, але не має обмежень, що покладаються на формулу Кенделла. Наприклад, для знаходження кореляції між результатами, формула Кенделла потребує рангового перетворення з наступним усередненням показників для рівних рангів. Подібні перетворення потребують додаткових затрат часу, як за рахунок винятково затрат на перетворення, так и за рахунок перекладу вихідних даних у речове представлення.
Модифікований коефіцієнт конкордації може працювати безпосередньо з вихідними даними. При цьому необхідно або зменшити все значення сукупності на величину мінімального значення, або привести (2.9) до виду
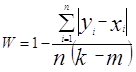 , (2.11)
де n - об’єм вибірки,
k - максимально можливе значення ознаки,
m - мінімально можливе значення ознаки.
Парний двухвибірковий t—тест для середніх використовується для перевірки гіпотези про розходження середніх для двох вибірок даних. У ньому не передбачається рівність дисперсій генеральних сукупностей, з яких обрані дані.
Алгоритм розрахунку включає в себе наступні етапи:
1) Знайти різницю парних варіант.
2) Обчислити середню різницю
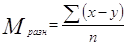 , (2.12)
де  - сума різниць парних варіант,
 - число парних спостережень.
3) Визначити відхилення різниць парних варіант від середньої різниці, звести їх у квадрат і підсумувати отримані результати.
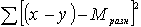 , (2.13)
4) Обчислити дисперсію.
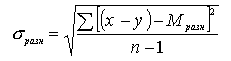 , (2.14)
5) Обчислити помилку середньої.
 (2.15)
6) Обчислити t-статистику
 (2.16)
7) Обчислити число ступенів свободи
 (2.17)
8) Визначити вірогідність розходжень, звіряючи отримані результати з табличними.
2.2 Методи оптимізації
Лінійне програмування – це розділ прикладної математики, що має справу з теорією і чисельними методами оптимізації лінійних функцій при наявності обмежень, що описуються кінцевими системами лінійних нерівностей.
Задачами лінійного програмування називають оптимізаційні задачі, що мають такі особливості: 1) Критерій оптимізації являє собою лінійну функцію від невідомих задачі х1, х2,.. хn; 2) обмеження, що накладаються на можливі розв’язки мають тип лінійних рівностей або нерівностей; 3) змінні приймають ненегативні значення.
Перші постановки задач лінійного програмування буди сформульовані відомим радянським математиком Л.В. Канторовичем, якому за ці роботи була присуджена Нобелівська премія по економіці. Значний розвиток теорія й алгоритмічний апарат лінійного програмування одержали з винаходом та поширення ЕОМ і формулюванням американським математиком Дж. Данцингом симплекс-методу.
У наш час лінійне програмування є одним з найбільш вживаних апаратів математичної теорії оптимального ухвалення рішення економічних задач різноманітного змісту. Для розв'язання задач лінійного програмування розроблене складне програмне забезпечення, що дає можливість ефективно і надійно вирішувати практичні задачі великих обсягів. Ці програми і системи мають розвинені системі підготовки вхідних даних, засобами їхнього аналізу і представлення отриманих результатів.
У розвиток і удосконалення цих систем вкладені праця і талант багатьох математиків, акумульований досвід рішення тисяч задач. Володіння апаратом лінійного програмування необхідно кожному економісту, що застосовує у своїй роботі методи прикладної математики.
Термін "програмування", що входить в назву цього метода, не повинен вводити в оману, тому що мова йде не про програмування електронно-обчислювальних машин. Цей термін сходить до загального змісту слова "програма" – план, керівництво до дії и як така, дисципліна "лінійне програмування" являє собою математичну теорію визначення найкращих планів дії у визначених економічних ситуаціях.
Що це за ситуації? У першу чергу їх можна охарактеризувати наявністю однієї добре визначеної мети чи критерію. Вона повинна вимірятися у визначених одиницях і однозначно визначатися обраним планом дій. Більш придатним прикладом може бути доход від діяльності підприємства, а планом дій, у даному випадку, може бути виробнича програма підприємства.
З погляду математики виробничу програму підприємства в першому наближенні можна записати як набір чисел х1, х2,.. хn, де хі позначає запланований випуск виробів і-го типу, n – кількість типів виробів.
Якщо сі – доход зробленого виробу і-го типу і кожен зроблений виріб купується по одній і тій же ціні, то сумарний дохід підприємства є простою сумою
 , (2.18)
що відбиває присутність терміна "лінійне" у назві "лінійне програмування".
Сума (2.18) є лінійною функцією величин і, звичайно, лише приблизно відбиває економічні реалії. У цьому випадку при збільшенні випуску усіх виробів у тисячі разів, доход підприємства зріс би також у тисячу разів. У реальній економіці при значному зростанні виробництва починають працювати такі фактори як насичення ринку, збільшення конкуренції, зростання виробничих витрат і ін., що, звичайно, знижує прибутковість і не відбувається в такій простій формулі, як (2.18). Зростання масштабів виробництва може не тільки знижувати прибутковість, але й підвищувати її, наприклад при переході від кустарного чи дрібносерійного виробництва до крупносерійного витрати, у розрахунку на один виріб, можуть зменшуватися і відповідно прибутковість підвищиться.
Іншим невід’ємним елементом економічної ситуації, на прикладі де безпосередньо застосуємо підхід лінійного програмування, є обмеження, що накладаються на можливі варіанти планів виробництва. Найчастіше, це ресурсні обмеження, що описують той факт, що: 1) для виробництва товарів приходиться витрачати ресурси; 2) кількість ресурсів, яку можна затратити на виробництво товарів обмежено.
Систему обмежень можна записати як:
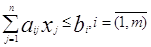 , (2.19)
де аij – кількість одиниць i-го ресурсу для виготовлення j-го виробу;
bi – кількість одиниць i-го ресурсу в наявності;
m – кількість ресурсів.
З погляду економіста, застосування лінійного програмування означає, у такий спосіб:
1) визначення структури задачі – що в ній є критерієм, які в ній присутні обмеження, якими змінними величинами ми можемо керувати, у чому полягає бажаний економічний ефект;
2) збір необхідної інформації, часто шляхом статистичних досліджень, аналізу ринку, прогнозів і ін., значень коефіцієнтів задачі;
3) підготовка задачі до рішення. Оскільки зараз це робиться, як правило, за допомогою обчислювальних машин, цей крок у рішенні задачі являє собою перенесення даних і опису задачі у спеціальну форму, що читається. Для цього застосовуються спеціальні формати даних і програмні системи;
4) рішення задачі. Для цього існує безліч високоефективних програм для найрізноманітніших обчислювальних платформ, від суперкомп’ютерів до персональних ЕОМ. Завдяки праці багатьох математиків і програмістів алгоритми і програми доведені до настільки високого ступеня досконалості, що на цій стадії рідко виникають обчислювальні проблеми. Значно частіше на цій стадії виявляються дефекти постановки задачі, помилки у підготовці або в описі структури задачі. Ефект таких помилок є часто дуже несподіваним і їхнє виправлення вимагає як високої математичної кваліфікації, так і знання конкретної області застосування;
5) аналіз результатів. Це заключна і, по суті справи, найбільш важлива частина процесу. Треба мати на увазі, що в ході рішення задачі лінійного програмування, як правило, визначається не тільки власне оптимальний план, але й великий об’єм супутньої інформації, що дуже коштовна для економічного аналізу і планування.
З усього вищенаведеного ясно, що сучасному економісту необхідно добре розбиратися в математичних основах лінійного програмування для того, щоб успішно застосовувати цей могутній апарат економічного аналізу і планування.
2.2.1 Метод Ньютона
Якщо виходити з того, що необхідним етапом знаходження рішення задачі:
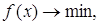 (2.20)
де f: Rm R, є етап знаходження стаціонарних точок, тобто точок, задовольняючих рівнянню: