Расчет показателей эконометрики
Содержание
Задача 1
Решение
Задача 2
Решение
Задача 3
Решение
Задача 4
Решение
Задача 5
Решение
Список используемой литературы
Приложение
Задача 1
По регионам страны изучается зависимость ВРП на душу населения (y тыс. руб.) от инвестиций в основной капитал (x - тыс. руб.):
| № региона | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| x, тыс. руб. | 9,4 | 2,5 | 3,9 | 4,3 | 2,1 | 6,0 | 6,3 | 5,2 | 6,8 | 8,2 |
| y, тыс. руб. | 35,8 | 22,5 | 28,3 | 26,0 | 18,4 | 31,8 | 30,5 | 29,5 | 41,5 | 41,3 |
Задание
Постройте поле корреляции, характеризующее зависимость ВРП на душу населения от размера инвестиций в основной капитал.
Определите параметры уравнения парной линейной регрессии. Дайте интерпретацию коэффициента регрессии и знака при свободном члене уравнения.
Рассчитайте линейный коэффициент корреляции и поясните его смысл. Определите коэффициент детерминации и дайте его интерпретацию.
Найдите среднюю ошибку аппроксимации.
Рассчитайте стандартную ошибку регрессии.
С вероятностью 0,95 оцените статистическую значимость уравнения регрессии в целом, а также его параметров. Сделайте вывод.
С вероятностью 0,95 постройте доверительный интервал ожидаемого значения ВРП на душу населения в предложении, что инвестиции в основной капитал составят 80% от максимального значения. Сделайте вывод.
Решение
Построение поля корреляции производится по исходным данным о парах значений ВРП на душу населения и инвестиций в основной капитал.

Оценка параметров уравнения парной линейной регрессии производится обычным методом наименьших квадратов (МНК).
Для расчета параметров a и b линейной регрессии y = a + b*x решаем систему нормальных уравнений относительно a и b:
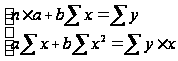
По исходным данным (табл. 1.1) рассчитываем Σy, Σx, Σyx, Σx2, Σy2.
Таблица 1.1 Расчетная таблица
| y | x | yx | x2 | y2 |
|
|
Аi | |
| 1 | 35,8 | 9,4 | 336,520 | 88,360 | 1281,640 | 41,559 | -5,759 | 16,087 |
| 2 | 22,5 | 2,5 | 56,250 | 6,250 | 506,250 | 22,248 | 0,252 | 1,122 |
| 3 | 28,3 | 3,9 | 110,370 | 15,210 | 800,890 | 26,166 | 2,134 | 7,541 |
| 4 | 26,0 | 4,3 | 111,800 | 18,490 | 676,000 | 27,285 | -1,285 | 4,944 |
| 5 | 18,4 | 2,1 | 38,640 | 4,410 | 338,560 | 21,128 | -2,728 | 14,827 |
| 6 | 31,8 | 6,0 | 190,800 | 36,000 | 1011,240 | 32,043 | -0,243 | 0,765 |
| 7 | 30,5 | 6,3 | 192,150 | 39,690 | 930,250 | 32,883 | -2,383 | 7,813 |
| 8 | 29,5 | 5,2 | 153,400 | 27,040 | 870,250 | 29,804 | -0,304 | 1,032 |
| 9 | 41,5 | 6,8 | 282,200 | 46,240 | 1722,250 | 34,282 | 7,218 | 17,392 |
| 10 | 41,3 | 8,2 | 338,660 | 67,240 | 1705,690 | 38,201 | 3,099 | 7,504 |
| Итого | 305,6 | 54,7 | 1810,790 | 348,930 | 9843,020 | 305,600 | 0 | 79,027 |
| Среднее значение | 30,56 | 5,47 | 181,079 | 34,893 | 984,302 | - | - | - |
|
|
7,098 | 2,23 | - | - | - | - | - | - |
|
|
50,381 | 4,973 | - | - | - | - | - | - |


Система нормальных уравнений составит
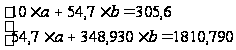
Используем следующие формулы для нахождения параметров:
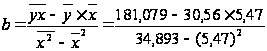 =
2,799
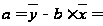 305,6
- 2,799*5,47 = 15,251
Уравнение парной линейной регрессии:
 = 15,251 + 2,799* x
Величина коэффициента регрессии b = 2,799 означает, что с ростом инвестиций в основной капитал на 1 тыс. руб. доля ВРП на душу населения растет в среднем на 2,80 %-ных пункта.
Знак при свободном члене уравнения положительный, следовательно связь прямая.
Рассчитаем линейный коэффициент корреляции:
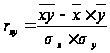 или

где
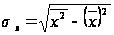 ,
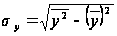 -
средние квадратические
отклонения
признаков x и
y, соответственно
Так как
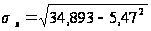 =
2,23,
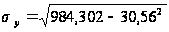 =
7,098, то
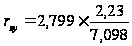 =
0,879, что означает
тесную прямую
связь рассматриваемых
признаков
Коэффициент детерминации составит
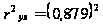 =
0,773
Вариация результата (y) на 77,3% объясняется вариацией фактора (x). На долю прочих факторов, не учитываемых в регрессии, приходится 22,7%.
Средняя
ошибка аппроксимации
( )
находится как
средняя арифметическая
простая из
индивидуальных
ошибок
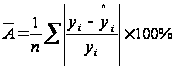 =
 =7,9%,
(см. последнюю графу расчетной табл. 1.1.).
Ошибка аппроксимации
показывает
хорошее соответствие
расчетных ( )
и фактических
(y)
данных: среднее
отклонение
составляет
7,9%.
Стандартная ошибка регрессии рассчитывается по следующей формуле:
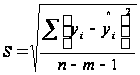 ,
где m – число параметров при переменных x.
В нашем примере стандартная ошибка регрессии
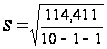 =
3,782
6. Оценку статистической значимости построенное модели регрессии в целом производится с помощью F-критерия Фишера. Фактическое значение F-критерия для парного линейного уравнения регрессии определяется как
F =
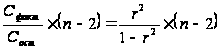
где Сфакт
=
 - факторная,
или объясненная
регрессия,
сумма квадратов;
Сост
=
 -
остаточная
сумма квадратов;
 -
коэффициент
детерминации.
В нашем примере F-критерий Фишера будет равен (см. приложение №1):
F =
 =
27,233
Табличное значение F-критерия при числе степеней свободы 1 и 8 и уровне значимости 0,05 составит: 0,05 F1,8 = 5,32, т. е. фактическое значение F (Fфакт = 27,233) превышает табличное (Fтабл = 5,32), и можно сделать вывод, что уравнение регрессии статистически значимо. Следовательно гипотеза Н0 отклоняется.
Чтобы оценить значимость отдельных параметров уравнения, надо по каждому из параметров определить его стандартные ошибки: mb и ma.
Стандартная ошибка коэффициента регрессии определяется по формуле:
mb
=
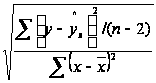 =

где S2 – остаточная дисперсия на одну степень свободы.
Стандартная ошибка параметра a определяется по формуле:
ma
=
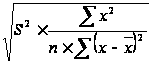 .
Для нахождения стандартных ошибок строим расчетную таблицу (см. приложение №1).
Для нашего примера величина стандартной ошибки коэффициента регрессии составила:
mb
= =
0,536.
Величина стандартной ошибки параметра a составила:
ma
=
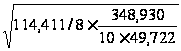 = 3,168
Для оценки существенности коэффициента регрессии и параметра a их величины сравниваются с их стандартными ошибками, т. е. определяются фактические значения t-критерия Стьюдента:
tb
= ,
ta
=
 .
Для нашего примера
tb
= = 5,222, ta
=
 = 4,814
Фактические значения t-критерии превосходят табличные значения:
tb =5,222 > tтабл = 2,306; ta = 4,814 > tтабл = 2,306
Поэтому гипотеза Н0 отклоняется, т. е. a и b не случайно отличаются от нуля, а статистически значимы.
7. Полученные
оценки уравнения
регрессии
позволяют
использовать
его для прогноза.
Для расчета
точечного
прогноза
 подставим в
уравнение
регрессии
заданное значение
факторного
признака
 .
Если прогнозное
значение инвестиций
в основной
капитал составит:
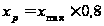 = 9,4*0,8 = 7,52 тыс. руб
Тогда прогнозное значение ВРП на душу населения составит:
=
15,251 + 2,799* 7,52 = 36,299 тыс. руб.
Доверительный интервал прогноза определяется с вероятностью (0,95) как
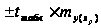 ,
где tтабл
– табличное
значение t-критерия
Стьюдента для
уровня значимости
 (1-0,95)
и числа степеней
свободы (n-2)
для парной
линейной регрессии;
 - стандартная
ошибка точечного
прогноза, которая
рассчитывается
по формуле:
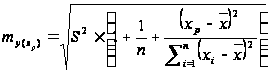
В нашем примере стандартная ошибка прогноза составила
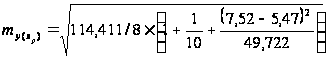 =
4,116
Предельная ошибка прогноза, которая в 95% случаев не будет превышена, составит:
 =
 = 2,306 * 4,116 = 9,491.
Доверительный интервал прогноза
γ =
36,299
 9,491;
γmin
= 36,299 – 9,491 = 26,808 тыс. руб.
γmаx
= 36,299 + 9,491 = 45,79 тыс. руб.
Выполненный
прогноз ВРП
на душу населения
оказался надежным
(р = 1 -
=
0,95), но не точным,
так как диапазон
верхней и нижней
границ доверительного
интервала Dγ
составляет
1,708 раза:
Dγ
= γmаx
/ γmin
= 45,79 / 26,808 = 1,708.
Задача 2
Зависимость валовой продукции сельского хозяйства (y – млн. руб.) от валового производства молока (x1 – тыс. руб.) и мяса (x2 – тыс. руб.) на 100 га сельскохозяйственных угодий по 26 районам области характеризуется следующим образом:
 =
- 2,229 + 0,039* x1
+ 0,303* x2
R2
= 0,956.
Матрица парных коэффициентов корреляции и средние значения:
| y | x1 | x2 | Среднее | |
| y | 1 | 25,8 | ||
| x1 | 0,717 | 1 | 364,9 | |
| x2 | 0,930 | 0,489 | 1 | 45,3 |
Задание
Оцените значимость уравнения регрессии с помощью F-критерия Фишера с вероятностью 0,95. Сделайте выводы.
Найдите скорректированный коэффициент множественной корреляции.
Постройте уравнение множественной регрессии в стандартизованном масштабе и сделайте вывод.
Найдите частные средние коэффициенты эластичности и корреляции; сделайте выводы.
Постройте
таблицу дисперсионного
анализа для
оценки целесообразности
включения в
модель фактора
x2
после фактора
x1,
если известно,
что
 =
1350,5.
Оцените значимость интервала при факторе x2 через t-критерий Стьюдента и дайте интервальную оценку коэффициента регрессии с вероятностью 0,95.
Найдите стандартную ошибку регрессии.
Решение
Оценку значимости уравнения регрессии в целом дает F-критерия Фишера:
Fфакт
=
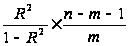
где m- число факторных признаков в уравнении регрессии; R – линейный коэффициент множественной корреляции.
В нашем примере F-критерий Фишера составляет
Fфакт
=
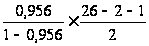 =
249,864
Fтабл = 3,42; α = 0,05.
Сравнивая Fтабл и Fфакт, приходим к выводу о необходимости отклонить гипотезу Н0, так как Fтабл = 3,42 < Fфакт = 249,864. С вероятностью 0,95 делаем заключение о статистической значимости уравнения в целом и показателя тесноты связи R2.
Скорректированный коэффициент множественной корреляции находится как корень из скорректированного коэффициента множественной детерминации (R2 скорр):
R скор
=
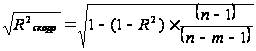 =
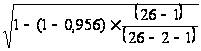 =
 =
0,976
Линейное уравнение множественной регрессии y от x1 и x2 имеет вид:
y = a + b1*x1 + b2*x2.
По условию оно нам дано:
=
- 2,229 + 0,039* x1
+ 0,303* x2
Построим искомое уравнение в стандартизованном масштабе:
ty = β1*tx1 + β2*tx2.
Расчет β-коэффициентов выполним по формулам:
β1
=
 =
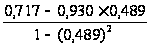 =
0,345;
β2
=
 =
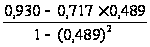 =
0,761.
Получим уравнение
ty = 0,345*tx1 + 0,761*tx2.
Для характеристики относительной силы влияния x1 и x2 на y рассчитаем средние коэффициенты эластичности:
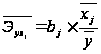 ;
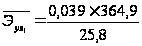 =
0,552%;
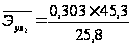 =
0,532%.
С увеличением валового производства молока x1 на 1% от его среднего уровня валовая продукция сельского хозяйства y возрастает на 0,55% от своего среднего уровня; при повышении валового производства мяса x2 на 1% валовая продукция сельского хозяйства y возрастает на 0,53% от своего среднего уровня. Очевидно, что сила влияния валового производства молока x1 на валовую продукцию сельского хозяйства y оказалась большей, чем сила влияния валового производства мяса x2, но правда не намного.
Частные коэффициенты корреляции рассчитываются по формуле:
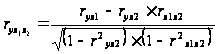 =
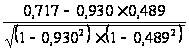 =
0,817,
т.е. при закреплении фактора x2 на постоянном уровне корреляция y и x1 оказывается более высокой (0,817 против 0,717);
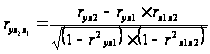 =
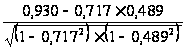 =
0,953,
т. е. при закреплении фактора x1 на постоянном уровне влияние фактора x2 на y оказывается более высокой (0,953 против 0,930);
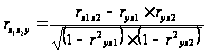 =
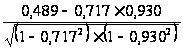 = - 0,692
Результаты дисперсионного анализа представлены в табл. 2.1.
Таблица 2.1
| Вариация результата, y | Число степеней свободы | Сумма квадратов отклонений, S | Дисперсия на одну степень свободы, s2 | Fфакт |
Fтабл α =0,05, k1 = 2, k2 = 23 |
| Общая | Df = n-1 = 25 | 35113 | - | - | - |
|
Факторная - за счет x1 - за счет дополнительного x2 |
k1 = m = 2 1 1 |
33568,028 18051,207 15516,821 |
16784,014 18051,207 15516,821 |
249,864 268,728 230,999 |
3,42 4,28 4,28 |
| Остаточная | k2 = n-m-1 = 23 | 1544,972 | 67,173 | - | - |
Sобщ
=
 =
1350,5 * 26 = 35113;
Sфакт
=
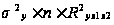 =
1350,5 * 26 * 0,956 = 33568,028;
Sфакт
x1
= =
1350,5 * 26 * 0,7172
= 18051,207;
Sфакт x2 = Sфакт - Sфакт x1 = 33568,028 – 18051,207 = 15516,821;
Sост
=
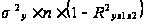 =
Sобщ
- Sфакт
= 35113 – 33568,028 = 1544,972;
Fфакт
=
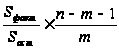 =
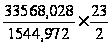 =
249,864;
Fфактx1
=
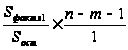 =
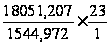 = 268,728;
Fчастнx2
=
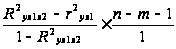 =
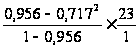 = 230,999.
 =
16784,014;
 =
15516,821;
 =
18051,207
Включение в модель фактора x2 после фактора x1 оказалось статистически значимым и оправданным: прирост факторной дисперсии (в расчете на одну степень свободы) оказался существенным, т. е. следствием дополнительного включения в модель систематически действующего фактора x2, так как Fчастнx2 = 230,999 > Fтабл = 4,28.
Оценка с помощью t-критерия Стьюдента значимости коэффициента b2 связана с сопоставлением его значения с величиной его случайной ошибки: mb2.
Расчет значения t-критерия Стьюдента для коэффициента регрессии линейного уравнения находится по следующей формуле:
 =
15,199.
При α
= 0,05; df
= n-m-1
= 26-2-1 = 23; tтабл
= 2,07. Сравнивая
tтабл
и tфакт,
приходим к
выводу, что так
как
 =
15,199 > 2,07 = tтабл,
коэффициент
регрессии b2
является
статистически
значимым, надежным,
на него можно
опираться в
анализе и в
прогнозе.
Стандартная ошибка регрессии рассчитывается по следующей формуле:
=
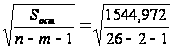 = 8,196.
Задача 3
Рассматривается модель вида
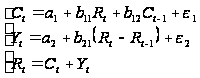
где
Сt – расходы на потребление в текущий период,
Сt-1 – расходы на потребление в предыдущий период,
Rt – доход текущего периода,
Rt-1 – доход предыдущего периода,
Yt – инвестиции текущего периода.
Ей соответствует следующая приведенная форма (построена по районам области)
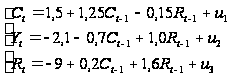
Задание
Проведите идентификацию модели.
Укажите способы оценки параметров каждого уравнения структурной модели.
Найдите структурные коэффициенты каждого уравнения, если известны следующие данные:
| № | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| Yt | 4 | 4 | 6 | 10 | 9 | 8 | 7 | 6 | 8 | 12 | 8 | 16 |
| Сt | 14 | 13 | 15 | 20 | 20 | 14 | 16 | 12 | 12 | 21 | 12 | 17 |
| Rt-1 | 15 | 14 | 16 | 22 | 26 | 18 | 18 | 15 | 19 | 28 | 18 | 26 |
| Сt-1 | 12 | 11 | 12 | 15 | 17 | 12 | 14 | 10 | 11 | 20 | 12 | 16 |
Решение
Модель имеет три эндогенные Н (Сt, Yt, Rt). Причем переменная Rt задана тождеством. Поэтому практически статистическое решение необходимо только для первых двух уравнений системы, которые необходимо проверить на идентификацию. Модель содержит две предопределенные D (Сt-1, Rt-1) переменные.
Проверим каждое уравнение системы на необходимое и достаточное условия идентификации.
Проверим необходимое условие идентификации для уравнений модели.
I уравнение.
Н: эндогенных переменных – 2 (Сt, Rt), отсутствующих предопределенных переменных – 1 (Rt-1).
Следовательно, по счетному правилу D + 1 = H (1 + 1 = 2) уравнение идентифицируемо.
II уравнение.
Н: эндогенных переменных – 1 (Yt); переменная Rt в данном уравнении не рассматривается как эндогенная, так как она участвует в уравнении не самостоятельно, а вместе с переменной Rt-1.
отсутствующих предопределенных переменных – 1 (Сt-1).
Следовательно, по счетному правилу D + 1 > H (1 + 1 > 1) уравнение сверхидентифицировано.
III уравнение.
Третье уравнение представляет собой тождество, параметры которого известны. Необходимости в его идентификации нет.
Следовательно, рассматриваемая в целом структурная модель сверхидентифицируема по счетному правилу.
Проверим для каждого из уравнений достаточное условие идентификации.
Для этого составим матрицу коэффициентов при переменных модели:
| Сt | Yt | Rt | Rt-1 | Сt-1 | |
| I уравнение | -1 | 0 | b11 | 0 | b12 |
| II уравнение | 0 | -1 | b21 | -b21 | 0 |
| III уравнение | 1 | 1 | -1 | 0 | 0 |
В соответствии с достаточным условием идентификации определитель матрицы коэффициентов при переменных, не входящих в исследуемое уравнение, не должен быть равен нулю, а ранг матрицы должен быть равен числу эндогенных переменных модели минус 1, т. е. 3-1=2.
I уравнение.
Матрица коэффициентов при переменных, не входящих в уравнение, имеет вид:
| Уравнение | Отсутствующие переменные | |
| Yt | Rt-1 | |
| Второе | -1 | -b21 |
| Третье | 1 | 0 |
Определитель
матрицы не
равен 0 (Det
A =
-1*0 – (1*-b21)
 0),
ранг матрицы
равен 2; следовательно,
выполняется
достаточное
условие идентификации.
II уравнение.
Матрица коэффициентов при переменных, не входящих в уравнение, имеет вид:
| Уравнение | Отсутствующие переменные | |
| Сt | Сt-1 | |
| Первое | -1 | b12 |
| Третье | 1 | 0 |
Определитель
матрицы не
равен 0 (Det
A =
-1*0 – (1*b12)
0.),
ранг матрицы
равен 2; следовательно,
выполняется
достаточное
условие идентификации.
Первое уравнение идентифицируемое, следовательно, для его решения применяется косвенный метод наименьших квадратов.
Косвенный метод наименьших квадратов (МНК):
Составить приведенную форму модели и определить численные значения параметров каждого уравнения системы обычным МНК.
Путем алгебраических преобразований переходим от приведенной формы к уравнениям структурной формы модели и получаем численные оценки структурных параметров.
Для решения второго уравнения, а оно у нас сверхидентифицируемое, применяется – двухшаговый метод наименьших квадратов.
Двушшаговый метод:
- Составить приведенную форму модели и определить численные значения параметров каждого уравнения системы обычным МНК.
- Выявляем эндогенные переменные, находящиеся в правой части структурного уравнения, параметры которого определяют двухшаговым МНК, и находим расчетные значения по соответствующим уравнениям приведенной формы модели.
- Обычным МНК определяем параметры структурного уравнения, используя в качестве исходных данных фактические значения предопределенных переменных и расчетные значения эндогенных переменных, стоящих в правой части данного структурного уравнения.
3. Найдем структурные коэффициенты первого и второго уравнений на основании исходных данных.
Составим расчетную таблицу (Rt = Ct + Yt ; обозначим d Rt = Rt - Rt-1).
Таблица 3.1 Расчетная таблица
| № | Yt | Ct | Rt-1 | Ct-1 | Rt | dRt | Yt*dRt | (dRt)2 | (Rt)2 | (Ct-1*Rt | Ct*Rt | (Ct-1)2 | Ct*Ct-1 |
| 1 | 4 | 14 | 15 | 12 | 18 | 3 | 12 | 9 | 324 | 216 | 252 | 144 | 168 |
| 2 | 4 | 13 | 14 | 11 | 17 | 3 | 12 | 9 | 289 | 187 | 221 | 121 | 143 |
| 3 | 6 | 15 | 16 | 12 | 21 | 5 | 30 | 25 | 441 | 252 | 315 | 144 | 180 |
| 4 | 10 | 20 | 22 | 15 | 30 | 8 | 80 | 64 | 900 | 450 | 600 | 225 | 300 |
| 5 | 9 | 20 | 26 | 17 | 29 | 3 | 27 | 9 | 841 | 493 | 580 | 289 | 340 |
| 6 | 8 | 14 | 18 | 12 | 22 | 4 | 32 | 16 | 484 | 264 | 308 | 144 | 168 |
| 7 | 7 | 16 | 18 | 14 | 23 | 5 | 35 | 25 | 529 | 322 | 368 | 196 | 224 |