Нейрокомпьютерные системы
wij=*(OUTi OUTj), (7.5)
где wij - изменение веса связи нейрона j с нейроном j в матрицах W или Wt; OUTi - выход нейрона j слоя 1 или 2; - положительный нормирующий коэффициент обучения, меньший 1.
КОНКУРИРУЮЩАЯ ДАП
Во многих конкурирующих нейронных системах наблюдаются некоторые виды конкуренции между нейронами. В нейронах, обрабатывающих сигналы от сетчатки, латеральное торможение приводит к увеличению выхода наиболее высокоактивных нейронов за счет соседних. Такие системы увеличивают контрастность, поднимая уровень активности нейронов, подсоединенных к яркой области сетчатки, в то же время еще более ослабляя выходы нейронов, подсоединенных к темным областям.
В ДАП конкуренция реализуется взаимным соединением нейронов внутри каждого слоя посредством дополнительных связей. Веса этих связей формируют другую весовую матрицу с положительными значениями элементов главной диагонали и отрицательными значениями остальных элементов. Теорема Кохен - Гроссберга [1] показывает, что такая сеть является безусловно стабильной, если весовые матрицы симметричны. На практике сети обычно стабильны даже в случае отсутствия симметрии весовых матриц. Однако неизвестно, какие особенности весовых матриц могут привести к неустойчивости функционирования сети.
ЗАКЛЮЧЕНИЕ
Ограниченная емкость памяти ДАП, ложные ответы и некоторая непредсказуемость поведения привели к рассмотрению ее как устаревшей модели искусственных нейронных сетей. Этот вывод определенно является преждевременным. ДАП имеет много преимуществ: она совместима с аналоговыми схемами и оптическими системами; для нее быстро сходятся как процесс обучения так, и процесс восстановления информации; она имеет простую и интуитивно привлекательную форму функционирования. В связи с быстрым развитием теории могут быть найдены методы, объясняющие поведение ДАП и разрешающие ее проблемы.
Глава 8 Адаптивная резонансная теория
Мозг человека выполняет трудную задачу обработки непрерывного потока сенсорной информации, получаемой из окружающего мира. Из потока тривиальной информации он должен выделить жизненно важную информацию, обработать ее и, возможно, зарегистрировать в долговременной памяти. Понимание процесса человеческой памяти представляет собой серьезную проблему; новые образы запоминаются в такой форме, что ранее запомненные не модифицируются и не забываются. Это создает дилемму: каким образом память остается пластичной, способной к восприятию новых образов, и в то же время сохраняет стабильность, гарантирующую, что образы не уничтожатся и не разрушатся в процессе функционирования? Традиционные искусственные нейронные сети оказались не в состоянии решить проблему стабильности-пластичности. Очень часто обучение новому образу уничтожает или изменяет результаты предшествующего обучения. В некоторых случаях это не существенно. Если имеется только фиксированный набор обучающих векторов, они могут предъявляться при обучении циклически. В сетях с обратным распространением, например, обучающие векторы подаются на вход сети последовательно до тех пор, пока сеть не обучится всему входному набору. Если, однако, полностью обученная сеть должна запомнить новый обучающий вектор, он может изменить веса настолько, что потребуется полное переобучение сети. В реальной ситуации сеть будет подвергаться постоянно изменяющимся воздействиям; она может никогда не увидеть один и тот же обучающий вектор дважды. При таких обстоятельствах сеть часто не будет обучаться; она будет непрерывно изменять свои веса, не достигая удовлетворительных результатов. Более того, в работе [1] приведены примеры сети, в которой только четыре обучающих вектора, предъявляемых циклически, заставляют веса сети изменяться непрерывно, никогда не сходясь. Такая временная нестабильность явилась одним из главных факторов, заставивших Гроссберга и его сотрудников исследовать радикально отличные конфигурации. Адаптивная резонансная теория (APT) является одним из результатов исследования этой проблемы [2,4]. Сети и алгоритмы APT сохраняют пластичность, необходимую для изучения новых образов, в то же время предотвращая изменение ранее запомненных образов. Эта способность стимулировала большой интерес к APT, но многие исследователи нашли теорию трудной для понимания. Математическое описание APT является сложным, но основные идеи и принципы реализации достаточно просты для понимания. Мы сконцентрируемся далее на общем описании APT; математически более подготовленные читатели смогут найти изобилие теории в литературе, список которой приведен в конце главы. Нашей целью является обеспечение достаточно конкретной информацией, чтобы читатель мог понять основные идеи и возможности, а также провести компьютерное моделирование с целью исследования характеристик этого важного вида сетей.
АРХИТЕКТУРА APT
Адаптивная резонансная теория включает две парадигмы, каждая из которых определяется формой входных данных и способом их обработки. АРТ-1 разработана для обработки двоичных входных векторов, в то время как АРТ-2, более позднее обобщение АРТ-1, может классифицировать как двоичные, так и непрерывные векторы. В данной работе рассматривается только АРТ-1. Читателя, интересующегося АРТ-2, можно отослать к работе [3] для полного изучения этого важного направления. Для краткости АРТ-1 в дальнейшем будем обозначать как APT.
Описание APT
Сеть APT представляет собой векторный классификатор. Входной вектор классифицируется в зависимости от того, на какой из множества ранее запомненных образов он похож. Свое классификационное решение сеть APT выражает в форме возбуждения одного из нейронов распознающего слоя. Если входной вектор не соответствует ни одному из запомненных образов, создается новая категория посредством запоминания образа, идентичного новому входному вектору. Если определено, что входной вектор похож на один из ранее запомненных векторов с точки зрения определенного критерия сходства, запомненный вектор будет изменяться (обучаться) под воздействием нового входного вектора таким образом, чтобы стать более похожим на этот входной вектор. Запомненный образ не будет изменяться, если текущий входной вектор не окажется достаточно похожим на него. Таким образом решается дилемма стабильности-пластичности. Новый образ может создавать дополнительные классификационные категории, однако новый входной образ не может заставить измениться существующую память.
Упрощенная архитектура APT
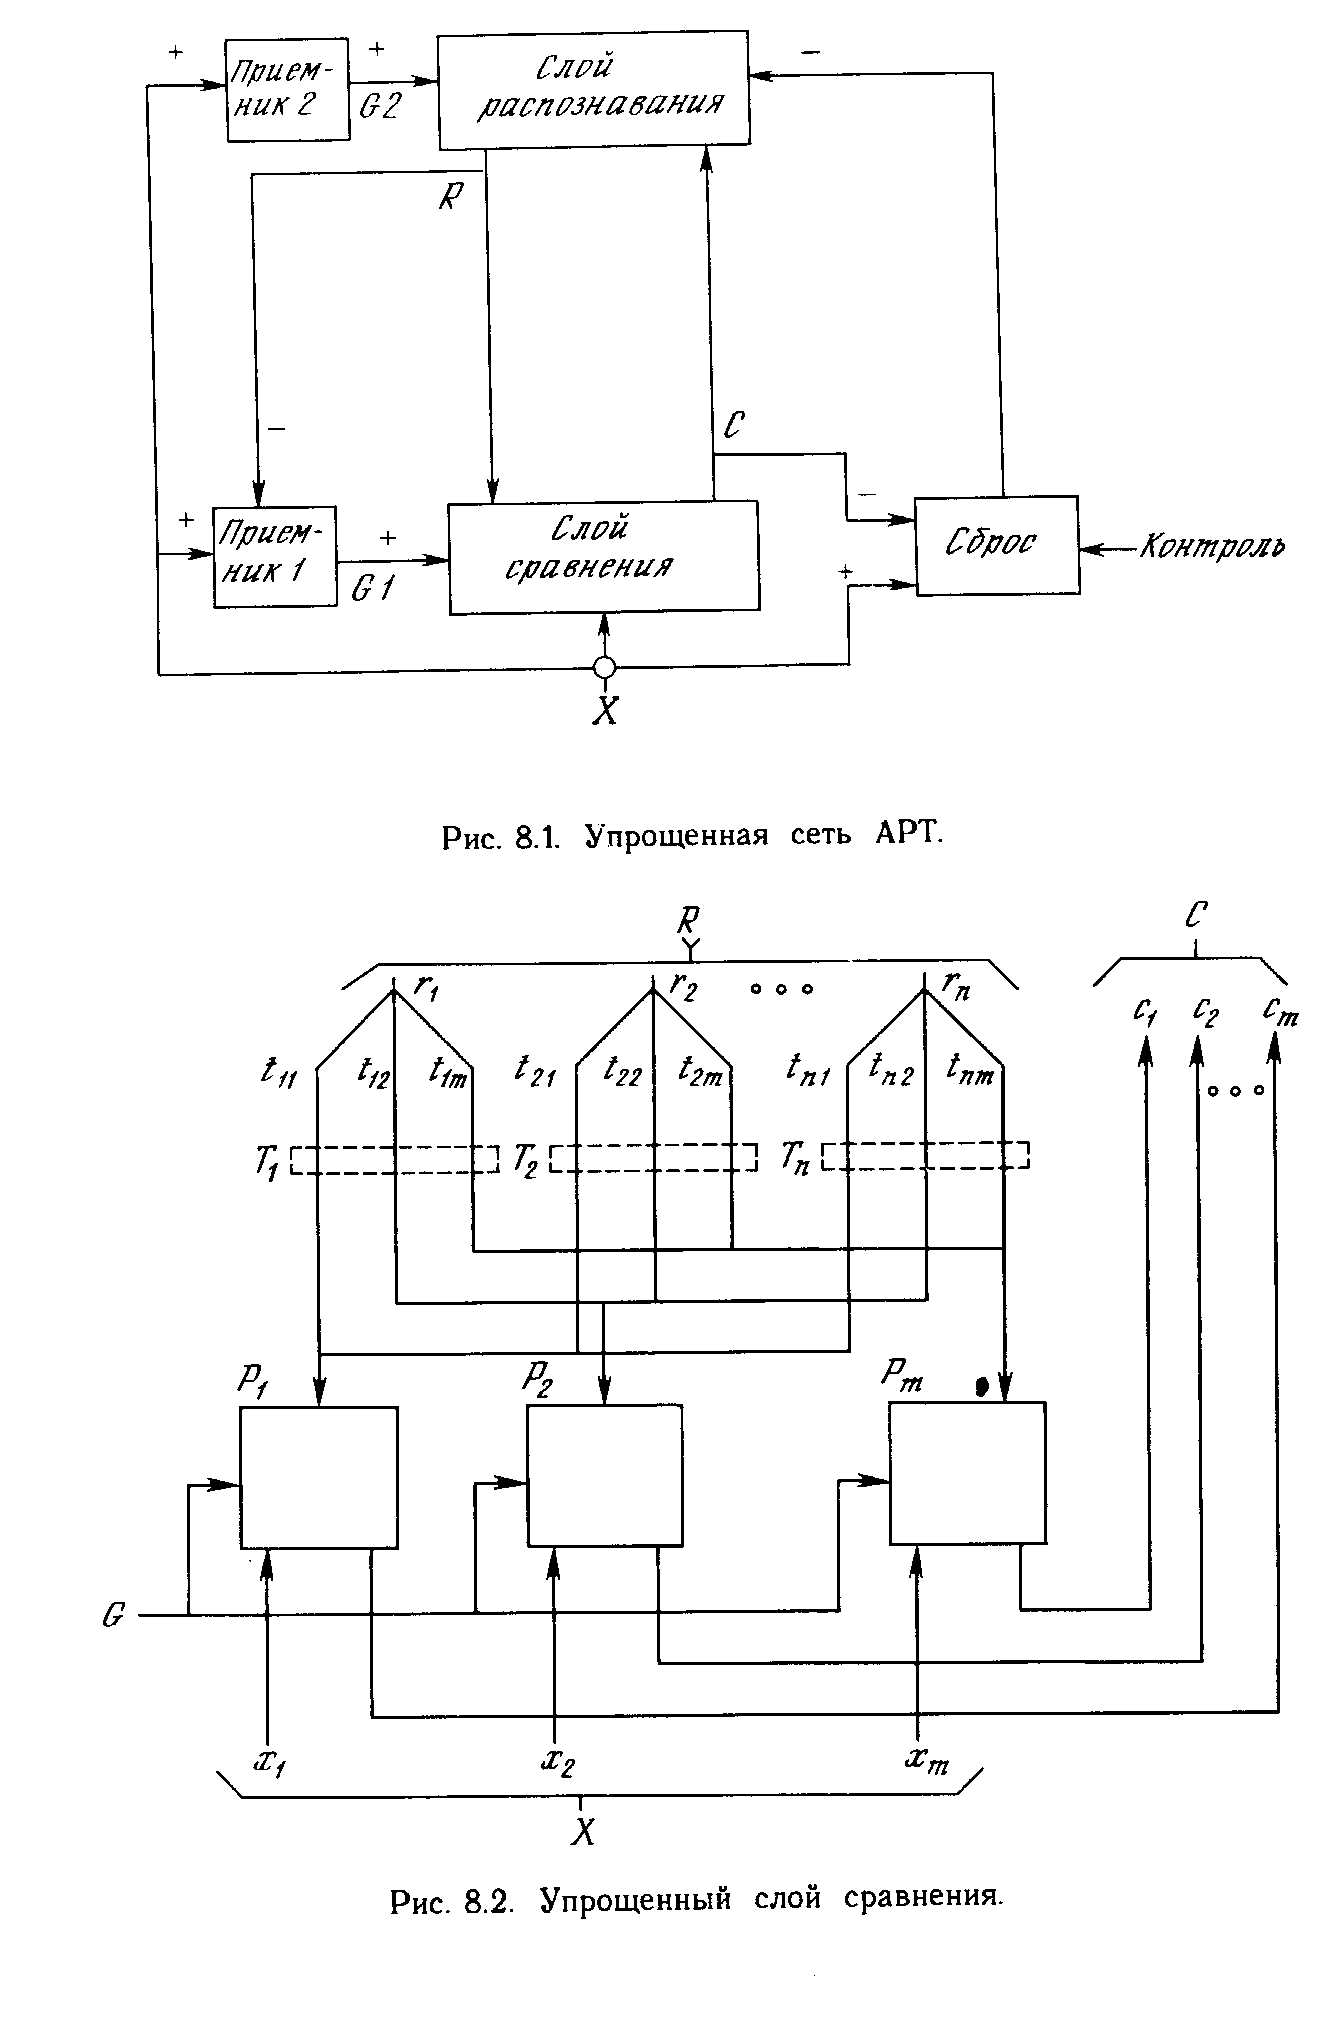
На рис. 8.1 показана упрощенная конфигурация сети APT, представленная в виде пяти функциональных модулей. Она включает два слоя нейронов, так называемых «слой сравнения» и «слой распознавания». Приемник 1, Приемник 2 и Сброс обеспечивают управляющие функции, необходимые для обучения и классификации. Перед рассмотрением вопросов функционирования сети в целом необходимо рассмотреть отдельно функции модулей; далее обсуждаются функции каждого из них.
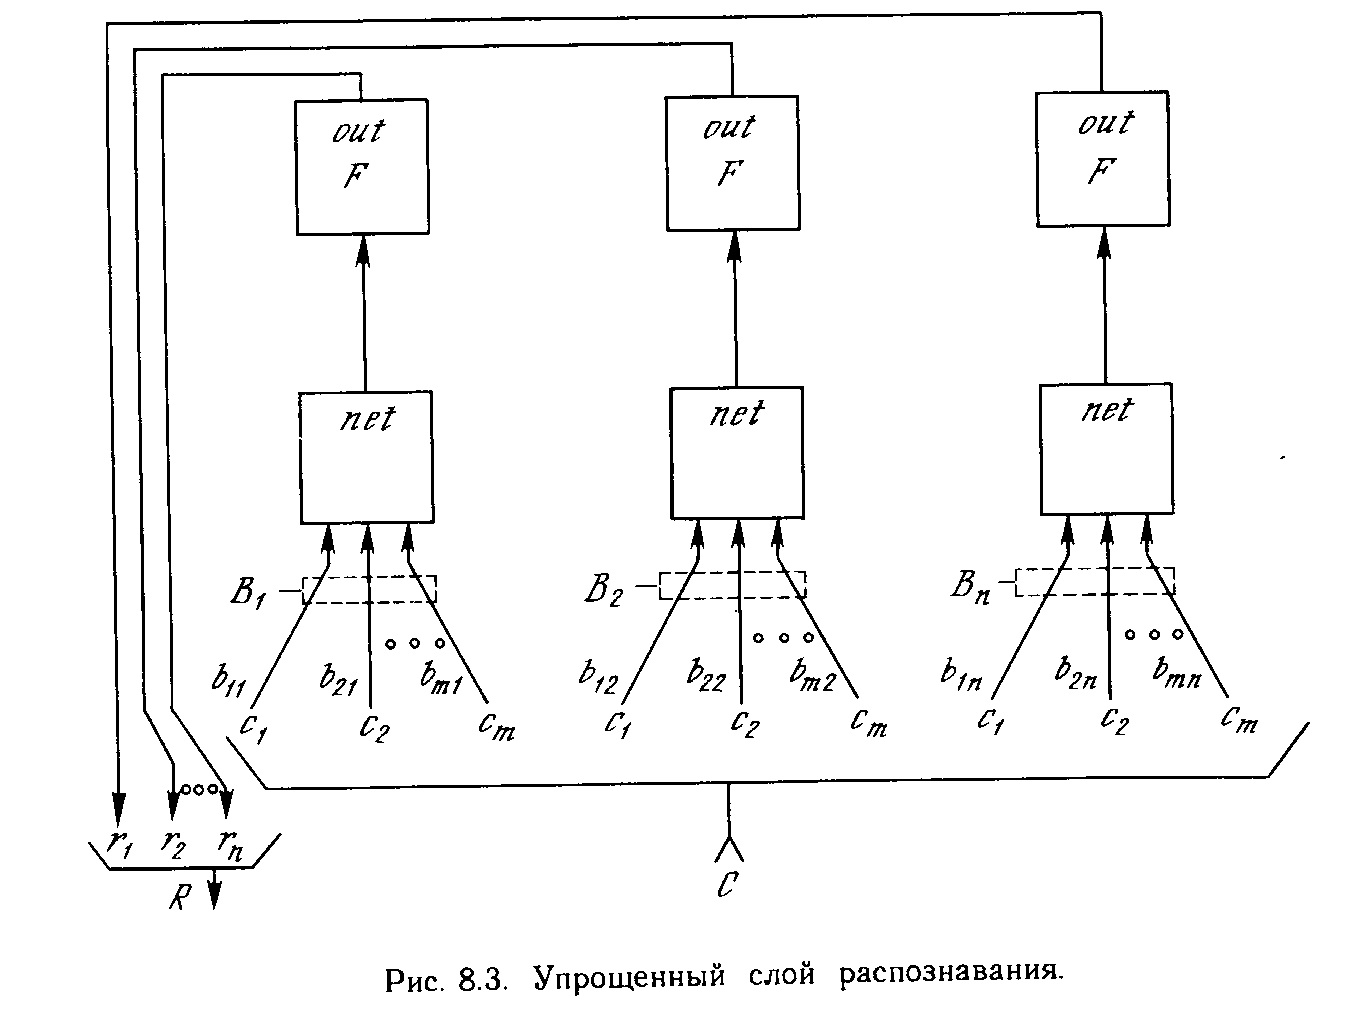
Слой сравнения. Слой сравнения получает двоичный входной вектор Х и первоначально пропускает его неизмененным для формирования выходного вектора С. На более поздней фазе в распознающем слое вырабатывается двоичный вектор R, модифицирующий вектор С, как описано ниже. Каждый нейрон в слое сравнения (рис. 8.2) получает три двоичных входа (0 или 1): (1) компонента хi. входного вектора X; (2) сигнал обратной связи Рj -взвешенная сумма выходов распознающего слоя; (3) вход от Приемника 1 (один и тот же сигнал подается на все нейроны этого слоя).
Чтобы получить на выходе нейрона единичное значение, как минимум два из трех его входов должны равняться единице; в противном случае его выход будет нулевым. Таким образом реализуется правило двух третей, описанное в [3]. Первоначально выходной сигнал G1 Приемника 1 установлен в единицу, обеспечивая один из необходимых для возбуждения нейронов входов, а все компоненты вектора R установлены в 0; следовательно, в этот момент вектор С идентичен двоичному входному вектору X.
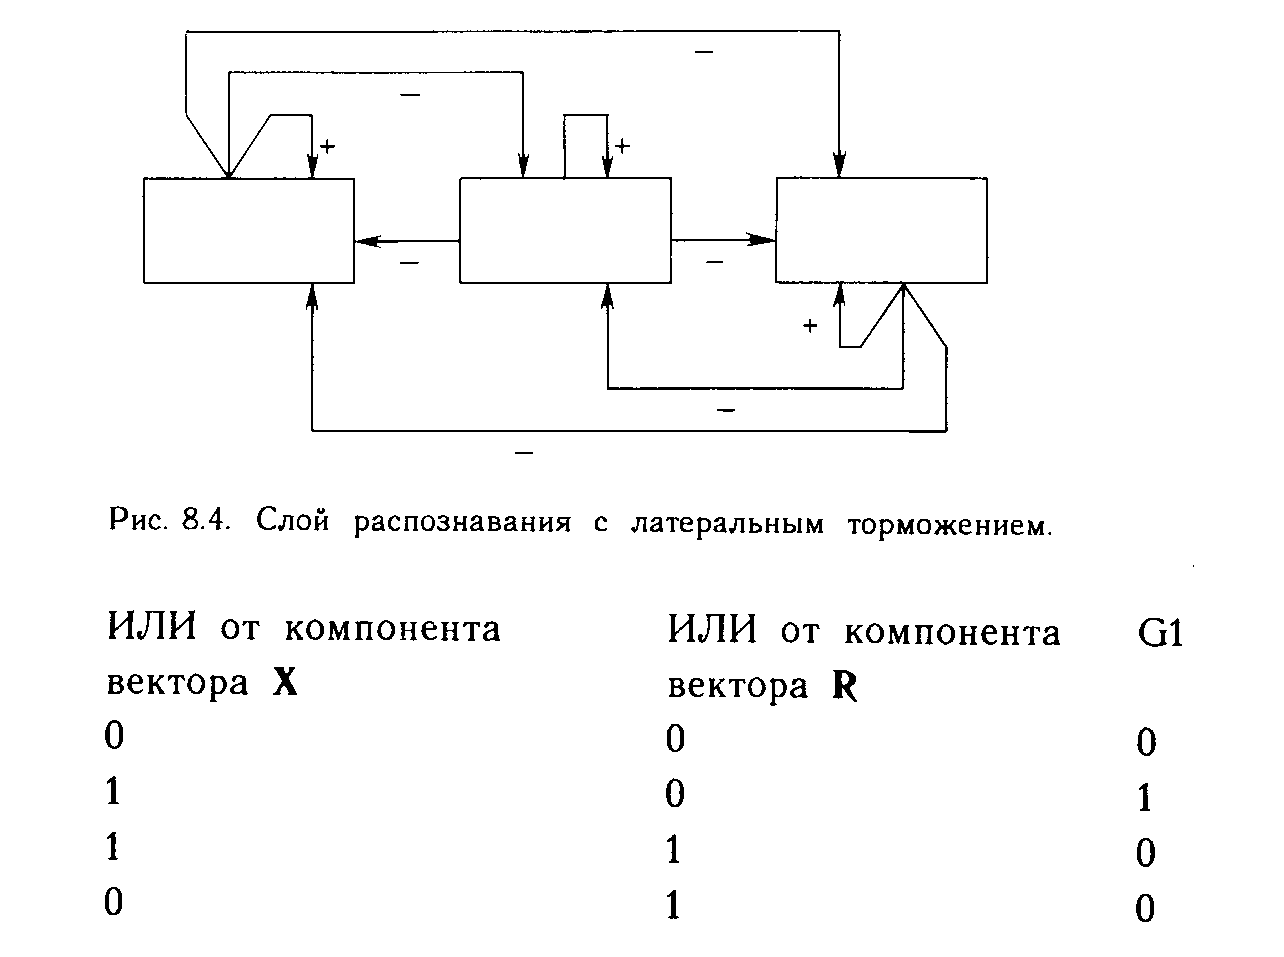
Слой распознавания. Слой распознавания осуществляет классификацию входных векторов. Каждый нейрон в слое распознавания имеет соответствующий вектор весов Вj. Только один нейрон с весовым вектором, наиболее соответствующим входному вектору, возбуждается; все остальные нейроны заторможены. Как показано на рис. 8.3, нейрон в распознающем слое имеет максимальную реакцию, если вектор С, являющийся выходом слоя сравнения, соответствует набору его весов, следовательно, веса представляют запомненный образ или экземпляр для категории входных векторов. Эти веса являются действительными числами, а не двоичными величинами. Двоичная версия этого образа также запоминается в соответствующем наборе весов слоя сравнения (рис. 8.2); этот набор состоит из весов связей, соединяющих определенные нейроны слоя распознавания, один вес на каждый нейрон слоя сравнения. В процессе функционирования каждый нейрон слоя распознавания вычисляет свертку вектора собственных весов и входного вектора С. Нейрон, имеющий веса, наиболее близкие вектору С, будет иметь самый большой выход, тем самым выигрывая соревнование и одновременно затормаживая все остальные нейроны в слое. Как показано на рис. 8.4, нейроны внутри слоя распознавания взаимно соединены в латерально-тормозящую сеть. В простейшем случае (единственном, рассмотренном в данной работе) предусматривается, что только один нейрон в слое возбуждается в каждый момент времени (т.е. только нейрон с наивысшим уровнем активации будет иметь единичный выход; все остальные нейроны будут иметь нулевой выход). Эта конкуренция реализуется введением связей с отрицательными весами lij с выхода каждого нейрона ri. на входы остальных нейронов. Таким образом, если нейрон имеет большой выход, он тормозит все остальные нейроны в слое. Кроме того, каждый нейрон имеет связь с положительным весом со своего выхода на свой собственный вход. Если нейрон имеет единичный выходной уровень, эта обратная связь стремится усилить и поддержать его.
Приемник 2. G2, выход Приемника 2, равен единице, если входной вектор Х имеет хотя бы одну единичную компоненту. Более точно, G2 является логическим ИЛИ от компонента вектора X.
Приемник 1. Как и сигнал G2, выходной сигнал G1 Приемника 1 равен 1, если хотя бы одна компонента двоичного входного вектора Х равна единице; однако если хотя бы одна компонента вектора R равна единице, G1 устанавливается в нуль. Таблица, определяющая эти соотношения:
Сброс. Модуль сброса измеряет сходство между векторами Х и С. Если они отличаются сильнее, чем требует параметр сходства, вырабатывается сигнал сброса возбужденного нейрона в слое распознавания. В процессе функционирования модуль сброса вычисляет сходство как отношение количества единиц в векторе С к их количеству в векторе X. Если это отношение ниже значения параметра сходства, вырабатывается сигнал сброса.
Функционирование сети APT в процессе классификации
Процесс классификации в APT состоит из трех основных фаз: распознавание, сравнение и поиск. Фаза распознавания. В начальный момент времени входной вектор отсутствует на входе сети; следовательно, все компоненты входного вектора Х можно рассматривать как нулевые. Тем самым сигнал G2 устанавливается в О и, следовательно, в нуль устанавливаются выходы всех нейронов слоя распознавания. Поскольку все нейроны слоя распознавания начинают работу в одинаковом состоянии, они имеют равные шансы выиграть в последующей конкуренции. Затем на вход сети подается входной вектор X, который должен быть классифицирован. Этот вектор должен иметь одну или более компонент, отличных от нуля, в результате чего и G1, и G2 становятся равными единице. Это «подкачивает» нейроны слоя сравнения, обеспечивая один из двух единичных входов, необходимых для возбуждения нейронов в соответствии с правилом двух третей, тем самым позволяя нейрону возбуждаться, если соответствующая компонента входного вектора Х равна единице. Таким образом, в течение данной фазы вектор S в точности дублирует вектор X. Далее для каждого нейрона в слое распознавания вычисляется свертка вектора его весов Вj и вектора С (рис. 8.4). Нейрон с максимальным значением свертки имеет веса, наилучшим образом соответствующие входному вектору. Он выигрывает конкуренцию и возбуждается, одновременно затормаживая все остальные нейроны этого слоя. Таким образом, единственная компонента rj вектора R (рис. 8.1) становится равной единице, а все остальные компоненты становятся равными нулю. В результате, сеть APT запоминает образы в весах нейронов слоя распознавания, один нейрон для каждой категории классификации. Нейрон слоя распознавания, веса которого наилучшим образом соответствуют входному вектору, возбуждается, его выход устанавливается в единичное значение, а выходы остальных нейронов этого слоя устанавливаются в нуль.
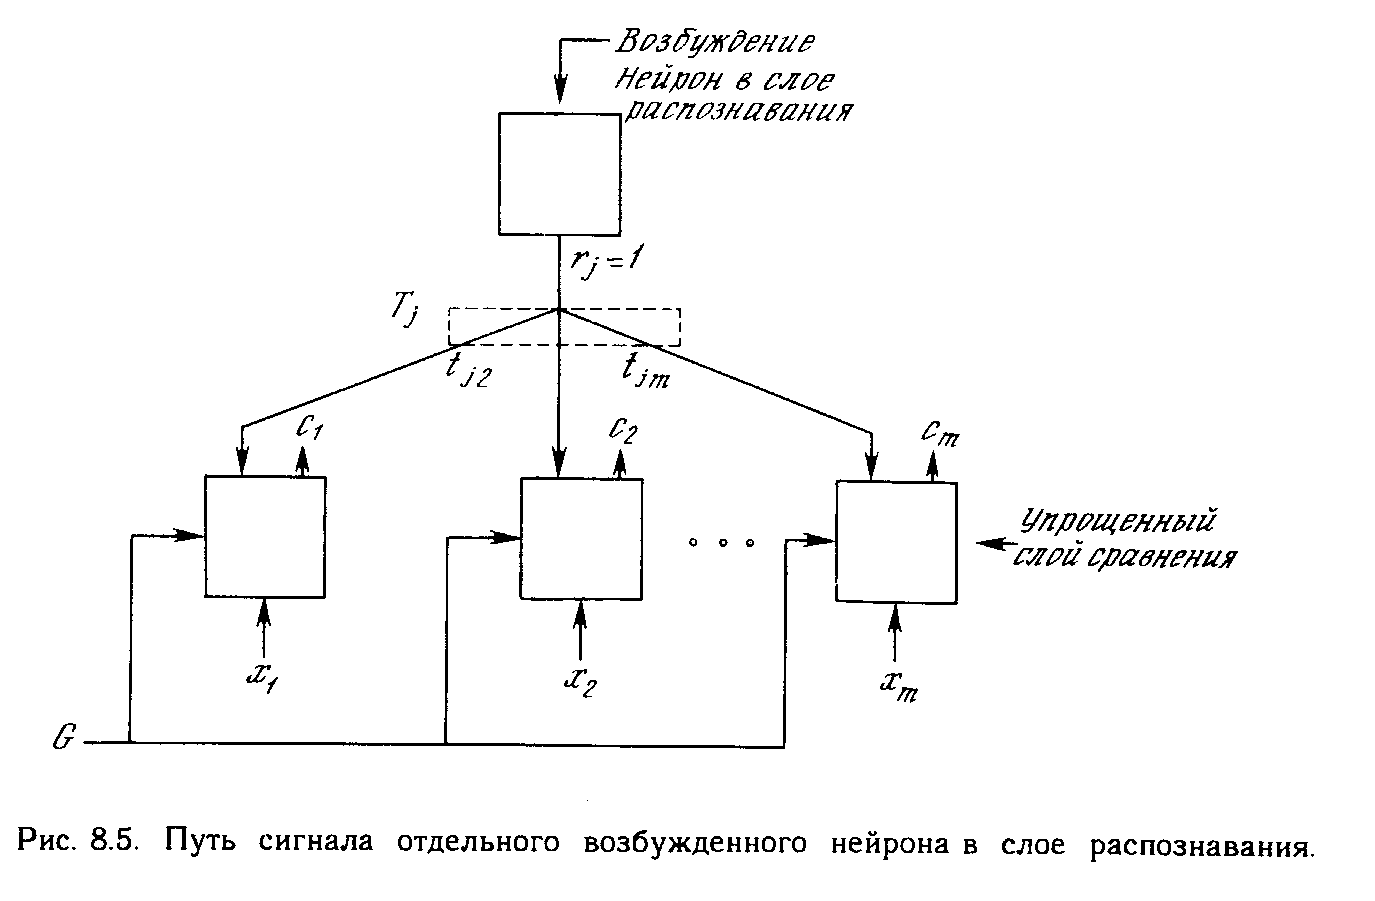
Фаза сравнения. Единственный возбужденный в слое распознавания нейрон возвращает единицу обратно в слой сравнения в виде своего выходного сигнала rj. Эта единственная единица может быть визуально представлена в виде «веерного» выхода, подающегося через отдельную связь с весом tij на каждый нейрон в слое сравнения, обеспечивая каждый нейрон сигналом рj, равным величине tji (нулю или единице) (рис. 8.5).
Алгоритмы инициализации и обучения построены таким образом, что каждый весовой вектор Тj. имеет