Нейрокомпьютерные системы
Несмотря на существующие проблемы, желание смоделировать человеческий мозг не угасает, а получение зачаровывающих результатов вдохновляет на дальнейшие усилия. Успешные модели, основанные на предположениях о структуре мозга, разрабатываются нейроанатомами и нейрофизиологами с целью их изучения для согласования структуры и функций этих моделей. С другой стороны, успехи в биологической науке ведут к модификации и тщательной разработке искуственных моделей. Аналогично инженеры применяют искусственные модели для реализации мировых проблем и получают положительные результаты, несмотря на отсутствие полного взаимопонимания.
Объединение научных дисциплин для изучения проблем искусственных нейросетей принесет эффективные результа ты, которые могут стать беспримерными в истории науки. Биологи, анатомы, физиологи, инженеры, математики и даже философы активно включились в процесс исследований. Проблемы являются сложными, но цель высока: познается сама человеческая мысль.
Приложение Б Алгоритмы обучения
Искусственные нейронные сети обучаются самыми разнообразными методами. К счастью, большинство методов обучения исходят из общих предпосылок и имеет много идентичных характеристик. Целью данного приложения является обзор некоторых фундаментальных алгоритмов, как с точки зрения их текущей применимости, так и с ' точки зрения их исторической важности. После ознакомления с этими фундаментальными алгоритмами другие, основанные на них, алгоритмы будут достаточно легки для понимания и новые разработки также могут быть лучше поняты и развиты.
ОБУЧЕНИЕ С УЧИТЕЛЕМ И БЕЗ УЧИТЕЛЯ
Обучающие алгоритмы могут быть классифицированы как алгоритмы обучения с учителем и без учителя. В первом случае существует учитель, который предъявляет входные образы сети, сравнивает результирующие выходы с требуемыми, а затем настраивает веса сети таким образом, чтобы уменьшить различия. Трудно представить такой обучающий механизм в биологических системах; следовательно, хотя данный подход привел к большим успехам при решении прикладных задач, он отвергается исследователями, полагающими, что искусственные нейронные сети обязательно должны использовать те же механизмы, что и человеческий мозг.
Во втором случае обучение проводится без учителя, при предъявлении входных образов сеть самоорганизуется посредством настройки своих весов согласно определенному алгоритму. Вследствие отсутствия указания требуемого выхода в процессе обучения результаты непредсказуемы с точки зрения определения возбуждающих образов для конкретных нейронов. При этом, однако, сеть организуется в форме, отражающей существенные характеристики обучающего набора. Например, входные образы могут быть классифицированы согласно степени их сходства так, что образы одного класса активизируют один и тот же выходной ней рон.
МЕТОД ОБУЧЕНИЯ ХЭББА
Работа [2] обеспечила основу для большинства алгоритмов обучения, которые были разработаны после ей выхода. В предшествующих этой работе трудах в обп^ виде определялось, что обучение в биологических системах происходит посредством некоторых физических изменений в нейронах, однако отсутствовали идеи о том, каки» образом это в действительности может иметь место. Основываясь на физиологических и психологических исследованиях, Хэбб в [2] интуитивно выдвинул гипотезу о том, каким образом может обучаться набор биологических нейронов. Его теория предполагает только локальное взаимодействие между нейронами при отсутствии глобального учителя; следовательно, обучение является неуправляемым. Несмотря на то что его работа не включает математического анализа, идеи, изложенные в ней, настолько ясны и непринужденны, что получили статус универсальных допущений. Его книга стала классической и широко изучается специалистами, имеющими серьезный интерес в этой области.
Алгоритм обучения Хебба
По существу Хэбб предположил, что синаптическое соединение двух нейронов усиливается, если оба эти нейрона возбуждены. Это можно представить как усиление синапса в соответствии с корреляцией уровней возбужденных нейронов, соединяемых данным синапсом. По этой причине алгоритм обучения Хэбба иногда называется корреляционным алгоритмом. Идея алгоритма выражается следующим равенством:
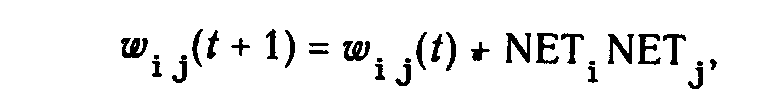
где ij(t) - сила синапса от нейрона i к нейрону j ,в момент времени t, NETi - уровень возбуждения пресинаптического нейрона; NETj - уровень возбуждения постсинаптического нейрона.
Концепция Хэбба отвечает на сложный вопрос, каким образом обучение может проводиться без учителя. В методе Хэбба обучение является исключительно локальным явлением, охватывающим только два нейрона и соединяющий их синапс; не требуется глобальной системы обратной связи для развития нейронных образований.
Последующее использование метода Хэбба для обучения нейронных сетей привело к большим успехам, но наряду с этим показало ограниченность метода; некоторые образы просто не могут использоваться для обучения этим методом. В результате появилось большое количество расширений и нововведений, большинство из которых в значительной степени основано на работе Хэбба.
Метод сигнального обучения Хэбба
Как мы видели, выход NET простого искусственного нейрона является взвешенной суммой его входов. Это может быть выражено следующим образом:
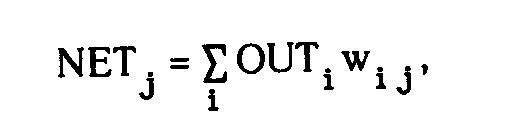
где NETj - выход NET нейрона j; OUTi - выход нейрона i; w,. - вес связи нейрона i с нейроном j. Можно показать, что в этом случае линейная многослойная сеть не является более мощной, чем однословная сеть; рассматриваемые возможности сети могут быть улучшены только введением нелинейности в передаточную функцию нейрона. Говорят, что сеть, использующая сигмои-дальную функцию активации и метод обучения Хэбба, обучается по сигнальному методу Хэбба. В этом случае уравнение Хэбба модифицируется следующим образом:
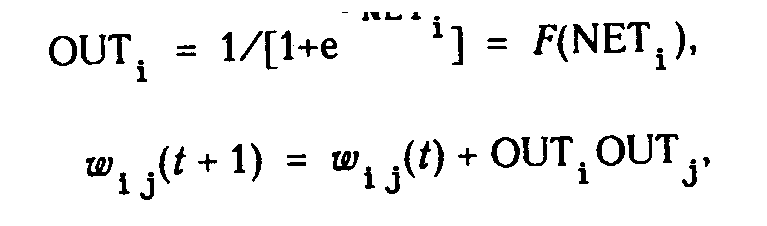
где ij(t) - сила синапса от нейрона i к нейрону j в момент времени t, OUTi - выходной уровень пресинаптического нейрона равный F(NETi); OUTj - выходной уровень постсинаптического нейрона равный F(NETj).
Метод дифференциального обучения Хэбба
Метод сигнального обучения Хэбба предполагает вычисление свертки предыдущих изменений выходов для определения изменения весов. Настоящий метод, называемый методом дифференциального обучения Хэбба, использует следующее равенство:
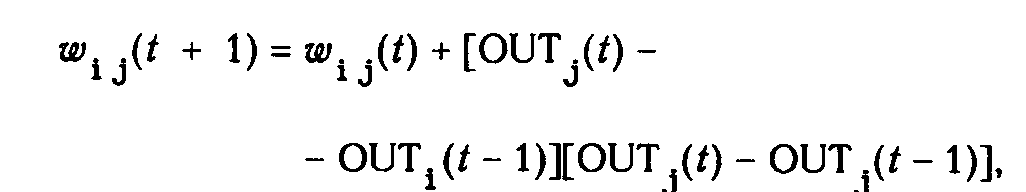
где ij(t) - сила синапса от нейрона i к нейрону j в момент времени t, OUTi(t) - выходной уровень пресинап-тического нейрона в момент времени t, OUTj(t) - выходной уровень постсинаптического нейрона в момент времени t.
ВХОДНЫЕ И ВЫХОДНЫЕ ЗВЕЗДЫ
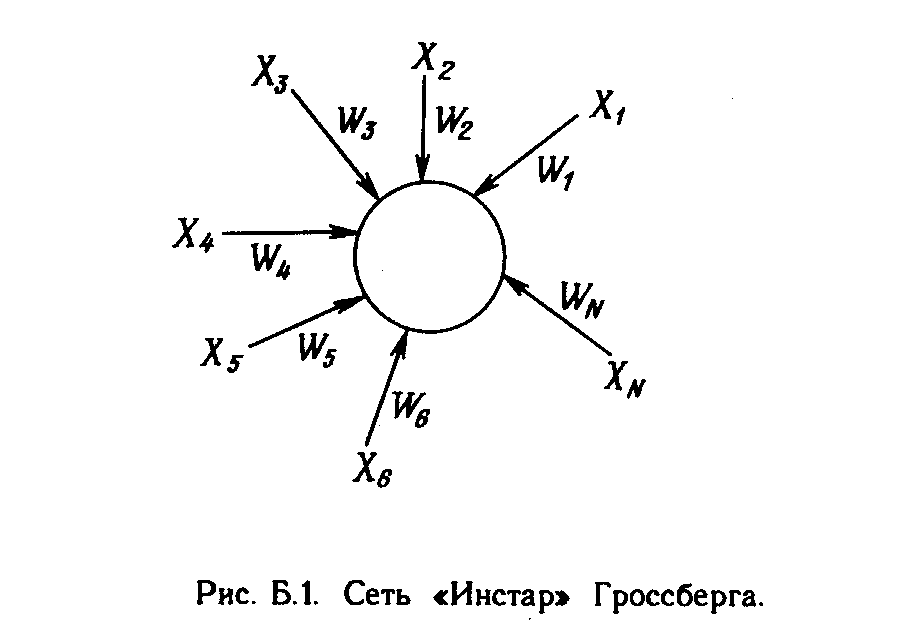
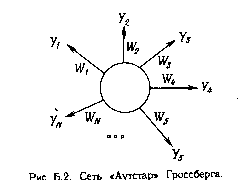
Много общих идей, используемых в искусственных нейронных сетях, прослеживаются в работах Гроссберга; в качестве примера можно указать конфигурации входных и выходных звезд [1], используемые во многих сетевых парадигмах. Входная звезда, как показано на рис. Б.1, состоит из нейрона, на который подается группа входов через синапсические веса. Выходная звезда, показанная на рис. Б.2, является нейроном, управляющим группой весов. Входные и выходные звезды могут быть взаимно соединены в сети любой сложности; Гроссберг рассматривает их как модель определенных биологических функций. Вид звезды определяет ее название, однако звезды обычно изображаются в сети иначе.
Обучение входной звезды
Входная звезда выполняет распознавание образов, т.е. она обучается реагировать на определенный входной вектор Хинина какой другой. Это обучение реализуется путем настройки весов таким образом, чтобы они соответствовали входному вектору. Выход входной звезды определяется как взвешенная сумма ее входов, как это описано в предыдущих разделах. С другой точки зрения, выход можно рассматривать как свертку входного вектора с весовым вектором, меру сходства нормализованных векторов. Следовательно, нейрон должен реагировать наиболее сильно на входной образ, которому был обучен. Процесс обучения выражается следующим образом:
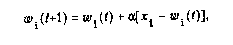
где i - вес входа хi ; хi - i-й вход; - нормирующий коэффициент обучения, который имеет начальное значение 0,1 и постепенно уменьшается в процессе обучения. После завершения обучения предъявление входного вектора Х будет активизировать обученный входной нейрон. Это можно рассматривать как единый обучающий цикл, если « установлен в 1, однако в этом случае исключается способность входной звезды к обобщению. Хорошо обученная входная звезда будет реагировать не только на определенный единичный вектор, но также и на незначительные изменения этого вектора. Это достигается постепенной настройкой нейронных весов при предъявлении в процессе обучения векторов, представляющих нормальные вариации входного вектора. Веса настраиваются таким образом, чтобы усреднить величины обучающих векторов, и нейроны получают способность реагировать на любой вектор этого класса.
Обучение выходной звезды
В то время как входная звезда возбуждается всякий раз при появлении определенного входного вектора, выходная звезда имеет дополнительную функцию; она вырабатывает требуемый возбуждающий сигнал для других нейронов всякий раз, когда возбуждается. Для того чтобы обучить нейрон выходной звезды, его веса настраиваются в соответствии с требуемым целевым вектором. Алгоритм обучения может быть представлен символически следующим образом:
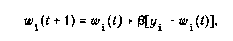
где представляет собой нормирующий коэффициент обучения, который в начале приблизительно равен единице и постепенно уменьшается до нуля в процессе обучения. Как и в случае входной звезды, веса выходной звезды, постепенно настраиваются над множеством векторов, представляющих собой обычные вариации идеального вектора. В этом случае выходной сигнал нейронов представляет собой статистическую характеристику обучающего набора и может в действительности сходиться в процессе обучения к идеальному вектору при предъявлении только искаженных версий вектора.
ОБУЧЕНИЕ ПЕРСЕПТРОНА
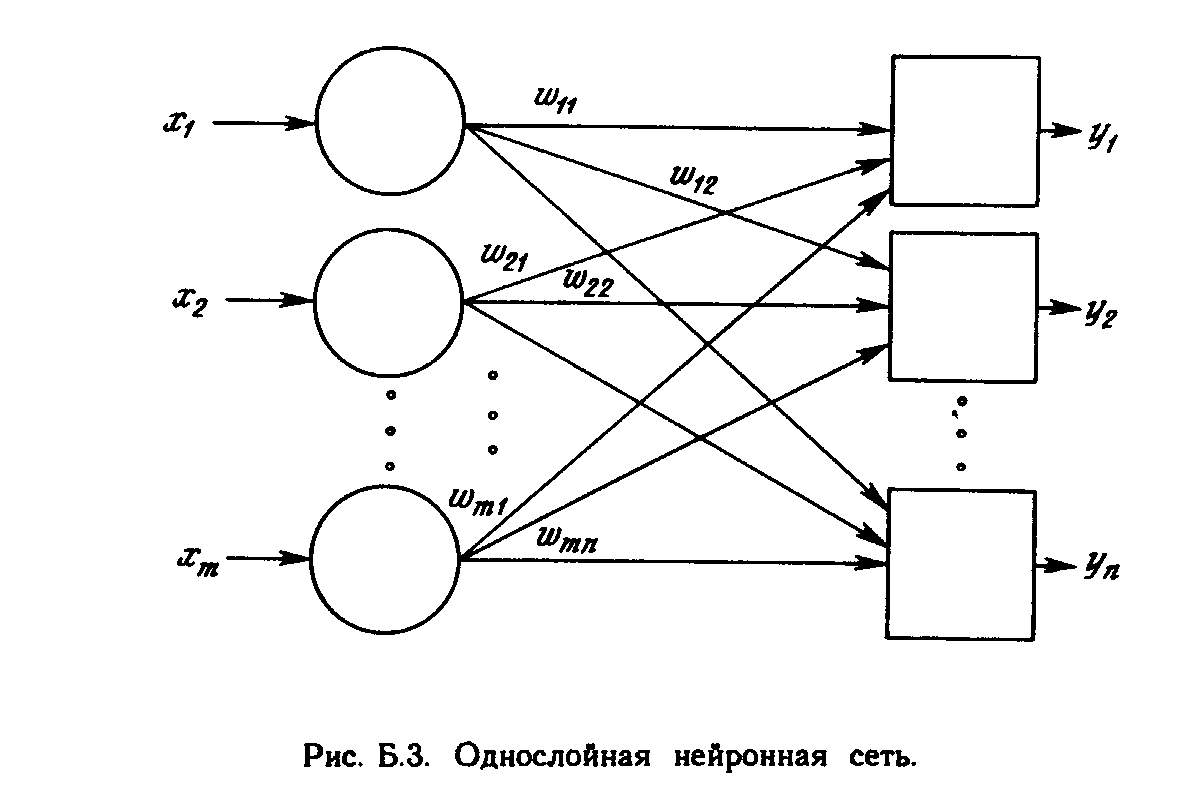
В 1957 г. Розенблатт [4] разработал модель, которая вызвала большой интерес у исследователей. Несмотря на некоторые ограничения ее исходной формы, она стала основой для многих современных, наиболее сложных алгоритмов обучения с учителем. Персептрон является настолько важным, что вся гл. 2 посвящена его описанию; однако это описание является кратким и приводится в формате, несколько отличном от используемого в [4]. Персептрон является двухуровневой, нерекуррентной сетью, вид которой показан на рис. Б.З. Она использует алгоритм обучения с учителем; другими словами, обучающая выборка состоит из множества входных векторов, для каждого из которых указан свой требуемый вектор цели. Компоненты входного вектора представлены непрерывным диапазоном значений; компоненты вектора цели являются двоичными величинами (0 или 1). После обучения сеть получает на входе набор непрерывных входов и вырабатывает требуемый выход в виде вектора с бинарными компонентами. Обучение осуществляется следующим образом: 1. Рандомизируются все веса сети в малые величины. 2. На вход сети подается входной обучающий вектор Х и вычисляется сигнал NET от каждого нейрона, используя стандартное выражение
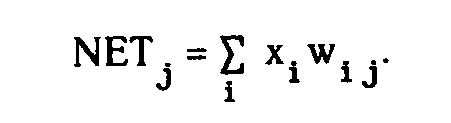
Вычисляется значение пороговой функции актива ции для сигнала NET от каждого нейрона следующим обра зом:
OUTj = 1, если NET больше чем порог j,
OUTj = 0, в противном случае.
Здесь j представляет собой порог, соответствующий нейрону j (в простейшем случае, все нейроны имеют один и тот же порог).
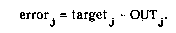
4. Вычисляется ошибка для каждого нейрона посредством вычитания полученного выхода из требуемого выхода:
5. Каждый вес модифицируется следующим образом:
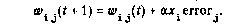
6. Повторяются шаги со второго по пятый до тех пор, пока ошибка не станет достаточно малой.
МЕТОД ОБУЧЕНИЯ УИДРОУ—ХОФФА
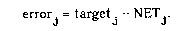
Как мы видели, персептрон ограничивается бинарными выходами. Уидроу вместе со студентом университета Хоф-фом расширили алгоритм обучения персептрона на случай непрерывных выходов, используя сигмоидальную функцию [5,6]. Кроме того, они разработали математическое доказательство того, что сеть при определенных условиях будет сходиться к любой функции, которую она может представить. Их первая модель - Адалин - имеет один выходной нейрон, более поздняя модель - Мадалин - расширяет ее на случай с многими выходными нейронами. Выражения, описывающие процесс обучения Адалина, очень схожи с персептронными. Существенные отличия имеются в четвертом шаге, где используются непрерывные сигналы NET вместо бинарных OUT. Модифицированный шаг 4 в этом случае реализуется следующим образом: 4. Вычислить ошибку для каждого нейрона, вычитая сигнал NET из требуемого выхода:
МЕТОДЫ СТАТИСТИЧЕСКОГО ОБУЧЕНИЯ
В гл. 5 детально описаны статистические методы обучения, поэтому здесь приводится лишь обзор этих методов. Однослойные сети несколько ограничены с точки зрения проблем, которые они могут решать; однако в течение многих лет отсутствовали методы обучения многослойных сетей. Статистическое обучение обеспечивает путь решения этих проблем. По аналогии обучение сети статистическими способами подобно процессу отжига металла. В процессе отжига температура металла вначале повышается, пока атомы металла не начнут перемещаться почти свободно. Затем температура постепенно уменьшается и атомы непрерывно стремятся к минимальной энергетической конфигурации. При некоторой низкой температуре атомы переходят на низший энергетический уровень. В искуственн.ых нейронных сетях полная величина энергии сети определяется как функция определенного множества сетевых переменных. Искусственная переменная температуры инициируется в большую величину, тем самым позволяя сетевым переменным претерпевать большие случайные изменения. Изменения, приводящие к уменьшению полной энергии сети, сохраняются; изменения, приводящие к увеличению энергии, сохраняются в соответствии с вероятностной функцией. Искусственная температура постепенно уменьшается с течением времени и сеть конвергирует в состояние минимума полной энергии. Существует много вариаций на тему статистического обучения. Например, глобальная энергия может быть определена как средняя квадратичная ошибка между полученным и желаемым выходным вектором из обучаемого множества, а переменными могут быть веса сети. В этом случае сеть может быть обучена, начиная с высокой искусственной температуры, путем выполнения следующих шагов:
Подать обучающий вектор на вход сети и вычислить выход согласно соответствующим сетевым правилам.
Вычислить значение средней квадратичной ошибки между желаемым и полученным выходными векторами.
Изменить сетевые веса случайным образом, затем вычислить новый выход и результирующую ошибку. Если ошибка уменьшилась, оставить измененный вес; если ошибка увеличилась, оставить измененный вес с вероятностью, определяемой распределением Больцмана. Если изменения весов не производится, то вернуть вес к его предыдущему значению.
Повторить шаги с 1 по 3, постепенно уменьшая искусственную температуру. Если величина случайного изменения весов определяется в соответствии с распределением Больцмана, сходимость к глобальному минимуму будет осуществляться только в том случае, если температура изменяется обратно пропорционально логарифму прошедшего времени обучения. Это может привести к невероятной длительности процесса обучения, поэтому большое внимание уделялось поиску более быстрых методов обучения. Выбором размера шага в соответствии с распределением Коши может быть достигнуто уменьшение температуры, обратно пропорциональное обучающему времени, что существенно уменьшает время, требуемое для сходимости. Заметим, что существует класс статистических методов для нейронных сетей, в которых переменными сети являются выходы нейронов, а не веса. В гл. 5 эти алгоритмы рассматривались подробно.
САМООРГАНИЗАЦИЯ
В работе [3] описывались интересные и полезные результаты исследований Кохонена на самоорганизующихся структурах, используемых для задач распознавания образов. Вообще эти структуры классифицируют образы, представленные векторными величинами, в которых каждый компонент вектора соответствует элементу образа. Алгоритмы