Нейрокомпьютерные системы
О = F(XW). (3.3)
Выходной вектор одного слоя является входным век тором для следующего, поэтому вычисление выходов последнего слоя требует применения уравнения (3.3) к каждому слою от входа сети к ее выходу.
Обратный проход. Подстройка весов выходного слоя. Так как для каждого нейрона выходного слоя задано целевое значение, то подстройка весов легко осуществляется с использованием модифицированного дельта-правила из гл. 2. Внутренние слои называют «скрытыми слоями», для их выходов не имеется целевых значений для сравнения. Поэтому обучение усложняется. На рис. 3.5 показан процесс обучения для одного веса от нейрона р в скрытом слое j к нейрону в q выходном слое k. Выход нейрона слоя k, вычитаясь из целевого значения (Target), дает сигнал ошибки. Он умножается на производную сжимающей функции [OUT(1 - OUT)], вычисленную для этого нейрона слоя k, давая, таким образом, величину .
= OUT(1 - OUT)(Target - OUT). (3.4)
Затем умножается на величину OUT нейрона, из которого выходит для рассматриваемый вес. Это произведение в свою очередь умножается на коэффициент скорости обучения (обычно от 0,01 до 1,0), и результат прибавляется к весу. Такая же процедура выполняется каждого веса от нейрона скрытого слоя к нейрону в выходном слое. Следующие уравнения иллюстрируют это вычисление:
wpq,k=q,kOUTp,j, (3.5)
wpq,k(n+1) = wpq,k(n) + wpq,k, (3.6)
где wpq,k {n) - величина веса от нейрона n в скрытом, слое к нейрону q в выходном слое на шаге п (до коррекции); отметим, что индекс k относится к слою, в котором заканчивается данный вес, т.е., согласно принятому в этой книге соглашению, с которым он объединен; wpq,k (n+1)- величина веса на шаге п + 1 (после коррекции); q,k- величина для нейрона q в выходном слое k, OUTp,j - величина OUT для нейрона р в скрытом слое j.
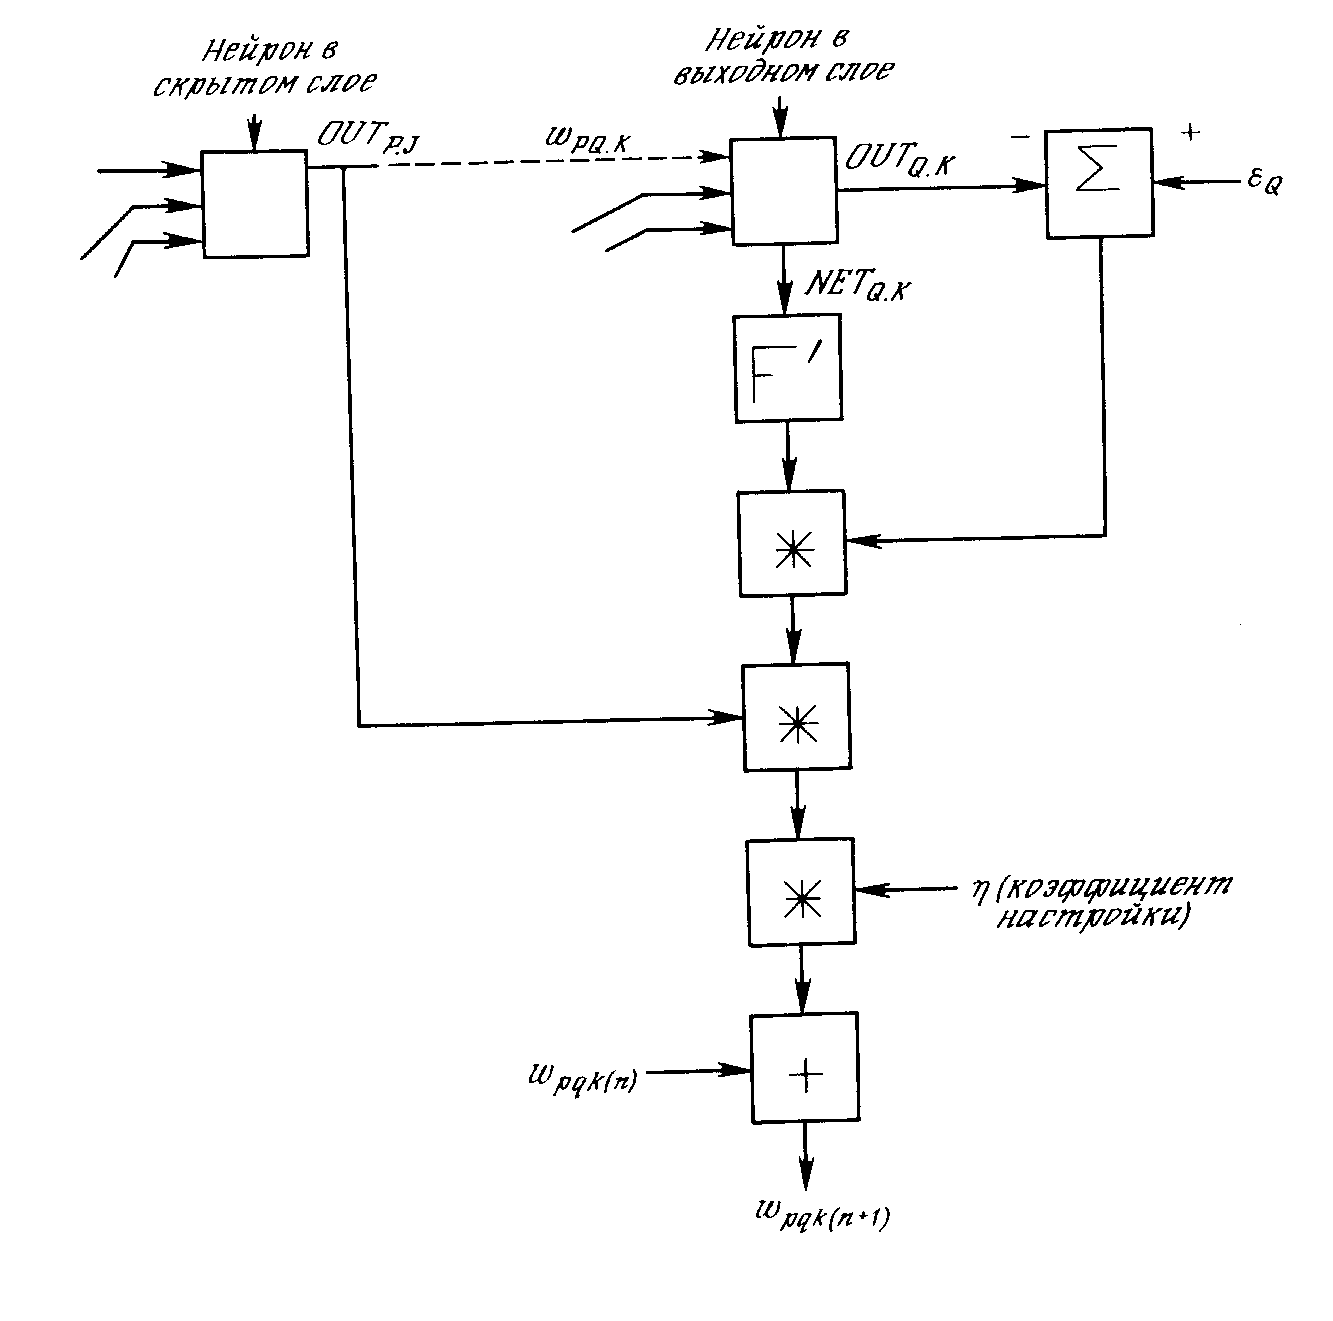
Рис.3.5. Настройка веса в выходном слое.
Подстройка весов скрытого слоя. Рассмотрим один нейрон в скрытом слое, предшествующем выходному слою. При проходе вперед этот нейрон передает свой выходной сигнал нейронам в выходном слое через соединяющие их веса. Во время обучения эти веса функционируют в обратном порядке, пропуская величину от выходного слоя назад к скрытому слою. Каждый из этих весов умножается на величину нейрона, к которому он присоединен в выходном слое. Величина , необходимая для нейрона скрытого слоя, получается суммированием всех таких произведений и умножением на производную сжимающей функции:
p,q
= OUTp,j
(1 - OUTp,j)(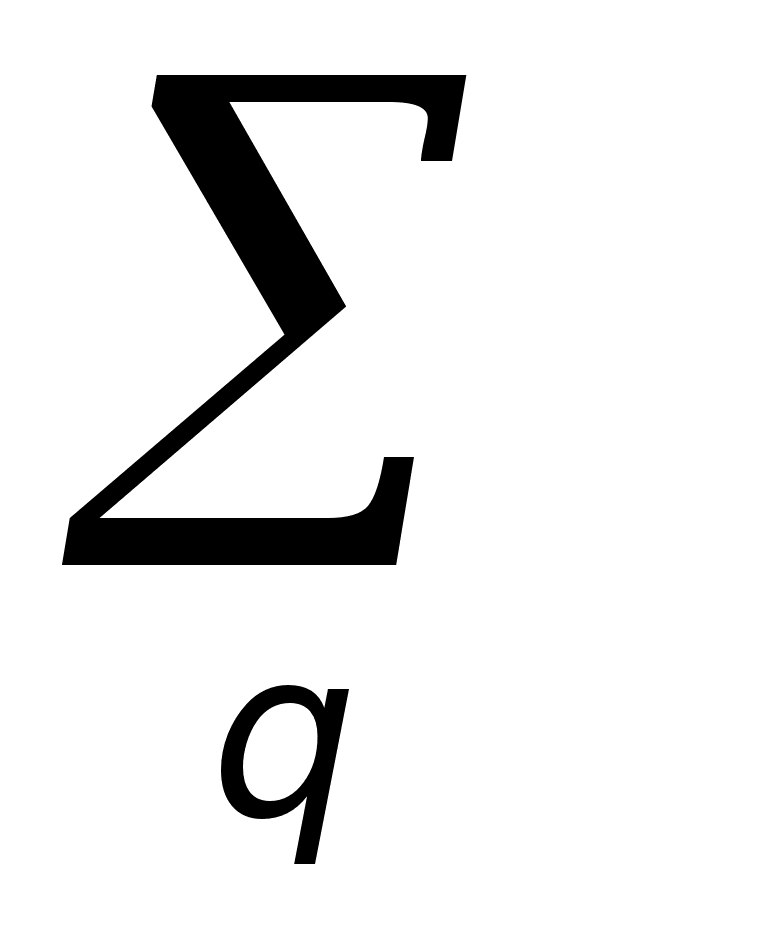 p,kwpq,k) (3.7)
(см. рис.3.6). Когда значение получено, веса, питающие первый скрытый уровень, могут быть подкорректированы с помощью уравнений (3.5) и (3.6), где индексы модифицируются в соответствии со слоем.
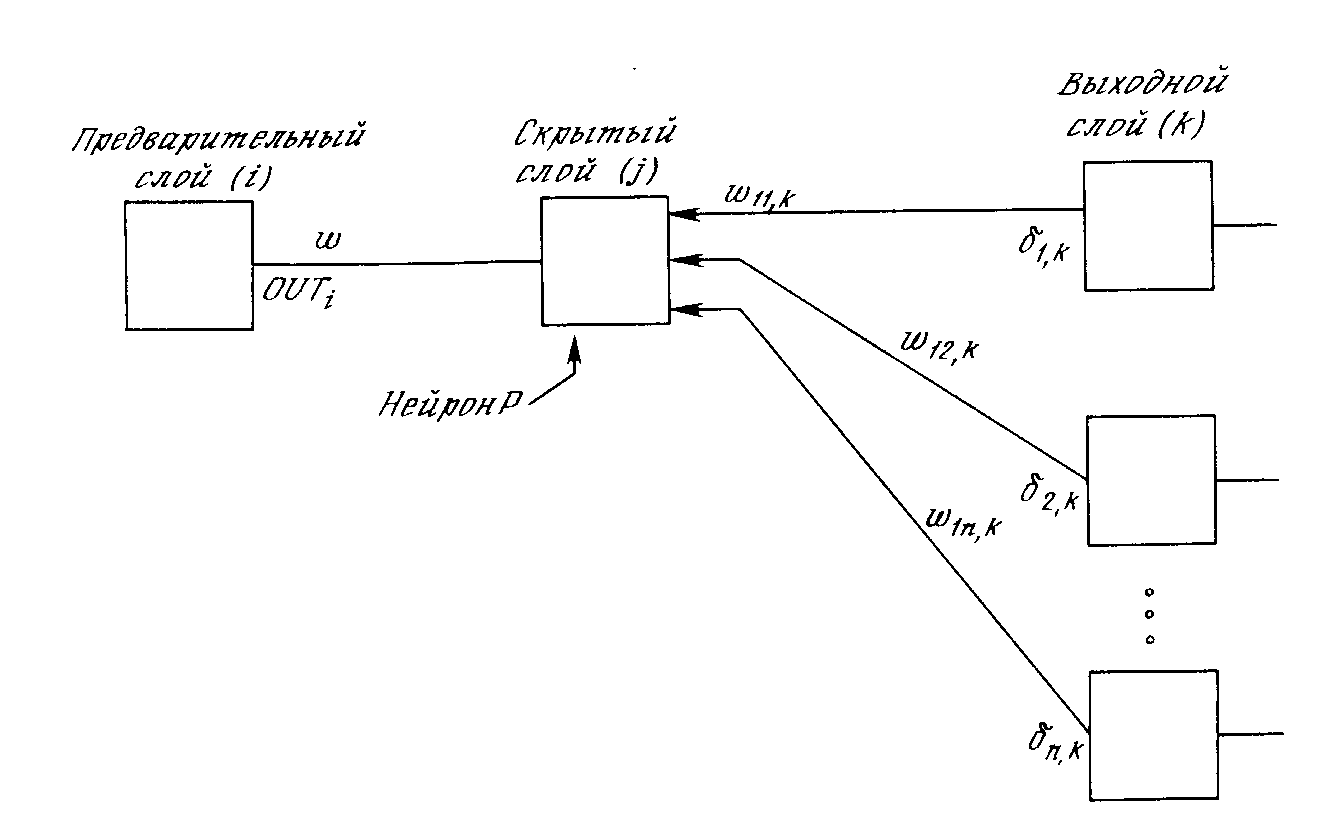
Рис.З.6. Настройка веса в скрытом слое.
Для каждого нейрона в данном скрытом слое должно быть вычислено и подстроены все веса, ассоциированные с этим слоем. Этот процесс повторяется слой за слоем по направлению к входу, пока все веса не будут подкорректированы. С помощью векторных обозначений операция обратного распространения ошибки может быть записана значительно компактнее. Обозначим множество величин выходного слоя через Dk и множество весов выходного слоя как массив W’k . Чтобы получить Dj, -вектор выходного слоя, достаточно следующих двух операций:
1. Умножить - вектор выходного слоя Dk на транспонированную матрицу весов W’k, соединяющую скрытый уровень с выходным уровнем.
2. Умножить каждую компоненту полученного произведения на производную сжимающей функции соответствующего нейрона в скрытом слое.
В символьной записи
Dj = DkW ‘k $ [Оj $(1- Oj)], (3.8)
где оператор $ в данной книге обозначает покомпонентное произведение векторов. О. - выходной вектор слоя j и 1 - вектор, все компоненты которого равны 1.
Добавление нейронного смещения. Во многих случаях желательно наделять каждый нейрон обучаемым смещением. Это позволяет сдвигать начало отсчета логистической функции, давая эффект, аналогичный подстройке порога персептронного нейрона, и приводит к ускорению процесса обучения. Эта возможность может быть легко введена в обучающий алгоритм с помощью добавляемого к каждому нейрону веса, присоединенного к +1. Этот вес обучается так же, как и все остальные веса, за исключением того, что подаваемый на него сигнал всегда равен +1, а не выходу нейрона предыдущего слоя.
Импульс. В работе [7] описан метод ускорения обучения для алгоритма обратного распространения, увеличивающий также устойчивость процесса. Этот метод, названный импульсом, заключается в добавлении к коррекции веса члена, пропорционального величине предыдущего изменения веса. Как только происходит коррекция, она «запоминается» и служит для модификации всех последующих коррекций. Уравнения коррекции модифицируются следующим образом:
 wpq,k(n+1)
=
(q,kOUTp,j)
+ (wpq,k(n)), (3.9)
wpq,k(n+1)
= wpq,k(n)
+ wpq,k(n+1)), (3.10)
где - коэффициент импульса, обычно устанавливается около 0,9.Используя метод импульса, сеть стремится идти по дну узких оврагов поверхности ошибки (если таковые имеются), а не двигаться от склона к склону. Этот метод, по-видимому, хорошо работает на некоторых задачах, но дает слабый или даже отрицательный эффект на других. В работе [8] описан сходный метод, основанный на экспоненциальном сглаживании, который может иметь преимущество в ряде приложений.
wpq,k(n+1)
=
wpq,k(n)
+ ( 1-
)q,kOUTp,j
. (3.11)
wpq,k(n+1)
= wpq,k(n)
+ wpq,k(n+1)), (3.12)
где коэффициент сглаживания, варьируемый и диапазоне от 0,0 до 1,0. Если равен 1,0, то новая коррекция игнорируется и повторяется предыдущая. В области между 0 и 1 коррекция веса сглаживается величиной, пропорциональной . По-прежнему, является коэффициентом скорости обучения, служащим для управления средней величиной изменения веса.
ДАЛЬНЕЙШИЕ АЛГОРИТМИЧЕСКИЕ РАЗРАБОТКИ
Многими исследователями были предложены улучшения и обобщения описанного выше основного алгоритма обратного распространения. Литература в этой области слишком обширна, чтобы ее можно было здесь охватить. Кроме того, сейчас еще слишком рано давать окончательные оценки. Некоторые из этих подходов могут оказаться действительно фундаментальными, другие же со временем исчезнут. Некоторые из наиболее многообещающих разработок обсуждаются в этом разделе. В [5] описан метод ускорения сходимости алгоритма обратного распространения. Названный обратным распространением второго порядка, он использует вторые производные для более точной оценки требуемой коррекции весов. В [5] показано, что этот алгоритм оптимален в том смысле, что невозможно улучшить оценку, используя производные более высокого порядка. Метод требует дополнительных вычислений по сравнению с обратным распространением первого порядка, и необходимы дальнейшие эксперименты для доказательства оправданности этих затрат. В [9] описан привлекательный метод улучшения характеристик обучения сетей обратного распространения. В работе указывается, что общепринятый от 0 до 1 динамический диапазон входов и выходов скрытых нейронов неоптимален. Так как величина коррекции веса wpq,k пропорциональна выходному уровню нейрона, порождающего OUTp,q, то нулевой уровень ведет к тому, что вес не меняется. При двоичных входных векторах половина входов в среднем будет равна нулю, и веса, с которыми они связаны, не будут обучаться! Решение состоит в приведении входов к значениям ±1/2 и добавлении смещения к сжимающей функции, чтобы она также принимала значения ±1/2. Новая сжимающая функция выглядит следующим образом:
OUT =-1/2 + 1 / (exp(-NET) + 1). (3.13)
С помощью таких простых средств время сходимости сокращается в среднем от 30 до 50%. Это является одним из примеров практической модификации, существенно улучшающей характеристику алгоритма. В [6] и [1] описана методика применения обратного распространения к сетям с обратными связями, т.е. к таким сетям, у которых выходы подаются через обратную связь на входы. Как показано в этих работах, обучение в подобных системах может быть очень быстрым и критерии устойчивости легко удовлетворяются.
ПРИМЕНЕНИЯ
Обратное распространение было использовано в широкой сфере прикладных исследований. Некоторые из них описываются здесь, чтобы продемонстрировать мощь этого метода. Фирма NEC в Японии объявила недавно, что обратное распространение было ею использовано для визуального распознавания букв, причем точность превысила 99%. Это улучшение было достигнуто с помощью комбинации обычных алгоритмов с сетью обратного распространения, обеспечивающей дополнительную проверку. В работе [8] достигнут впечатляющий успех с NetTalk, системой, которая превращает печатный английский текст в высококачественную речь. Магнитофонная запись процесса обучения сильно напоминает звуки ребенка на разных этапах обучения речи. В [2] обратное распространение использовалось в машинном распознавании рукописных английских слов. Буквы, нормализованные по размеру, наносились на сетку, и брались проекции линий, пересекающих квадраты сетки. Эти проекции служили затем входами для сети обратного распространения. Сообщалось о точности 99,7% при использовании словарного фильтра. В [3] сообщалось об успешном применении обратного распространения к сжатию изображений, когда образы представлялись одним битом на пиксель, что было восьмикратным улучшением по сравнению с входными данными.
ПРЕДОСТЕРЕЖЕНИЕ
Несмотря на многочисленные успешные применения обратного распространения, оно не является панацеей. Больше всего неприятностей приносит неопределенно долгий процесс обучения. В сложных задачах для обучения сети могут потребоваться дни или даже недели, она может и вообще не обучиться. Длительное время обучения может быть результатом неоптимального выбора длины шага. Неудачи в обучении обычно возникают по двум причинам: паралича сети и попадания в локальный минимум.
Паралич сети
В процессе обучения сети значения весов могут в результате коррекции стать очень большими величинами. Это может привести к тому, что все или большинство нейронов будут функционировать при очень больших значениях OUT, в области, где производная сжимающей функции очень мала. Так как посылаемая обратно в процессе обучения ошибка пропорциональна этой производной, то процесс обучения может практически замереть. В теоретическом отношении эта проблема плохо изучена. Обычно этого избегают уменьшением размера шага т), но это увеличивает время обучения. Различные эвристики использовались для предохранения от паралича или для восстановления после него, но пока что они могут рассматриваться лишь как экспериментальные.
Локальные минимумы
Обратное распространение использует разновидность градиентного спуска, т.е. осуществляет спуск вниз по поверхности ошибки, непрерывно подстраивая веса в направлении к минимуму. Поверхность ошибки сложной сети сильно изрезана и состоит из холмов, долин, складок и оврагов в пространстве высокой размерности. Сеть может попасть в локальный минимум (неглубокую долину), когда рядом имеется гораздо более глубокий минимум. В точке локального минимума все направления ведут вверх, и сеть неспособна из него выбраться. Статистические методы обучения могут помочь избежать этой ловушки, но они медленны. В [10] предложен метод, объединяющий статистические методы машины Коши с градиентным спуском обратного распространения и приводящий к системе, которая находит глобальный минимум, сохраняя высокую скорость обратного распространения. Это обсуждается в гл. 5.
Размер шага
Внимательный разбор доказательства сходимости в [7] показывает, что коррекции весов предполагаются бесконечно малыми. Ясно, что это неосуществимо на практике, так как ведет к бесконечному времени обучения. Размер шага должен браться конечным, и в этом вопросе приходится опираться только на опыт. Если размер шага очень мал, то сходимость слишком медленная, если же очень велик, то может возникнуть паралич или постоянная неустойчивость. В [II] описан адаптивный алгоритм выбора шага, автоматически корректирующий размер шага в процессе обучения.
Временная неустойчивость
Если сеть учится распознавать буквы, то нет смысла учить Б, если при этом забывается А. Процесс обучения должен быть таким, чтобы сеть обучалась на всем обучающем множестве без пропусков того, что уже выучено. В доказательстве сходимости [7] это условие выполнено, но требуется также, чтобы сети предъявлялись все векторы обучающего множества прежде, чем выполняется коррекция весов. Необходимые изменения весов должны вычисляться на всем множестве, а это требует дополнительной памяти; после ряда таких обучающих циклов веса сойдутся к минимальной ошибке. Этот метод может оказаться бесполезным, если сеть находится в постоянно меняющейся внешней среде, так что второй раз один и тот же вектор может уже не повториться. В этом случае процесс обучения может никогда не сойтись, бесцельно блуждая или сильно осциллируя. В этом смысле обратное распространение не похоже на биологические системы. Как будет указано в гл.8 это несоответствие (среди прочих) привело к системе ART , принадлежавшей Гроссбергу.
Глава 4 Сети встречного распространения
ВВЕДЕНИЕ В СЕТИ ВСТРЕЧНОГО РАСПРОСТРАНЕНИЯ
Возможности сети встречного распространения, разработанной в [5-7], превосходят возможности однослойных сетей. Время же обучения по сравнению с обратным распространением может уменьшаться в сто раз. Встречное распространение не столь общо, как обратное распространение, но оно может давать решение в тех приложениях, где долгая обучающая процедура невозможна. Будет показано, что помимо преодоления ограничений других сетей встречное распространение обладает собственными интересными и полезными свойствами. Во встречном распространении объединены два хорошо известных алгоритма: самоорганизующаяся карта