Модель распределения
Принимаем значения эмпирической функции распределения в точке t равным следующему значению (табл.1.4):
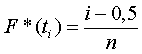 |
где i= 1, 2,...,n. При t< t1 F*(t)=0, а при t>tn F*(t)=l.
Таблица 1.4.
| F*(ti) | |
| 1 | 2 |
| 1 | 0,016667 |
| 2 | 0,05 |
| 3 | 0,083333 |
| 4 | 0,116667 |
| 5 | 0,15 |
| 6 | 0,183333 |
| 7 | 0,216667 |
| 8 | 0,25 |
| 9 | 0,283333 |
| 10 | 0,316667 |
| 11 | 0,35 |
| 12 | 0,383333 |
| 13 | 0,416667 |
| 14 | 0,45 |
| 15 | 0,483333 |
| 16 | 0,516667 |
| 17 | 0,55 |
| 18 | 0,583333 |
| 19 | 0,616667 |
| 20 | 0,65 |
| 21 | 0,683333 |
| 22 | 0,716667 |
| 23 | 0,75 |
| 24 | 0,783333 |
| 25 | 0,816667 |
| 26 | 0,85 |
| 27 | 0,883333 |
| 28 | 0,916667 |
| 29 | 0,95 |
| 30 | 0,983333 |
Определим максимальное значение модуля разности между эмпирической функцией распределения F*(t) и теоретической функцией для нормального закона распределения F(t) (значения F(t) представлены в табл.3.2):
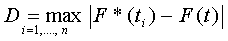 |
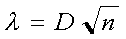 |
и определяем величину:
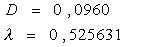 Для признака x:
Для признака y:
Затем по таблице определяем в зависимости от l вероятность Р(l), того что за счёт чисто случайных причин расхождение между F*(t) и F(t) будет не больше, чем фактически наблюдаемое.
При сравнительно больших Р(l) теоретический закон распределения можно считать совместимым с опытными данными.
Раздел 2. Исследование взаимосвязи двух количественных признаков
1. Оценка тесноты корреляционной связи
Из логических соображений выдвинем предположение, что признак (названный нами y) зависит от второго исследуемого признака x.
Используя проведенное в первом разделе разбиение значений x на интервалы, построим аналитическую таблицу:
Аналитическая таблица исследования зависимости признака y от признака x
| Группы предприятий по признаку x | Число предприятий в j-ой группе mj | Признак y | |
| Суммарное значение в группе | Среднее значение признака yi в j-ой группе на одно предприятие | ||
| 31,4 – 34,02 | 8 | 250,8 | 31,3500 |
| 34,02 – 36,64 | 9 | 298,6 | 33,1778 |
| 36,64 – 39,26 | 6 | 207,8 | 34,6333 |
| 39,26 – 41,88 | 4 | 143,8 | 35,9500 |
| 41,88 – 44,5 | 3 | 113,3 | 37,7667 |
Далее рассчитываем общую дисперсию:
 |
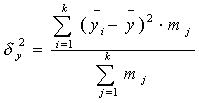 где
 - среднее значение
признака для всей выборки, и межгрупповую дисперсию:
где  - среднее значение
признака в j-й группе; mj- численность j-й группы; k - число групп.
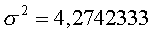 |
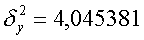 |
||
 Для оценки тесноты связи между признаками y и x рассчитываем корреляционное
отношение:
Оценку тесноты связи признаков y и x проводим по шкале Чеддока:
-если 0,3<h£0,5, то теснота связи заметная;
-если 0,5<h£0,7, то теснота связи умеренная;
-если 0,7<h£0,9, то теснота связи высокая;
-если 0,9<h£0,9(9), то теснота связи весьма высокая.
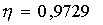 |
2. Определение формы связи двух признаков
Примерное представление о виде зависимости y от x даёт линия, проведённая через точки, соответствующие групповым средним