Серьёзные лекции по высшей экономической математике
-
x1
x2
x3
... xk
m1
m2
m3
... mk
то получится таблица, называемая дискретным вариационным рядом. Число mi называется частотой i-го значения признака.
Очевидно, что xi в ряду (*) может не совпадать с xi в вариационном ряду. Очевидна также справедливость равенства
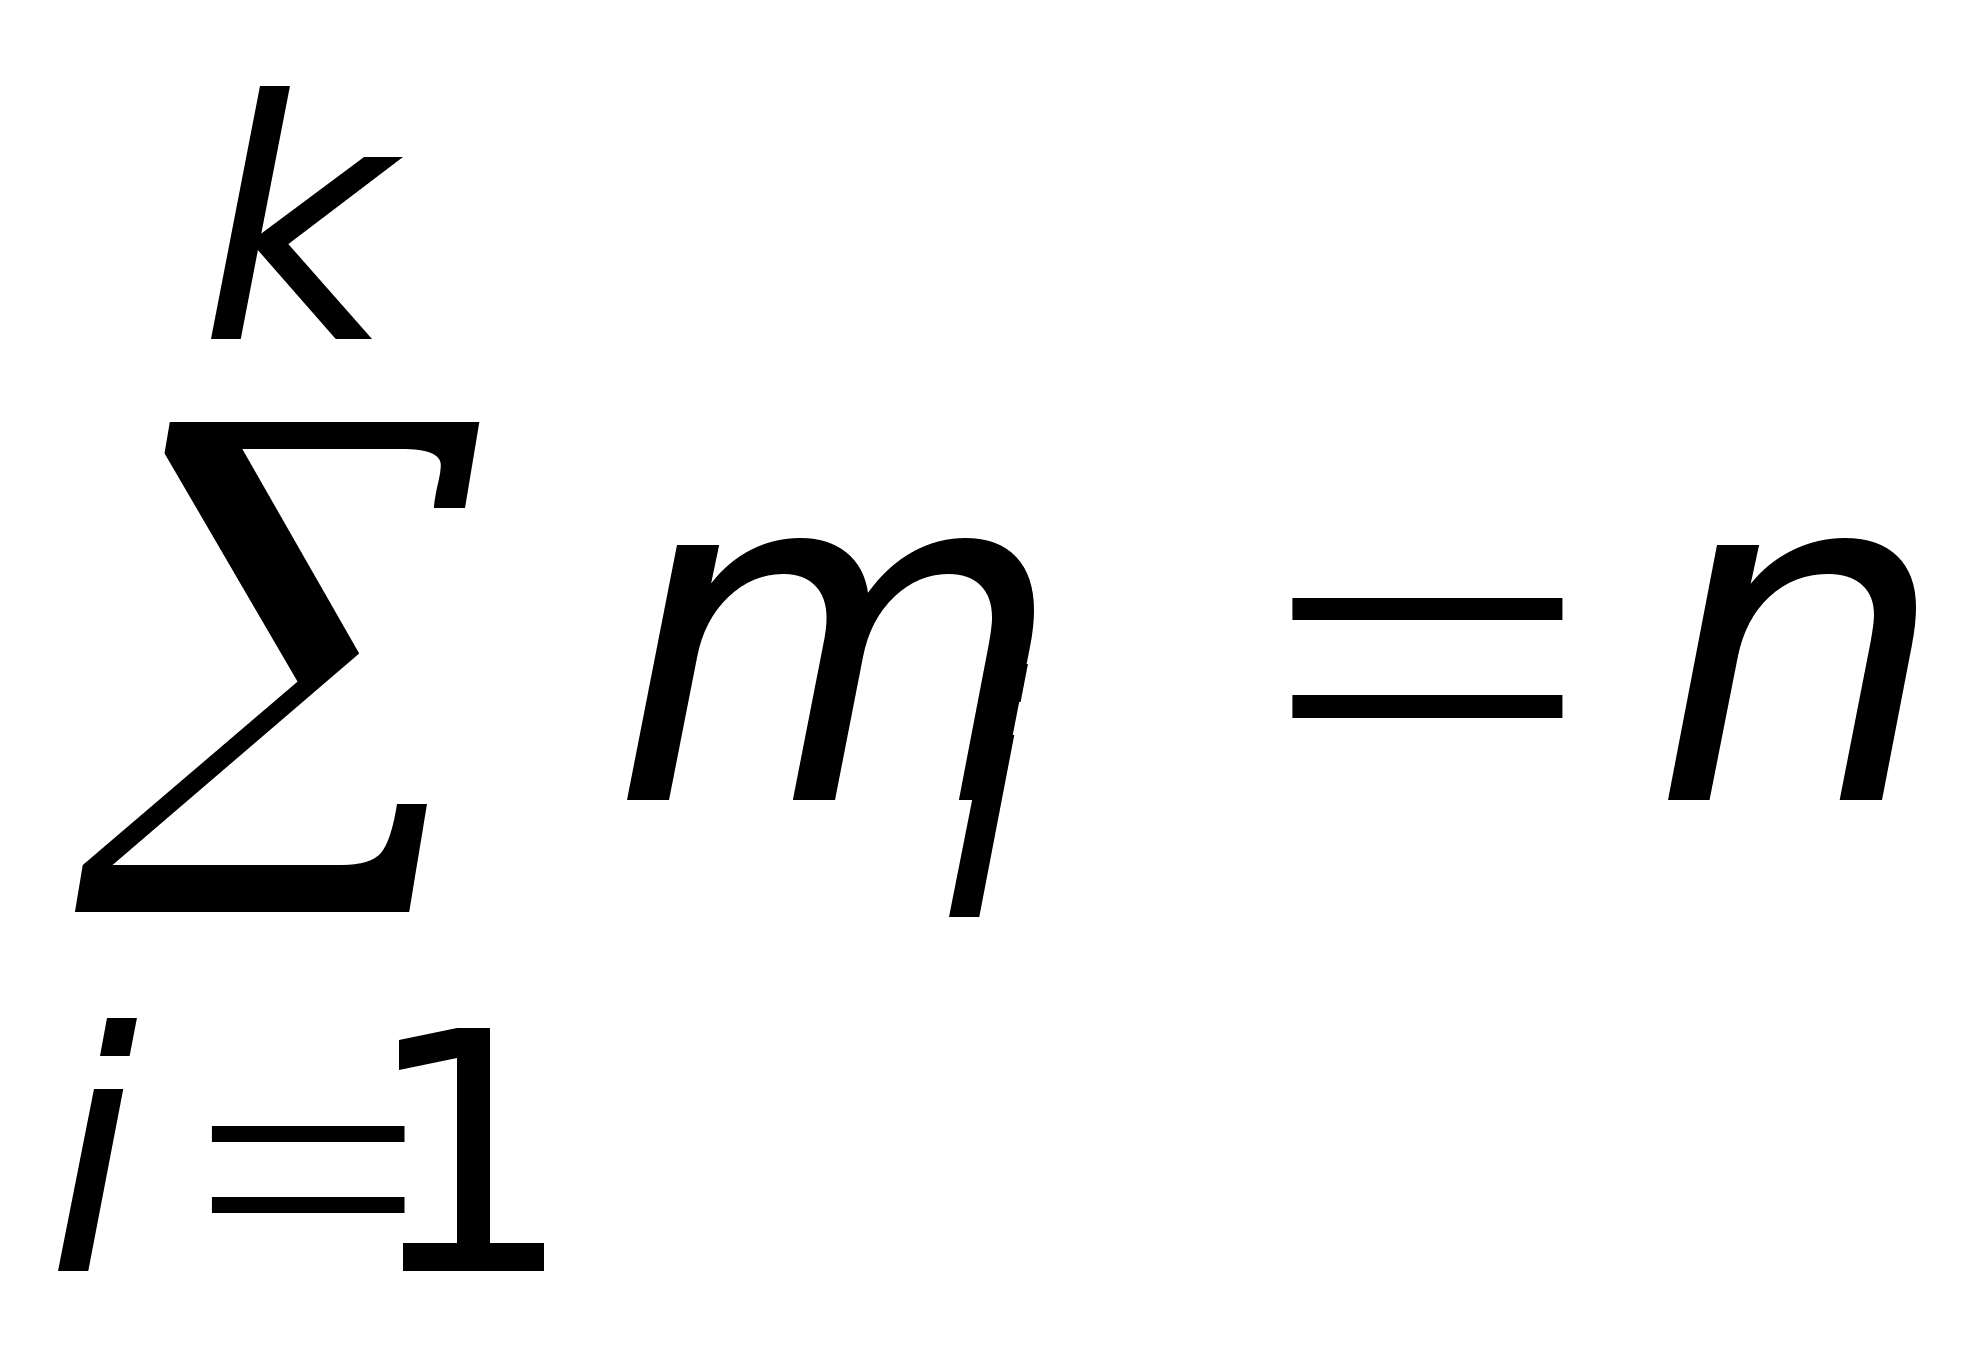 .
Если промежуток между наименьшим и наибольшим значениями признака в выборке разбить на несколько интервалов одинаковой длины, каждому интервалу поставить в соответствие число выборочных значений признака, попавших в этот интервал, то получим интервальный вариационный ряд. Если признак может принимать любые значения из некоторого промежутка, то есть является непрерывной случайной величиной, приходится выборку представлять именно таким рядом. Если в вариационном интервальном ряду каждый интервал [ai; ai+1) заменить лежащим в его середине числом (ai+ai+1)/2, то получим дискретный вариационный ряд. Такая замена вполне естественна, так как, например, при измерении размера детали с точностью до одного миллиметра всем размерам из промежутка [49,5; 50,5), будет соответствовать одно число, равное 50.
Точечные оценки параметров генеральной совокупности.
Во многих случаях мы располагаем информацией о виде закона распределения случайной величины (нормальный, бернуллиевский, равномерный и т. п.), но не знаем параметров этого распределения, таких как Mx, Dx. Для определения этих параметров применяется выборочный метод.
Пусть выборка объема n представлена в виде вариационного ряда. Назовем выборочной средней величину
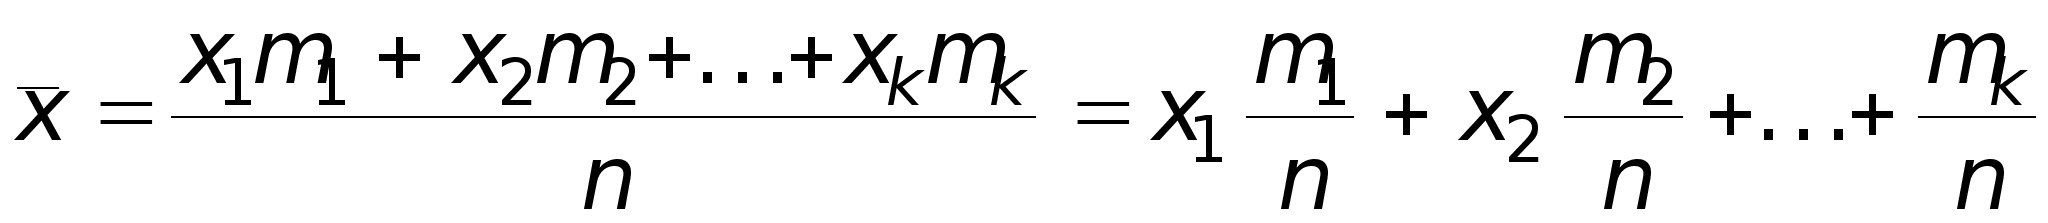
Величина
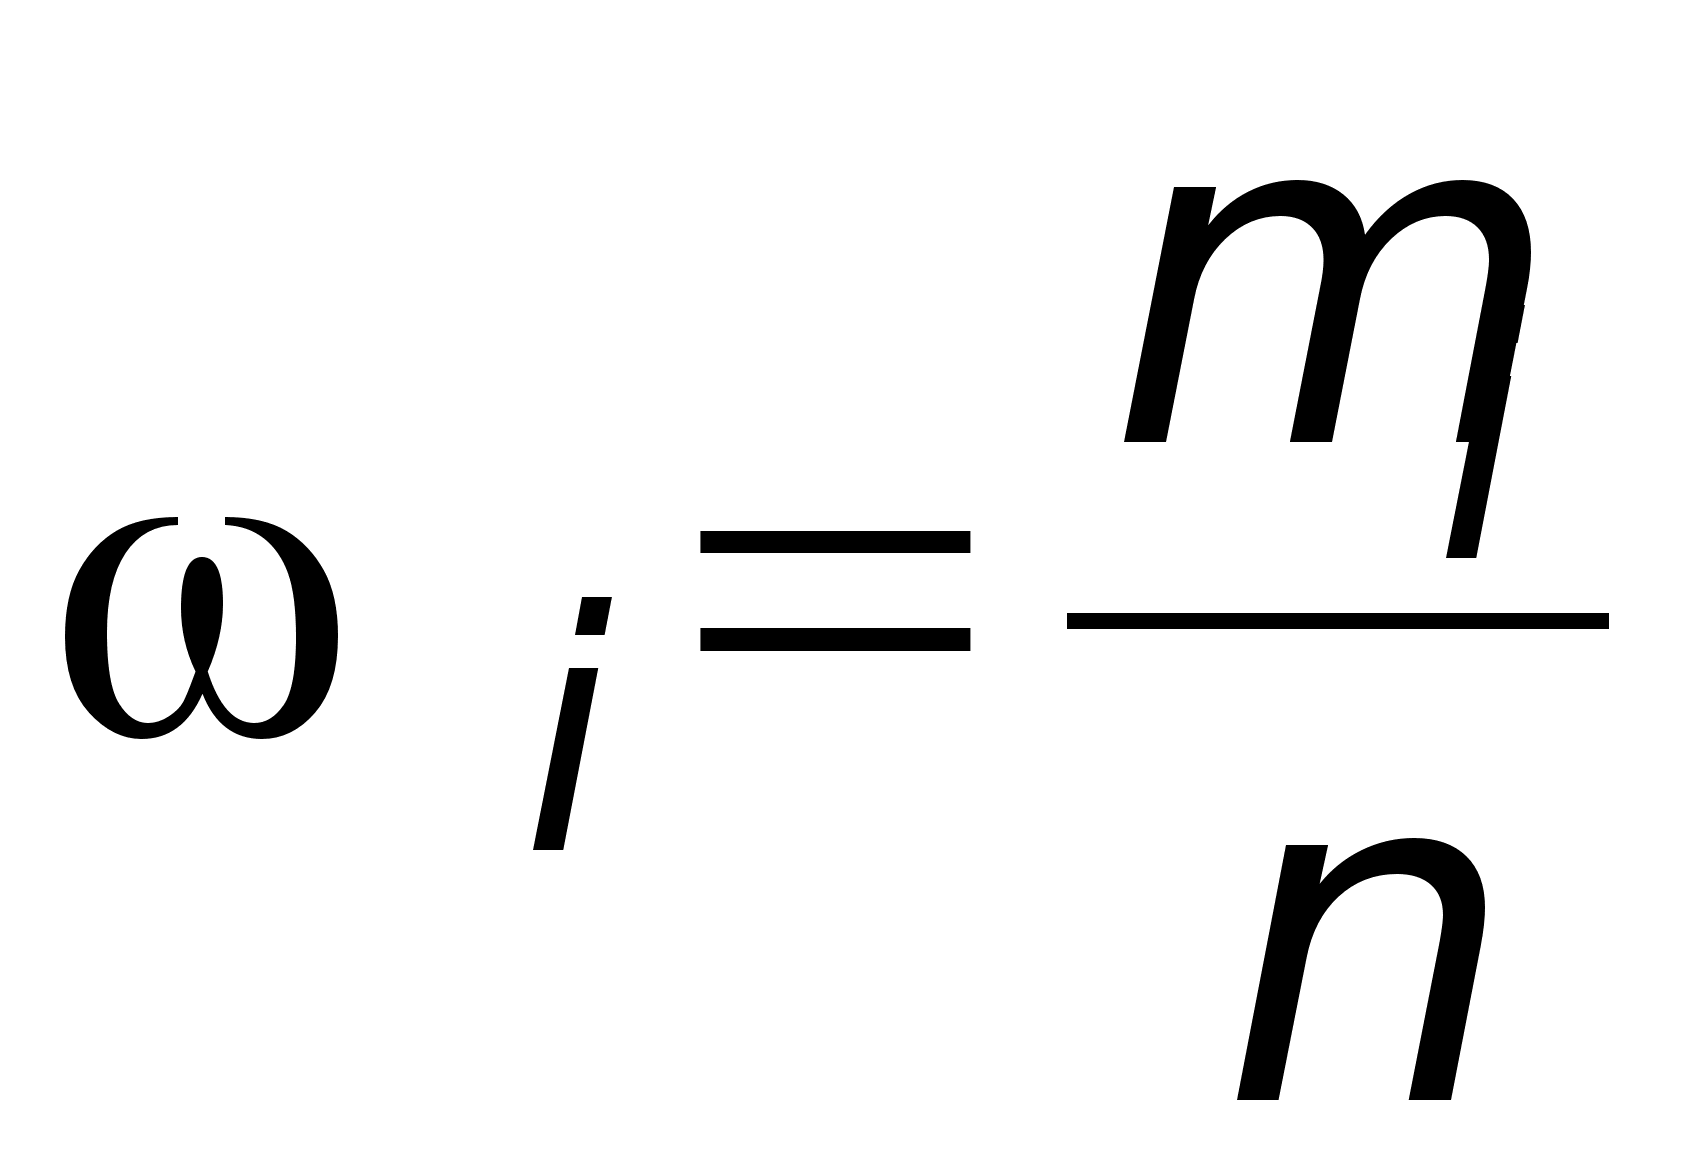 называется
относительной
частотой
значения признака
xi.
Если значения
признака, полученные
из выборки не
группировать
и не представлять
в виде вариационного
ряда, то для
вычисления
выборочной
средней нужно
пользоваться
формулой
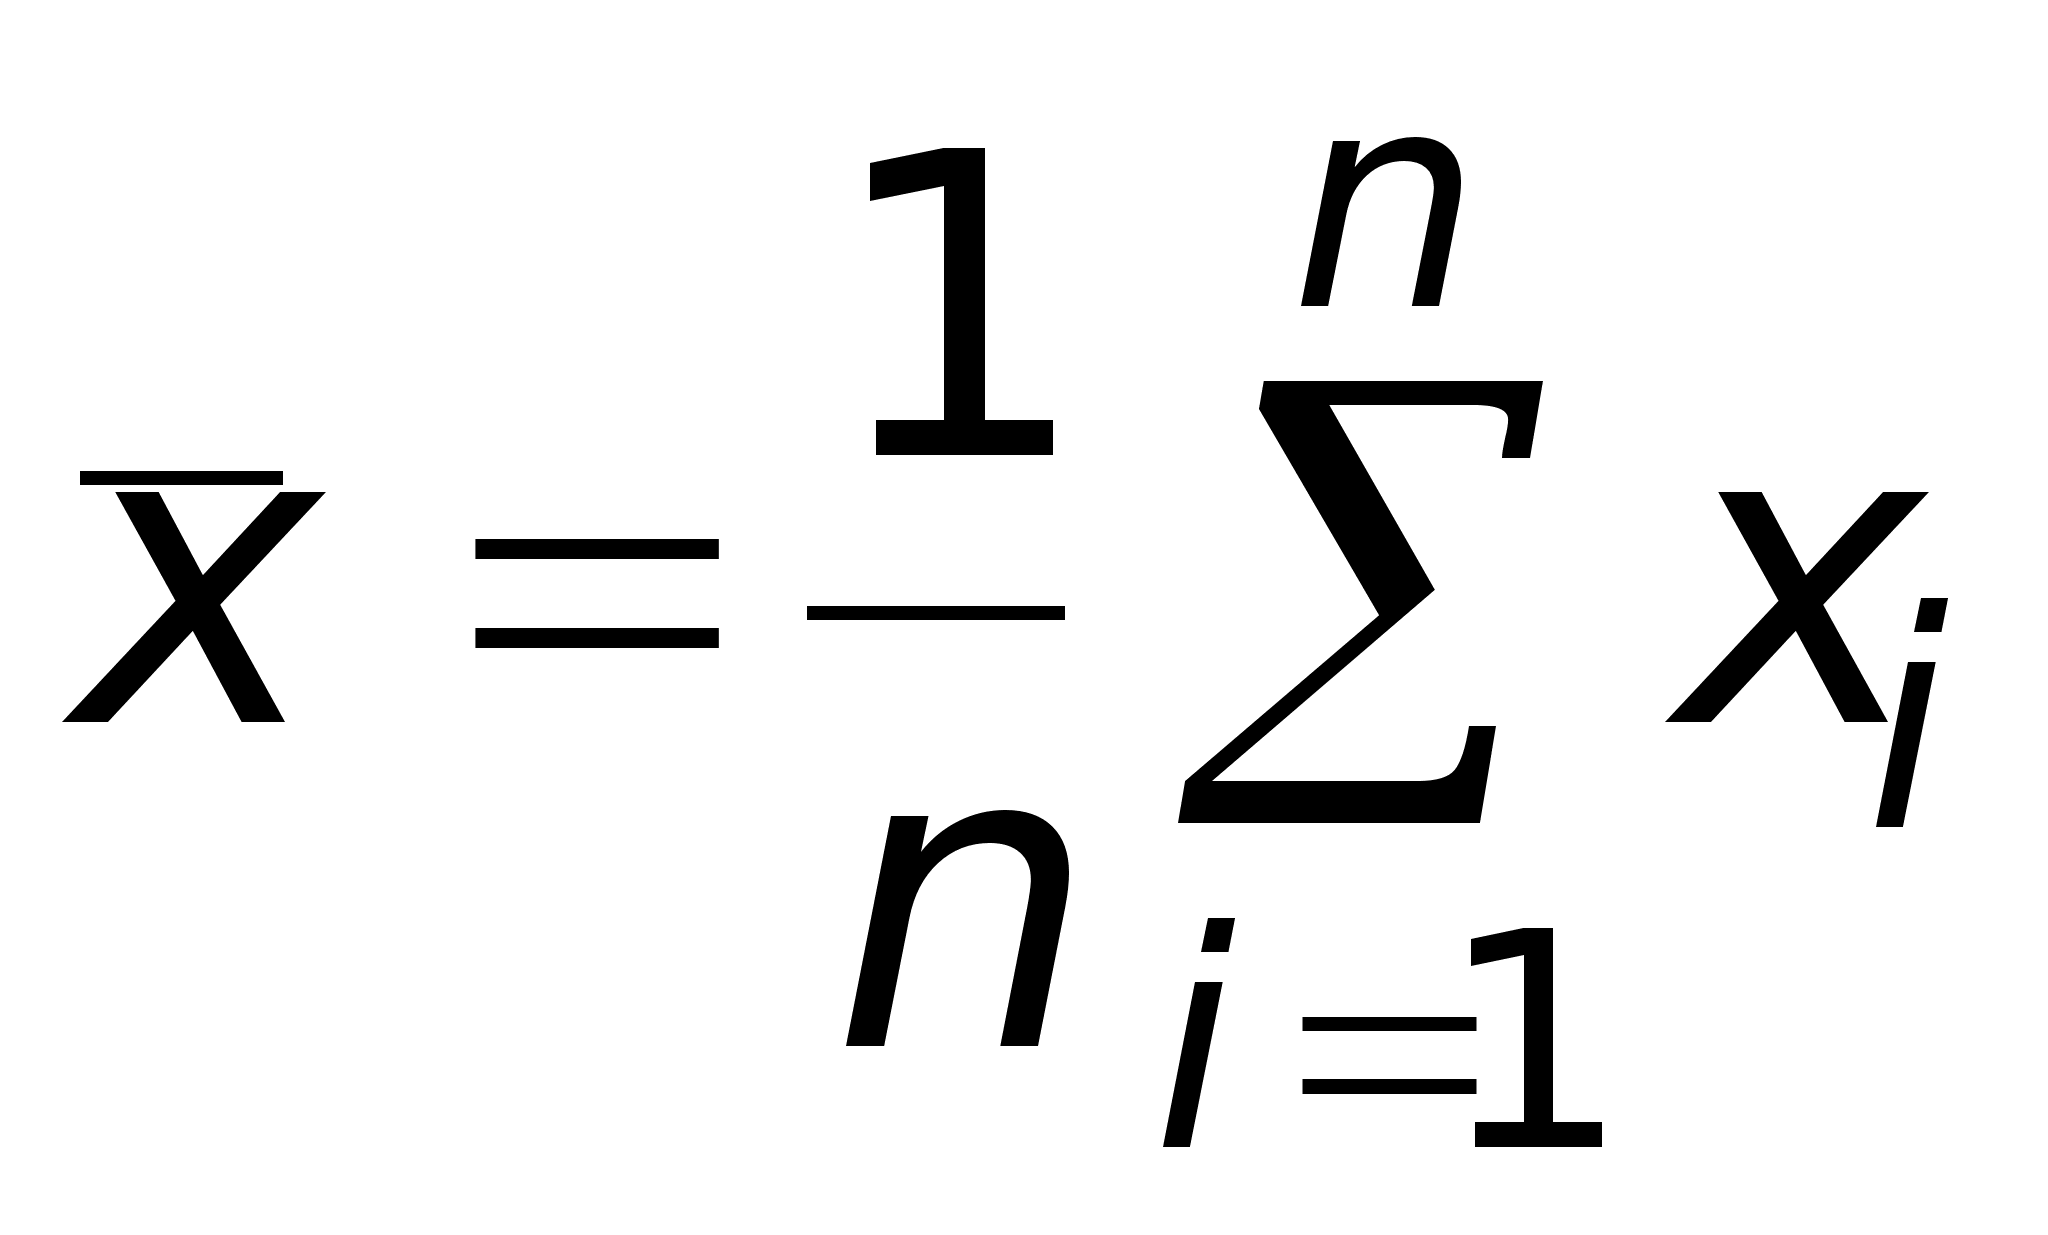 .
Естественно
считать величину
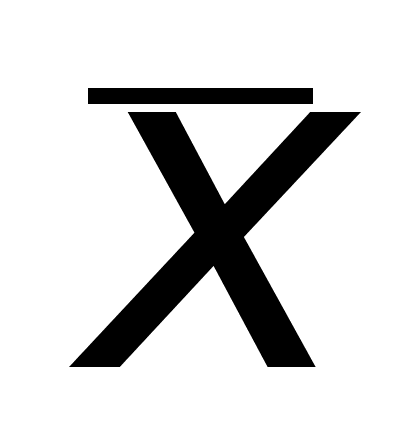 выборочной
оценкой параметра
Mx.
Выборочная
оценка параметра,
представляющая
собой число,
называется
точечной оценкой.
Выборочную дисперсию
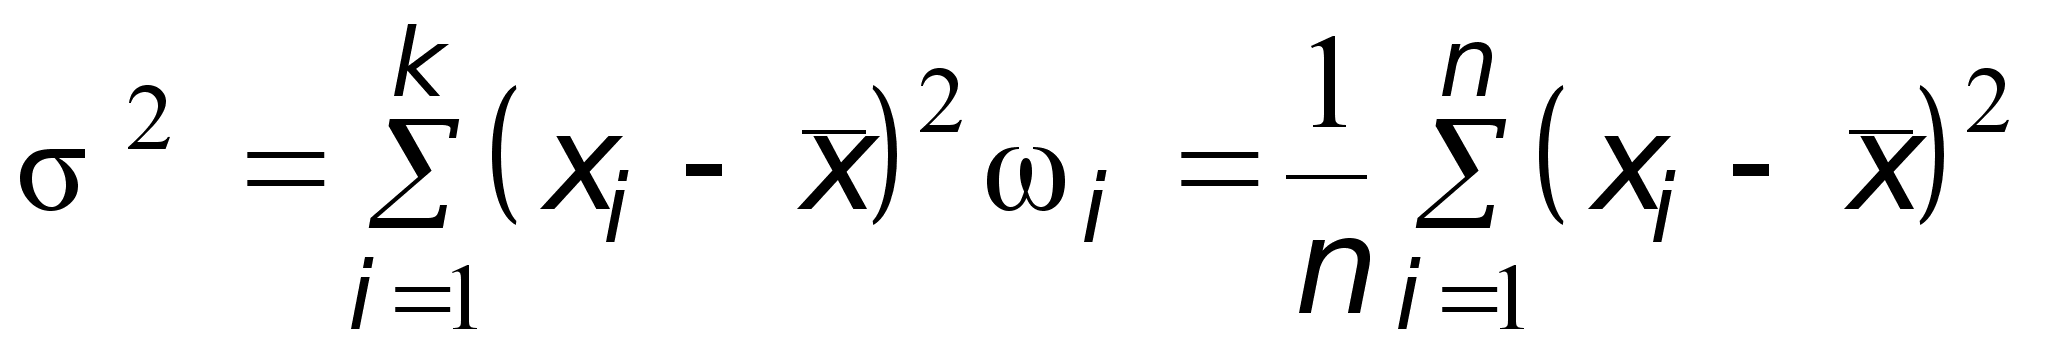
можно считать точечной оценкой дисперсии Dx генеральной совокупности.
Приведем еще один пример точечной оценки. Пусть каждый объект генеральной совокупности характеризуется двумя количественными признаками x и y. Например деталь может иметь два размера – длину и ширину. Можно в различных районах измерять концентрацию вредных веществ в воздухе и фиксировать количество легочных заболеваний населения в месяц. Можно через равные промежутки времени сопоставлять доходность акций данной корпорации с каким-либо индексом, характеризующим среднюю доходность всего рынка акций. В этом случае генеральная совокупность представляет собой двумерную случайную величину x, h. Эта случайная величина принимает значения x, y на множестве объектов генеральной совокупности. Не зная закона совместного распределения случайных величин x и h, мы не можем говорить о наличии или глубине корреляционной связи между ними, однако некоторые выводы можно сделать, используя выборочный метод.
Выборку
объема n
в этом случае
представим
в виде таблицы,
где
i-тый
отобранный
объект (i=
1,2,...n)
представлен
парой чисел
xi,
yi
:
-
x1
x2
... xn
y1
y2
... yn
Выборочный коэффициент корреляции рассчитывается по формуле
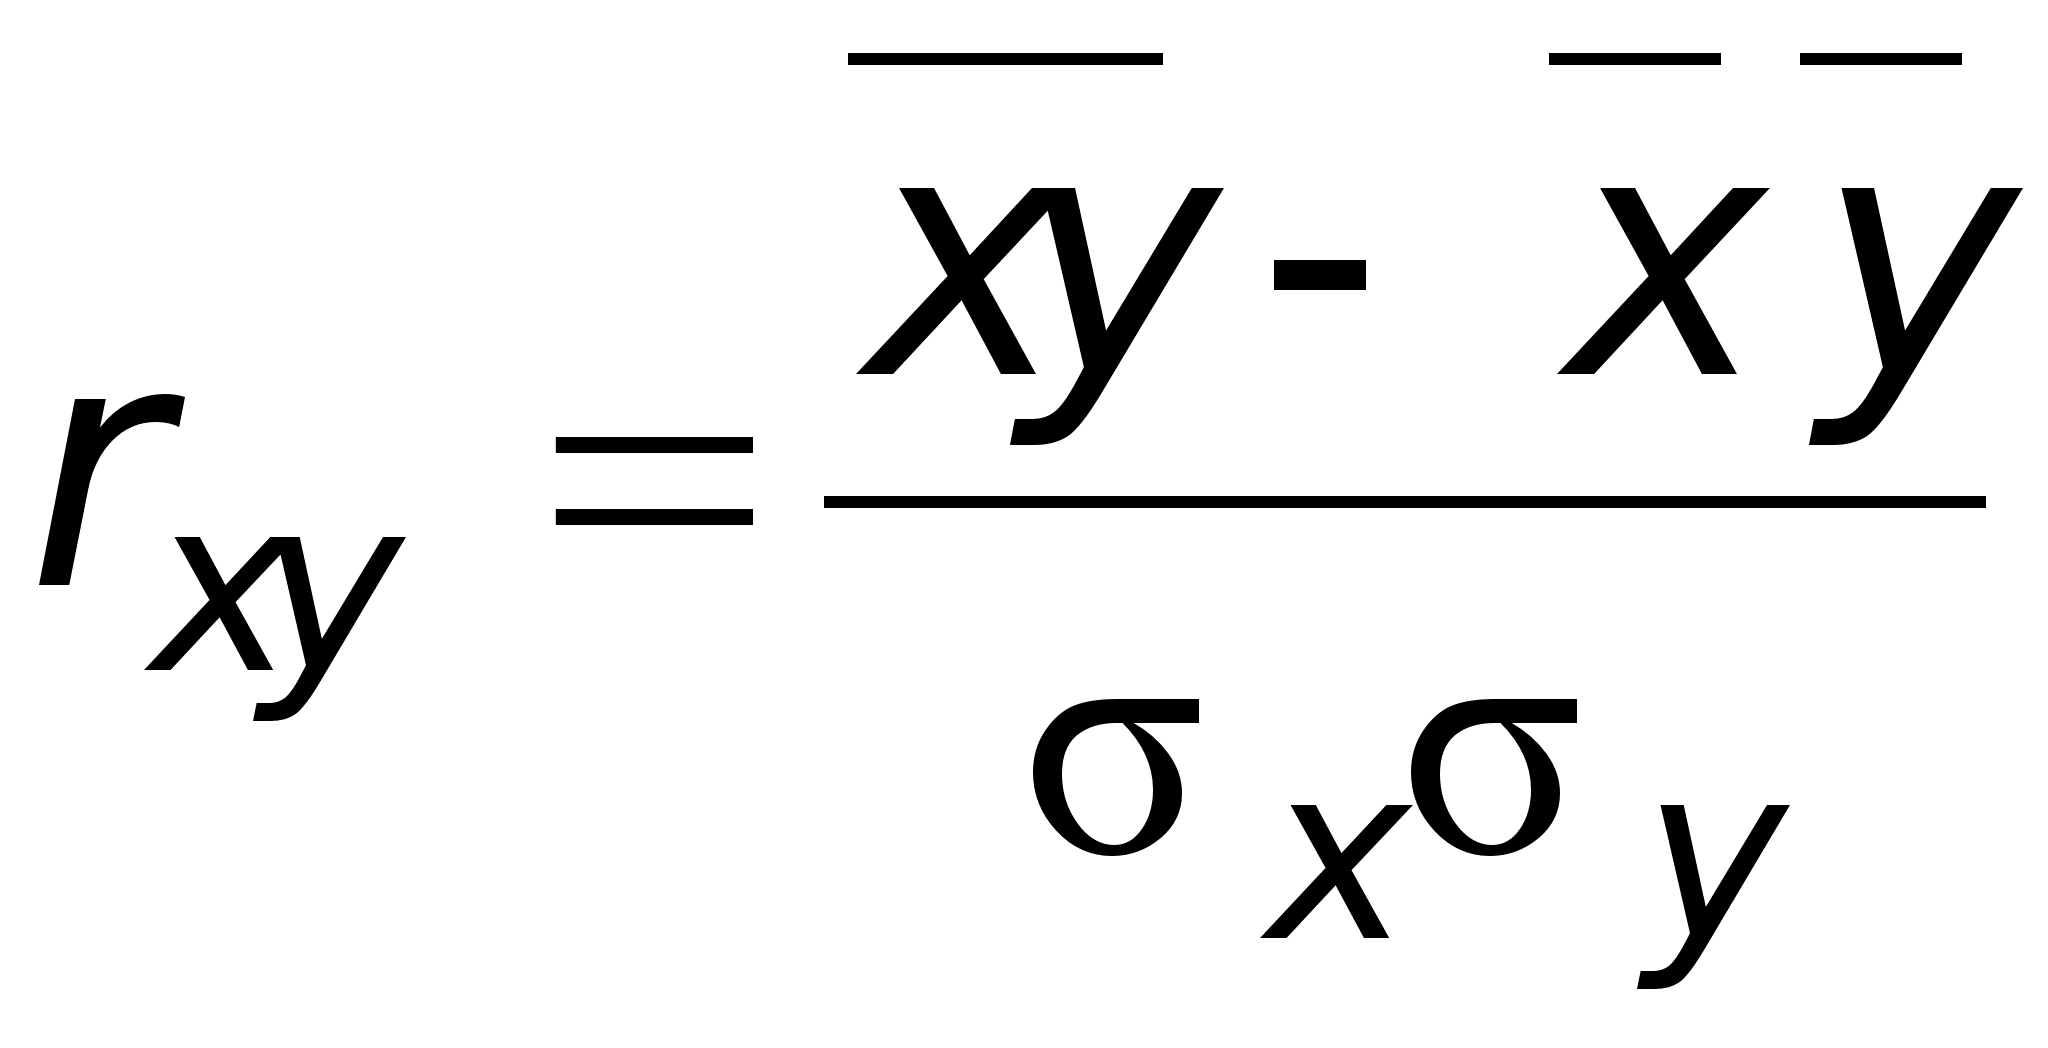
Здесь
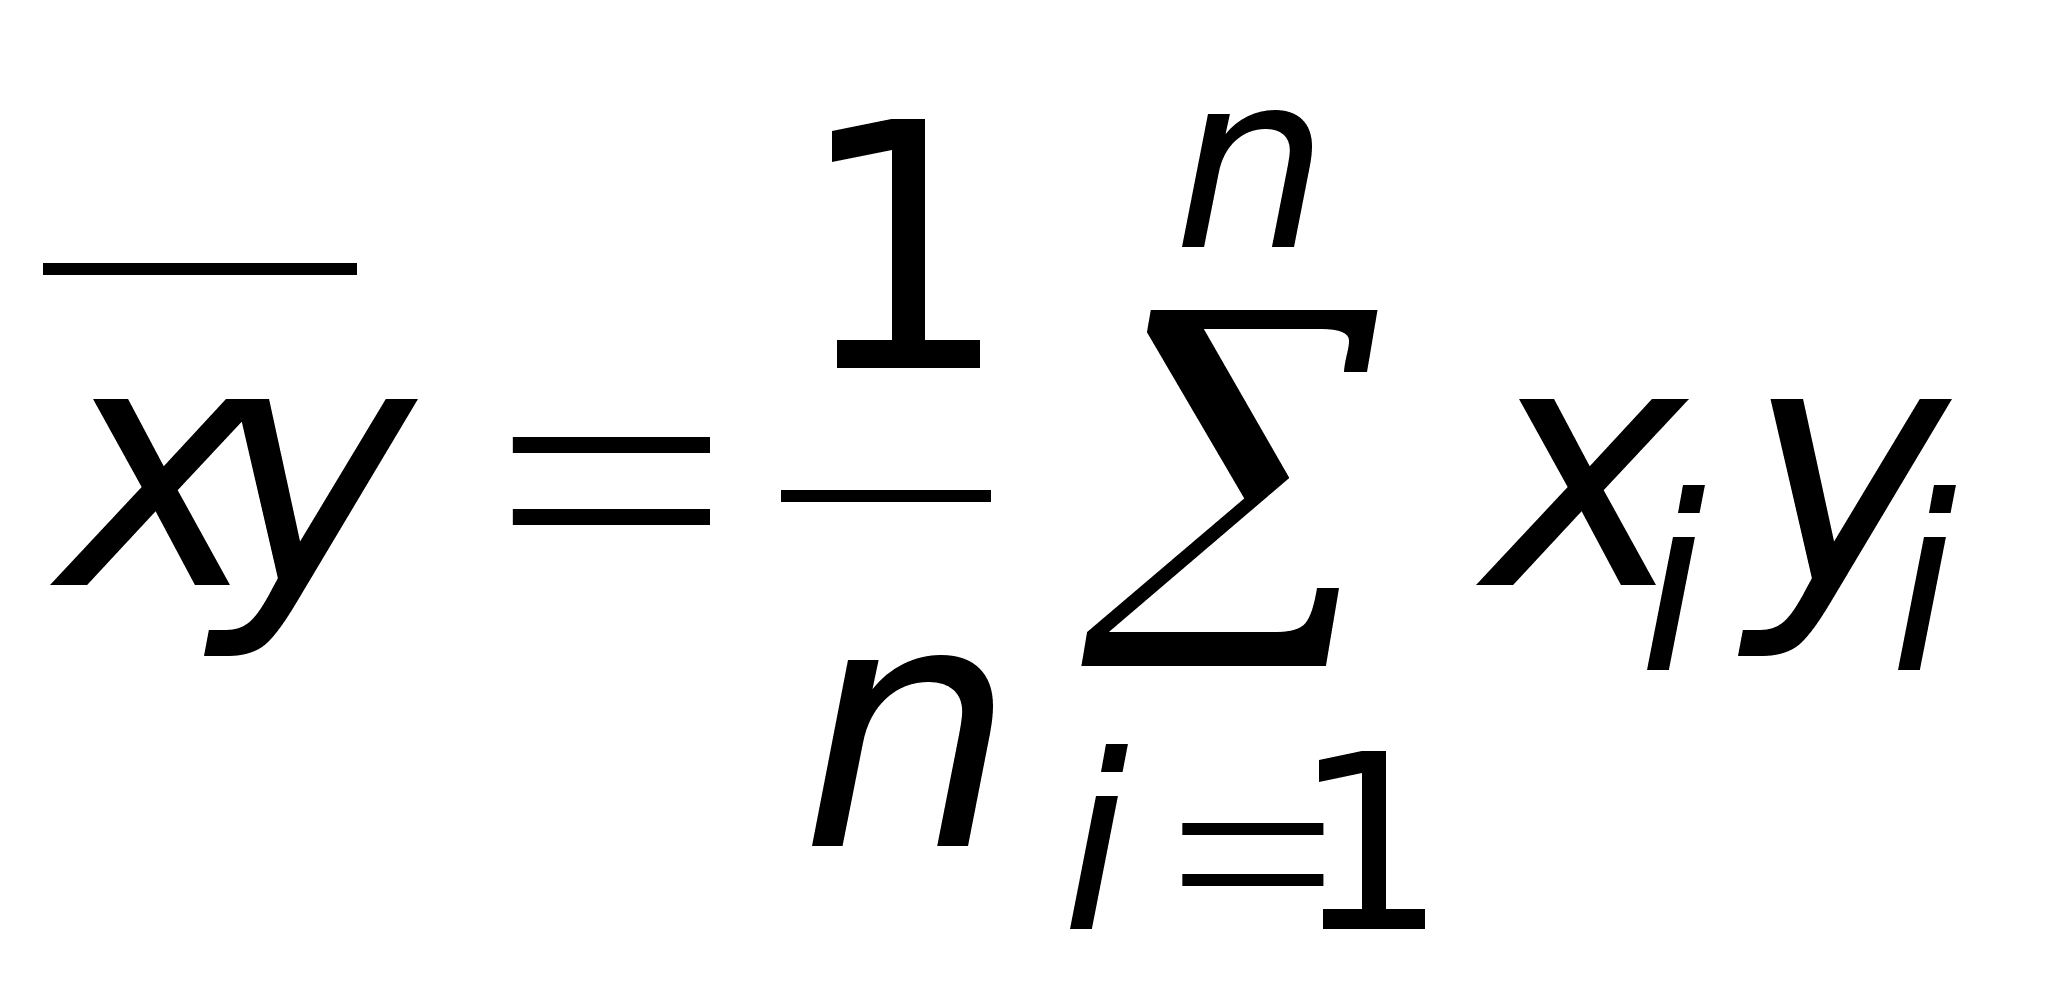 ,
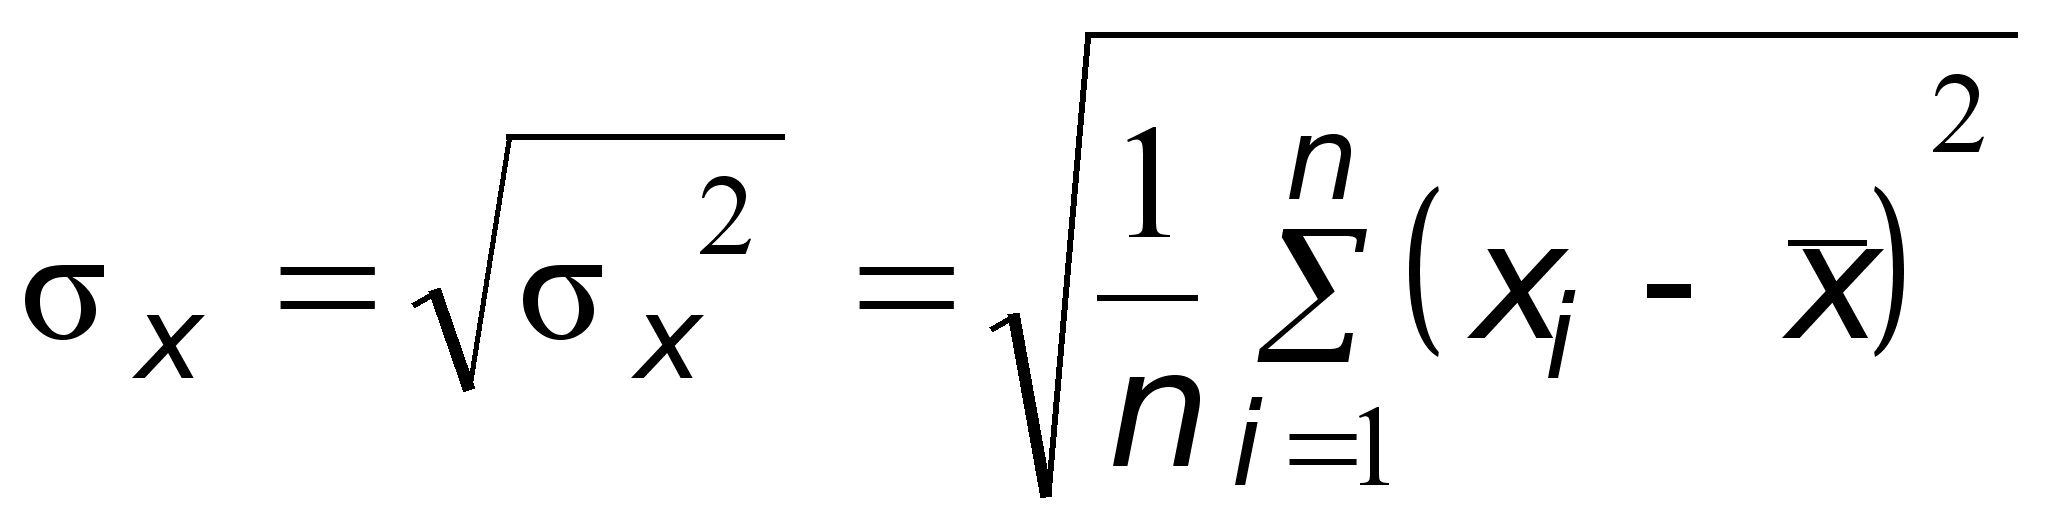 ,
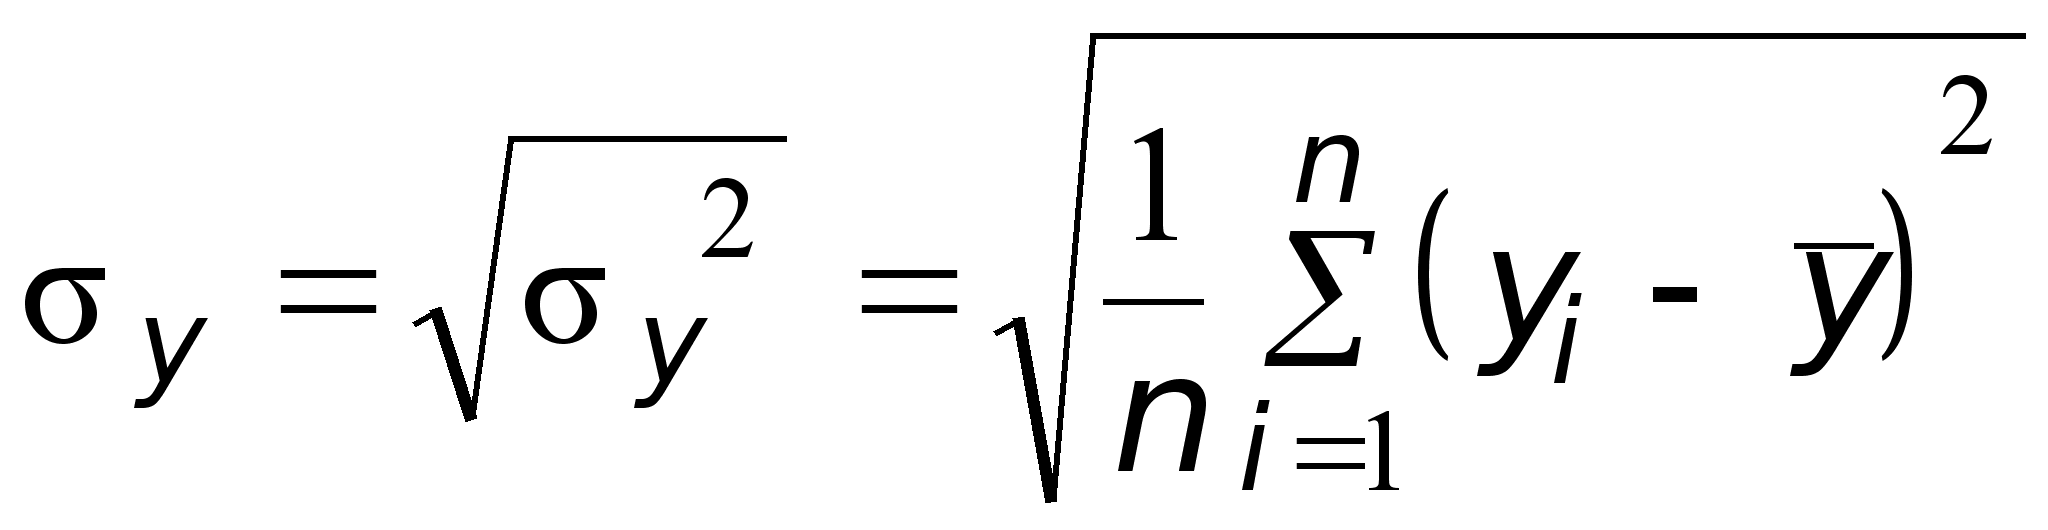 .
Выборочный коэффициент корреляции можно рассматривать как точечную оценку коэффициента корреляции rxh, характеризующего генеральную совокупность.
Выборочные
параметры
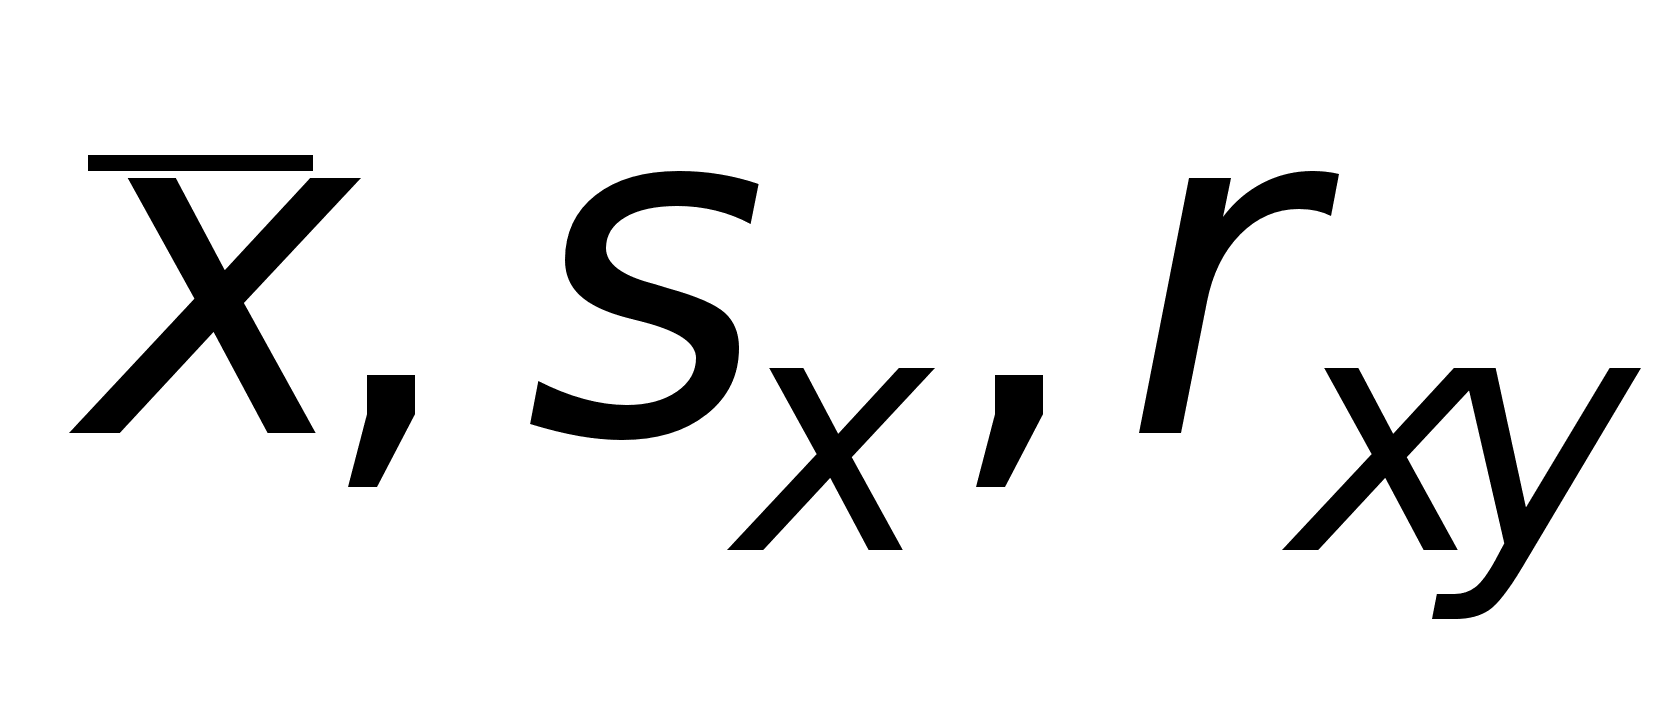 или любые другие
зависят от
того, какие
объекты генеральной
совокупности
попали в выборку
и различаются
от выборки к
выборке. Поэтому
они сами являются
случайными
величинами.
Пусть выборочный параметр d рассматривается как выборочная оценка параметра D генеральной совокупности и при этом выполняется равенство
Md =D.
Такая выборочная оценка называется несмещенной.
Для
доказательства
несмещённости
некоторых
точечных оценок
будем рассматривать
выборку объема
n как
систему n
независимых
случайных
величин x1,
x2,...
xn
, каждая из которых
имеет тот же
закон распределения
с теми же параметрами,
что и случайная
величина x,
представляющая
генеральную
совокупность.
При таком подходе
становятся
очевидными
равенства:
Mxi = Mxi =Mx;
Dxi
= Dxi
=Dx
для всех k
= 1,2,...n.
Теперь
можно показать,
что выборочная
средняя
есть несмещенная
оценка средней
генеральной
совокупности
или , что то же
самое, математического
ожидания интересующей
нас случайной
величины x
:
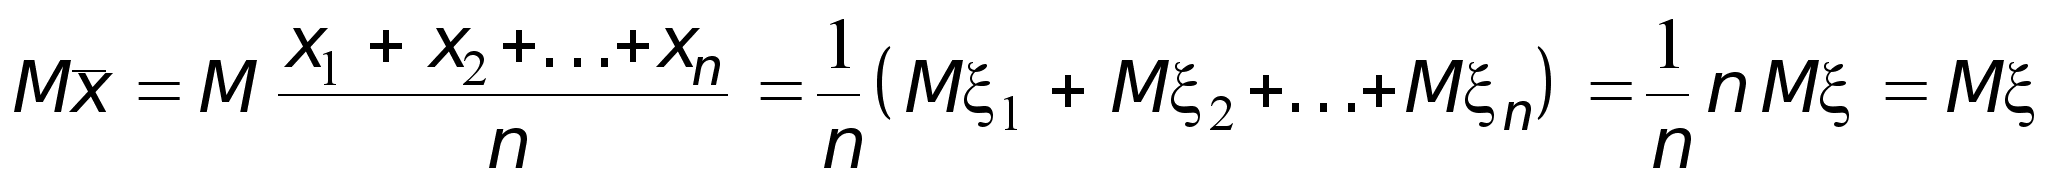 .
Выведем формулу для дисперсии выборочной средней:
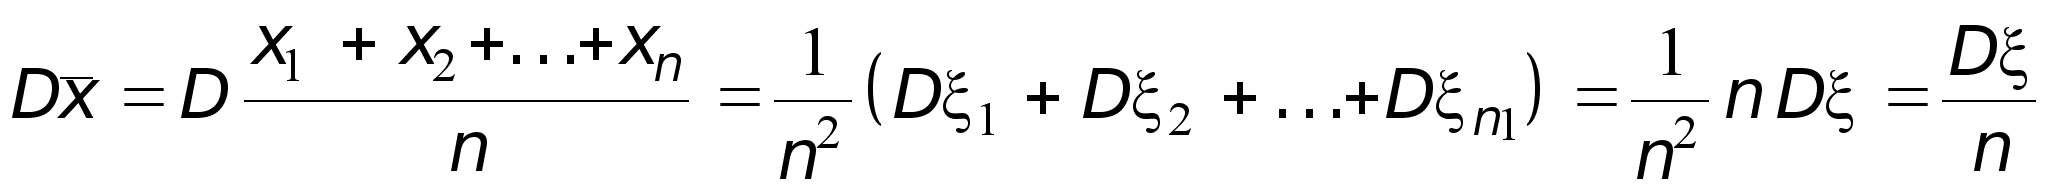 .
Найдем теперь, чему равно математическое ожидание выборочной дисперсии s 2. Сначала преобразуем s 2 следующим образом:
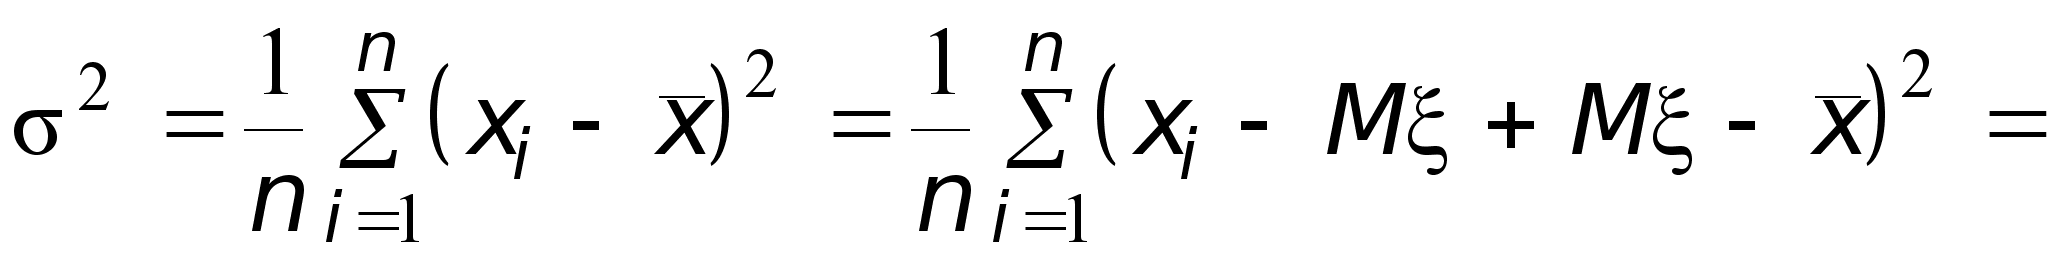
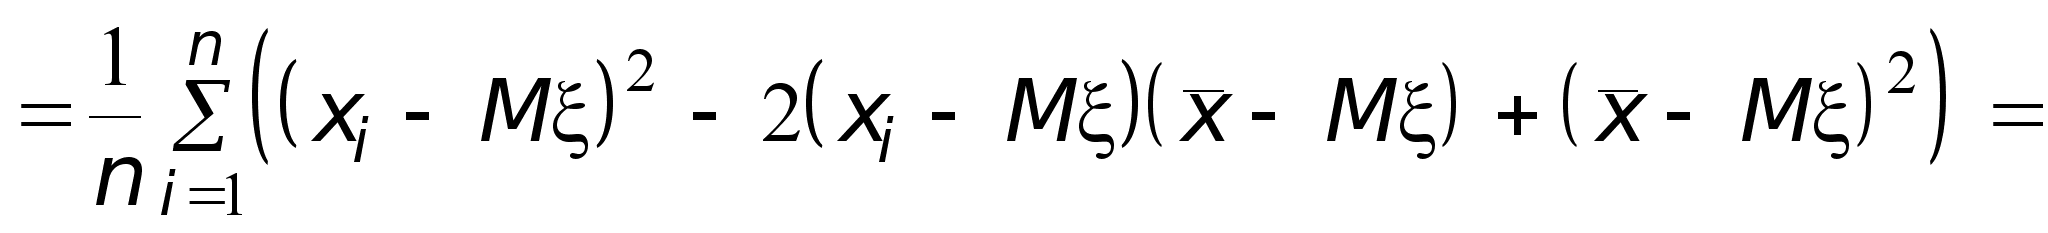
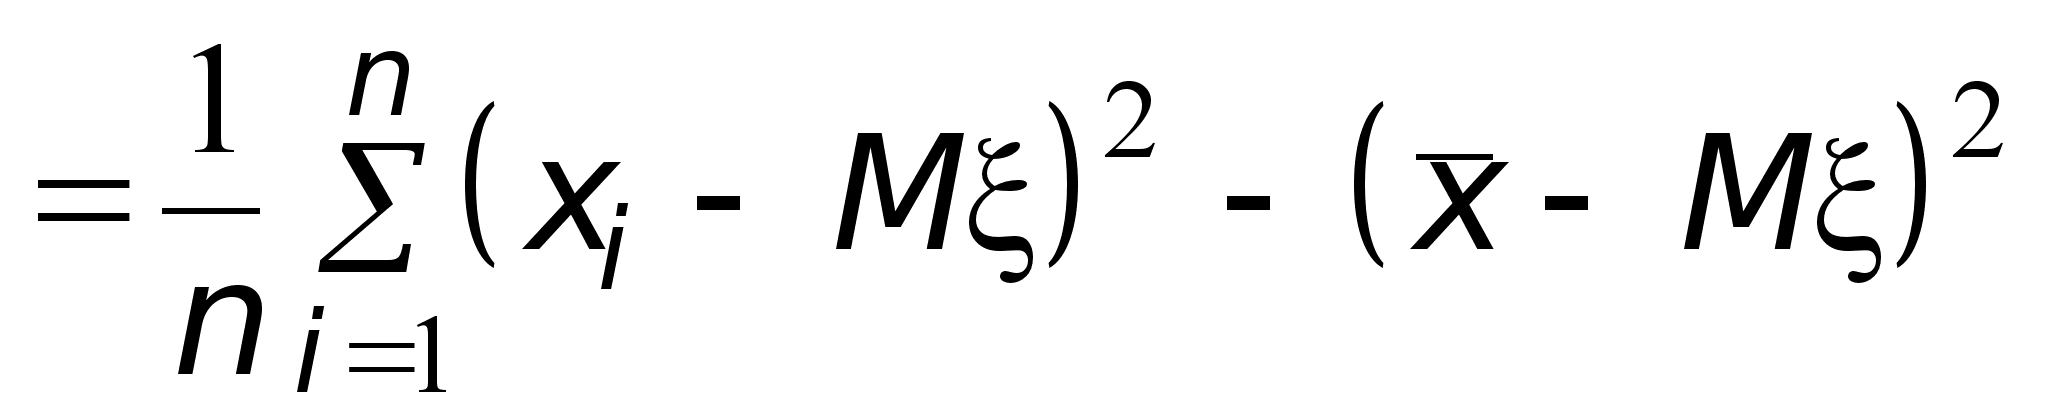
Здесь использовано преобразование:
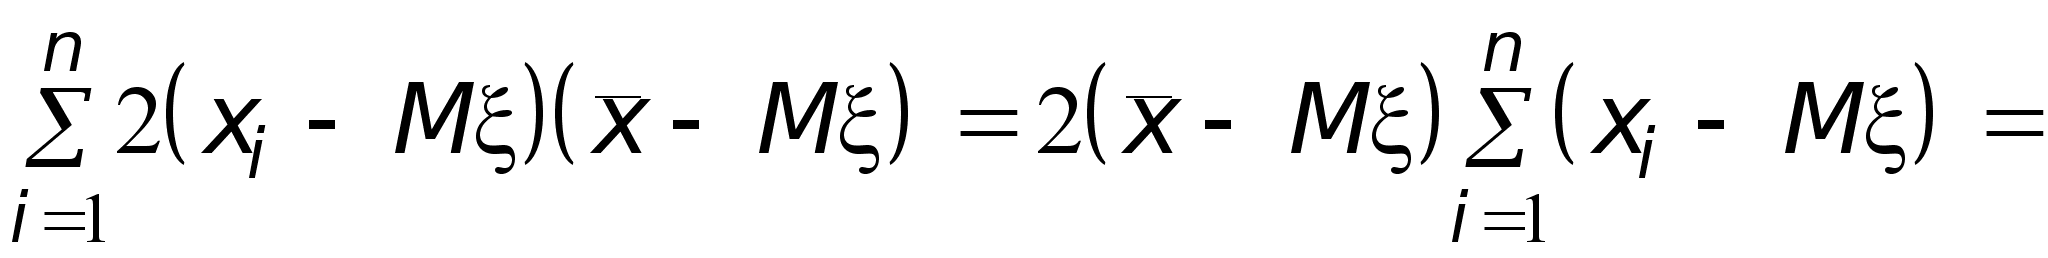
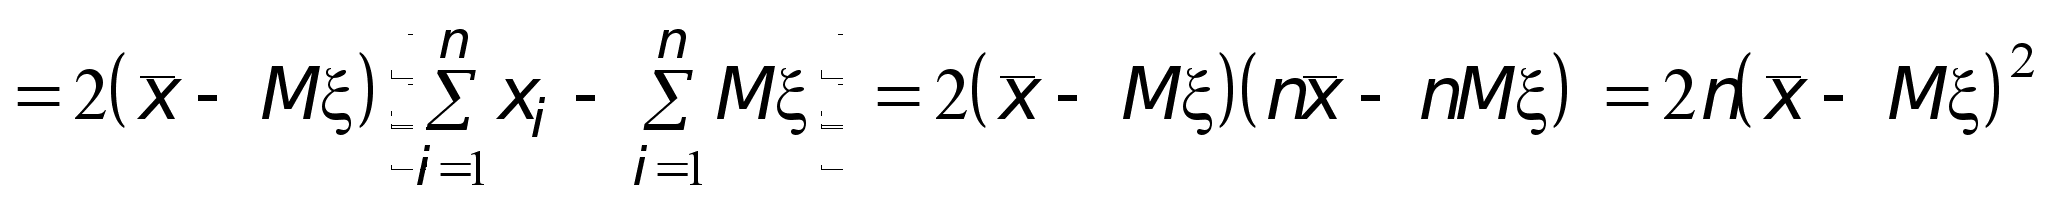
Теперь, используя полученное выше выражение для величины s 2, найдем ее математическое ожидание.
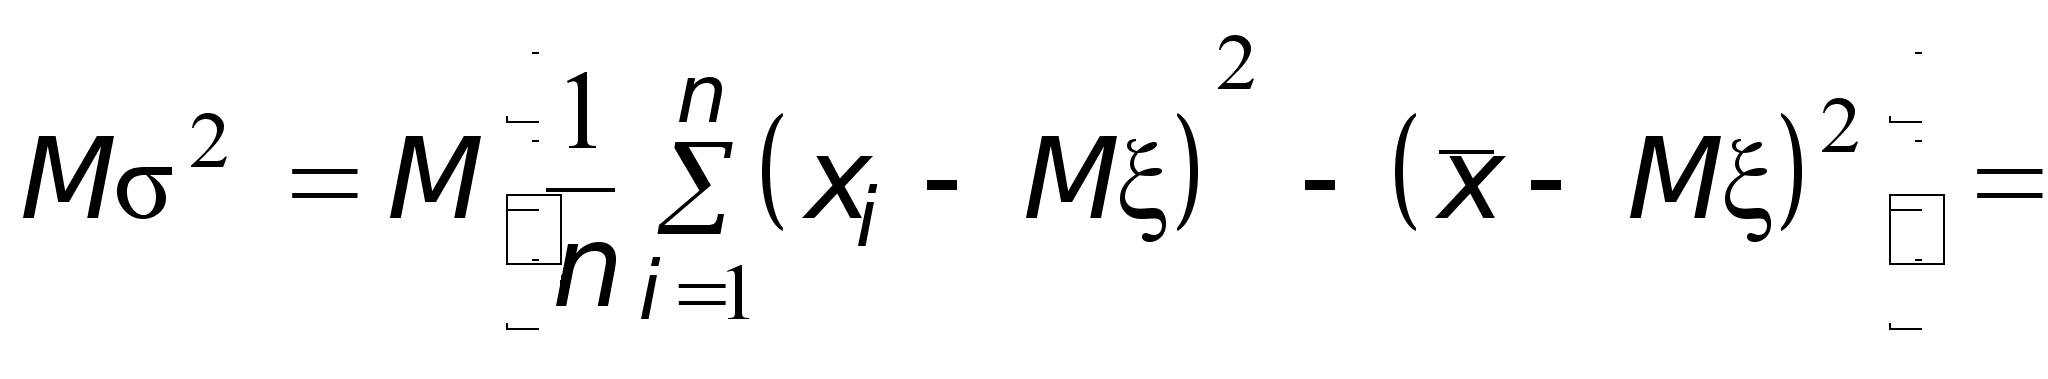
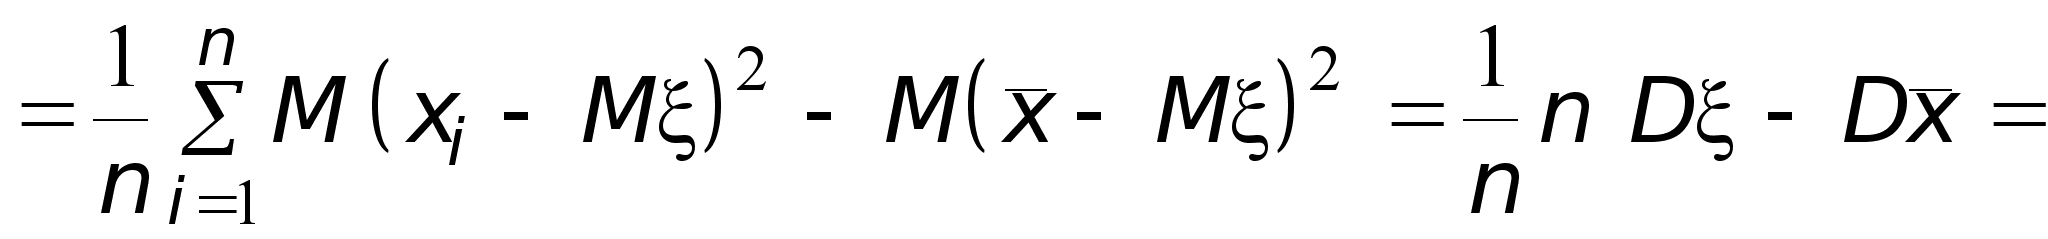
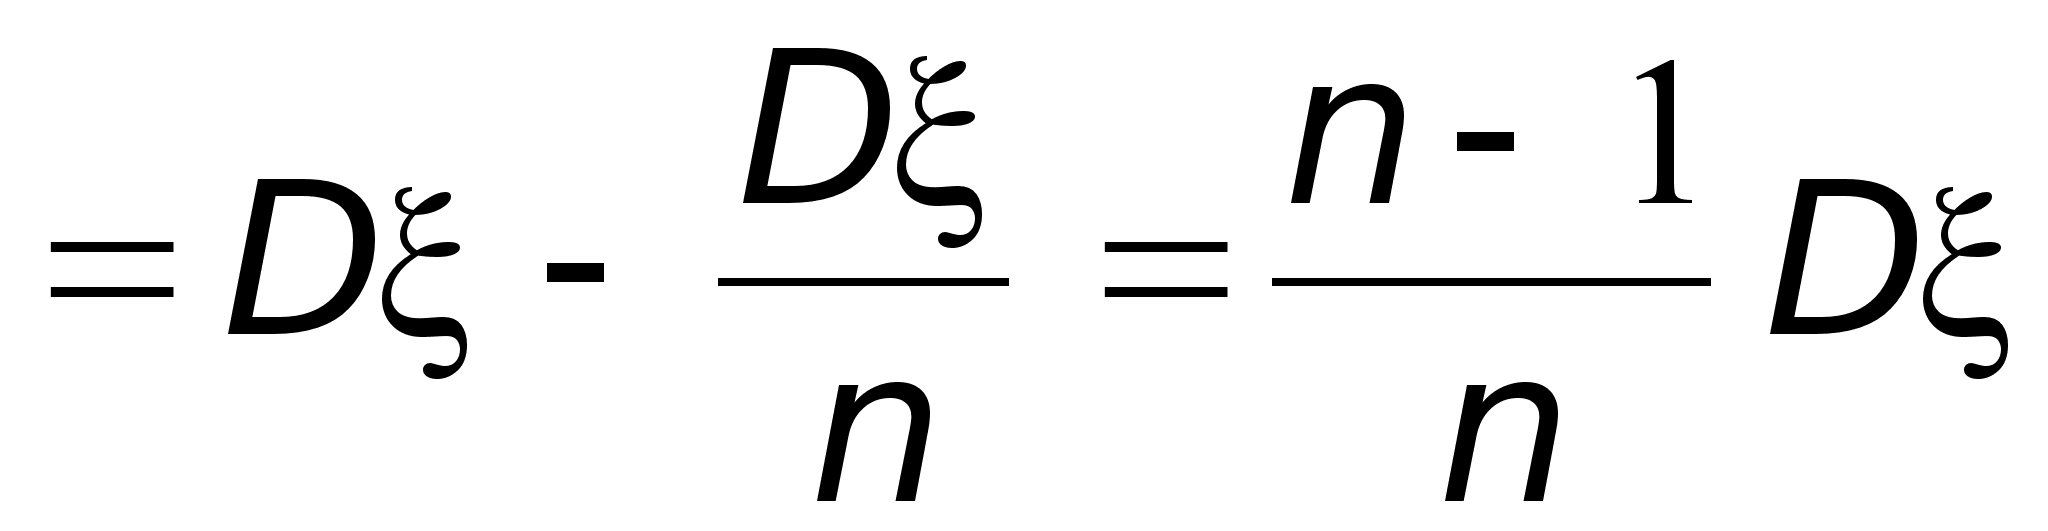 .
Так как Ms 2 № Dx, выборочная дисперсия не является несмещенной оценкой дисперсии генеральной совокупности.
Чтобы
получить несмещенную
оценку дисперсии
генеральной
совокупности,
нужно умножить
выборочную
дисперсию на
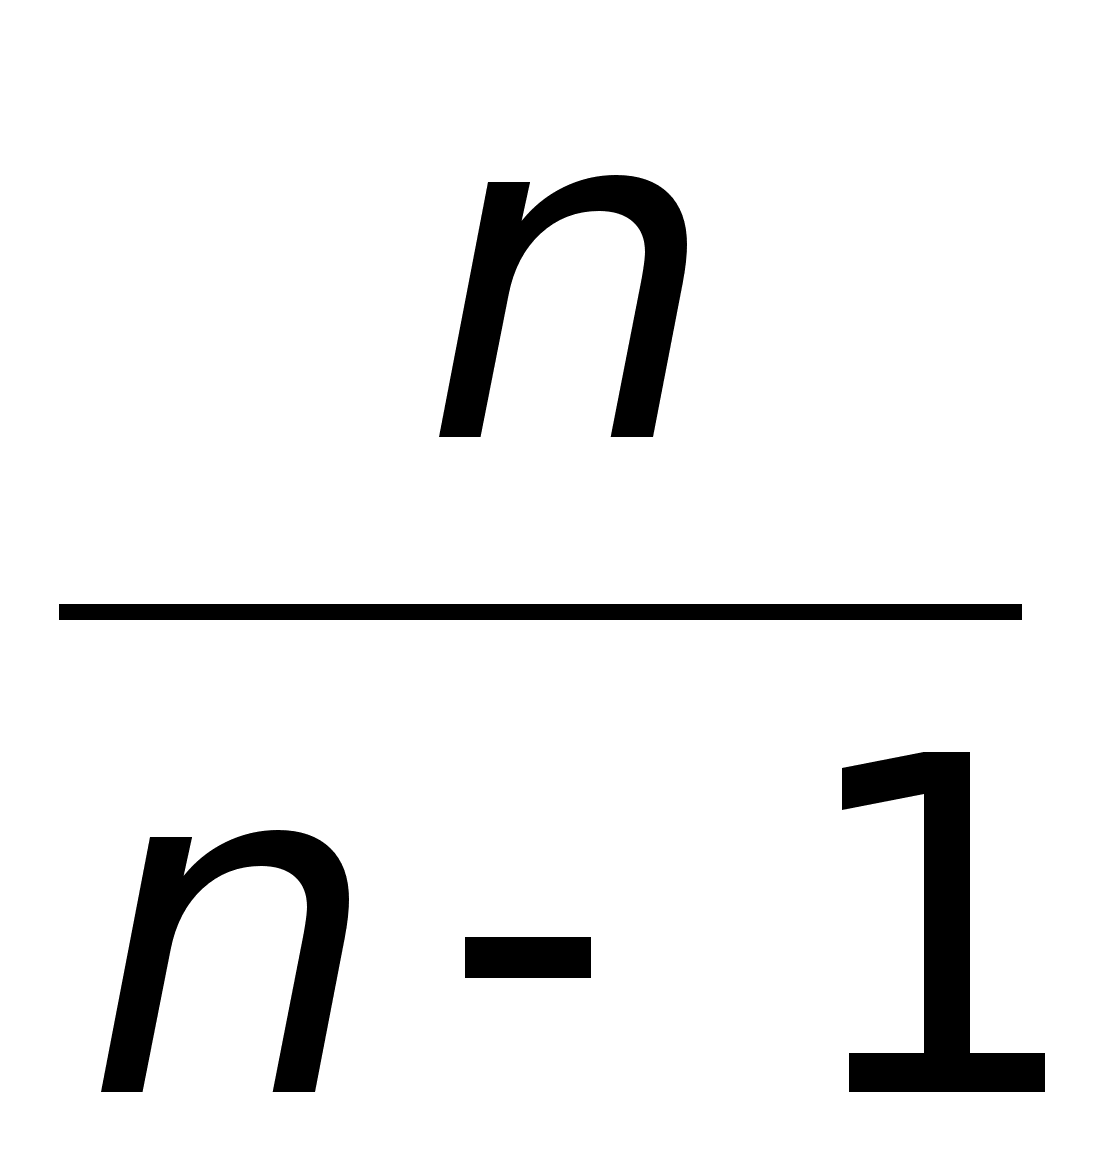 .
Тогда получится
величина
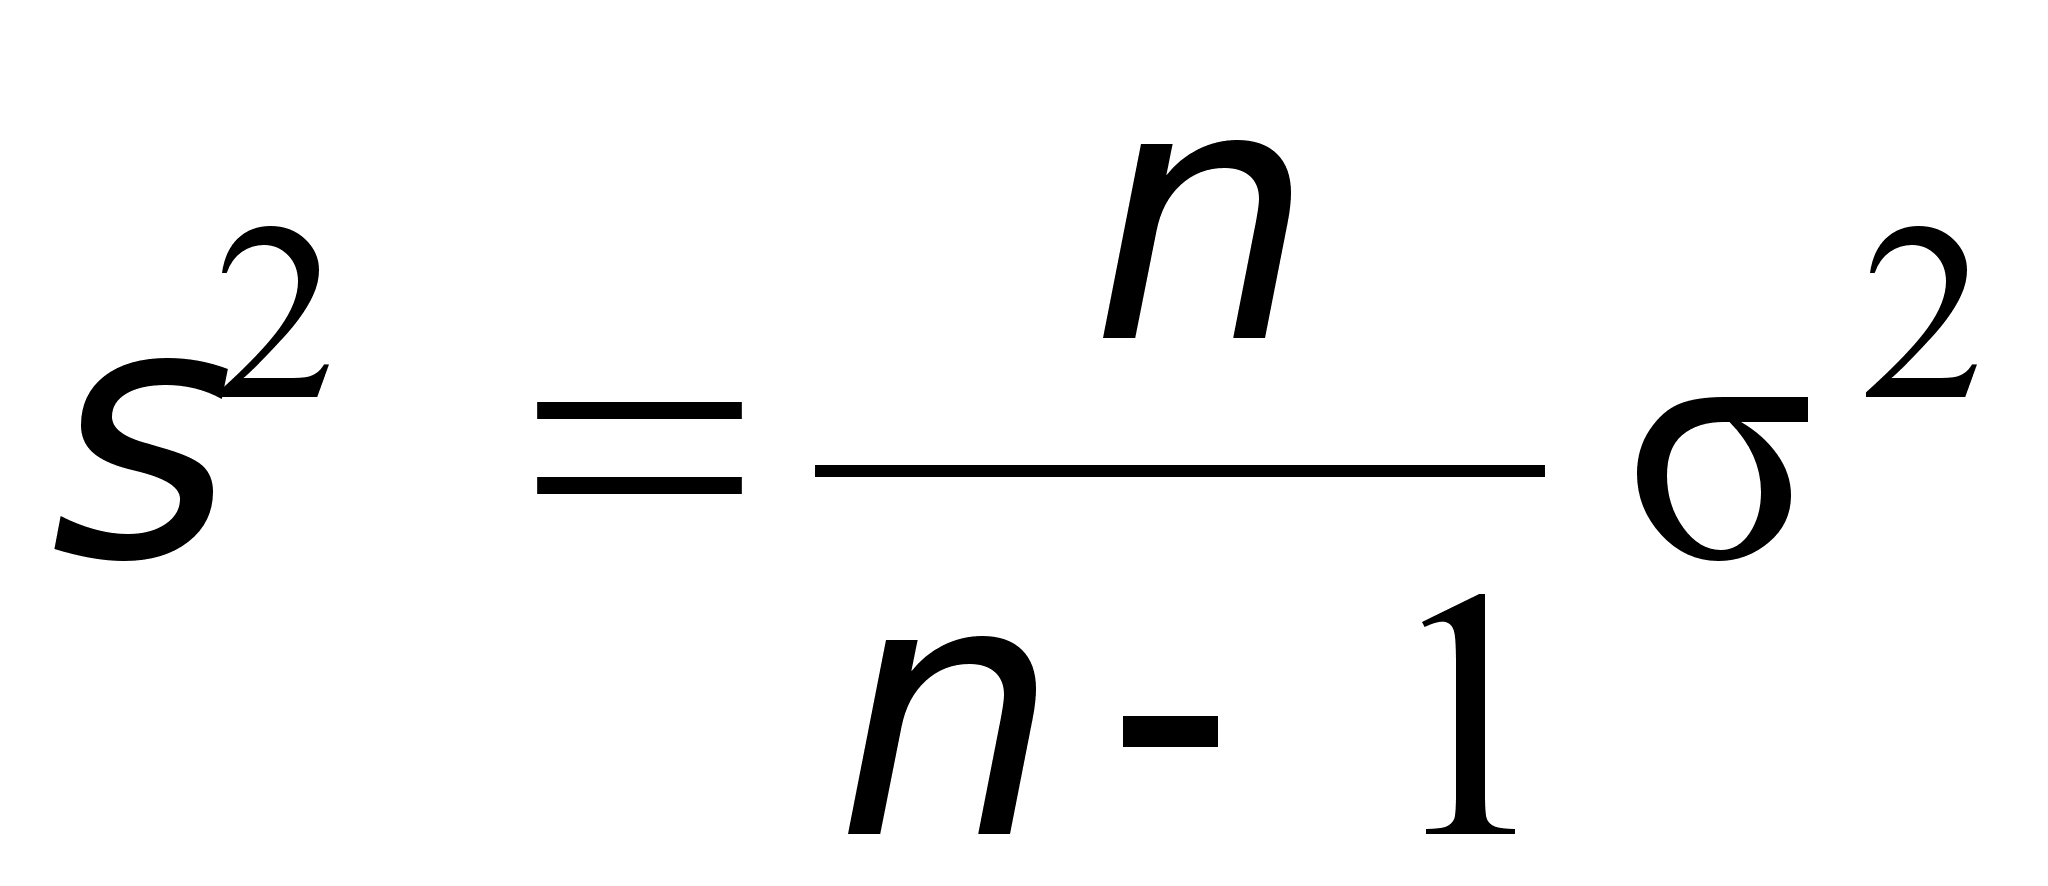 ,
называемая
исправленнойвыборочнойдисперсией.
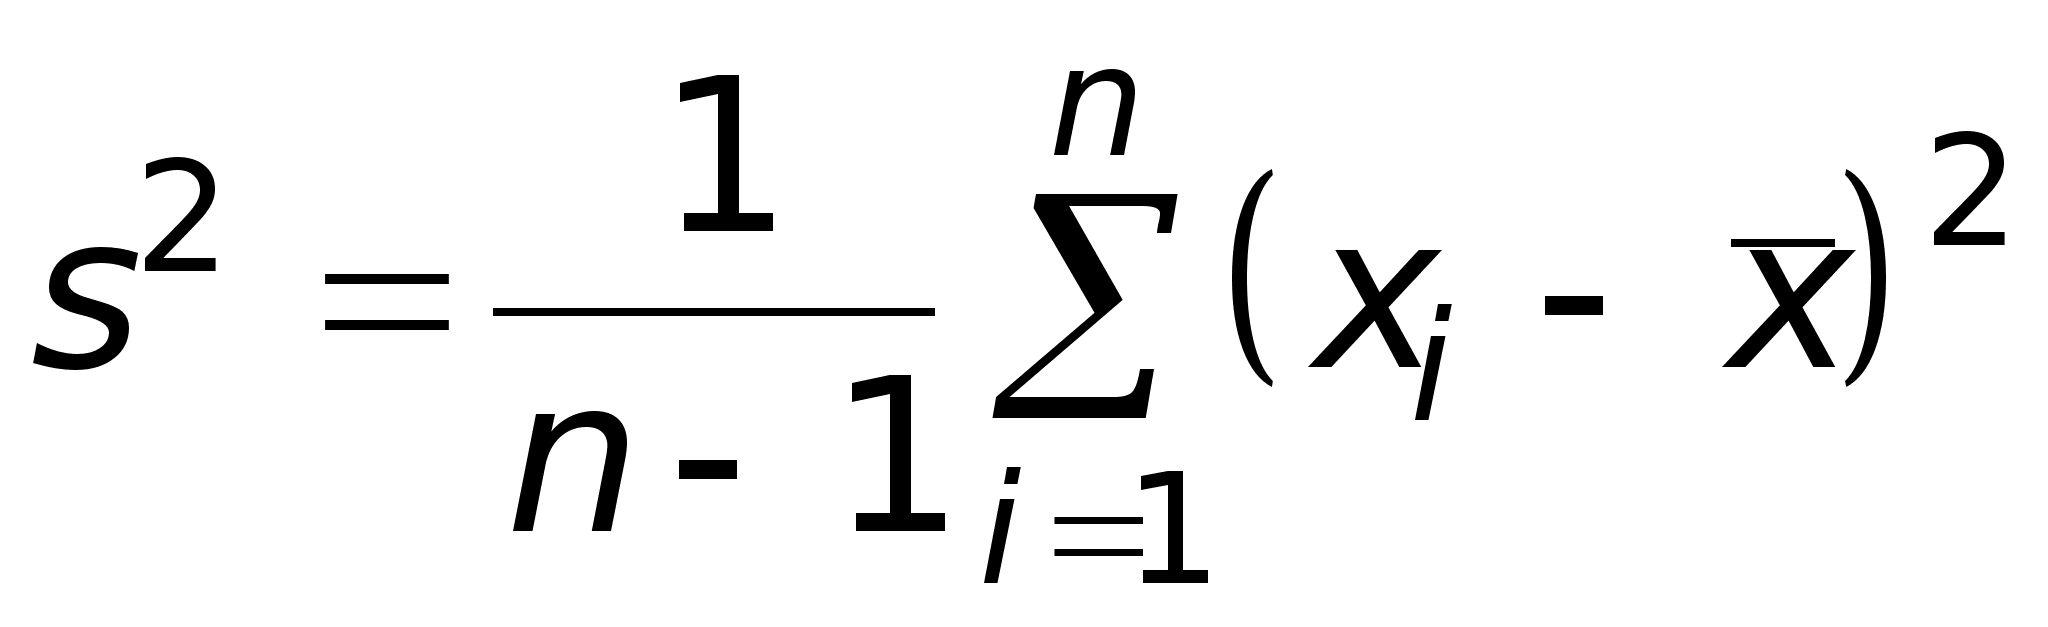
Пусть имеется ряд несмещенных точечных оценок одного и того же параметра генеральной совокупности. Та оценка, которая имеет наименьшую дисперсию называется эффективной.
Полученная
из выборки
объема n
точечная оценка
dn
параметра D
генеральной
совокупности
называется
состоятельной,
если она сходится
по вероятности
к D.
Это означает,
что для любых
положительных
чисел e
и g
найдется такое
число neg
, что для всех
чисел n,
удовлетворяющих
неравенству
n > neg
выполняется
условие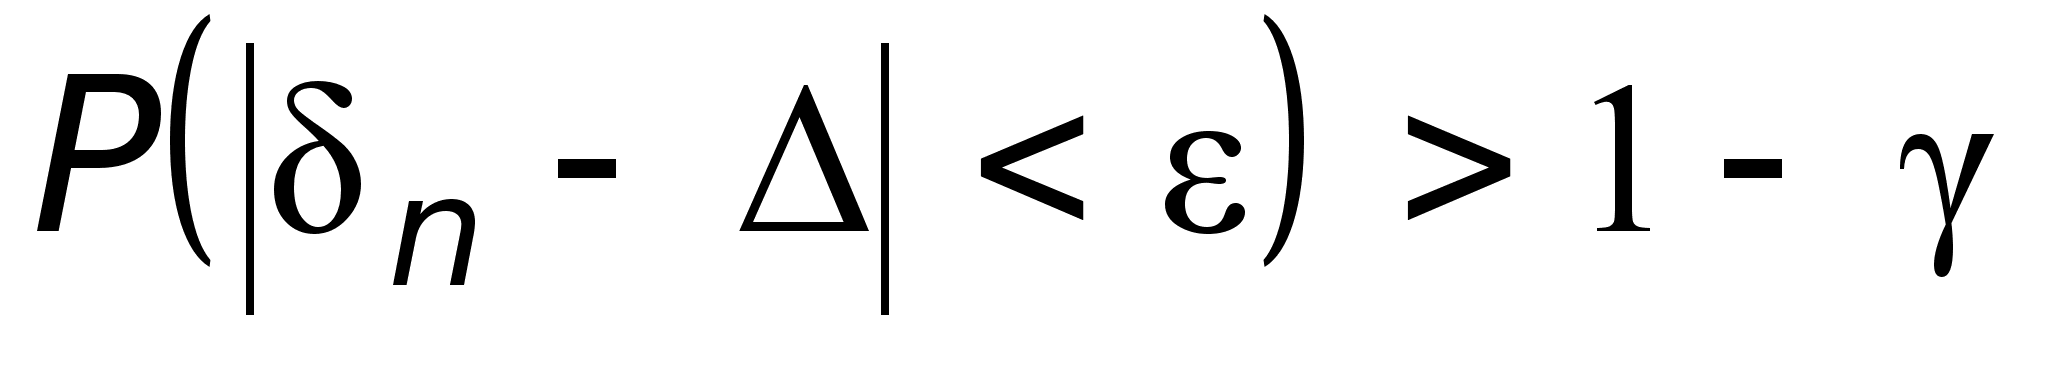 .
и
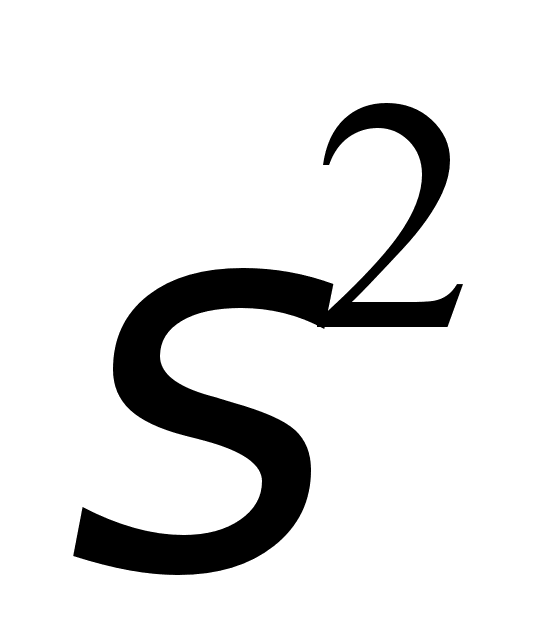 являются
несмещёнными,
состоятельными
и эффективными
оценками величин
Mx
и Dx.
Лекция 12.
Интервальные оценки.
Точечные оценки параметров генеральной совокупности могут быть приняты в качестве ориентировочных, первоначальных результатов обработки выборочных данных. Их недостаток заключается в том, что неизвестно, с какой точностью оценивается параметр. Если для выборок большого объема точность обычно бывает достаточной (при условии несмещенности, эффективности и состоятельности оценок), то для выборок небольшого объема вопрос точности оценок становится очень важным.
Введем понятие интервальной оценки неизвестного параметра генеральной совокупности (или случайной величины , определенной на множестве объектов этой генеральной совокупности). Обозначим этот параметр через . По сделанной выборке по определенным правилам найдем числа 1 и 2, так чтобы выполнялось условие:
P(1< < 2) =P ((1; 2)) =
Числа 1 и 2 называются доверительными границами, интервал (1, 2) — доверительным интервалом для параметра . Число называется доверительной вероятностью или надежностью сделанной оценки.
Сначала задается надежность. Обычно ее выбирают равной 0.95, 0.99 или 0.999. Тогда вероятность того, что интересующий нас параметр попал в интервал (1, 2) достаточно высока. Число (1 + 2) / 2 – середина доверительного интервала – будет давать значение параметра с точностью (2 – 1) / 2, которая представляет собой половину длины доверительного интервала.
Границы 1 и 2 определяются из выборочных данных и являются функциями от случайных величин x1, x2,..., xn , а следовательно – сами случайные величины. Отсюда – доверительный интервал (1, 2) тоже случаен. Он может покрывать параметр или нет. Именно в таком смысле нужно понимать случайное событие, заключающееся в том, что доверительный интервал покрывает число .
Доверительный интервал для математического ожидания нормального распределения при известной дисперсии.
Пусть случайная величина (можно говорить о генеральной совокупности) распределена по нормальному закону, для которого известна дисперсия D = 2 ( > 0). Из генеральной совокупности (на множестве объектов которой определена случайная величина) делается выборка объема n. Выборка x1, x2,..., xn рассматривается как совокупность n независимых случайных величин, распределенных так же как (подход, которому дано объяснение выше по тексту).
Ранее также обсуждались и доказаны следующие равенства:
Mx1 = Mx2 = ... = Mxn = M;
Dx1 = Dx2 = ... = Dxn = D;
 M;
 D
/n;
Достаточно
просто доказать
(мы доказательство
опускаем), что
случайная
величина
 в данном случае
также распределена
по нормальному
закону.
Обозначим неизвестную величину M через a и подберем по заданной надежности число d > 0 так, чтобы выполнялось условие:
P(–
a
< d) =
(1)
Так
как случайная
величина
распределена
по нормальному
закону с математическим
ожиданием M
= M
= a и
дисперсией
D
= D
/n =
2/n,
получаем:
P(–
a
< d)
=P(a
– d <
< a +
d) =
=
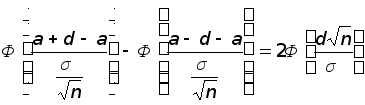
Осталось
подобрать d
таким, чтобы
выполнялось
равенство
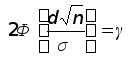 или
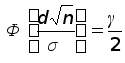 .
Для
любого
[0;1]
можно по таблице
найти такое
число t,
что
(
t )=
/ 2. Это число
t иногда
называют квантилем.
Теперь из равенства

определим
значение d:
 .
Окончательный результат получим, представив формулу (1) в виде:
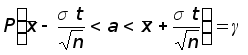 .
Смысл последней формулы состоит в следующем: с надежностью доверительный интервал
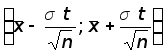
покрывает
неизвестный
параметр a
= M
генеральной
совокупности.
Можно сказать
иначе: точечная
оценка
определяет
значение параметра
M
с точностью
d=
t / и надежностью
.
Задача.
Пусть имеется
генеральная
совокупность
с некоторой
характеристикой,
распределенной
по нормальному
закону с дисперсией,
равной 6,25. Произведена
выборка объема
n = 27 и
получено
средневыборочное
значение
характеристики
=
12. Найти доверительный
интервал, покрывающий
неизвестное
математическое
ожидание исследуемой
характеристики
генеральной
совокупности
с надежностью
=0,99.
Решение.
Сначала по
таблице для
функции Лапласа
найдем значение
t из
равенства
(t) =
/ 2 = 0,495.
По полученному
значению
t
= 2,58 определим
точность оценки
(или половину
длины доверительного
интервала) d:
d =
2,52,58 / 
1,24. Отсюда получаем
искомый доверительный
интервал: (10,76;
13,24).
Доверительный интервал для математического ожидания нормального распределения при неизвестной дисперсии.
Пусть
– случайная
величина,
распределенная
по нормальному
закону с неизвестным
математическим
ожиданием M,
которое обозначим
буквой a
. Произведем
выборку объема
n. Определим
среднюю выборочную
и исправленную
выборочную
дисперсию s2
по известным
формулам.
Случайная величина
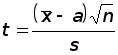
распределена по закону Стьюдента с n – 1 степенями свободы.
Задача заключается в том, чтобы по заданной надежности и по числу степеней свободы n – 1 найти такое число t , чтобы выполнялось равенство
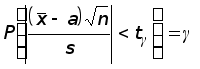 (2)
или эквивалентное равенство
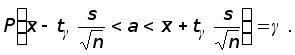 (3)
Здесь в
скобках написано
условие того,
что значение
неизвестного
параметра a
принадлежит
некоторому
промежутку,
который и является
доверительным
интервалом.
Его границы
зависят от
надежности
, а также от
параметров
выборки
и s.
Чтобы определить значение t по величине , равенство (2) преобразуем к виду:
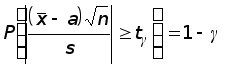
Теперь по таблице для случайной величины t, распределенной по закону Стьюдента, по вероятности 1 – и числу степеней свободы n – 1 находим t . Формула (3) дает ответ поставленной задачи.
Задача. На контрольных испытаниях 20-ти электроламп средняя продолжительность их работы оказалась равной 2000 часов при среднем квадратическом отклонении (рассчитанном как корень квадратный из исправленной выборочной дисперсии), равном 11-ти часам. Известно, что продолжительность работы лампы является нормально распределенной случайной величиной. Определить с надежностью 0,95 доверительный интервал для математического ожидания этой случайной величины.
Решение.
Величина 1 –
в данном
случае равна
0,05. По таблице
распределения
Стьюдента, при
числе степеней
свободы, равном
19, находим: t
= 2,093. Вычислим
теперь точность
оценки: 2,093121/ = 56,6. Отсюда получаем
искомый доверительный
интервал:
(1943,4; 2056,6).
Доверительный интервал для дисперсии нормального распределения.
Пусть случайная величина распределена по нормальному закону, для которого дисперсия D неизвестна. Делается выборка объема n . Из нее определяется исправленная выборочная дисперсия s2. Случайная величина
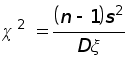
распределена по закону 2 c n –1 степенями свободы. По заданной надежности можно найти сколько угодно границ 12 и 22 интервалов, таких, что
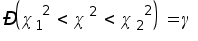 (*)
Найдем 12 и 22 из следующих условий:
P(2 12) = (1 – )/ 2 (**)
P(2 22) = (1 – )/ 2 (***)
Очевидно, что при выполнении двух последних условий справедливо равенство (*).
В таблицах для случайной величины 2 обычно дается решение уравнения P(2 q2) = q . Из такой таблицы по заданной величине q и по числу степеней свободы n – 1 можно определить значение q2. Таким образом, сразу находится значение 22 в формуле (***).
Для определения 12 преобразуем (**):
P(2 12) = 1 – (1 – )/ 2 = (1 + )/ 2
Полученное равенство позволяет определить по таблице значение 12.
Теперь, когда найдены значения 12 и 22, представим равенство (*) в виде
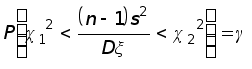 .
Последнее
равенство
перепишем в
такой форме,
чтобы были
определены
границы доверительного
интервала для
неизвестной
величины
D:
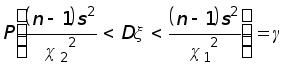 .
Отсюда легко получить формулу, по которой находится доверительный интервал для стандартного отклонения:
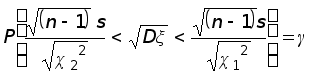 (****)
Задача. Будем считать, что шум в кабинах вертолетов одного и того же типа при работающих в определенном режиме двигателях — случайная величина, распределенная по нормальному закону. Было случайным образом выбрано 20 вертолетов, и произведены замеры уровня шума (в децибелах) в каждом из них. Исправленная выборочная дисперсия измерений оказалась равной 22,5. Найти доверительный интервал, накрывающий неизвестное стандартное отклонение величины шума в кабинах вертолетов данного типа с надежностью 98%.
Решение.
По числу степеней
свободы, равному
19, и по вероятности
(1 – 0,98)/2 = 0,01 находим
из таблицы
распределения
2
величину
22 = 36,2.
Аналогичным
образом при
вероятности
(1 + 0,98)/2 = 0,99 получаем
12 = 7,63.
Используя
формулу (****), получаем
искомый доверительный
интервал: (3,44;
7,49).
Лекция 13.
Задачи статистической проверки гипотез.
Статистическая проверка гипотез является вторым после статистического оценивания параметров распределения и в то же время важнейшим разделом математической статистики.
Методы математической статистики позволяют проверить предположения о законе распределения некоторой случайной величины (генеральной совокупности), о значениях параметров этого закона (например M, D ), о наличии корреляционной зависимости между случайными величинами, определенными на множестве объектов одной и той же генеральной совокупности.
Пусть по некоторым данным имеются основания выдвинуть предположения о законе распределения или о параметре закона распределения случайной величины (или генеральной совокупности, на множестве объектов которой определена эта случайная величина). Задача заключается в том, чтобы подтвердить или опровергнуть это предположение, используя выборочные (экспериментальные) данные.
Гипотезы о значениях параметров распределения или о сравнительной величине параметров двух распределений называются параметрическими гипотезами.
Гипотезы о виде распределения называются непараметрическими гипотезами.
Проверить статистическую гипотезу – это значит проверить, согласуются ли данные, полученные из выборки с этой гипотезой. Проверка осуществляется с помощью статистического критерия. Статистический критерий – это случайная величина, закон распределения которой (вместе со значениями параметров) известен в случае, если принятая гипотеза справедлива. Этот критерий называют еще критерием согласия (имеется в виду согласие принятой гипотезы с результатами, полученными из выборки).
Гипотезу, выдвинутую для проверки ее согласия с выборочными данными, называют нулевой гипотезой и обозначают H0. Вместе с гипотезой H0 выдвигается альтернативная или конкурирующая гипотеза, которая обозначается H1. Например:
| 1) |
H0: M= 0 |
2) |
H0: M= 0 |
3) |
H0: M= 0 |
|
H1: M 0 |
H1: M> 0 |
H1: M= 2 |
Пусть случайная величина K – статистический критерий проверки некоторой гипотезы H0. При справедливости гипотезы H0 закон распределения случайной величины K характеризуется некоторой известной нам плотностью распределения pK(x).
Выберем некоторую малую вероятность , равную 0,05 , 0,01 или еще меньшую. Определим критическое значение критерия Kкр как решение одного из трех уравнений, в зависимости от вида нулевой и конкурирующей гипотез:
P(K> Kкр) = (1)
P(K< Kкр) = (2)
P((K< Kкр1)(K> Kкр2)) = (3)
Возможны и другие уравнения, но они встречаются значительно реже, чем приведенные.
Решение уравнения (1) (то же самое для уравнений (2) и (3)) заключается в следующем: по вероятности , зная функцию pK(x), заданную как правило таблицей, нужно определить Kкр.
Что означает условие (1)?
Если гипотеза H0 справедлива, то вероятность того, что критерий K превзойдет некоторое значение Kкр очень мала – 0,05 , 0,01 или еще меньше, в зависимости от нашего выбора. Если Kв – значение критерия K, рассчитанное по выборочным данным, превзошло значение Kкр, это означает, что выборочные данные не дают основания для принятия нулевой гипотезы H0 ( например, если =0,01 , то можно сказать, что произошло событие, которое при справедливости гипотезы H0 встречается в среднем не чаще, чем в одной из ста выборок). В этом случае говорят, что гипотеза H0 несогласуется с выборочными данными и должна быть отвергнута. Если Kв не превосходит Kкр, то говорят, что выборочные данные непротиворечат гипотезе H0, и нет оснований отвергать эту гипотезу.
Для уравнения (1) область K> Kкр называется критической областью. Если значение Kв попадает в критическую область, то гипотеза H0 отвергается.
Для уравнения (1) область K < Kкр называется областьюпринятия гипотезы. Если значение Kв попадает в область принятия гипотезы, то гипотеза H0 принимается.
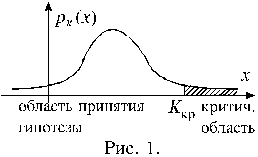
Пусть выбрано некоторое малое значение вероятности , по нему определено значение Kкр и по выборочным данным определено значение Kв, которое попало в критическую область. В этом случае гипотеза H0 отвергается, но она может оказаться справедливой, просто случайно произошло событие, которое имеет очень малую вероятность . В этом смысле есть вероятность отвержения правильной гипотезы H0.
Отвержение правильной гипотезы называется ошибкой первогорода. Вероятность называется уровнем значимости. Таким образом уровень значимости – это вероятность совершения ошибки первого рода.
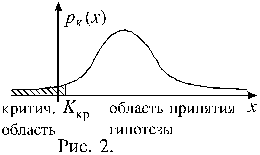
Уравнение (2) определяет левосторонюю критическую область. Ее изображение приводится на рисунке 2.
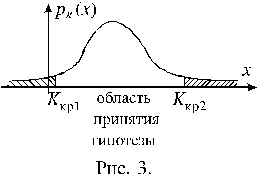
Уравнение (3) определяет двусторонюю критическую область. Такая область изображена на рисунке 3. Здесь критическая область состоит из двух частей. В случае двусторонней критической области границы ее частей Kкр1 и Kкр2 определяются таким образом, чтобы выполнялось условие:
P(K Kкр) = P(K Kкр) = / 2.
На рисунке 3. площадь каждой из заштрихованных фигур равна / 2.
Вид критической области зависит от того, какая гипотеза выдвинута в качестве конкурирующей.
Чем меньше уровень значимости, тем меньше вероятность отвергнуть проверяемую гипотезу H0, когда она верна, то есть совершить ошибку первого рода. Но с уменьшением уровня значимости расширяется область принятия гипотезы H0 и увеличивается вероятность принятия проверяемой гипотезы, когда она неверна, то есть когда предпочтение должно быть отдано конкурирующей гипотезе.
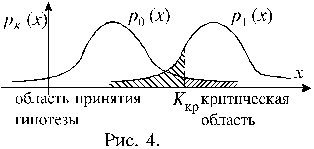
Пусть при справедливости гипотезы H0 статистический критерий K имеет плотность распределения p0(x), а при справедливости конкурирующей гипотезы H1 – плотность распределения p1(x). Графики этих функций приведены на рисунке 4. При некотором уровне значимости находится критическое значение Kкр и правостороняя критическая область. Если значение Kв, определенное по выборочным данным, оказывается меньше, чем Kкр, то гипотеза H0 принимается. Предположим, что справедлива на самом деле конкурирующая гипотеза H1. Тогда вероятность попадания критерия в область принятия гипотезы H0 есть некоторое число , равное площади фигуры, образованной графиком функции p1(x) и полубесконечной частью горизонтальной координатной оси, лежащей слева от точки Kкр. Очевидно, что – это вероятность того, что будет принята неверная гипотеза H0.
Принятие неверной гипотезы называется ошибкой второго рода. В рассмотренном случае число – это вероятность ошибки второго рода. Число 1 – , равное вероятности того, что не совершается ошибка второгорода, называется мощностью критерия. На рисунке 4 мощность критерия равна площади фигуры, образованной графиком функции p1(x).и полубесконечной частью горизонтальной координатной оси, лежащей справа от точки Kкр.
Выбор статистического критерия и вида критической области осуществляется таким образом, чтобы мощность критерия была максимальной.
Лекция 14.
Проверка статистической гипотезы о математическом ожидании нормального распределения при известной дисперсии.
Пусть имеется нормально распределенная случайная величина ,, определенная на множестве объектов некоторой генеральной совокупности. Известно, что D = 2. Математическое ожидание M неизвестно. Допустим, что имеются основания предполагать, что M = a, где a – некоторое число (такими основаниями могут быть ограниченные сведения об объектах генеральной совокупности, опыт исследования подобных совокупностей и т. д.). Будем считать также, что имеется другая информация, указывающая на то, что M = a1, где a1 > a.
I. Выдвигаем нулевую гипотезу H0: M = a;
при конкурирующей гипотезе H1: M = a1.
Делаем
выборку объема
n: x1,
x2,...,
xn .
В основе проверки
лежит тот факт,
что случайная
величина
 (выборочная
средняя) распределена
по нормальному
закону с дисперсией
2/n
и математическим
ожиданием,
равным a
в случае справедливости
H0,
и равным a1
в случае справедливости
H1.
Очевидно,
что если величина
оказывается
достаточно
малой, то это
дает основание
предпочесть
гипотезу H0
гипотезе H1.
При достаточно
большом значении
более вероятна
справедливость
гипотезы H1.
Задачу можно
было бы поставить
так: требуется
найти некоторое
критическое
число, которое
разбивало бы
все возможные
значения выборочной
средней ( в условиях
данной задачи
это все действительные
числа ) на два
полубесконечных
промежутка.
При попадании
в левый промежуток
следовало бы
принимать
гипотезу H0,
а при попадании
в правый промежуток
предпочтение
следовало бы
оказать гипотезе
H1.
Однако на самом
деле поступают
несколько
иначе.
В качестве статистического критерия выбирается случайная величина
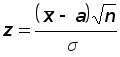 ,
распределенная
по нормальному
закону , причем
Mz = 0 и
Dz = 1 (
это следует
из свойств
математического
ожидания и
дисперсии ) в
случае справедливости
гипотезы H0.
Если справедлива
гипотеза H1,
то
Mz
= a* = (
a1
– a
) /,
Dz = 1.
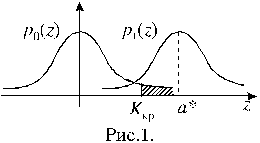
Если
величина
,
полученная
из выборочных
данных, относительно
велика, то и
величина z
велика, что
является
свидетельством
в пользу гипотезы
H1.
Относительно
малые значения
приводят к
малым значениям
z, что
свидетельствует
в пользу гипотезы
H0.
Отсюда следует,
что должна быть
выбрана правосторонняя
критическая
область. По
принятому
уровню значимости
(например
= 0,05), используя
то, что случайная
величина z
распределена
по нормальному
закону, определим
значение Kкр
из формулы
= P(Kкр < z <) = () – (Kкр) = 0,5 – (Kкр).
Отсюда
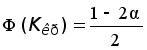 ,
и осталось
воспользоваться
таблицей функции
Лапласа для
нахождения
числа Kкр.
Если
величина z,
полученная
при выборочном
значении
,
попадает в
область принятия
гипотезы