Серьёзные лекции по высшей экономической математике
Используя определение дисперсии, для дискретной случайной величины формулу вычисления дисперсии можно представить в таком виде:
D = 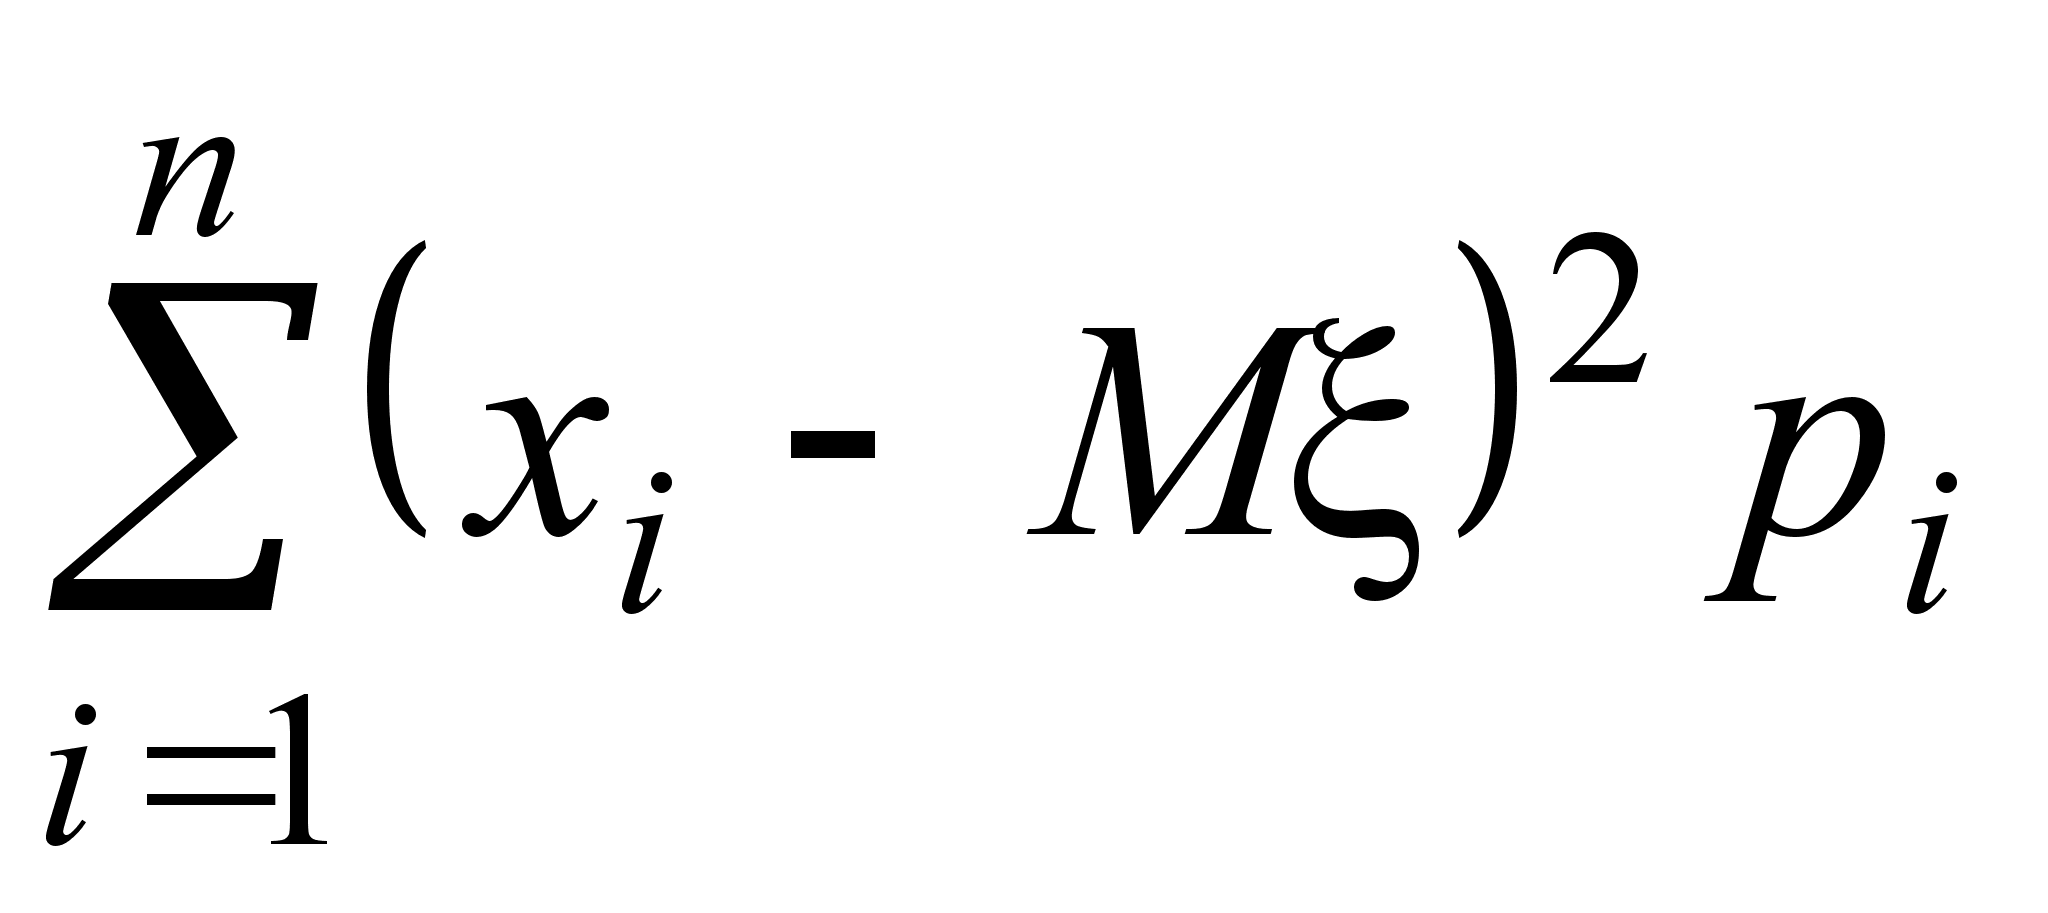
Можно вывести ещё одну формулу для вычисления дисперсии:
D = 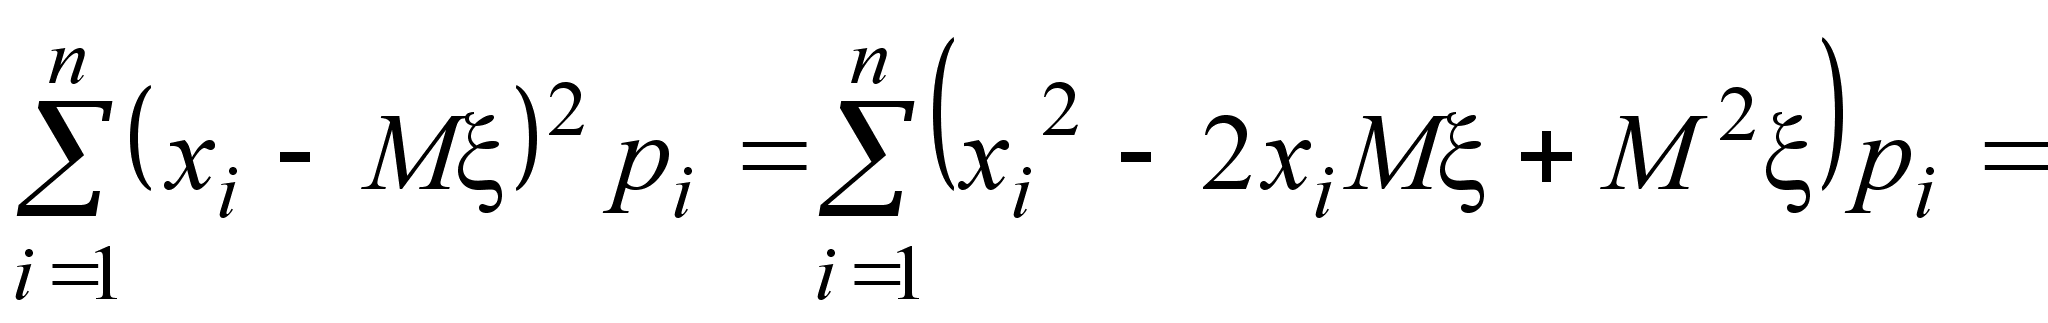
= 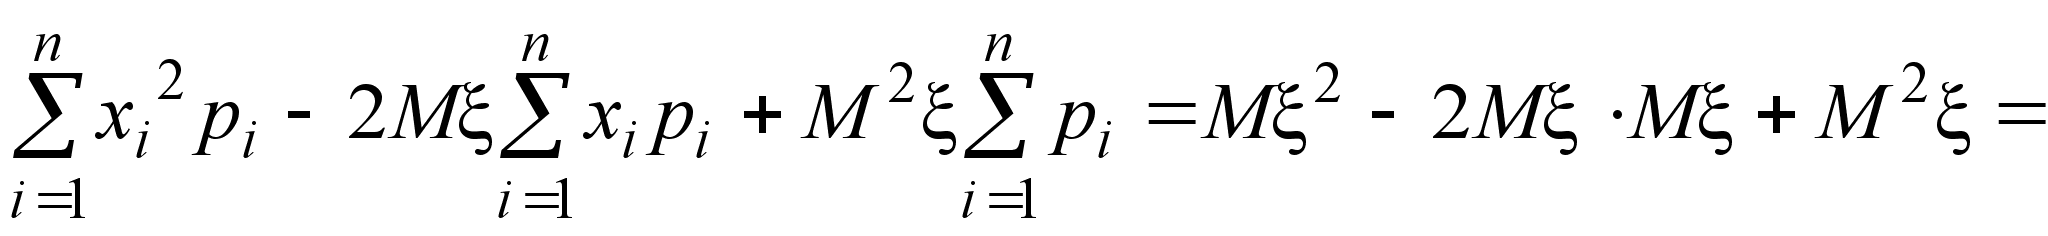
= M2 – M2
Таким образом, дисперсия случайной величины равна разности математического ожидания квадрата случайной величины и квадрата её математического ожидания.
Пример.
Найти дисперсию случайной величины, заданной законом распределения
-
1 0 Р
p
q
Выше было показано, что M = р. Легко видеть, что M2 = р. Таким образом, получается, что D = р – р2 = pq.
Дисперсия характеризует степень рассеяния значений случайной величины относительно её математического ожидания. Если все значения случайной величины тесно сконцентрированы около её математического ожидания и большие отклонения от математического ожидания маловероятны, то такая случайная величина имеет малую дисперсию. Если значения случайной величины рассеяны и велика вероятность больших отклонений от математического ожидания, то такая случайная величина имеет большую дисперсию.
Свойства дисперсии.
Если k – число, то D(k) = k2 D.
Доказательство.
D(k) = M(k – M(k))2 = M(k – k M)2 = M(k2 ( – M)2) = k2M( – M)2 =
= k2 D
Для попарно независимых случайных величин 1, 2,, n справедливо равенство
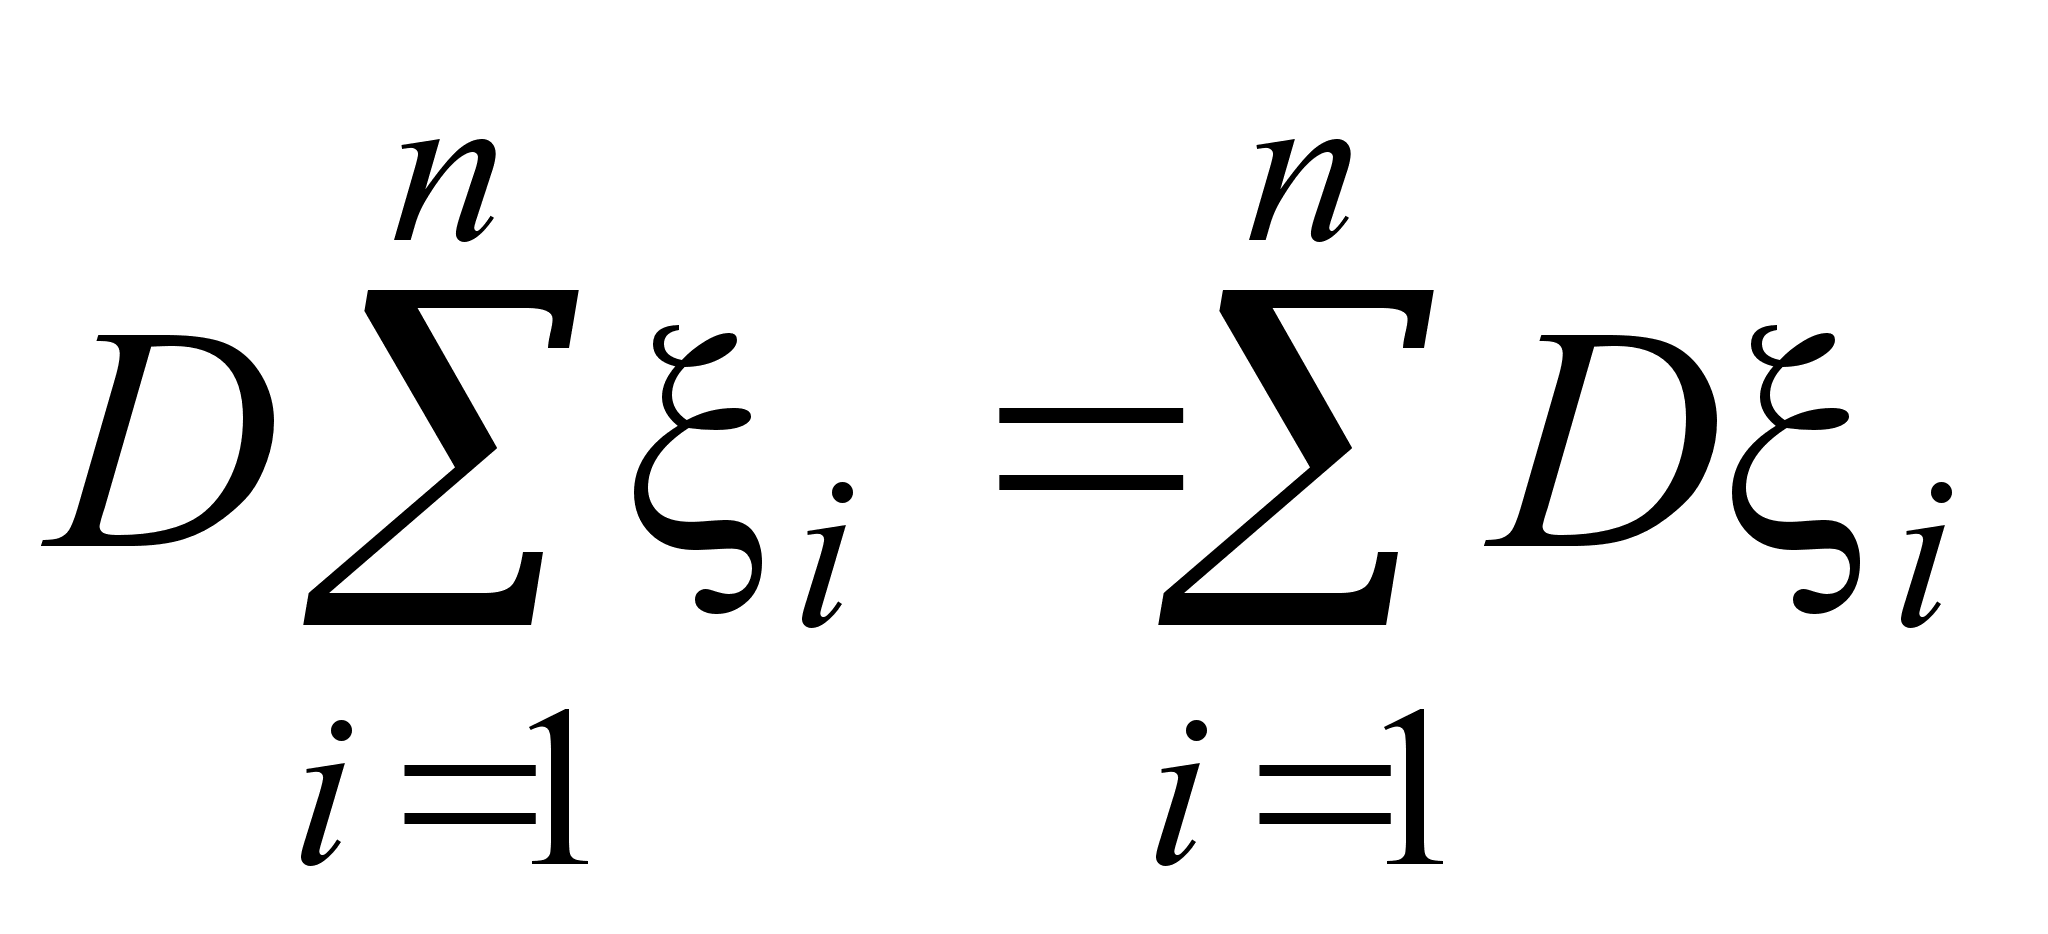
Это свойство оставим без доказательства. Рекомендуем читателю рассмотреть следующий пример.
Пусть и – независимые случайные величины с заданными законами распределения:
-
0
1
1
2
Р
0,25
0,75
Р
0,7
0,7
Показать, что D( + ) = D + D.
Биномиальный закон распределения.
Пусть заданы числа n N и p (0 p 1). Тогда каждому целому числу из промежутка [0; n] можно поставить в соответствие вероятность, рассчитанную по формуле Бернулли. Получим закон распределения случайной величины (назовём её )
-
0
k
n
Р
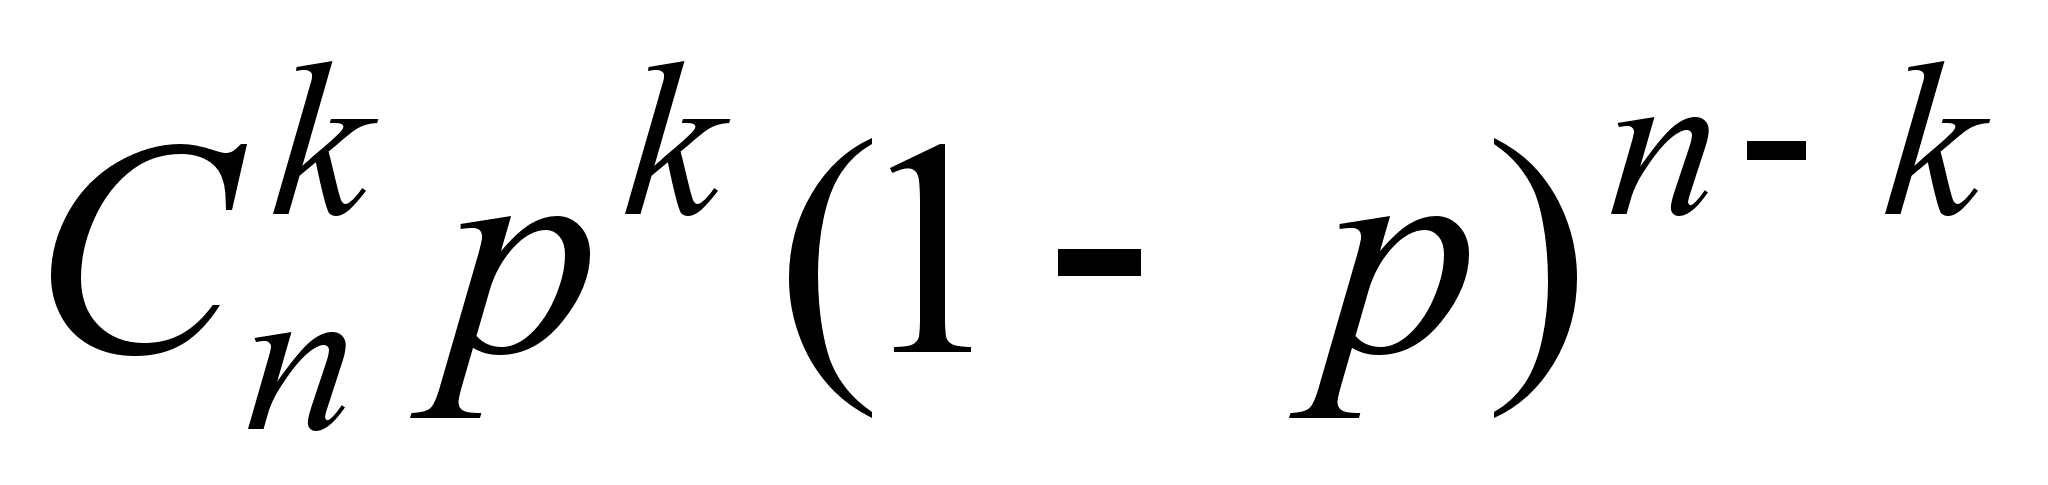
Будем говорить, что случайная величина распределена по закону Бернулли. Такой случайной величиной является частота появления события А в n повторных независимых испытаниях, если в каждом испытании событие А происходит с вероятностью p.
Рассмотрим отдельное i-е испытание. Пространство элементарных исходов для него имеет вид
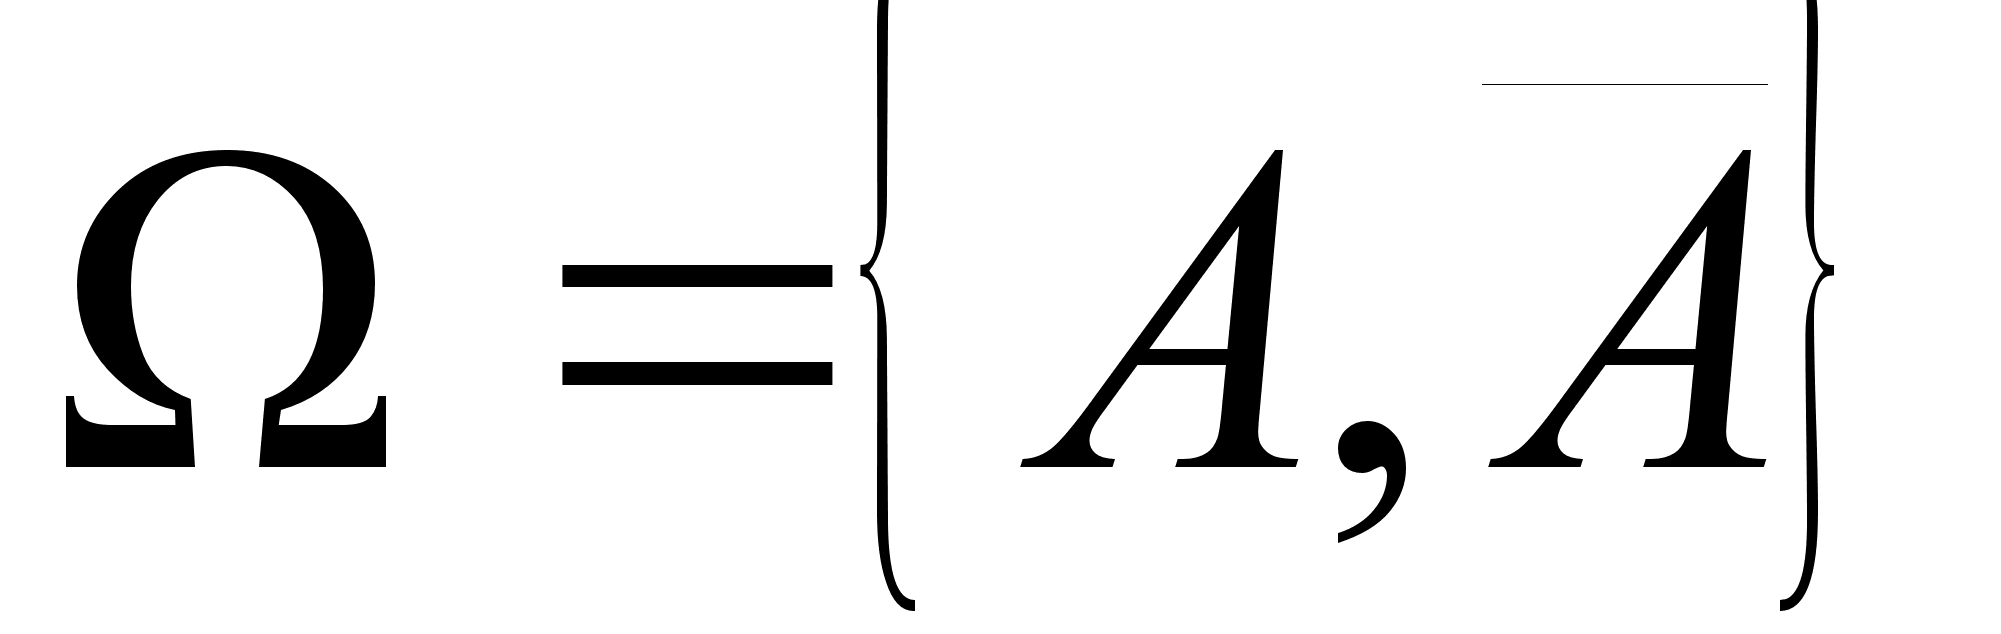
Определим на этом пространстве случайную величину i следующим образом:
i = 1, если происходит событие А;
i
= 0,
если происходит
событие
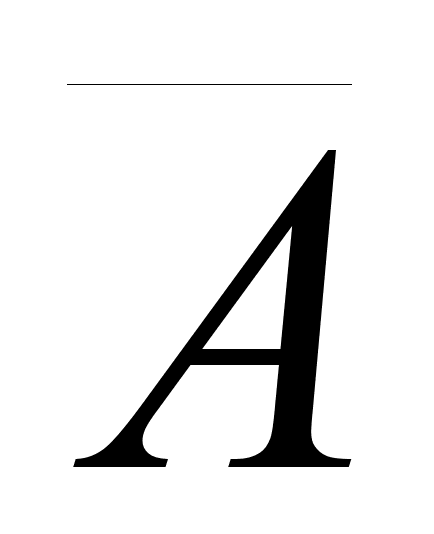
Закон распределения случайной величины i рассматривался в предыдущем параграфе.
-
i
1
0
Р
p
q = 1–p
M = р; D = рq
Для
i = 1,2,,n
получаем систему
из n
независимых
случайных
величин i,
имеющих одинаковые
законы распределения.
Если теперь
сравнить законы
распределения
двух случайных
величин
и
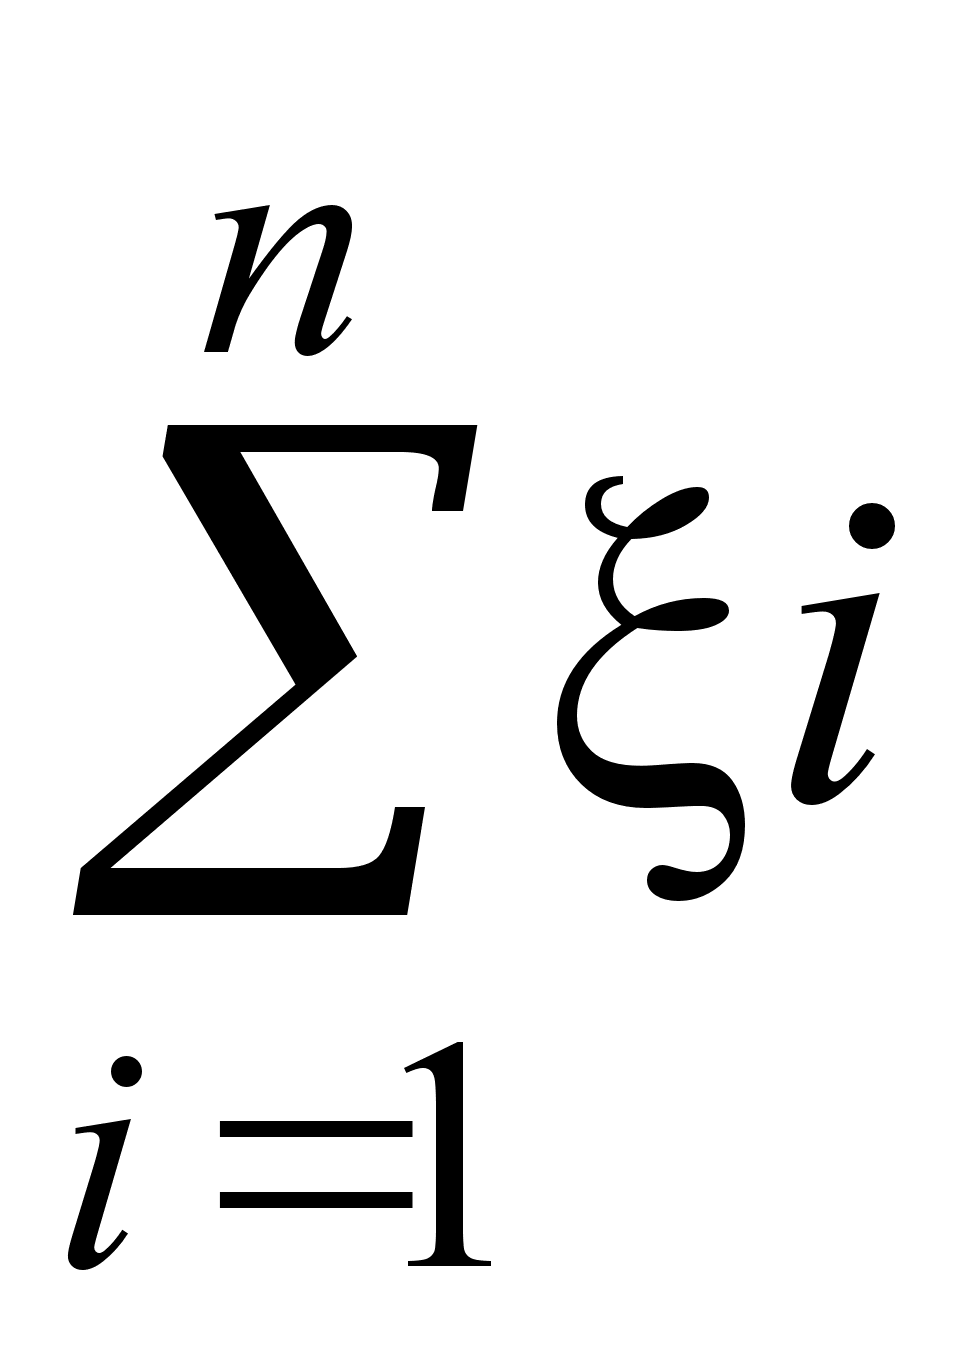 ,
то можно сделать
очевидный
вывод:
=
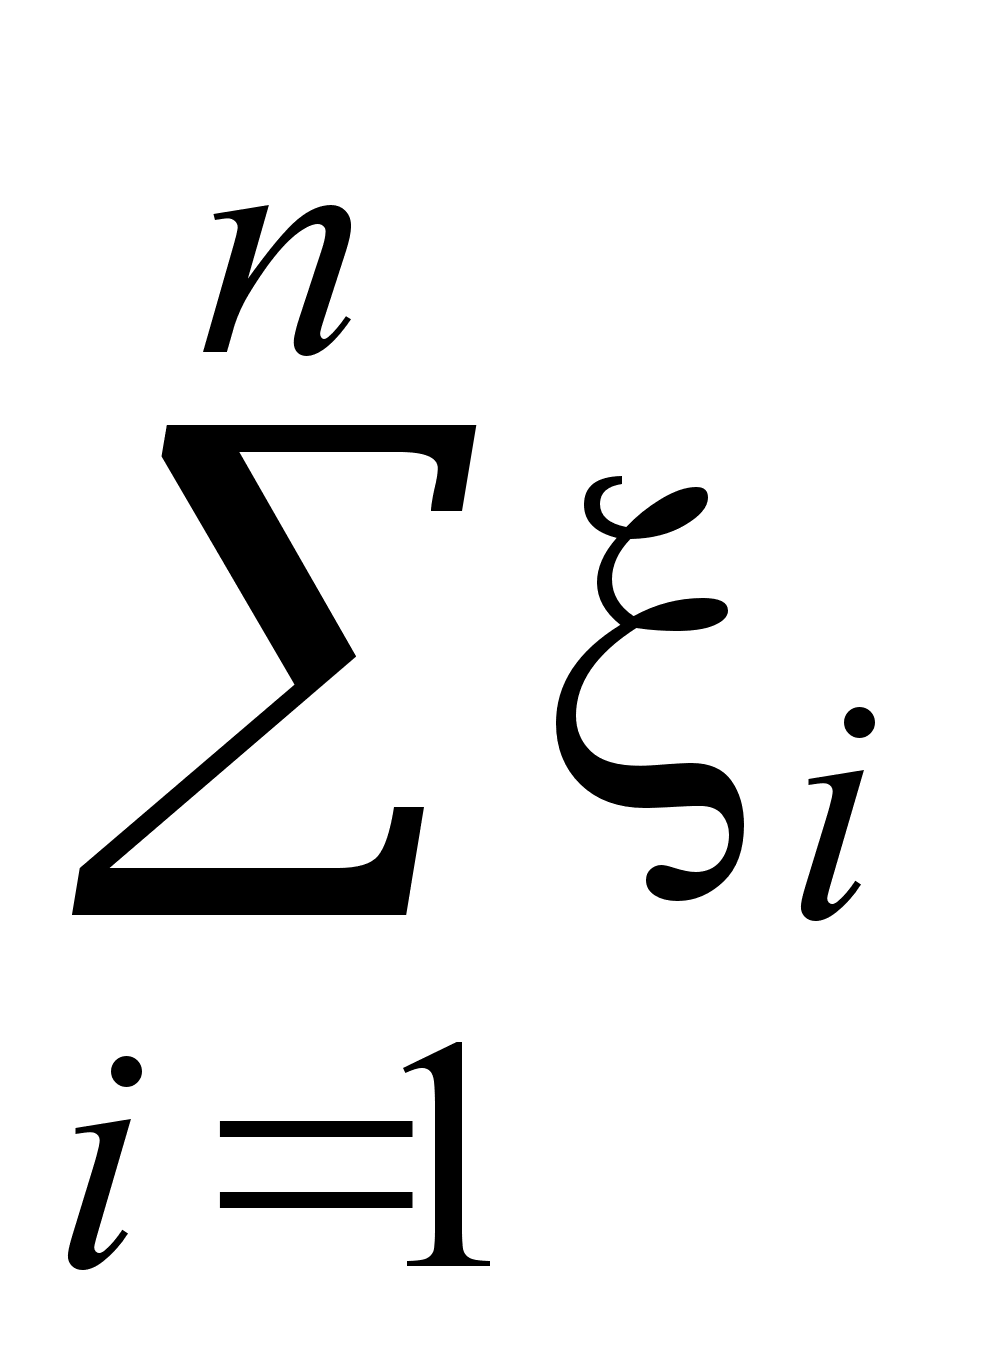 .
Отсюда следует,
что для случайной
величины ,
имеющей закон
распределения
Бернулли,
математическое
ожидание и
дисперсия
определяются
формулами
M
= M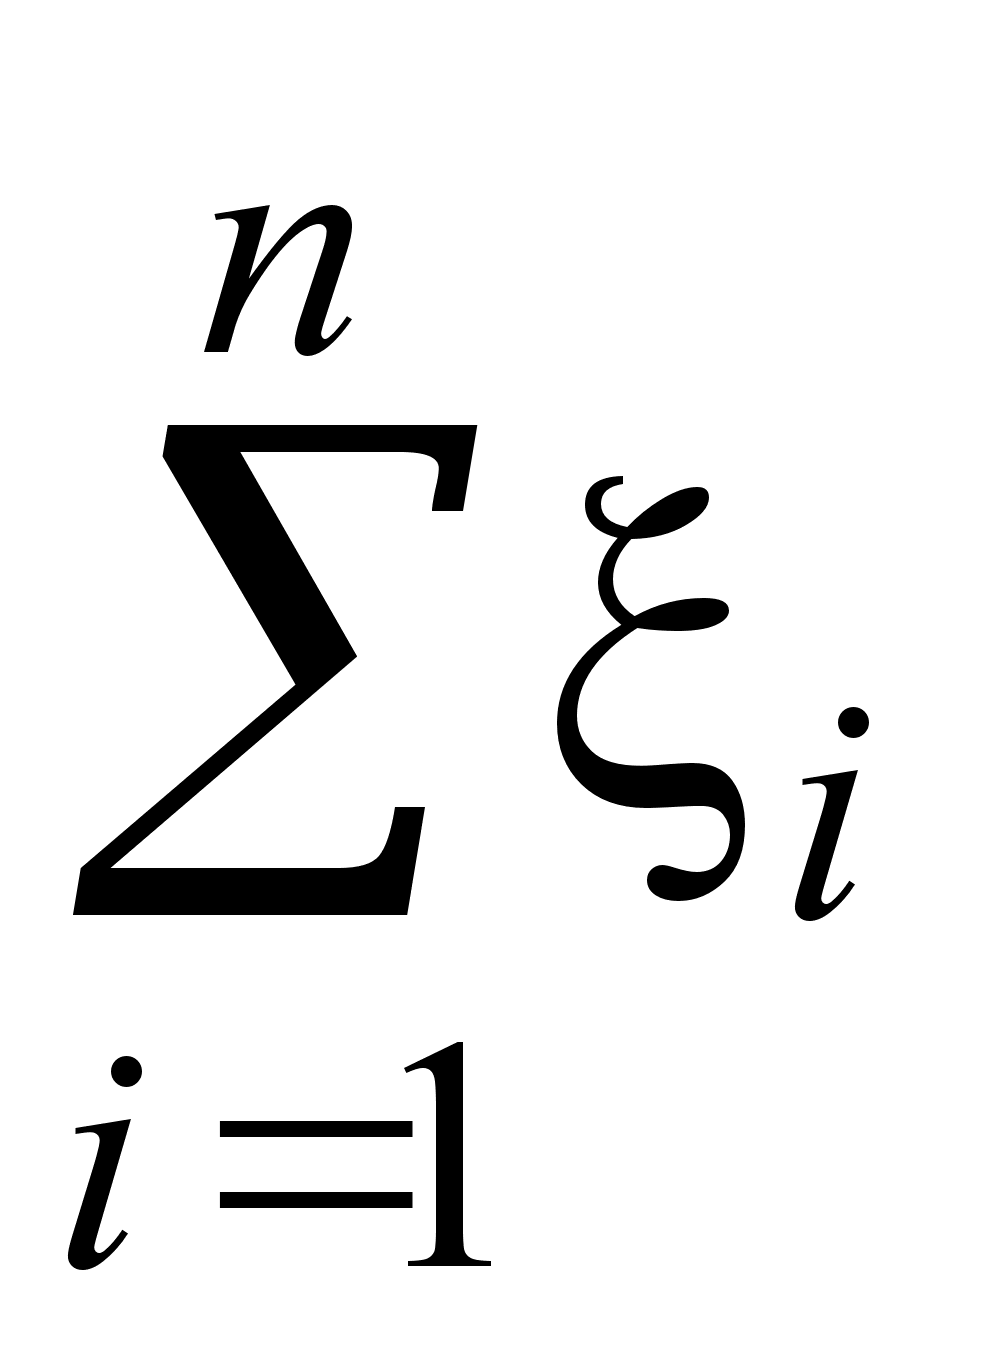 =
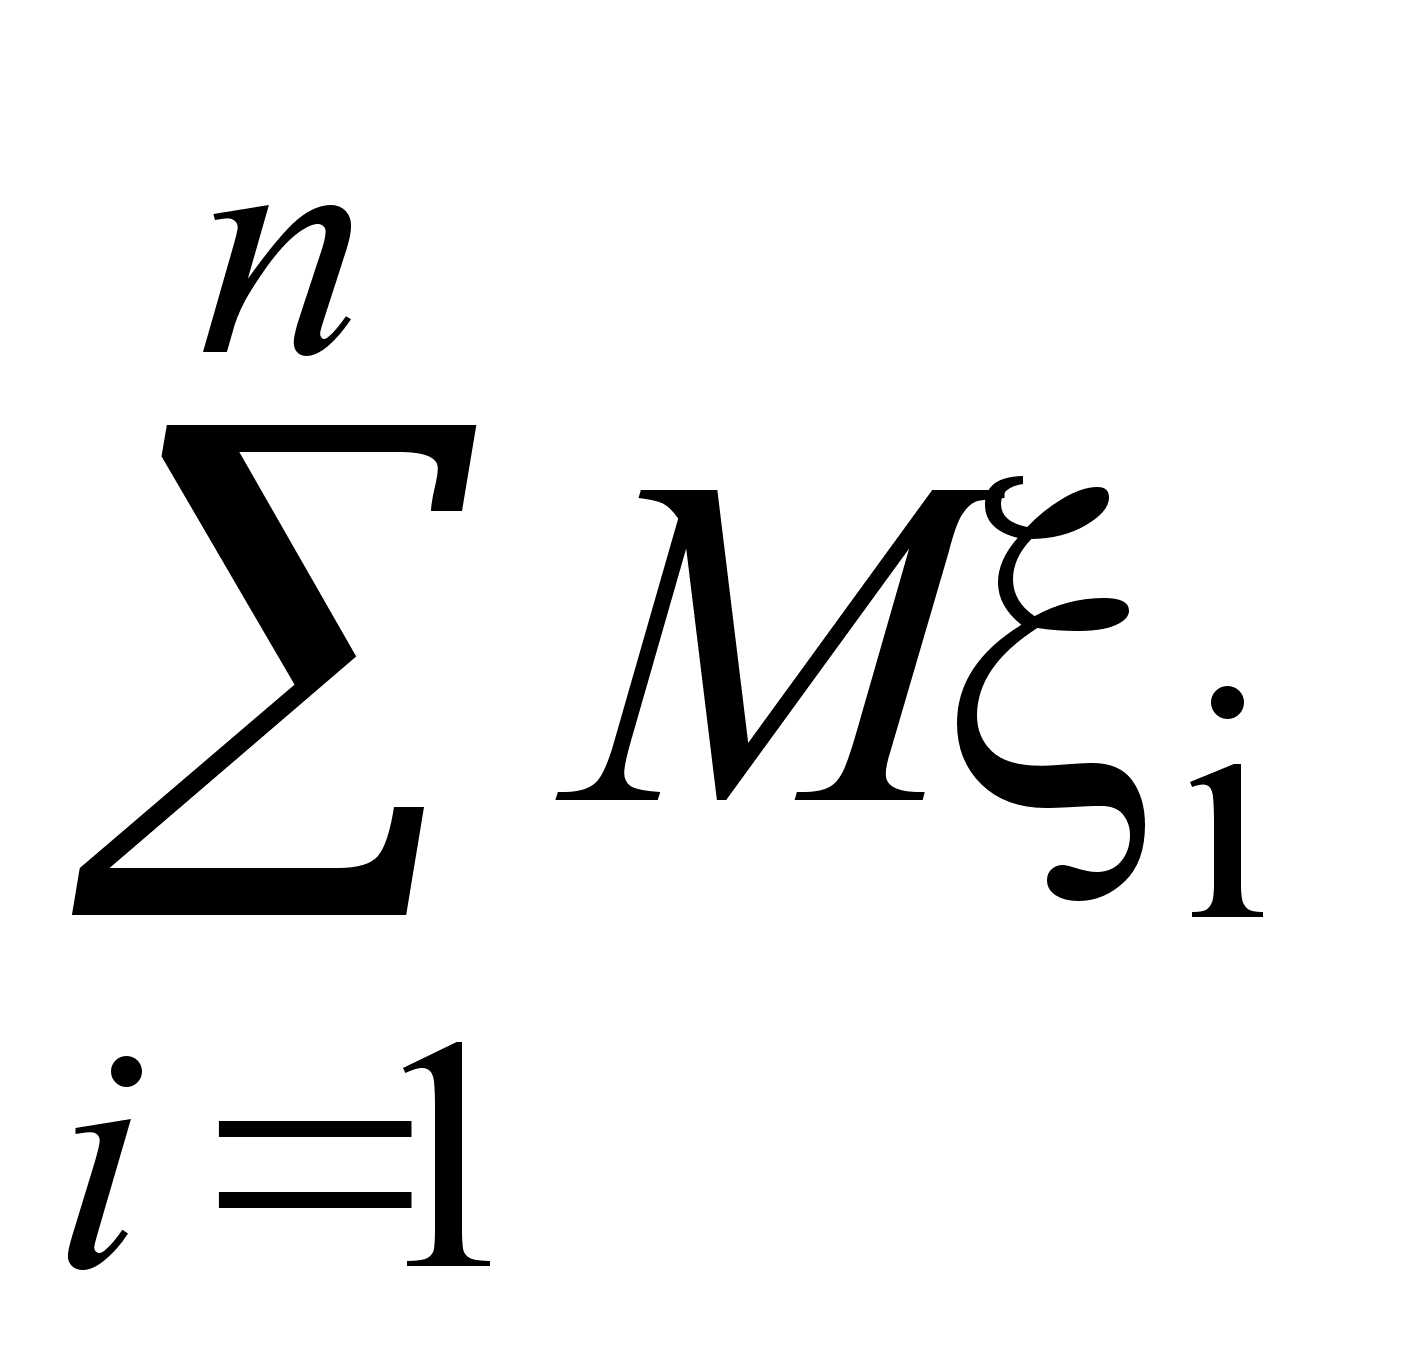 =
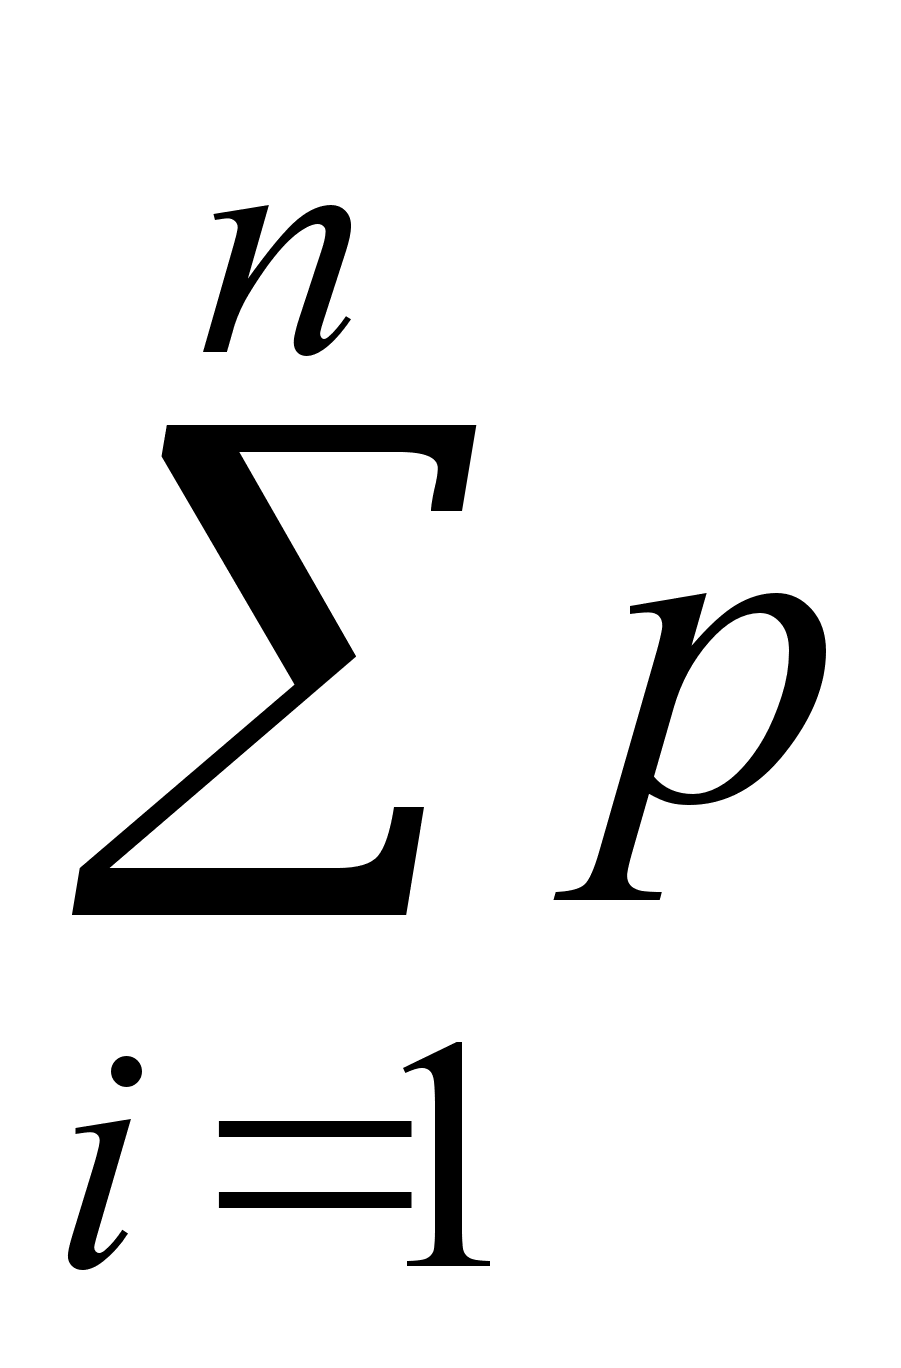 =
np;
D
= D=
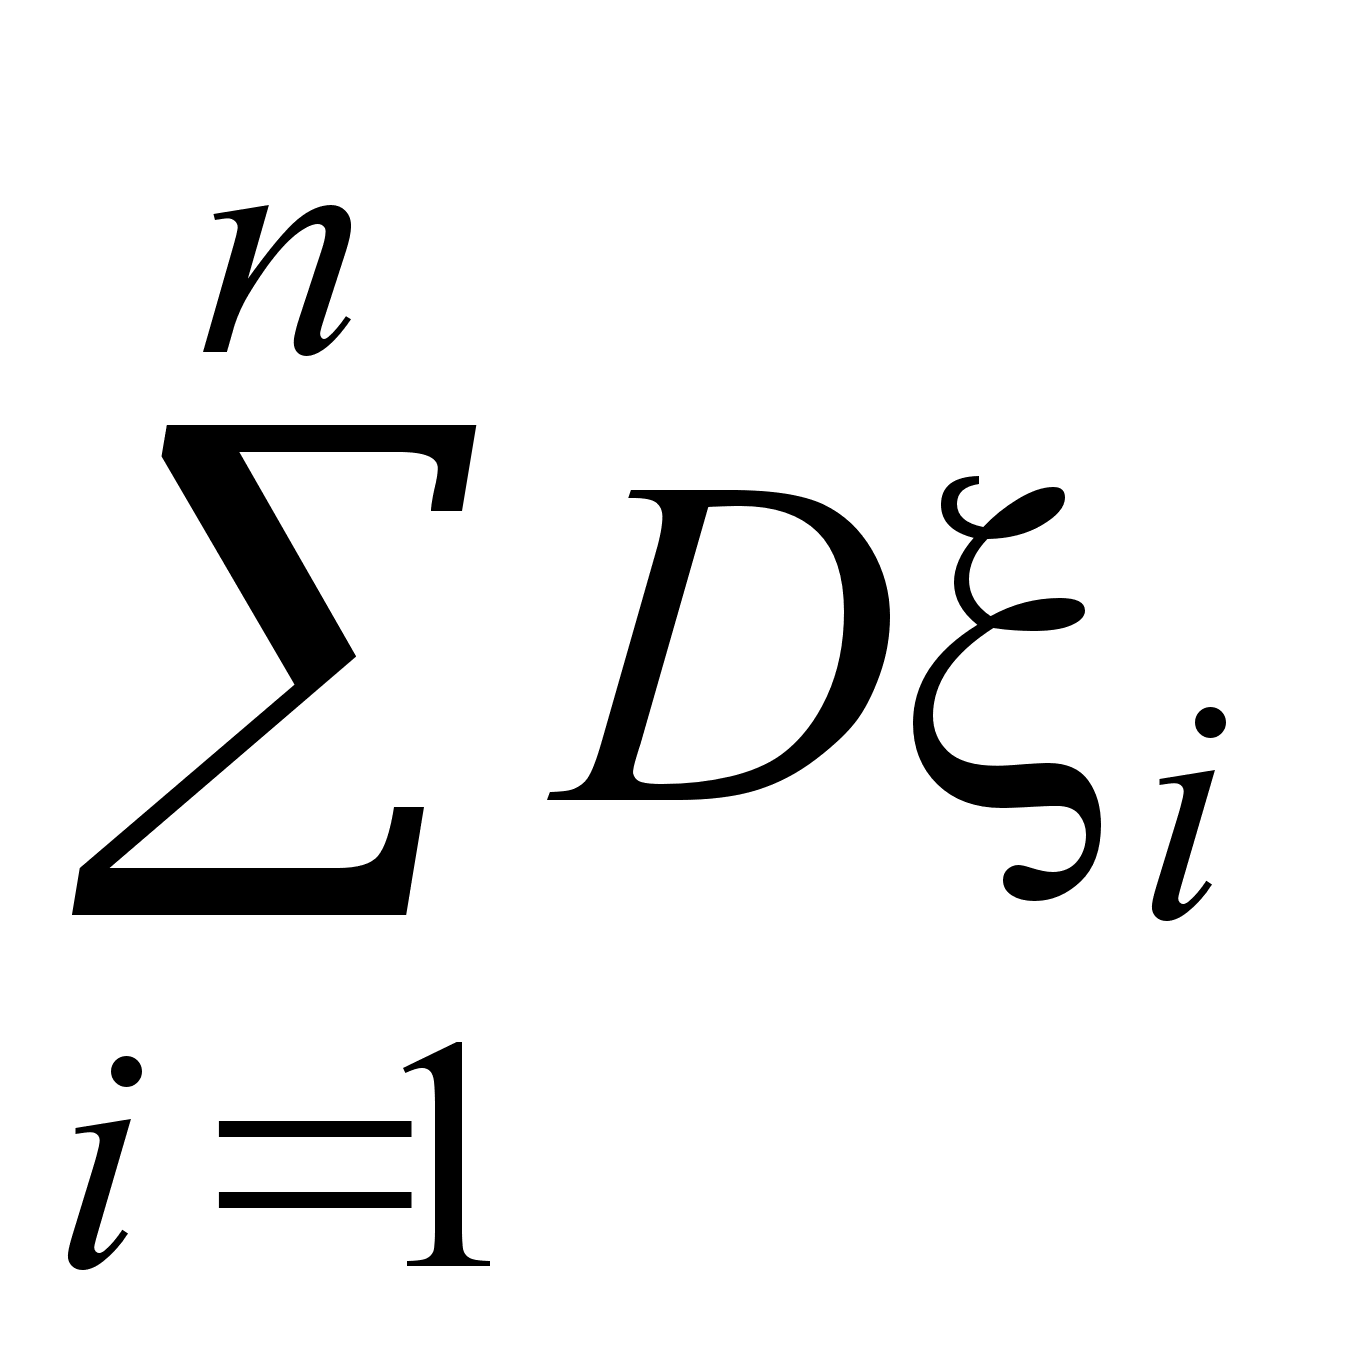 =
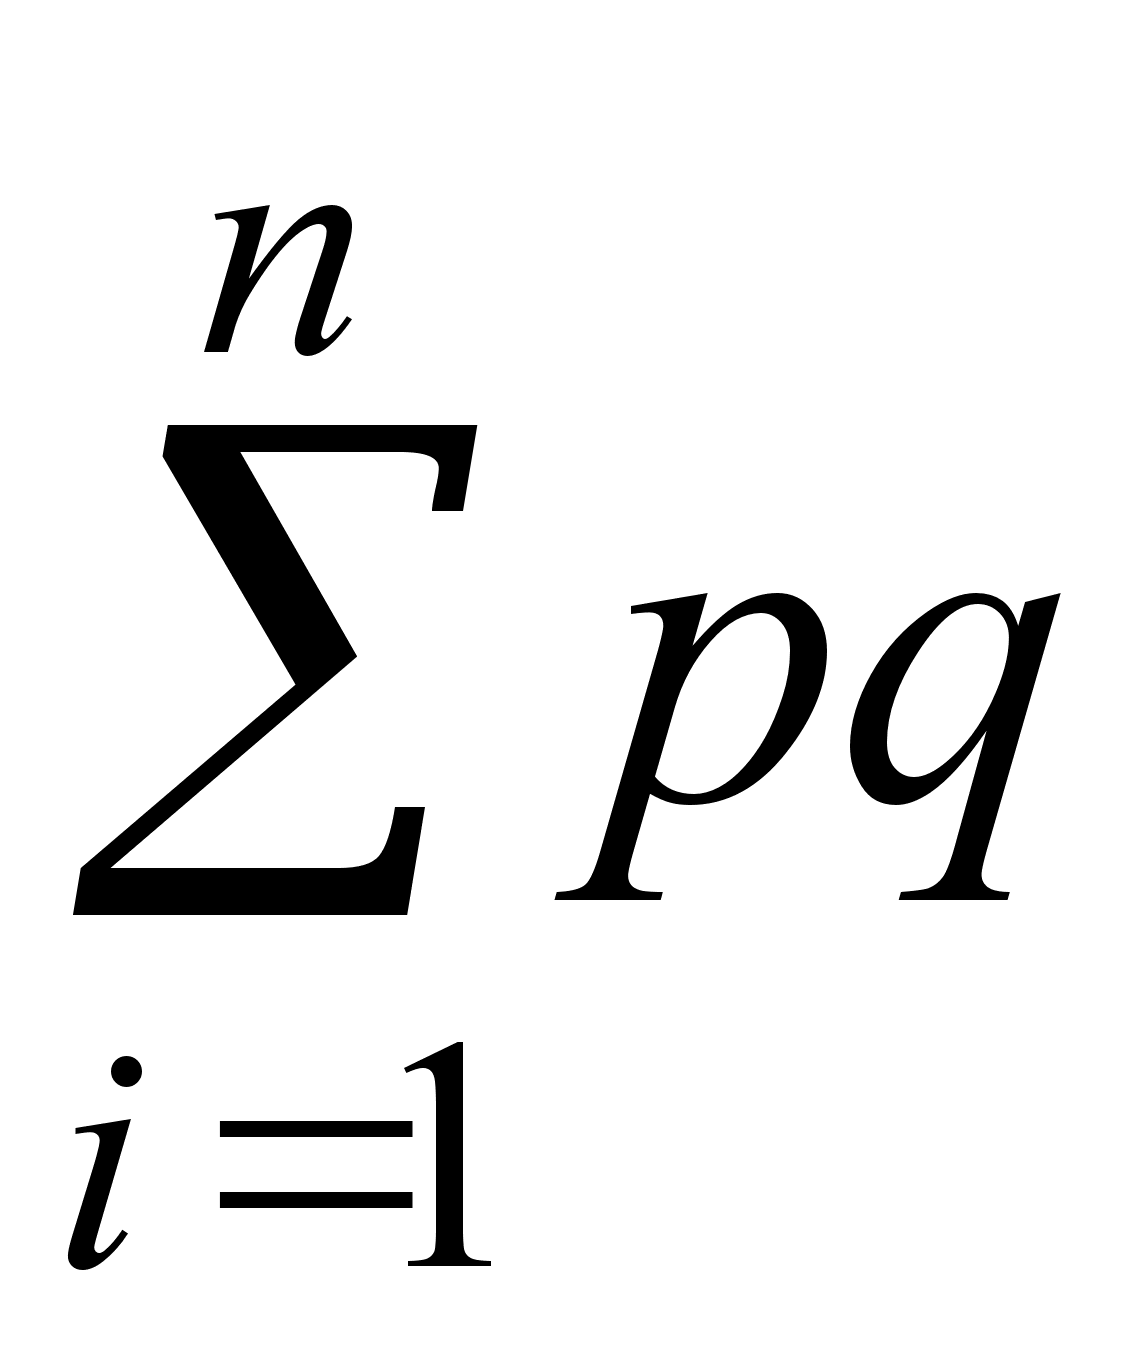 =
npq
Найдём
оценку величины
р — вероятности
успеха в одном
испытании
некоторого
биномиального
эксперимента.
Для этого проведём
n испытаний
и подсчитаем
х – число успехов.
Оценку р*
неизвестной
величины р
определим
формулой р*
=
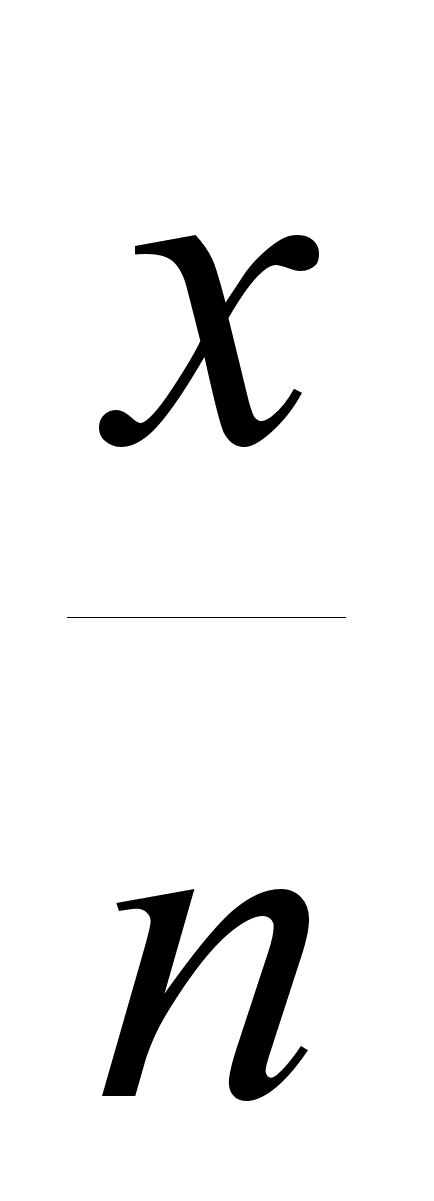 .
Пример.
Из 20 отобранных для контроля образцов продукции 4 оказались нестандартными. Оценим вероятность того, что случайно выбранный экземпляр продукции не отвечает стандарту отношением р* = 4/20 = 0,2.
Так
как х случайная
величина, р*
– тоже случайная
величина. Значения
р* могут
меняться от
одного эксперимента
к другому (в
рассматриваемом
случае экспериментом
является случайный
отбор и контроль
20-ти экземпляров
продукции).
Каково математическое
ожидание
р*? Поскольку
х
есть случайная
величина,
обозначающая
число успехов
в n
испытаниях
по схеме Бернулли,
Мx
= np.
Для математического
ожидания случайной
величины р*
по определению
получаем:
Mp* = M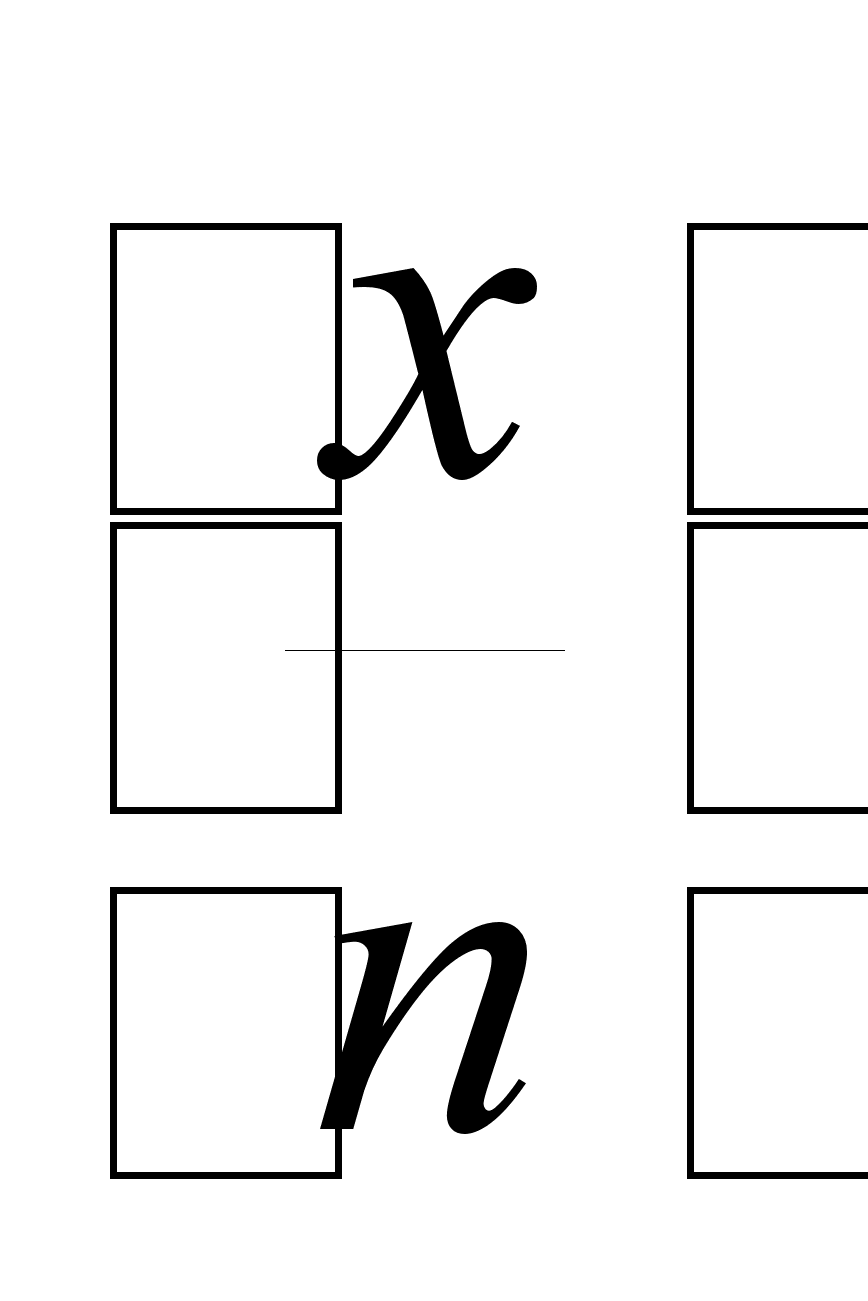 ,
но n
здесь
является константой,
поэтому по
свойству
математического
ожидания
Mp* = 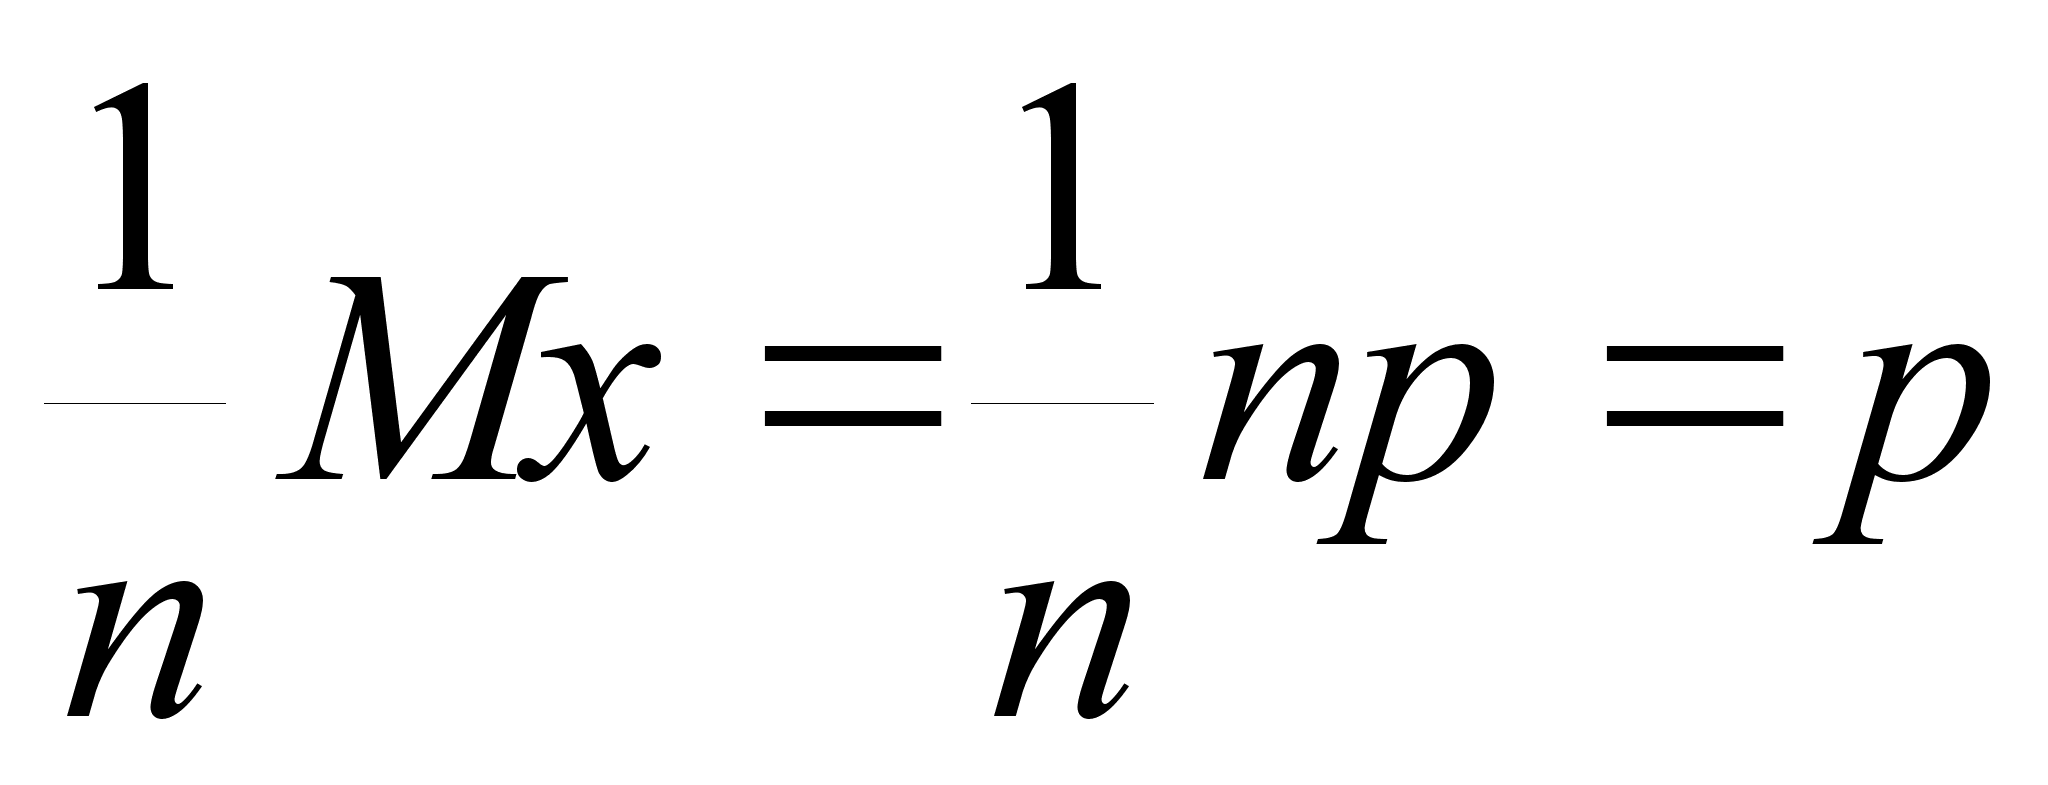
Таким образом, “в среднем” получается истинное значение р, чего и следовало ожидать. Это свойство оценки р* величины р имеет название: р* является несмещённой оценкой для р. Отсутствие систематического отклонения от величины оцениваемого параметра р подтверждает целесообразность использования величины р* в качестве оценки. Вопрос о точности оценки пока оставляем открытым.
Биномиальный закон распределения.
Пусть заданы числа n N и p (0 p 1). Тогда каждому целому числу из промежутка [0; n] можно поставить в соответствие вероятность, рассчитанную по формуле Бернулли. Получим закон распределения случайной величины (назовём её )
-
0
k
n
Р
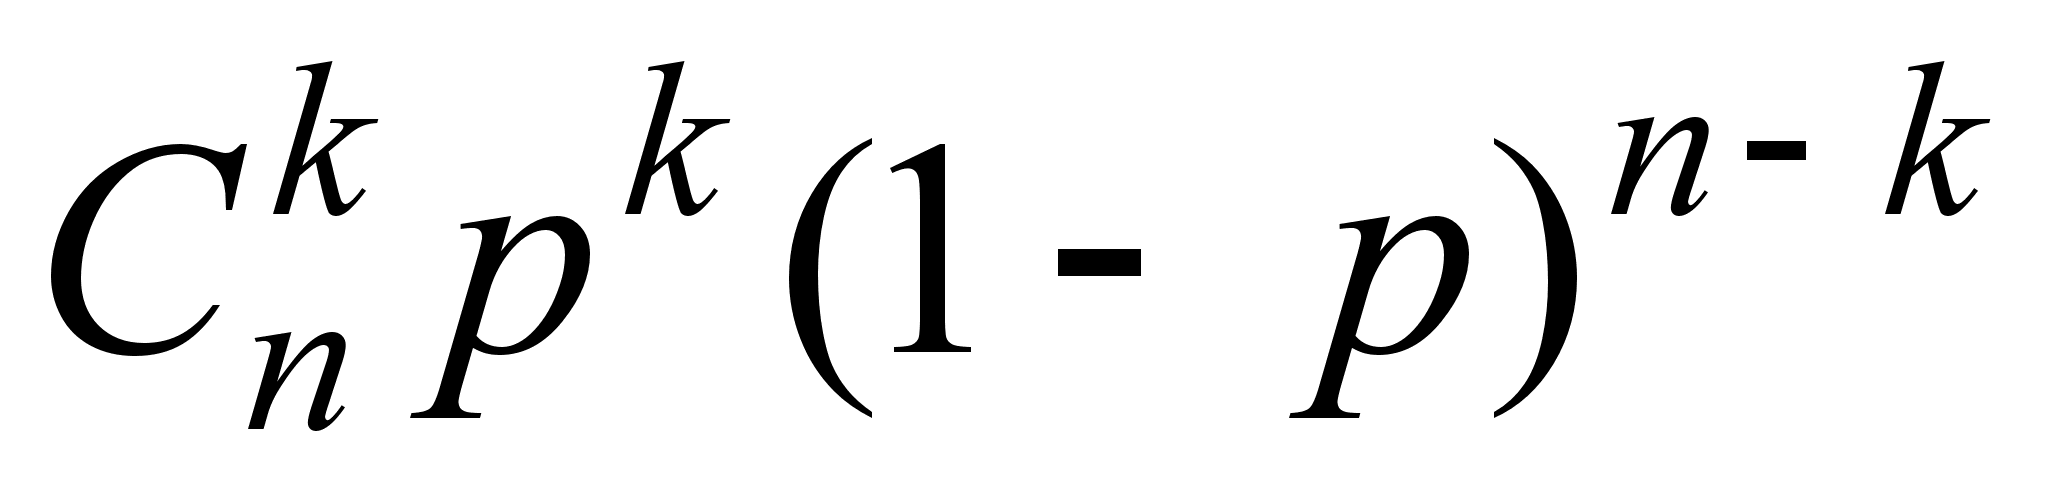
Будем говорить, что случайная величина распределена по закону Бернулли. Такой случайной величиной является частота появления события А в n повторных независимых испытаниях, если в каждом испытании событие А происходит с вероятностью p.
Рассмотрим отдельное i-е испытание. Пространство элементарных исходов для него имеет вид
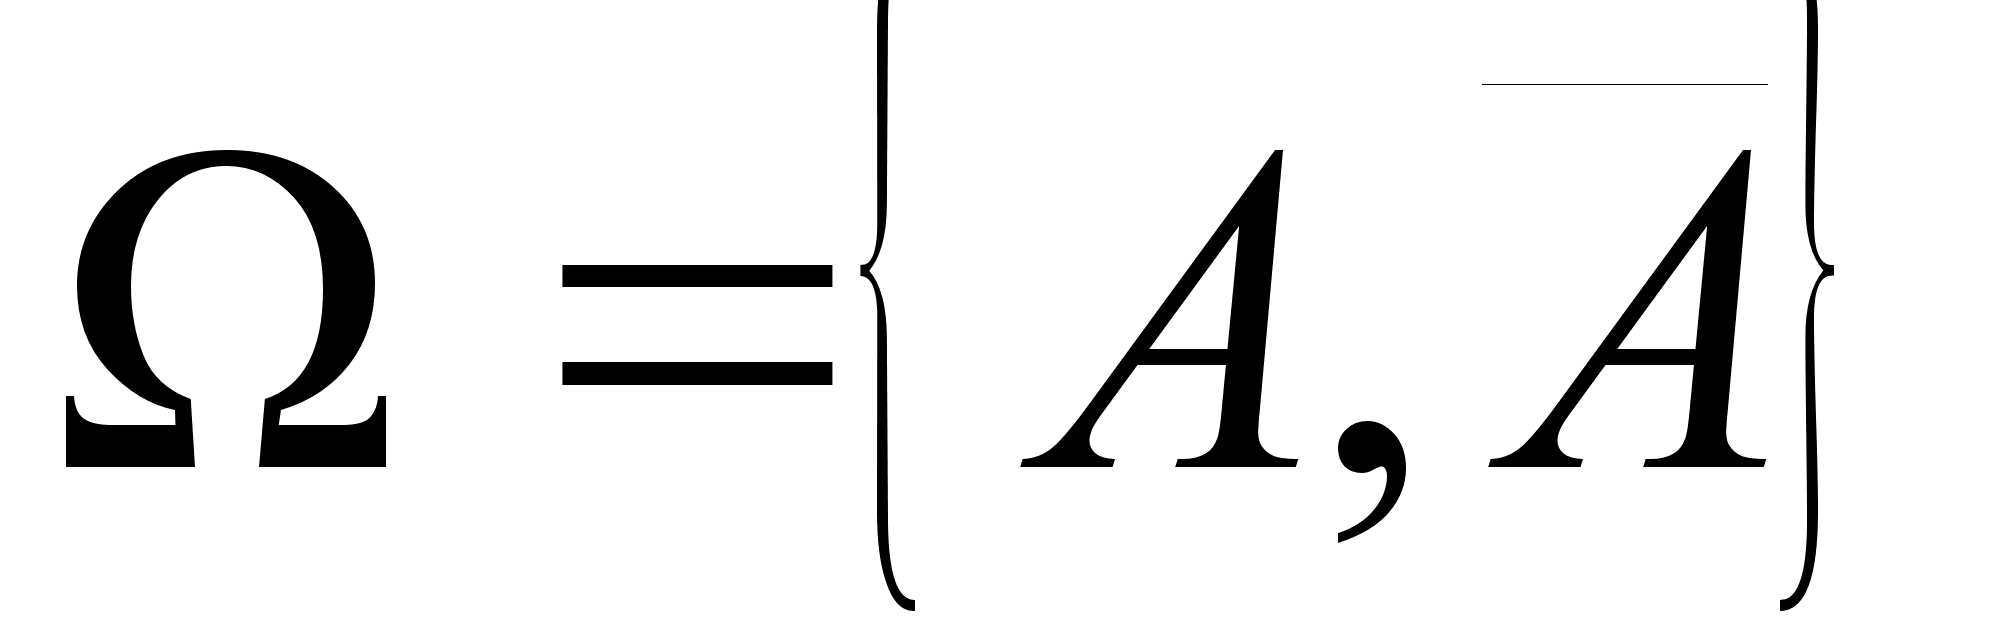
Определим на этом пространстве случайную величину i следующим образом:
i = 1, если происходит событие А;
i
= 0,
если происходит
событие
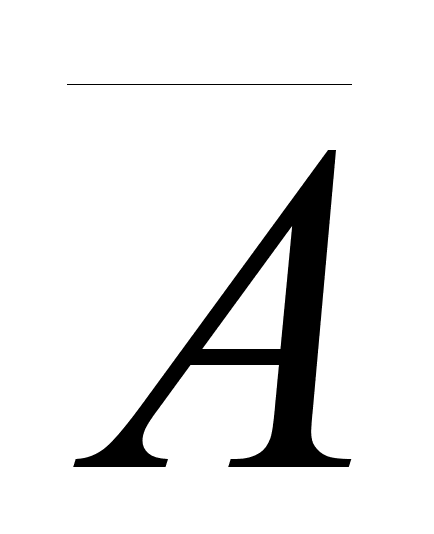
Закон распределения случайной величины i рассматривался в предыдущем параграфе.
-
i
1
0
Р
p
q = 1–p
M = р; D = рq
Для
i = 1,2,,n
получаем систему
из n
независимых
случайных
величин i,
имеющих одинаковые
законы распределения.
Если теперь
сравнить законы
распределения
двух случайных
величин
и
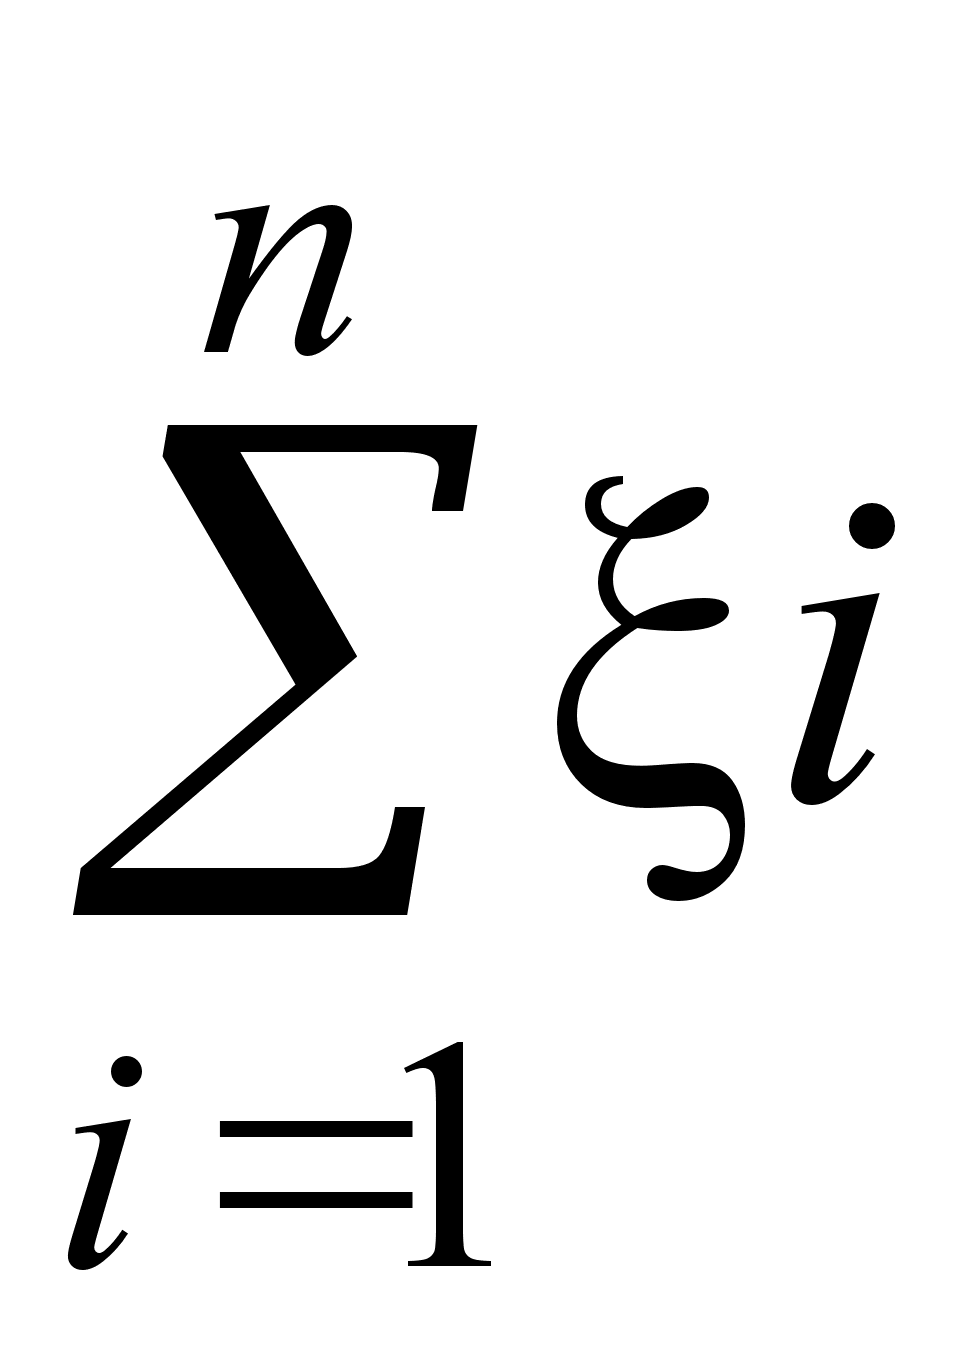 ,
то можно сделать
очевидный
вывод:
=
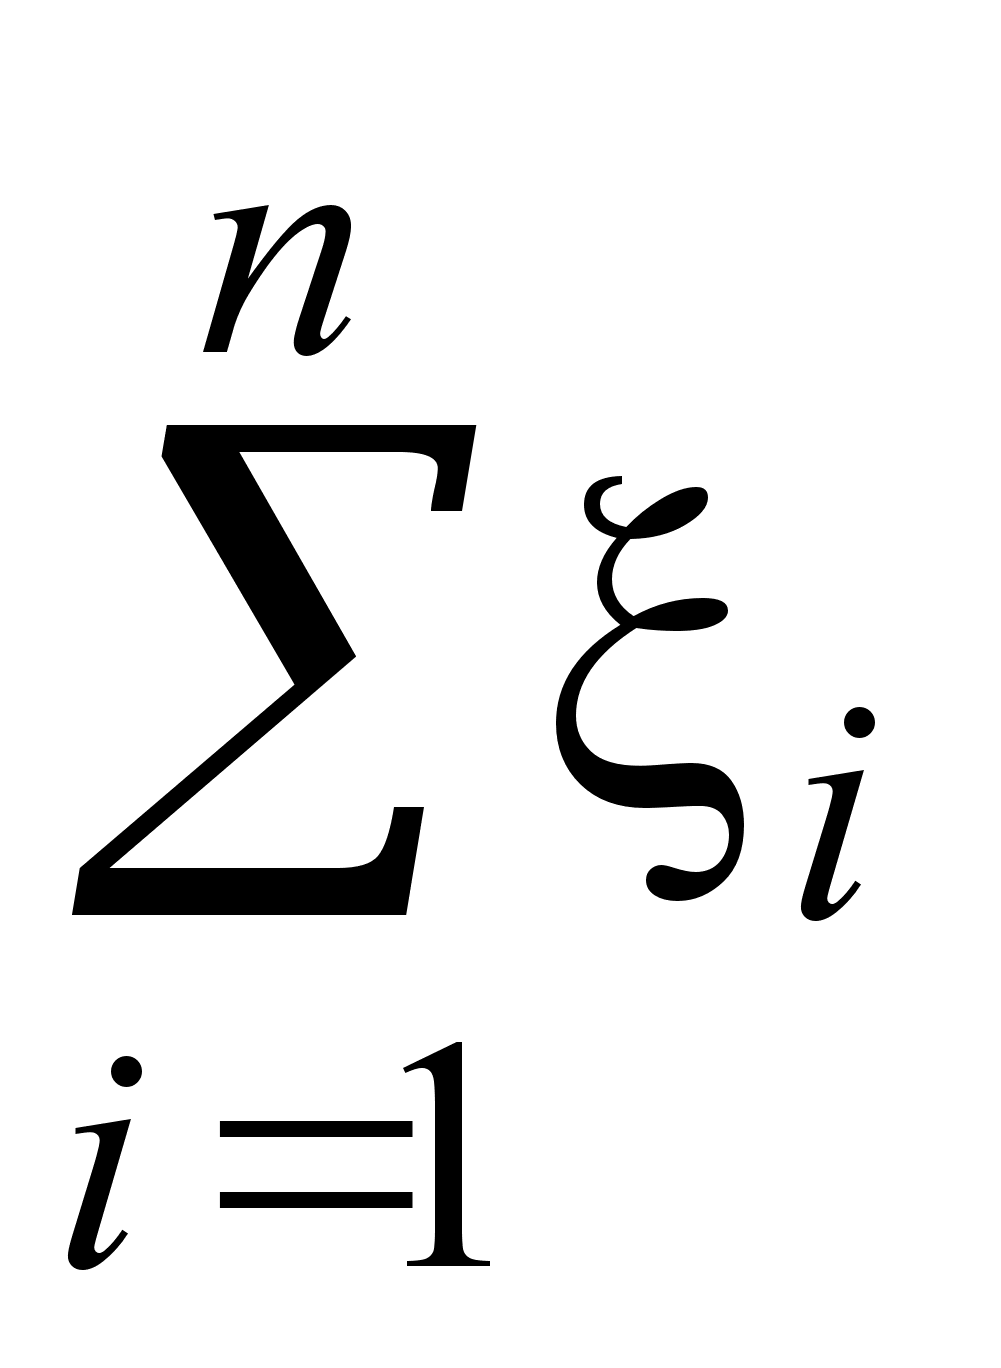 .
Отсюда следует,
что для случайной
величины ,
имеющей закон
распределения
Бернулли,
математическое
ожидание и
дисперсия
определяются
формулами
M
= M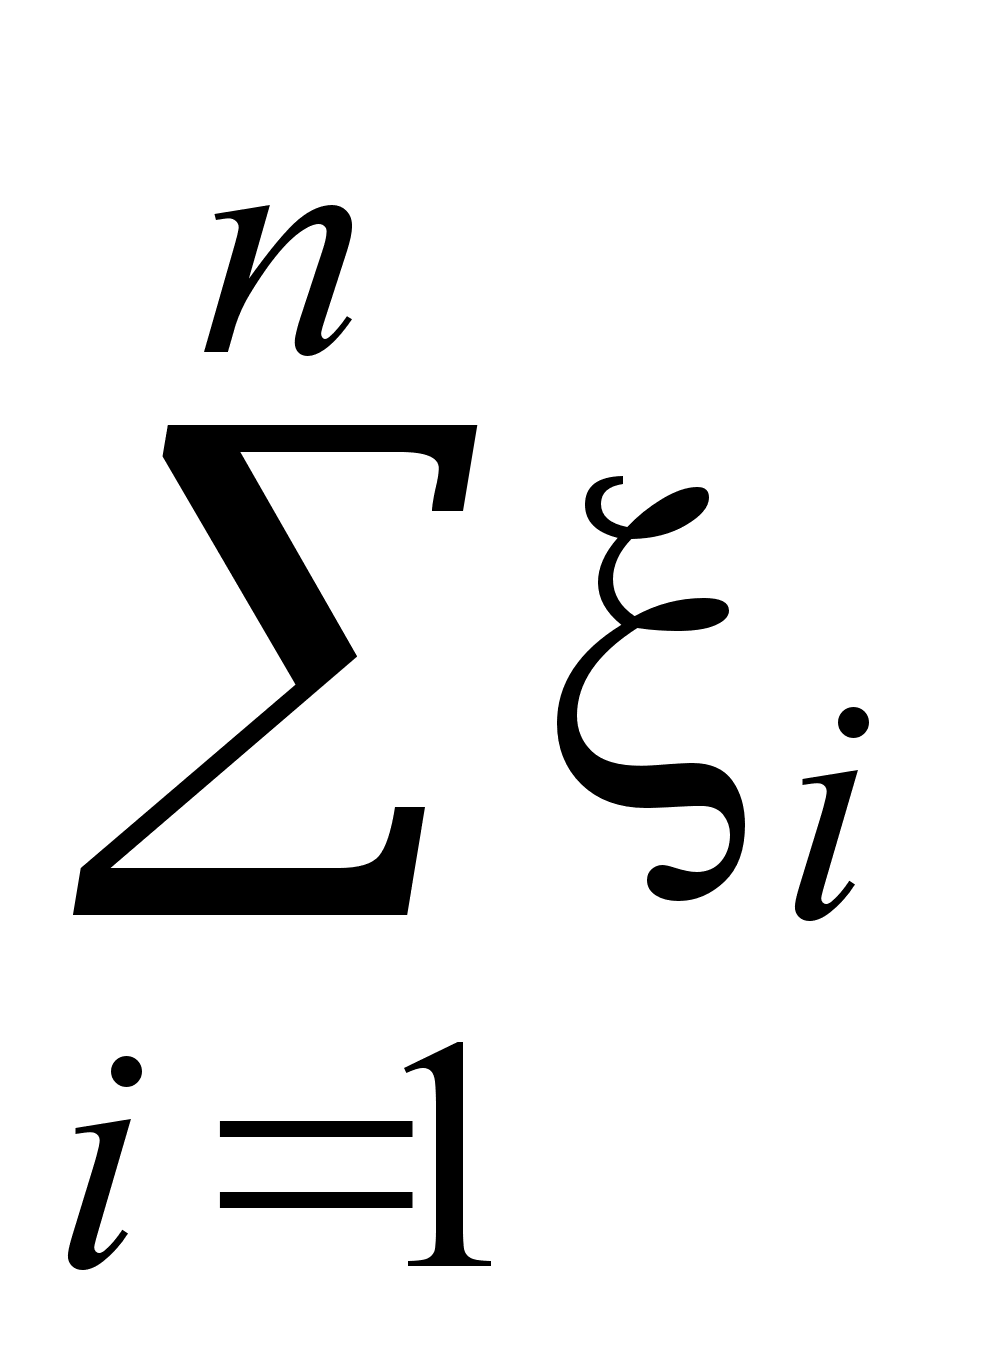 =
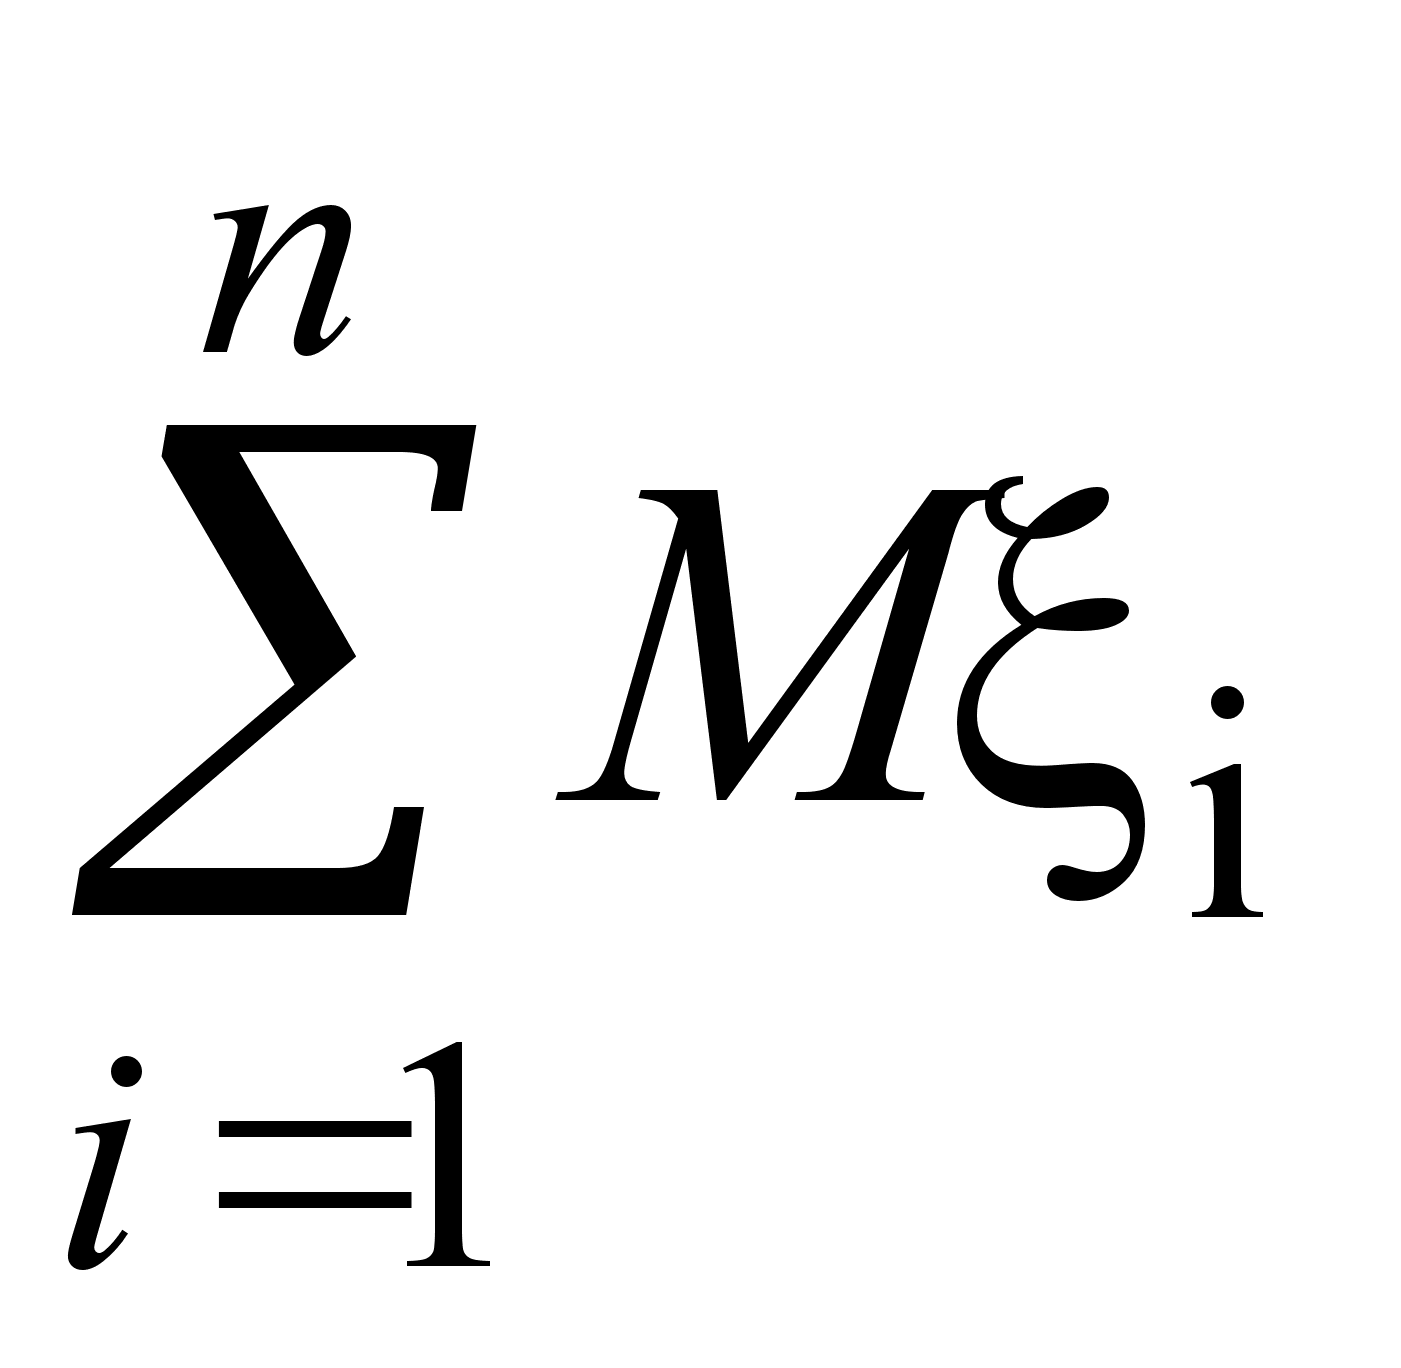 =
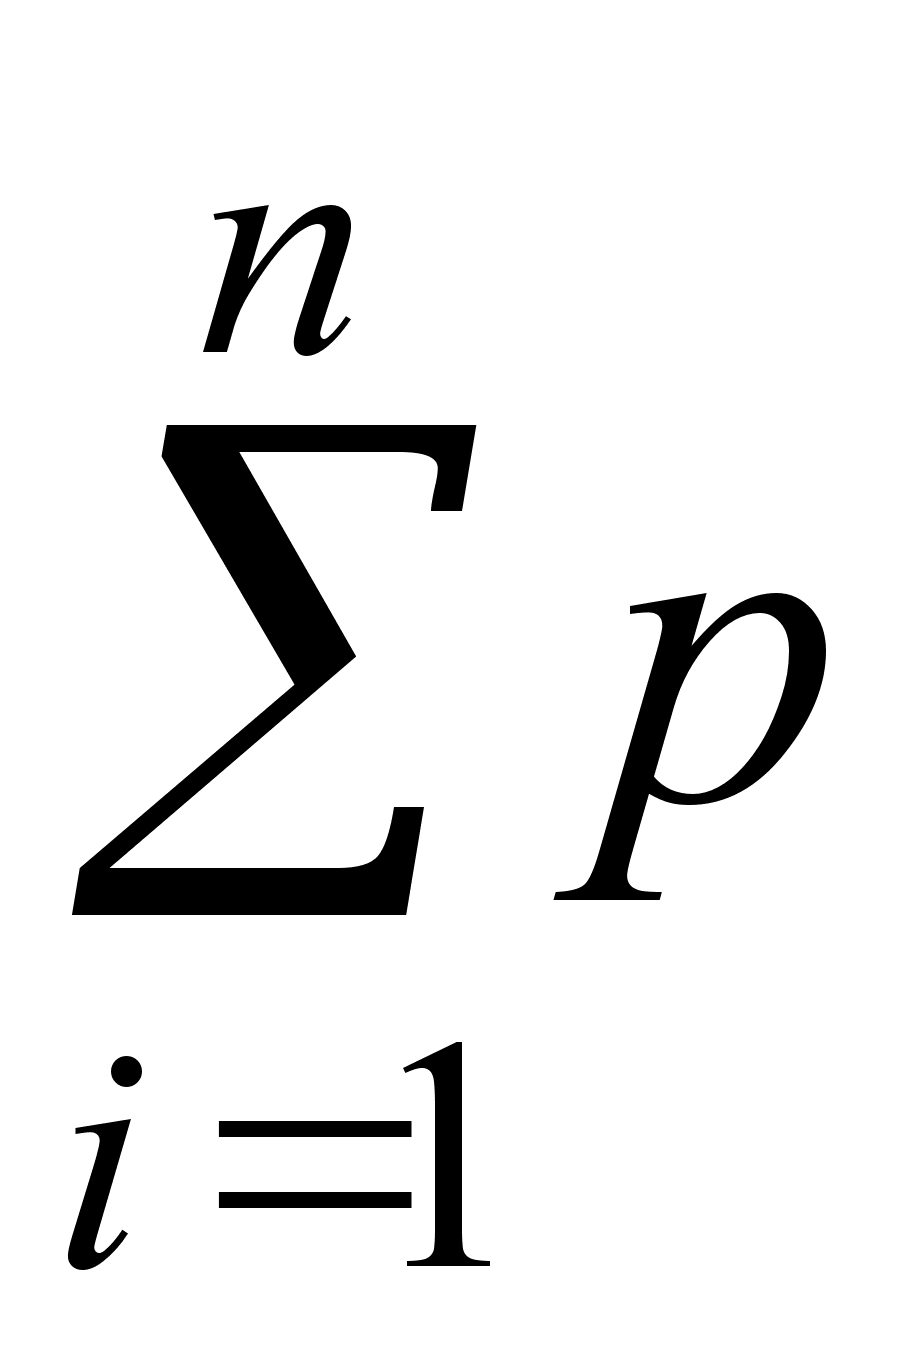 =
np;
D
= D=
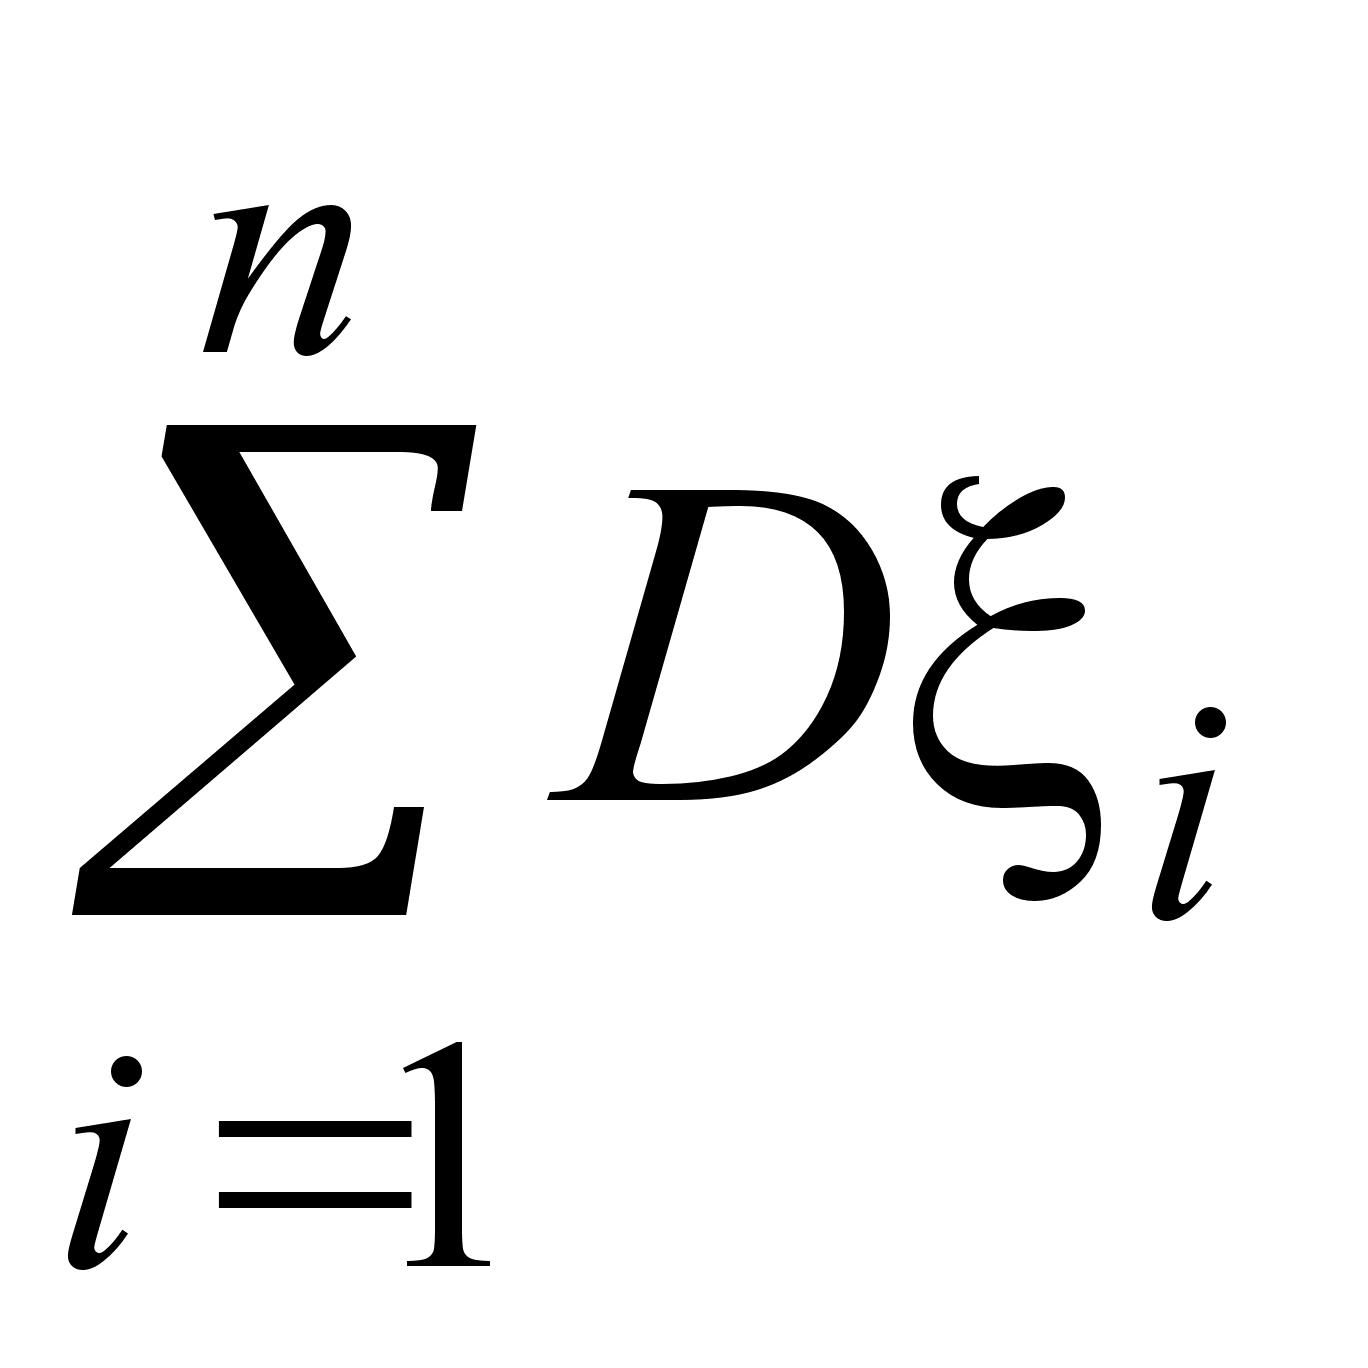 =
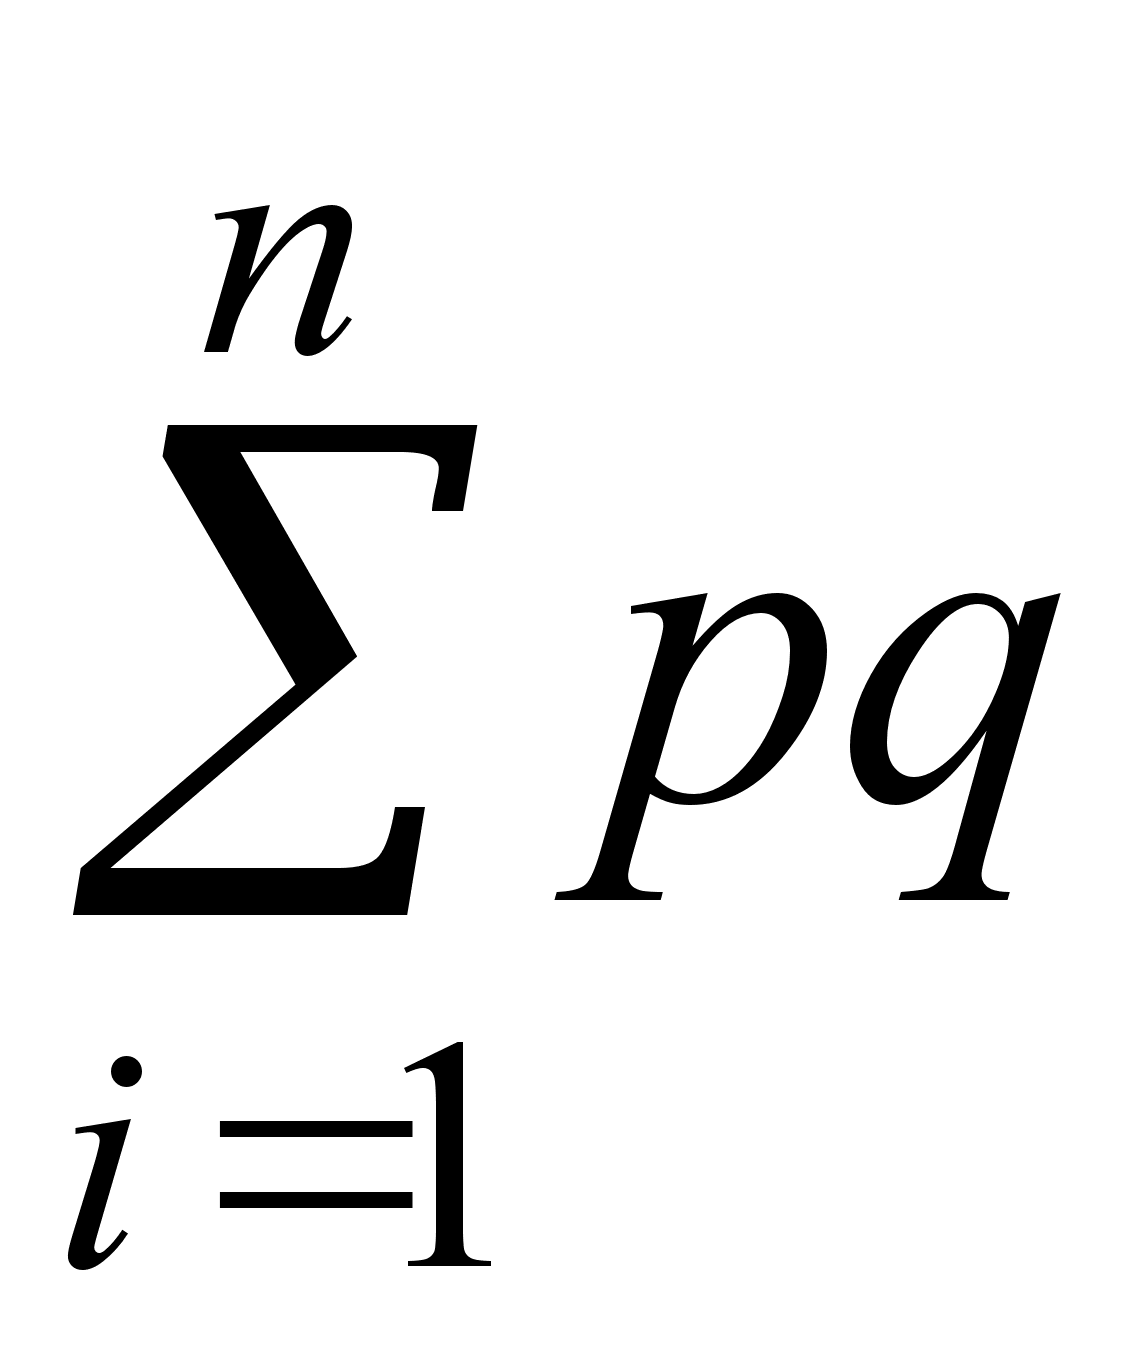 =
npq
Найдём
оценку величины
р — вероятности
успеха в одном
испытании
некоторого
биномиального
эксперимента.
Для этого проведём
n испытаний
и подсчитаем
х – число успехов.
Оценку р*
неизвестной
величины р
определим
формулой р*
=
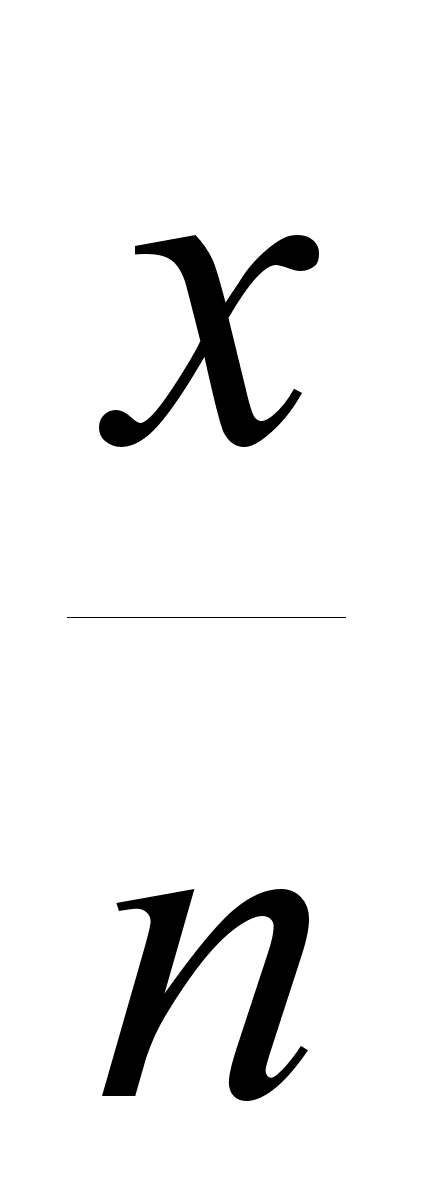 .
Пример.
Из 20 отобранных для контроля образцов продукции 4 оказались нестандартными. Оценим вероятность того, что случайно выбранный экземпляр продукции не отвечает стандарту отношением р* = 4/20 = 0,2.
Так
как х случайная
величина, р*
– тоже случайная
величина. Значения
р* могут
меняться от
одного эксперимента
к другому (в
рассматриваемом
случае экспериментом
является случайный
отбор и контроль
20-ти экземпляров
продукции).
Каково математическое
ожидание
р*? Поскольку
х
есть случайная
величина,
обозначающая
число успехов
в n
испытаниях
по схеме Бернулли,
Мx
= np.
Для математического
ожидания случайной
величины р*
по определению
получаем:
Mp* = M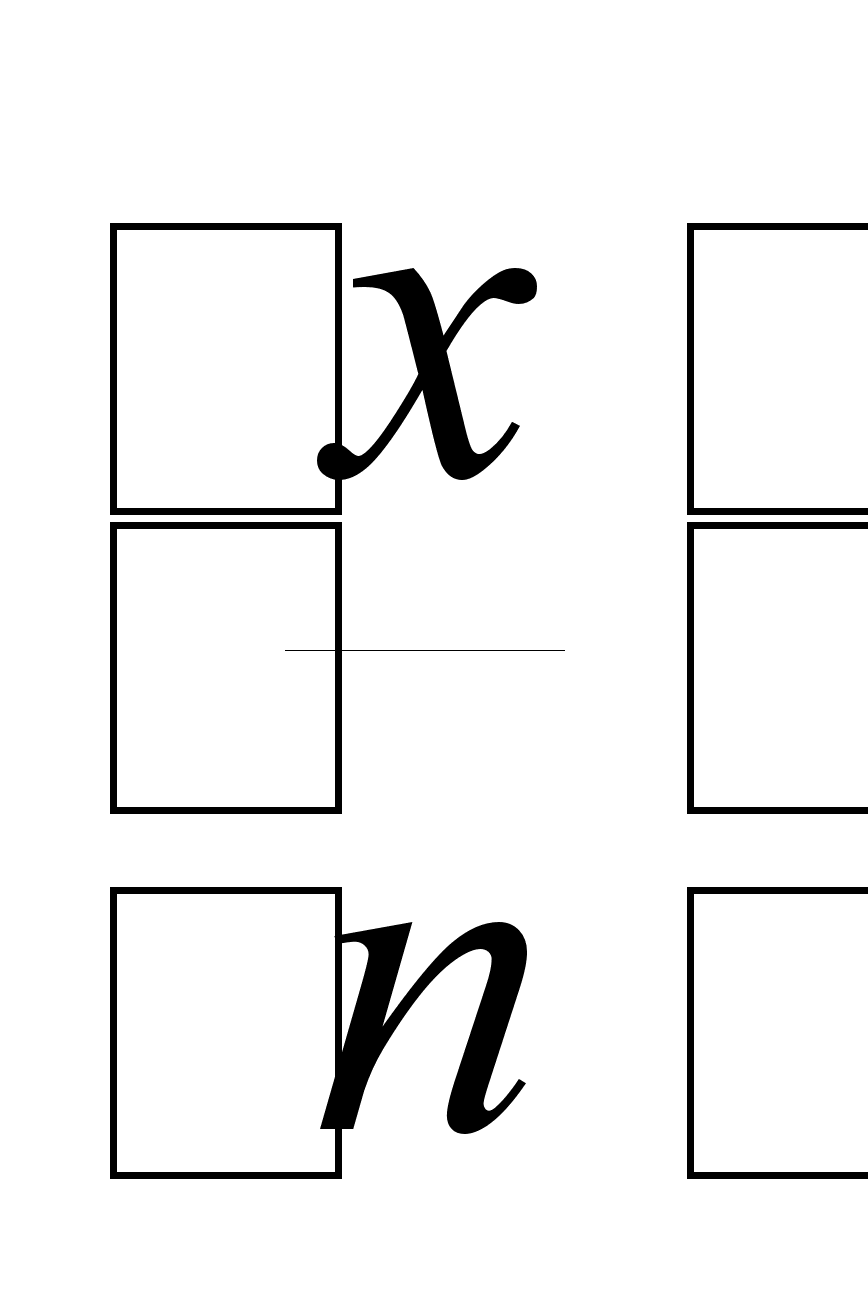 ,
но n
здесь
является константой,
поэтому по
свойству
математического
ожидания
Mp* = 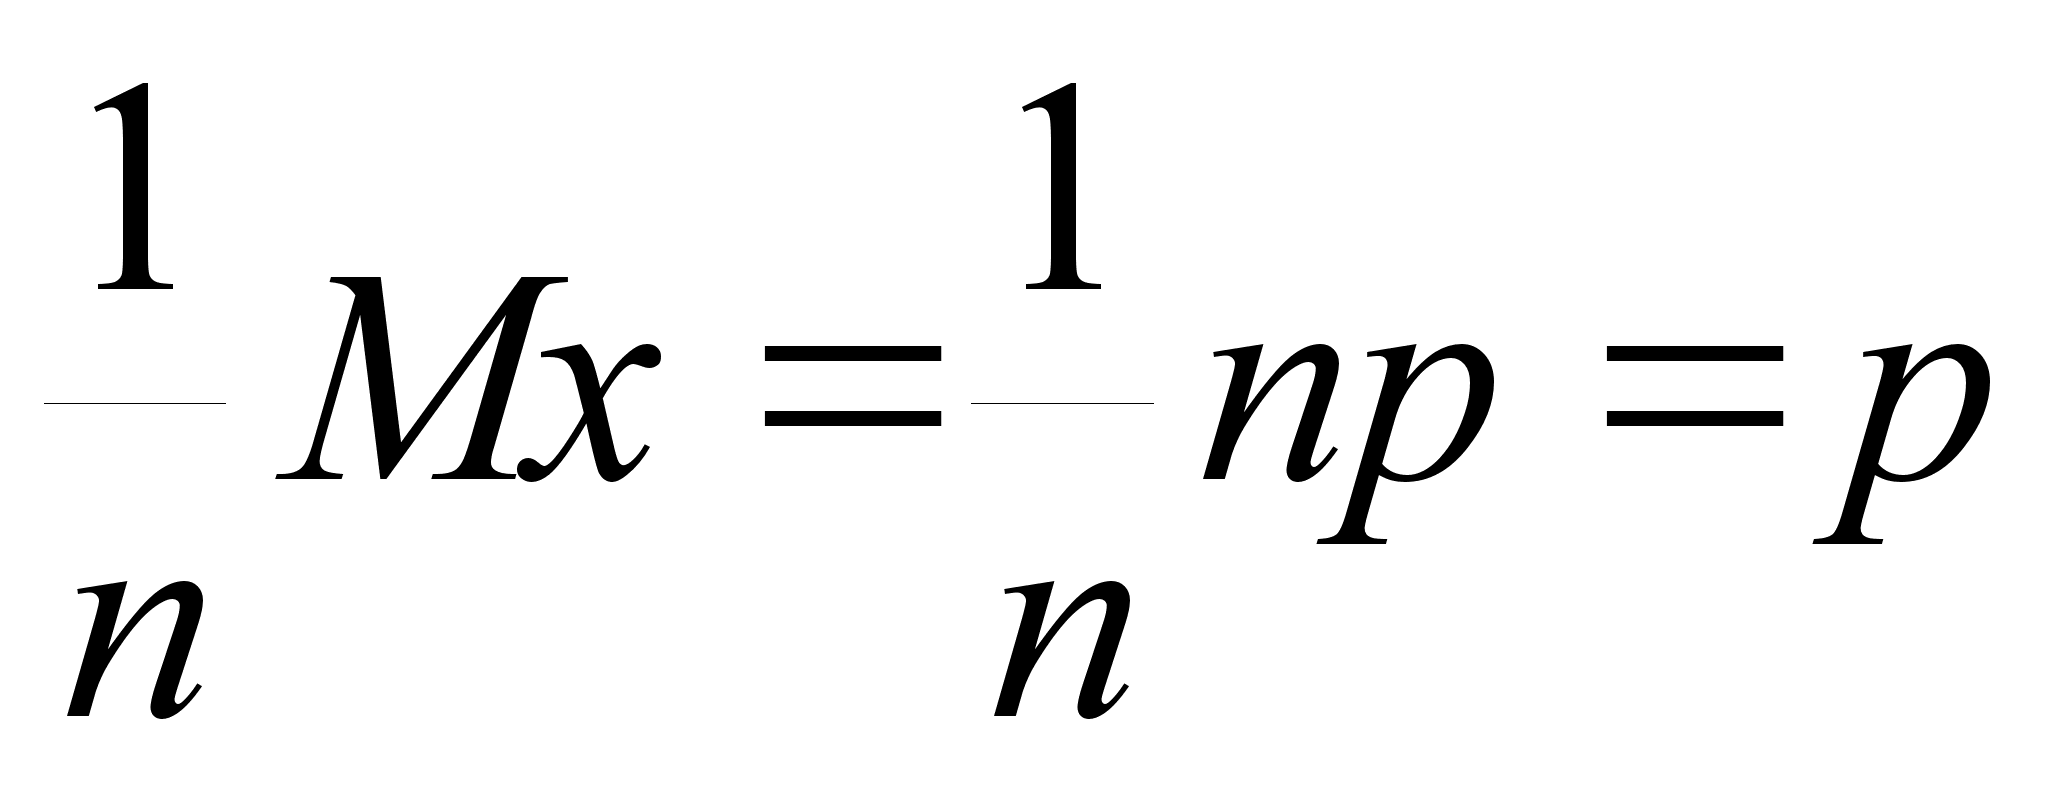
Таким образом, “в среднем” получается истинное значение р, чего и следовало ожидать. Это свойство оценки р* величины р имеет название: р* является несмещённой оценкой для р. Отсутствие систематического отклонения от величины оцениваемого параметра р подтверждает целесообразность использования величины р* в качестве оценки. Вопрос о точности оценки пока оставляем открытым.
Непрерывные случайные величины.
Случайная величина, значения которой заполняют некоторый промежуток, называется непрерывной.
В частных случаях это может быть не один промежуток, а объединение нескольких промежутков. Промежутки могут быть конечными, полубесконечными или бесконечными, например: (a; b], (– ; a), [b;), (–; ).
Вообще непрерывная случайная величина – это абстракция. Снаряд, выпущенный из пушки, может пролететь любое расстояние, скажем, от 5 до 5,3 километров, но никому не придёт в голову измерять эту величину с точностью до 0,0000001 километра (то есть до миллиметра), не говоря уже об абсолютной точности. В практике такое расстояние будет дискретной случайной величиной, у которой одно значение от другого отличается по крайней мере на 1 метр.
При описании непрерывной случайной величины принципиально невозможно выписать и занумеровать все её значения, принадлежащие даже достаточно узкому интервалу. Эти значения образуют несчётное множество, называемое «континуум».
Если – непрерывная случайная величина, то равенство = х представляет собой, как и в случае дискретной случайной величины, некоторое случайное событие, но для непрерывной случайной величины это событие можно связать лишь с вероятностью, равной нулю, что однако не влечёт за собой невозможности события. Так например, можно говорить, что только с вероятностью «нуль» снаряд пролетит 5245,7183 метра, или что отклонение действительного размера детали от номинального составит 0,001059 миллиметра. В этих случаях практически невозможно установить, произошло событие или нет, так как измерения величин проводятся с ограниченной точностью, и в качестве результата измерения можно фактически указать лишь границы более или менее узкого интервала, внутри которого находится измеренное значение.
Значениям непрерывной случайной величины присуща некоторая неопределенность. Например, нет практического смысла различать два отклонения от номинального размера, равные 0,5 мм и 0,5000025 мм. Вероятность, отличная от нуля, может быть связана только с попаданием величины в заданный, хотя бы и весьма узкий, интервал. Здесь можно привести сравнение с распределением массы вдоль стержня. Отсутствует масса, сосредоточенная, скажем, в сечении, расположенном на расстоянии 20 см от левого конца стержня, имеет смысл говорить лишь о массе, заключённой между сечениями, проходящими через концы некоторого промежутка.
Пусть – непрерывная случайная величина. Рассмотрим для некоторого числа х вероятность неравенства х < < х + х
P(х < < х + х).
Здесь х – величина малого интервала.
Очевидно, что если х 0, то P(х < < х + х) 0. Обозначим р(х) предел отношения P(х < < х + х) к при х 0, если такой предел существует:
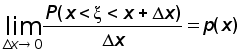 (1)
Функция р(х) называется плотностью распределения случайной величины. Из формулы (1) следует равенство, справедливое для малых величин х, которое также можно считать определением функции р(х):
P(х < < х + х) 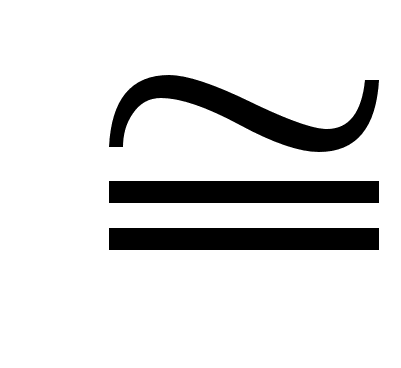 p(x)х (2)
Очевидно, что p(x) – неотрицательная функция. Для определения вероятности того, что случайная величина примет значение из промежутка [a, b] конечной длины, нужно выбрать на промежутке произвольные числа x1, х2,, хn удовлетворяющие условию а=х0<х1<x2<<xn<b=xn+1. Эти числа разобьют промежуток [a, b] на n+1 частей, представляющих собой промежутки [х0, х1), [х1, х2), ,[хn, b]. Введём обозначения:
х0= х1 – х0, х1= х2 – х1, , хn = b – хn,
и
составим сумму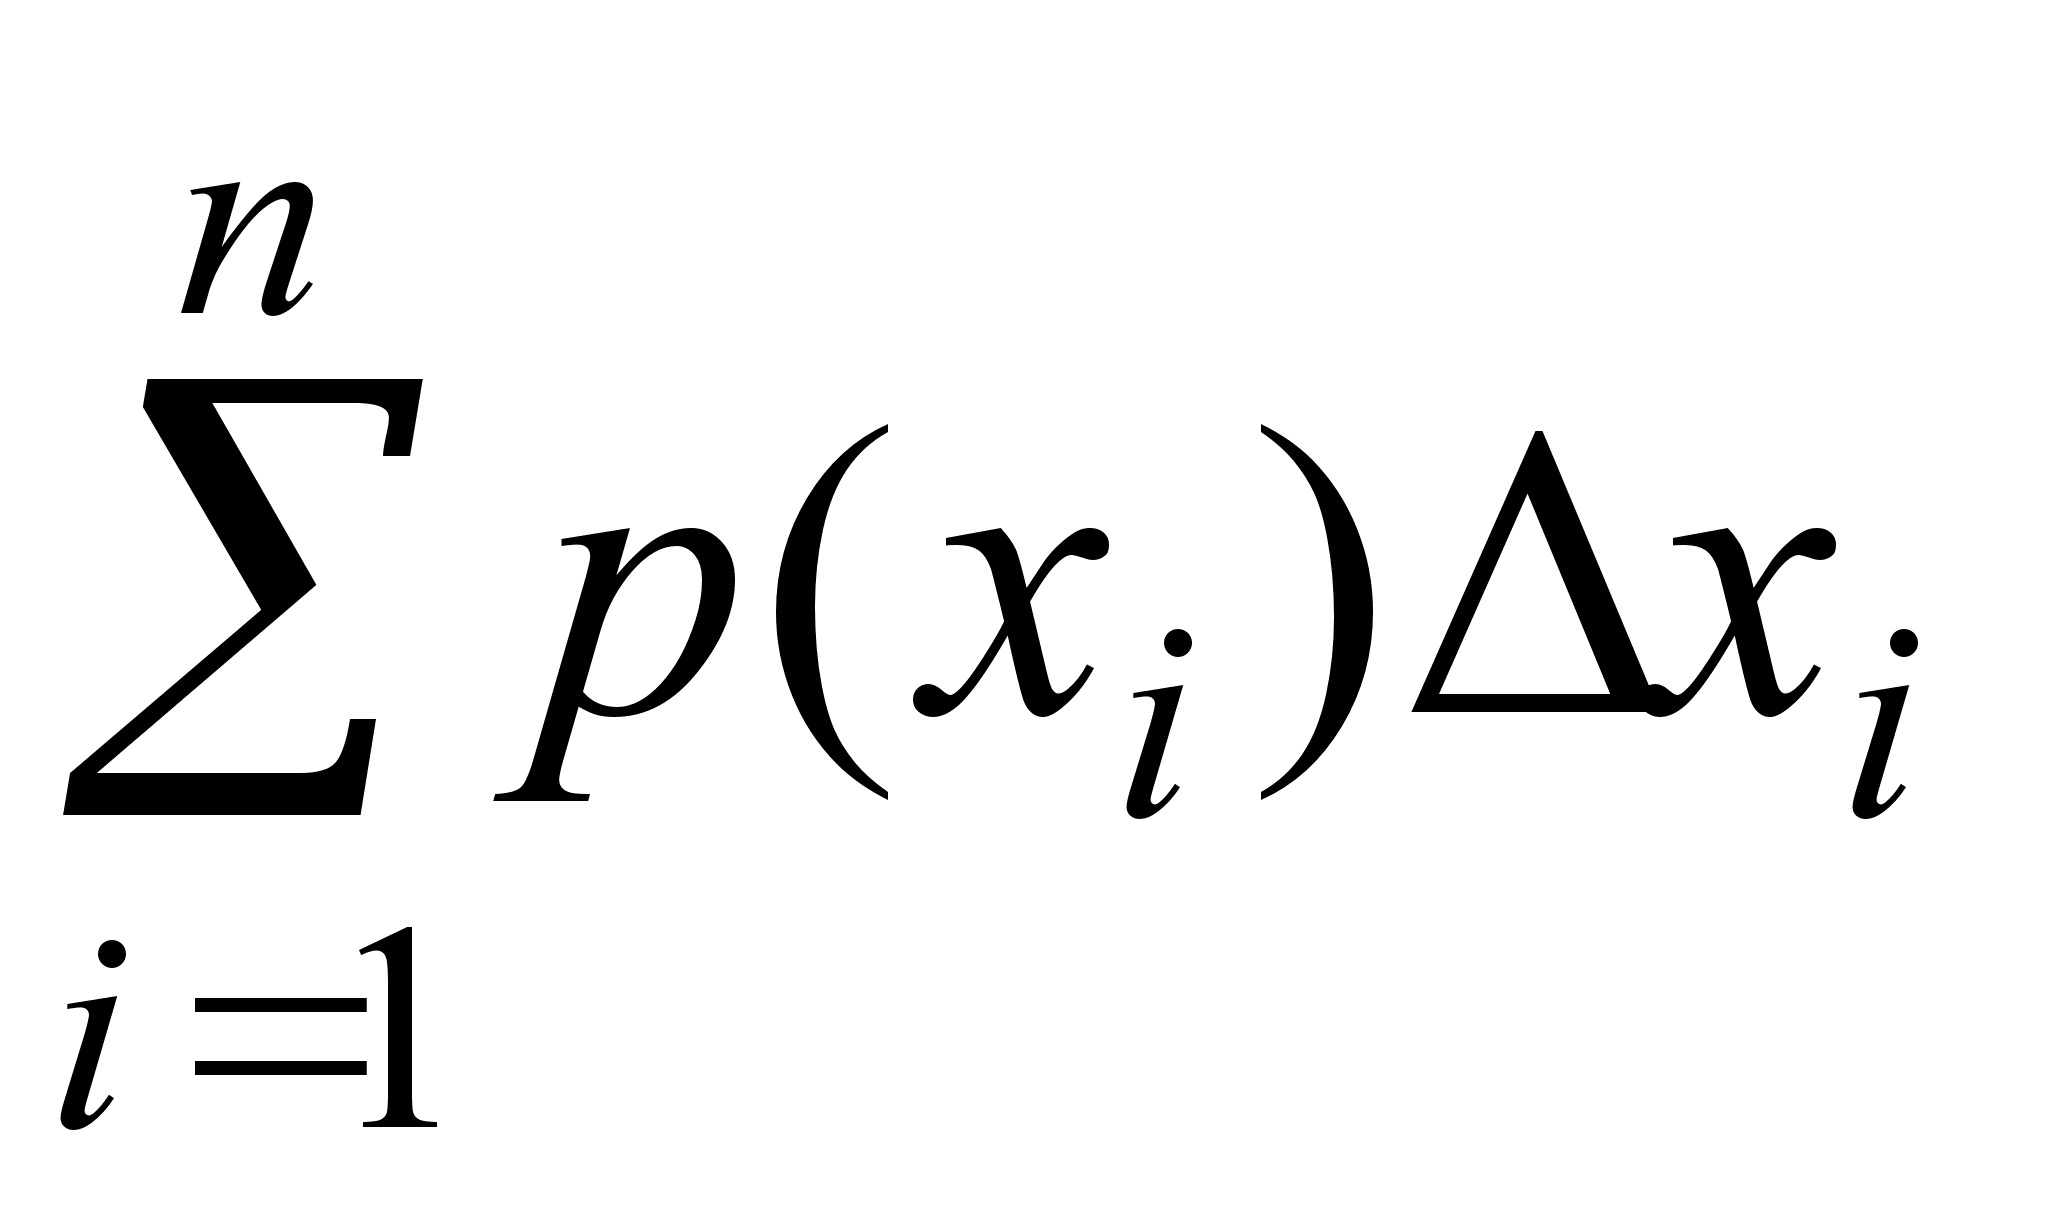 .
Рассмотрим
процесс, при
котором число
точек разбиения
неограниченно
возрастает
таким образом,
что максимальная
величина хi
стремится к
нулю. Будем
считать функцию
p(x)
непрерывной
на промежутке
(а; b),
тогда пределом
суммы
 будет
определённый
интеграл по
промежутку
[a;
b]
от функции
p(x),
равный искомой
вероятности:
P(a b) = 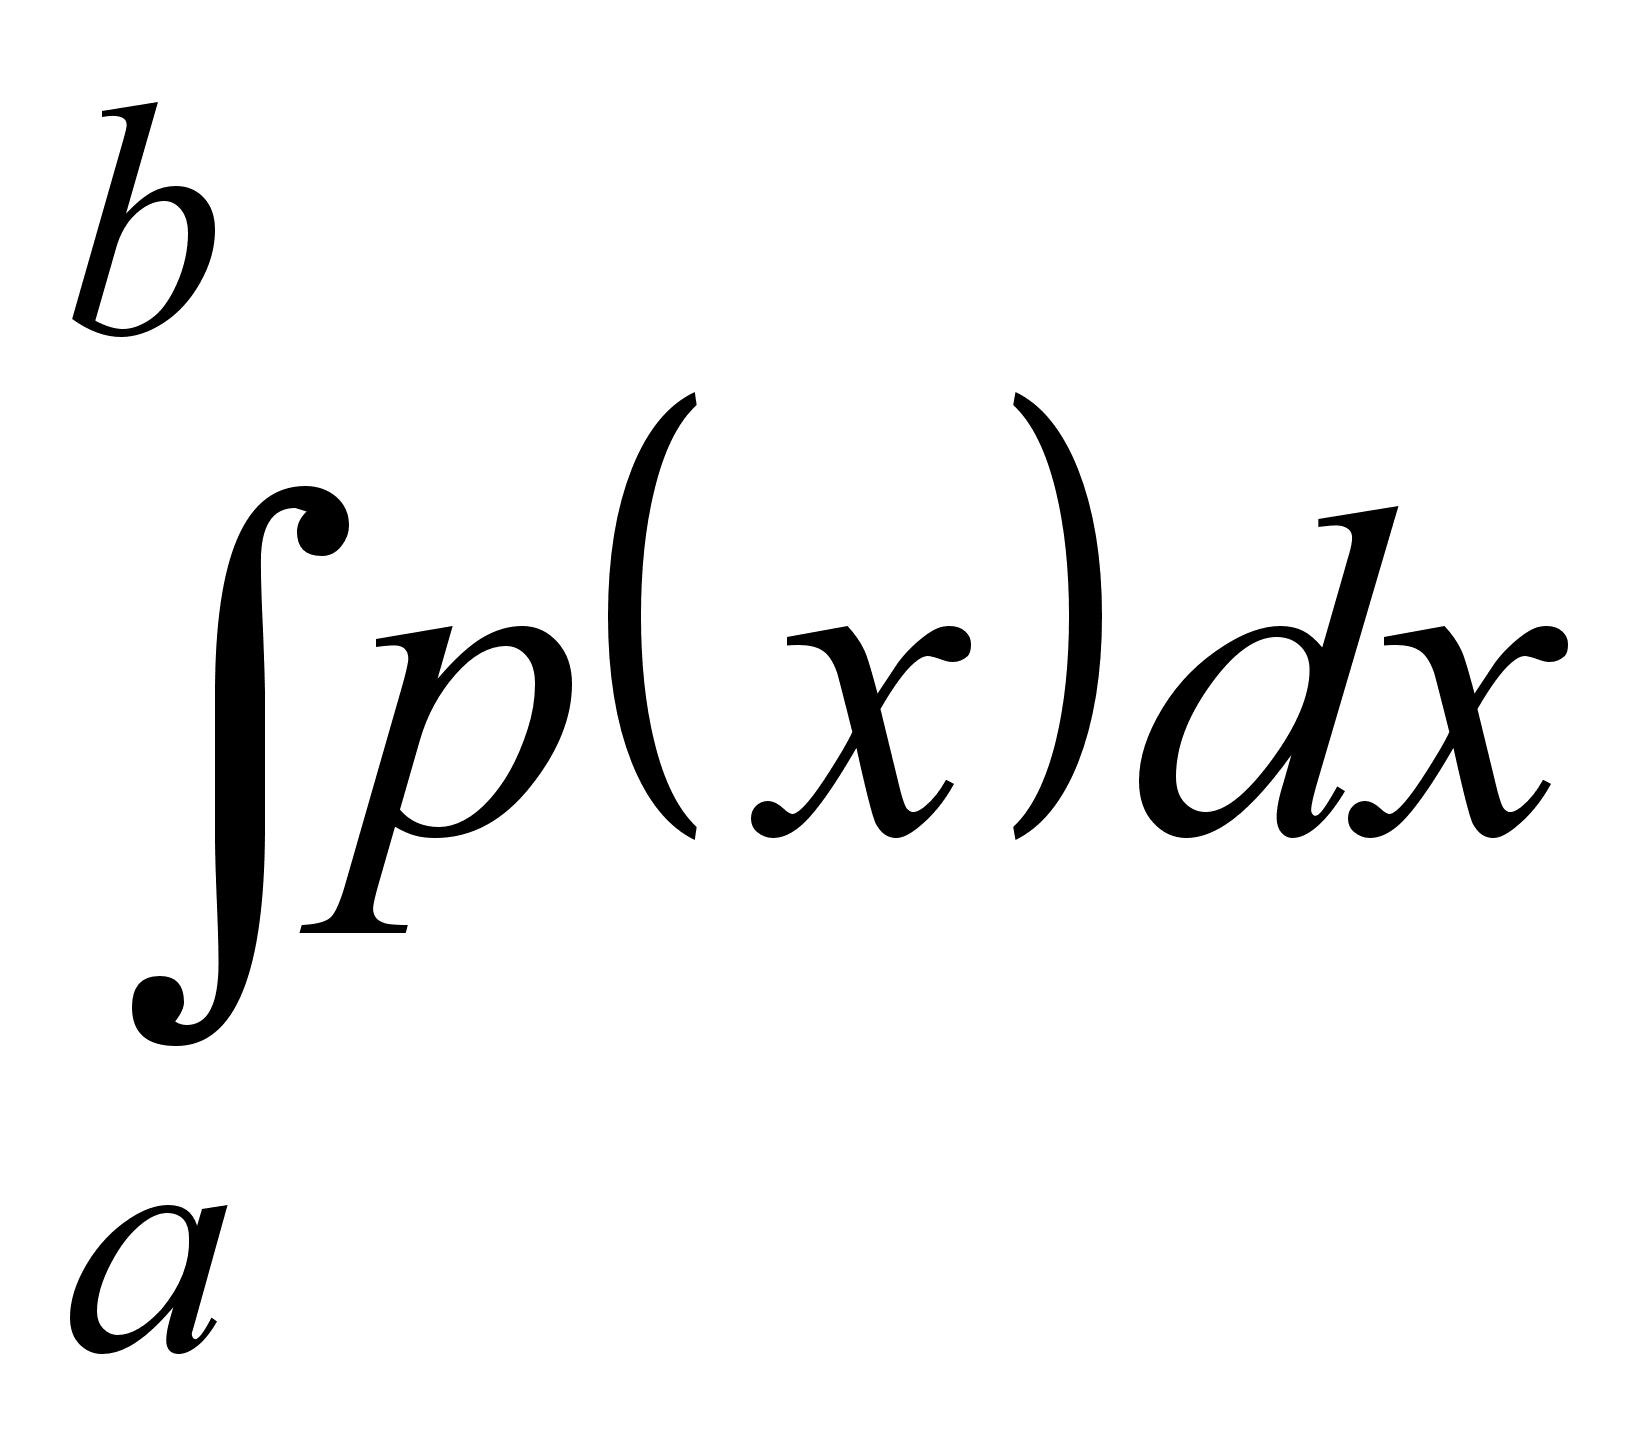 (3)
Э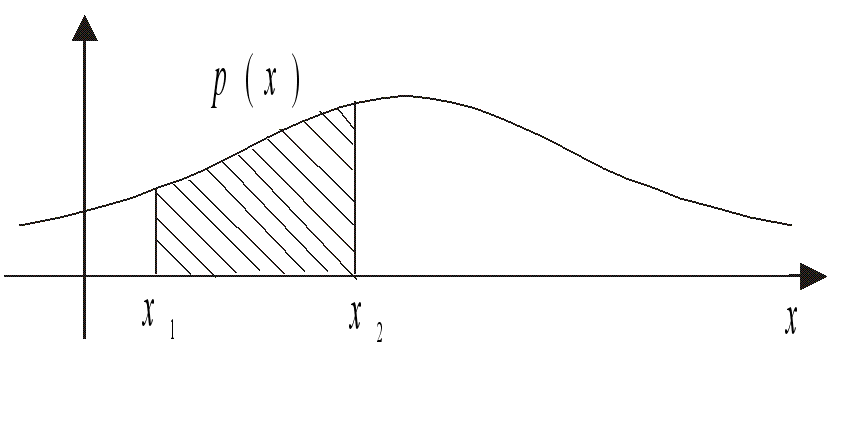
Рис. 1
то равенство можно также рассматривать как определение функции р(х). Отсюда следует, что вероятность попадания случайной величины в любой интервал (х1, х2) равна площади фигуры, образованной отрезком [х1, х2] оси х, графиком функции р(х) и вертикальными прямыми х = х1, х = х2, как изображено на рисунке 1.Если все возможные значения случайной величины принадлежат интервалу (а; b), то для р(х) – её плотности распределения справедливо равенство
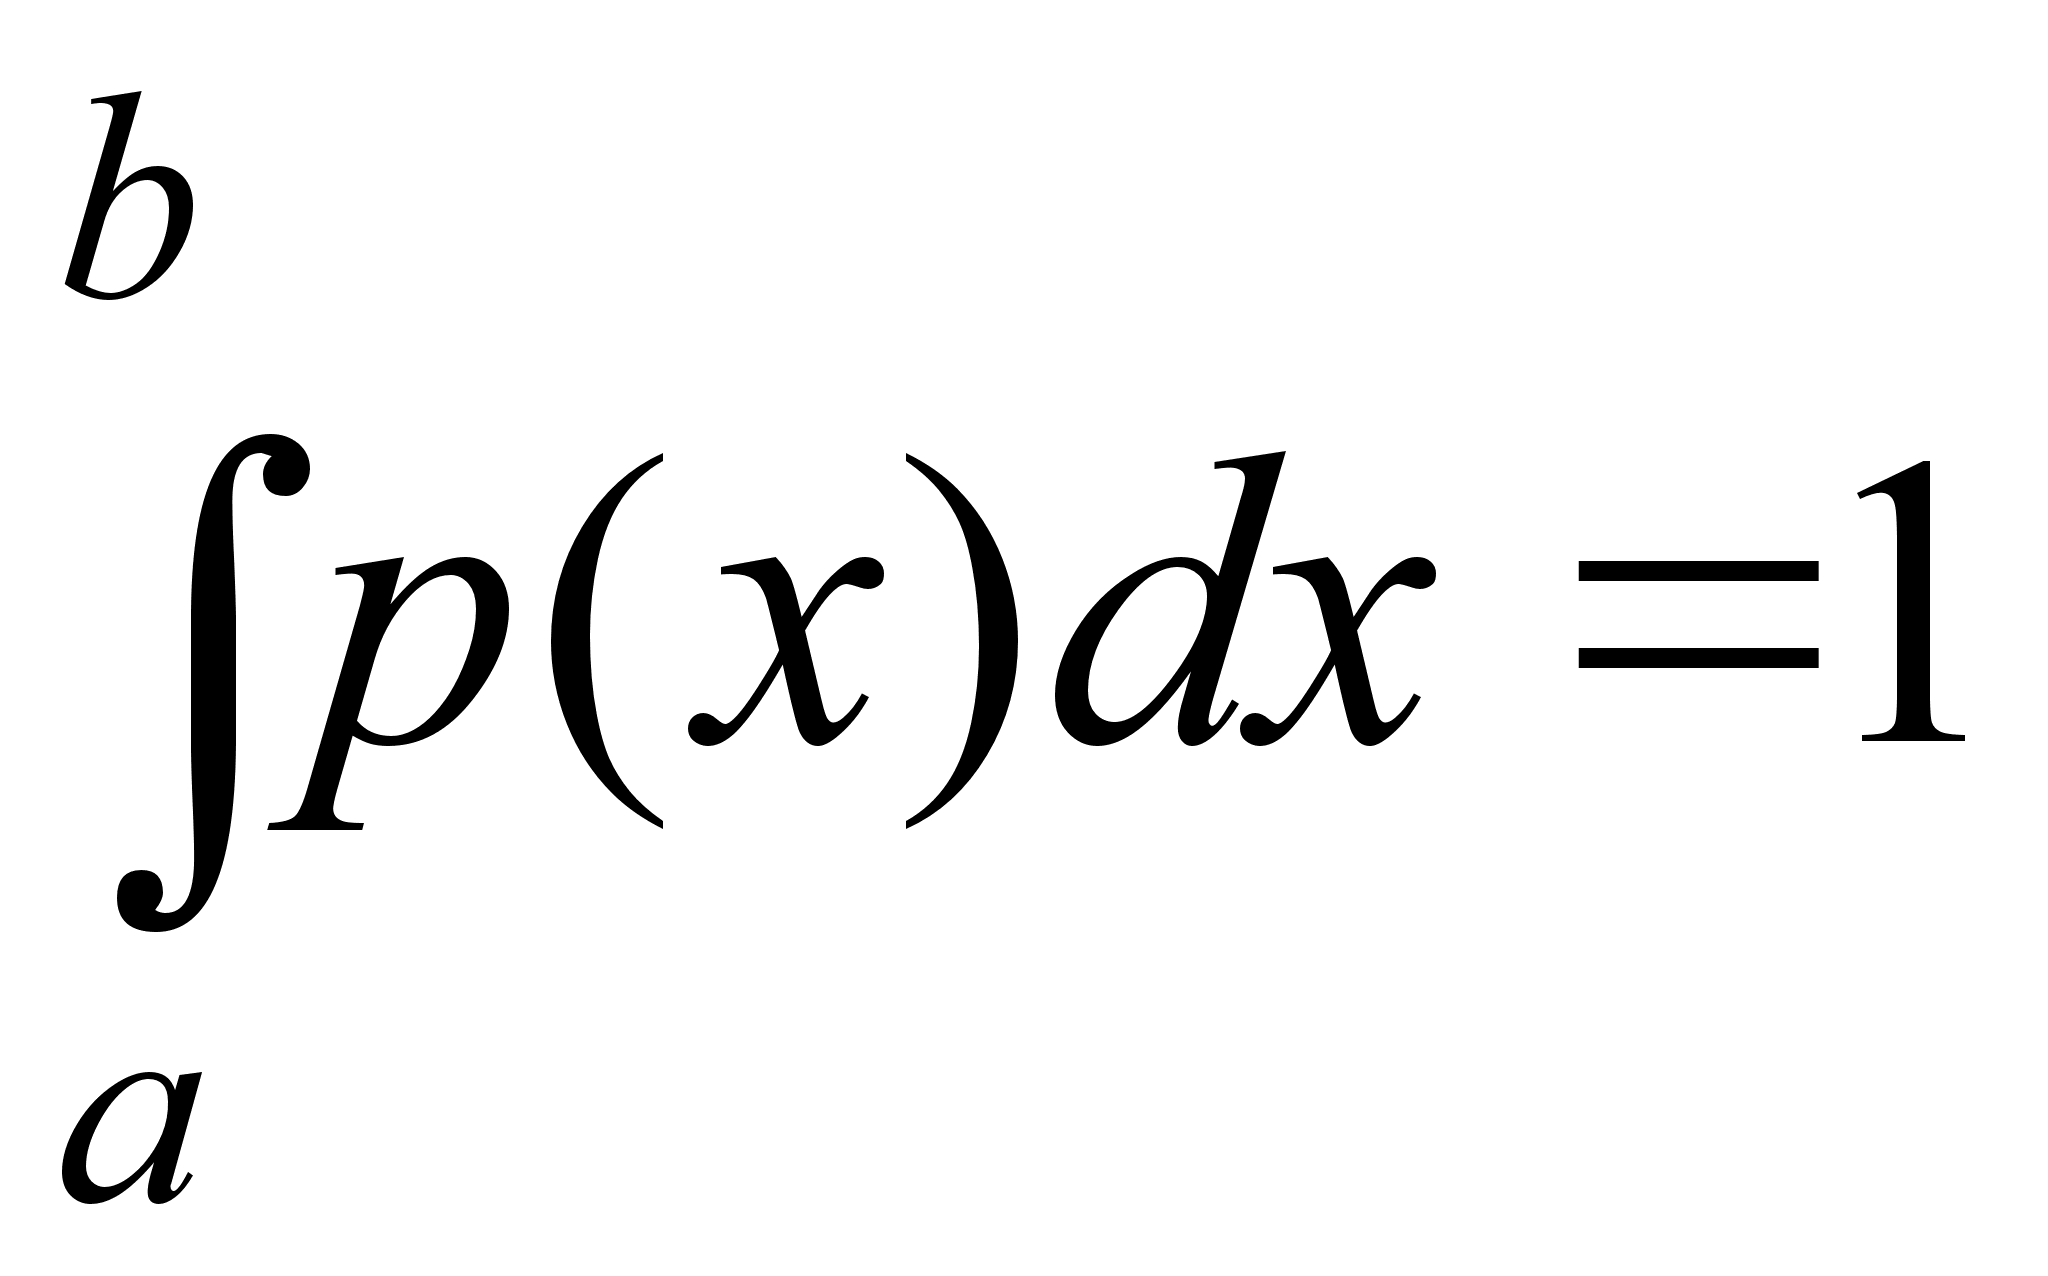
Для удобства иногда считают функцию р(х) определённой для всех значений х, полагая её равной нулю в тех точках х, которые не являются возможными значениями этой случайной величины.
Плотностью распределения может служить любая интегрируемая функция р(х), удовлетворяющая двум условиям:
р(х) 0;
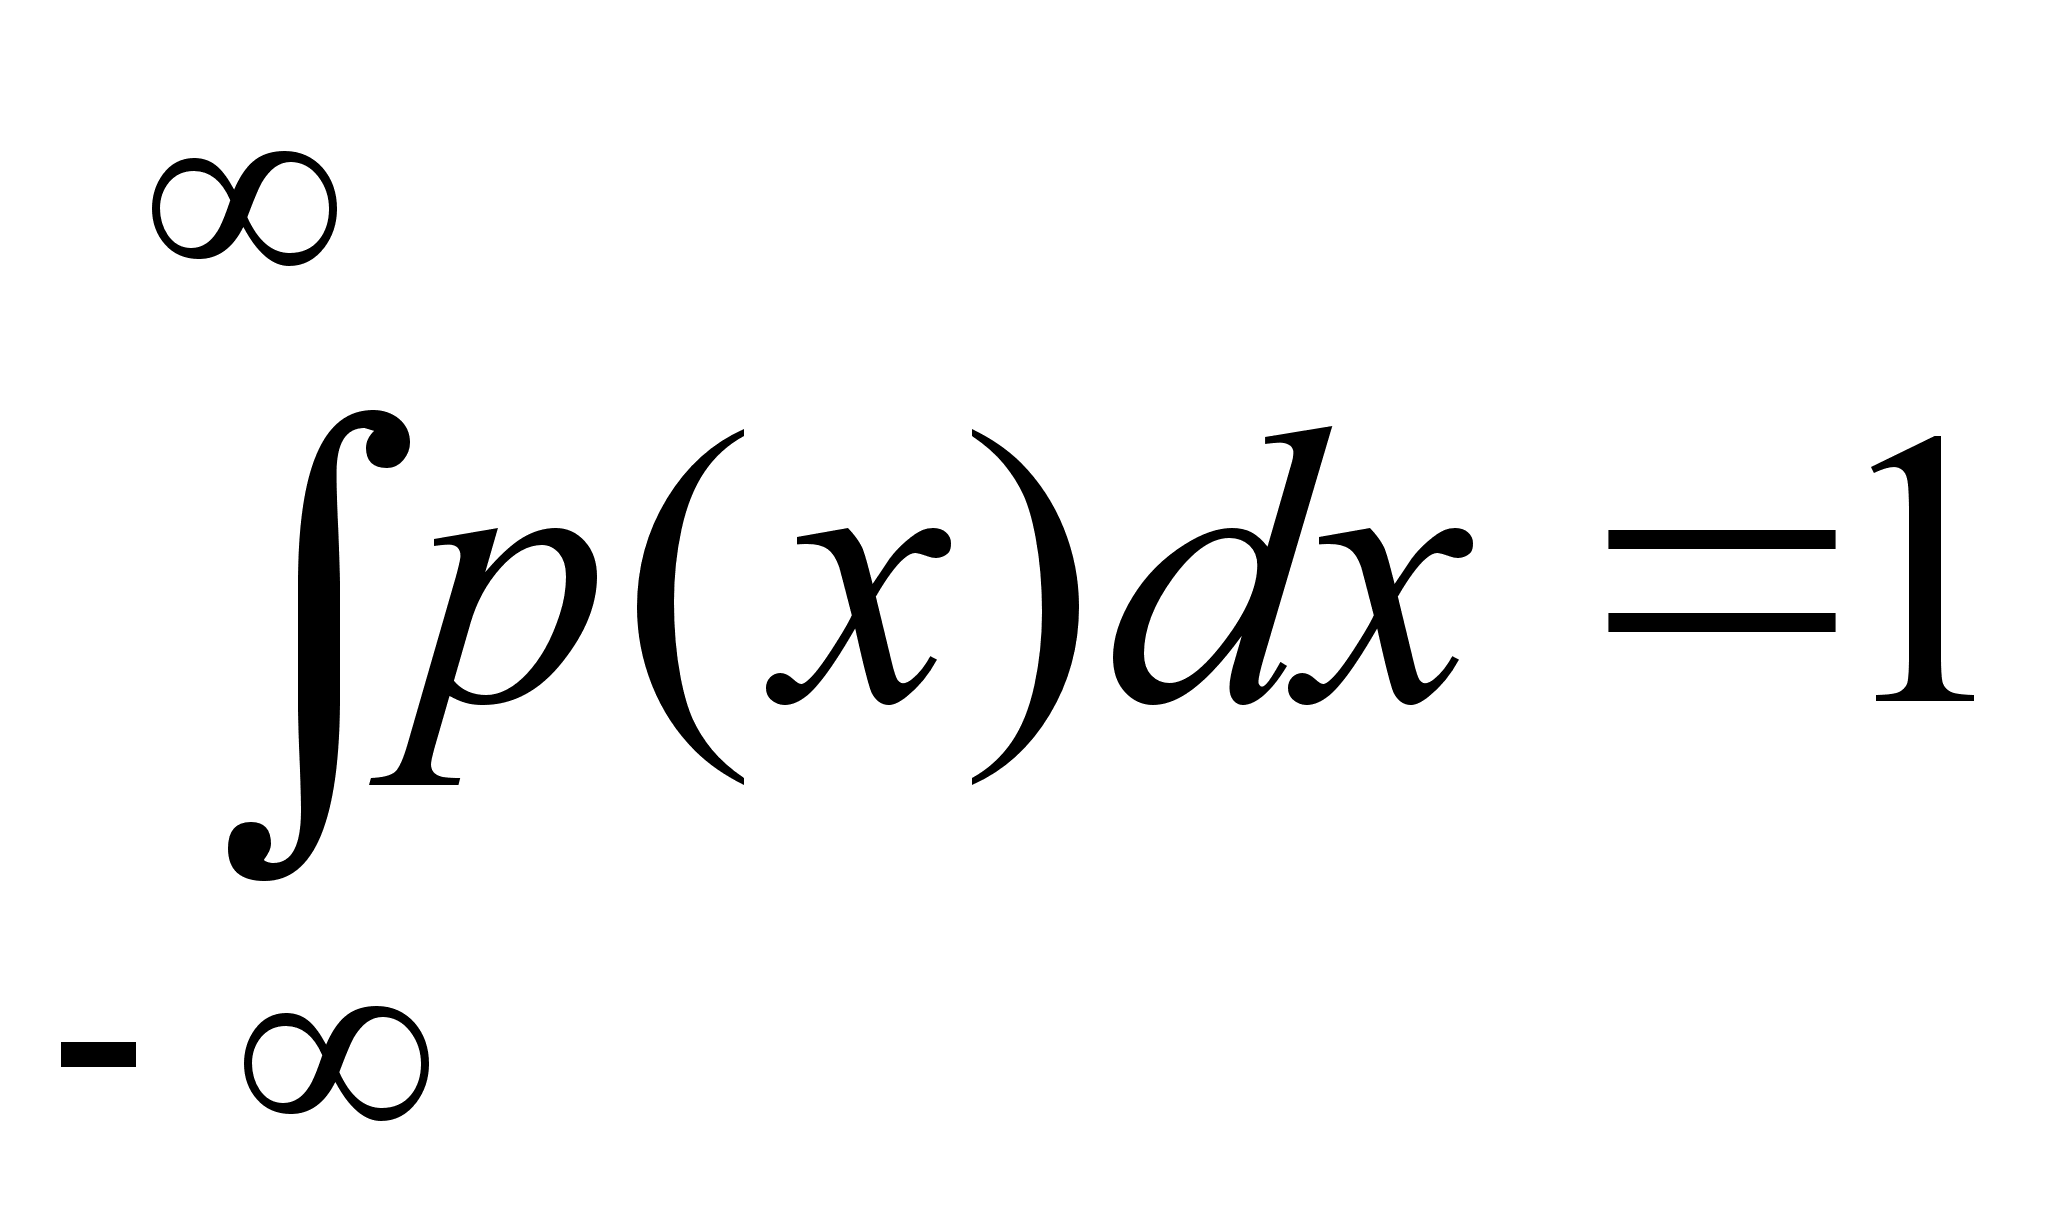
Можно задавать случайную величину, задавая функцию р(х), удовлетворяющую этим условиям.
В качестве примера рассмотрим случайную величину , равномерно распределённую на промежутке [a; b]. В этом случае р(х) постоянна внутри этого промежутка:
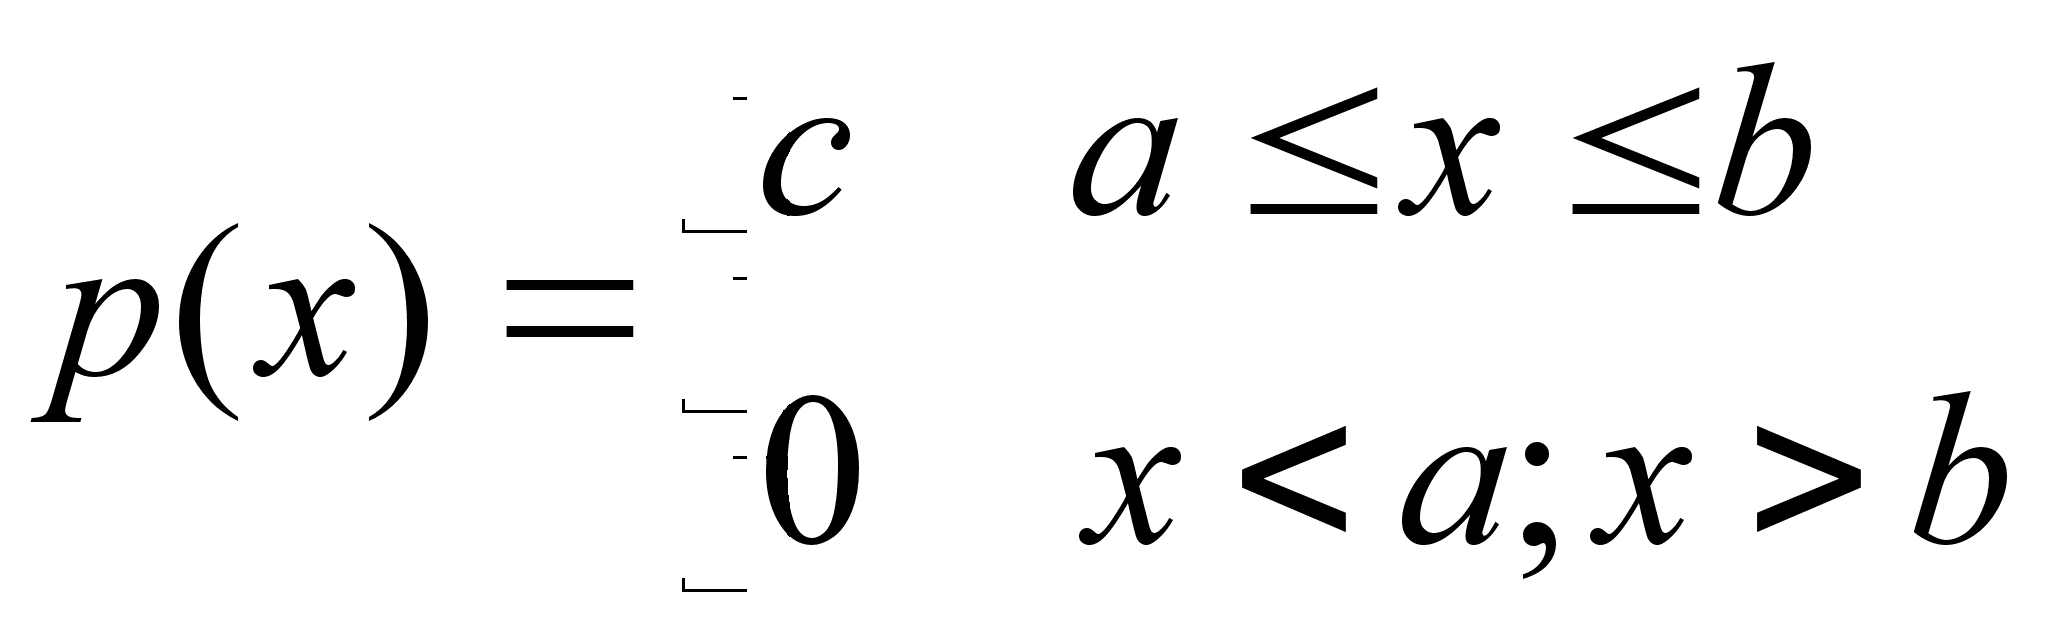
По свойству 2) функции р(х)
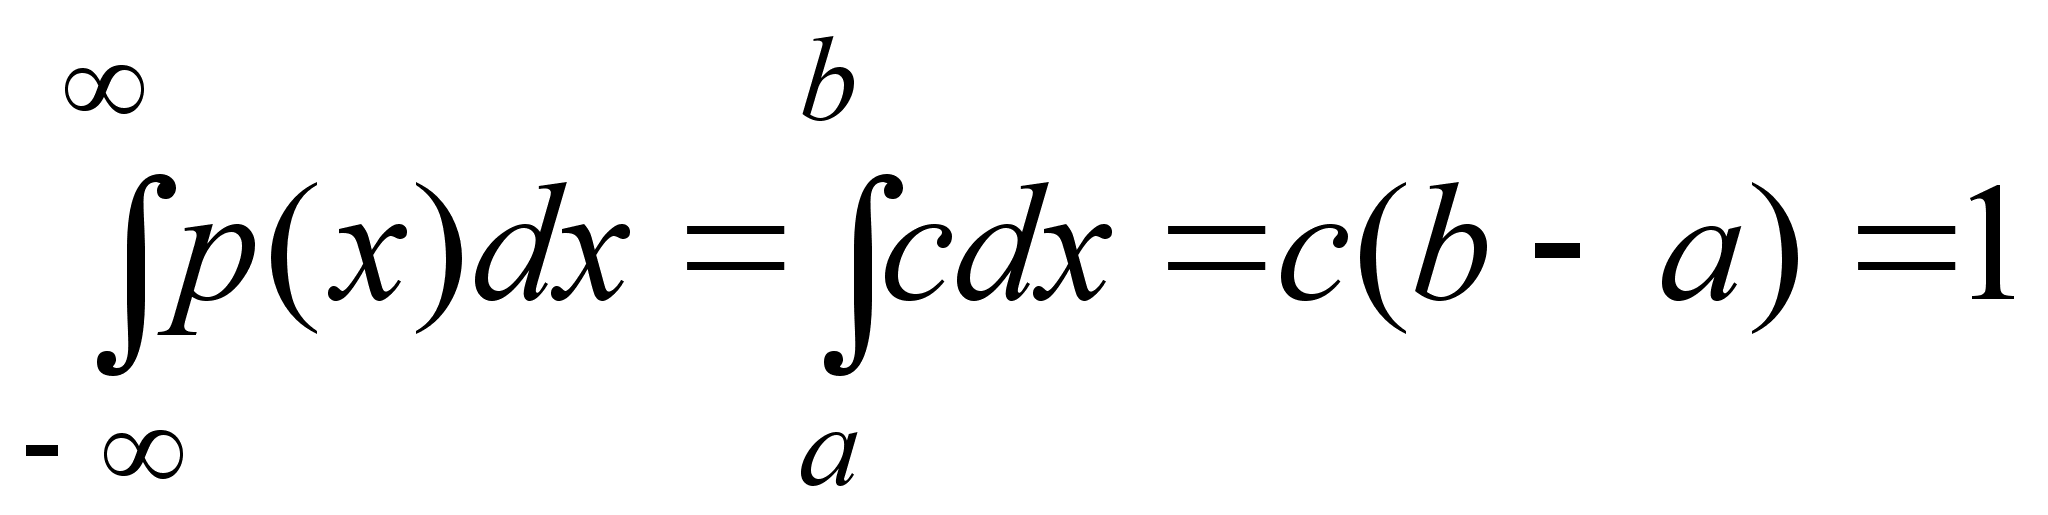
О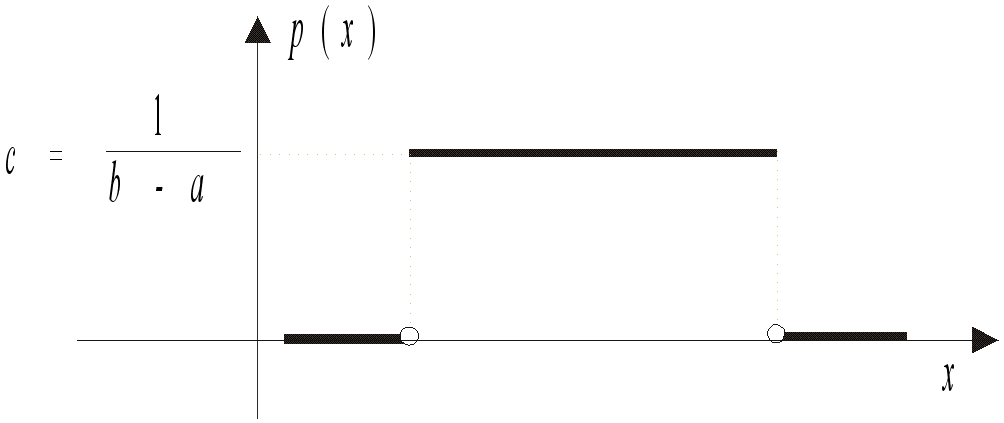
Рис. 2
тсюда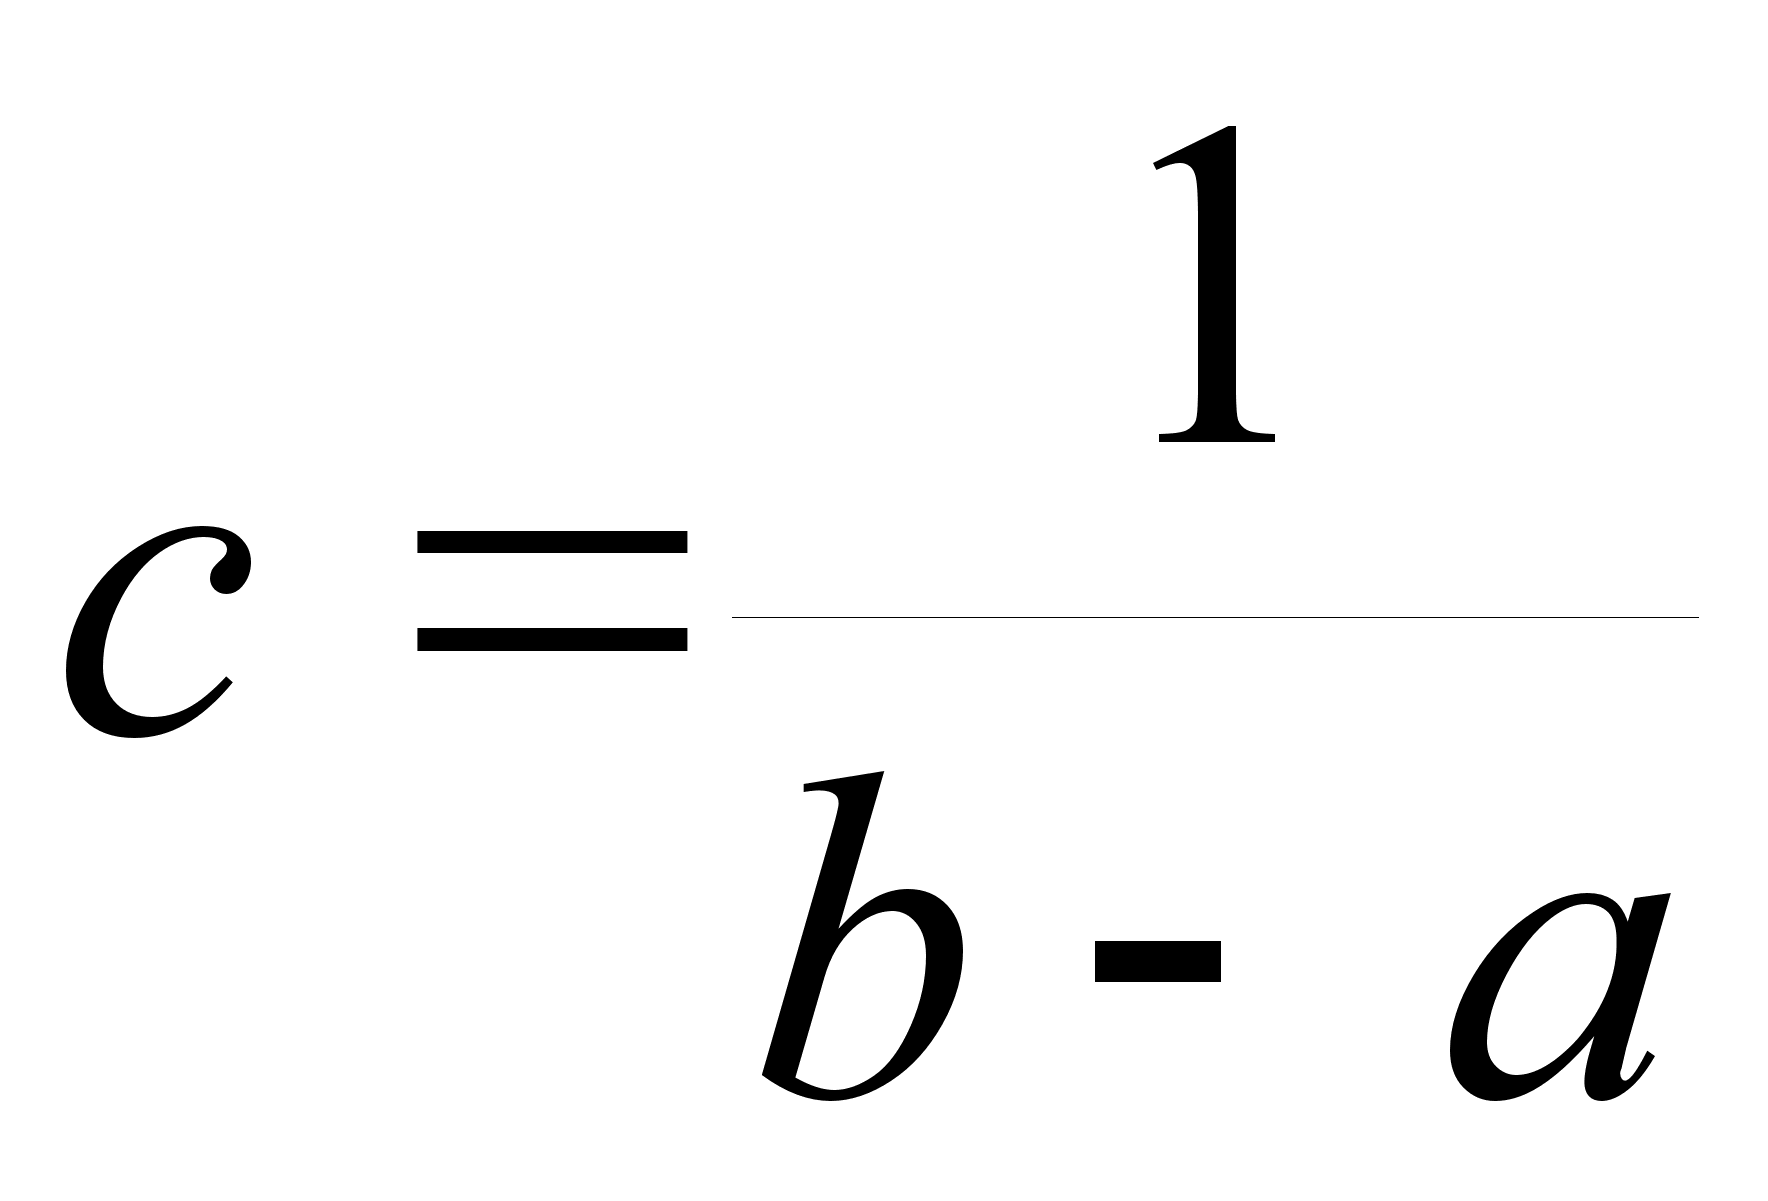 .
График функции
р(х) представлен
на рисунке 2.
Во многих практических задачах встречаются случайные величины, у которых возможные значения не ограничены сверху и снизу. В этом случае кривая распределения располагается над осью х и при х и х – асимптотически приближается к этой оси, как изображено на рисунке 1. Вероятность того, что случайная величина примет значение, меньшее некоторого числа а, равна площади фигуры, заключённой между кривой распределения и горизонтальной координатной осью слева от точки а. Будем считать, что такая площадь существует.
Пусть – непрерывная случайная величина. Функция F(x), которая определяется равенством
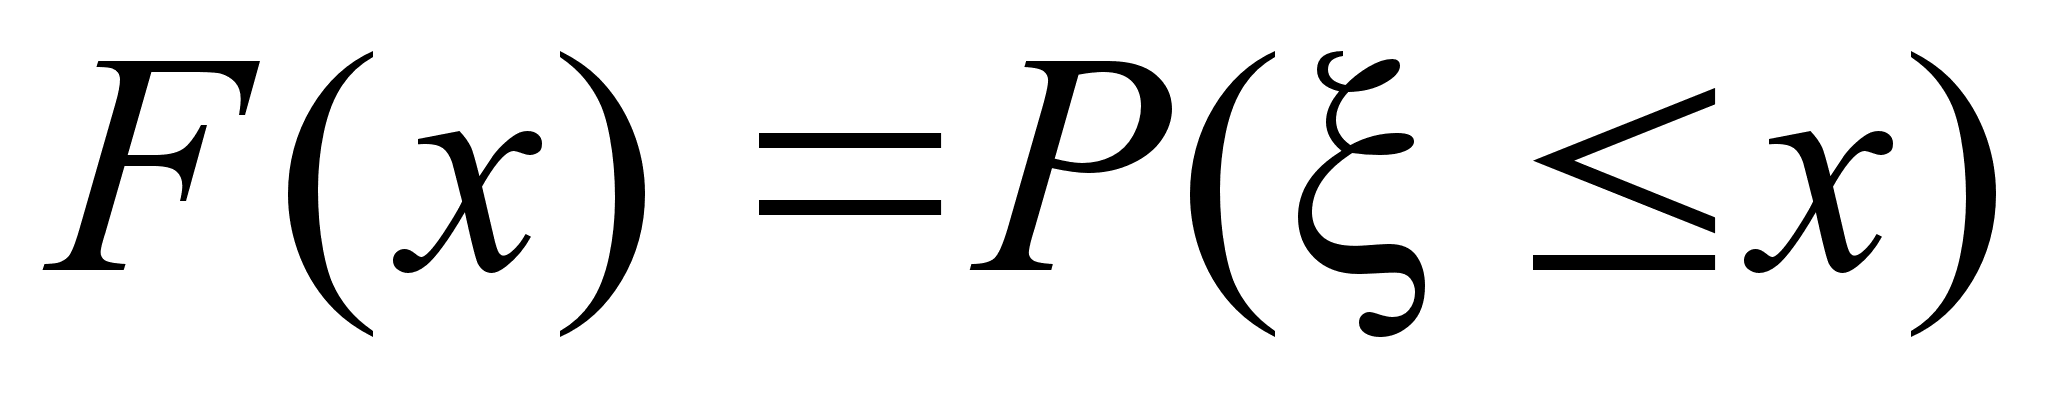 ,
называется
интегральной
функцией
распределения
или просто
функцией
распределения
случайной
величины .
Непосредственно
из определения
следует равенство
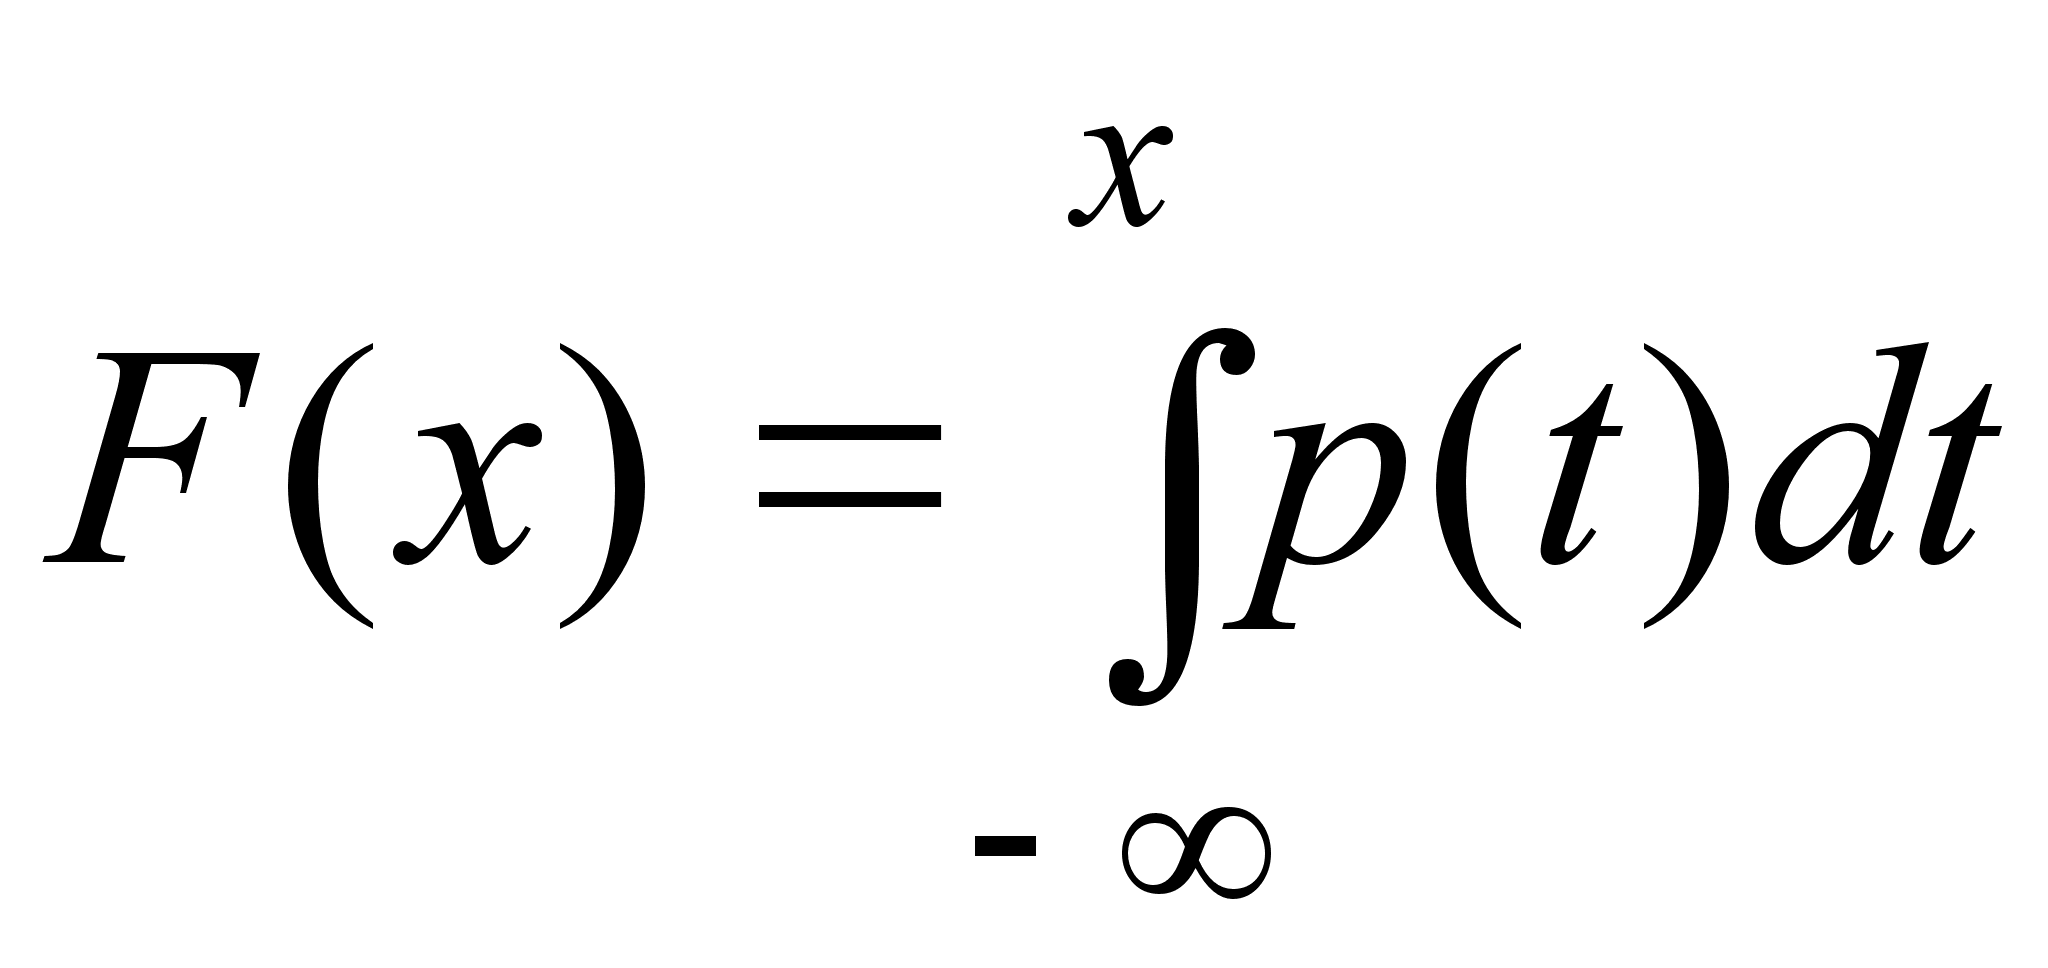 .
Формула производной
определённого
интеграла по
верхнему пределу
в данном случае
приводит к
соотношению
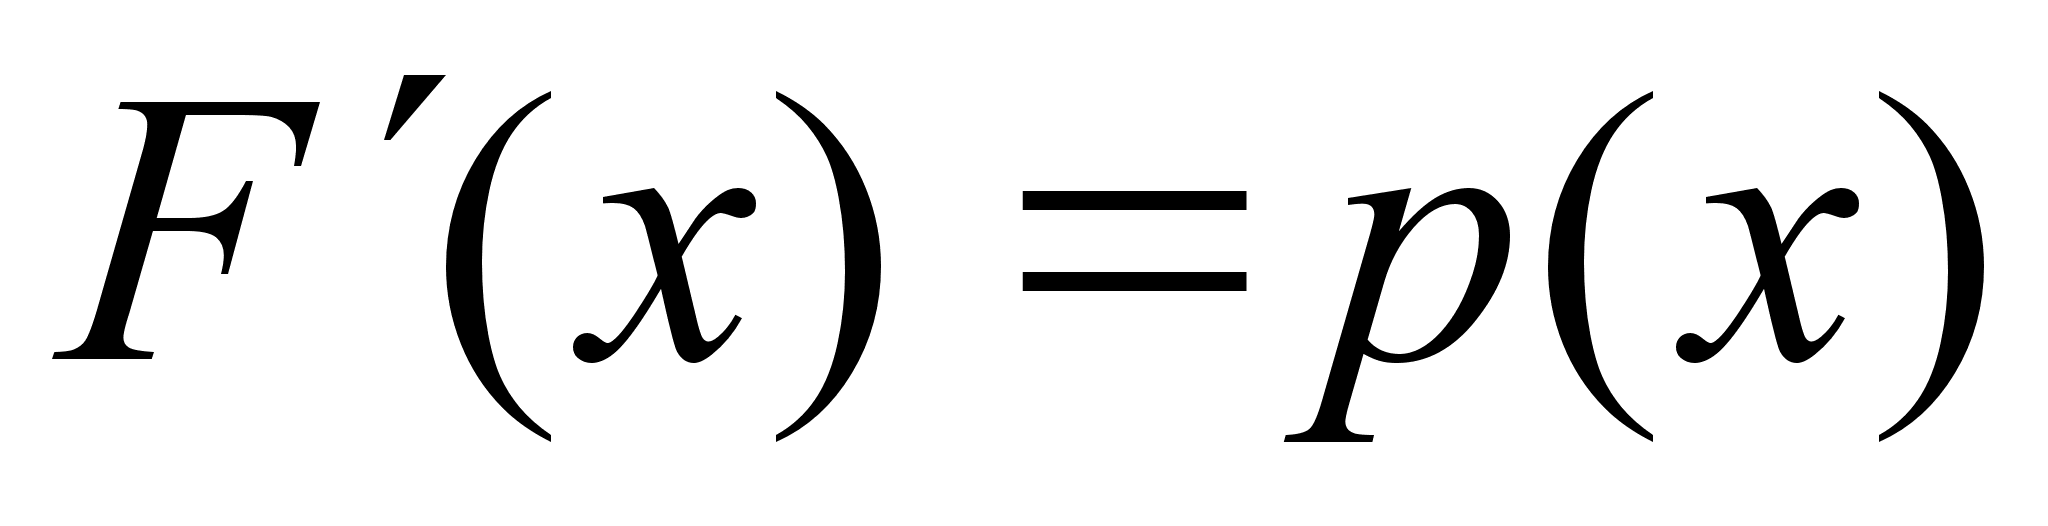 .
Плотность
распределения
р(х)
называют
дифференциальной
функцией
распределения.
Функция распределения F(x) случайной величины имеет следующие свойства.
F(x) — непрерывная возрастающая функция.
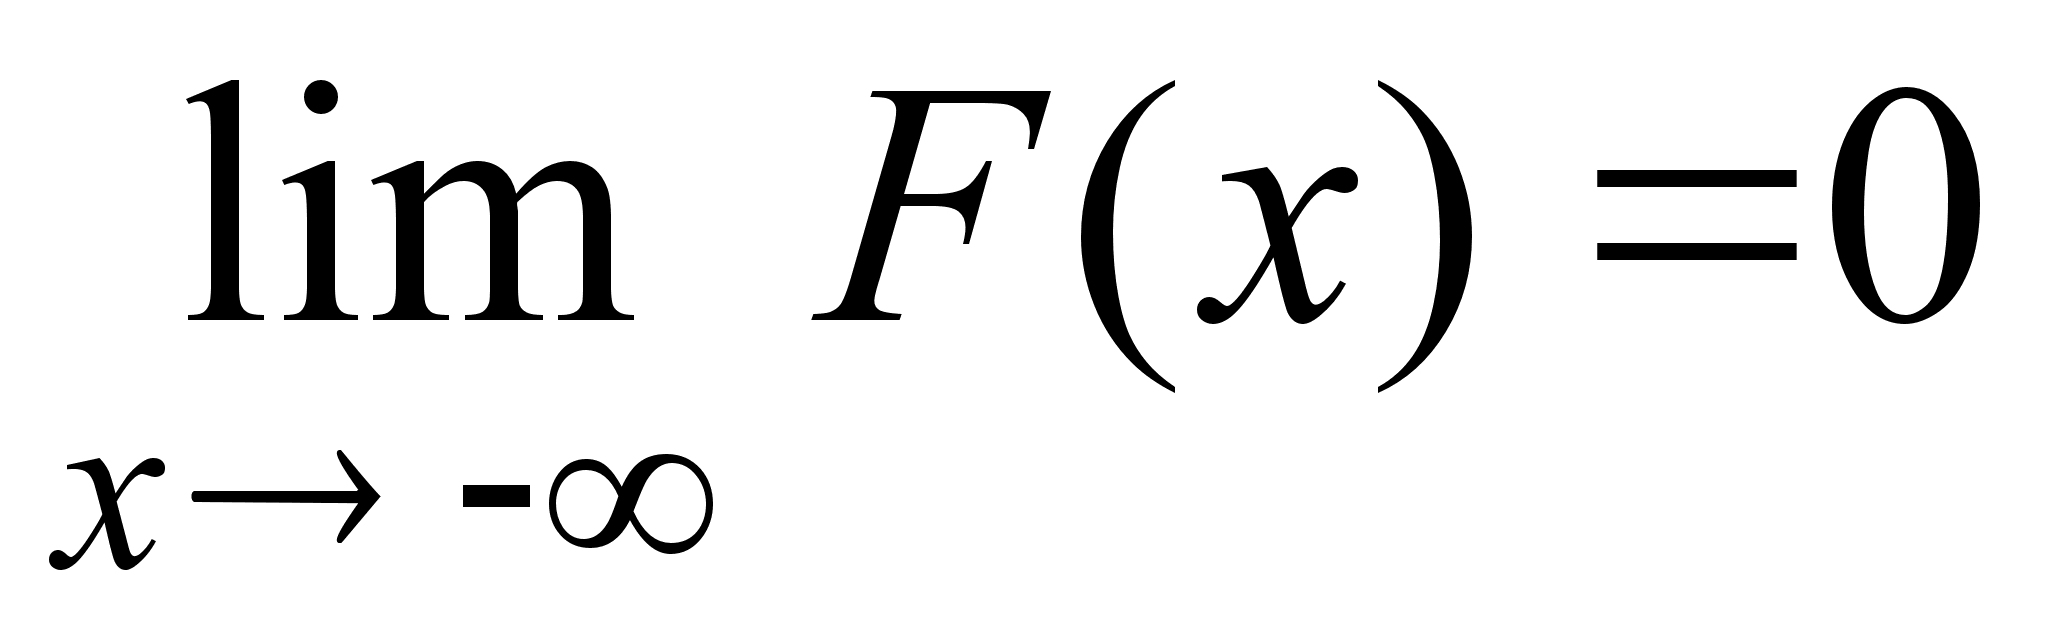 ;
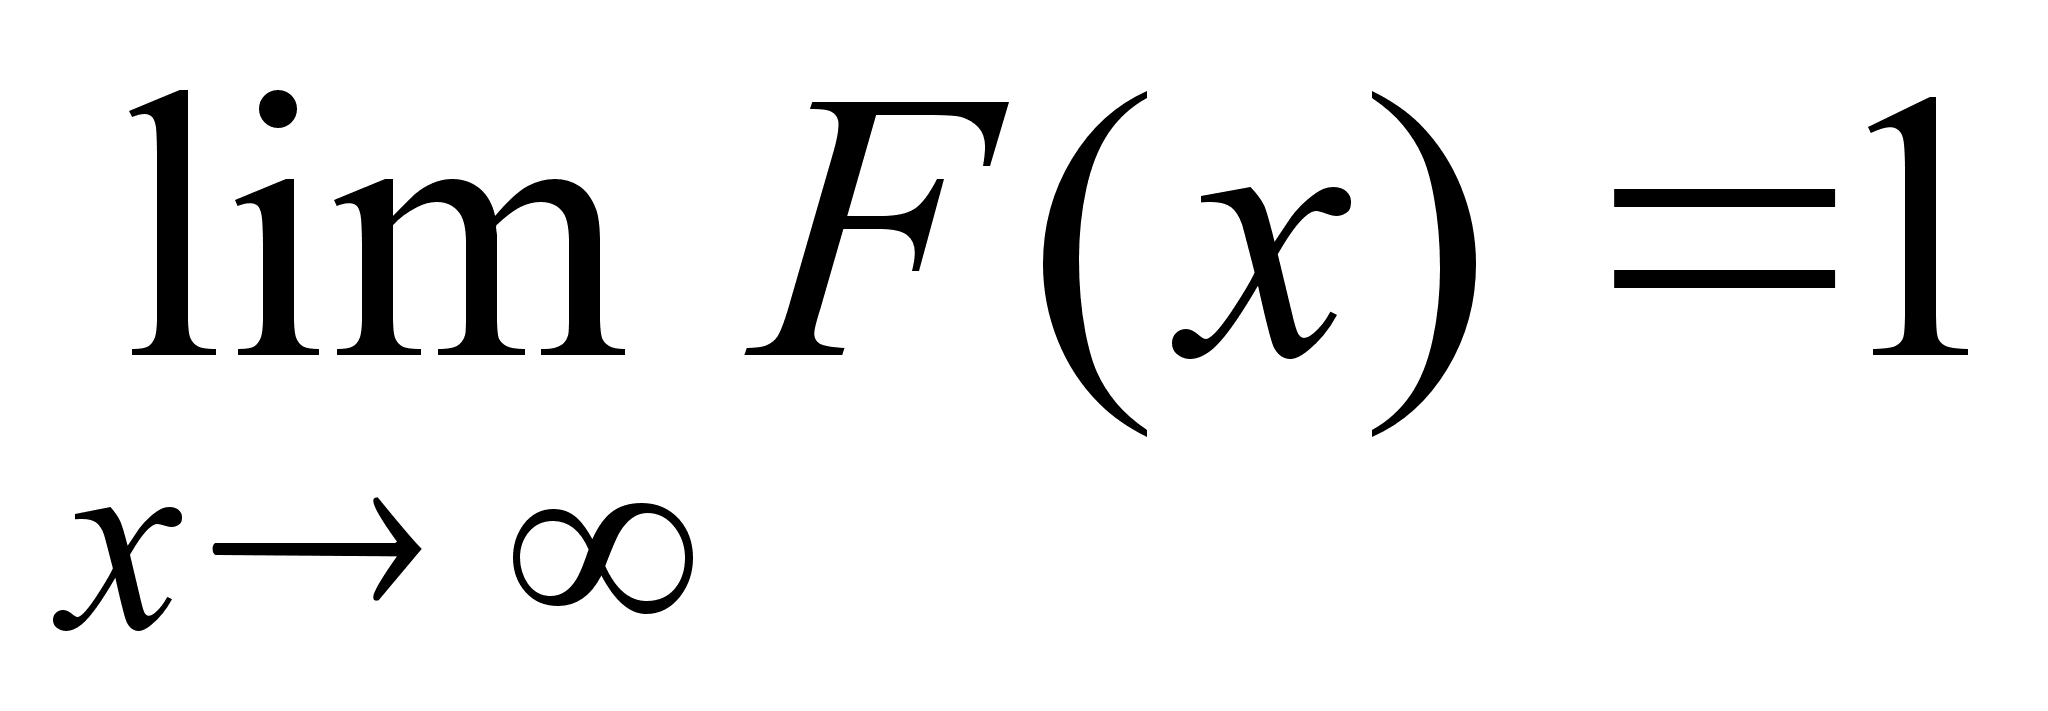
Свойства 1 и 2 вытекают непосредственно из определения функции F(x).
Приращение F(x) на промежутке (х1; х2) равно вероятности того, что случайная величина принимает значение из этого промежутка:
F(x2) – F(x1) = P(x1 < x2)
Доказательство.
F(x2) = P( x2) = P( x1) + P(x1 < x2) = F(x1) + P(x1 < x2)
Отсюда
P(x1 < x2) = F(x2) – F(x1)
Заметим, что для непрерывной случайной величины справедливы равенства
P(x1 < x2) = P(x1 < < x2) = P(x1 < x2) = P(x1 x2)
Для равномерного распределения функция F(x) имеет вид:
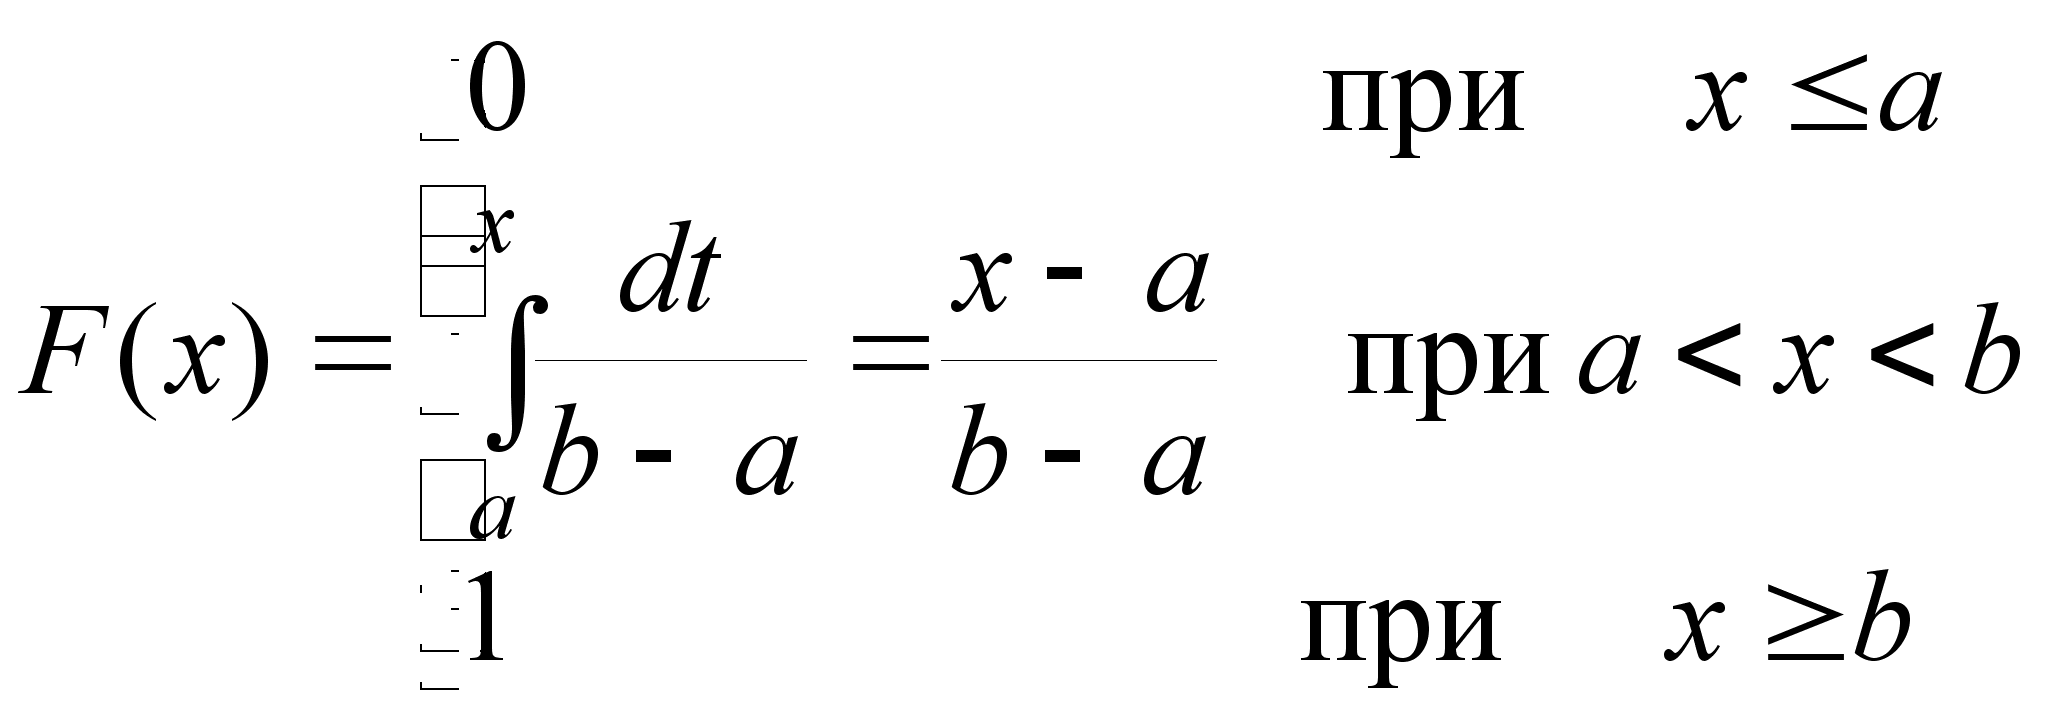
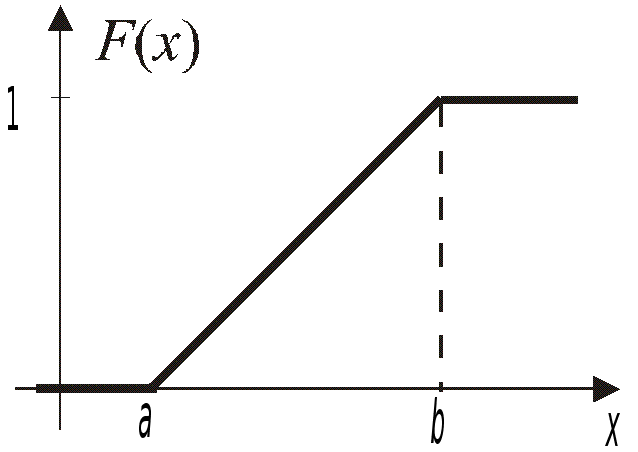
Рис. 3
График функции F(x) представлен на рисунке 3.Закон распределения непрерывной случайной величины можно определить заданием либо функции р(х), либо функции F(x).
Правило 3-х (трех “сигм”).
Пусть имеется нормально распределённая случайная величина с математическим ожиданием, равным а и дисперсией 2. Определим вероятность попадания в интервал (а – 3; а + 3), то есть вероятность того, что принимает значения, отличающиеся от математического ожидания не более, чем на три среднеквадратических отклонения.
P(а – 3< < а + 3)=Ф(3) – Ф(–3)=2Ф(3)
По таблице находим Ф(3)=0,49865, откуда следует, что 2Ф(3) практически равняется единице. Таким образом, можно сделать важный вывод: нормальная случайная величина принимает значения, отклоняющиеся от ее математического ожидания не более чем на 3.
(Выбор числа 3 здесь условен и никак не обосновывается: можно было выбрать 2,8, 2,9 или 3,2 и получить тот же вероятностный результат. Учитывая, что Ф(2)=0,477, можно было бы говорить и о правиле 2–х “сигм”.)
Совместное распределение двух случайных величин.
Пусть пространство элементарных исходов случайного эксперимента таково, что каждому исходу ij ставиться в соответствие значение случайной величины , равное xi и значение случайной величины , равное yj.
Примеры:
Представим себе большую совокупность деталей, имеющих вид стержня. Случайный эксперимент заключается в случайном выборе одного стержня. Этот стержень имеет длину, которую будем обозначать и толщину— (можно указать другие параметры—объем, вес, чистота обработки, выраженная в стандартных единицах).
Если результат эксперимента—случайный выбор какого–либо предприятия в данной области, то за можно принимать объем производства отнесенный к количеству сотрудников, а за —объем продукции, идущей на экспорт, тоже отнесенной к числу сотрудников.
В этом случае мы можем говорить о совместном распределении случайных величин и или о “двумерной” случайной величине.
Если и дискретны и принимают конечное число значений ( – n значений, а – k значений), то закон совместного распределения случайных величин и можно задать, если каждой паре чисел xi, yj (где xi принадлежит множеству значений , а y j—множеству значений ) поставить в соответствие вероятность pij, равную вероятности события, объединяющего все исходы ij (и состоящего лишь из этих исходов), которые приводят к значениям
= xi; = y j.
Такой закон распределения можно задать в виде таблицы:
-
y1
y2
yj
yk
x1
р11
р12
р1j
р1k
P1
xi
рi1
рi2
рij
рik
Pi
(*)
xn
рn1
рn2
рnj
рnk
Pn
P1
P2
Pj
Pk
Очевидно
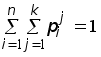
Если просуммировать все рij в i–й строке, то получим

вероятность того, что случайная величина примет значение xi. Аналогично, если просуммировать все рij в j–м столбце, то получим

вероятность того, что принимает значение y j.
Соответствие xi Pi (i = 1,2,,n) определяет закон распределения , также как соответствие yj P j (j = 1,2,,k) определяет закон распределения случайной величины .
Очевидно
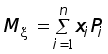 ,
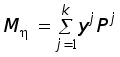 .
Раньше мы говорили, что случайные величины и независимы, если
pij=PiP j (i=1,2,,n; j=1,2,,k).
Если это не выполняется, то и зависимы.
В чем проявляется зависимость случайных величин и и как ее выявить из таблицы?
Рассмотрим столбец y1. Каждому числу xi поставим в соответствие число
pi/1= (1)
которое
будем называть
условной вероятностью
=
xi при
=y1.
Обратите внимание
на то, что это
не вероятность
Pi
события =
xi, и
сравните формулу
(1) с уже известной
формулой условной
вероятности
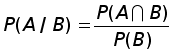 .
Соответствие
xiрi/1, (i=1,2,,n)
будем
называть условным
распределением
случайной
величины
при =y1.
Очевидно
 .
Аналогичные
условные законы
распределения
случайной
величины
можно построить
при всех остальных
значениях ,
равных y2;
y3,,
yn
,ставя в соответствие
числу xi
условную вероятность
pi/j = (
 ).
В таблице приведён условный закон распределения случайной величины при =yj
-
x1
x2
xi
xn
pi/j


Можно ввести понятие условного математического ожидания при = yj
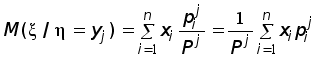
Заметим, что и равноценны. Можно ввести условное распределение при =xi соответствием
 (j = 1,2,,k)
Также можно ввести понятие условного математического ожидания случайной величины при =xi :
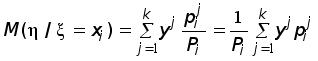
Из определения следует, что если и независимы, то все условные законы распределения одинаковы и совпадают с законом распределения (напоминаем, что закон распределения определяется в таблице (*) первым и последним столбцом). При этом очевидно, совпадают все условные математические ожидания М(/ = yj) при j = 1,2,,k, которые равны М.
Если условные законы распределения при различных значениях различны, то говорят, что между и имеет место статистическая зависимость.
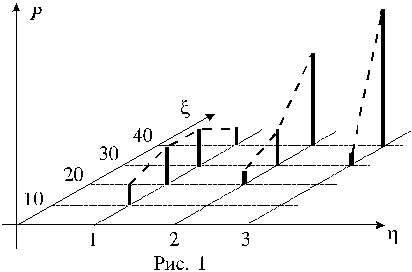
Пример I. Пусть закон совместного распределения двух случайных величин и задан следующей таблицей. Здесь, как говорилось ранее, первый и последний столбцы определяют закон распределения случайной величины , а первая и последняя строки – закон распределения случайной величины .
-
1
2
3
10
1/36
0
0
1/36
20
2/36
1/36
0
3/36
30
2/36
3/36
2/36
7/36
40
1/36
8/36
16/36
25/36
6/36
12/36
18/36
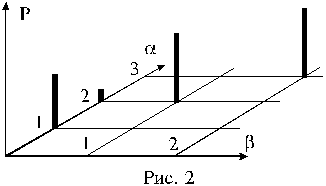
Полигоны условных распределений можно изобразить на трехмерном графике (рис. 1).
Пример II. (Уже встречавшийся).
Пусть даны две независимые случайные величины и с законами распределения
-
0
1
1
2
Р
1/3
2/3
Р
3/4
1/4
Найдем законы распределений случайных величин =+ и =
-
1
2
3
0
1
2
Р
3/12
7/12
2/12
Р
4/12
6/12
2/12
Построим таблицу закона совместного распределения и .
-
0
1
2
1
3/12
0
0
3/12
2
1/12
6/12
0
7/12
3
0
0
2/12
2/12
4/12
6/12
2/12
Чтобы получить =2 и =0, нужно чтобы приняла значение 0, а приняла значение 2. Так как и независимы, то
Р(=2; =0)= Р(=0; =2)=Р(=0)Р(=2)=1/12.
Очевидно также Р(=3; =0)=0.
 принимает
значение 1 и с
вероятностью
 – значение 2.
Пример III.
Рассмотрим закон совместного распределения и , заданный таблицей
-
0
1
2
1
1/30
3/30
2/30
1/5
2
3/30
9/30
6/30
3/5
3
1/30
3/30
2/30
1/5
1/6
3/6
2/6
В этом случае выполняется условие P(=xi; =yj)=P(=xi)P(=yj), i=1,2,3; j=1,2,3,
Построим законы условных распределений
-
1
2
3
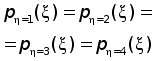
1/5
3/5
1/5
Законы условных распределений не отличаются друг от друга при =1,2,3 и совпадают с законом распределения случайной величины .
В данном случае и независимы.
Характеристикой зависимости между случайными величинами и служит математическое ожидание произведения отклонений и от их центров распределений (так иногда называют математическое ожидание случайной величины), которое называется коэффициентом ковариации или просто ковариацией.
cov(; ) = M((–M)(–M))
Пусть = x1, x2, x3,, xn, = y1, y2, y3,,yn. Тогда
cov(;
)=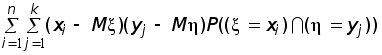 (2)
Эту формулу можно интерпретировать так. Если при больших значениях более вероятны большие значения , а при малых значениях более вероятны малые значения , то в правой части формулы (2) положительные слагаемые доминируют, и ковариация принимает положительные значения.
Если же более вероятны произведения (xi – M)(yj – M), состоящие из сомножителей разного знака, то есть исходы случайного эксперимента, приводящие к большим значениям в основном приводят к малым значениям и наоборот, то ковариация принимает большие по модулю отрицательные значения.
В первом случае принято говорить о прямой связи: с ростом случайная величина имеет тенденцию к возрастанию.
Во
втором случае
говорят об
обратной связи:
с ростом
случайная
величина