Складність методів вирішення проблеми дискретного логарифмування в групі точок еліптичної кривої


 історично була
визначена як
адитивна група,
але з тим же
успіхом можна
було б визначити
як мультиплікативну,
назвавши групову
операцію множенням
точок.
Операція
експоненціювання
 у мультиплікативній
групі найбільш
ефективно
здійснюється
методом послідовного
піднесення
до квадрата.
Для цього число
 подається у
двійковій
системі числення
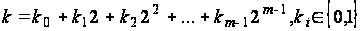
як
 -розрядне
двійкове число
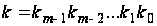 .
Наприклад,
мінімальним
5-розрядним
числом (з 1 у
старшому розряді)
є двійкове
число
 (рівне 16 у десятковій
системі), а
максимальним
– число 11111 (рівне
31 у десятковій
системі). Тоді
експоненціювання
елемента
 зводиться до
послідовного
піднесення
до квадрата
і множення на
(останнє за
наявності 1 у
двійковому
записі від
старшого розряду
до молодшого):
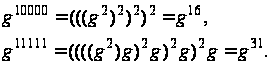
У першому
випадку виконується
4 операції множення,
у другому 8-множень.
У загальному
випадку експоненціювання
у двійкову
-розрядний
степінь цим
методом здійснюється
за допомогою
від
 до
 операцій множення
за модулем
 .
Об'єм обчислень
пропорційний
розрядності
числа
.
Така обчислювальна
складність
називається
поліноміальною
 а -
коефіцієнт
пропорційності).
Зворотна
функція дискретного
логарифмування
 у найгіршому
разі може зажадати
перебору до
 значень, при
цьому говорять
про експонентну
складність
обчислень

Взагалі кажучи, поняття обчислювальної складності визначається через співвідношення вхідного й вихідного об'ємів даних деякого обчислювального алгоритму. Алгоритми поліноміального часу (швидкі алгоритми) характеризуються лінійним співвідношенням об'ємів даних на виході й вході процесора, а алгоритми експонентного часу (повільні), відповідно, експонентним. Зі збільшенням об'єму вхідних даних експонентна складність веде до практично нереалізованих обчислювальних витрат.
Сьогодні
відомі досить
ефективні
субекспоненційні
методи рішення
DLP над скінченними
полями. Це пов'язано
з тим, що елемент
поля
 - ціле
число, яке можна
факторизувати
у вигляді добутку
ступенів простих
чисел. Це затребувано
з метою безпеки
істотно збільшити
розміри поля
для криптосистем
Діффі-Хеллмана
й Ель-Гамала
(до тисяч біт).
З іншого боку,
точку еліптичної
кривої
 факторизувати
на зразок цілого
числа не вдається.
Тому для ЕСС
поки не відомі
методи розв’язання
 ,
більш ефективні,
ніж класичні
методи з експонентною
складністю
обчислень. Цим
і пояснюється
високий рівень
безпеки криптосистем
на еліптичних
кривих.
Криптоатаки
на
 прийнято розділяти
на дві групи:
атаки на загальну
структуру й
атаки ізоморфізму.
До першого
звичайно відносять:
– метод Шенкса( Shenks Method- Giant Step-Baby step);
–
 методи Полларда
(Pollardўs
Method);
– метод Поліга- Хеллмана (Pohlig-Hellman Method);
– метод обчислення степенів (Index Calculus Method).
Ці методи застосовні для будь-якої скінченної групи, у тому числі й для еліптичної кривої (крім останнього). Атаки ізоморфізму специфічні для ECC. Серед них найбільш відомі:
– атака Менезиса, Окамото й Ванстоуна, або MOV- атака;
– ізоморфізм Семаєва;
– метод спуску Вейля й ін.
Атаки ізоморфізму
базуються на
перетвореннях,
що переводять
абелеву групу
точок
в елементи
мультиплікативної
групи поля.
Оскільки, рішення
 у поле набагато
простіше, ніж
на еліптичній
кривій (при
порівнянних
порядках), то
знаходження
ізоморфізму
між двома групами
істотно знижує
безпека ЕСС.
Поки відомі
кілька класів
криптографічно
слабких кривих,
для яких ці
атаки успішні.
2. Метод Шенкса
Прямий
метод розрахунку
дискретного
логарифма може
використати
два варіанти:
 -
кратне додавання
точки
 до збігу із
точкою
 (шлях від точки
 до точки
 )
або шлях від
точки
до точки.
У найгіршому
випадку для
визначення
числа
із точки
 може знадобитися
до
 додавань точки
(
при
 маємо множину
зворотних за
знаком точок,
 -
координати
яких уже відомі).
Обчислювальна
складність
безпосереднього
розрахунку
дискретного
логарифма
оцінюється
числом операцій
 .
Щоб скоротити
шлях до збігу
(колізії) з відомою
точкою, природно
на всьому шляху
поставити
маркери
 ,
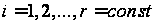 ,
координати
яких визначено
на етапі попередніх
обчислень.
Рухаючись від
точки
до найближчого
маркера, ми
істотно скорочуємо
зону пошуку
(рис 1). Виникає
лише питання,
як розставити
маркери?
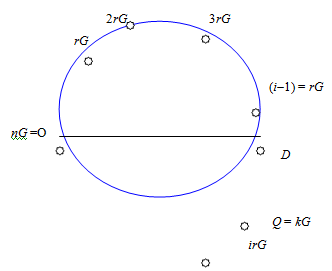
Рисунок 1 - Подання елементів циклічної групи точками на колі й інтервал аналізу за методом Шенкса
По суті
введення маркерів
- це
обмін обчислень
на пам'ять. Якщо
об'єми цих ресурсів
зробити рівними,
то відстань
між маркерами
слід вибирати
рівною
 . Ця ідея запропонована
Д.Шенксом.
Метод Шенкса
часто називають
методом великих
і малих кроків
(Giant step-Baby step). Маркери
 - це
Giant step. Номери
 цих точок з їх
 -координатами
зберігаються
в пам'яті. Baby step –
це послідовні
додавання точок
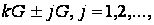 після чого
обчислені
-координати
порівняюються
з координатами
маркерів. При
збігу координат
отримуємо
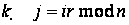 ,
звідки визначається
шукане значення
.
Метод Шенкса
є детерміністським.
Обчислювальна
складність
методу
 оцінюється
як середнє
число малих
кроків. Основний
недолік методу
– надмірний
об'єм необхідної
пам'яті, пропорційний
 .
Крім того,
на кожному
кроці порівняння
координат
здійснюється
по всіх точках,
що зберігаються
в пам'яті. Для
задач реального
криптоаналізу
метод не знайшов
застосування.
Однак, часто
метод Шенкса
приводиться
як теоретична
основа для
інших, більш
практичних
методів рішення
.
Метод ділення точок на два ( продовження)
Він заснований
на використанні
точок <P> з максимальним
порядком
 ,
 (коефіцієнт
кривої a=0). Задамо
рекурентну
функцію
ділення-відрахування
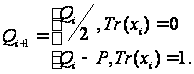
 (1)
Оскільки
кожне ділення
дає дві точки,
повна процедура
утворює дерево
розв’язків
із
 галузями (
 - число
віднімань точки
 ).
В ідеальному
випадку, при
правильному
виборі точок
ділення, одна
з галузей найбільш
коротким шляхом
веде до точки
,
а інша –
 .
При цьому двійковий
запис алгоритму
ділення (0) або
відрахування
– ділення (1) дає
шукане число
 або
 .
Для цього буде
потрібно не
більше
 ділень. Зрозуміло,
при випадковому
виборі точок
ділення ймовірність
знаходження
таких галузей
мізерно мала.
Точки групи
<P> зручно подати
у вигляді
еквідистантних
точок кола,
починаючи
відлік від
точки ПРО,
розташованої
ліворуч за
годинниковою
стрілкою (рис.
2). Будь-якій парній
точці групи
<P> ®
 відповідають
дві точки ділення
 й
 ,
розташовані
на одній діагоналі
кола й пов'язані
співвідношенням
 із точкою
 другого порядку.
Значення точок
 ,
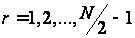 верхнього
півкола можна
розглядати
як додатні, а
нижнього півкола
 - як
від’ємні. Координати
 кожної такої
пари збігаються,
а
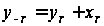 .
У процедурі
ділення, що
прагне до точки
,
можна ігнорувати
знак точки,
зазначимо, що
є лише
-
координата
точки. Назвемо
"правильною"
точкою ділення
точку лівого
півкола (на рис
2 – точка
).
Послідовний
вибір "правильних"
точок ділення
в процедурі
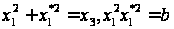 веде до точки