Линейный множественный регрессивный анализ
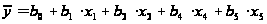
Параметры данного уравнения найдем с помощью инструмента «Регрессия» надстройки «Анализ данных» приложения MS Excel (результаты вычисления – в Приложении 8):
b0=11,3789103724081
b1= -0,140477614195711
b2= 0,334073328849854
b4= -0,0590948468841696
b5= 0,354719169807746
Получаем уравнение линейной множественной регрессии:
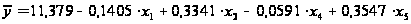
Расчетные значения критерия для заданных параметров получили с помощью инструмента «Регрессия» надстройки «Анализ данных» приложения MS Excel (результаты вычисления – в Приложении 8):


Поскольку
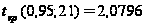 ,
то коэффициенты
b1, b2,
b4 не являются
значимыми для
построенной
модели. Исключаем
самый незначимый
фактор:
Исключаем фактор Х1 - потребление мяса и мясопродуктов на душу населения (кг).
Строим новую модель с оставшимися факторами:
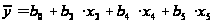
Параметры данного уравнения найдем с помощью инструмента «Регрессия» надстройки «Анализ данных» приложения MS Excel (результаты вычисления – в Приложении 9):
b0= 5,45597214112287
b2= 0,200539077387593
b4= -0,0847616134509301
b5= 0,374792925415136
Получаем уравнение линейной множественной регрессии:
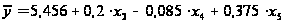
Расчетные значения критерия для заданных параметров получили с помощью инструмента «Регрессия» надстройки «Анализ данных» приложения MS Excel (результаты вычисления – в Приложении 8):


Поскольку
,
то коэффициенты
b2, b4
не являются
значимыми для
построенной
модели. Исключаем
самый незначимый
фактор:
Исключаем фактор Х8 - потребление фруктов и ягод на душу населения (кг). Строим новую модель с оставшимися факторами:
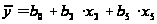
Параметры данного уравнения найдем с помощью инструмента «Регрессия» надстройки «Анализ данных» приложения MS Excel (результаты вычисления – в Приложении 10):
b0= -14,5137453627595
b2= 0,272342209805998
b5= 0,471219957359132
Получаем уравнение линейной множественной регрессии:
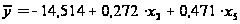
Расчетные значения критерия для заданных параметров получили с помощью инструмента «Регрессия» надстройки «Анализ данных» приложения MS Excel (результаты вычисления – в Приложении 10):


Поскольку
,
то коэффициент b2 не является значимым для построенной модели. Исключаем незначимый фактор:
Исключаем фактор Х3 - потребление сахара на душу населения (кг). Строим новую модель с оставшимся фактором:
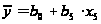
Параметры данного уравнения найдем с помощью инструмента «Регрессия» надстройки «Анализ данных» приложения MS Excel (результаты вычисления – в Приложении 11):
b0= 0,166147
b5= 0,412251
Получаем уравнение линейной парной регрессии:
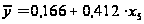
Расчетное значение критерия для параметра b5 получили с помощью инструмента «Регрессия» надстройки «Анализ данных» приложения MS Excel (результаты вычисления – в Приложении 11):

Поскольку
,
то коэффициент b5 является значимым для построенной модели. Таким образом, посредством пошагового регрессионного анализа, осуществленного методом исключения факторов, получили модель, содержащую только один значимый фактор Х9 - потребление хлебных продуктов на душу населения (кг).
Определим прогнозное значение результата, если прогнозные значения факторов составляют 80 % от их максимальных значений.Поскольку в уравнении регрессии остался лишь один значимый фактор, именно на основе данных о потреблении хлебных продуктов на душу населения будем рассчитывать прогнозное значение результативного показателя.

Если прогнозное значение фактора составит 80% от своего максимального значения
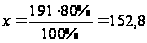 ,
тогда точечное прогнозное значение результативного показателя составит
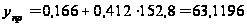
Т.е. если потребление хлебных продуктов на душу населения составит 152,8 кг, то прогнозное значение смертности населения по причине болезни органов кровообращения на 100000 населения составит примерно 63.
Рассчитаем
ошибки и доверительный
интервал прогноза
для уровня
значимости
 и
 .
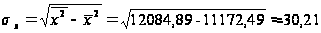
Доверительный интервал для среднего размера смертности населения по причине болезни органов кровообращения на 100000 населения при условии, что потребление хлебных продуктов составляет х = 152,8 кг с надежностью g=0,95:
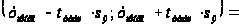
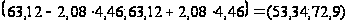
где стандартная ошибка для средних значений:
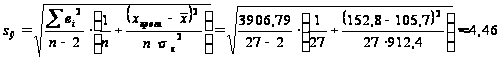
Т.е. средний размер смертности населения по причине болезни органов кровообращения на 100000 населения при условии, что потребление хлебных продуктов составляет х = 152,8 кг, находится в интервале от 53 до 72 человек. Доверительный интервал для индивидуальных значений размера смертности населения по причине болезни органов кровообращения на 100000 населения при условии, что потребление хлебных продуктов составляет х = 152,8 кг с надежностью g=0,95:
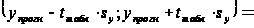
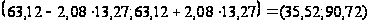 ,
где стандартная ошибка для индивидуальных значений:
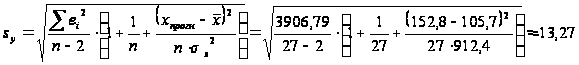
Таким образом, если потребление хлебных продуктов будет находиться на уровне 152,8 кг, то возможный размер смертности населения по причине болезни органов кровообращения на 100000 населения в 95% случаев может находиться внутри интервала от 35 до 90 человек.
Рассчитаем
те же показатели
для уровня
значимости
Доверительный интервал для среднего размера смертности населения по причине болезни органов кровообращения на 100000 населения при условии, что потребление хлебных продуктов составляет х = 152,8 кг с надежностью g=0,90:
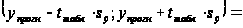
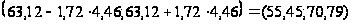
Т.е. средний размер смертности населения по причине болезни органов кровообращения на 100000 населения при условии, что потребление хлебных продуктов составляет х = 152,8 кг, находится в интервале от 55 до 70 человек.
Доверительный интервал для индивидуальных значений размера смертности населения по причине болезни органов кровообращения на 100000 населения при условии, что потребление хлебных продуктов составляет х = 152,8 кг с надежностью g=0,90:
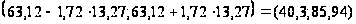
Таким образом, если потребление хлебных продуктов будет находиться на уровне 152,8 кг, то возможный размер смертности населения по причине болезни органов кровообращения на 100000 населения в 90% случаев может находиться внутри интервала от 40 до 85 человек.
Полученные результаты позволяют сделать следующие выводы:На основе сравнительной оценки влияния факторов на результативный показатель посредством расчета коэффициентов эластичности удалось установить, что смертность населения по причине болезни органов кровообращения на 100000 населения увеличивается примерно на 0,12 % при увеличении потребления мяса и мясопродуктов на душу населения на 1 %, на 0,21% при увеличении на 1% потребления сахара на душу населения и на 0,37% при увеличении потребления хлебных продуктов на душу населения на 1%.
А при увеличении оценки ВВП по паритету покупательной способности в 1994 г. на душу населения на 1% результативный показатель, наоборот, уменьшится на 0,59%. Увеличение же потребления фруктов и ягод на душу населения на 1% повлечет снижение смертности примерно на 1,02%.
Величина множественного коэффициента детерминации R2=0,799 свидетельствует о том, что изменение результативного показателя примерно на 80% обусловлено влиянием факторов, включенных в модель. Оценка качества построенного уравнения с помощью средней ошибки аппроксимации подтверждает удовлетворительную точность построенной модели.
Оценка адекватности построенной модели с помощью F-Критерия Фишера подтвердила, что в 95 % случаев уравнение регрессии статистически значимо и отражает существенную зависимость между факторами и результативным показателем. А значит, уравнение можно признать надежным и значимым, доказывающим наличие исследуемой зависимости.
Посредством
пошагового
регрессионного
анализа, осуществленного
методом исключения
факторов, получили
модель, содержащую
только один
значимый фактор
- потребление
хлебных продуктов
на душу населения.
С его использованием
построили новое
уравнение
регрессии, с
помощью которого
рассчитали
прогнозное
точечное значение
результативного
показателя
и доверительный
интервал для
уровня значимости
и
.
Задача 3
В исходной таблице (графы 2 и 3 Приложения 13) представлены статистические данные об объеме продаж продовольственных товаров с 1 января 1990 г. в относительных единицах.
Требуется:
Представить временной ряд графически, провести его сглаживание методом простой скользящей средней, оценить наличие тренда.
Построить
уравнение
неслучайной
составляющей
(тренда) временного
ряда, проверить
значимость
построенного
уравнения по
F-критерию
при уровне
значимости
.
Дать
точечную,
интервальную
оценки прогноза
среднего и
индивидуального
значений с
надежностью
 на
1 и 2 шага вперед.
Построить
авторегрессионную
модель временного
ряда, дать
точечный,
интервальный
прогноз среднего
и индивидуального
значений с
надежностью
на
1 и 2 шага вперед.
Сделать выводы по полученным результатам.
Решение:
Представим временной ряд графически:
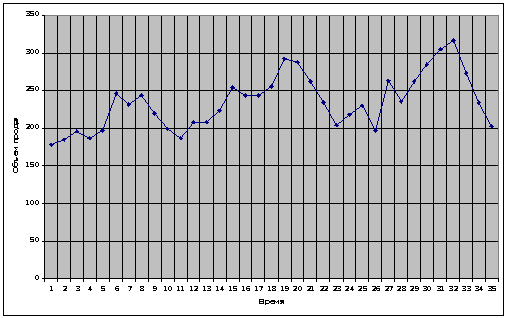
Проведем его сглаживание методом простой скользящей средней. Выбрав величину скользящей средней, равную 3, доработаем исходную таблицу данных – найдем средние значения для каждых трех исходных (графа 4 Приложения 13).
На основе средних значений строим диаграмму сглаженных данных:
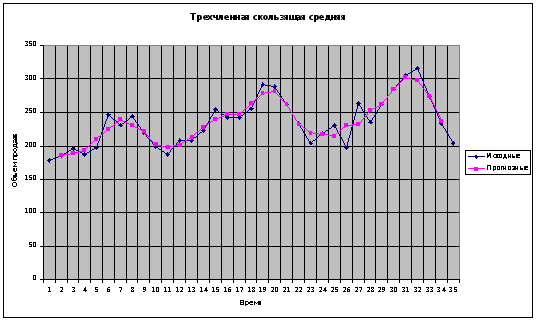
По графику можно сделать предположение о наличии тренда линейного типа. Для наглядности еще более сгладим исходные данные, построив с помощью инструмента «Скользящее среднее» надстройки «Анализ данных» приложения MS Excel график пятичленной скользящей средней.
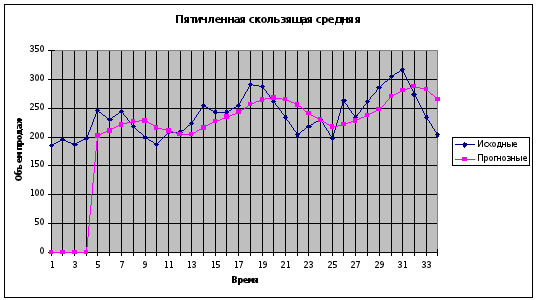
Предположение о наличии тренда подтверждается, очевидно, также имеет место сезонная компонента.
Построим уравнение неслучайной составляющей (тренда) временного рядаДля определения параметров модели временного ряда из линейного уравнения

воспользуемся инструментом «Регрессия» надстройки «Анализ данных» приложения MS Excel (результаты вычислений – в Приложении 14).
Получаем уравнение тренда временного ряда следующего вида:
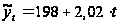
Проверим
значимость
построенного
уравнения по
F-критерию
при уровне
значимости
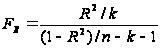
Величина коэффициента детерминации R2=0,324 также рассчитана с помощью инструмента «Регрессия» надстройки «Анализ данных» приложения MS Excel (результаты вычисления – в Приложении 14). Судя по этому параметру, изменение результативного показателя примерно на 32 % обусловлено влиянием временного фактора. Построенную модель на основе парного коэффициента корреляции =0,57 можно признать умеренно качественной.
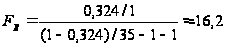
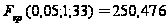
Наблюдаемое
значение F–критерия
меньше табличного:
250,476 > 16,2, т.е. выполнено
неравенство
 ,
а значит, в 95 %
случаев уравнение
регрессии
статистически
незначимо и
не отражает
зависимости
между временем
и объемом продаж
продовольственных
товаров, что
подтверждается
экономической
теорией.
Дать
точечную,
интервальную
оценки прогноза
среднего и
индивидуального
значений с
надежностью
на 1 и 2 шага вперед.
Чтобы сделать точечный прогноз на 1 и 2 шага вперед, подставим соответствующие значения фактора в полученное уравнение регрессии:
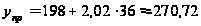
Доверительный интервал для среднего размера объема продаж продовольственных товаров на 01.12.1995 г. (t=36) с надежностью g=0,95:
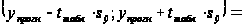
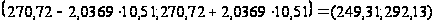
где стандартная ошибка для средних значений:
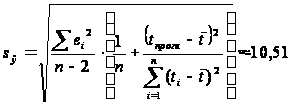 ,
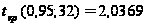
Т.е. средний размер объема продаж продовольственных товаров на 01.12.1995 г. (t=36) примерно находится в интервале от 249 до 292 относительных единиц.
Доверительный интервал для индивидуальных значений размера объема продаж продовольственных товаров на 01.12.1995 г. (t=36) с надежностью g=0,95:
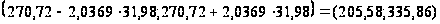
где стандартная ошибка для индивидуальных значений:
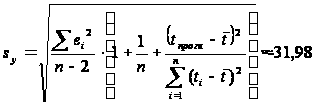
Таким образом, размер объема продаж продовольственных товаров на 01.12.1995 г. (t=36) в 95% случаев может находиться внутри интервала примерно от 205 до 335 относительных единиц.
Для прогноза на 2 шага вперед:
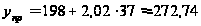
Доверительный интервал для среднего размера объема продаж продовольственных товаров на 01.01.1996 г. (t=37) с надежностью g=0,95:
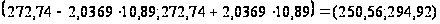
где стандартная ошибка для средних значений:
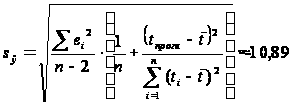 ,
Т.е. средний размер объема продаж продовольственных товаров на 01.01.1996 г. (t=37) примерно находится в интервале от 250 до 294 относительных единиц.
Доверительный интервал для индивидуальных значений размера объема продаж продовольственных товаров на 01.01.1996 г. (t=37) с надежностью g=0,95:
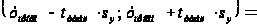
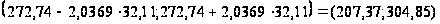
где стандартная ошибка для индивидуальных значений:
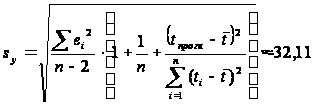
Таким образом, размер объема продаж продовольственных товаров на 01.01.1996 г. (t=37) в 95% случаев может находиться внутри интервала примерно от 207 до 304 относительных единиц.
Построим авторегрессионную модель временного ряда.Для построения авторегрессионной модели 1-го порядка вида
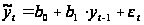
Определим ее параметры с помощью МНК из системы уравнений:
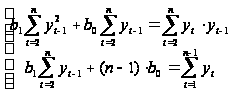
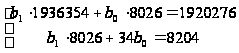
Воспользовавшись надстройкой «Поиск решения» приложения MS Excel, находим коэффициенты модели:

Получаем модель:
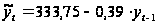
Дадим точечный прогноз по полученной авторегрессионной модели на 1 и 2 шага вперед:
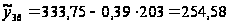
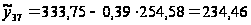
Дадим интервальный
прогноз среднего
и индивидуального
значений по
полученной
авторегрессионной
модели с надежностью
на
1 и 2 шага вперед.
Доверительный интервал для среднего размера объема продаж продовольственных товаров по полученной авторегрессионной модели на 01.12.1995 г. (t=36) с надежностью g=0,95:
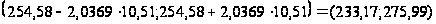
где стандартная ошибка для средних значений:
 ,
Доверительный интервал для индивидуальных значений размера объема продаж продовольственных товаров по полученной авторегрессионной модели на 01.12.1995 г. (t=36) с надежностью g=0,95:
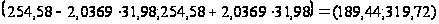
где стандартная ошибка для индивидуальных значений:

Итак, с надежностью 0,95 среднее значение объема продаж продовольственных товаров на момент t=36 будет заключено в пределах от 233,17 до 275,99 относительных единиц, а его индивидуальное значение — от 189,44 до 319,72 относительных единиц.
Для прогноза на 2 шага вперед:
Доверительный интервал для среднего размера объема продаж продовольственных товаров по полученной авторегрессионной модели на 01.12.1995 г. (t=37) с надежностью g=0,95:
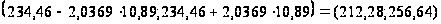
где стандартная ошибка для средних значений

Доверительный интервал для индивидуальных значений размера объема продаж продовольственных товаров по полученной авторегрессионной модели на 01.01.1996 г. (t=37) с надежностью g=0,95:
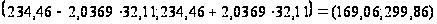
где стандартная
ошибка для
индивидуальных
значений:

Итак, с надежностью 0,95 среднее значение объема продаж продовольственных товаров на момент t=37 будет заключено в пределах от 212,28 до 254,64 относительных единиц, а его индивидуальное значение — от 169,06 до 299,86 относительных единиц.
Выводы по полученным результатам:Проведя сглаживание временного ряда методом простой скользящей средней, по графику сделали предположение о наличии тренда линейного типа. Вычислив параметры модели, получаем уравнение тренда
Величина коэффициента детерминации R2=0,324 свидетельствует о том, что изменение У на 32% обусловлено влиянием времени. Построенную модель на основе коэффициента корреляции можно признать умеренно качественной.
Проверив значимость построенного уравнения по F-критерию, приходим к выводу, что в 95% случаев уравнение регрессии статистически незначимо и не отражает зависимости между временем и объемом продаж продовольственных товаров, что подтверждается экономической теорией.
Точечный прогноз на 1 шаг вперед на основе полученной модели примет значение
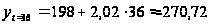
Интервальный прогноз позволяет установить, что размер объема продаж на 01.12.1995 г. в 95% случаев может находиться в интервале от 205 до 335 относительных единиц, а средний размер объема продаж - в интервале от 249 до 292 относительных единиц.
Точечный прогноз на 2 шага вперед на основе полученной модели примет значение
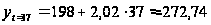
Интервальный прогноз позволяет установить, что размер объема продаж на 01.01.1996 г. в 95% случаев может находиться внутри интервала примерно от 207 до 304 относительных единиц, а средний размер объема продаж – внутри интервала от 207 до 304 относительных единиц.
Поскольку построенное ранее уравнение линейного тренда не является значимым, для прогнозирования значений временного ряда построили авторегрессионную модель