Математична обробка результатів вимірів
Закон розподілу системи випадкових величин можна задавати в різних формах. Покажемо табличний спосіб розподілу системи дискретних випадкових величин.
Якщо X та У -
дискретні
випадкові
величини, значення
яких дорівнюють
(ХbУj), де і =
 ,
а j = (
 ),
то їх розподіл
системи можна
характеризувати
ймовірностями
рij = Р(Х =
х1; Y = y1.
Це означає, що
коли випадкова
величина X приймає
значення х1
одночасно і
величина Y прийме
значення уj
Всі можливі
події (X = xі, Y = yj)
і =
,
а j = ()
складають повну
групу несумісних
подій і тому
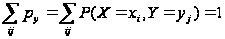
2. Система двох випадкових величин
В практиці геодезичних вимірів досить часто взаємодіють дві випадкові величини X та У, тобто двомірні випадкові величини. В попередньому параграфі ми наводили приклад з координатами точки. При лінійних вимірах взаємодіють - довжина мірного приладу та температура. При дослідженнях деформацій інженерних споруд взаємодіють — величина осідання та інтервал часу і так далі.
Закон розподілу системи двох випадкових величин задають функцією розподілу та щільністю розподілу.
Функцією розподілу системи двох випадкових величин називають функцію двох аргументів F (х,у), що дорівнює ймовірності сумісного виконання двох нерівностей Х<х і У < у, тобто
F(x,y) = P (X<x I Y<y)
Геометричне функцією розподілу системи двох випадкових величин є ймовірність попадання випадкової точки (Х,У) в нескінченний квадрат площини з вершиною в точці (х,у).
Функція розподілу має такі властивості:
1. Якщо один із аргументів наближається до плюс нескінченності, то функція розподілу системи наближається до функції розподілу випадкової величини другого аргументу, тобто
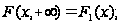
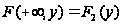
2. При наближенні обох аргументів до плюс нескінченності функція розподілу F (х,у) наближається до одиниці:

 або
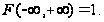
3. При наближенні одного чи обох аргументів до мінус нескінченності функція розподілу наближається до нуля:
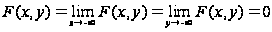
Практичне
значення мають
системи неперервних
випадкових
величин, розподіл
яких характеризують
щільністю
розподілу
 (х,
у). За допомогою
неї більш просто
знаходять
імовірність
попадання в
різні області,
а опис розподілу
системи випадкових
величин стає
більш наочним.
Щільність розподілу системи двох випадкових неперервних величин визначають як другу змішану часткову похідну від функції F(х,у), тобто
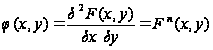
Функція розподілу F(х,у) визначається за формулою
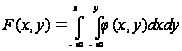
Щільність розподілу системи двох випадкових величин має властивості:
1. Щільністю
розподілу є
функція 
2. Подвійний інтеграл з нескінченними межами від функції щільності розподілу дорівнює одиниці:
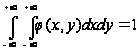
Геометрично це свідчить про те, що об'єм тіла, відмежованого поверхнею розподілу і площиною х0у, дорівнює одиниці.
Щільності розподілу величин х та у, що входять в систему, визначають за формулами:
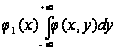
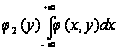
Тобто, для
визначення
щільності
розподілу
однієї із системи
випадкових
величин, треба
проінтегрувати
в необмежених
межах щільність
розподілу
системи
(х,у)
за аргументом
другої випадкової
величини.
Якщо відомі щільності розподілу окремих випадкових величин системи і випадкові величини х та у незалежні між собою, то можна визначити закон їх сумісного розподілу за формулою
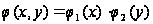
Поняття залежності та незалежності випадкових величин має велике значення в теорії ймовірностей та при математичній обробці результатів вимірів.
Випадкова величина X буде незалежною від випадкової величини У, якщо закон розподілу величини X не залежить від прийнятого значення величини У, тобто
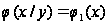
і навпаки, для випадкової величини Y маємо
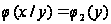
Якщо вони
взаємно залежні
між собою, то
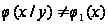 ;
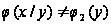
Випадкові
величини Х і
У незалежні,
якщо щільність
сумісного
розподілу
(х,у)
можна визначити
у вигляді добутку
двох множників,
кожен із яких
утримує тільки
величини х та
у, тобто
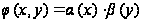
Додамо, що
при розкладанні,
функції
 ,
 (у)
з точністю до
постійної
множників
збігаються
з щільностями
розподілу
1(х)
і
2(у).
Між випадковими величинами виникає функціональна або стохастнчна (ймовірна) залежність.
Функціональною залежністю між випадковими величинами X і У називають таку залежність, коли кожному значенню X відповідає точне значення У.
Стохастичною (ймовірною) залежністю між випадковими величинами X і У називають таку залежність, при якій кожному значенню х можна вказати розподіл величини у, яке змінюється при зміні х.
Така залежність в практичній діяльності зустрічається досить часто. Наприклад, зріст та вага людини, висота і товщина дерева в лісі, величина деформації інженерних споруд, час їх експлуатації і т.д.
Тобто у випадку ймовірної залежності на кожне точне значення аргументу х можна вказати значення випадкової величини у з певною мірою ймовірності (Ру).
Система двох випадкових величин може підкорятися різним законам розподілу. Проте в практиці геодезичних вимірювань найбільше розповсюдження має нормальний закон розподілу.
3. Числові характеристики системи двох випадкових величин. Кореляційний момент, коефіцієнт кореляції і рівняння регресії
Найбільш повними ймовірними характеристиками системи двох випадкових величин є закон розподілу. Однак в практичній діяльності не завжди є можливість визначити його. Тому при дослідженнях систему двох випадкових величин характеризують їх числовими характеристиками: початковими та центральними моментами.
Початковим
моментом
 порядку s,
q системи
(X, У) називається
математичне
сподівання
від добутка
Xs на
Y9.
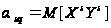
Для системи дискретних випадкових величин
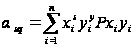
Між
випадковими
величинами
X і У може виникати
зв'язок. Кореляційний
момент Х
і Y
характеризує
силу або щільність
зв'язку. Відомо,
якщо між випадковими
величинами
існує ймовірний
зв'язок (залежність),
то зі зміною
випадкової
величини X змінюється
закон розподілу
випадкової
величини У. В
той же час закон
розподілу
задають кривою
розподілу у
= .
Характер кривих
може бути різним,
тому і відрізняють
декілька типів
імовірної
залежності.
Одним із найбільш
розповсюджених
типів є кореляційна
залежність,
за якої заміна
аргументу х
призводить
до зміни математичного
сподівання
величини у. В
першому випадку
ми маємо прямолінійну
кореляцію. При
дослідженнях
можуть виникнути
й інші типи
кореляційної
залежності.
Кореляційну залежність часто називають кореляцією. Кореляційний момент має розмірність, яка залежить від розмірності випадкових величин X і У. Тому для оцінки сили зв'язку між випадковими величинами системи (X, У) використовують не коефіцієнт зв'язку Кху, а безрозмірне відношення
 ,
яке називають
коефіцієнтом
кореляції
випадкових
величин Х і У.
Коефіцієнт
кореляції
змінюється
в межах від -1
до +1, тобто

Якщо r > 0, то маємо позитивну кореляцію, тобто із збільшенням абсциси х, збільшується величина ординати у і навпаки при r < 0 .
Якщо випадкові величини X і Y незалежні, то кореляційний момент і коефіцієнт кореляції дорівнює нулю, тобто Кху = 0 і rxy = 0.
Дві корельовані випадкові величини завжди є взаємозалежними, але дві залежні величини не завжди є корельованими. Прикладом цього може бути система випадкових величин (X, Y) рівномірно розподілена в межах кола з центром на початку координат. Розрахунки показують, що величини X і У залежні, а кореляційний момент Кxу = 0, а це означає, що і rxy = 0.
Випадкові
величини X і У
називають
корельованими,
якщо
 i при
 - некорельованими.
ГЛАВА II. ЕЛЕМЕНТИ МАТЕМАТИЧНОЇ СТАТИСТИКИ.
СТАТИСТИЧНА ОЦІНКА ПАРАМЕТРІВ РОЗПОДІЛУ
1. Основні поняття і задачі математичної статистики. Генеральна сукупність та вибірка
Математична статистика - дисципліна, яка займається регістрацією, збором, описом і аналізом експериментальних даних з метою вивчення закономірностей масових випадкових явищ.
Таким чином, всі задачі математичної статистики зводяться до визначення методів обробки результатів експериментальних досліджень (спостережень) масових випадкових явищ.
Найбільш типовими задачами математичної статистики є:
1. Оцінка невідомої функції розподілу за результатами вимірів. Якщо за результатами досліджень випадкової величини X одержано значення x1, x2, … xn то необхідно приблизно оцінити невідому функцію розподілу Р(х).
2. Оцінка точності невідомих параметрів розподілу. При вирішенні цього питання обчислюють параметри функції розподілу випадкової величини на основі отриманих результатів експерименту і оцінюють їх значення.
3. Статистична перевірка гіпотез. Якщо за результатами експерименту визначено функцію розподілу Р(х) випадкової величини X, то вирішується питання: чи дійсно випадкова величина X має розподіл Р(х) ?
При дослідженнях випадкових явищ виконують досить велику кількість випробувань (експериментів) - N.
Генеральна сукупність - це сукупність значень результатів досліджень (вимірів). Досить часто мають на увазі, що число N може бути нескінченним.
Проте практично виконати нескінченну кількість дослідів (вимірів) або обстежити нескінченну кількість виробів неможливо, і економічно невигідно. В цьому випадку із всієї генеральної сукупності відбирають обмежене число результатів експерименту.
Вибірковою сукупністю або просто вибіркою називають сукупність випадково вибраних результатів чи об'єктів.
Проте вибірка може як досить точно характеризувати досліджуване випадкове явище, так і ні.
Представницькою або презентабельною вибірковою називають об'єм вибірки n із генеральної сукупності N, який дозволяє повною мірою визначити характеристики генеральної сукупності. Інформація буде більш імовірною, коли результати досліджень, що складають вибірку, будуть незалежними.
2. Розподіл статистичних рядів
Практично, до початку досліджень випадкового явища, заздалегідь невідомо, якому закону розподілу будуть підпорядковуватися результати експерименту. Для його визначення над випадковою величиною X виконують низку незалежних експериментів (вимірів).
Статистична таблиця є початковою формою запису статистичного матеріалу, який може оброблятися різними методами.
Однак при великій кількості експериментів (вимірів) їх результати практично неможливо показати в статистичній таблиці. Тоді результати спостережень розділяють на групи. Кожна група містить деяку кількість (частоту) результатів, що належать визначеному інтервалу. Довжина інтервалу розраховується за формулою Г.А.Стерджеса
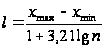
де n - кількість результатів спостережень.
Можна задати число інтервалів k. Тоді довжину інтервалу визначають за формулою
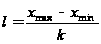
Значення
інтервалу l
заокруглюють
до зручного
цілого значення
так, щоб число
їх було в межах
 .
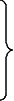 Потім
визначають
граничні значення
інтервалів
за формулами
для 1-ої
групи 

для 2-ої
групи 

для k-ої
групи 
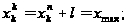
де
 ,
 - відповідно
початкове та
кінцеве значення
абсциси х
(результатів
вимірів).
Для кожної
групи підраховують
частоту результатів
Vi, які
попадають в
граничні значення
і
,
і статистичну
ймовірність
 за формулою
 ,
причому V1 + V2 + ...+ Уk = n; р1 + р2+... + рk = 1.
За допомогою статистичної таблиці або статистичної сукупності можна побудувати статистичну функцію розподілу випадкової величини X.
3. Оцінювання параметрів закону розподілу
Відомо, що випадкова величина X характеризується законом розподілу, що має деякі невідомі параметри a(a1, a2, …, аk). Якщо в результаті виконаного експерименту нами отримано статистичний ряд Х1, Х2, ..., Х3 то очевидно можна знайти надійну оцінку параметра а.
Припустимо,
що на основі
обробки статистичного
ряду отримано
параметра, який
буде оцінкою
невідомого
параметра
 .
Разом з тим,
він буде функцією
від випадкових
величин Х1,
Х2, ..., Х3 тобто
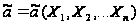
Таким чином і обчислений параметр а буде випадковою величиною, закон розподілу якого залежить від закону розподілу випадкової величини X і від числа експериментів n. При цьому оцінка а буде мати практичну цінність, якщо володіє властивостями:
1 . Незміщеності. При цьому повинна виконуватися умова
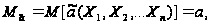
де а - істинне значення параметра.
2. Обгрунтованості. Тобто за ймовірністю вона зводиться до оцінюваного параметра при нескінченному збільшенні кількості дослідів, тобто

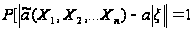
де
 - як завгодно
мале позитивне
число.
3. Ефективності. Це означає, що дисперсія оцінки а повинна бути мінімальною, тобто
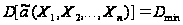
При цьому буде мінімальна ймовірність появи грубої помилки при визначенні наближеного значення невідомого параметра.
Таким чином при розробці методів обробки статистичних даних для визначення оцінок наближених значень невідомих параметрів треба виходити з їх властивостей. Оцінки параметрів закону розподілу, що відповідають всім трьом властивостям називають доброякісними.
Практично розроблено три способи визначення оцінок: метод моментів; метод максимальної правдоподібності (ММП); метод найменших квадратів (МНК).
В методі моментів значення теоретичних моментів заміняють значеннями емпіричних моментів, які обчислюють за результатами статистичних рядів чи статистичної сукупності.
В методі
максимальної
правдоподібності
(ММП), розробленого
Р. Фішером
розглядають
значення випадкових
величин Х1,
Х2, ..., Х3, що
отримані при
проведенні
дослідів і
використовують
їх для визначення
невідомого
параметра а.
Якщо щільність
розподілу
 (х,
а) залежить від
параметра а,
то в ММП задаються
правдоподібною
функцією, виходячи
з того, що всі
Х1 незалежні.
Сутність ММП
полягає в тому,
що за якісну
оцінку параметра
а беруть таке
значення аргументу,
яке приводить
функцію L
до максимуму.
Рівняння розв'язують
за умови

При цьому вибирають таке визначення а, яке зводить функцію Ь до максимуму. Для спрощення функцію правдоподібності заміняють логарифмом, тоді
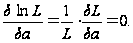
РОЗДІЛ 5. СТАТИСТИЧНА ПЕРЕВІРКА ГІПОТЕЗ
1. Статистичні дослідження рядів вимірів
Навколишнє середовище, явища природи, закони фізики та інших наук вивчають шляхом випробувань, в результаті яких отримують випадкові величини або статистичний ряд x1, x2, …, xn. Одночасно може досліджуватися декілька явищ. При цьому отримують декілька статистичних рядів або сукупностей випадкових величин.
Залежно від процесів, що відбуваються при випробуваннях, кожен статистичний ряд підпорядковується тому чи іншому закону розподілу. Його можна визначити шляхом математичної обробки вимірів.
Для отримання надійних результатів і обгрунтованих рішень при математичній обробці результатів експериментів необхідно знати закони розподілу статистичних рядів. Знання закону розподілу необхідно і для застосування методів обробки вимірів.
Всяке передбачення про закон розподілу випадкових величин називають статистичною гіпотезою.
Статистична перевірка гіпотез полягає у визначенні закону розподілу результатів експериментів. Висунуту гіпотезу називають нульовою гіпотезою.
В результаті статистичної перевірки для нульової гіпотези визначають статистику Q. Перевірка нульової гіпотези базується на теорії надійних інтервалів та способах перевірки статистичних гіпотез.
За принципом
практичної
впевненості
для висунутої
нульової гіпотези
визначають
теоретичне
значення статистики
Qq. Його визначають
за таблицями
різних критеріїв
перевірки по
заданій імовірності
p або рівнях
значимості
q = 1 - р. В разі, коли
 нульова гіпотеза
приймається.
В протилежному
випадку вона
не підтверджується,
тобто відкидається.
Статистична перевірка може виконуватися одним і більше критеріями (методами). При цьому може виникнути дві помилки:
1. Бракування правильної гіпотези. Уникнути її можна підвищенням значення ймовірності р або зниженням рівня значності q.
2. Прийняття неправильної гіпотези. Уникнути її можна застосуванням різних критеріїв перевірки.
Ймовірність
прийняття
нульової гіпотези
підвищується
зі збільшенням
кількості
випробувань
і практично
надійна, коли
 .
Надійність
перевірки
статистичної
гіпотези висока
при достатньо
великій імовірності
бракування
неправильної
гіпотези. Важливе
значення має
і вибір критерію
перевірки.
При математичній обробці геодезичних вимірів найбільш поширені такі перевірки статистичних гіпотез:
1. Визначення систематичної (або постійної) похибки
Залежність від умов експерименту може виконуватися такими способами:
а) систематичні похибки значно спотворюють результат і можуть призвести до недоброякісних оцінок. Систематична похибка може визначатися на компараторі розміром X і в результаті експериментів буде отримано статистичний ряд x1, x2, …, xn
При обробці за формулою визначають середнє арифметичне X і обчислюють різницю

За формулою визначають середню квадратичну похибку окремого виміру m та обчислюють середню квадратичну похибку середнього арифметичного X за формулою
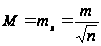
Обчислюють статистику

2. Визначення граничних похибок.
При математичній обробці результатів вимірів слід виключати із обробки грубі помилки. Методика вимірювань дозволяє своєчасно виключити "промахи" при яких окремі результати значно відрізняються від інших. Разом з тим в статистичному ряду вимірів можуть бути результати вимірів, які досить близькі між собою, але за вимогами точності або технології виконання робіт будуть грубими. Тому поняття "груба помилка" досить умовне і залежить від прийнятої надійної ймовірності.
При визначенні цільності нормованого нормального закону розподілу користувалися нормованими похибками

де
 - похибка
виміру; m
- середня квадратична
похибка.
При визначених
умовах вимірів
завжди існує
деяка гранична
похибка
 ,
яку не можуть
перевищити
випадкові
похибки. Тоді
за функцією
Лапласа нормованого
нормального
закону розподілу
можна визначити
інтервал zg,
залежність
від рівня значності
q.
2. Перевірка закону розподілу статистичних рядів
Важливе значення при математичній обробці геодезичних вимірів має знання закону розподілу результатів або похибок вимірів. Найкращі оцінки отримують, коли ряд вимірів підпорядковується нормальному закону розподілу. Однак, практично комплекс умов постійно дещо змінюється. В наслідок цього виникає відхилення закону розподілу результатів вимірів від теоретичного значення функцій розподілу.
Практично на основі тих чи інших відомостей висувають припущення або ("нульову") гіпотезу про вид закону розподілу статистичного ряду, створеного за результатами вимірів. Шляхом застосування різних критеріїв перевірки визначають, чи є допустимим розходження між дослідним і теоретичним (передбачуваним) законом розподілу.
Враховуючи, що результати геодезичних вимірів, як правило, підпорядковуються нормальному закону розподілу при дотриманні "комплексу умов" або вимог нормативно-технічної документації, розглянемо ряд критеріїв повірки відповідності нормальному закону розподілу результатів вимірів:
1. Перевірка по асиметрії і ексцесу
Гіпотезу про нормальний закон розподілу статистичного ряду називають нульовою або основною. Маємо статистичний ряд x1, x2, …, xn і висунута гіпотеза, що він підпорядковується нормальному закону розподілу (НЗР). За формулами можна визначити числові характеристики НЗР: математичне сподівання або середнє арифметичне, дисперсію, середню квадратичну похибку, асиметрію Sk та ексцес Еk.
Скористаємося тим, що асиметрія Sk та ексцес Еk є числовими характеристиками, що характеризують ступінь відхилення досліджуваного розподілу від теоретичного НЗР. Вони, як і інші параметри НЗР є випадковими величинами, а тому можуть відхилятися від нуля.
Мірою точності асиметрії та ексцесу є дисперсії
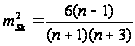
При великій кількості вимірів відповідно маємо
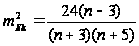
При великій кількості вимірів маємо:


2. Критерій Колмогорова
Це найбільш
простий критерій
перевірки
гіпотези про
нормальний
закон розподілу.
Використовується
різниця D
між статистичною
інтегральною
функцією розподілу
 (z)
і відповідною
теоретичною
функцією розподілу
F(z).
При невеликій
кількості
вимірів
 для статистичного
розрахунку
обчислюють:
середнє арифметичне
 ,
відхилення
 ,
за формулою
Бесселя середню
квадратичну
похибку m.
Далі обчислюють
нормовані
похибки
 і складають
зростаючий
ряд Zmin,
Z1,
Z2,
… Zmax.
3. Критерій x2 (Пірсона)
В математичній статистиці його вважають найбільш строгим і надійним критерієм погодження нульових гіпотез. Він забезпечує мінімальну ймовірність виникнення похибок 2-го роду.
Розрахунки в критерії Пірсона аналогічні критерію Колмогорова і пов'язані з групуванням нормованих похибок. Слід пам'ятати, що при групуванні похибок в кожному інтервалі їх повинно бути не менше п'яти. Тому крайні інтервали можна штучно об'єднувати (збільшувати). Число інтервалів повинно бути не менше чотирьох.
Критерієм перевірки нульової гіпотези є статистика
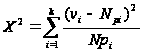 ,
де N= [vi] - число всіх вимірів, pi - теоретичне значення ймовірності вибраних інтервалів вибирається із таблиць.
В критерії Пірсона доведено, що при нормальному розподілі похибок вимірів статистика X2 має X2 - розподіл з числом ступенів вільності k = n – 1.
Критична область для нульової гіпотези буде

де %д - вибирається із таблиць дод. 9 за заданими д і г = & — З, &- кількість інтервалів.
2. Розподіл імовірностей випадкових похибок
Результати вимірів е випадковими оскільки передбачити їх величину неможливо. Тоді і їх похибки будуть випадковими і для них можна вказати лише межу, в яких вони змінюються згідно з першою властивістю.
Неперервні випадкові похибки можна характеризувати законом розподілу, як об'єктивно існуючим зв'язком між випадковими величинами і їх імовірностями.
При багаторазових випробуваннях закон розподілу ряду істинних випадкових похибок можна характеризувати функціями:
1. Інтегральною функцією розподілу
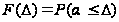 (
 )
2. Функцією щільності
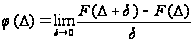
де
 - приріст випадкової
похибки
 .
Звернемося до постулату Гаусса, згідно з яким найбільш імовірним значенням шуканої величини є середнє арифметичне Із результатів повторних вимірювань. Скористаємося теоремою:
Якщо випадкові
похибки відповідають
постулату
Гаусса, то законом
розподілу
випадкових
похибок буде
нормальний
закон. В методі
максимальної
правдоподібності
Фішера також
доведено, що
для нормального
закону розподілу
випадкових
величин оцінкою
параметра