Систематичний відбір
 ,
тому що кожна
з
 страт вносить
 ступінь вільності.
Величина
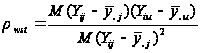 .
є коефіцієнтом кореляції між відхиленнями від середнього значення для страти по всім парам одиниць, що належать до однієї й тієї ж систематичної вибірки.
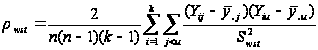 .
(1.1.5)
Доведення.
Доведення цієї теореми аналогічно доведенню теореми 1.1.3.
Дисперсія
середнього
значення
 систематичної
вибірки дорівнює
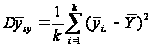
Розпишемо
середнє значення
популяції
 через середнє
стратифікованої
вибірки
 :
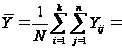 {
 -
це
 -та
одиниця
 -ї
страти}

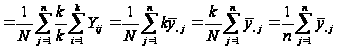 .
Отже маємо
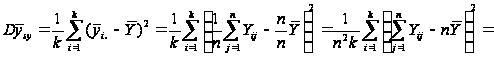
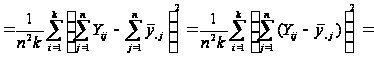
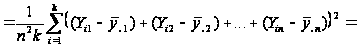
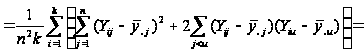
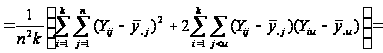
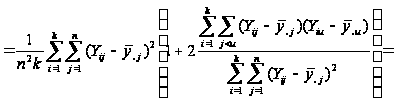
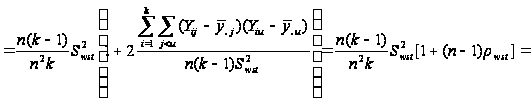
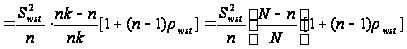 .
Отже,
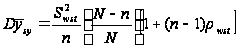 .
Теорема доведена.
Наслідок.
Якщо
 ,
то систематична
вибірка має
ту саму точність,
що й відповідна
стратифікована
випадкова
вибірка з однією
одиницею у
кожній страті.
Це твердження
випливає з
того, що для
такої стратифікованої
випадкової
вибірки
 дорівнює:
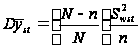 .
Теорема
1.1.5. Дисперсія
величини
 ,
яка використовується
для оцінювання
сумарного
значення популяції
 ,
дорівнює
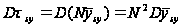 .
Приклад.
У таблиці 1.1.2
наведені данні
для невеликої
штучної популяції,
яка показує
тенденцію до
досить стійкого
зростання
значень ознаки
у послідовності
одиниць. Маємо
 ,
 ,
 .
Кожний стовпчик
відповідає
деякій систематичній
вибірці, а рядки
є стратами.
Приклад ілюструє
ситуацію, коли
кореляція
«всередині
страт» додатна.
Наприклад, у
першій вибірці
кожне з чотирьох
чисел (0, 6, 18, 26) менше
середнього
значення у
страті, до якого
воно належить.
Це справедливо,
з невеликим
винятком, для
перших п’яти
систематичних
вибірок. В останніх
п’яти вибірках
відхилення
від середніх
значень для
страт в основному
додатне. Таким
чином, члени
суми у виразі
для
 переважно
додатні. Відповідно
до теореми
1.1.4 можна очікувати,
що систематичний
відбір буде
менш точним,
ніж стратифікований
випадковий
відбір з однією
одиницею у
кожній страті.
Таблиця 1.1.2
Данні по 10 систематичним
вибіркам при
обсязі вибірок
та
обсязі популяції
| Страта |
Номер
систематичної
вибірки ( |
|
|||||||||
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | ||
|
I II III IV |
0 6 18 26 |
1 8 19 30 |
1 9 20 31 |
2 10 20 31 |
5 13 24 33 |
4 12 23 32 |
7 15 25 35 |
7 16 28 37 |
8 16 29 38 |
6 17 27 38 |
4,1 12,2 23,3 33,1 |
|
|
12, 5 | 14, 75 | 15, 25 | 15, 75 | 18, 75 | 17, 75 | 20, 5 | 22 | 22, 75 | 22 | 72,7 |
|
|
50 | 58 | 61 | 63 | 75 | 71 | 82 | 88 | 91 | 88 | |


Середнє значення систематичної вибірки має розподіл
~
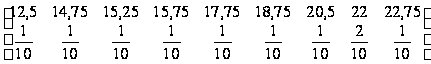
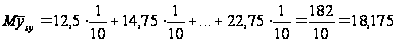
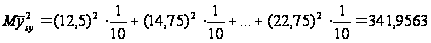
Дисперсія систематичної вибірки дорівнює
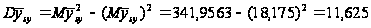
Знайдемо середнє та дисперсію для всієї популяції:
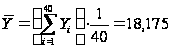
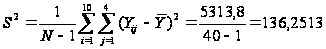
Тепер знайдемо дисперсію одиниць, що належать до однієї й тієї самої страти:
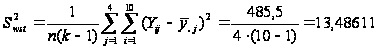 ,
де
-
число страт,
 -
обсяг стратифікованої
вибірки.
Тоді дисперсія оцінки середнього для простої випадкової вибірки має вид:
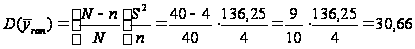 ,
де
-
обсяг простої
випадкової
вибірки.
Дисперсія оцінки середнього для стратифікованої випадкової вибірки
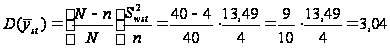 ,
де
- число страт.
Стратифікований випадковий відбір та систематичний відбір виявились набагато ефективнішими, ніж простий випадковий відбір, причому, як і очікувалось, систематичний відбір менш точний, ніж стратифікований випадковий відбір.
1.2 Порівняння систематичного відбору зі стратифікованим випадковим відбором
Ефективність
систематичного
відбору в порівнянні
зі стратифікованим
або простим
випадковим
відбором суттєво
залежить від
особливостей
популяції.
Існують такі
популяції, в
яких систематичний
відбір дає
високу точність,
але є й такі,
для яких простий
випадковий
відбір є більш
точним ніж
систематичний.
Для деяких
популяцій та
деяких значень
дисперсія
 середнього
систематичної
вибірки, веде
себе досить
погано − вона
може навіть
зростати при
збільшені
обсягу вибірки
.
Тому важко
вказати загальні
умови, за яких
рекомендовано
застосовувати
систематичний
відбір. В будь-якому
випадку для
того, щоб його
застосування
було ефективним,
необхідно знати
будову популяції,
з якої проводиться
відбір.
При дослідженні
цієї проблеми
існує два напрямки.
При одному з
них порівнюються
різні типи
відбору зі
штучних сукупностей,
для яких
 є деякою простою
функцією
.
При іншому −
проводиться
аналогічне
порівняння
для реальних
популяцій.
1.3 Популяції з «випадковим» порядком розміщення одиниць
Систематичний
відбір, оскільки
він зручний,
застосовується
іноді до популяцій,
в яких одиниці
дійсно розташовані
навмання. Наприклад,
так буває при
відборі з картотеки,
що складена
в алфавітному
порядку за
прізвищами,
якщо змінюється
ознака, яка
ніяк не пов’язана
з прізвищем
того, кого
обстежують.
В цьому випадку
не буде ніякої
тенденції чи
стратифікування
по
в розташуванні
карток, ні кореляції
між сусідніми
одиницями.
У такій ситуації
ми могли б очікувати,
що систематичний
відбір буде,
по суті, рівносильний
простому випадковому
відбору та буде
мати ту саму
дисперсію. Для
конкретної
скінченої
популяції при
заданих значеннях
і
це не завжди
вірно, тому що
 ,
яка має
ступенів вільності,
при малих
досить нестійка
і може виявитись
як більше так
і менше, ніж
 .
Але існують
дві теореми,
які показують,
що в середньому
ці дисперсії
рівні.
Теорема
1.3.1. Розглянемо
всі
 скінчених
популяцій, що
утворюються
за допомогою
перестановок
деякого набору
чисел
 .
Тоді в середньому
по всім цим
скінченим
популяціям
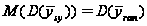 .
Зауважимо,
що
 для усіх перестановок
однакова.
Ця теорема
стверджує, що
якщо перестановку,
яка визначає
порядок значень
у деякій конкретній
скінченій
популяції,
можна вважати
обраною навмання
із можливих
перестановок,
то в середньому
систематичний
відбір еквівалентний
простому випадковому
відбору.
При іншому підході скінчену популяцію вважають добутою навмання з деякої нескінченої надпопуляції, що має певні властивості. Теорема 1.3.1 відноситься не до будь-якої скінченої популяції, а до середнього по всім скінченим популяціям, які можуть бути добуті із даної нескінченої надпопуляції.
Позначимо
через
 -
середнє по всім
скінченним
популяціям,
які можуть бути
добуті з даної
надпопуляції.
Теорема
1.3.2. Якщо змінні
 добуті за допомогою
випадкового
відбору із
надпопуляції,
для якої

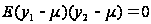
 ,
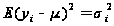 ,
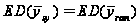 .
Головну роль відіграють дві умови:
всі
мають одне і
теж середнє
 ,
тобто в їх змінах
відсутній
будь-який тренд;
між значеннями
та
 у двох різних
точках відсутня
лінійна кореляція.
Дисперсія
 може
бути різною
для різних
.
Доведення. Для будь-якої визначеної скінченої популяції
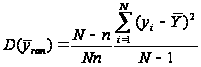 .
Далі,
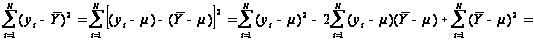
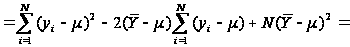
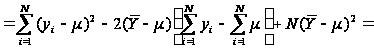
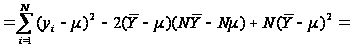
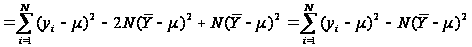 .
Оскільки
та
некорельовані
,
то
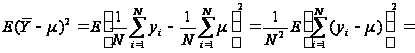
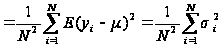 .
Отже,
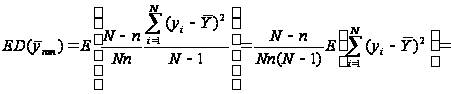
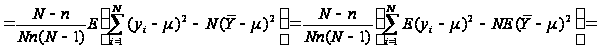
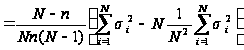 .
Звідси
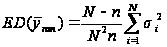 .
Повертаючись
до
позначимо через
 середнє значення
ознаки для
 -тої
систематичної
вибірки. Для
будь-якої визначеної
скінченої
популяції
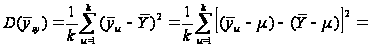
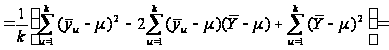
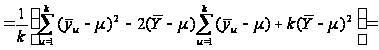
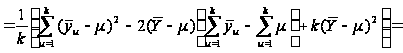
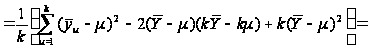
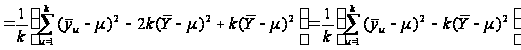 .
За теоремою про дисперсію середнього для некорельованої вибірки, добутої з нескінченої популяції
~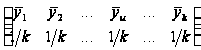 ,
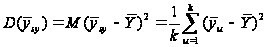 ,
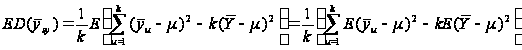 .
Розглянемо докладніше вираз у дужках
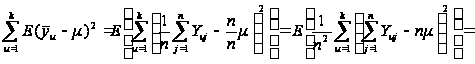
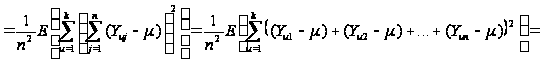
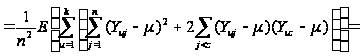
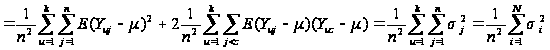 .
Раніше було показано, що
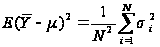 .
Отже маємо
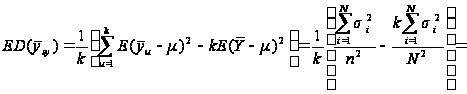
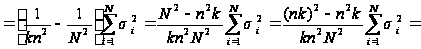
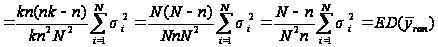 .
Теорема доведена.
1.4 Популяції з лінійним трендом
Якщо
популяція
містить тільки
лінійний тренд,
як показано
на рис.1.4.1, то характер
результатів
уявити собі
досить просто.
З рис. 1.4.1 видно,
що
та
 (при вибірці
з однією одиницею
із кожної страти)
будуть менше,
ніж
.
Крім того,
буде більше,
ніж
,
оскільки, якщо
в деякій страті
значення
спостереження
менше середнього
для цієї страти,
то при систематичному
відборі значення
спостереження
буде менше в
усіх інших
стратах, в той
час, як при
випадковому
стратифікованому
відборі помилки
всередині страт
можуть взаємно
знищуватись.
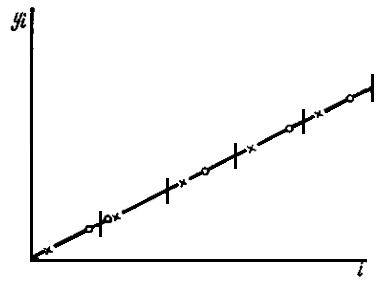
Рис. 1.4.1.
Систематичний
відбір із популяцій
з лінійним
трендом:
 - систематична
вибірка,
 -
стратифікована
вибірка
Для теоретичної
перевірки цих
результатів
достатньо
розглянути
випадок, коли
 ,
 .
Маємо
 ;
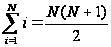 ;
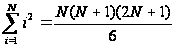 .
(1.4.1)
Дисперсія
сукупності,
 ,
дорівнює:
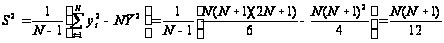 .
(1.4.2)
Отже,
дисперсія
середнього
для простої
випадкової
вибірки дорівнює:
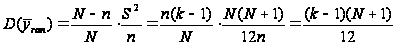 .
(1.4.3)
Для того,
щоб знайти
дисперсію
всередині
страт,
 ,
достатньо лише
підставити
у формулу (1.4.2)
замість
 .
Це дає
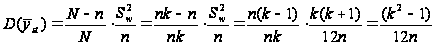 (1.4.4)
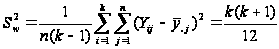
При систематичному
відборі середнє
значення для
другої вибірки
перевищує
середнє для
першої на 1; середнє
значення для
третьої вибірки
перевищує
середнє для
другої на 1 і
т.д. Тому при
обчисленні
дисперсії
середні
можна замінити
числами
 .
Отже, виходячи
з (1.4.2), використовуючи
;
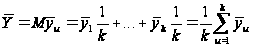 ,
Отримаємо
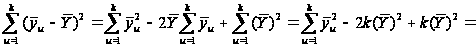
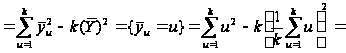
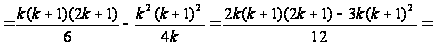
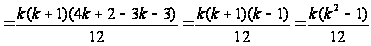 .
Звідси
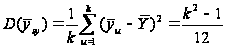 .
(1.4.5)
З формул (1.4.3), (1.4.4), (1.4.5) випливає, що
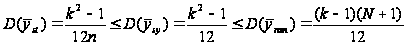 .
Дисперсії
для різних
способів відбору
рівні тільки
при
 .
Таким чином,
якщо ми хочемо
уникнути впливу
лінійного
тренду (очікуваного
або неочікуваного),
то для цієї
мети систематична
вибірка набагато
ефективніша,
ніж проста
випадкова
вибірка, але
менш ефективна,
ніж стратифікована
випадкова
вибірка.
Ефект
використання
систематичного
відбору за
наявності
лінійного
тренду можна
збільшити
кількома способами.
Один із них
полягає у тому,
щоб використати
центрально
розташовану
вибірку. Інший
− в тому, щоб
при обчисленні
оцінки замість
незваженого
середнього
брати зважене,
в якому усім
внутрішнім
членам вибірки
надається вага,
що дорівнює
одиниці (до
ділення на
),
а першому та
останньому
членам − інша
вага. Якщо число,
яке відібране
навмання з
чисел
виявиться
рівним
,
то ця вага буде
дорівнювати
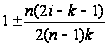 ,
причому
вага, що надається
першому члену,
має знак «+», а
останньому
− знак «-». Очевидно,
що при будь-якому
сума цих двох
ваг дорівнює
2.
1.5 Популяції з періодичною варіацією
Якщо
популяція
містить періодичний
тренд, наприклад,
звичайну синусоїду,
то ефективність
систематичної
вибірки залежить
від значення
.
Це можна